
PostgreSQL 18: откуда взялся предел в 100 миллионов и почему autovacuum стал ходить чаще
Обновили сервер до PostgreSQL 18, autovacuum_vacuum_scale_factor не трогали — а самая большая таблица в базе вдруг чистится в два с лишним раза чаще, диск шумит, реплика отстаёт. Разбираю, откуда взялся новый предел в 100 миллионов строк, кого он реально задел (спойлер: далеко не всех, и типовые базы 1С почти никогда), как за пятнадцать минут понять, ваш это случай или нет, и что крутить в первую очередь — на примере сервера небольшой микрофинансовой организации, который я разбирал этим летом.
Откуда взялся предел: одна строка в формуле
Начну с главного: вы ничего не сломали и никто не подкрутил конфиг за вашей спиной. В PostgreSQL 18 изменилась сама формула, по которой autovacuum решает, пора ли идти в таблицу. До восемнадцатой версии порог считался тупо и линейно: autovacuum_vacuum_threshold плюс autovacuum_vacuum_scale_factor, умноженный на pg_class.reltuples. Пятьдесят строк плюс двадцать процентов от размера таблицы. Всё. Чем больше таблица — тем больше мёртвых версий строк она должна накопить, прежде чем к ней придут.
В 18-й формулу обернули в минимум. Документация формулирует так: vacuum threshold = Minimum(vacuum max threshold, vacuum base threshold + vacuum scale factor × number of tuples). Роль верхней границы играет новый параметр autovacuum_vacuum_max_threshold, и его значение по умолчанию — 100 000 000. То есть теперь порог никогда не поднимется выше ста миллионов мёртвых строк, сколько бы миллиардов записей в таблице ни лежало. В release notes авторами изменения указаны Натан Боссарт и Фредерик Юэль; саму идею «жёсткого потолка» и выбор значения по умолчанию долго обсуждали в рассылке pgsql-hackers.
Дальше простая арифметика, которую стоит проделать до того, как лезть в конфиг. Старая формула догоняет новый потолок в точке 0,2 × N + 50 = 100 000 000, то есть при N ≈ 499 999 750 строк. Круглым счётом — полмиллиарда. Если ваша самая жирная таблица меньше, минимум всегда выберет старое процентное выражение, и в её расписании не изменилось ровным счётом ничего. Я это проговариваю отдельно, потому что после выхода 18-й ко мне трижды приходили с «у нас после апгрейда autovacuum сошёл с ума», и в двух случаях из трёх самая большая таблица была на 60–90 миллионов строк, а причина всплеска оказывалась совсем в другом месте.
Параметр — обычный GUC уровня postgresql.conf (задаётся в файле или в командной строке сервера), применяется при перечитывании конфигурации, рестарт не нужен. Значение -1 снимает верхнюю границу и возвращает поведение PostgreSQL 17. Есть и табличный вариант через storage parameters, и вариант с префиксом toast. для служебной TOAST-таблицы — про них ниже отдельно, там прячется половина граблей.
# postgresql.conf, PostgreSQL 18 — значения по умолчанию
autovacuum_vacuum_threshold = 50
autovacuum_vacuum_scale_factor = 0.2
autovacuum_vacuum_max_threshold = 100000000   # новое в 18; -1 снимает потолок
Перечитать конфиг без рестарта:
SELECT pg_reload_conf();- autovacuum_vacuum_threshold — 50 строк, как и раньше;
- autovacuum_vacuum_scale_factor — 0.2, как и раньше;
- autovacuum_vacuum_max_threshold — 100 000 000, появился в PostgreSQL 18;
- -1 снимает потолок и возвращает поведение 17-й версии;
- применяется перечитыванием конфига (pg_reload_conf), рестарт кластера не требуется;
- переопределяется по таблице и отдельно для её TOAST через toast.autovacuum_vacuum_max_threshold.
Кого задело на самом деле и почему это не всегда плохо
Возьмём таблицу на два миллиарда строк. По старой формуле autovacuum приходил, когда накапливалось 400 000 050 мёртвых версий. По новой — когда накопится 100 000 000. Ровно в четыре раза чаще. При десяти миллиардах строк разница будет двадцатикратной. Вот и весь фокус: чем крупнее таблица, тем резче поменялось её расписание, и никакой скрытой логики тут нет.
Теперь честно о том, хорошо это или плохо. Сообщество вводило потолок не из вредности: процентная модель на огромных таблицах вырождается. Таблица растёт, порог растёт вместе с ней, и в какой-то момент autovacuum приходит раз в неделю, а то и реже, но зато молотит по шесть-девять часов, раздувая индексы и превращая каждый свой заход в маленькую аварию. Плюс всё это время мёртвые строки честно лежат в куче и в индексах, и index-only scan по ним деградирует. С потолком проходы становятся чаще, но короче и предсказуемее — это как раз то, что нужно системе с круглосуточной нагрузкой.
Обратная сторона тоже реальная, и я не буду её замазывать. Стоимость одного прохода autovacuum определяется не столько количеством мёртвых строк, сколько объёмом того, что надо просканировать. Кучу vacuum обходит по visibility map, а вот индексы, если мёртвые строки вообще есть, обходит целиком. Значит, четыре прохода вместо одного — это четыре полных обхода всех индексов таблицы вместо одного. На таблице с шестью-восемью индексами суммарный дисковый ввод-вывод растёт заметно, и именно это люди чувствуют как «после апгрейда стало хуже».
Мой вывод из практики: на NVMe и приличном пуле воркеров новый дефолт — это улучшение, надо только дать autovacuum достаточную пропускную способность. На старых SAS-полках и на кластерах, где autovacuum годами душили дефолтным vacuum_cost_limit = 200, новый дефолт вскрывает застарелую проблему и выглядит как регрессия. Лечится это не откатом потолка, а настройкой скорости — но об этом в пятом разделе.
Отдельно про базы 1С, потому что именно с ними к нам приходят чаще всего. В типовой конфигурации небольшой компании самые крупные таблицы — это регистры бухгалтерии и накопления (_AccRg, _AccumRg) и регистры сведений (_InfoRg), и даже за много лет работы они редко дотягивают до сотни миллионов строк, не то что до полумиллиарда. Журнал регистрации 1С по умолчанию вообще живёт в файлах на сервере приложений, а не в СУБД. Поэтому для самой базы 1С новый потолок почти всегда нейтрален. А ещё 1С сама управляет схемой: табличные reloptions на её таблицах после реструктуризации при обновлении конфигурации могут пропасть вместе с пересозданной таблицей, так что точечные настройки там надо перепроверять после каждого обновления. Прежде чем обновлять PostgreSQL под 1С, сверьтесь с перечнем поддерживаемых версий СУБД для вашей версии платформы.
- 1 млрд строк: было 200 000 050 → стало 100 000 000, вдвое чаще;
- 2 млрд строк: было 400 000 050 → стало 100 000 000, вчетверо чаще;
- 5 млрд строк: было 1 000 000 050 → стало 100 000 000, в десять раз чаще;
- меньше 500 млн строк: не изменилось ничего.
Стенд: «МикроЗайм Дом», таблица на 1,12 миллиарда строк
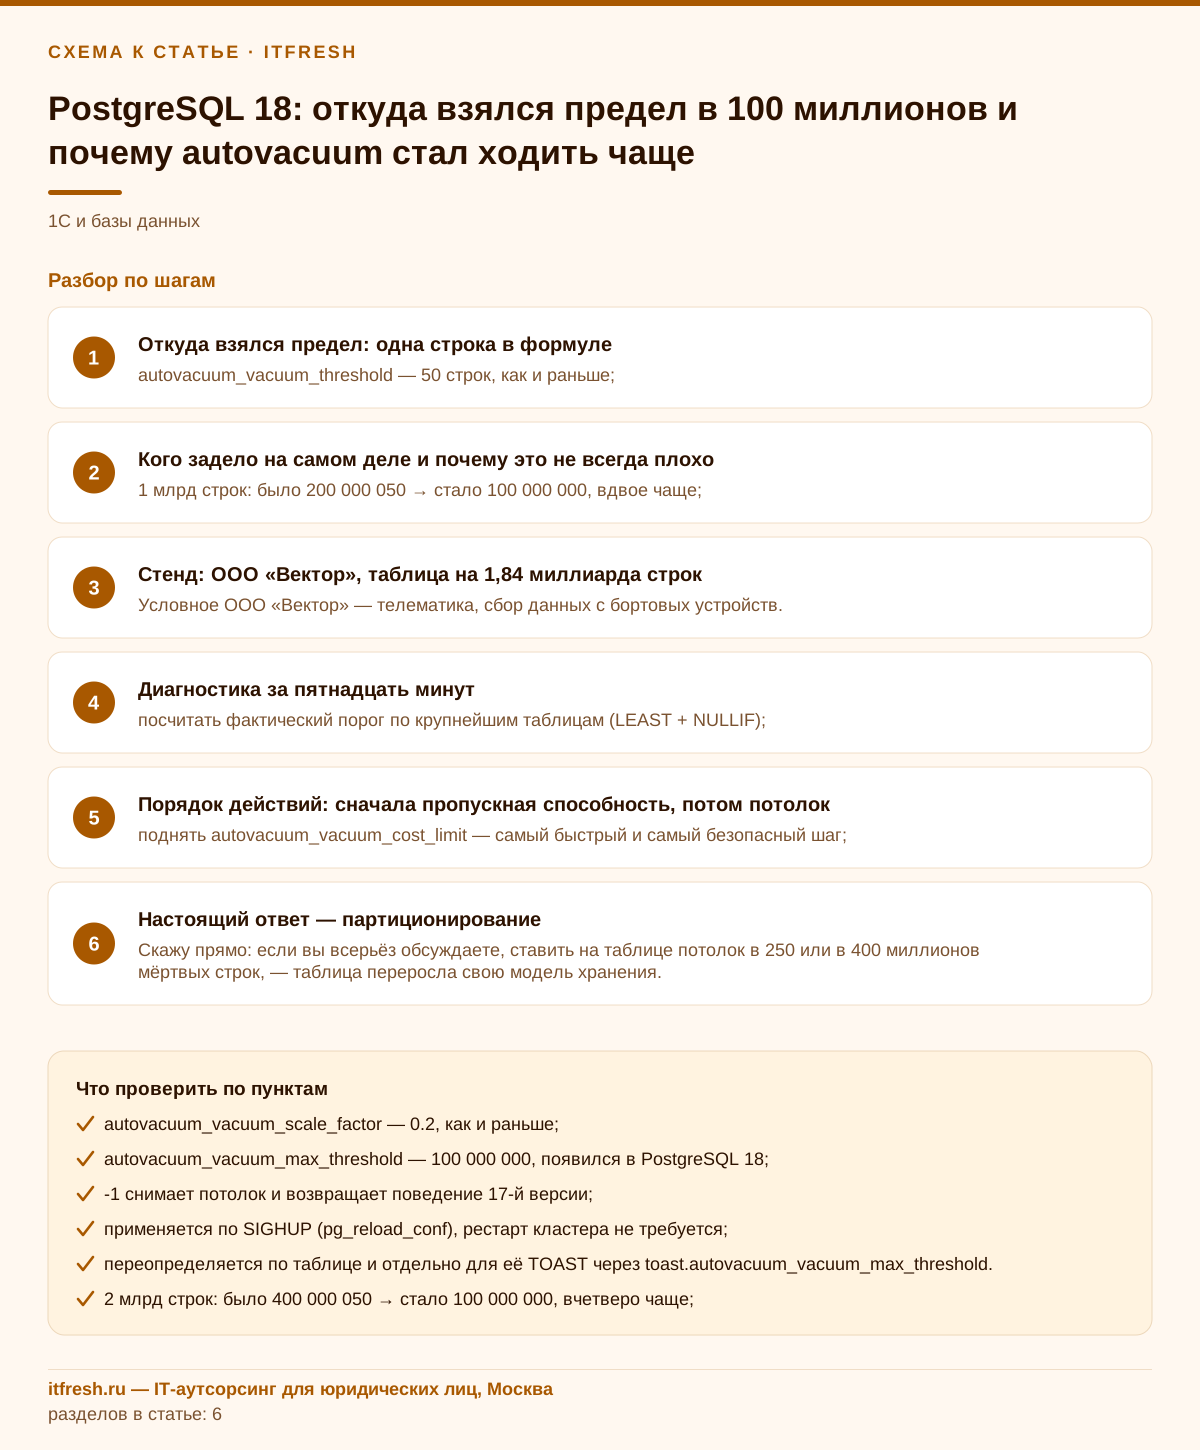
Условная микрофинансовая организация «МикроЗайм Дом»: восемь рабочих мест, учёт в 1С на PostgreSQL, плюс сайт онлайн-заявок со своей базой на том же сервере. Одна потоковая реплика для резерва, диски NVMe, обновление с 17.11 на 18.6 через pg_upgrade --link в ночное окно. База 1С — около 60 ГБ, и её самая крупная таблица не дотягивает до 40 миллионов строк. А вот в базе сайта лежит public.loan_events — журнал событий по заявкам и займам: статусы платёжного шлюза, ответы скоринга, SMS-уведомления за пять лет. pg_class.reltuples на момент апгрейда 1 120 000 000, пять индексов, вместе с ними около 480 ГБ. Нагрузка — примерно девять миллионов UPDATE в сутки по статусным полям плюс поток INSERT.
Считаем, что было. Старый порог: 50 + 0,2 × 1 120 000 000 = 224 000 050 мёртвых строк. При девяти миллионах изменений в сутки autovacuum приходил примерно раз в 25 суток и работал около трёх часов. Новый порог: 100 000 000, то есть примерно раз в 11 суток. Расписание сжалось в 2,24 раза — не катастрофа, но заметно.
Дальше — деталь, из-за которой все и запаниковали не в тот момент. Первую неделю после апгрейда было тихо. pg_upgrade в 18-й переносит бо́льшую часть оптимизаторной статистики, но кумулятивную статистику — ту самую, где живут n_dead_tup и n_mod_since_analyze — не переносит. Счётчики обнулились, и autovacuum к большой таблице долго не приходил. Когда пришёл, это совпало с утренним пиком выдачи займов: лаг реплики до 25 секунд, всплески задержек на сайте заявок, ночная выгрузка в бюро кредитных историй стала вылезать за своё окно. Директор, естественно, связал это не с апгрейдом, а с «чем-то, что сломали на сайте».
Что я сделал первым делом — и что советую делать всем. Не полез поднимать потолок. Включил log_autovacuum_min_duration = 0 и track_cost_delay_timing = on, дождался очередного прохода и посмотрел в лог и в pg_stat_progress_vacuum. В 18-й при включённом track_cost_delay_timing autovacuum показывает время, проведённое во сне по cost delay, — очень удобная новая метрика. Оказалось, что больше половины времени прохода по loan_events — это сон. Сервер на NVMe жил с дефолтным vacuum_cost_limit = 200, унаследованным ещё с тех времён, когда база стояла на SATA-дисках.
Итог. Поднял autovacuum_vacuum_cost_limit до 2000, autovacuum_max_workers с 3 до 5 — в 18-й это делается перечитыванием конфига, потому что autovacuum_worker_slots по умолчанию и так 16. Проход по loan_events сократился примерно с трёх часов до 35 минут, лаг реплики в окно очистки упал до 2–4 секунд. И только после этого — компромисс по потолку: на одной этой таблице поставил 150 000 000, чтобы проходы шли примерно раз в 16–17 суток и не гоняли пять индексов слишком часто. Глобальный дефолт не трогал вообще, базу 1С — тоже. Bloat по loan_events за месяц наблюдения не вырос.
-- поднять потолок только для одной таблицы
ALTER TABLE public.loan_events SET (autovacuum_vacuum_max_threshold = 150000000);

-- и для её TOAST-таблицы, если она большая
ALTER TABLE public.loan_events SET (toast.autovacuum_vacuum_max_threshold = 150000000);

-- совсем снять потолок (поведение как в 17)
ALTER TABLE public.loan_events SET (autovacuum_vacuum_max_threshold = -1);

-- вернуться к глобальному значению
ALTER TABLE public.loan_events RESET (autovacuum_vacuum_max_threshold);- loan_events: 1,12 млрд строк, старый порог 224 000 050 → новый 100 000 000;
- частота autovacuum по таблице выросла примерно в 2,2 раза;
- причина «шторма» — дефолтный vacuum_cost_limit = 200, а не сам потолок;
- cost_limit 2000 и 5 воркеров сократили проход примерно с 3 часов до 35 минут;
- табличный потолок 150 000 000 выставлен только на loan_events, база 1С не тронута.
Диагностика за пятнадцать минут
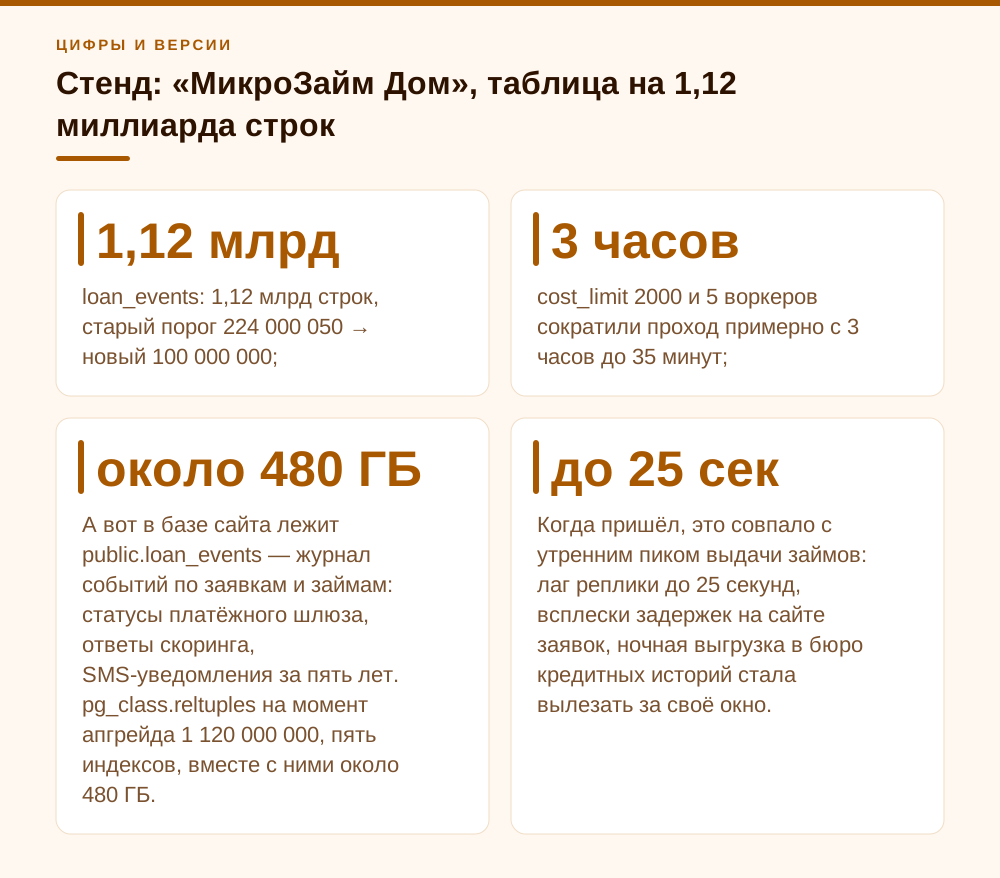
Первый запрос, который я запускаю на любом кластере после обновления на 18, — расчёт фактического порога по каждой крупной таблице. Он сразу показывает, какие объекты перешли под управление нового потолка, а какие живут по старой формуле. Обратите внимание на NULLIF: если вы или ваш предшественник выставили autovacuum_vacuum_max_threshold = -1, наивный LEAST честно выберет минус единицу и запрос начнёт врать. Я на это наступал.
SELECT c.relname,
       c.reltuples::bigint AS rows_est,
       s.n_dead_tup,
       LEAST(
         NULLIF(current_setting('autovacuum_vacuum_max_threshold')::bigint, -1),
         (current_setting('autovacuum_vacuum_threshold')::bigint
          + current_setting('autovacuum_vacuum_scale_factor')::float8 * c.reltuples)::bigint
       ) AS vacuum_threshold,
       s.last_autovacuum
FROM pg_class c
JOIN pg_stat_all_tables s ON s.relid = c.oid
WHERE c.relkind IN ('r','m') AND c.reltuples > 0
ORDER BY c.reltuples DESC
LIMIT 20;
Запрос считает по глобальным значениям и не знает про табличные переопределения, поэтому вторым шагом обязательно смотрим reloptions. У меня был случай, когда админ год назад прописал на «горячей» таблице свой scale_factor 0.01, забыл об этом, а после апгрейда искал причину в новом параметре — которого на этой таблице фактически и не было видно, потому что 1 % от 300 миллионов заведомо меньше потолка.
SELECT relname, reloptions
FROM pg_class
WHERE reloptions IS NOT NULL;
Третий шаг — новые счётчики 18-й версии. В pg_stat_all_tables добавили total_vacuum_time, total_autovacuum_time, total_analyze_time и total_autoanalyze_time. Раньше приходилось собирать длительность из логов, теперь суммарное время обслуживания лежит прямо в системном представлении. Это лучший способ за минуту понять, какая таблица съедает бюджет фонового обслуживания.
SELECT relname,
       autovacuum_count,
       round(total_autovacuum_time::numeric / 1000, 1) AS autovac_sec,
       round(total_autoanalyze_time::numeric / 1000, 1) AS autoanalyze_sec,
       n_dead_tup,
       last_autovacuum
FROM pg_stat_all_tables
WHERE autovacuum_count > 0
ORDER BY total_autovacuum_time DESC
LIMIT 15;
Для ежедневного мониторинга удобнее pg_stat_user_tables — то же представление без системных каталогов. Минимальный набор, который я вывожу на график: n_dead_tup, n_live_tup, last_autovacuum и autovacuum_count по топу крупных таблиц. Если n_dead_tup стабильно держится у рассчитанного порога, а last_autovacuum давно не обновлялся — воркеры не успевают или заняты другими таблицами.
SELECT relname, n_live_tup, n_dead_tup,
       round(100.0 * n_dead_tup / NULLIF(n_live_tup + n_dead_tup, 0), 2) AS dead_pct,
       last_autovacuum, autovacuum_count
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
И четвёртое — логирование. На время разбора я всегда ставлю log_autovacuum_min_duration = 0, чтобы видеть каждый проход, и включаю track_cost_delay_timing, чтобы в логе и в pg_stat_progress_vacuum появилось время сна по cost delay. Именно оно обычно и объясняет, почему очистка «идёт вечно» на быстрых дисках. После разбора порог логирования поднимаю обратно до 250ms — иначе на живой базе лог превращается в кашу.
- посчитать фактический порог по крупнейшим таблицам (LEAST + NULLIF);
- проверить reloptions — табличные переопределения перебивают глобальные;
- снять total_autovacuum_time из pg_stat_all_tables, новая колонка в 18;
- включить log_autovacuum_min_duration = 0 и track_cost_delay_timing на время разбора;
- посмотреть pg_stat_progress_vacuum в момент реального прохода и n_dead_tup/last_autovacuum в pg_stat_user_tables.
Порядок действий: сначала пропускная способность, потом потолок
Соблазн после апгрейда очевиден: прописать autovacuum_vacuum_max_threshold = -1 в postgresql.conf, перечитать конфиг и вернуть привычную жизнь. Так делать можно, это законный откат к поведению 17-й версии, и мир не рухнет. Но я так не делаю почти никогда, потому что вместе с раздражающим симптомом вы выключаете и полезный эффект, а корневая причина — недокормленный autovacuum — остаётся с вами до следующего инцидента.
Мой порядок такой. Первое и главное — скорость очистки. Дефолтный vacuum_cost_limit = 200 при vacuum_cost_delay для autovacuum в 2 мс писался под механические диски. На NVMe я поднимаю autovacuum_vacuum_cost_limit до 1000–3000 и в девяти случаях из десяти на этом проблема закрывается: проходы становятся быстрыми, и их возросшая частота перестаёт быть заметной. Дальше — параллелизм. В 18-й появился autovacuum_worker_slots — пул слотов, резервируемых при старте (по умолчанию обычно 16), и autovacuum_max_workers теперь меняется перечитыванием конфига в пределах этого пула, без рестарта. Это отдельный подарок: раньше добавить воркеров на боевой базе означало окно обслуживания.
Второе — maintenance_work_mem. Начиная с 17-й версии хранилище мёртвых TID перешло на компактную структуру и перестало упираться в жёсткий гигабайтный лимит, так что многопроходность по индексам стала редкостью. Но память всё равно нужна: 1–2 ГБ на воркер для больших таблиц — разумный старт, если оперативки в сервере хватает.
Третье, и только третье — потолок. И почти всегда точечно, по конкретной таблице, а не глобально. Глобальная правка бьёт по всей базе, включая таблицы, которым новый дефолт объективно на пользу. Табличная — документирована, видна в reloptions и не забудется через полгода. Если уж пришлось выключать потолок целиком, я выключаю его на одной таблице значением -1, а не на всём кластере.
# ориентиры для NVMe-кластера под нагрузкой
autovacuum_vacuum_cost_limit = 2000   # дефолт -1 → берётся vacuum_cost_limit = 200
autovacuum_vacuum_cost_delay = 2ms    # дефолт, обычно не трогаю
autovacuum_worker_slots = 16          # новое в 18, дефолт обычно 16; меняется только рестартом
autovacuum_max_workers = 6            # в 18 меняется по reload, в пределах worker_slots
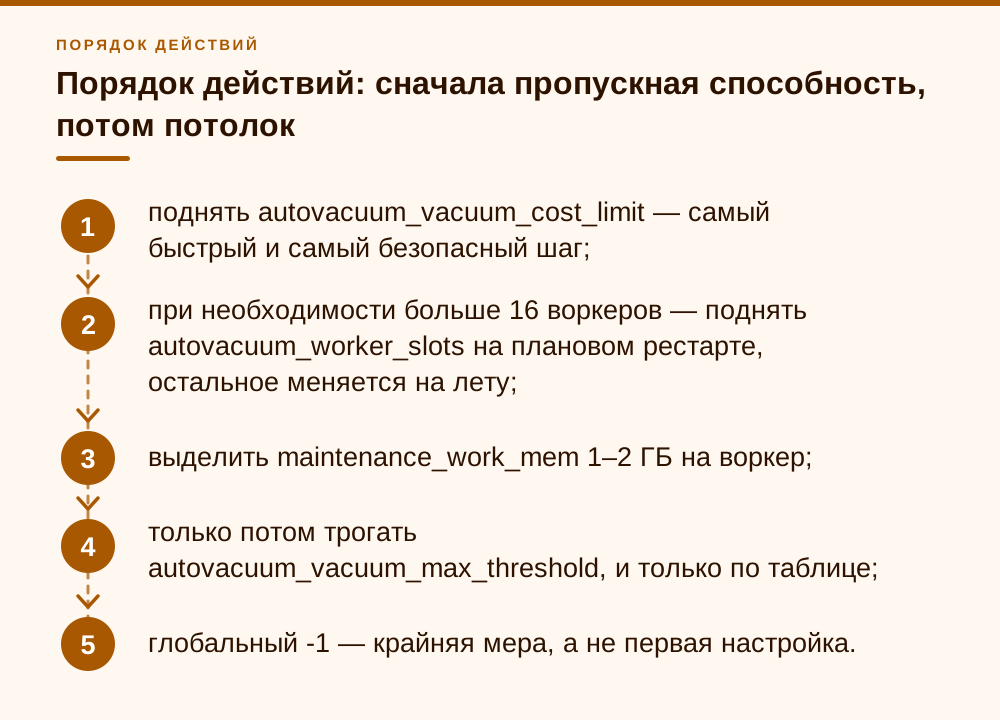
maintenance_work_mem = 2GB- поднять autovacuum_vacuum_cost_limit — самый быстрый и самый безопасный шаг;
- при необходимости больше 16 воркеров — поднять autovacuum_worker_slots на плановом рестарте, остальное меняется на лету;
- выделить maintenance_work_mem 1–2 ГБ на воркер;
- только потом трогать autovacuum_vacuum_max_threshold, и только по таблице;
- глобальный -1 — крайняя мера, а не первая настройка.
Настоящий ответ — партиционирование
Скажу прямо: если вы всерьёз обсуждаете, ставить на таблице потолок в 250 или в 400 миллионов мёртвых строк, — таблица переросла свою модель хранения. Сам факт этого разговора означает, что событийный или журнальный поток лежит одной кучей на несколько миллиардов записей. Потолок autovacuum тут — обезболивающее, а лечение называется секционированием по времени.
Разница в том, что при партиционировании удаление старых данных перестаёт быть операцией DELETE. Вы делаете DROP TABLE на месячную секцию — и мёртвых строк не появляется вообще, чистить нечего, autovacuum к этому объекту больше не приходит. Живые секции при этом на порядок меньше, попадают под старую процентную формулу, и весь вопрос с потолком снимается сам собой. У «МикроЗайм Дом» это следующий этап работ, расписанный на осень: перевести loan_events базы сайта на помесячные секции, а данные старше срока хранения, установленного внутренними правилами организации, выносить в архив целыми секциями. С базой 1С так не выйдет: схемой там управляет платформа, и объём регистров сокращают средствами самой конфигурации — свёрткой базы или удалением устаревших записей.
Пара технических моментов, о которые спотыкаются при переезде. Autovacuum не обрабатывает саму партиционированную таблицу — он работает только с листовыми секциями. Storage-параметры на родительскую таблицу поставить нельзя, документация говорит об этом прямо: указывайте их на отдельных листовых секциях. То есть ваш ALTER TABLE parent SET (autovacuum_vacuum_max_threshold = ...) закончится ошибкой, и это не баг.
Зато в 18-й появилась приятная мелочь для родительских таблиц — ONLY у VACUUM и ANALYZE. Раньше, чтобы обновить статистику на самой партиционированной таблице, приходилось запускать ANALYZE, который тянул за собой все секции. Теперь можно обработать только родителя. Обратите внимание на синтаксис: ONLY пишется перед именем таблицы, а не внутри скобок с опциями.
-- статистика только по родительской таблице, без обхода секций
ANALYZE ONLY public.loan_events;

-- то же вместе с VACUUM
VACUUM (ANALYZE) ONLY public.loan_events;- DROP TABLE или DETACH PARTITION на старой секции вместо массового DELETE — мёртвых строк не остаётся;
- живые секции небольшие и чистятся по обычной процентной формуле;
- storage-параметры autovacuum задаются на листовых секциях, не на родителе;
- статистику родителя обновляйте через ANALYZE ONLY — autovacuum её сам не соберёт;
- таблицы 1С не секционируются вручную: объём там сокращают средствами конфигурации.
Грабли, чек-лист и что делать дальше
Первая и самая частая: -1 путают с выключением autovacuum. Нет. Минус единица в autovacuum_vacuum_max_threshold отключает только верхнее ограничение — процентная формула продолжает работать, autovacuum продолжает ходить. Выключается очистка совсем другими вещами: параметром autovacuum или табличным autovacuum_enabled = false. И вот этого делать не надо никогда: даже с выключенным autovacuum_enabled таблица всё равно будет принудительно очищена при достижении autovacuum_freeze_max_age, только придёт это в самый неподходящий момент и в агрессивном режиме.
Вторая: забывают про TOAST. Если у таблицы есть длинные текстовые или jsonb-поля, её TOAST-таблица может быть больше основной кучи, а порог для неё считается отдельно. Правило простое: если табличный параметр задан, а его toast.-аналог нет, TOAST наследует значение основной таблицы. Но если вы правите потолок только на TOAST или только на куче — проверьте, что получили именно то, что хотели.
Третья: доверяют reltuples вслепую. Порог считается по pg_class.reltuples, а это оценка, обновляемая при VACUUM и ANALYZE. После pg_upgrade оптимизаторная статистика в 18-й переносится, но не вся: не переносятся расширенная статистика из CREATE STATISTICS, статистика расширений и кумулятивная статистика. Мануал прямо предписывает после апгрейда прогнать vacuumdb --all --analyze-in-stages --missing-stats-only, а затем vacuumdb --all --analyze-only. Пропустите второй шаг — и autovacuum будет считать пороги от кривых цифр.
Четвёртая: правят конфиг и ждут рестарта. autovacuum_vacuum_max_threshold перечитывается без перезапуска, достаточно pg_reload_conf(). autovacuum_max_workers в 18-й тоже меняется перечитыванием, но реально работает только в пределах autovacuum_worker_slots: если выставить воркеров больше, чем слотов, лишние просто не запустятся. Сам же autovacuum_worker_slots меняется только рестартом — если планируете больше 16 воркеров, заложите это в ближайшее плановое окно.
Пятая, тонкая: путают порог по изменениям с порогом по вставкам. autovacuum_vacuum_max_threshold ограничивает только ветку «изменённые и удалённые строки». Вставочная ветка живёт по своей формуле, и в 18-й она тоже поменялась — теперь в расчёт входит доля незамороженных страниц через pg_class.relallfrozen и relpages. Если ваша большая таблица растёт в основном на INSERT, всплеск autovacuum после апгрейда мог прийти как раз оттуда, а не от нового потолка. Я на этом однажды потерял полдня, копая не в ту сторону.
Сведу всё в последовательность, по которой я прохожу любой кластер после апгрейда. Занимает она полчаса и снимает девяносто процентов вопросов к autovacuum, которые всплывут через неделю в виде тикета «база тормозит по ночам».
Отдельно про измерения. До 18-й версии, чтобы понять цену фонового обслуживания, надо было парсить логи. Теперь есть total_autovacuum_time и total_autoanalyze_time в pg_stat_all_tables, есть время сна по cost delay в pg_stat_progress_vacuum при включённом track_cost_delay_timing и ANALYZE VERBOSE, который в 18-й научился выводить статистику по WAL, CPU и среднему чтению, как давно умел VACUUM VERBOSE. Заведите на это график в мониторинге сразу — потом будет с чем сравнивать.
И последнее, что я говорю клиентам почти дословно. Новый потолок — это не регрессия и не «сломали autovacuum». Это признание того, что процентная модель плохо масштабируется на миллиарды строк. Если он вас задел, значит, у вас есть таблица, к которой давно пора было подойти с секционированием. Потолок просто сделал этот разговор неизбежным.
- посчитать reltuples по топ-20 таблиц и найти те, что больше 500 млн строк;
- для них посчитать фактический порог и сравнить со старым;
- проверить reloptions на предмет унаследованных переопределений;
- прогнать vacuumdb --all --analyze-in-stages --missing-stats-only, затем --analyze-only;
- поднять autovacuum_vacuum_cost_limit под реальные диски;
- проверить autovacuum_worker_slots и при необходимости поднять его на плановом рестарте;
- включить track_cost_delay_timing и завести график total_autovacuum_time;
- потолок править точечно и только после всего перечисленного.
Частые вопросы
Я не менял autovacuum_vacuum_scale_factor. Почему после обновления на 18 очистка идёт чаще?
Потому что изменилась формула, а не ваши настройки. В PostgreSQL 18 расчётный порог обёрнут в минимум с новым параметром autovacuum_vacuum_max_threshold, значение по умолчанию — 100 000 000. Для таблиц крупнее примерно полумиллиарда строк побеждает именно потолок, а не прежние 20 процентов от размера.
С какого размера таблицы новый предел вообще начинает работать?
С момента, когда 50 + 0,2 × reltuples превышает 100 000 000, то есть примерно с 500 миллионов строк при дефолтных настройках. Всё, что меньше, живёт ровно по старой формуле, и никаких изменений в расписании autovacuum там нет.
Значение -1 выключает autovacuum?
Нет. -1 снимает только верхнюю границу и возвращает поведение PostgreSQL 17: порог снова считается как threshold + scale_factor × reltuples без ограничения сверху. Сам autovacuum продолжает работать. Отключается он параметром autovacuum или табличным autovacuum_enabled = false, и делать этого на боевой базе не стоит.
Как поменять предел только для одной таблицы?
Через storage parameters: ALTER TABLE schema.table SET (autovacuum_vacuum_max_threshold = 250000000). Для TOAST-таблицы есть отдельный toast.autovacuum_vacuum_max_threshold. Вернуть глобальное значение — RESET. На партиционированной родительской таблице эти параметры не поддерживаются, только на листовых секциях.
Нужен ли рестарт сервера после изменения этого параметра?
Нет, достаточно перечитать конфигурацию: SELECT pg_reload_conf() или systemctl reload. autovacuum_max_workers в 18-й тоже меняется без рестарта, но в пределах autovacuum_worker_slots (по умолчанию обычно 16). Рестарт нужен только для изменения самого autovacuum_worker_slots.
Что делать в первую очередь, если после апгрейда выросла нагрузка на диски?
Не откатывать потолок, а сначала измерить. Включите log_autovacuum_min_duration = 0 и track_cost_delay_timing, посмотрите долю времени сна по cost delay и колонку total_autovacuum_time в pg_stat_all_tables. В большинстве случаев проблема не в частоте проходов, а в дефолтном vacuum_cost_limit = 200, который душит очистку на быстрых дисках.
Касается ли новый потолок баз 1С на PostgreSQL?
Как правило, нет. В базах 1С небольших компаний даже крупнейшие регистры редко превышают сотню миллионов строк, а потолок начинает действовать примерно с 500 миллионов при дефолтных настройках. Проверить свою базу можно запросом по pg_class.reltuples. Если табличные параметры на таблицах 1С всё же выставлялись, перепроверяйте их после обновлений конфигурации: реструктуризация может пересоздать таблицу.
Источники
- PostgreSQL 18 Documentation — Automatic Vacuuming — Раздел 20.10 «Automatic Vacuuming», описания autovacuum_vacuum_max_threshold (default 100000000, -1 disables), autovacuum_vacuum_threshold (50), autovacuum_vacuum_scale_factor (0.2), autovacuum_worker_slots, autovacuum_max_workers, vacuum_cost_limit/delay. https://www.postgresql.org/docs/18/runtime-config-vacuum.html
- PostgreSQL 18 Documentation — Routine Vacuuming — Раздел 24.1.6 «The Autovacuum Daemon», формула vacuum threshold = Minimum(vacuum max threshold, vacuum base threshold + vacuum scale factor * number of tuples), вставочная формула с relallfrozen/relpages, поведение при autovacuum_freeze_max_age. https://www.postgresql.org/docs/18/routine-vacuuming.html
- PostgreSQL 18 Documentation — CREATE TABLE, Storage Parameters — Перечень табличных storage parameters, включая autovacuum_vacuum_max_threshold и его toast.-вариант, и прямое указание, что задавать их на партиционированных таблицах нельзя — только на листовых секциях. https://www.postgresql.org/docs/18/sql-createtable.html
- PostgreSQL 18 Release Notes — Пункты о новых autovacuum_vacuum_max_threshold (Nathan Bossart, Frédéric Yhuel), autovacuum_worker_slots и runtime-изменении autovacuum_max_workers, vacuum_max_eager_freeze_failure_rate, ONLY для VACUUM/ANALYZE по партиционированным таблицам, vacuumdb --missing-stats-only, колонках total_vacuum_time / total_autovacuum_time в pg_stat_all_tables и track_cost_delay_timing. Первый релиз 18 — 25 сентября 2025. https://www.postgresql.org/docs/18/release-18.html
- PostgreSQL 18 Documentation — pg_upgrade — Про перенос оптимизаторной статистики, опцию --no-statistics и предписанный порядок восстановления: vacuumdb --all --analyze-in-stages --missing-stats-only, затем vacuumdb --all --analyze-only. https://www.postgresql.org/docs/18/pgupgrade.html
- pgsql-hackers: Re: New GUC autovacuum_max_threshold? — Обсуждение мотивации «жёсткого потолка», выбора значения по умолчанию 100000000 и семантики -1 (отключение максимального порога). https://www.postgresql.org/message-id/Z6EeM0CNKJlxhAYb%40nathan
- PostgreSQL Versioning Policy — Поддерживаемые ветки и текущие минорные релизы: на август 2026 актуальна 18.6 (выпущена 13 августа 2026 вместе с 17.11). https://www.postgresql.org/support/versioning/