
Поднял proxy_read_timeout до 300 секунд, а PHP-отчёт всё равно рвётся на 60-й: какой тайм-аут на самом деле управляет PHP-FPM
Знакомая сцена: бухгалтерия жмёт «Выгрузить отчёт», ровно через минуту в браузере 504 Gateway Time-out. Админ идёт в nginx.conf, ставит proxy_read_timeout 300s, перезапускает — и получает тот же 504 на той же 60-й секунде. Дальше цифру поднимают до 600, до 3600, дописывают proxy_connect_timeout и proxy_send_timeout, и ничего не меняется. Разбираю, почему так, какие тайм-ауты реально управляют связкой nginx + PHP-FPM, в каком порядке их выставлять, как за пять минут по логам понять, кто именно оборвал запрос, и почему самый надёжный способ починить тайм-аут — перестать держать HTTP-соединение полчаса.
proxy_read_timeout не имеет к PHP-FPM никакого отношения
В nginx директивы принадлежат модулям, а модуль выбирается тем, каким *_pass заканчивается ваш location. proxy_read_timeout живёт в ngx_http_proxy_module — модуле, который, по формулировке документации, «allows passing requests to another server», то есть проксирует по HTTP/HTTPS на другой сервер. PHP-FPM говорит не по HTTP, а по протоколу FastCGI, и обслуживает его ngx_http_fastcgi_module со своим отдельным набором директив: fastcgi_connect_timeout, fastcgi_send_timeout, fastcgi_read_timeout. Пересечений между наборами нет. Написали proxy_read_timeout 300s; в location с fastcgi_pass — вы написали строку, которую nginx разберёт, примет, но применять будет не к этому обработчику.
Коварство именно в этом: строка синтаксически валидна в контекстах http, server и location, поэтому nginx -t бодро отвечает «syntax is ok, test is successful», конфиг перечитывается без единого предупреждения, и у человека складывается ощущение, что настройка применена. Она применена — просто ни на что не влияет. Я видел конфиги, где в http-блоке лежало пять proxy-директив с тайм-аутами по часу, а во всём развёрнутом конфиге не было ни одного proxy_pass. Неделя переписки с подрядчиком ушла в никуда.
Откуда берётся путаница. Во-первых, из двухслойных схем: когда перед PHP-хостом стоит фронтовой nginx или балансировщик, на фронте proxy_read_timeout абсолютно уместен — и человек, найдя решение для фронта, тащит его на бэкенд. Во-вторых, из статей про Node.js, Python и Go: там приложение действительно за proxy_pass, и вся выдача поисковика по запросу «nginx timeout» состоит из proxy-директив. В-третьих, из копипасты в панелях хостинга. Проверяется всё за десять секунд:
# чем реально обслуживается динамика
grep -rnE 'fastcgi_pass|proxy_pass|uwsgi_pass|scgi_pass|grpc_pass' /etc/nginx/ | grep -v '#'

# что применилось по факту, со всеми include
nginx -T 2>/dev/null | grep -nE 'fastcgi_pass|fastcgi_read_timeout|proxy_read_timeout|send_timeout'
nginx -T (заглавная T) печатает итоговый развёрнутый конфиг — единственный честный способ узнать, что реально видит демон, а не что вы думаете, что вы написали. Если в выводе есть fastcgi_pass, а рядом только proxy-тайм-ауты — вы нашли причину, не читая дальше.
- `fastcgi_pass` (PHP-FPM) → директивы `fastcgi_*`
- `proxy_pass` (HTTP-бэкенд, Node, gunicorn, второй nginx) → `proxy_*`
- `uwsgi_pass` (uWSGI) → `uwsgi_*`
- `scgi_pass` → `scgi_*`, `grpc_pass` → `grpc_*`
- `send_timeout` и `client_body_timeout` — из core-модуля, они про общение с клиентом, а не с бэкендом
Четыре тайм-аута в цепочке и кто из них выстрелит первым
Между кнопкой в браузере и строкой в базе стоит цепочка: клиент → (иногда CDN или облачный WAF) → nginx → unix-сокет или TCP до FPM → воркер PHP → MySQL. У каждого звена свои часы, и они друг о друге не знают. Обрывает тот, кто досчитал первым, а код ошибки, который увидит пользователь, зависит от того, кто именно это сделал. Пока вы не разложили все четыре счётчика по полочкам, вы будете крутить случайные цифры.
Сторона nginx, всё по документации ngx_http_fastcgi_module: fastcgi_connect_timeout — по умолчанию 60s, время на установление соединения с FastCGI-сервером, причём в мануале отдельно оговорено, что этот тайм-аут обычно не может превышать 75 секунд. fastcgi_send_timeout — 60s, ограничивает интервал между двумя последовательными операциями записи при передаче запроса. fastcgi_read_timeout — 60s, ограничивает интервал между двумя последовательными операциями чтения ответа. Все три разрешены в контекстах http, server и location. Плюс send_timeout 60s из core-модуля — это уже про отдачу ответа клиенту, к FPM он отношения не имеет, но регулярно виноват в обрывах больших выгрузок на медленных каналах.
Сторона PHP-FPM, файл пула (обычно /etc/php/8.3/fpm/pool.d/www.conf): request_terminate_timeout — по умолчанию 0, то есть выключен. Документация формулирует его назначение прямо: «тайм-аут обслуживания одного запроса, после которого рабочий процесс будет убит», и «эта опция должна использоваться, когда ini-опция max_execution_time по каким-то причинам не останавливает выполнение скрипта». Проблема в том, что дистрибутивные сборки, панели управления и «оптимизации от предыдущего админа» очень любят поставить туда 120 или 300 секунд — и этот лимит выстрелит раньше вашего щедрого nginx.
Сторона PHP, php.ini: max_execution_time — по умолчанию 30 (в CLI — 0). И тут ключевой нюанс, который объясняет всё остальное. В мануале написано: «On non Windows systems, the maximum execution time is not affected by system calls, stream operations etc.». На Linux ожидание ответа MySQL, curl, чтение по сети в счётчик не идут. Скрипт с max_execution_time = 30 спокойно живёт двадцать минут, если девятнадцать из них он ждёт базу. Именно поэтому request_terminate_timeout вообще существует — он считает настенное время и режет по-настоящему.
- `fastcgi_connect_timeout` — 60s, коннект к FPM (для живого unix-сокета не срабатывает практически никогда)
- `fastcgi_send_timeout` — 60s, интервал между записями при передаче запроса
- `fastcgi_read_timeout` — 60s, интервал между чтениями ответа — тот самый виновник 504
- `request_terminate_timeout` — 0 (off) по умолчанию, но в реальных пулах часто 120–300s
- `max_execution_time` — 30, но на Linux не считает время в системных вызовах
- `send_timeout` — 60s, отдача ответа клиенту
«Только между двумя чтениями» — почему 60 секунд иногда хватает на три часа
Самая дорогая ошибка понимания звучит так: «fastcgi_read_timeout — это сколько всего разрешено выполняться скрипту». Нет. Документация формулирует это однозначно: «The timeout is set only between two successive read operations, not for the transmission of the whole response. If the FastCGI server does not transmit anything within this time, the connection is closed». Это не бюджет на запрос, это таймер бездействия. Каждый полученный байт обнуляет его заново.
Отсюда два следствия, которые на практике выглядят как мистика. Первое: скрипт, который каждые десять секунд что-то отдаёт в поток, при fastcgi_read_timeout 60s проживёт хоть три часа — и вы никогда не увидите 504. Второе: скрипт, который молча считает 61 секунду, а потом отдаёт готовый XLSX за 0,2 секунды, будет убит — хотя «время передачи ответа» у него мизерное. Классический отчёт «собрал всё в память → отдал одним куском» — худший из возможных сценариев для дефолтных значений. И это же объясняет, почему у соседа с такой же конфигурацией «всё работает»: у него приложение болтливое, у вас — молчаливое.
Но есть ловушка: flush() в PHP не равен байтам на проводе. Между вашим echo и сокетом nginx стоит как минимум четыре буфера — output_buffering из php.ini (в дистрибутивных сборках обычно 4096), собственный ob_start() фреймворка, буферизация ответа в nginx (fastcgi_buffering on по умолчанию) и gzip. Если хотите держать соединение живым потоком, буферизацию надо снимать на всём пути, а не только в PHP.
<?php
header('X-Accel-Buffering: no');   // документированный способ выключить буферизацию nginx для этого ответа
header('Content-Type: text/csv; charset=utf-8');
while ($row = $stmt->fetch()) {
    echo implode(';', $row), "\n";
    if (function_exists('ob_get_level') && ob_get_level() > 0) { ob_flush(); }
    flush();
}
Заголовок X-Accel-Buffering: no — не хак, он описан в документации fastcgi-модуля наравне с директивой fastcgi_buffering; отключить эту возможность можно через fastcgi_ignore_headers, так что если он не работает — сначала проверьте, не запрещён ли он у вас.
- Долгий, но «болтливый» скрипт дефолтные 60 с не заметит вообще
- Быстрый, но молчаливый скрипт умрёт на 60-й секунде тишины
- `output_buffering`, `ob_start()`, `fastcgi_buffering`, `gzip` — четыре места, где ваш flush может застрять
- Для стриминга: `fastcgi_buffering off` в location либо `X-Accel-Buffering: no` в ответе
Разбор: аптека «Зелёный крест», отчёт по остаткам и три ошибки подряд
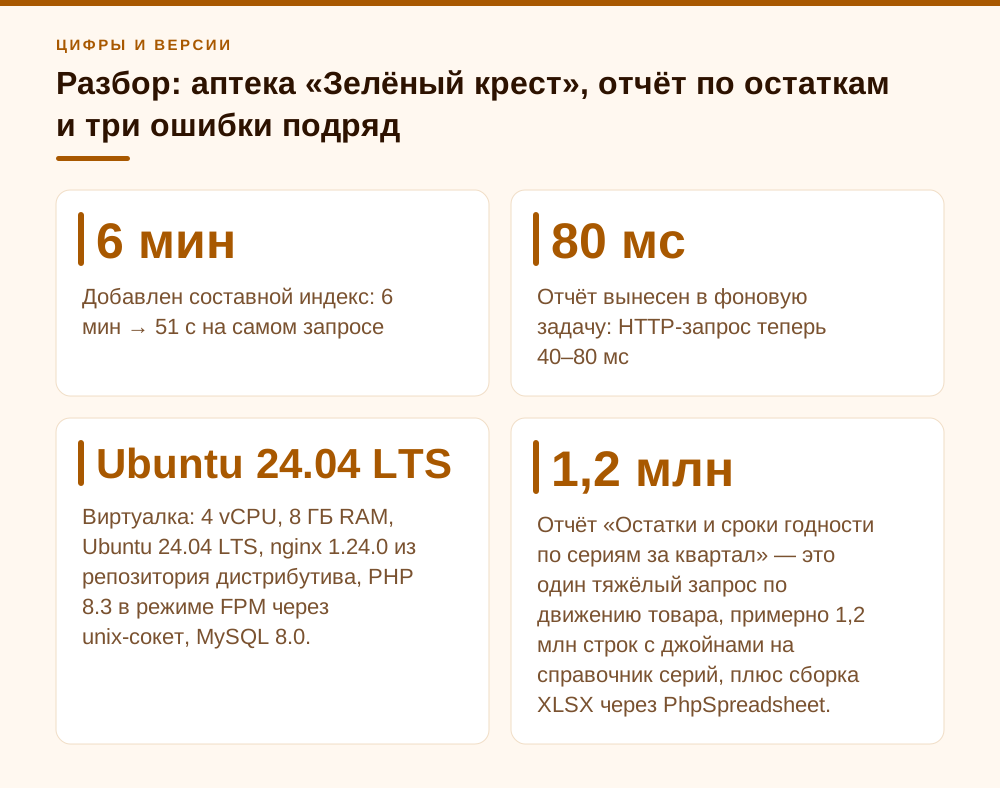
Клиент — аптека «Зелёный крест», 14 рабочих мест: провизоры за кассами, заведующая, бухгалтер и закупщик. Самописная учётная система на PHP, её когда-то написал фрилансер. Виртуалка: 4 vCPU, 8 ГБ RAM, Ubuntu 24.04 LTS, nginx 1.24.0 из репозитория дистрибутива, PHP 8.3 в режиме FPM через unix-сокет, MySQL 8.0. Отчёт «Остатки и сроки годности по сериям за квартал» — это один тяжёлый запрос по движению товара, примерно 1,2 млн строк с джойнами на справочник серий, плюс сборка XLSX через PhpSpreadsheet. Закупщик выгружает его перед каждым заказом у дистрибьютора. Заявка пришла в понедельник: «отчёт не выгружается, минуту крутится и белая страница с 504». До нас в конфиг уже залезали.
Ошибка номер один нашлась в /etc/nginx/nginx.conf: в http-блоке аккуратно, с комментарием «для больших отчётов», стояли proxy_read_timeout 300s;, proxy_send_timeout 300s;, proxy_connect_timeout 300s;. Во всём выводе nginx -T не было ни единого proxy_pass. Смотрим error.log — и там сразу всё написано:
2026/03/11 11:42:07 [error] 1187#1187: *90412 upstream timed out (110: Connection timed out) while reading response header from upstream, client: 10.20.30.14, server: erp.example.local, request: "GET /report/stock.php?q=2026Q1 HTTP/1.1", upstream: "fastcgi://unix:/run/php/php8.3-fpm.sock", host: "erp.example.local"Три вещи в этой строке решают всё: fastcgi:// — значит правим fastcgi_*, а не proxy_*; «while reading response header» — значит ответ вообще не начал приходить, упёрлись в fastcgi_read_timeout; код 110 — это таймер, а не разрыв. Ставлю fastcgi_read_timeout 600s; в location ~ \.php$, перечитываю конфиг — и получаю не победу, а новую ошибку: 502 Bad Gateway ровно на 121-й секунде. Смотрю в /var/log/php8.3-fpm.log:
[11-Mar-2026 11:58:31] WARNING: [pool www] child 21437, script '/var/www/erp/public/report/stock.php' (request: "GET /report/stock.php") execution timed out (120.418613 sec), terminating
[11-Mar-2026 11:58:31] WARNING: [pool www] child 21437 exited on signal 15 (SIGTERM) after 4471.882 seconds from start
Ошибка номер два: в pool.d/www.conf лежал request_terminate_timeout = 120s, поставленный когда-то, чтобы «зависшие скрипты не ели память». nginx в этот момент честно писал у себя recv() failed (104: Connection reset by peer) while reading response header from upstream — то есть соединение оборвал не он. Поднял лимит до 630s, отчёт дошёл до конца за 7 минут 12 секунд. Ошибка номер три была скорее ловушкой для меня: max_execution_time в php.ini так и остался 30, и это ничего не сломало — шесть из семи минут скрипт ждал MySQL, а системное время на Linux в лимит не входит. Я всё равно выставил его явно через php_admin_value в пуле, чтобы поведение не зависело от сборки PHP. В мануале прямо сказано, что с --enable-zend-max-execution-timers (для ZTS-сборок это дефолт начиная с PHP 8.3.0) лимит считает прошедшее время, и ожидание ввода-вывода в него уже входит. Если обновление PHP вдруг начало ронять отчёты на 30-й секунде, проверьте, как собран новый PHP.
Чем закончилось. Через две недели отчёт переехал в очередь: кнопка возвращает 202 и идентификатор задания, воркер под supervisord собирает файл в фоне, закупщик получает ссылку на готовый XLSX. Время ответа веб-запроса — 40–80 мс, тайм-ауты я вернул к 120 секундам, request_terminate_timeout для основного пула — к 180. Параллельно нашёлся недостающий составной индекс по товару, серии и дате, после которого сам запрос стал отрабатывать за 51 секунду вместо 6 минут. Забавный итог: самый устойчивый способ починить тайм-аут — перестать держать HTTP-соединение открытым полчаса.
- `proxy_*` тайм-ауты удалены как мусор — они не работали ни дня
- `fastcgi_read_timeout 600s` — только в location для PHP, не глобально
- `request_terminate_timeout` 120s → 630s, потом обратно 180s после переезда на очередь
- `max_execution_time` задан явно в пуле, а не оставлен на волю php.ini
- Добавлен составной индекс: 6 мин → 51 с на самом запросе
- Отчёт вынесен в фоновую задачу: HTTP-запрос теперь 40–80 мс
Как я это настраиваю: конфиг, который переживёт следующий отчёт
Правило простое: тайм-ауты растут снизу вверх по стеку. Я хочу, чтобы первым сработал самый «умный» уровень — сам PHP: он оставит запись в error_log с файлом и строкой, отработает shutdown-функции, вернёт внятную 500-ку. Следом — FPM, который хотя бы напишет в лог имя скрипта и текст запроса. nginx — последняя страховка; если сработал он, значит контекст вы потеряли и разбираться будете по косвенным признакам.
location ~ ^/report/ {
    include                 fastcgi_params;
    fastcgi_pass            unix:/run/php/php8.3-fpm-reports.sock;
    fastcgi_param           SCRIPT_FILENAME $document_root$fastcgi_script_name;

    fastcgi_connect_timeout 5s;     # сокет либо есть, либо нет — ждать нечего
    fastcgi_send_timeout    60s;
    fastcgi_read_timeout    660s;   # последняя страховка, выше лимита FPM

    fastcgi_buffering       on;     # off — только если реально стримите
    send_timeout            120s;   # отдача готового файла клиенту
}

location ~ \.php$ {
    include                 fastcgi_params;
    fastcgi_pass            unix:/run/php/php8.3-fpm.sock;
    fastcgi_param           SCRIPT_FILENAME $document_root$fastcgi_script_name;
    fastcgi_read_timeout    60s;    # остальной сайт живёт с дефолтом
}
И соответствующий отдельный пул для отчётов — /etc/php/8.3/fpm/pool.d/reports.conf. Отдельный пул тут не роскошь, а способ не дать закупщику, бухгалтеру и заведующей с их отчётами занять все воркеры, пока провизоры пробивают чеки через тот же бэкенд. Ниже пул целиком:
[reports]
user = www-data
group = www-data
listen = /run/php/php8.3-fpm-reports.sock
listen.owner = www-data
listen.group = www-data

pm = ondemand
pm.max_children = 4
pm.process_idle_timeout = 30s

request_terminate_timeout = 630s
request_terminate_timeout_track_finished = yes
request_slowlog_timeout = 30s
slowlog = /var/log/php8.3-fpm-reports.slow.log
catch_workers_output = yes

php_admin_value[max_execution_time] = 600
php_admin_value[memory_limit] = 1024M
Здесь стоит объяснить request_terminate_timeout_track_finished = yes (доступен с PHP 7.3). По умолчанию лимит не действует после вызова fastcgi_finish_request() и во время shutdown-функций — то есть скрипт, который «отдал ответ и пошёл дальше работать», формально бессмертен. Если у вас фреймворк активно пользуется fastcgi_finish_request(), а воркеры почему-то висят вечно — вот ваша причина. Флаг включает лимит безусловно.
Теперь честно о спорном. Схема «PHP < FPM < nginx» не гарантирована математически: fastcgi_read_timeout считает паузу между чтениями, а не общее время, поэтому теоретически возможен сценарий, где молчащий скрипт упрётся в nginx раньше своего лимита. Поэтому запас я держу не символический, а процентов десять сверху. Второй спорный момент: часть коллег делает ровно наоборот — ставит nginx строже FPM, чтобы быстрее освобождать соединения и не копить клиентов. Логика в этом есть, но вы теряете причину в логах, а PHP-воркер всё равно продолжает молотить базу до собственного лимита — то есть ресурс вы не экономите, а диагностику ломаете. Я выбираю читаемые логи.
- `max_execution_time` (600) < `request_terminate_timeout` (630) < `fastcgi_read_timeout` (660)
- Тайм-ауты — только в конкретном location, никогда в http-блоке «на всякий случай»
- `fastcgi_connect_timeout` для локального сокета — 5 секунд, не 60
- Отдельный пул `ondemand` с малым `pm.max_children` под тяжёлые страницы
- `request_slowlog_timeout` + `slowlog` включены сразу, а не после инцидента
Диагностика за пять минут: читаем логи правильно
Порядок всегда один: сначала error.log nginx — он говорит, кто оборвал; потом php-fpm.log — он говорит, что именно оборвали; потом slowlog — он говорит, где скрипт стоял. Формулировка в логе nginx различает случаи гораздо точнее, чем принято думать, и по одной строке видно направление раскопок.
Дальше идём в лог FPM. Ключевые маркеры: execution timed out (NNN sec), terminating — сработал request_terminate_timeout; exited on signal 15 — тот самый SIGTERM от этого лимита; exited on signal 11 — segfault, тайм-ауты ни при чём, смотрите расширения и стек; exited on signal 9 — почти всегда OOM-killer, проверяйте dmesg -T | grep -i -E 'oom|killed process'; server reached pm.max_children setting — у вас не проблема тайм-аутов вообще, у вас очередь запросов, и все ваши 504 растут из ожидания свободного воркера.
Про очередь стоит сказать отдельно, потому что её часто принимают за медленный скрипт. pm.max_children — это, по документации, предел одновременно обслуживаемых запросов. Когда все воркеры заняты, новое соединение от nginx к сокету всё равно устанавливается: оно ждёт в очереди listen(), размер которой задаёт listen.backlog (по умолчанию 511 на Linux, -1 на FreeBSD и OpenBSD; ядро дополнительно ограничивает его значением net.core.somaxconn). Для nginx соединение уже открыто, поэтому пока запрос стоит в очереди, тикает fastcgi_read_timeout. В итоге вы видите тот же upstream timed out (110) while reading response header, хотя скрипт даже не начинал выполняться. Если переполнится и сама очередь, nginx получит мгновенный отказ на connect и отдаст 502. Посмотреть очередь можно без догадок:
# слушающий сокет: Recv-Q — сколько соединений ждёт accept, Send-Q — размер очереди
ss -xlp | grep php8.3-fpm

# если в пуле включён pm.status_path = /fpm-status (и location для него закрыт от чужих)
curl -s 'http://127.0.0.1/fpm-status' | grep -E 'listen queue|active processes|max children reached'
Живая проверка, которая экономит массу времени, — замер по секундомеру. Ровное число почти всегда означает конфиг, «плавающее» — реальную нагрузку:
curl -o /dev/null -s -w 'code=%{http_code} connect=%{time_connect} ttfb=%{time_starttransfer} total=%{time_total}\n' \
  'https://erp.example.ru/report/stock.php?q=2026Q1'

# кто на самом деле висит и на чём
ps -eo pid,etimes,stat,cmd --sort=-etimes | grep '[p]hp-fpm' | head
ss -x | grep php8.3-fpm.sock | head
Если ttfb ≈ total ≈ 60,0 при коде 504 — это дефолт fastcgi_read_timeout. Если total ≈ 120,0 при коде 502 — это request_terminate_timeout пула. Если total уходит за настроенный вами лимит и код внезапно 524 или 502 от чужого сервера — смотрите, что стоит перед nginx: у облачных прокси и WAF есть собственный потолок ожидания, и он часто оказывается порядка сотни секунд. И, наконец, slowlog: request_slowlog_timeout = 30s заставит FPM сбросить в файл полный PHP-backtrace в тот момент, когда скрипт ещё висит. Это единственный инструмент, который отвечает не на вопрос «сколько», а на вопрос «где» — обычно там оказывается один конкретный запрос в цикле.
- `upstream timed out (110) ... while reading response header from upstream` — истёк `fastcgi_read_timeout`, ответ не начинался. Клиенту 504
- `... while reading upstream` (без слова header) — заголовки пришли, оборвалось тело. Клиент получит обрезанный файл, часто вообще без ошибки в браузере
- `recv() failed (104: Connection reset by peer)` или `upstream prematurely closed connection` — оборвал FPM: тайм-аут пула, segfault или OOM. Клиенту 502
- `client timed out ... while sending to client` — упёрлись в `send_timeout`, виноват канал или клиент
- `connect() to unix:/run/php/...sock failed (2: No such file or directory)` — FPM просто не запущен, тайм-ауты ни при чём
- `connect() to unix:/run/php/...sock failed (11: Resource temporarily unavailable)` — переполнена очередь `listen.backlog`, все `pm.max_children` заняты. Клиенту 502
Куда идти дальше: тайм-аут — это симптом, а не болезнь
Поставить fastcgi_read_timeout 3600s можно, и иногда это правильное тактическое решение на вечер пятницы. Но помните цену: всё это время воркер FPM занят целиком, а их конечное число. Даже в аптеке на 14 рабочих мест три-четыре одновременных отчёта при pm.max_children = 8 занимают половину пула, а при pm.max_children = 4 кладут систему полностью, вместе с кассами. Плюс браузеры, корпоративные прокси, мобильные сети и VPN рвут висящие соединения по собственным правилам, о которых вас никто не спросит. Часовой HTTP-запрос — это не архитектура, это отложенный инцидент.
Мой порядок приоритетов, когда прилетает «отчёт отваливается», выглядит так — и цифры в конфиге в нём стоят последними, а не первыми. Первое, что я делаю, — смотрю план запроса. В восьми случаях из десяти отчёт «внезапно стал долгим» не потому, что данных стало больше, а потому что перестал использоваться индекс или кто-то добавил джойн. Полминуты EXPLAIN экономят день возни с тайм-аутами.
На что можно спокойно забить. Директивы proxy_* в конфиге с одним только FastCGI — просто удалите, они ничего не делают и путают следующего человека. max_input_time при значении -1 берётся из max_execution_time, отдельно его крутить смысла нет. fastcgi_connect_timeout для unix-сокета на том же хосте не сработает почти никогда — если FPM жив, коннект мгновенный, а если мёртв, вы получите не тайм-аут, а сразу ошибку. А вот что проверить обязательно, если перед nginx стоит CDN, облачный WAF или второй балансировщик: их собственный потолок ожидания. Именно там прячется «загадочная минута», которая не лечится ни одной строчкой в вашем конфиге.
- Сначала `EXPLAIN` и индексы — самая дешёвая победа
- Потом вынос тяжёлой задачи из HTTP: очередь, ответ 202 и ссылка на готовый файл
- Если очередь дорого — стриминг ответа с `flush()` и отключённой буферизацией: тогда `fastcgi_read_timeout` перестаёт быть проблемой, а пользователь видит прогресс
- Отдельный пул FPM под отчёты со своими лимитами — самая недооценённая мера из всех
- И только после этого — правка цифр в тайм-аутах
Частые вопросы
Я поставил fastcgi_read_timeout 600s, а 504 всё равно прилетает через 60 секунд. Почему?
Скорее всего директива не применилась к нужному location. Проверьте `nginx -T | grep -n fastcgi_read_timeout` — там видно итоговый конфиг со всеми include; частая причина в том, что правку сделали в одном server-блоке, а запрос попадает в другой, или что более специфичный location (например `location ~ ^/report/`) перекрывает общий `location ~ \.php$` и своего тайм-аута не имеет. Второй вариант — перед nginx стоит CDN, WAF или второй балансировщик со своим потолком ожидания.
Чем отличается 504 от 502 в этой связке?
504 Gateway Time-out nginx выдаёт сам, когда истёк его тайм-аут ожидания FastCGI-сервера — в логе будет `upstream timed out (110: Connection timed out)`. 502 Bad Gateway означает, что соединение оборвал бэкенд: сработал `request_terminate_timeout` пула, воркер упал по segfault или его убил OOM-killer. В логе nginx это выглядит как `recv() failed (104: Connection reset by peer)` или `upstream prematurely closed connection`, а причину надо искать уже в php-fpm.log и в `dmesg`.
Достаточно ли поднять max_execution_time в php.ini?
Как правило нет, и часто эта настройка вообще ни при чём. На Linux `max_execution_time` не учитывает время системных вызовов и потоковых операций — то есть ожидание ответа базы, curl или чтение по сети в него не входят. Скрипт с лимитом 30 секунд может честно работать двадцать минут, если ждёт MySQL. Исключение: сборки с `--enable-zend-max-execution-timers`, для ZTS это дефолт с PHP 8.3.0. Там считается прошедшее время, включая ожидание I/O. Реально режет настенное время `request_terminate_timeout` в пуле FPM, а последний рубеж — `fastcgi_read_timeout` в nginx.
Какие значения ставить, чтобы не гадать?
Я выстраиваю их лесенкой снизу вверх: `max_execution_time` меньше `request_terminate_timeout` меньше `fastcgi_read_timeout`, с запасом порядка 10 % на каждом шаге — например 600 / 630 / 660 секунд. Тогда первым сработает PHP, который оставит внятную запись в логе с именем файла и строкой, а nginx останется страховкой. И всё это — только в отдельном location и отдельном пуле для тяжёлых страниц, никогда не глобально.
Почему у коллеги такой же долгий скрипт работает с дефолтными 60 секундами?
Потому что `fastcgi_read_timeout` — это таймер бездействия, а не бюджет на запрос: он ограничивает интервал между двумя последовательными чтениями ответа, и каждый полученный байт обнуляет отсчёт. Скрипт, который что-то отдаёт в поток каждые десять секунд, проживёт хоть три часа. Ваш отчёт молчит до самого конца — и умирает на 60-й секунде тишины, даже если сама передача файла занимает доли секунды.
Как понять, что дело не в тайм-аутах, а в нехватке воркеров?
Ищите в php-fpm.log строку `server reached pm.max_children setting, consider raising it`. Если она есть, ваши 504 растут не из долгого скрипта, а из очереди: запрос ждёт свободного воркера и не начинает выполняться вовсе. Косвенный признак — время падения плавает, а не стоит на ровном круглом значении. Проверить можно через страницу статуса FPM (`pm.status_path`): поля `listen queue` и `max children reached` показывают, сколько запросов ждёт в очереди `listen.backlog` и сколько раз пул упирался в предел. Лечится это увеличением `pm.max_children` под доступную память и выносом тяжёлых страниц в отдельный пул.
Источники
- nginx: ngx_http_fastcgi_module — Директивы fastcgi_read_timeout (default 60s; context http, server, location; «The timeout is set only between two successive read operations, not for the transmission of the whole response»), fastcgi_send_timeout (60s), fastcgi_connect_timeout (60s, «cannot usually exceed 75 seconds»), fastcgi_buffering (on, с версии 1.5.6) и заголовок X-Accel-Buffering. https://nginx.org/en/docs/http/ngx_http_fastcgi_module.html#fastcgi_read_timeout
- nginx: ngx_http_proxy_module — proxy_read_timeout (default 60s; context http, server, location). Модуль описан как «allows passing requests to another server» по HTTP/HTTPS и к FastCGI-обработчику не применяется. https://nginx.org/en/docs/http/ngx_http_proxy_module.html#proxy_read_timeout
- nginx: ngx_http_core_module — send_timeout (default 60s, отдача ответа клиенту) и client_body_timeout (default 60s, при истечении — 408 Request Time-out). https://nginx.org/en/docs/http/ngx_http_core_module.html#send_timeout
- PHP Manual: Configuring PHP-FPM (php-fpm.conf / pool) — request_terminate_timeout (default 0, «should be used when the max_execution_time ini option does not stop script execution for some reason»), request_terminate_timeout_track_finished (default no, с PHP 7.3.0), request_slowlog_timeout и slowlog, pm.max_children, listen.backlog (default 511 на Linux, -1 на FreeBSD/OpenBSD), pm.status_path, catch_workers_output. Актуально для ветки PHP 8.x. https://www.php.net/manual/en/install.fpm.configuration.php
- PHP Manual: Runtime Configuration — max_execution_time — max_execution_time, default 30 (в CLI — 0): «On non Windows systems, the maximum execution time is not affected by system calls, stream operations etc.»; При сборке с --enable-zend-max-execution-timers (дефолт для ZTS с PHP 8.3.0) учитывается прошедшее время, включая ожидание I/O. max_input_time, default -1 (берётся max_execution_time). https://www.php.net/manual/en/info.configuration.php#ini.max-execution-time