
Пул почти пуст, а ВМ сыплют ошибками записи: как поймать исчерпание метаданных LVM thin до аварии
Если виртуалки на LVM thin ловят ошибки записи при свободных данных, смотрите не Data%, а Meta% и девятый символ lv_attr: метаданные пула закончились раньше места. Ниже: три места, где это видно сразу, почему штатные предупреждения не спасают, готовый скрипт и ключи для Zabbix и разбор случая на 35 рабочих местах.
Почему ВМ получают ошибки записи, если в пуле свободно больше половины
Сценарий, который я вижу регулярно: админ открывает lvs, видит Data% 47, пожимает плечами и начинает искать причину в гостевой ОС, в драйвере диска, в сети. А причина в соседней колонке. Тонкий пул — это не один ресурс, а два: блоки данных и карта метаданных, которая помнит, какой виртуальный блок лежит в каком физическом. Закончиться может любой из них. Если вы строите мониторинг серверов и хранилища и следите только за данными, то пропустите именно тот отказ, который приходит без предупреждающих симптомов.
Что говорит документация. По lvmthin(7), исчерпание метаданных может привести к несогласованным метаданным пула и несогласованным файловым системам, а на тонкие тома начинают возвращаться ошибки ввода-вывода. Документация ядра по thin-provisioning формулирует то же самое жёстче: если метаданные закончились или операция с метаданными не удалась, пул отдаёт ошибки на ввод-вывод, пока его не выведут из работы, а после починки выше по стеку рекомендуется fsck. Для гостя это выглядит как умирающий диск: ошибки записи, файловая система в read-only, зависшая 1С. Железо при этом абсолютно здорово.
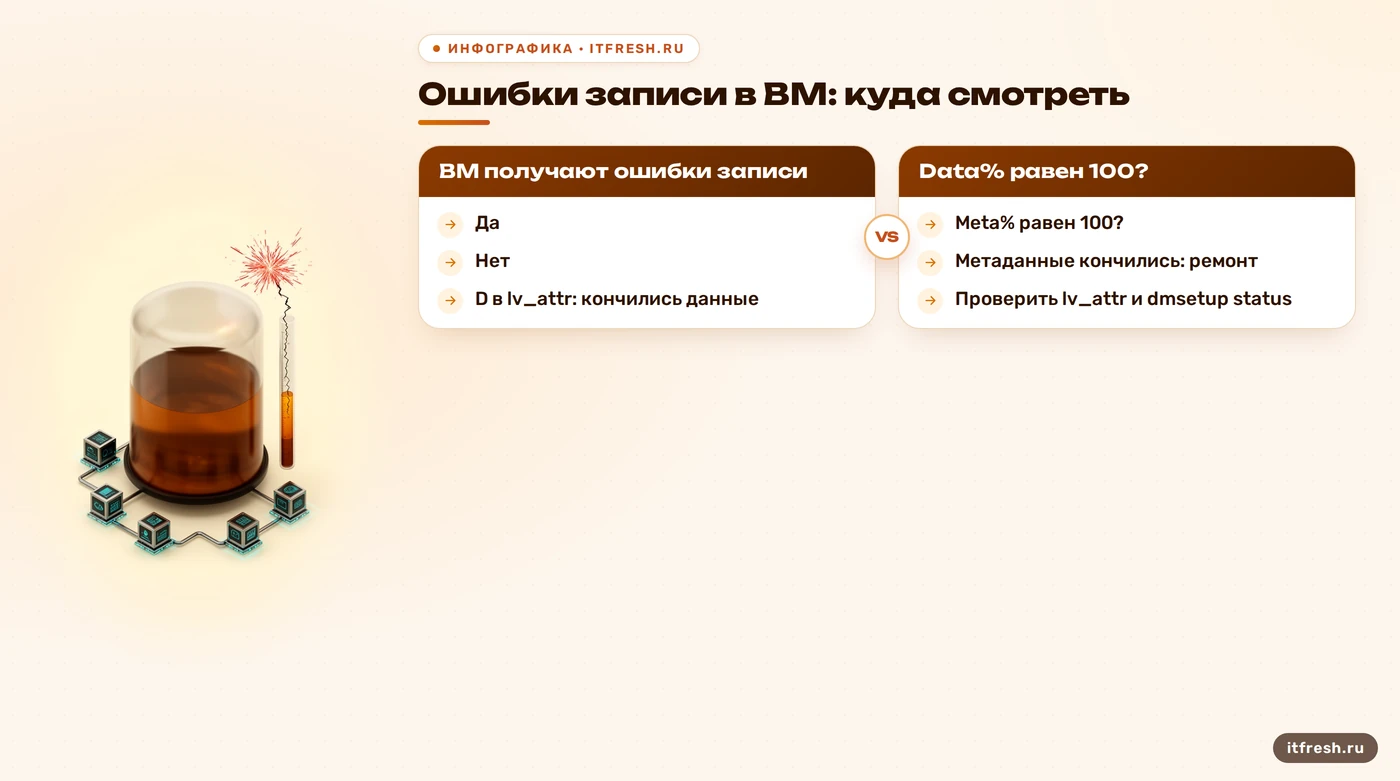
Отличать два сценария нужно сразу, потому что лечатся они по-разному. Когда кончаются данные, пул по умолчанию ставит записи в очередь и ждёт расширения; по умолчанию это 60 секунд, потом приходят ошибки (параметр модуля dm_thin_pool no_space_timeout). Режим --errorwhenfull y возвращает ошибку сразу. Признаки понятные: Data% равен 100, в атрибутах пула стоит D. Когда кончаются метаданные, Data% может быть любым, хоть 5, хоть 60. Вот это и сбивает с толку: ошибка записи при «свободном месте» почти всегда означает, что смотреть надо на Meta%.
Откуда метаданные вообще берут размер. Ядро советует прикидывать их как 48 байт на блок данных, то есть 48 × размер данных / размер chunk, с минимумом 2 МиБ и потолком 16 ГиБ. Мелкий chunk (минимум 64 КиБ, кратность 64 КиБ) раздувает карту, снапшоты тоже: снимок сначала делит блоки с оригиналом, а потом расходится с ним по мере записи, и каждое расхождение — новые записи в карте. Тонкий снапшот бесплатен ровно до того момента, когда на него начинает что-то писаться. Ещё один повод не оставлять «временный» снимок перед обновлением на полгода.
Где смотреть: lvs, атрибуты пула и dmsetup status
Начните с lvs с ключом -a, чтобы увидеть и служебные тома. Основы работы с томами я разбирал в материале про управление дисками в LVM, здесь только то, что относится к thin. Поля data_percent и metadata_percent документированы в lvmthin(7) именно для этой задачи: пул нужно расширять до того, как любое из значений дойдёт до 100.
lvs -a -o lv_name,lv_size,data_percent,metadata_percent,lv_attr vg_vmИмя vg_vm и ниже pool0 — условные, подставьте свои. В выводе вы увидите скрытые тома [pool0_tmeta] и [pool0_tdata]: первый хранит карту, второй сами данные. Размер _tmeta — это ровно тот ресурс, который тихо исчезает.
Второй источник — атрибуты. В lvs(8) для тонкого пула первый символ lv_attr равен t, пятый показывает состояние (c или C — пулу нужна проверка), а девятый — здоровье: F пул отказал и ввод-вывод запрещён, D закончилось место данных, M метаданные доступны только на чтение, изменения запрещены. Если в девятой позиции не прочерк, это уже не метрика, а авария. Для тонкого тома F означает, что его пул упал. Считать позицию из скрипта легко: lvs --noheadings -o lv_attr vg_vm/pool0 | tr -d ' ' | cut -c9.
Третий источник — состояние прямо из ядра. Команда dmsetup status --target thin-pool покажет все thin-pool в системе, а порядок полей в строке описан в документации ядра: номер транзакции, использовано/всего блоков метаданных, использовано/всего блоков данных, корень удерживаемого снимка метаданных, затем режим ro, rw или out_of_data_space, политика discard, политика при нехватке места (error_if_no_space или queue_if_no_space), флаг needs_check и low water mark метаданных. Опция --noflush не даёт принудительно фиксировать метаданные на диск при чтении статуса, что полезно, если вы опрашиваете пул часто.
dmsetup status --target thin-poolЕсли в этой строке режим ro или стоит needs_check, пул уже перестал вести себя нормально, какие бы проценты ни показывал lvs.
Чтобы не держать всё в голове, я сопоставляю симптомы с источниками так:
| Что видно | Где подтвердить | Что означает |
|---|---|---|
| Ошибки записи в гостях, Data% низкий | Meta% в lvs, режим в dmsetup status | Метаданные на исходе или кончились |
| Записи зависают примерно на минуту, потом ошибки | Data% 100, D в lv_attr | Кончились данные, работает очередь |
| M в девятой позиции lv_attr | lvs, dmsetup status | Метаданные только на чтение, нужен ремонт |
| c или C в пятой позиции | lvs, флаг needs_check | Пулу требуется проверка |
| Предупреждения в системном журнале | журнал dmeventd | Пул перешёл порог заполнения |
Что система сообщает заранее и почему это не спасает
Хорошая новость: у LVM есть собственный сторож, dmeventd. По его man-странице thin-плагин следит за заполнением и данных, и метаданных, пишет предупреждение в syslog выше 80 процентов и повторяет его на 85, 90 и 95. Выше 50 процентов он вызывает заданную dmeventd/thin_command на каждые 5 процентов роста, а по умолчанию выполняет lvextend --use-policies, чтобы расширить пул, когда пройден порог автоматического расширения. Посмотреть, что он говорил за неделю, можно так: journalctl --since '7 days ago' | grep -i thin.
Плохая новость: почти везде это не работает, и причин четыре. Пишу их списком, потому что каждая реально встречалась у клиентов. Меня до сих пор веселит формулировка «у нас же включено авторасширение»: включено, как правило, в голове, а не в lvm.conf.
Теперь про автоматическое расширение. Параметры живут в секции activation файла lvm.conf: thin_pool_autoextend_threshold (минимум 50, значение 100 отключает расширение) и thin_pool_autoextend_percent (на сколько процентов от текущего размера растёт пул). Чтобы это работало, нужен включённый мониторинг: lvs -o+seg_monitor vg_vm/pool0 покажет состояние, а lvchange --monitor y vg_vm/pool0 включит его. И нужны свободные экстенты в группе: vgs -o vg_name,vg_free. По lvmthin(7), когда lvextend увеличивает пул, том метаданных тоже растёт при необходимости, но только если места в группе хватает. Нет свободных экстентов — нет расширения, сколько бы вы ни настраивали порог.
Если у вас такая картина и вы не уверены, что она не про вас, давайте проверим сервер вместе: мы за пару часов посмотрим Meta%, режим мониторинга, свободные экстенты и список снапшотов и честно скажем, сколько у вас времени до границы.
- Предупреждения уходят в syslog, который никто не читает до аварии. Письмо в журнале, который открывают после отказа, это не оповещение, а улика.
- Событие low water mark в ядре срабатывает один раз при пересечении порога, а при возобновлении устройства приходит даже если места уже мало, поэтому полагаться на разовое событие нельзя, нужен постоянный опрос значения.
- Автоматическое расширение выключено (порог 100), мониторинг не включён или в группе нет свободных экстентов.
- Свободное место данных принимают за запас всего пула: данных ещё полно, а метаданных остались проценты.
Как поставить мониторинг Meta% и атрибутов: скрипт, cron и Zabbix
Минимальный вариант — один маленький скрипт, который печатает три значения. Он не требует ничего, кроме LVM, и годится и для cron, и для ручной проверки. Положите его, например, в /usr/local/sbin/thin-check.sh.
#!/bin/sh
# thin-check.sh VG/POOL
lvs --noheadings --nosuffix -o data_percent,metadata_percent,lv_attr "$1" |
  awk '{ print "data=" $1, "meta=" $2, "health=" substr($3, 9, 1) }'
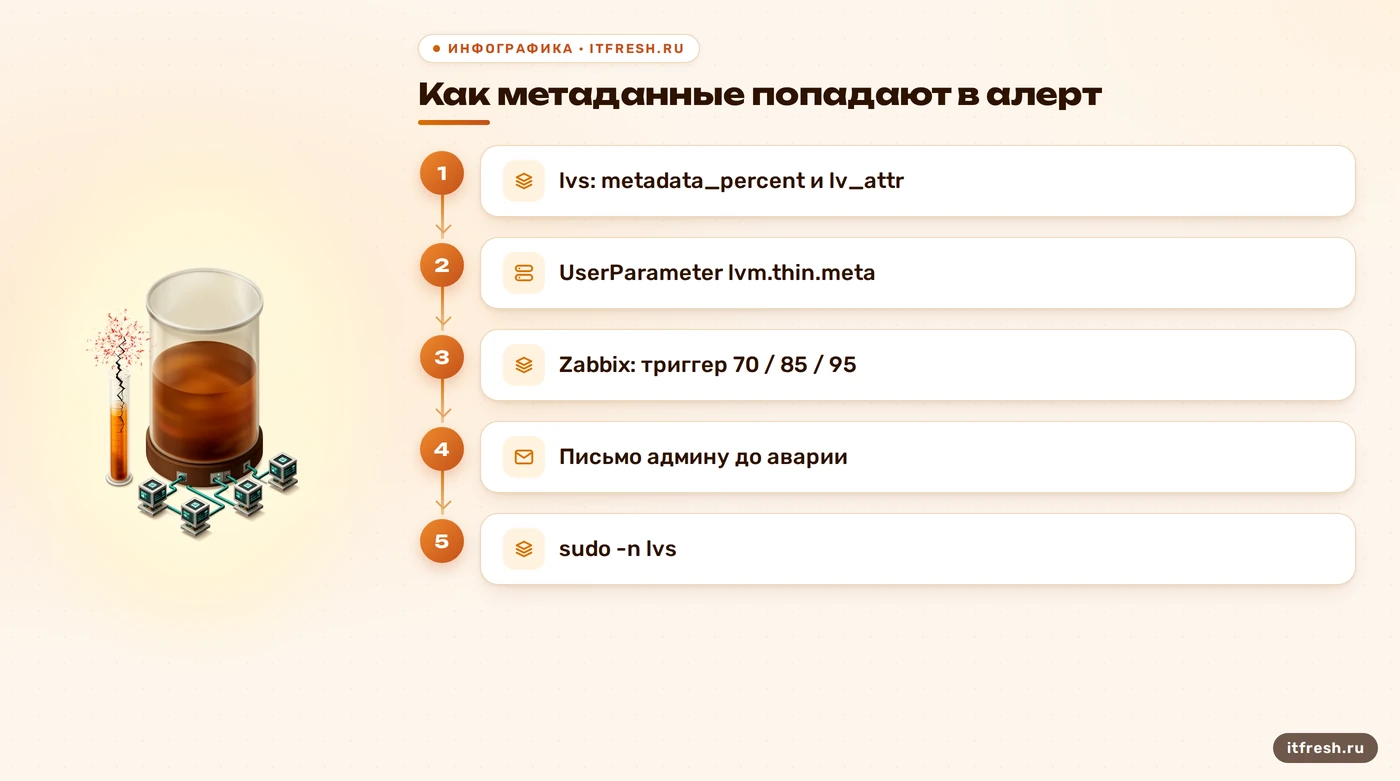
На выходе получится строка вроде data=47.12 meta=63.40 health=-. Цифры условные. Если вам не нужен Zabbix, повесьте в cron проверку, которая шлёт письмо при Meta% выше выбранного порога и при любом символе кроме прочерка в девятой позиции. Это сорок минут работы, а не проект.
Для Zabbix я использую пользовательские параметры. Агент работает не от root, а lvs требует прав, поэтому нужна узкая запись в sudoers. Правьте через visudo -f /etc/sudoers.d/zabbix-lvs и разрешайте одну команду: путь к lvs проверьте через command -v lvs, он отличается между дистрибутивами. Затем в конфигурации агента (или во включаемом через Include файле, проверьте в своей версии) добавьте ключи с параметром: по документации Zabbix, форма UserParameter=key[*],command позволяет передать в команду $1.
UserParameter=lvm.thin.meta[*],sudo -n lvs --noheadings -o metadata_percent $1 | tr -d ' '
UserParameter=lvm.thin.data[*],sudo -n lvs --noheadings -o data_percent $1 | tr -d ' '
UserParameter=lvm.thin.health[*],sudo -n lvs --noheadings -o lv_attr $1 | tr -d ' ' | cut -c9
Ключ вызывается как lvm.thin.meta[vg_vm/pool0]. После правки конфигурации нужно перезапустить агента или перечитать параметры на лету: для классического агента это zabbix_agentd -R userparameter_reload, для Agent 2 я просто перезапускаю службу. Некоторые символы в пользовательских параметрах по умолчанию запрещены, а список и параметр UnsafeUserParameters описаны в справочнике по конфигурации агента, прочитайте раздел один раз.
Пороги — это моя практика, а не рекомендация вендора, но они хорошо работают на пулах офисного размера. Метаданные: предупреждение на 70 процентах, высокий приоритет на 85, авария на 95. Данные: 80 и 90, это совпадает с порогами dmeventd. Здоровье: любое значение кроме прочерка — авария сразу. Для Zabbix 6.0 и новее триггер на здоровье выглядит так: last(/host/lvm.thin.health[vg_vm/pool0])<>"-", подставьте имя узла. Главное правило: Meta% нужен триггер на скорость роста, а не только на абсолютное значение. Рост на пять процентов за сутки при 60 процентах заполнения хуже, чем стабильные 80.
Отдельно держите ревизию снапшотов, потому что они главный разгон метаданных. Раз в неделю смотрите список: lvs -o lv_name,origin,lv_time vg_vm (набор полей сверьте через lvs -o help в своей версии). Любой том с заполненным origin, которому больше нескольких дней, нужно либо оправдать, либо удалить. «Снимок перед обновлением 1С» месячной давности ничем не отличается от забытого утюга, только утюг по крайней мере греется.
Разбор случая: фитнес-центр «Энергия движения», 35 рабочих мест
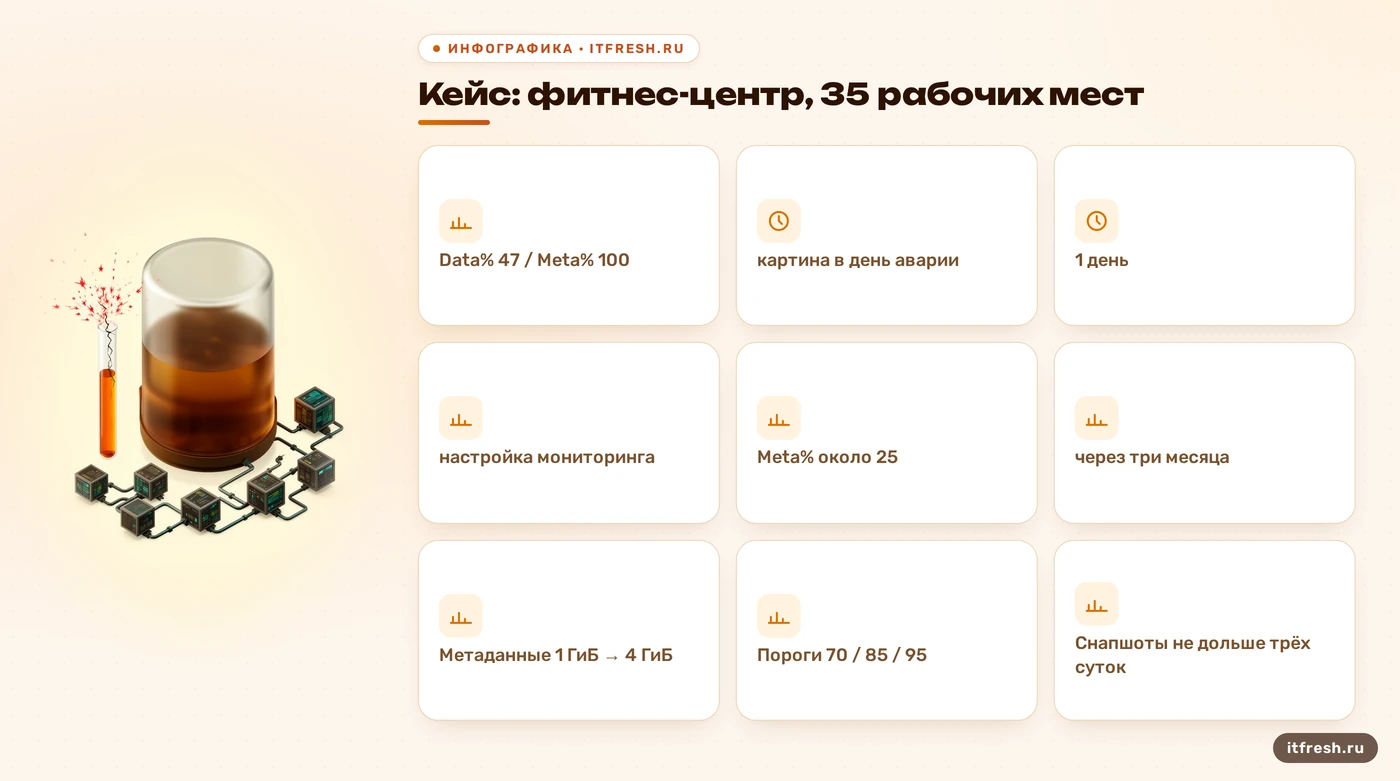
Условный клиент, фитнес-центр «Энергия движения»: 35 рабочих мест (ресепшен, тренерская, бухгалтерия, администраторы залов). Один сервер виртуализации на KVM с зеркалом из двух SSD, шесть виртуальных машин: 1С, файловый сервер, СКУД, система видеонаблюдения, терминальный сервер и тестовая машина. Тонкий пул vg_vm/pool0 на 2,6 ТиБ, chunk 64 КиБ, метаданные 1 ГиБ. По формуле из документации ядра на полностью заполненный пул нужно около 2 ГиБ, то есть запаса хватало примерно на половину пула, а снапшоты съедали остаток быстрее.
Обращение выглядело так: в понедельник утром 1С на ресепшене зависает при записи, файловый сервер отдаёт ошибки, в гостях диск уходит в read-only. Администратор клуба смотрел на хост: df свободен, lvs показывает Data% 47. Диагностика заняла десять минут, когда мы знали, куда смотреть: Meta% 100, в девятой позиции lv_attr буква, отличная от прочерка. Причина — полгода никто не смотрел метаданные и пара забытых снапшотов, сделанных перед обновлениями 1С. Ремонт мы делали по порядку, описанному в разборе про нехватку метаданных thin-pool, здесь он не повторяется.
Дальше самое полезное. За один рабочий день мы настроили то, что описано выше: расширили метаданные до 4 ГиБ, оставили в группе резерв свободных экстентов, включили мониторинг и проверили seg_monitor, добавили в Zabbix три ключа и триггеры с порогами 70, 85 и 95 процентов, удалили снапшоты и ввели недельную ревизию. Работа вместе с отчётом заняла один день, и тестовое срабатывание алерта мы проверили искусственно, а не ждали аварии.
Итог за три месяца. Meta% держится около 25 процентов, снапшоты живут не дольше трёх суток. Один раз алерт на 70 процентов сработал во втором месяце, когда параллельно с большой загрузкой данных висел снимок перед обновлением: письмо пришло в рабочее время, снимок удалили за пять минут. Раньше для того же эффекта требовалось падение 1С в понедельник утром.
Что делать первым, если Meta% уже высокий, и на что не тратить время
Порядок такой. Сегодня, а не на следующей неделе: посмотрите Meta% и lv_attr на всех хостах с thin. Если там меньше 70, спокойно ставьте мониторинг. Если выше 85, сразу смотрите свободные экстенты в группе и расширяйте метаданные, пока пул жив: lvextend --poolmetadatasize 2G vg_vm/pool0 (значение должно быть больше текущего, по lvmthin(7) метаданные ограничены примерно 16 ГиБ, а стартовой разумной величиной документация называет 1 ГиБ). Нет свободных экстентов — добавляйте физический диск в группу, и здесь пригодится понимание операций с PV, например вывод диска из LVM после сбоя pvmove, если придётся переносить данные.
Если пул уже в M, F или Meta% 100, не импровизируйте. По lvmthin(7) нужен офлайн-ремонт: деактивировать пул, выполнить lvconvert --repair vg_vm/pool0 (исправленная копия метаданных пишется в служебный том pmspare, а повреждённый вариант остаётся в томе с именем вида pool0_metaN), расширить метаданные и обязательно проверить файловые системы в гостях. Перед ремонтом снимите копию метаданных. Тонкости этой процедуры уже разобраны в отдельной статье, поэтому здесь не дублирую.
Что можно не делать. Не переключайте пул в --errorwhenfull y в надежде, что «пусть лучше сразу ошибка»: режим очереди с минутным ожиданием часто даёт автоматическому расширению шанс отработать, а для метаданных этот ключ вообще ничего не меняет. Не гоняйтесь за идеальным chunk size на живом пуле. И не считайте, что бэкап всё решает: бэкап делают все, проверяет его почти никто, а восстановление гостя из копии на пуле, который снова упадёт через неделю, не лечение.
Частые вопросы
Как узнать, что у thin-pool закончились метаданные, а не данные?
Выполните `lvs -a -o lv_name,data_percent,metadata_percent,lv_attr` и сравните Data% и Meta%. Если Meta% равен 100, а Data% низкий, закончились метаданные. Данные подтверждает буква D в девятой позиции lv_attr, метаданные только на чтение подтверждает M.
Какой порог Meta% ставить в алерт?
Документация порогов для офисных пулов не задаёт. В моей практике: предупреждение на 70, высокий приоритет на 85, авария на 95 процентах, плюс отдельный триггер на скорость роста. Это совпадает по духу с порогами dmeventd, который предупреждает в syslog выше 80 процентов.
Почему не сработало авторасширение пула?
Проверьте три вещи: thin_pool_autoextend_threshold не равен 100 (минимум 50), включён мониторинг (`lvs -o+seg_monitor`, при необходимости `lvchange --monitor y`) и в группе есть свободные экстенты (`vgs -o vg_free`). Без любого из условий расширения не будет.
Что показывает dmsetup status для thin-pool?
Номер транзакции, использовано и всего блоков метаданных, использовано и всего блоков данных, режим ro, rw или out_of_data_space, политику при нехватке места и флаг needs_check. Порядок полей описан в документации ядра по thin-provisioning.
Можно ли расширить метаданные пула без остановки ВМ?
Да, если пул ещё в рабочем состоянии: команда lvextend --poolmetadatasize увеличивает том метаданных на активном пуле, но требует свободных экстентов в группе. Делайте это заранее. Если метаданные уже исчерпаны, по lvmthin(7) нужен офлайн-ремонт с деактивацией пула; проверьте процедуру для своей версии lvm2.
Источники
- lvmthin(7): LVM thin provisioning — Data% и Meta%, исчерпание метаданных и данных, режимы queue/error, пороги автоматического расширения (минимум 50, 100 отключает), мониторинг seg_monitor, диапазон размера метаданных, lvconvert --repair. https://man7.org/linux/man-pages/man7/lvmthin.7.html
- Linux kernel: thin provisioning (device-mapper) — Порядок полей статуса thin-pool, поведение при исчерпании метаданных, no_space_timeout, low water mark, формула размера метаданных 48 байт на блок. https://docs.kernel.org/admin-guide/device-mapper/thin-provisioning.html
- lvs(8) — Биты lv_attr для thin pool: тип t, состояние c/C, здоровье F, D, M; опции --noheadings, --nosuffix, --separator. https://man7.org/linux/man-pages/man8/lvs.8.html
- dmeventd(8) — Thin-плагин: предупреждения в syslog выше 80 процентов, повторы на 85, 90 и 95, вызов lvextend --use-policies. https://man7.org/linux/man-pages/man8/dmeventd.8.html
- dmsetup(8) — Синтаксис dmsetup status [--target target_type] [--noflush], смысл --noflush для thin-pool. https://man7.org/linux/man-pages/man8/dmsetup.8.html
- Zabbix Documentation: User parameters — Синтаксис UserParameter=key[*],command и подстановка $1, перезагрузка параметров командой zabbix_agentd -R userparameter_reload. https://www.zabbix.com/documentation/current/en/manual/config/items/userparameters