
Создал отдельную таблицу маршрутов, а трафик всё равно уходит через main: разбираю policy routing в Linux
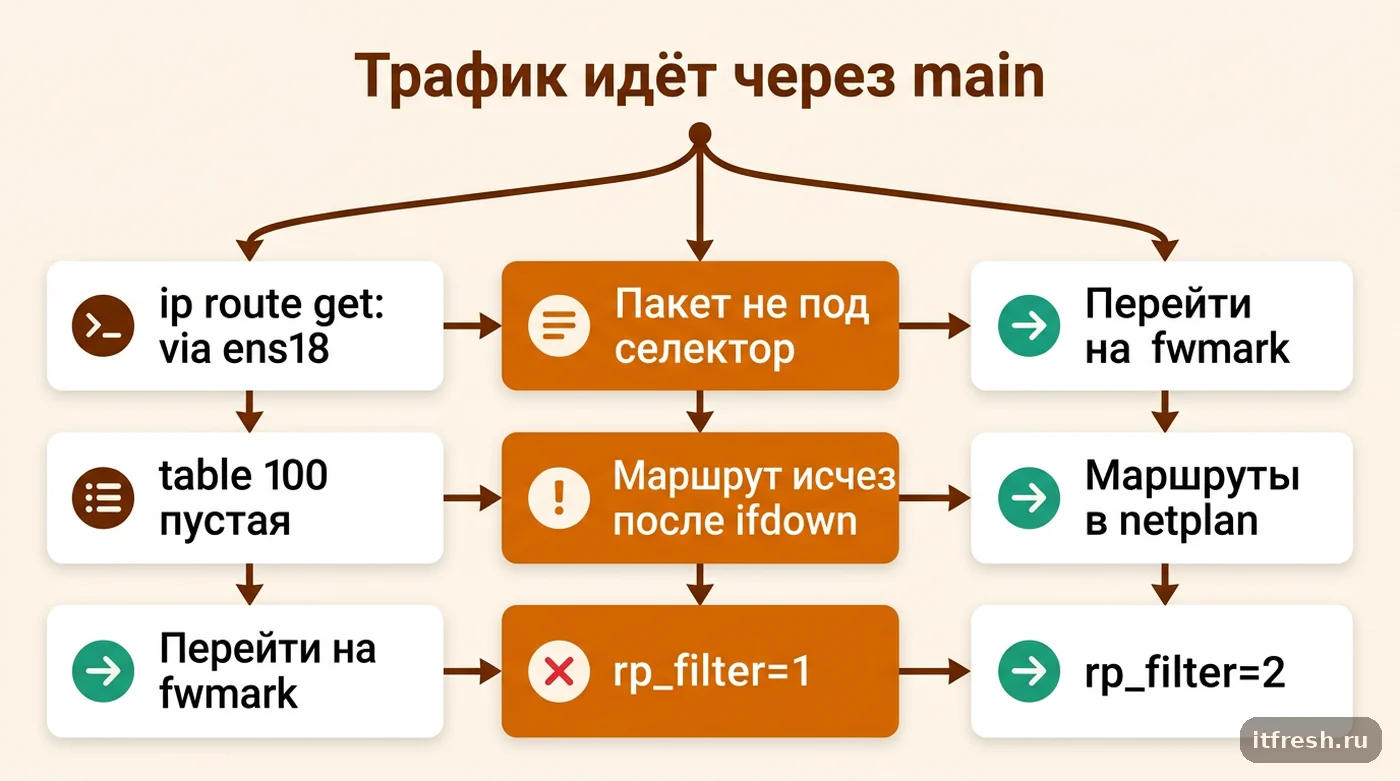
Если после ip rule трафик всё равно уходит через main, почти всегда виновата одна из трёх вещей: правило совпало, но в таблице нет маршрута; пакет вообще не подходит под селектор (классика — from для трафика самого сервера); ответы режет rp_filter. Ниже — диагностика тремя командами, рабочая схема на fwmark и разбор шлюза швейного цеха.
Как ядро выбирает таблицу маршрутов: RPDB сверху вниз и провал в main
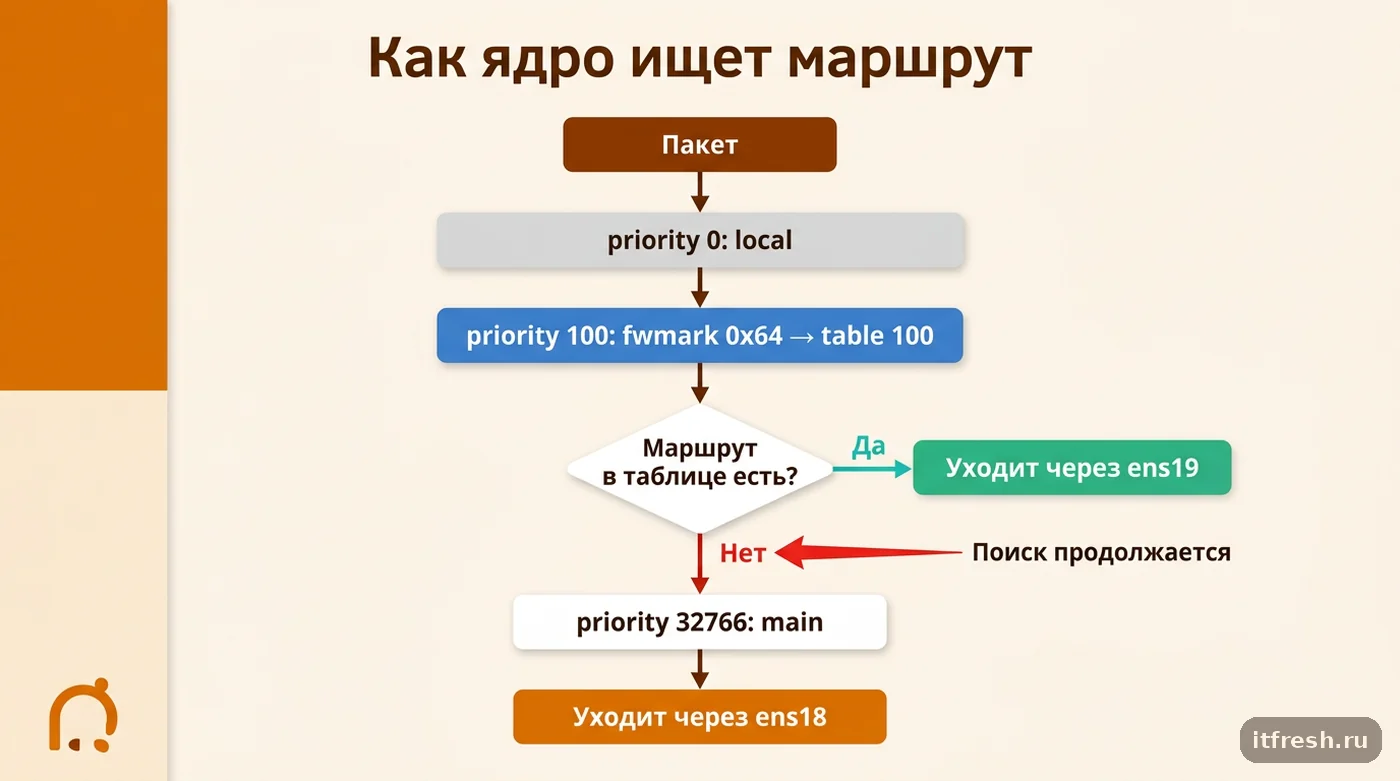
Ядро не ищет «самую подходящую» таблицу. Оно идёт по списку правил RPDB (routing policy database) строго по возрастанию числа priority: меньшее число проверяется раньше. Стартовый набор, который ядро создаёт само, — три правила: priority 0 — таблица local, 32766 — main, 32767 — default. Всё, что вы добавляете руками, живёт между нулём и 32766. Если ваше правило не отработало, пакет доезжает до 32766 и уходит по main. Когда такой шлюз достаётся нам на ИТ-аутсорсинг небольшого офиса, первое, что я делаю, — смотрю этот список глазами, а не конфиги.
Самое важное и самое неочевидное: совпадение селектора не заканчивает поиск. В man ip-rule(8) сказано, что если действие правила не дало маршрута, RPDB продолжает со следующего правила. По-человечески: правило совпало, ядро заглянуло в вашу таблицу 100, маршрута для адреса там нет — и поиск тихо идёт дальше, до main. В ip rule show правило выглядит идеально, в логах ничего нет, а трафик уходит через основной канал.
Вторая мина — приоритет, который вы не задали. Если написать ip rule add без priority, ядро подставит номер само: на единицу меньше приоритета первого правила после нулевого. Первое правило приземлится на 32765, следующее — на 32764, и порядок начинает зависеть от того, в какой последовательности правила добавлялись. Стоит сетевому менеджеру пересоздать часть правил после netplan apply или реконнекта — порядок меняется. В man прямо написано, что у каждого правила должен быть явно заданный уникальный priority. Я задаю его всегда, даже когда правило одно.
- from PREFIX — адрес источника: самый популярный и самый коварный селектор;
- to PREFIX — адрес назначения;
- iif NAME — входящий интерфейс; для локально рождённых пакетов это lo;
- oif NAME — исходящий интерфейс, если сокет к нему привязан;
- fwmark MARK[/MASK] — метка фаервола, самый универсальный инструмент;
- uidrange, ipproto, sport, dport — пользователь-отправитель, протокол и порты;
- suppress_prefixlength N — отбросить решение таблицы, если префикс длиной N или короче.
Диагностика policy routing за три команды: rule, table, route get
Я не начинаю с чтения конфигов — сначала смотрю, что в ядре прямо сейчас. Три команды закрывают почти всё.
# 1. Порядок правил с приоритетами
ip rule show

# 2. Что реально лежит в таблице (не только default)
ip -4 route show table 100

# 3. Что ядро решит для конкретного адреса
ip route get 192.0.2.10
Первая часто сразу показывает, что выше вашего правила висит забытое правило от VPN-клиента или контейнерного рантайма. Вторая — что в таблице один default и больше ничего. Третья — главная: ip route get выполняет полный поиск в FIB и печатает результат так, как его видит ядро.
У ip route get есть параметры, без которых вы моделируете не тот трафик, который разбираете.
# пакет, рождённый на самом шлюзе (поведение по умолчанию)
ip route get 192.0.2.10

# транзитный пакет от клиента LAN: обязательно from + iif
ip route get 192.0.2.10 from 10.20.0.15 iif ens20

# проверка правила по метке
ip route get 192.0.2.10 mark 0x64

# показать совпавшую запись FIB, а не итоговый dst
ip route get 192.0.2.10 fibmatch
Самая частая ошибка диагностики, которую я вижу: транзитный трафик проверяют командой без from и iif. Ядро отвечает про пакет, рождённый на самом сервере, — это другой сценарий с другим выбором адреса источника. На стенде «всё правильно», у пользователей не работает.
И ещё одна полезная команда перед любой чисткой: ip rule save выгружает текущие правила в бинарный поток, который потом можно вернуть через ip rule restore. Прежде чем «убрать мусор», сделайте ip rule save > /root/rules.bin — откат займёт секунду, а не вечер восстановления по памяти.
Причина первая: правило совпало, но в таблице нет маршрута
Кастомная таблица ничего не наследует из main: ни connected-маршрутов к локальным сетям, ни маршрутов к соседним VLAN и туннелям. Если адрес назначения не покрывается ни одной записью таблицы 100, поиск проваливается дальше. Для внешних адресов обычно хватает default, но я всё равно кладу в таблицу пару — маршрут к сети провайдера и шлюз по умолчанию через него. Так таблица самодостаточна, и ip route show table 100 читается без знания main.
ip route add 203.0.113.32/29 dev ens19 scope link table 100
ip route add default via 203.0.113.33 dev ens19 table 100
ip route show table 100
# 203.0.113.32/29 dev ens19 scope link
# default via 203.0.113.33 dev ens19
Отдельный подвох — исчезающая таблица. Когда интерфейс опускают административно (ifdown, пересоздание подключения сетевым менеджером), ядро удаляет все маршруты через него, в том числе в таблице 100. Интерфейс поднялся, а руками добавленный default назад сам не вернулся. Правило на месте, таблица пустая, трафик в main.
Второй промах этой же категории — слишком широкий селектор. Правило «весь трафик от 10.20.0.0/24 — в таблицу 100» ловит и обращения к соседнему VLAN, и к серверу за IPsec. В таблице 100 этих маршрутов нет, поиск проваливается в main и там находит нужное. Работает — до дня, когда кто-нибудь положит в таблицу 100 unreachable или blackhole на «всё остальное»: такие действия останавливают поиск, и внутренняя связность падает. Поэтому селектор я делаю максимально узким, а не «весь LAN».
Про имена таблиц. Строка «100 isp2» в /etc/iproute2/rt_tables не обязательна, но через полгода сильно помогает. Только помните: NetworkManager в ipv4.routing-rules прямо не поддерживает имена таблиц в lookup и table, а netplan в поле table принимает целые числа от 1. Имя — для людей и ручных команд, в декларативные конфиги пишите номер.
- в таблице есть маршрут к сети шлюза, а не только default;
- после ifdown/ifup таблица снова заполнена (ip route show table N);
- селектор не захватывает внутренние сети, которых нет в таблице;
- unreachable или blackhole в кастомной таблице — только осознанно и с проверкой внутренних маршрутов.
Причина вторая: пакет не подходит под селектор from — и как помогает fwmark
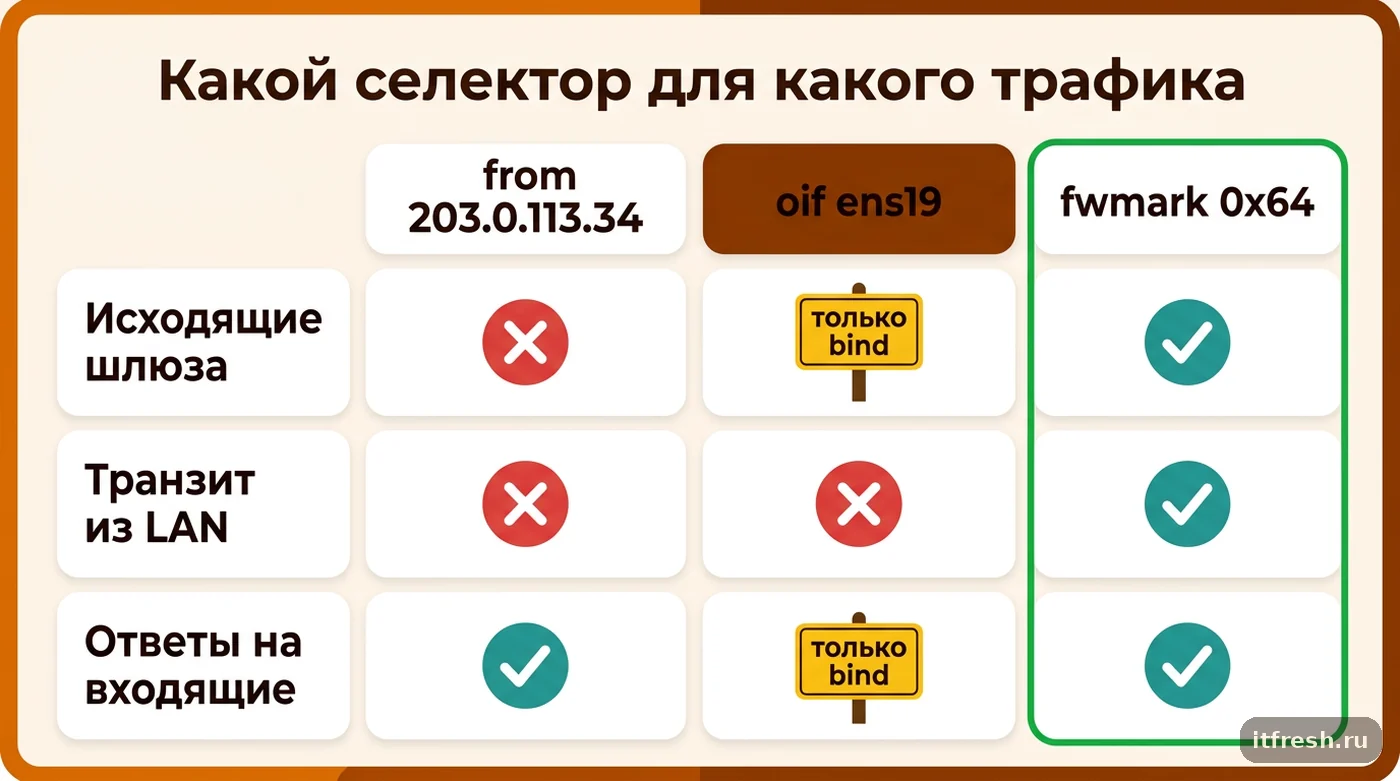
Классика — правило from для исходящих соединений самого сервера. Логика кажется железной: «у шлюза адрес 203.0.113.34 на втором провайдере, значит from 203.0.113.34 table 100 отправит его трафик через второй канал». Не отправит. Когда приложение открывает соединение, не привязываясь к адресу, источник ещё не выбран: ядро делает маршрутный поиск как раз для того, чтобы его выбрать. Правило from совпасть не может, поиск доезжает до main, main говорит «через ens18», источником становится 198.51.100.10 — и правило для 203.0.113.34 уже мимо. Для транзитного трафика из LAN правило тоже не сработает: у клиентов источник 10.20.0.x, а не адрес провайдера.
При этом у правила from есть честная работа — ответы. Если соединение пришло на 203.0.113.34 извне, ответ уходит с этим адресом источника, и правило from 203.0.113.34 table 100 возвращает его через правильного провайдера. То же — для программ, явно привязанных к адресу (curl --interface 203.0.113.34). Поэтому я оставляю его для входящих, а исходящий трафик направляю меткой.
ip rule add fwmark 0x64/0xff table 100 priority 100
ip rule add from 203.0.113.34 table 100 priority 110
Маска /0xff нужна, чтобы чужие биты метки от других подсистем не ломали совпадение: без маски сравнивается всё 32-битное значение.
Метку важно поставить вовремя. Для транзитных пакетов — в prerouting, до маршрутного решения. Для пакетов самого шлюза — в output, причём в цепочке типа route: только она заставляет ядро пересчитать маршрут после изменения метки. В обычной filter-цепочке output метка проставится, а перемаршрутизации не будет.
table inet mangle {
  set psp_nets {
    type ipv4_addr
    flags interval
    elements = { 192.0.2.0/24 }
  }
  chain prerouting {
    type filter hook prerouting priority mangle; policy accept;
    ct mark != 0 meta mark set ct mark
    iifname "ens20" ip daddr @psp_nets meta mark set 0x64 ct mark set meta mark
  }
  chain output {
    type route hook output priority mangle; policy accept;
    ip daddr @psp_nets meta mark set 0x64
  }
}
Первая строка prerouting восстанавливает метку из conntrack для последующих пакетов соединения, вторая ставит её новым и сохраняет. Метка в forward или в nat-цепочке уже бесполезна — маршрут к тому моменту выбран.
Причина третья: маршрут верный, но ответы режет rp_filter
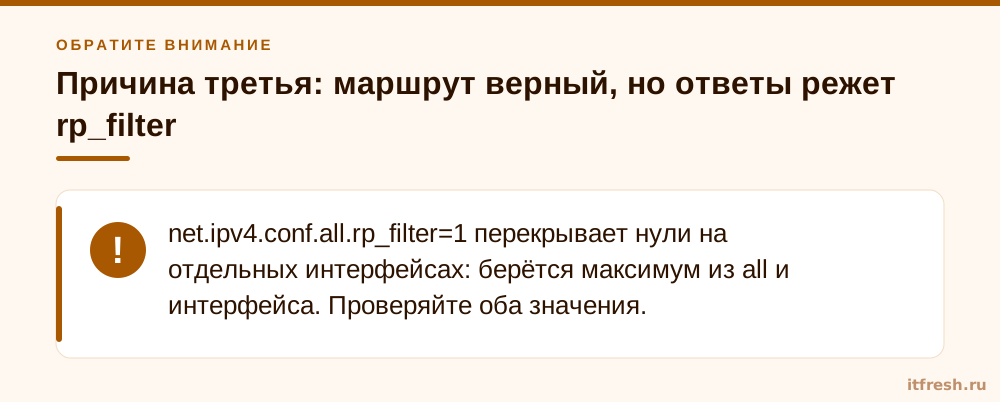
Бывает и так: ip route get показывает нужную таблицу, tcpdump на ens19 видит уходящие пакеты, а соединения не устанавливаются. Почти всегда это reverse path filter. Документация ядра (ip-sysctl) описывает три режима: 0 — без проверки, 1 — строгий по RFC 3704, когда входящий пакет отбрасывается, если лучший обратный маршрут к его источнику ведёт не через тот интерфейс, на который он пришёл, и 2 — свободный, когда источник должен быть достижим хоть через какой-то интерфейс. При policy routing ответ от банка приходит на ens19, а main считает, что к этому адресу надо ходить через ens18, — строгий режим молча выбрасывает пакет. Подробно механику я разбирал в статье пакет виден в tcpdump, но Linux его отбрасывает.
Ключевой нюанс: значения all и конкретного интерфейса не перекрывают друг друга, а берётся максимум. В документации ядра так и сказано: для проверки на интерфейсе используется максимальное из conf/all/rp_filter и conf/<интерфейс>/rp_filter. Поставить 0 на ens19 при all=1 бесполезно.
sysctl net.ipv4.conf.all.rp_filter net.ipv4.conf.default.rp_filter net.ipv4.conf.ens19.rp_filter
grep -rn rp_filter /etc/sysctl.conf /etc/sysctl.d /usr/lib/sysctl.d
Значение по умолчанию зависит от дистрибутива и образа: где-то приезжает 2 из системных sysctl.d, где-то 1 из облачного шаблона. Проверяйте на конкретной машине.
Документация ядра сама рекомендует свободный режим при асимметричной или сложной маршрутизации. В мультиканальных схемах я ставлю 2 на all и default, а 0 включаю только точечно и на время отладки. Есть и более аккуратный путь: если метка восстанавливается из conntrack ещё в prerouting, можно включить net.ipv4.conf.all.src_valid_mark=1 — тогда обратная проверка учитывает метку и идёт через таблицу 100. Но на небольшом шлюзе свободный режим проще и понятнее тому, кто будет обслуживать его после вас.
Разбор: швейный цех «Крой и шов», два провайдера и банк с белым списком
Условный клиент — пошивочное предприятие «Крой и шов», 17 рабочих мест: офис, цех на 9 машин и склад готовой продукции. Шлюз — мини-сервер на Ubuntu Server 24.04 LTS с ядром 6.8 и nftables. Два канала: ens18 — дешёвая оптика, 198.51.100.10/29, шлюз 198.51.100.9; ens19 — бизнес-канал со статическим адресом 203.0.113.34/29, шлюз 203.0.113.33. LAN 10.20.0.0/24 на ens20. Задача пришла от бухгалтерии: клиент-банк и оператор ЭДО пускают только с адреса 203.0.113.34, всё остальное должно идти через дешёвый канал.
Прежний подрядчик сделал то, что советует первая ссылка в поиске.
echo '100 isp2' >> /etc/iproute2/rt_tables
ip route add default via 203.0.113.33 dev ens19 table 100
ip rule add from 203.0.113.34 table 100
Три недели бухгалтер получала «доступ запрещён», платёжки отправляли с домашнего ноутбука директора. Схему дважды переделывали и чуть не сменили провайдера. Мой разбор занял сорок минут, из них тридцать — чтение того, что уже наворотили.
Диагностика показала три причины сразу. ip rule show — правило на 32765, порядок нормальный. ip route show table 100 — пусто: после вчерашнего переподключения ens19 сетевым менеджером руками добавленный default исчез. ip route get 192.0.2.10 from 10.20.0.15 iif ens20 — via 198.51.100.9 dev ens18: трафик бухгалтерии имел источник 10.20.0.15 и под from 203.0.113.34 не подходил в принципе. Третьим слоем стоял net.ipv4.conf.all.rp_filter=1, который резал бы ответы, даже если бы первые две проблемы решились.
Итоговая схема заняла один вечер. Сети банка и ЭДО вынесли в nft-set, метку 0x64 ставим в prerouting для LAN и в route-цепочке output для самого шлюза, masquerade на ens19 для помеченного трафика, два правила с явным приоритетом — fwmark для исходящих, from для ответов, rp_filter=2. Проверка: ip route get 192.0.2.10 mark 0x64 показал via 203.0.113.33 dev ens19 src 203.0.113.34, запрос к сервису определения внешнего адреса вернул нужный IP, бухгалтер вошла в банк. Через неделю мы специально сделали netplan apply и перезагрузку — ничего не отвалилось, потому что всё уже жило в конфиге, о чём следующий раздел.
- Было: 3 недели сбоев, платежи с чужого ноутбука, правило без приоритета и пустая таблица.
- Стало: трафик к банку и ЭДО через ens19 с src 203.0.113.34, остальное — через ens18.
- Правил в RPDB: 2, priority 100 и 110, оба в netplan.
- Разбор — 40 минут, внедрение с персистентностью и мониторингом — один вечер.
Как сделать правила постоянными и не сломать схему через полгода
Ядро при загрузке создаёт только три правила, всё остальное живёт до перезагрузки или до ближайшего пересоздания подключения. Поэтому ip rule add в консоли — инструмент отладки, а решение живёт в конфиге того менеджера, который управляет сетью. В netplan это блок routing-policy с ключами from, to, table, priority, mark и type-of-service.
network:
  version: 2
  ethernets:
    ens19:
      addresses: [203.0.113.34/29]
      routes:
        - to: 203.0.113.32/29
          scope: link
          table: 100
        - to: default
          via: 203.0.113.33
          table: 100
      routing-policy:
        - mark: 100
          table: 100
          priority: 100
        - from: 203.0.113.34
          table: 100
          priority: 110
mark: 100 — это та же метка 0x64 в десятичной записи. В NetworkManager то же делается свойствами ipv4.route-table и ipv4.routing-rules (синтаксис как у ip rule, приоритет обязателен), в systemd-networkd — секцией [RoutingPolicyRule] с FirewallMark= и Priority=.
Схему приоритетов я записываю комментарием рядом с конфигом: 100–199 — бизнес-правила вроде сервисов с белым списком, 200–299 — VPN и туннели, 300–399 — служебное. Через год, когда появится ещё один сервис с привязкой к адресу, будет понятно, куда его вставлять. Мониторинг проверяет не наличие строки в ip rule show, а результат: скрипт делает ip route get 192.0.2.10 mark 0x64 и проверяет, что в ответе src 203.0.113.34. Такая проверка ловит и снесённое правило, и опустевшую таблицу, и пропавший маршрут. Если у вас уже настроены зависимости триггеров в Zabbix, сделайте этот элемент зависимым от доступности второго канала, чтобы при обрыве не получать пачку писем.
Честно о том, когда всё это не нужно. Если задача звучит как «один сервис с фиксированным списком адресов должен ходить через второй канал», часто хватает статических маршрутов к этим сетям прямо в main плюс SNAT на нужном интерфейсе — без правил и отдельной таблицы. Policy routing нужен, когда критерий не помещается в адрес назначения: источник, пользователь, метка, интерфейс. И помните про conntrack: после смены схемы старые соединения продолжают жить по старым NAT-записям, как я описывал в статье о том, где прячется прежний адрес после правки DNAT, — при проверке сбросьте их через conntrack -D или дождитесь истечения.
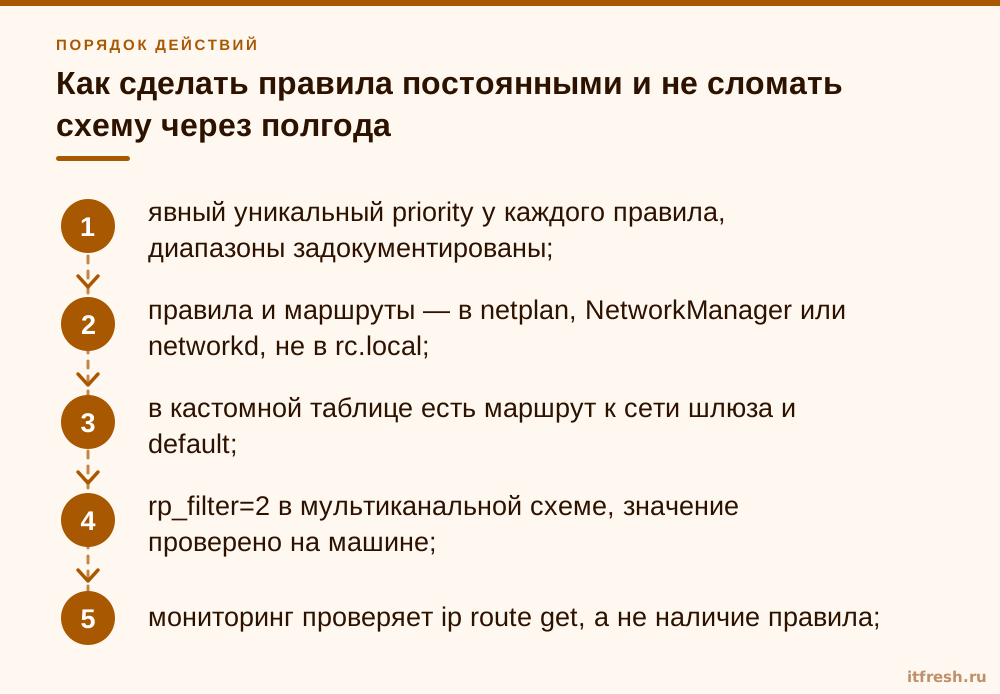
- явный уникальный priority у каждого правила, диапазоны задокументированы;
- правила и маршруты — в netplan, NetworkManager или networkd, не в rc.local;
- в кастомной таблице есть маршрут к сети шлюза и default;
- rp_filter=2 в мультиканальной схеме, значение проверено на машине;
- мониторинг проверяет ip route get, а не наличие правила;
- перед чисткой — ip rule save > /root/rules.bin.
Частые вопросы
Почему ip rule add from МОЙ_IP table 100 не работает для трафика самого сервера?
Потому что при новом исходящем соединении адрес источника ещё не выбран: ядро как раз ищет маршрут, чтобы его выбрать. Правило from совпасть не может, и поиск уходит в main. Для исходящих используйте метку и правило fwmark, а from оставьте для ответов на входящие соединения.
Как точно узнать, какая таблица выбрана для пакета?
Командой ip route get: она выполняет полный поиск в FIB. Для транзитного трафика обязательно указывайте from и iif, для правил по метке — mark, для просмотра совпавшей записи — fibmatch. Сам вывод ip rule show ничего не доказывает.
Обязательно ли прописывать имя таблицы в rt_tables?
Нет, номер работает и без имени. Имя удобно в ручных командах. В NetworkManager (ipv4.routing-rules) и netplan (table) указывайте только число.
Правила пропали после перезагрузки или netplan apply — это нормально?
Да. Ядро создаёт только правила local (0), main (32766) и default (32767). Всё добавленное из консоли живёт до перезагрузки или пересоздания подключения. Постоянные настройки описывайте в netplan (routing-policy), NetworkManager или systemd-networkd.
Нужно ли выключать rp_filter при policy routing?
В ноль — не нужно. Документация ядра рекомендует свободный режим (2) для асимметричной маршрутизации. Помните, что берётся максимум из conf/all и conf/<интерфейс>, поэтому проверяйте оба значения.
Источники
- ip-rule(8), Linux manual page — Порядок обработки RPDB, стартовые правила 0/32766/32767, продолжение поиска при неудачном действии, требование уникального priority, fwmark MARK/MASK, save/restore: https://man7.org/linux/man-pages/man8/ip-rule.8.html
- ip-route(8), Linux manual page — ip route get с параметрами from, iif, mark, fibmatch; ip route show table: https://man7.org/linux/man-pages/man8/ip-route.8.html
- Linux kernel documentation — IP Sysctl — rp_filter 0/1/2, правило максимума conf/all и conf/<interface>, рекомендация loose mode при асимметричной маршрутизации, src_valid_mark: https://docs.kernel.org/networking/ip-sysctl.html
- Netplan documentation — YAML configuration — routing-policy (from, to, table, priority, mark, type-of-service), table — целые от 1, scope в routes: https://netplan.readthedocs.io/en/stable/netplan-yaml/
- NetworkManager — nm-settings-nmcli — ipv4.routing-rules: синтаксис ip rule, обязательный priority, имена таблиц не поддерживаются; ipv4.route-table: https://networkmanager.dev/docs/api/latest/nm-settings-nmcli.html
- systemd.network(5) — Секция [RoutingPolicyRule]: FirewallMark=, Table=, Priority=, From=: https://www.freedesktop.org/software/systemd/man/latest/systemd.network.html