
Зависимости триггеров в Zabbix 7.4: почему при обрыве канала всё равно прилетает два десятка писем
Канал до второго зала коворкинга лёг в 09:14, а к 09:18 в почте лежит 23 письма: сервер бронирования, NAS, два коммутатора, восемь камер, контроллеры СКУД и где-то на одиннадцатой позиции сам шлюз. Зависимости в Zabbix настроены, на дашборде всё свёрнуто под одну аварию — а почта и Telegram всё равно забиты. Разбираю, почему так происходит в 7.4 (и в любой другой версии — это поведение by design, а не баг), как считается окно гонки между родительской и дочерней проверкой, что делает эскалатор с зависимыми событиями и что я реально настраиваю, чтобы из обрыва канала приезжало одно письмо, а не двадцать.
Зависимость — это не глушилка, а условие в момент пересчёта
Начну с формулировки, из-за которой всё и ломается. Вкладка Dependencies у триггера в голове большинства админов означает «не слать уведомления про дочерний хост, пока родитель лежит». В документации написано другое и заметно уже: пока родительский триггер находится в состоянии PROBLEM, зависимый триггер не меняет состояние, и действия по нему не выполняются. Ключевое слово — «находится». Не «упадёт», не «упал в течение минуты», а именно уже находится в PROBLEM ровно в тот момент, когда сервер пересчитывает зависимый триггер.
Из этого вылезает вторая деталь, которую в мануале тоже написали прямым текстом, но её обычно пролистывают. Зависимый триггер пересчитывается не по таймеру и не по событию у родителя, а по приходу новой метрики для самого зависимого триггера. Документация оговаривает это применительно к восстановлению: после закрытия родительской проблемы дочерний триггер пересчитается только с получением новой метрики, поэтому обновление не обязано быть немедленным. Работает правило симметрично. Если дочерний триггер успел провалиться в PROBLEM раньше родителя — назад его никто не вернёт. Событие создано, действие сработало, письмо ушло. Зависимость потом честно свернёт всё это на дашборде, но почтовый ящик уже не разгрузишь.
И третье, самое обидное: в Zabbix нет зависимостей между хостами. Совсем. Ни в 7.4, ни в ветке 8.0, которая на сентябрь 2026 года всё ещё в бете (последняя в release notes — 8.0.0beta2 от 9 июля 2026; актуальный стабильный релиз 7.4 — 7.4.14 от 25 августа 2026). Напомню, что 7.4 — не LTS: вышла 30 июня 2025 года, а LTS-веткой остаётся 7.0 (7.0.30). Зависимости живут исключительно на уровне триггеров. Практический смысл в том, что связку «шлюз → два десятка хостов второго зала» вы строите не одной галочкой, а двадцатью связями триггер-триггер, и каждую из них надо чем-то порождать — шаблоном, LLD или API.
Правила связывания при этом ещё и несимметричные, и на этом спотыкаются при переносе конфигурации в шаблоны. Триггер шаблона может зависеть от триггера другого шаблона (тогда первый шаблон требует линковки второго) и может зависеть от триггера конкретного хоста. А вот наоборот — триггер хоста не может зависеть от триггера шаблона. Прототипы триггеров внутри одного правила LLD могут зависеть друг от друга и от обычных триггеров, но не от прототипов из другого правила обнаружения.
- Зависимость блокирует смену состояния дочернего триггера, а не отправку письма как таковую
- Проверяется состояние родителя в момент пересчёта дочернего триггера, не «за последние N минут»
- Пересчёт привязан к приходу новой метрики дочернего элемента данных
- Зависимостей хост→хост в Zabbix нет — ни в 7.4, ни в бете 8.0
- Триггер хоста не может зависеть от триггера шаблона — только наоборот
Арифметика гонки: почему второй зал кричит раньше шлюза
Возьмём стандартный шаблон ICMP Ping из поставки 7.4. Он предельно простой: три простых проверки — icmpping, icmppingloss, icmppingsec — с интервалом, прописанным прямо в элементах данных, и три триггера. Макросов у шаблона всего два, отдельного макроса под интервал опроса нет. Главный триггер выглядит так:
max(/ICMP Ping/icmpping,#3)=0Описание в шаблоне честное: «Last three attempts returned timeout». Тяжесть — High. Два оставшихся триггера (Warning), про потери пакетов и время отклика, уже зависят от него внутри самого шаблона:
min(/ICMP Ping/icmppingloss,5m)>{$ICMP_LOSS_WARN} and min(/ICMP Ping/icmppingloss,5m)<100
avg(/ICMP Ping/icmppingsec,5m)>{$ICMP_RESPONSE_TIME_WARN}
По умолчанию {$ICMP_LOSS_WARN} = 20, {$ICMP_RESPONSE_TIME_WARN} = 0.15.
Теперь считаем. Допустим, интервал опроса и у шлюза, и у всех хостов за ним — одинаковый, 60 секунд. Это ровно то, что получается, если навесить один и тот же шаблон на всё подряд, а так делают почти всегда. Три подряд неудачных опроса — значит, от момента реального обрыва до срабатывания триггера пройдёт от 120 до 180 секунд в зависимости от того, куда попал обрыв относительно фазы опроса конкретного хоста. Фазы у хостов разные: Zabbix размазывает опросы по интервалу, чтобы не долбить всё разом. И вот здесь возникает окно.
Пусть шлюз опрашивается в :00 каждой минуты, а сервер за ним — в :05. Канал падает в 09:14:02, то есть сразу после успешного опроса шлюза. Шлюз получит неудачи в 09:15:00, 09:16:00, 09:17:00 — триггер сработает в 09:17:00. Сервер получит неудачи в 09:14:05, 09:15:05, 09:16:05 — его триггер сработает в 09:16:05, на 55 секунд раньше родителя. В момент пересчёта серверного триггера родитель ещё в OK. Зависимость не применяется. Письмо уходит. Умножьте на два десятка хостов второго зала, у которых фазы разбросаны по всей минуте, — и вы получаете тот самый ящик из двадцати трёх писем, где авария по шлюзу приезжает где-то в середине пачки.
Максимальный разбег при одинаковых интервалах равен как раз одному интервалу опроса. То есть при 60-секундном шаблоне у вас есть окно шириной до 60 секунд, в которое улетает всё, что успело набрать свои три неудачи. Ровно этот эффект описал Olger Diekstra в разборе ICMP Rings в блоге Zabbix: устройство ниже по цепочке может набрать три неудачных опроса раньше вышестоящего и отправить уведомление до того, как зависимость вообще получит шанс сработать.
- Одинаковый интервал у родителя и детей = окно гонки шириной до одного интервала опроса
- Фаза опроса каждого элемента своя: Zabbix раскладывает проверки по интервалу, а не запускает их одновременно
- Зависимость проверяется в момент пересчёта дочернего триггера — «опоздавший» родитель уже ничего не отменит
- Увеличение числа проверок в триггере (#3 → #5) окно не закрывает, только сдвигает обе стороны
- Лечится разведением интервалов по уровням топологии и задержкой оповещения в действии
Разбор со стенда: коворкинг на 33 рабочих места
Клиент — коворкинг «Рабочее место Плюс»: 33 рабочих места в двух помещениях — основной зал с ресепшеном и второй зал с переговорными в соседнем корпусе. Между помещениями — IPsec поверх обычного провайдерского канала, во втором зале стоит небольшой Zabbix proxy на мини-ПК. В мониторинге 64 хоста: шлюзы, пять коммутаторов, девять точек Wi-Fi, три МФУ, двенадцать камер, контроллеры СКУД, NAS, ИБП и маленький гипервизор с виртуалками бронирования и контроллера Wi-Fi. Zabbix 7.4 на Debian 12. Канал между корпусами, скажем прямо, не идеальный: за квартал пять обрывов длительностью от двух до тридцати минут.
Пришли с формулировкой «мониторинг спамит, администратор перестал читать почту». Собрал статистику по одному обрыву: в 09:14 упал канал до второго зала, к 09:18 в канал оповещений улетело 23 уведомления. Из них 1 — про шлюз, 2 — про коммутаторы, 5 — про точки доступа, 8 — про камеры, 3 — про СКУД, 2 — про МФУ и 2 — про виртуалки. Зависимости в конфигурации БЫЛИ: предыдущий подрядчик аккуратно привязал триггеры хостов второго зала к триггеру шлюза. На дашборде всё сворачивалось идеально — одна авария High и остальное под ней. Спам при этом никуда не делся.
Первая же проверка объяснила всё. У всех 64 хостов, включая шлюз, был прилинкован один и тот же штатный ICMP Ping с интервалом 1m и триггером max(#3)=0. Никакой иерархии в интервалах. Плюс отдельная неприятность: часть хостов второго зала опрашивалась через тот самый прокси. При обрыве канала прокси не может отдать данные серверу, но сам продолжает опрашивать локальные железки — и после восстановления канала выгружает накопленную историю. Родительский триггер к этому моменту уже в OK, поэтому зависимость по такому пакету значений ничего не блокирует.
Что сделал по итогу: развёл интервалы по кольцам (об этом ниже), вынес доступность прокси в отдельное нулевое кольцо через внутренний элемент zabbix[proxy,<имя>,lastaccess] и — самое дешёвое и самое результативное — поставил операцию оповещения в действии на второй шаг эскалации с длительностью шага 3 минуты. На следующем обрыве, через девять дней, из второго зала приехало 2 письма: авария по шлюзу и авария по прокси. Остальные 21 событие отработали как надо — создались, свернулись под родителя на дашборде, закрылись при восстановлении, никого не разбудили.
- Было: 23 уведомления за обрыв, единый интервал 1m на 64 хостах, зависимости настроены и бесполезны
- Стало: 2 уведомления, лестница интервалов 30/40/53/71 c, оповещение на втором шаге эскалации через 3 минуты
- Побочный эффект: худшее время обнаружения аварии на нижнем уровне выросло со 180 до 213 секунд — клиент согласился
Кольца ICMP: развожу интервалы, а не количество проверок
Рабочий приём я взял из того самого разбора Diekstra и адаптировал под свои стенды. Идея в том, чтобы каждый следующий уровень топологии опрашивался РЕЖЕ предыдущего — настолько реже, чтобы вышестоящее устройство гарантированно успело набрать свои три неудачи первым. Формула у автора такая: берём интервал опроса вышестоящего кольца в секундах, умножаем на количество проверок в триггере плюс один, делим на три.
У Diekstra базовое кольцо — 60 секунд, и лестница получается 60 → 80 → 107 → 143 → 191. Ноль — внешний интерфейс файрвола, первое — внутренний интерфейс, второе — коммутаторы, третье — физические хосты, четвёртое — виртуалки на них. Я эту лестницу считаю слишком медленной для нижних уровней: 191 секунда на интервал означает до 573 секунд до срабатывания триггера, почти десять минут. Для сервера бронирования, без которого ресепшен не выдаёт гостям пропуска, это много. Поэтому базу беру 30 секунд:
# Ring 0 — шлюз/внешний интерфейс периметра
{$ICMP_UPDATE_INTERVAL} = 30s
# Ring 1 — внутренний интерфейс, ядро сети:  30*4/3
{$ICMP_UPDATE_INTERVAL} = 40s
# Ring 2 — коммутаторы доступа:               40*4/3
{$ICMP_UPDATE_INTERVAL} = 53s
# Ring 3 — серверы, NAS, ИБП, точки Wi-Fi:    53*4/3
{$ICMP_UPDATE_INTERVAL} = 71s
# Ring 4 — виртуалки, камеры, СКУД, МФУ:      71*4/3
{$ICMP_UPDATE_INTERVAL} = 95s
Важная оговорка: в штатном шаблоне ICMP Ping макроса {$ICMP_UPDATE_INTERVAL} нет — интервал зашит в элементы данных, и переопределить его обёрткой-линковкой не получится. Поэтому я делаю так: полный клон шаблона (Full clone) под именем, например, ICMP Ping Rings, где в поле Update interval всех трёх элементов вместо 1m стоит макрос {$ICMP_UPDATE_INTERVAL} — пользовательские макросы в интервале опроса поддерживаются. Дальше пять тонких шаблонов ICMP_Ring0 … ICMP_Ring4: каждый линкует клон и задаёт макрос своим значением (либо макрос задаётся на уровне группы хостов через скрипт API). Зависимости триггеров при этом всё равно нужны: кольца убирают гонку, но не сворачивают аварии в одну. Кольца дают гарантию порядка, зависимости — отсутствие действий по дочерним событиям.
Честно скажу, где решение спорное. Во-первых, это ручная топология: каждый новый хост надо положить в правильное кольцо, и даже на 64 хостах это дисциплина, а не автоматика. Я закрываю это group-based линковкой и проверкой раз в квартал. Во-вторых, лестница ломается на плоских сетях, где «шлюз» и «сервер» физически в одном свитче и падают одновременно по питанию — там кольца просто добавляют задержку без пользы. В-третьих, на нижнем кольце вы платите временем обнаружения. Считайте заранее и согласуйте цифру с клиентом, а не открывайте её постфактум в разборе инцидента.
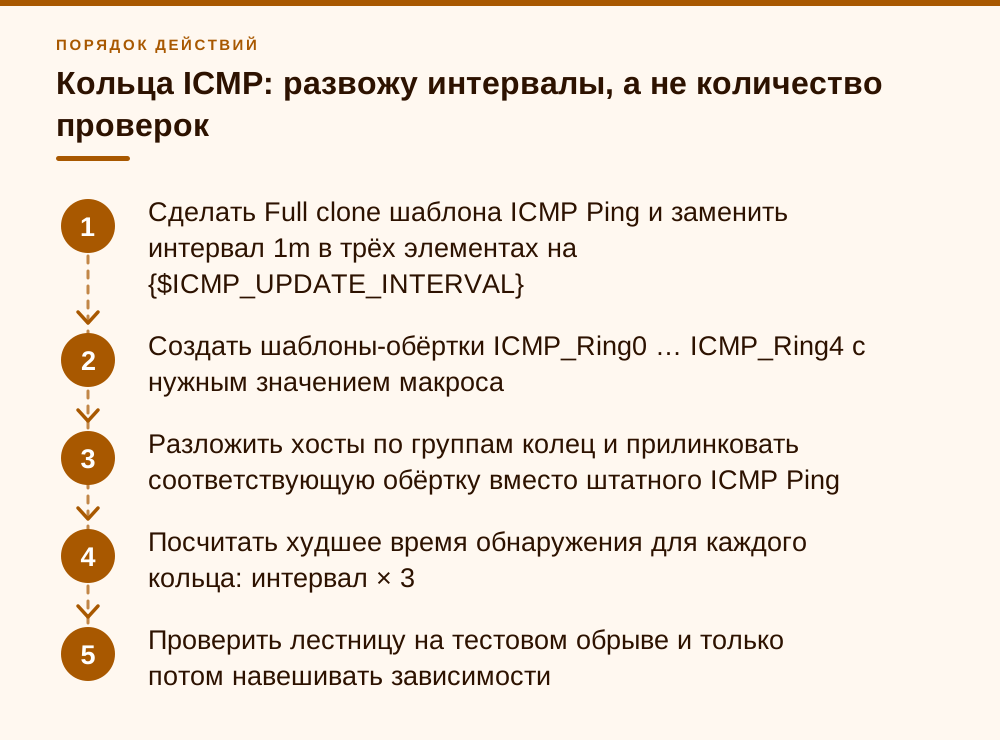
- Сделать Full clone шаблона ICMP Ping и заменить интервал 1m в трёх элементах на {$ICMP_UPDATE_INTERVAL}
- Создать шаблоны-обёртки ICMP_Ring0 … ICMP_Ring4 с нужным значением макроса
- Разложить хосты по группам колец и прилинковать соответствующую обёртку вместо штатного ICMP Ping
- Посчитать худшее время обнаружения для каждого кольца: интервал × 3
- Проверить лестницу на тестовом обрыве и только потом навешивать зависимости
Где ломается всё остальное: прокси, unreachable poller и агентские элементы
Кольца ICMP решают задачу для ping-проверок. Но у большинства хостов половина триггеров — не про ping, а про агента: место на диске, служба не запущена, nodata на ключевом элементе. И вот у них логика падения совсем другая, потому что в дело вступает механика недоступности интерфейса.
Когда опрос агентского интерфейса начинает валиться, Zabbix переводит его в состояние unreachable. По умолчанию UnreachableDelay = 15 секунд — с такой частотой идут повторные попытки; UnreachablePeriod = 45 секунд — через столько интерфейс объявляется недоступным; дальше UnavailableDelay = 60 секунд задаёт частоту проверок уже в состоянии unavailable. Касается это агентских, SNMP, IPMI и JMX-интерфейсов (с 6.2 — и активных проверок агента), но не ICMP simple checks. Практический вывод: агентские элементы отрезанного хоста живут в собственном ритме, никак не связанном с лестницей ICMP, а триггеры с nodata() и функциями даты/времени дополнительно пересчитываются каждые 30 секунд — независимо от того, пришло ли новое значение.
Что я с этим делаю. Триггеры типа nodata на хостах ниже нулевого кольца я не завожу как отдельные аварии — либо цепляю их зависимостью к ICMP-триггеру своего кольца и растягиваю окно до 10m, либо понижаю severity до Information и вывожу только на дашборд. Авария «нет данных с хоста» почти всегда дублирует «хост не пингуется», а в оставшихся случаях говорит о зависшем агенте, и это уже не High. Для хостов за прокси есть полезная деталь из документации: в режиме по умолчанию (nstrict) nodata() при недоступном прокси возвращает 0, пока последнее полученное от прокси значение остаётся в истории, — то есть сам по себе не устраивает шторм при обрыве канала. Режим "strict" это поведение отключает, и тогда nodata честно сработает на каждом отрезанном хосте.
Отдельная история — прокси. Если удалённая площадка стоит за Zabbix proxy, то при обрыве канала сервер перестаёт получать вообще всё с этой площадки, включая ICMP-проверки шлюза. Родительский триггер в такой схеме не сработает никогда, потому что метрика для него не придёт. Значит, нулевым кольцом должна быть не доступность шлюза, а доступность прокси, и меряется она внутренним элементом на самом сервере:
zabbix[proxy,<имя прокси>,lastaccess]Элемент возвращает Unix-время последнего heartbeat от прокси, поэтому триггер строится через fuzzytime или разницу с текущим временем, например fuzzytime(/Zabbix server/zabbix[proxy,Hall2,lastaccess],180)=0. Все ICMP-триггеры площадки вешаются зависимостью уже на него. И не забудьте про выгрузку накопленной истории после восстановления канала: родитель к этому моменту уже в OK, и зависимость такие события не остановит. Тут помогает только задержка оповещения, о которой ниже.
- UnreachableDelay = 15 c — период повторных попыток после первой ошибки
- UnreachablePeriod = 45 c — через столько интерфейс становится недоступным
- UnavailableDelay = 60 c — частота проверок в состоянии unavailable
- Для хостов за прокси nodata() в режиме по умолчанию не срабатывает, пока прокси недоступен и его последнее значение есть в истории
Самый дешёвый фикс, который стоит сделать первым
Если из всей статьи вы сделаете только одно — сделайте это. Сдвиньте оповещение в действии на время, заведомо превышающее ширину окна гонки. В настройках действия ставите Default operation step duration, скажем, 180 секунд (минимум — 60), а операцию оповещения размещаете не на шаге 1, а на шагах 2–2. Первые три минуты после появления события ничего не отправляется. За эти три минуты родительский триггер успевает свалиться в PROBLEM.
Почему это работает, видно прямо в исходниках эскалатора (src/zabbix_server/escalator/escalator.c, ветка release/7.4). Эскалатор просыпается каждые 3 секунды и перед выполнением шага проверяет зависимости триггера: если какой-то из родителей в PROBLEM, эскалация получает статус ZBX_ESCALATION_SKIP с комментарием «process escalation later» — шаг не выполняется и откладывается. Событие у дочернего хоста создастся в любом случае, но оповещение по нему будет стоять, пока родитель лежит. Нюанс: это отсрочка, а не отмена. Если родитель восстановился, а дочерний триггер так и остался в PROBLEM (хост реально сломан), письмо уйдёт — и это правильно.
Цена решения — три минуты задержки на ВСЕ уведомления, включая одиночные и важные. Для коворкинга на 33 места и большинства инфраструктур до 50 рабочих мест это приемлемо: разница между «узнать про упавший сервер в 09:14» и «в 09:17» на практике нулевая, а разница между двумя письмами и двадцатью тремя — колоссальная. Если для каких-то критичных хостов три минуты неприемлемы — заведите под них отдельное действие с условием по группе хостов и мгновенной отправкой, а общее действие оставьте с задержкой.
Второй инструмент — ранжирование проблем на причину и симптом (cause/symptom), появилось в 7.0. По умолчанию все новые проблемы классифицируются как cause, переназначить их симптомами можно вручную в Monitoring → Problems или через API. Только cause-проблемы учитываются в счётчиках карт и виджетов. В действии есть галка Pause operations for symptom problems — но она приостанавливает операции после первой, то есть первое письмо по симптому всё равно уйдёт. Для разбора инцидента полезно, как замена зависимостям — нет. Туда же — условие Problem is suppressed = no в действии и галка Pause operations for suppressed problems: они про обслуживание (maintenance), а не про зависимости. Плановые работы на шлюзе закрывайте maintenance на всю группу хостов второго зала — тогда проблемы подавляются, и шторма не будет даже без колец.
- Default operation step duration = 180 c, оповещение на шаге 2 — задержка первого письма
- Отдельное действие без задержки для 2–3 действительно критичных хостов (условие по группе)
- Условие Problem is suppressed = no и Pause operations for suppressed problems — для плановых работ через maintenance
- Pause operations for symptom problems — только как дополнение: первое письмо по симптому уходит
- Помнить: зависимость откладывает эскалацию, а не отменяет её
Чек-лист внедрения и на что можно забить
Собираю всё в порядок действий, который сам применяю на новом стенде. Сначала — карта. Не топология в Zabbix, а простой список: что от чего зависит физически. Шлюз, ядро, коммутаторы доступа, серверы, виртуалки. На полусотне хостов коворкинга это лист бумаги на двадцать минут, на четырёхстах — час с сетевиком клиента. Без этой карты всё остальное бессмысленно, потому что зависимости вы всё равно расставите наугад.
Дальше — действие с задержкой, оно даёт результат сразу и не требует переделки хостов. Потом кольца: клон ICMP Ping с макросом в интервале, пять шаблонов-обёрток, пять групп хостов, разложить. Потом зависимости триггеров — их удобнее всего нарезать через API скриптом, руками на двух десятках хостов вы устанете и ошибётесь. И только в конце — чистка производных триггеров: nodata, «служба не отвечает», «порт не слушается». Их обычно оказывается вдвое больше, чем ожидалось.
На что можно спокойно забить. Первое — на попытки построить идеальную иерархию колец для облачных и внешних сервисов: там у вас нет контроля над топологией, и лестница интервалов превращается в гадание. Достаточно одного кольца и зависимости от доступности интернета на периметре. Второе — на зависимости внутри одного физического ящика: если виртуалка и её гипервизор падают одновременно, разводить их по кольцам смысла нет, хватит обычной зависимости триггеров. Третье — на глобальную корреляцию событий: инструмент мощный, но для инфраструктуры до пятидесяти рабочих мест это из пушки по воробьям, отладка правил съест больше времени, чем сэкономит.
И последнее наблюдение из практики, которое стоит любых настроек. Шторм уведомлений почти всегда чинится не в Zabbix, а в голове: дежурный должен получать письма только про то, на что он может отреагировать прямо сейчас. Авария по камере в отрезанном втором зале в этот список не входит ни при каких настройках зависимостей. Если после всех правок у вас всё ещё двадцать писем — начните с вопроса «на какие из них кто-то реально пойдёт что-то делать», и половина триггеров уедет в Information без всякой лестницы интервалов.
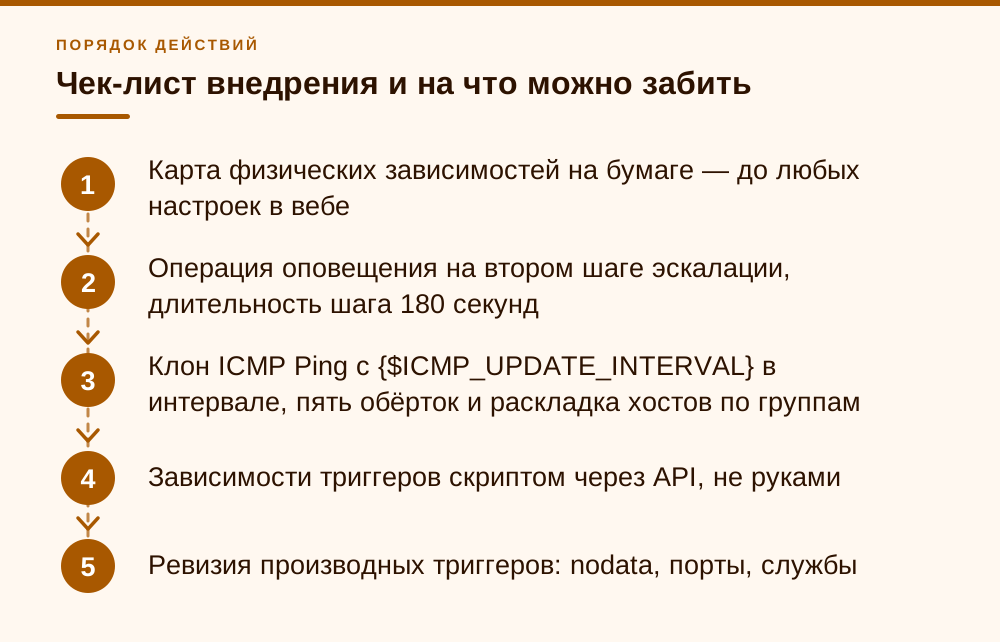
- Карта физических зависимостей на бумаге — до любых настроек в вебе
- Операция оповещения на втором шаге эскалации, длительность шага 180 секунд
- Клон ICMP Ping с {$ICMP_UPDATE_INTERVAL} в интервале, пять обёрток и раскладка хостов по группам
- Зависимости триггеров скриптом через API, не руками
- Ревизия производных триггеров: nodata, порты, службы
- Для площадок за прокси — корень зависимостей на zabbix[proxy,<имя>,lastaccess]
Частые вопросы
Можно ли в Zabbix 7.4 сделать зависимость одного хоста от другого целиком?
Нет. В Zabbix зависимости существуют только на уровне триггеров, зависимостей хост→хост нет ни в 7.4, ни в бете 8.0. На практике связку «шлюз → два десятка хостов второго зала» вы делаете двадцатью связями триггер-триггер, и порождать их удобнее скриптом через API или в шаблонах, а не руками в вебе. Помните ограничение: триггер хоста не может зависеть от триггера шаблона.
Почему дочерний триггер сработал, хотя родительский тоже в PROBLEM?
Почти наверняка дочерний триггер перешёл в PROBLEM раньше родителя. Условие зависимости проверяется в момент пересчёта дочернего триггера, и если в этот момент родитель ещё в OK — событие создаётся. Это не баг, а описанное в документации поведение. При одинаковых интервалах опроса окно равно одному интервалу. Лечится разведением интервалов по кольцам и переносом оповещения на второй шаг эскалации: пока родитель в PROBLEM, эскалатор откладывает шаги зависимого события.
Насколько вырастет время обнаружения аварии, если сделать лестницу интервалов?
Ровно на разницу интервалов, умноженную на число проверок в триггере. При базе 30 секунд и лестнице 30/40/53/71/95 нижнее кольцо срабатывает максимум через 285 секунд против 90 у нулевого. При классической базе 60 секунд из разбора Diekstra нижнее кольцо доходит до 573 секунд. Цифру надо считать заранее и согласовывать с заказчиком, а не объяснять постфактум.
Помогает ли пометка событий как cause/symptom вместо зависимостей?
Не заменяет. Ранжирование на причину и симптом появилось в 7.0: по умолчанию все проблемы — cause, симптомами их помечают вручную или через API. В действии есть опция Pause operations for symptom problems, но она приостанавливает операции после первой — первое письмо по симптому уйдёт. Как дополнение к зависимостям для разбора инцидента — полезно, как замена — нет.
Что делать с площадкой за Zabbix proxy — там вообще ничего не приходит при обрыве?
Именно так, и поэтому корнем зависимостей для такой площадки должен быть не ICMP-триггер шлюза, а триггер по внутреннему элементу zabbix[proxy,<имя>,lastaccess] на самом сервере (он возвращает время последнего heartbeat). nodata() в режиме по умолчанию при недоступном прокси не срабатывает. А после восстановления канала прокси выгрузит накопленную историю — родитель к тому моменту уже в OK, и спасает только задержка оповещения в действии.
Стоит ли переезжать на Zabbix 8.0 ради зависимостей?
На сентябрь 2026 года ветка 8.0 в бете (8.0.0beta2 от 9 июля), свежий стабильный релиз 7.4 — 7.4.14, LTS 7.0 — 7.0.30 (оба от 25 августа 2026). Принципиальных изменений в механике зависимостей триггеров в 8.0 не заявлено. Если на проде важна стабильность — сидите на LTS 7.0 или актуальном 7.4, а поведение зависимостей чините интервалами и эскалациями, а не апгрейдом.
Помогает ли maintenance, если работы на шлюзе плановые?
Да, и это самый чистый вариант. Заведите период обслуживания на группу хостов за шлюзом со сбором данных: проблемы будут подавлены (suppressed), а в действии поставьте условие Problem is suppressed = no или галку Pause operations for suppressed problems. Для внезапных обрывов maintenance не годится — там работают только кольца и задержка оповещения.
Источники
- Zabbix Documentation — Trigger dependencies — Официальный мануал Zabbix: пока родительский триггер в PROBLEM, зависимый не меняет состояние; пересчёт только по приходу новой метрики; ограничения для шаблонов. https://www.zabbix.com/documentation/current/en/manual/config/triggers/dependencies
- ICMP Rings for better Dependencies — Olger Diekstra, Zabbix Blog — Инженерный разбор гонки между дочерней и родительской проверкой и формула лестницы интервалов: интервал вышестоящего кольца × (число проверок + 1) ÷ 3. Пример лестницы 60 → 80 → 107 → 143 → 191 с. https://blog.zabbix.com/icmp-rings-for-better-dependencies/15157/
- Шаблон ICMP Ping, ветка release/7.4 — README официального шаблона ICMP Ping в ветке release/7.4: триггер max(/ICMP Ping/icmpping,#3)=0 (High), макросы {$ICMP_LOSS_WARN}=20 и {$ICMP_RESPONSE_TIME_WARN}=0.15, внутренние зависимости триггеров; макроса интервала опроса нет. https://github.com/zabbix/zabbix/blob/release/7.4/templates/net/icmp_ping/README.md
- Zabbix Documentation — Unreachability of host interfaces — Приложение к мануалу: UnreachableDelay (15 c), UnreachablePeriod (45 c), UnavailableDelay (60 c) для агентских, SNMP, IPMI и JMX-интерфейсов. https://www.zabbix.com/documentation/current/en/manual/appendix/items/unreachability
- Zabbix Documentation — Internal checks — Внутренние элементы данных: zabbix[proxy,<name>,lastaccess] — время последнего heartbeat от прокси; элементы proxy group. https://www.zabbix.com/documentation/7.4/en/manual/config/items/itemtypes/internal
- Zabbix Documentation — Escalations — Минимальная длительность шага эскалации 60 секунд, поведение при maintenance и Pause operations for suppressed problems. https://www.zabbix.com/documentation/current/en/manual/config/notifications/action/escalations
- Zabbix source — escalator.c (release/7.4) — check_escalation(): ZBX_ESCALATION_SKIP «one of trigger dependencies is in PROBLEM state, process escalation later», подавление эскалаций симптомов, CONFIG_ESCALATOR_FREQUENCY 3. https://github.com/zabbix/zabbix/blob/release/7.4/src/zabbix_server/escalator/escalator.c
- Zabbix Documentation 7.4 — History functions (nodata) — Режимы strict/nstrict и поведение nodata() для хостов за недоступным прокси. https://www.zabbix.com/documentation/7.4/en/manual/appendix/functions/history
- Zabbix Documentation — Cause and symptom problems — Классификация проблем на причину и симптом, по умолчанию все проблемы — cause. https://www.zabbix.com/documentation/current/en/manual/web_interface/frontend_sections/monitoring/problems/cause_and_symptom
- Zabbix Release Notes — 7.4.0 — 30.06.2025; 7.4.14 и 7.0.30 — 25.08.2026; 8.0.0beta2 — 09.07.2026. https://www.zabbix.com/release_notes