
Почему оба узла Keepalived стали MASTER, хотя ping работает
Знакомая картина: реальные адреса двух серверов пингуются, сервис Keepalived запущен, но один VIP обнаруживается сразу на обоих узлах. Администратор добавляет `nopreempt`, перезапускает демоны — и ничего принципиально не меняется. Я, Семёнов Евгений Сергеевич, обычно начинаю не с конфигурации приоритетов, а с проверки VRRP-пакетов в обе стороны. Ниже покажу, почему ICMP здесь почти ничего не доказывает, как за несколько минут локализовать разрыв и какую схему я оставляю в эксплуатации.
Ping проверяет не тот протокол
Если оба узла перешли в MASTER, я первым делом предполагаю потерю VRRP-объявлений. Не «сломанные приоритеты» и не мистическую ошибку Keepalived, а именно отсутствие нормального обмена. BACKUP не получает объявления действующего MASTER, выдерживает Master Down Interval и закономерно назначает VIP себе. Первый узел при этом продолжает считать себя MASTER. Получается split-brain: два независимых хозяина одного адреса.
Успешный ping между реальными адресами проверяет только прохождение ICMP Echo Request и Echo Reply. VRRP для IPv4 — отдельный IP-протокол с номером 112. Это не TCP и не UDP, поэтому открыть какой-нибудь «порт VRRP» невозможно. Стандартный VRRPv3 отправляет объявления на link-local multicast-адрес 224.0.0.18 с TTL 255. Современным нормативным документом является RFC 9568 от апреля 2024 года, который заменил RFC 5798. У unicast-режима Keepalived назначение другое, но номер IP-протокола остаётся 112.
Особенно обманчив ping самого VIP с одного из узлов. Когда адрес уже добавлен локально, ядро может ответить, вообще не отправляя пакет к соседу. Даже стабильный ping с третьей машины не оправдывает конфигурацию: ARP-запись клиента способна некоторое время указывать на один сервер, пока другие клиенты уже ходят на второй. В результате часть соединений работает, часть обрывается, а команда дежурного видит четыре красивых ответа ICMP и считает сеть исправной.
- ICMP между реальными IP подтверждает лишь базовую IP-доступность.
- VRRP multicast должен проходить внутри одного L2-сегмента.
- Для unicast оба узла должны отправлять и принимать IP protocol 112.
- Совпадение VIP, VRID и версии не заменяет доставку объявлений.
- Один VIP на двух интерфейсах — уже авария, даже если пользователи пока не жалуются.
Как я подтверждаю split-brain за десять минут
Сначала отделяю состояние демона от состояния ядра. В журнале ищу переходы Entering MASTER STATE, затем проверяю наличие адреса на каждом сервере. Если оба журнала говорят MASTER и ip показывает VIP на обоих интерфейсах, это настоящий dual-active. Если Keepalived на одном узле пишет BACKUP, но VIP там остался, причина другая: адрес добавлен статически, сторонним скриптом или не был убран после нештатной операции.
Базовый набор команд запускаю на обоих узлах почти одновременно. Интерфейс и адрес, конечно, подставляю из проекта:
keepalived --version
systemctl status keepalived --no-pager
journalctl -u keepalived --since '-15 min' --no-pager
ip -br -4 address show dev ens192
sudo timeout 12 tcpdump -ni ens192 -e -vvv 'ip proto 112'
При advert_int 1 за 12 секунд должен появиться не один случайный пакет, а устойчивая последовательность примерно раз в секунду. В выводе смотрю источник, назначение, TTL, версию VRRP, VRID и priority.
Захват нужен с двух сторон. Если узел A отправляет объявления, а на B их нет, и наоборот, проблема лежит между интерфейсами: VLAN, multicast-фильтрация, distributed firewall, security group, ACL или виртуальный коммутатор. Если B видит кадр через tcpdump, но Keepalived на него не реагирует, проверяю локальный firewall и параметры пакета. Захватчик видит кадр раньше части сетевой обработки ядра, поэтому наличие строки в tcpdump ещё не доказывает, что пакет дошёл до VRRP-сокета.
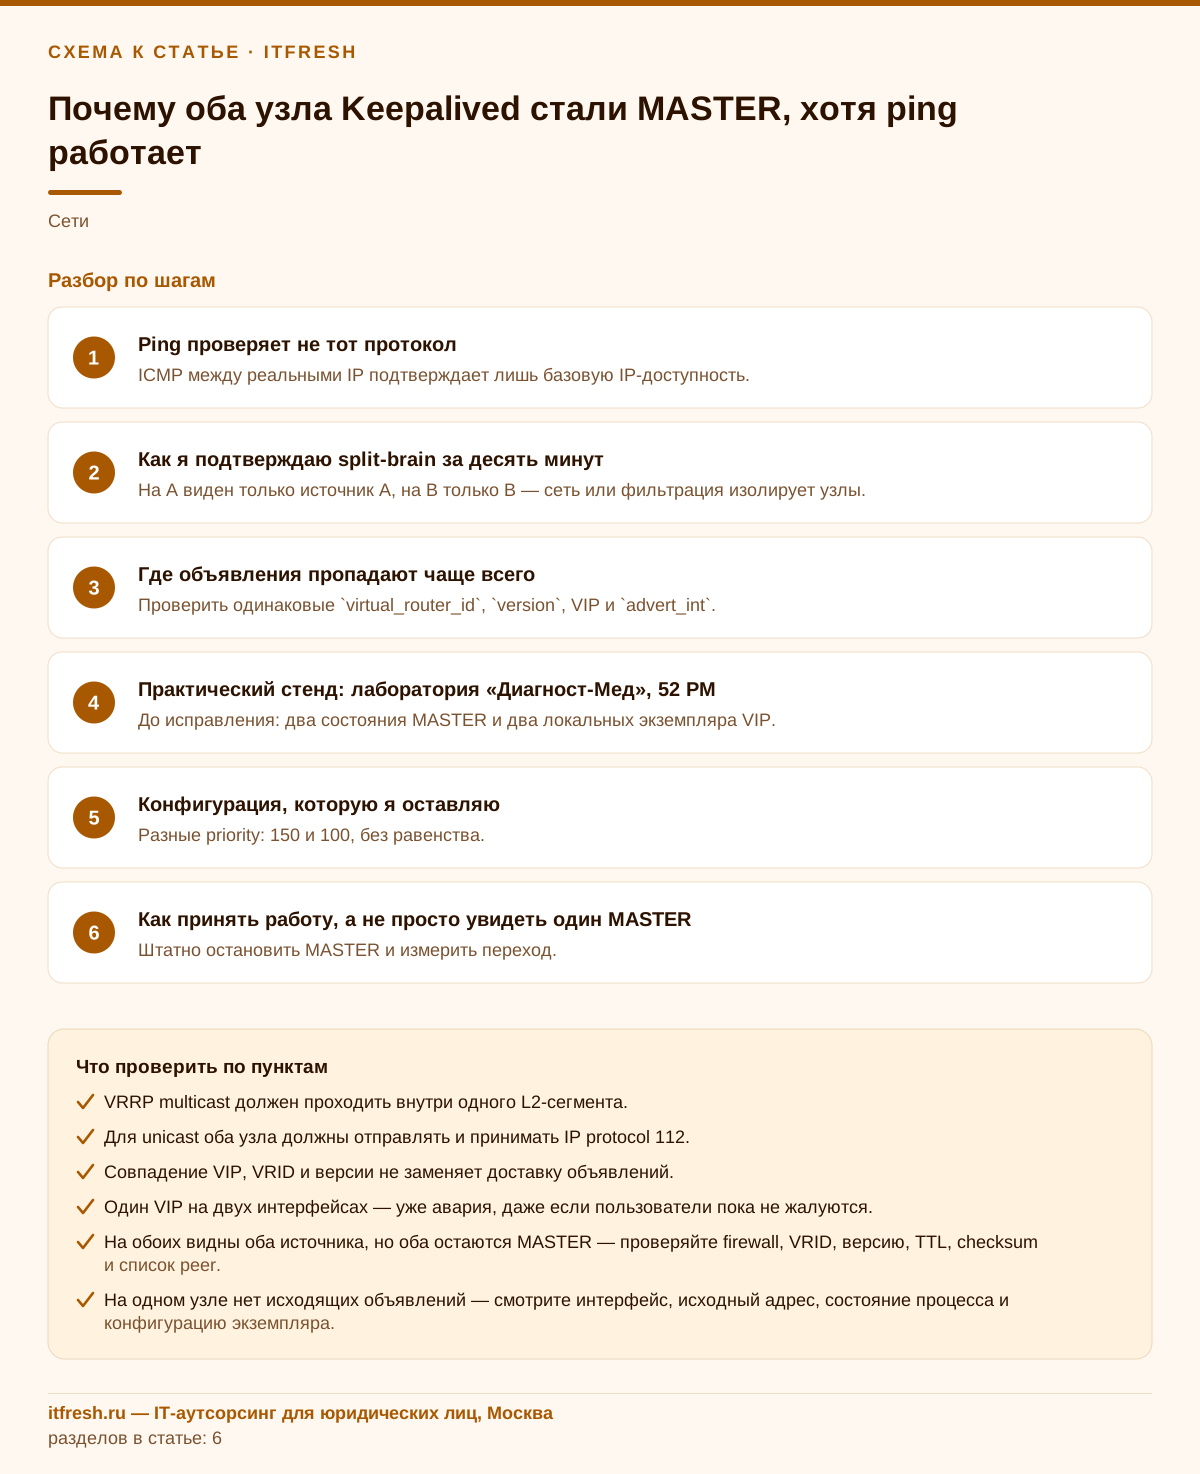
- На A виден только источник A, на B только B — сеть или фильтрация изолирует узлы.
- На обоих видны оба источника, но оба остаются MASTER — проверяйте firewall, VRID, версию, TTL, checksum и список peer.
- На одном узле нет исходящих объявлений — смотрите интерфейс, исходный адрес, состояние процесса и конфигурацию экземпляра.
- В журналах BACKUP, но VIP есть на интерфейсе — ищите статический адрес или стороннюю автоматизацию, а не split-brain VRRP.
Где объявления пропадают чаще всего
На физических коммутаторах чаще всего виноваты неверный VLAN, port isolation, ACL для IP protocol 112 или неудачная multicast-политика. В виртуальной среде добавляются распределённый firewall, правила security group и ограничения облачной сети. Некоторые платформы вообще не обещают L2 multicast. Там я сразу выбираю unicast Keepalived, если сама платформа разрешает плавающий адрес и L2/L3-модель этого решения. Просто заменить multicast на unicast, не сверившись с устройством сети, тоже нельзя.
В облаках и на части гипервизоров multicast режется ещё до гостевой ОС. Публичные облака, как правило, не передают multicast между виртуальными машинами, а виртуальные коммутаторы с включёнными фильтрами MAC/multicast или IGMP snooping без querier тихо отбрасывают кадры на 224.0.0.18. Симптом одинаковый: каждый узел отправляет объявления, но на соседе захват пуст. В такой среде я не спорю с платформой, а перевожу пару на unicast_src_ip и unicast_peer, предварительно убедившись, что облако вообще позволяет переносить VIP между интерфейсами — иначе адрес переезжает только через API провайдера, и VRRP здесь не поможет.
На Linux-хосте типовой промах выглядит скучно: политика INPUT — drop, ICMP разрешён отдельным правилом, TCP-порты сервиса тоже разрешены, а протокол 112 забыли. Поэтому ping проходит идеально. Я просматриваю полный ruleset с handle и счётчиками:
sudo nft -a list ruleset
sudo iptables-save
Если используется unicast, разрешаю VRRP только от реального адреса второго узла и, при фильтрации OUTPUT, симметрично наружу. Временное правило годится для доказательства причины, но постоянное изменение вношу в управляемый ruleset или Ansible, иначе следующий reload всё сотрёт.
Ещё одна группа причин — узлы получают пакеты, но считают их чужими или недействительными. На обоих должны совпадать address family, virtual_router_id, версия VRRP, набор VIP и интервал объявлений. В unicast-конфигурации адрес локального unicast_src_ip должен существовать, а в unicast_peer должен быть настоящий адрес соседа. Опция check_unicast_src полезна: она не позволяет принимать объявления от незаявленного источника. Для пары на одном VLAN я также фиксирую TTL 255 и проверяю его на приёме.
Нехватка CPU и длинная пауза планировщика действительно могут задержать Keepalived, особенно в перегруженной VM. Но это обычно даёт кратковременное переключение, а не устойчивые два MASTER при нормальном обмене. Я проверяю scheduler и загрузку после сети, а не до неё. Сначала смотрю фактические объявления — это быстрее и почти всегда приводит к причине.
Отдельно проверяю расхождения, при которых пакеты доходят, но отбрасываются. Разные virtual_router_id означают для Keepalived два независимых виртуальных роутера: каждый честно становится MASTER своего экземпляра, а VIP оказывается на обоих. Несовпадение блока authentication (auth_type/auth_pass) или ключей auth_hmac приводит к тому же результату — объявления соседа отвергаются, и в журнале обычно видно сообщение о неверной аутентификации или неизвестном VRID. Ещё один источник ложного MASTER — track_script: если скрипт проверки на одном узле постоянно падает (нет прав, неверный путь, enable_script_security без script_user), приоритет снижается или экземпляр уходит в FAULT, и картина переключений становится непредсказуемой. Сам по себе track_script не создаёт два MASTER, но маскирует настоящую причину.
Для multicast-схемы на хосте с политикой drop разрешение выглядит так — отдельно для nftables и для классического iptables; цепочку подставьте из своего ruleset:
# nftables
sudo nft insert rule inet filter input ip daddr 224.0.0.18 ip protocol vrrp counter accept comment "VRRP multicast"
# iptables
sudo iptables -I INPUT -p 112 -d 224.0.0.18 -j ACCEPT
# firewalld
sudo firewall-cmd --permanent --add-rich-rule='rule protocol value="vrrp" accept'
sudo firewall-cmd --reload
Счётчик counter сразу показывает, начали ли пакеты попадать в правило. Если счётчик растёт, а узлы всё ещё оба MASTER, причина уже не в firewall, а в параметрах экземпляра.
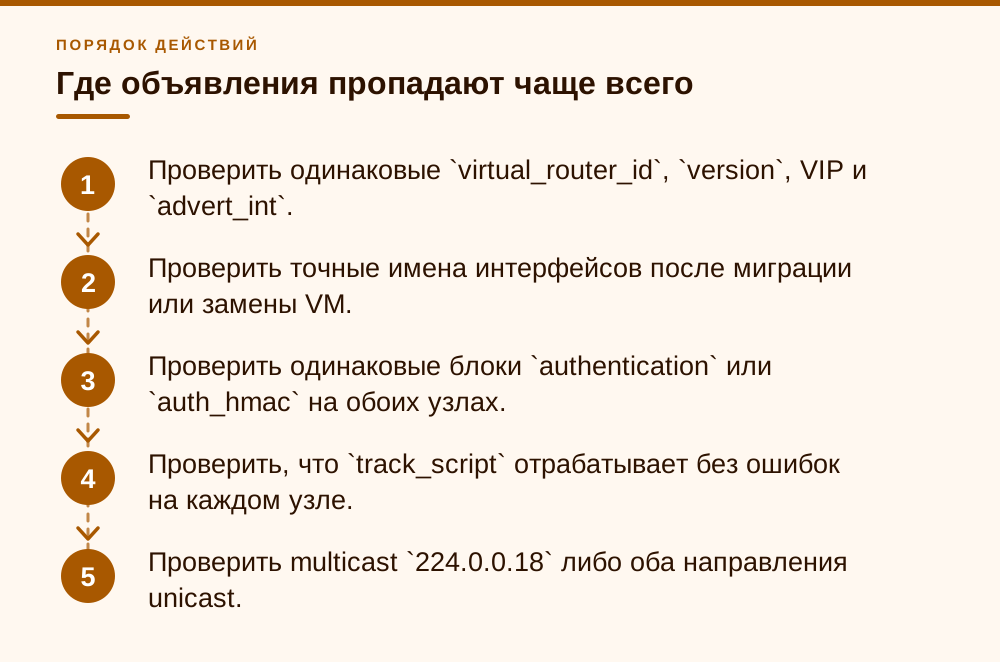
- Проверить одинаковые `virtual_router_id`, `version`, VIP и `advert_int`.
- Проверить точные имена интерфейсов после миграции или замены VM.
- Проверить одинаковые блоки `authentication` или `auth_hmac` на обоих узлах.
- Проверить, что `track_script` отрабатывает без ошибок на каждом узле.
- Проверить multicast `224.0.0.18` либо оба направления unicast.
- Проверить INPUT и OUTPUT в nftables, iptables, firewalld и внешнем firewall.
- Исключить дублирующий VRID от третьего устройства в том же сегменте.
- Сверить время события с reload firewall, переносом VLAN и изменением security policy.
Практический случай: компьютерная школа «Клавиатура и класс», 49 РМ
Название школы условное; схема и последовательность работ взяты из моей практики без раскрытия заказчика. В компьютерной школе «Клавиатура и класс» 49 рабочих мест: четыре учебных класса, преподавательская и администрация. Внутренний учебный портал и сервер заданий стояли за двумя виртуальными балансировщиками lb01 и lb02, по 2 vCPU, 2 Гбайт RAM и одному интерфейсу 1 Гбит/с. Оба работали на Debian 12 с пакетным Keepalived 2.2.7. Реальные адреса — 10.20.49.11/24 и 10.20.49.12/24, VIP портала — 10.20.49.20/24, VRID 49. Приоритеты 150 и 100, advert_int 1. Для этой нагрузки ресурсы были с большим запасом; добавлять CPU ради VRRP не требовалось.
После переноса VLAN на новый хост виртуализации оба узла оказались MASTER. Ping между .11 и .12 не терялся, доступ по SSH работал. Во время занятия в двух классах за 14 минут у девяти учеников появились плавающие ошибки входа на портал: новый TCP-сеанс попадал то на один балансировщик, то на другой, и сессия терялась посреди контрольной. В ARP-кэшах разных компьютеров VIP соответствовал разным MAC-адресам. Дежурный добавил nopreempt на резервный узел и перезапустил Keepalived. Это не помогло — резервный по-прежнему не слышал MASTER и после тайм-аута назначал адрес себе.
Мы одновременно запустили tcpdump на двух VM. Каждый узел исправно отправлял VRRP, а захват на принимающей стороне видел пакеты второго узла. Затем проверили nftables: шаблон hardening разрешал ct state established,related, ICMP, SSH и HTTPS, после чего цепочка INPUT завершалась политикой drop. Разрешения для IP protocol 112 в шаблоне не было. Именно поэтому ping создавал ложное ощущение исправности, а Keepalived не получал объявления из сетевого стека.
Я сначала остановил Keepalived на резервном узле, чтобы убрать второй VIP и прекратить ARP-качели. Затем мы добавили двустороннее разрешение protocol 112 только между .11 и .12. Заодно перевели пару на явный unicast: для управляемой пары VM он проще в диагностике и не зависит от multicast-политики виртуальной сети. После проверки конфигурации последовательно запустили узлы. При аварийном исчезновении MASTER резерв с priority 100 принимал VIP примерно за 3,6 секунды — это ровно 3 × advert_int + (256 − 100)/256; при штатной остановке с объявлением priority 0 — заметно быстрее. За следующую учебную неделю синтетическая проверка не зафиксировала ни одного обрыва, а из шаблона firewall сделали отдельный тест.
- До исправления: два состояния MASTER и два локальных экземпляра VIP.
- Причина: INPUT drop пропускал ICMP, но не IP protocol 112.
- Немедленное действие: остановить Keepalived на выбранном резервном узле.
- Постоянное решение: адресные правила firewall, unicast peer и двусторонний тест.
- Результат: предсказуемое переключение и отсутствие самопроизвольного возврата VIP.
Конфигурация, которую я оставляю
Для такой двухузловой виртуальной пары я выбираю unicast. Это расширение Keepalived, а не стандартный режим взаимодействия любых VRRP-реализаций, и я говорю об этом прямо. Зато peer задан явно, источник легко ограничить firewall, а диагностика не зависит от IGMP snooping. На обычной физической LAN без ограничений multicast стандартная схема тоже нормальна — переделывать её только ради моды не нужно.
На lb01 конфигурация выглядела так:
vrrp_script chk_nginx {
    script "/usr/bin/systemctl is-active --quiet nginx"
    interval 2
    fall 2
    rise 2
}

vrrp_instance VI_WEB {
    state BACKUP
    interface ens192
    version 3
    virtual_router_id 49
    priority 150
    advert_int 1
    nopreempt

    unicast_src_ip 10.20.49.11
    check_unicast_src
    unicast_ttl 255
    unicast_peer {
        10.20.49.12 min_ttl 255 max_ttl 255
    }

    track_script {
        chk_nginx
    }

    virtual_ipaddress {
        10.20.49.20/24 dev ens192
    }
}
На lb02 меняются unicast_src_ip на 10.20.49.12, peer на 10.20.49.11, а priority — на 100. VRID, версия, интервал и VIP остаются одинаковыми. Ограничение TTL 255 здесь уместно, потому что peer находится в одном L2-сегменте. Для маршрутизируемого unicast такой предел применять вслепую нельзя: каждый L3-переход уменьшает TTL.
Блок vrrp_script с track_script здесь проверяет не соседа, а собственный сервис: если nginx на узле остановлен, экземпляр без weight уходит в FAULT и снимает VIP, а BACKUP получает роль. Скрипт должен быть быстрым и отрабатывать без ошибок под пользователем, заданным в global_defs (script_user, enable_script_security), иначе Keepalived отключит проверку или будет считать её проваленной. Сначала я запускаю ту же команду вручную и смотрю код возврата, а уже потом доверяю журналу переключений.
Оба узла стартуют из BACKUP, потому что это требуется для корректной работы nopreempt. Опция означает только одно: узел с более высоким priority не отберёт роль у уже работающего MASTER с меньшим priority. Она не является heartbeat, не проверяет соседа и не блокирует назначение VIP после истечения таймера. Если объявления недоступны, каждый BACKUP в конце концов станет MASTER независимо от nopreempt. Более того, находясь в MASTER, узел при разрешении конфликта руководствуется полученными объявлениями и приоритетами, а не превращает nopreempt в вечную блокировку.
Для unicast правило на lb01 разрешает источник .12, а на lb02 — источник .11. Конкретная цепочка зависит от вашего ruleset, поэтому ниже именно диагностический пример, а не универсальный файл firewall:
sudo nft insert rule inet filter input ip saddr 10.20.49.12 ip daddr 10.20.49.11 ip protocol 112 counter accept comment "VRRP from lb02"После подтверждения я переношу правило в постоянную конфигурацию. Если OUTPUT фильтруется, добавляю зеркальное разрешение. У VRRP снова нет портов: правило с tcp dport 112 или udp dport 112 работать не будет.
- Разные priority: 150 и 100, без равенства.
- Одинаковые VRID 49, VRRPv3, VIP и `advert_int`.
- Начальное состояние BACKUP на обоих узлах при `nopreempt`.
- Явные и взаимные `unicast_src_ip` и `unicast_peer`.
- Адресное разрешение IP protocol 112 в обе стороны.
- `track_script` проверяет локальный сервис и отлажен вручную до включения.
Как принять работу, а не просто увидеть один MASTER
После исправления я наблюдаю захват не меньше минуты. На BACKUP должны регулярно приходить объявления MASTER с правильными VRID и priority. Затем проверяю три сценария: штатная остановка активного демона, аварийная потеря узла и возвращение узла с более высоким приоритетом. При advert_int 1 аварийное переключение обычно укладывается примерно в 3–4 секунды; точное время зависит от priority и формулы таймера. Обещать строго три секунды неправильно.
Тестирую с третьей машины, а не только между балансировщиками. Запускаю непрерывный прикладной запрос к VIP, фиксирую MAC и одновременно смотрю журналы обоих узлов:
while true; do date +%T.%3N; curl -fsS --connect-timeout 1 http://10.20.49.20/health || echo FAIL; sleep 0.2; doneСначала останавливаю действующий MASTER через systemctl stop keepalived, затем запускаю его обратно. С nopreempt вернувшийся высокоприоритетный узел должен остаться BACKUP. После этого останавливаю текущий MASTER и убеждаюсь, что первый сервер принимает VIP. Финальный тест — оставить ICMP доступным, временно заблокировать именно protocol 112 и проверить, что мониторинг действительно обнаружит dual-active.
На сентябрь 2026 года актуальный upstream-релиз Keepalived — 2.4.3 (тег от 20 июля 2026 года). Это не означает, что любой стабильный дистрибутив надо немедленно переводить на самосборный пакет: версия 2.2.7 в Debian 12 остаётся нормальной для описанной базовой схемы. Но функции и синтаксис всегда сверяйте с локальным keepalived --version и man keepalived.conf именно установленного пакета — например, auth_hmac появился только в 2.4.0 и в 2.2.7 его нет. Если используете auth_hmac, учитывайте изменения 2.4.3: там исправлено восстановление счётчика последовательности после коррекции часов и истечение отметок anti-replay, а при anti_replay time узлам нужен синхронный NTP — иначе сосед отбрасывает объявления, и пара снова уходит в dual-active.
В мониторинге мне важны не только доступность VIP и статус systemd. Я собираю состояние роли с обоих узлов, наличие VIP, переходы MASTER/BACKUP/FAULT и отсутствие входящих объявлений дольше расчётного интервала. Алерт «оба MASTER» должен быть отдельным и громким. На проверку обычного ping можно почти забить: как дополнительный сигнал он полезен, но для здоровья VRRP недостаточен.
- Штатно остановить MASTER и измерить переход.
- Имитировать исчезновение узла без корректного shutdown.
- Вернуть высокоприоритетный узел и проверить действие `nopreempt`.
- Проверить непрерывный HTTP-запрос и ARP/MAC с третьего хоста.
- Убедиться, что мониторинг видит две роли MASTER одновременно.
- Сохранить эталонный `tcpdump` исправного обмена для следующего инцидента.
Частые вопросы
Почему Keepalived не использует ping второго узла как heartbeat?
Потому что выбор MASTER выполняется по VRRP Advertisement, а не по ICMP. Узел может отвечать на ping и одновременно не получать IP protocol 112.
Поможет ли `nopreempt`, если VRRP-пакеты заблокированы?
Нет. `nopreempt` запрещает высокоприоритетному BACKUP отбирать роль у доступного MASTER, но для этого его объявления сначала надо получить. Без связи оба узла по таймеру становятся MASTER.
Какой порт нужно открыть для VRRP?
Никакой. VRRP использует отдельный IP-протокол 112. Для multicast IPv4 стандартное назначение — `224.0.0.18`; в unicast Keepalived назначением служит адрес peer.
Почему tcpdump видит объявления, а Keepalived остаётся MASTER?
Пакет может быть захвачен на интерфейсе, а затем отброшен firewall или самим Keepalived из-за VRID, версии, TTL, checksum либо неверного unicast-источника. Сопоставьте захват с журналом и ruleset.
Стоит ли всегда переходить с multicast на unicast?
Нет. Для управляемой пары VM я выбираю unicast из-за явных peer и простой фильтрации. В стандартной физической LAN multicast короче и обеспечивает совместимость с другими VRRP-реализациями.
Можно ли настроить оба узла с `state MASTER`?
Технически начальное состояние допустимо, но для схемы с `nopreempt` документация требует старт не из MASTER. Я задаю BACKUP обоим, а победителя определяю разными priority.
Может ли split-brain быть вызван разными virtual_router_id или паролем?
Да. При разных `virtual_router_id` узлы участвуют в разных виртуальных роутерах и каждый становится MASTER своего экземпляра. При несовпадении `auth_pass` или ключей `auth_hmac` объявления соседа отбрасываются. Сверяю эти параметры в конфигурации обоих узлов и ищу в журнале сообщения об ошибке аутентификации.
Источники
- RFC Editor — RFC 9568, Virtual Router Redundancy Protocol (VRRP) Version 3 for IPv4 and IPv6, апрель 2024 (заменяет RFC 5798): протокол 112, 224.0.0.18, TTL 255, Active_Down_Interval и Skew_Time: https://www.rfc-editor.org/rfc/rfc9568.html
- Keepalived Core Team — man keepalived.conf(5): vrrp_instance — state, priority, nopreempt («the initial state must not be MASTER»), unicast_src_ip, unicast_peer с min_ttl/max_ttl, check_unicast_src, unicast_ttl, authentication, auth_hmac, track_script: https://www.keepalived.org/manpage.html ; исходник страницы: https://github.com/acassen/keepalived/blob/master/doc/man/man5/keepalived.conf.5.in
- Keepalived Core Team — Релиз keepalived 2.4.3 (тег v2.4.3, 20.07.2026), исправления auth_hmac после коррекции часов: https://github.com/acassen/keepalived/releases/tag/v2.4.3 ; сводные release notes: https://www.keepalived.org/release-notes/
- Debian Project — Пакет keepalived для Debian 12 Bookworm, версия 1:2.2.7-1+b2: https://packages.debian.org/bookworm/keepalived