
Два гигабитных порта в LACP, а файл идёт на 1 Гбит/с
В интерфейсе bond честно видны два активных гигабитных порта, а копирование большого файла упирается примерно в 110–115 МБ/с. Знакомая картина. Я, Семёнов Евгений Сергеевич, разбирал такие обращения не раз, и обычно оборудование исправно: от LACP просто ждут того, чего он не обязан делать. Покажу, где проходит предел одного потока, как проверить оба направления и как отличить нормальное поведение от неправильного распределения трафика.
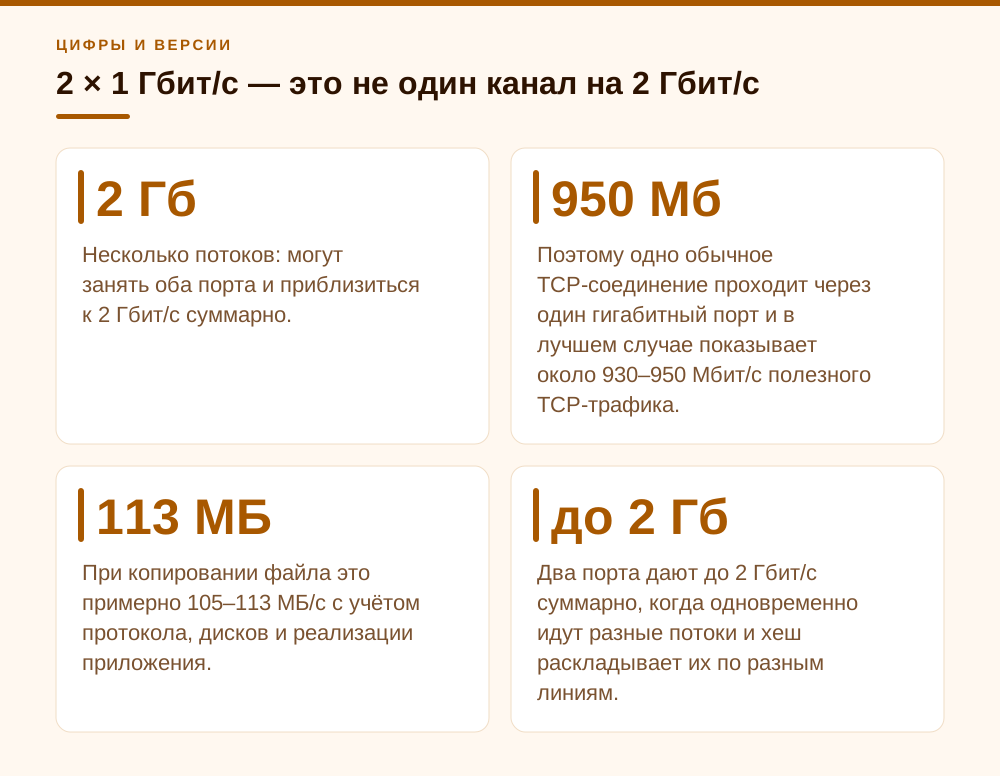
2 × 1 Гбит/с — это не один канал на 2 Гбит/с
LACP объединяет физические линии в логический агрегат, но не склеивает их побитно. Перед отправкой устройство вычисляет хеш по полям кадра или пакета и закрепляет поток за одним участником агрегата. Это сохраняет порядок кадров. Поэтому одно обычное TCP-соединение проходит через один гигабитный порт и в лучшем случае показывает около 930–950 Мбит/с полезного TCP-трафика. При копировании файла это примерно 105–113 МБ/с с учётом протокола, дисков и реализации приложения.
Два порта дают до 2 Гбит/с суммарно, когда одновременно идут разные потоки и хеш раскладывает их по разным линиям. Например, два пользователя могут получать с файлового сервера по 110 МБ/с каждый. Но один пользователь с одним TCP-соединением быстрее не поедет. Даже восемь соединений не гарантируют идеальные 50 на 50: хеш детерминированный, а совпадения возможны. Чем больше независимых потоков и адресов, тем ровнее статистика.
Есть исключение, которое часто запутывает картину. SMB Multichannel, NFS с nconnect и iSCSI с MPIO создают несколько TCP-соединений или сессий для одной логической операции. Тогда одна задача действительно может использовать суммарную ёмкость нескольких линий. Microsoft в документации по SMB Multichannel прямо пишет: без Multichannel одна SMB-сессия через два адаптера 1GbE не даст 2 Гбит/с, а поверх NIC teaming SMB создаёт лишь одно TCP-соединение на команду. Это заслуга прикладного протокола, а не способность LACP разделить единственный TCP-поток. В документации Linux bonding единственным режимом, который раскладывает одно TCP-соединение по нескольким интерфейсам, назван balance-rr — и к 802.3ad он отношения не имеет.
- Один TCP-поток: максимум примерно одного физического порта.
- Несколько потоков: могут занять оба порта и приблизиться к 2 Гбит/с суммарно.
- Отказ одного кабеля: агрегат продолжит работать с пропускной способностью оставшегося порта.
- Полный дуплекс не превращает 2 × 1 Гбит/с в «4 Гбит/с для файла».
Порт выбирают две стороны, и это важно
У агрегата два независимых распределителя. Когда сервер отправляет данные, физический порт выбирает Linux bonding. Когда сервер принимает данные, участника LAG выбирает коммутатор. Их алгоритмы не обязаны совпадать. Изменить xmit_hash_policy на сервере и ждать, что входящий трафик тоже перераспределится, — типичная ошибка. Для загрузки на сервер надо смотреть хеш и счётчики именно коммутатора.
Политика layer2 учитывает MAC-адреса. Между сервером и одним шлюзом или одним тестовым узлом все потоки легко оказываются на одной линии. layer2+3 добавляет IP-адреса и лучше работает со множеством клиентов, но несколько соединений между одной парой IP всё равно имеют одинаковый набор признаков. layer3+4 добавляет TCP- или UDP-порты, поэтому разные соединения одной пары узлов могут попасть на разные физические порты.
Для обычного файлового сервера я выбираю layer3+4: именно он даёт полезное распределение множества TCP-соединений. Говорю честно — документация ядра помечает этот алгоритм как не полностью совместимый с требованиями 802.3ad для редкого случая, когда один разговор содержит фрагментированные и нефрагментированные пакеты. В нормальной локальной сети с MTU 1500, исправным PMTUD и TCP без IP-фрагментации риск невелик. Если оборудование старое или регламент требует строгого соответствия, выбираю layer2+3 и принимаю менее гибкое распределение. Заодно помню про дефолты драйвера: без явного указания xmit_hash_policy равен layer2, lacp_rate — slow (LACPDU раз в 30 секунд), а fast просит партнёра слать их каждую секунду.
- Исходящий с Linux трафик проверяйте по `eno1` и `eno2`.
- Входящий трафик проверяйте по физическим портам коммутатора.
- Хеш определяет размещение потока, но не ограничивает его скорость дополнительно.
- `lacp-rate: fast` ускоряет обнаружение проблем, а не передачу данных.
Как я проверяю LACP до измерения скорости
Сначала убеждаюсь, что это действительно один агрегатор, а не два интерфейса, один из которых просто показывает carrier. В Linux файл /proc/net/bonding/bond0 должен показывать Bonding Mode: IEEE 802.3ad Dynamic link aggregation, нужную Transmit Hash Policy, у обоих участников MII Status: up и одинаковый Aggregator ID. На современных ядрах там же выводятся детали LACP: port state у actor и partner. Значение 61 означает, что выставлены биты Activity, Aggregation, Synchronization, Collecting и Distributing; при lacp_rate fast добавляется бит короткого таймаута и получается 63. Скорость и duplex проверяю отдельно через ethtool. Одинаковая индикация линка ещё не доказывает правильное согласование LACP.
Базовый набор команд у меня короткий. Я сохраняю вывод до теста, запускаю нагрузку и повторяю команды после него. Так видно не мигающие цифры, а точную дельту байтов:
cat /proc/net/bonding/bond0
ip -s link show dev eno1
ip -s link show dev eno2
ethtool eno1 | grep -E 'Speed|Duplex|Link detected'
ethtool eno2 | grep -E 'Speed|Duplex|Link detected'
Если у участников разные Aggregator ID, port state одного из них не содержит бит Distributing или растёт Link Failure Count, обсуждать хеш рано. Сначала исправляю LACP, VLAN, кабель, модуль либо настройки порта.
На MikroTik проверяю состояние самого bond и счётчики каждого порта. Оба участника должны быть активными. Затем смотрю прирост RX и TX во время одно- и многопоточного тестов:
/interface bonding monitor bond-srv once
/interface bonding monitor-slaves bond-srv
/interface ethernet print stats where name=ether23
/interface ethernet print stats where name=ether24
На коммутаторах других производителей ищу те же сущности: partner system ID, actor/partner key, collecting/distributing и per-port counters. Названия команд меняются, смысл — нет.
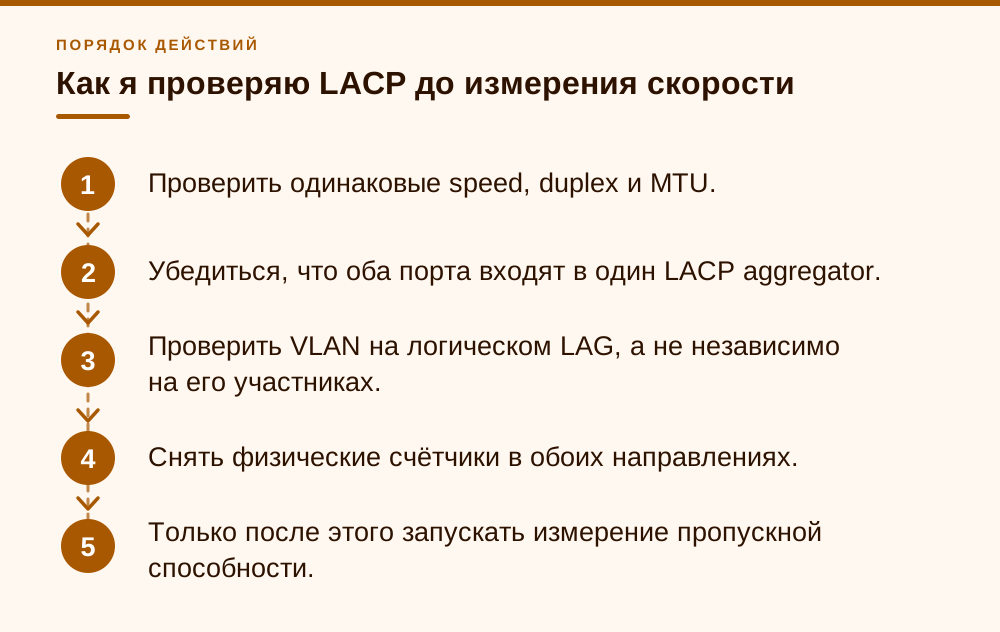
- Проверить одинаковые speed, duplex и MTU.
- Убедиться, что оба порта входят в один LACP aggregator.
- Проверить VLAN на логическом LAG, а не независимо на его участниках.
- Снять физические счётчики в обоих направлениях.
- Только после этого запускать измерение пропускной способности.
Кейс «КожевенныйЦех»: где спряталась вторая линия
Название «КожевенныйЦех» условное; это типовой проект без раскрытия реального клиента. На кожевенном производстве с 26 рабочими местами файловый сервер хранит лекала, фотографии партий кожи для контроля качества и ночные резервные копии учётной базы. В сервере стояли два порта Intel I350 1GbE, NVMe-массив и Ubuntu Server 24.04 LTS с HWE-ядром, iperf3 взят из штатного репозитория. Сервер подключили портами eno1 и eno2 к MikroTik CRS326-24G-2S+RM на RouterOS v7. Тестовый узел входил в тот же VLAN через 10GbE SFP+, поэтому его собственный порт не ограничивал результат.
Жалоба звучала убедительно: bond поднят, оба кабеля активны, но архив сканов лекал размером 40 ГБ копируется со скоростью 111–113 МБ/с. Первичная проверка iperf3 дала 941 Мбит/с для одного потока — это норма. Однако затем обнаружилась реальная недоработка. В Netplan указали mode: 802.3ad, но не задали transmit-hash-policy, поэтому Linux использовал layer2. В обратном многопоточном тесте, когда отправлял сервер, все восемь соединений к одному тестовому узлу оставались на eno1, а eno2 почти простаивал.
На стороне CRS326 ситуация была другой. Этот коммутатор построен на Marvell Prestera 98DX3236; по документации MikroTik при аппаратно обрабатываемом bond такие чипы хешируют по признакам Layer2+Layer3+Layer4, а ручная смена transmit-hash-policy на это не влияет. Прямой тест на приём сервером с восемью потоками уже давал 1,86 Гбит/с и примерно равный прирост счётчиков ether23 и ether24. Получилась характерная асимметрия: в одном направлении распределение работало, в другом — нет. Если смотреть только общий график bond, этого не заметишь.
- Один TCP-поток до сервера: 941 Мбит/с.
- Восемь потоков до сервера: 1,86 Гбит/с.
- Восемь потоков от сервера до исправления: 943 Мбит/с.
- Диск во время теста не использовался; запас CPU и 10GbE на генераторе исключили посторонние ограничения.
Конфигурация и повторный тест
На сервере я явно задал layer3+4, быстрые LACPDU и MII-проверку каждые 100 мс. Адрес приведён для отдельного серверного VLAN. Перед применением такой конфигурации нужен локальный доступ или консоль: ошибка в Netplan легко отрежет удалённое подключение.
network:
  version: 2
  renderer: networkd
  ethernets:
    eno1: {}
    eno2: {}
  bonds:
    bond0:
      interfaces: [eno1, eno2]
      addresses: [172.16.20.20/24]
      parameters:
        mode: 802.3ad
        lacp-rate: fast
        mii-monitor-interval: 100ms
        transmit-hash-policy: layer3+4
Сначала выполняю sudo netplan generate, затем sudo netplan try. Немедленное apply по единственному удалённому каналу — ненужный риск.
На CRS326 физические порты заранее убрали из bridge по отдельности, создали из них LACP bond и уже логический интерфейс добавили в bridge. В рабочей сети это делается в согласованное окно:
/interface bonding add name=bond-srv mode=802.3ad slaves=ether23,ether24 lacp-rate=1sec link-monitoring=mii mii-interval=100ms
/interface bridge port add bridge=br-lan interface=bond-srv
Я не добавлял transmit-hash-policy ради видимости настройки: на этом switch chip с hardware offload фактическое распределение задаёт ASIC. Гораздо важнее сохранить аппаратную обработку и проверить реальные счётчики.
Тестовый сервер запустили командой iperf3 -s, а с 10GbE-узла выполнили оба направления. Ключ -P 8 создаёт восемь параллельных потоков, -R разворачивает передачу, -O 3 исключает первые три секунды из отчёта:
iperf3 -c 172.16.20.20 -t 30 -O 3
iperf3 -c 172.16.20.20 -t 30 -O 3 -P 8
iperf3 -c 172.16.20.20 -t 30 -O 3 -P 8 -R
После изменения один поток остался на ожидаемых 940–942 Мбит/с. Восемь потоков дали 1,86 Гбит/с к серверу и 1,84 Гбит/с от него. Затем два рабочих места технологов одновременно копировали разные большие файлы: 108 и 110 МБ/с, суммарно 218 МБ/с. Один файл по обычной SMB-сессии по-прежнему шёл около 111 МБ/с. Именно так LACP и должен работать.
- Сначала тест `-P 1`, чтобы зафиксировать предел одной линии.
- Потом `-P 8` в прямом и обратном направлениях.
- Параллельно фиксировать RX/TX каждого физического порта.
- После синтетики проверить реальное приложение и дисковую подсистему.
- Отдельно выдернуть один кабель и подтвердить сохранение связи.
Что делать, если многопоточный тест всё равно даёт 1 Гбит/с
Я иду по направлению трафика. Если сервер отправляет и занят один eno, проверяю xmit_hash_policy Linux. Если сервер принимает и занят один порт коммутатора, изучаю алгоритм LAG на коммутаторе и признаки, доступные его ASIC. Если оба участника нагружены, а сумма остаётся около гигабита, ищу другой предел: одногигабитный порт генератора, межкоммутаторный uplink, виртуальный vSwitch, CPU, шифрование, диск или ограничение QoS.
Не требуйте ровно 50 на 50 от короткого теста. При двух линиях четыре или восемь потоков могут случайно распределиться 3:1 или даже попасть на один участник. Я меняю число соединений, использую несколько исходных узлов и повторяю тест. Но стабильное отсутствие байтов на одном порту при десятках разнообразных потоков — уже основание разбирать хеш и состояние LAG.
Для блочного хранилища правильный инструмент — не LACP, а MPIO. Если сервер Windows забирает тома с iSCSI-СХД, я не собираю два порта в команду, а даю каждому адаптеру собственный IP в отдельной подсети хранения и открываю по сессии на каждый путь. Microsoft MPIO объединяет дубликаты устройства в один диск, а политика Round Robin раскладывает ввод-вывод по всем путям:
Install-WindowsFeature -Name Multipath-IO
Enable-MSDSMAutomaticClaim -BusType iSCSI
Set-MSDSMGlobalDefaultLoadBalancePolicy -Policy RR
Connect-IscsiTarget -NodeAddress iqn.2004-01.example:storage.lun1 -TargetPortalAddress 172.16.30.10 -InitiatorPortalAddress 172.16.30.21 -IsMultipathEnabled $true -IsPersistent $true
Connect-IscsiTarget -NodeAddress iqn.2004-01.example:storage.lun1 -TargetPortalAddress 172.16.31.10 -InitiatorPortalAddress 172.16.31.21 -IsMultipathEnabled $true -IsPersistent $true
После установки компонента MPIO нужна перезагрузка, а политика по умолчанию применяется только к устройствам, которые MSDSM захватит после её установки. Поэтому уже подключённые LUN проверяю отдельно через mpclaim -s -d.
И ещё о приоритетах. Сначала добейтесь, чтобы оба участника были collecting/distributing, затем подтвердите распределение в обе стороны, а потом занимайтесь SMB Multichannel и настройкой приложений. На бренд патч-корда, jumbo frames и косметическую цифру скорости bond пока можно не тратить время. Если бизнесу нужна гарантированная скорость одного задания выше гигабита, я сразу предлагаю 10GbE: это проще в сопровождении и предсказуемее, чем попытки заставить LACP вести себя как один широкий канал.
- Один тестовый клиент должен иметь путь быстрее 1 Гбит/с либо тест надо запускать с нескольких клиентов.
- Проверяйте оба направления: `iperf3 -P 8` и `iperf3 -P 8 -R`.
- Убедитесь, что VLAN и uplink между коммутаторами не образуют отдельное узкое место.
- Для SMB на Windows проверьте `Get-SmbMultichannelConnection`.
- Не используйте `balance-rr` без лабораторной проверки переупорядочивания и поведения коммутатора.
- Для iSCSI используйте MPIO с отдельными подсетями путей, а не LACP-агрегат.
Частые вопросы
Можно ли получить 2 Гбит/с при передаче одного файла?
Да, если приложение создаёт несколько TCP-соединений, например через SMB Multichannel. Одно TCP-соединение в обычном LACP остаётся ограничено скоростью одного физического порта.
Почему `iperf3 -P 8` иногда показывает только 1 Гбит/с?
Проверьте направление, хеш передающей стороны и физические счётчики. Потоки могли попасть на один участник, либо тестовый клиент, uplink, CPU или виртуальный коммутатор сам ограничен 1 Гбит/с.
Должны ли политики хеширования Linux и коммутатора совпадать?
Нет. Каждая сторона выбирает порт только для собственного исходящего трафика. Но обе политики должны подходить структуре ваших потоков и возможностям оборудования.
Поможет ли `lacp-rate: fast` увеличить скорость?
Нет. Параметр меняет частоту LACPDU и время реакции на изменение состояния, но не алгоритм распределения и не пропускную способность потока.
Стоит ли включать `balance-rr`, чтобы один поток занял оба порта?
Я не рекомендую это для обычной производственной сети. Пакеты могут прийти не по порядку, TCP снизит окно или начнёт повторные передачи, а коммутатор может вообще не поддержать ожидаемое распределение.
Почему оба порта активны, но трафик виден только на одном?
Состояние active означает готовность участвовать в агрегате, а не обязательную загрузку. Если текущие поля потока дают один и тот же хеш, второй порт останется свободным до появления подходящих независимых потоков.
Собирать ли в LACP порты сервера, подключённые к iSCSI-хранилищу?
Нет. Для iSCSI я использую MPIO: отдельный IP и подсеть на каждый путь, отдельная сессия на каждый путь и политика Round Robin или Least Queue Depth. Так ввод-вывод идёт по всем путям, а отказ одного пути обрабатывает MPIO, а не LACP.
Источники
- Linux Kernel Documentation — Linux Ethernet Bonding Driver HOWTO: разделы Bonding Driver Options (mode, miimon, lacp_rate, xmit_hash_policy), Querying Bonding Configuration, Maximum Throughput in a Single Switch Topology: https://docs.kernel.org/networking/bonding.html
- Netplan Documentation — Netplan YAML configuration, раздел Properties for device type bonds: mode, lacp-rate, mii-monitor-interval и transmit-hash-policy: https://netplan.readthedocs.io/en/latest/netplan-yaml/
- MikroTik RouterOS Documentation — Bonding: режим 802.3ad, lacp-rate 1sec/30secs, monitor и monitor-slaves, раздел Bonding offloading (Prestera — хеш L2+L3+L4, 88E6393X/88E6191X/88E6190 — только Layer2): https://help.mikrotik.com/docs/spaces/ROS/pages/8323193/Bonding
- MikroTik Hardware — CRS326-24G-2S+RM, характеристики коммутатора и switch chip Marvell 98DX3236: https://mikrotik.com/product/CRS326-24G-2SplusRM
- ESnet iperf3 Documentation — iperf3 3.21 Manual Page, параметры -P/--parallel, -R/--reverse, -O/--omit и -t/--time: https://software.es.net/iperf/invoking.html
- Microsoft Learn — Manage SMB Multichannel, применимость к Windows Server 2025/2022/2019/2016, несколько TCP-соединений и использование суммарной полосы: https://learn.microsoft.com/en-us/windows-server/storage/storage-spaces/manage-smb-multichannel
- IEEE Standards Association — IEEE 802.1AX-2020, действующий стандарт Link Aggregation: https://standards.ieee.org/ieee/802.1AX/6768/
- Microsoft Learn — MPIO — Set-MSDSMGlobalDefaultLoadBalancePolicy (MPIO module), значения политики None/FOO/RR/LQD/LB: https://learn.microsoft.com/en-us/powershell/module/mpio/set-msdsmglobaldefaultloadbalancepolicy
- Microsoft Learn — iSCSI — Register-IscsiSession: повторная регистрация подключения создаёт несколько сессий для MPIO, параметр -IsMultipathEnabled: https://learn.microsoft.com/en-us/powershell/module/iscsi/register-iscsisession