
Почему Linux-шлюз исчерпывает таблицу nf_conntrack
Интернет едва занят, процессор скучает, но новые сайты не открываются, телефония срывается, а ядро пишет `nf_conntrack: table full, dropping packet`. Я, Семёнов Евгений Сергеевич, разбираю эту аварию не по мегабитам, а по состояниям потоков: какой счётчик сравнивать с лимитом, почему таблицу забивают маленькие пакеты и как найти конкретный источник без разрушительной очистки всех соединений.
Канал здесь вообще ни при чём
nf_conntrack учитывает состояния сетевых потоков, а не загрузку интерфейса. Один короткий UDP-пакет может занять запись на десятки секунд, хотя передал сотню байт. Поэтому тысяча новых запросов в секунду способна заполнить таблицу быстрее, чем оператор заметит трафик на графике. В этот момент уже установленные соединения иногда продолжают работать, а новые открываются через раз: для знакомого потока запись существует, для нового ядру нечего выделить.
В современных ядрах, включая ветку Linux 6.12, при превышении nf_conntrack_max ядро сначала пытается вытеснить подходящую запись. Если это не удаётся, оно отказывает в создании состояния, увеличивает статистику потерь и выводит сообщение с ограничением частоты. Проверяю это так:
sudo sysctl net.netfilter.nf_conntrack_count \
  net.netfilter.nf_conntrack_max \
  net.netfilter.nf_conntrack_buckets
cat /proc/sys/net/netfilter/nf_conntrack_count
sudo conntrack -C
sudo conntrack -S
sudo journalctl -k -g 'nf_conntrack.*table full'
Главная пара — nf_conntrack_count и nf_conntrack_max; тот же счётчик лежит в /proc/sys/net/netfilter/nf_conntrack_count, а conntrack -C по man conntrack(8) показывает счётчик таблицы. buckets влияет на устройство хеш-таблицы и скорость поиска, но не является непосредственно проверяемым лимитом записей.
Если шлюз уже роняет бизнес-трафик, я сначала фиксирую показатели и при наличии памяти временно увеличиваю nf_conntrack_max. Это возвращает время для расследования. Затем ищу доминирующий протокол, адрес и состояние. Перезагрузка шлюза или conntrack -F — плохая первая реакция: симптом исчезнет, доказательства тоже, а действующие NAT-сопоставления и сессии оборвутся.
- Смотрим отношение `count/max`, а не загрузку канала.
- Берём дельту `insert_failed`, `drop` и `early_drop`, поскольку `conntrack -S` показывает накопительные счётчики по процессорам.
- Проверяем именно тот network namespace, где проходит трафик.
- Снимаем один дамп таблицы и анализируем его, а не запускаем тяжёлый `conntrack -L` каждую секунду.
Что ядро считает одним соединением
Одна запись — это двунаправленный поток, который ядро описывает исходным и ответным кортежами: семейство адресов, протокол, адреса, порты или соответствующие протоколу идентификаторы, а при использовании — ещё и зона conntrack. Для TCP это похоже на привычную пятёрку src/dst/protocol/sport/dport. UDP не имеет рукопожатия, но conntrack всё равно создаёт для него временное состояние. Отслеживаются также ICMP, ICMPv6, SCTP, GRE и другие поддерживаемые протоколы.
В документации ядра сказано, что запись добавляется в хеш-таблицу дважды: для original и reply. Здесь регулярно ошибаются. Это не две единицы в nf_conntrack_count, а один объект потока с двумя узлами поиска. Поэтому один TCP-сеанс обычно увеличивает счётчик на единицу. SNAT или DNAT также не создаёт вторую запись: преобразование хранится в том же состоянии. Зато отдельное RELATED-соединение, например канал данных протокола с helper, получит собственную запись.
nf_conntrack_count показывает число выделенных flow-объектов в текущем сетевом пространстве имён. Туда могут кратковременно попадать ещё не подтверждённые и уже уничтожаемые объекты, поэтому результат иногда немного выше числа строк, возвращённых conntrack -L или conntrack -C. Большая и устойчивая разница заслуживает отдельного расследования, но обычно она мала. В контейнерной инфраструктуре команда из контейнера и команда на хосте могут показать разные значения — я всегда проверяю путь пакета и нужный namespace.
- Один двунаправленный поток — обычно одна единица счётчика.
- Original и reply — два ключа поиска одного объекта.
- NAT меняет кортежи внутри записи, но не удваивает её.
- IPv4 и IPv6, локальный и транзитный трафик учитываются, если проходят через включённый conntrack.
- Поток с правилом `notrack` не учитывается, но теряет возможности stateful-фильтрации и обычного NAT.
Почему записи накапливаются
Рабочая оценка проста: число записей примерно равно скорости появления новых потоков, умноженной на среднее время их жизни, плюс долгоживущие состояния. Если приложение создаёт 800 новых UDP-кортежей в секунду, а тайм-аут равен 90 секундам, получается около 72 000 записей. Такой поток маленьких DNS-пакетов займёт считаные мегабиты в секунду, но шлюз с лимитом 65 536 уже ляжет.
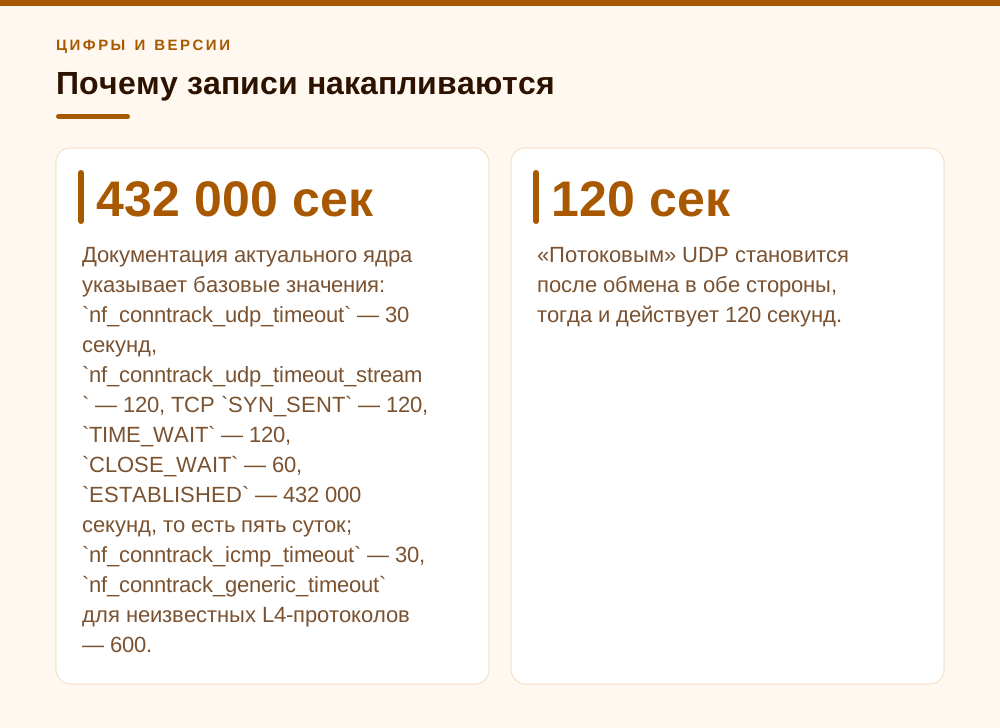
Документация актуального ядра указывает базовые значения: nf_conntrack_udp_timeout — 30 секунд, nf_conntrack_udp_timeout_stream — 120, TCP SYN_SENT — 120, TIME_WAIT — 120, CLOSE_WAIT — 60, ESTABLISHED — 432 000 секунд, то есть пять суток; nf_conntrack_icmp_timeout — 30, nf_conntrack_generic_timeout для неизвестных L4-протоколов — 600. «Потоковым» UDP становится после обмена в обе стороны, тогда и действует 120 секунд. Таймер обновляется подходящими пакетами. Записи копятся из-за запросов к мёртвому адресу, повторных попыток, сканирования, незакрытых TCP-сессий и асимметричной маршрутизации, при которой ответ проходит через другой шлюз. Последний случай часто выдаёт масса [UNREPLIED].
Из раза в раз вижу два неверных лечения. Первое — поставить nf_conntrack_max=2000000 и забыть. Авария отложена, источник продолжает шуметь, память и длина хеш-цепочек растут. Второе — глобально сократить nf_conntrack_tcp_timeout_established до часа. Это может разрушить состояние тихих SSH-, VPN- или прикладных соединений. Я меняю тайм-аут только после классификации записей; предпочтительнее исправить генератор трафика или применить отдельную timeout policy к известному классу потоков.
- `UNREPLIED` — первым делом проверяем доступность назначения и обратный маршрут.
- Много `SYN_SENT` — ищем недоступный сервис, сканирование или агрессивные ретраи.
- Много `ESTABLISHED` — проверяем действительно долгие сессии и отсутствие корректного закрытия.
- Много UDP к одному порту — группируем по исходным и конечным адресам.
Стенд «Зодчий сада»: 65 тысяч записей от DNS
Разберу случай из практики, название условное: студия ландшафтного дизайна «Зодчий сада», 32 рабочих места — проектировщики с тяжёлыми CAD- и 3D-файлами, сметный отдел, бухгалтерия и планшеты бригад, которые подключаются к офису через WireGuard. Все выходят через виртуальный шлюз с 2 vCPU, 4 ГиБ RAM и двумя virtio-net по 1 Гбит/с. На шлюзе стояли Debian 13, ядро серии 6.12, nftables 1.1.3 и conntrack-tools 1.4.8. Он делал SNAT в интернет, маршрутизировал VLAN офиса, гостевого Wi-Fi и видеонаблюдения питомника, держал WireGuard для бригад. Лимит никто не задавал: ядро само выставило 65 536 buckets для машины больше 1 ГиБ памяти, max равен им по умолчанию.
После обновления клиента синхронизации сметной программы проектировщики пожаловались, что новые HTTPS-соединения и видеозвонки с заказчиками открываются со второй-третьей попытки, а облачное хранилище с чертежами «отваливается». Максимум на внешнем интерфейсе был 38 Мбит/с, CPU — 14 %. Зато диагностика показала почти точное упирание в предел:
net.netfilter.nf_conntrack_count = 65531
net.netfilter.nf_conntrack_max = 65536
net.netfilter.nf_conntrack_buckets = 65536

nf_conntrack: table full, dropping packet
За десять минут сумма дельт insert_failed и drop выросла на 18 427, early_drop — на 617. Это уже не предположение, а подтверждённая потеря новых состояний.
Один снимок обеих таблиц семейств с закрытыми правами показал картину: 91 % записей были UDP, 84 % всех записей шли на 10.77.0.53:53, почти все с [UNREPLIED]. Двадцать восемь рабочих станций и двенадцать планшетов в сумме создавали 730–780 новых DNS-кортежей в секунду — около 18–20 на устройство. В старом файле настройки шлюза дополнительно сохранилось nf_conntrack_udp_timeout=90. Получалось до 70 тысяч живых записей при трафике около 1,8 Мбит/с.
Причина оказалась двойной. Внутренний DNS перенесли с 10.77.0.53 на 10.77.0.54, а новая версия клиента синхронизации держала старый адрес в собственном конфиге и на каждый ретрай открывала новый UDP-сокет с новым исходным портом. Сначала я временно поднял лимит до 262 144, затем исправил адрес в централизованной конфигурации и перезапустил клиентов группами. Тайм-аут вернул к штатным 30 секундам. Через две минуты счётчик снизился до 5 200; после наблюдения закрепили max и buckets по 131 072 — памяти на это хватает с большим запасом. За следующие 14 суток пик составил 9 400, а insert_failed больше не рос.
- До сбоя: обычный диапазон 3 500–6 000 записей.
- В аварии: 65 531 из 65 536, то есть 99,99 %.
- Источник: 730–780 новых UDP-кортежей в секунду от 40 устройств к недоступному DNS.
- После исправления: пик 9 400 при лимите 131 072.
Как я нахожу виновника
Сначала снимаю лёгкие показатели дважды с интервалом в минуту. Так видна скорость роста, а не случайная фотография. conntrack -S выдаёт строки по CPU, поэтому сравниваю сумму дельт, особенно insert_failed, drop, early_drop и search_restart. Одновременно проверяю доступную память и размер slab-кеша:
sudo sysctl net.netfilter.nf_conntrack_count \
  net.netfilter.nf_conntrack_max \
  net.netfilter.nf_conntrack_buckets
sudo conntrack -S
free -h
sudo grep '^nf_conntrack ' /proc/slabinfo
Универсальной стоимости одной записи в байтах нет: она зависит от архитектуры, сборки ядра и расширений accounting, timestamp, labels и NAT. Поэтому цифру «320 байт навсегда» я не использую.
Если таблица большая, делаю один дамп и работаю с файлом. В нём есть внутренние адреса, поэтому задаю права и после расследования удаляю:
sudo sh -c 'umask 077; {
  conntrack -L -f ipv4 -o extended 2>/dev/null
  conntrack -L -f ipv6 -o extended 2>/dev/null
} > /run/conntrack.snapshot'

sudo grep -oE 'UNREPLIED|SYN_SENT|SYN_RECV|ESTABLISHED|TIME_WAIT' \
  /run/conntrack.snapshot | sort | uniq -c | sort -nr

sudo awk '{
  src=""; dst=""; dport=""
  for (i=1; i<=NF; i++) {
    if (src=="" && $i ~ /^src=/) src=$i
    if (dst=="" && $i ~ /^dst=/) dst=$i
    if (dport=="" && $i ~ /^dport=/) dport=$i
  }
  print src, dst, dport
}' /run/conntrack.snapshot | sort | uniq -c | sort -nr | head -30
Первое вхождение src, dst и dport относится к original-направлению. Этого обычно достаточно, чтобы увидеть один адрес или сервис, который создаёт львиную долю состояний.
Дальше проверяю гипотезу пакетным захватом на нужном интерфейсе, маршрутом до назначения и обратным маршрутом. Не надо сразу захватывать весь гигабитный интерфейс: фильтр по найденному хосту и порту даст ответ быстрее. После работы удаляю снимок командой sudo rm -f /run/conntrack.snapshot. Если подозреваю короткий всплеск, на минуту запускаю conntrack -E -e NEW, но помню: при высокой скорости событий Netlink-буфер может переполниться, поэтому отсутствие всех событий не доказывает отсутствие потоков.
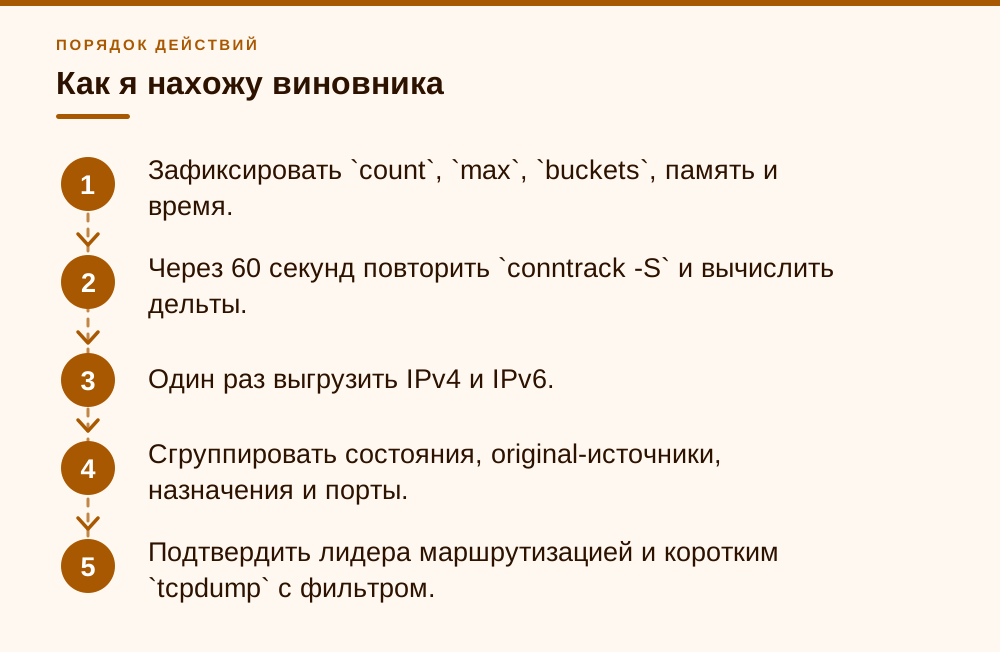
- Зафиксировать `count`, `max`, `buckets`, память и время.
- Через 60 секунд повторить `conntrack -S` и вычислить дельты.
- Один раз выгрузить IPv4 и IPv6.
- Сгруппировать состояния, original-источники, назначения и порты.
- Подтвердить лидера маршрутизацией и коротким `tcpdump` с фильтром.
NOTRACK для DNS и мониторинга: где уместно
Исключение из conntrack — не способ «лечить» переполнение, а инструмент для трафика, которому состояние не нужно в принципе. Типичные кандидаты — сам шлюз, отвечающий как DNS-резолвер для офиса, и частые опросы мониторинга: SNMP, ICMP-проверки, Zabbix или Prometheus с десятков точек. Каждый такой запрос без NOTRACK создаёт запись, которая живёт 30–120 секунд. На маленьком шлюзе «Зодчего сада» это не проблема, а на узле, который опрашивает сотни хостов, счёт идёт на десятки тысяч. Правило должно сработать раньше, чем conntrack, который регистрируется на приоритете −200, — поэтому цепочка с priority raw (−300):
table inet raw {
  chain prerouting {
    type filter hook prerouting priority raw; policy accept;
    iifname "lan0" udp dport 53 ip daddr 10.77.0.1 notrack
    iifname "lan0" tcp dport 53 ip daddr 10.77.0.1 notrack
  }
  chain output {
    type filter hook output priority raw; policy accept;
    oifname "lan0" udp sport 53 notrack
    oifname "lan0" tcp sport 53 notrack
  }
}
На старых системах с iptables то же делается целью CT --notrack в таблице raw; устаревшая цель NOTRACK — её алиас:
sudo iptables -t raw -A PREROUTING -i lan0 -p udp --dport 53 -j CT --notrack
sudo iptables -t raw -A OUTPUT -o lan0 -p udp --sport 53 -j CT --notrack
Исключать нужно оба направления: запрос на входе в prerouting и ответ шлюза в output, иначе ответ всё равно создаст запись. Дальше обязательная часть, о которой забывают: пакеты получают состояние untracked, и правило ct state established,related accept их не пропустит. В фильтре нужно явно разрешить ct state untracked для этих портов, иначе после «оптимизации» перестанет работать сам DNS. К трафику, который проходит через SNAT/DNAT, NOTRACK неприменим: без записи нет и трансляции адресов. Транзитный DNS пользователей к внешним резолверам через NAT исключать нельзя — там помогает только локальный кеширующий резолвер на шлюзе.
- Исключать только трафик к адресам самого шлюза или маршрутизируемый без NAT.
- Правило ставить в цепочку с `priority raw` в hook `prerouting` и `output`, для обоих направлений.
- В filter-цепочке явно разрешить `ct state untracked` для исключённых портов.
- Сверить эффект по `conntrack -C` до и после, а не по ощущениям.
- Не исключать весь LAN: пропадут stateful-фильтрация, NAT и helper'ы.
Docker и Kubernetes-узлы: свой счётчик и чужие sysctl
На контейнерных хостах conntrack загружен практически всегда: Docker публикует порты через DNAT и маскарадит исходящий трафик контейнеров, kube-proxy строит Service через DNAT в режимах iptables и nftables. Счётчик nf_conntrack_count в исходниках 6.12 ведётся для каждого network namespace отдельно и сравнивается с nf_conntrack_max, а nf_conntrack_buckets можно менять только из начального namespace. Трафик контейнера, выходящий через bridge и NAT хоста, учитывается в namespace хоста — поэтому команда conntrack -C внутри пода ничего не скажет о переполнении узла. Смотреть нужно на хосте или через nsenter -t 1 -n.
У Kubernetes есть ловушка, которую я встречаю регулярно: kube-proxy при старте сам пишет sysctl. По справочнику kube-proxy --conntrack-max-per-core по умолчанию 32768, --conntrack-min — 131072, итоговый лимит — большее из «ядра × 32768» и минимума; --conntrack-tcp-timeout-established — 24 часа, --conntrack-tcp-timeout-close-wait — 1 час. Значения из /etc/sysctl.d будут перезаписаны при каждом рестарте kube-proxy, так что менять их нужно в его конфигурации. Вторая типовая беда — UDP DNS подов: каждый запрос к CoreDNS проходит DNAT и оставляет запись на 30 секунд, а параллельные A/AAAA-запросы дают гонки при вставке и рост insert_failed. Документация Kubernetes прямо рекомендует NodeLocal DNSCache, который обходит DNAT и conntrack и переводит обращения к CoreDNS на TCP.
- Считать `nf_conntrack_count` и `insert_failed` в корневом namespace узла, а не в поде.
- Лимиты и тайм-ауты на узлах Kubernetes задавать через конфигурацию kube-proxy, а не sysctl.d.
- При росте `insert_failed` на узлах с множеством подов проверить DNS и внедрить NodeLocal DNSCache.
- На Docker-хосте с опубликованными портами не применять NOTRACK к этим портам — сломается DNAT.
- Учитывать, что увеличение памяти узла меняет дефолтный лимит только там, где его не задаёт kube-proxy.
Как задать лимит и не перенести проблему
При аварии и достаточном MemAvailable лимит можно увеличить без очистки существующих записей:
sudo sysctl -w net.netfilter.nf_conntrack_max=262144Это изменение обратимо и начинает действовать сразу. Я наблюдаю память, загрузку CPU и статистику ошибок, пока устраняю источник. Если память уже под давлением, слепое увеличение опасно. Полный conntrack -F оставляю для согласованного аварийного окна: он удаляет состояния firewall и NAT, поэтому активные соединения могут оборваться.
Полезно понимать, откуда берётся стартовое значение. В nf_conntrack-sysctl.rst сказано, что без параметра модуля hashsize число buckets считается от объёма памяти (делением на 16384), не меньше 1024 и не больше 262 144, а nf_conntrack_max по умолчанию равен nf_conntrack_buckets. В исходниках 6.12 это выглядит конкретнее: на 64-битной системе с памятью больше 4 ГиБ сразу ставится 262 144, больше 1 ГиБ — 65 536, на маленьких машинах — производная от RAM, но не ниже 1024. Поэтому шлюз на 2 и на 4 ГиБ получает одинаковые 65 536, а добавление памяти в ВМ до 8 ГиБ после перезагрузки молча учетверяет лимит. Размер хеша можно задать и при загрузке модуля:
echo 'options nf_conntrack hashsize=131072' | sudo tee /etc/modprobe.d/nf_conntrack.conf
cat /sys/module/nf_conntrack/parameters/hashsize
Если явно задан hashsize, ядро исходит из прежнего множителя 8, и max по умолчанию станет в восемь раз больше buckets — я всё равно фиксирую max явно в sysctl.
Постоянный предел рассчитываю от измерений: пиковая скорость новых потоков умножается на характерное время жизни, отдельно прибавляются долгоживущие соединения. Затем даю запас минимум в два раза; для нестабильной нагрузки — в три-четыре. В «Зодчем сада» после исправления пик 9 400 позволял оставить и 65 536, но при 4 ГиБ памяти я закрепил 131 072 с запасом на рост. Размер хеш-таблицы я держу того же порядка, что и max: документация ядра по умолчанию делает их равными и прямо предупреждает, что запись попадает в хеш дважды, поэтому заполненная таблица при равных значениях даёт среднюю длину цепочки 2. Слишком мало buckets при огромном max увеличивает цепочки и стоимость поиска.
Итоговый файл на этом шлюзе выглядел так:
# /etc/sysctl.d/90-nf-conntrack.conf
net.netfilter.nf_conntrack_buckets = 131072
net.netfilter.nf_conntrack_max = 131072
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 120
Применили через sudo sysctl --system и обязательно проверили значения после перезагрузки. Изменение buckets означает перестройку хеша; на загруженном боевом шлюзе я планирую это на окно работ. Если команда выполняется внутри контейнера, изменение buckets может быть запрещено: документация разрешает запись только из начального network namespace.
В мониторинг ставлю заполнение таблицы и дельты ошибок. Предупреждение — 70 %, критический уровень — устойчивые 85–90 %; это мой эксплуатационный выбор, а не правило ядра. insert_failed > 0 требует разбора даже после автоматического восстановления. Для этого достаточно двух чисел — nf_conntrack_count и nf_conntrack_max — и дельты insert_failed из conntrack -S; снимать полный дамп агентом мониторинга не нужно, и для контейнерных узлов метрику собираю в корневом namespace хоста.
- Лимит выбирается по числу одновременных состояний, а не по скорости интерфейса.
- Сначала устраняется генератор лишних потоков, затем закрепляется запас.
- `max` без соразмерного `buckets` может ухудшить поиск.
- Тайм-ауты меняются по подтверждённому профилю трафика.
- После перезагрузки проверяются и sysctl, и отсутствие новых `insert_failed`.
Частые вопросы
Какой лимит вызывает `nf_conntrack: table full`?
Ядро сравнивает число выделенных flow-записей с `net.netfilter.nf_conntrack_max`. `nf_conntrack_buckets` задаёт размер хеш-таблицы и влияет на поиск, но это не лимит соединений.
Один TCP-сеанс считается два раза из-за original и reply?
Нет. Это один объект conntrack и обычно одна единица `nf_conntrack_count`. Original и reply помещаются в хеш как два направления поиска.
Почему `conntrack -L` показывает меньше, чем `nf_conntrack_count`?
Sysctl считает выделенные flow-объекты, включая краткоживущие unconfirmed или dying. `conntrack -L` обычно показывает подтверждённую основную таблицу. Небольшая разница нормальна; большая устойчивая разница требует проверки namespace и обработки пакетов.
Можно ли сразу выполнить `conntrack -F`?
Технически можно, но это удалит все состояния и NAT-сопоставления, оборвёт часть активных соединений и уничтожит данные для диагностики. Я сначала снимаю показатели и дамп, а затем временно увеличиваю лимит, если хватает памяти.
Какой `nf_conntrack_max` поставить для 1 Гбит/с?
По скорости порта это не рассчитывается. Нужны пиковая скорость создания новых потоков, их тайм-ауты, число долгоживущих соединений и запас. Два шлюза на 1 Гбит/с могут требовать 32 тысячи и миллион записей соответственно.
Поможет ли `notrack`?
Иногда, для заранее известного stateless-трафика без NAT. Но пакет станет `UNTRACKED`, а правила `ct state established,related` его не пропустят автоматически. Исключение нужно проектировать вместе с явными правилами обоих направлений.
Какой лимит ядро ставит по умолчанию?
`nf_conntrack_max` равен `nf_conntrack_buckets`, а buckets считаются от памяти. В ядре 6.12 на 64-битной машине больше 4 ГиБ это 262 144, больше 1 ГиБ — 65 536, меньше — производная от RAM, но не ниже 1024. Kubernetes-узлы переопределяет kube-proxy.
Стоит ли уменьшать `nf_conntrack_tcp_timeout_established` с 432000?
Только по результатам классификации записей. Глобальное сокращение рвёт тихие долгие сессии; надёжнее найти источник или назначить отдельную `ct timeout`-политику в nftables для конкретного класса трафика.
Источники
- Linux Kernel Documentation — Netfilter Conntrack Sysfs variables (nf_conntrack-sysctl.rst): nf_conntrack_count, nf_conntrack_max, nf_conntrack_buckets, тайм-ауты TCP/UDP/ICMP/generic — https://docs.kernel.org/networking/nf_conntrack-sysctl.html
- Linux kernel source v6.12 — net/netfilter/nf_conntrack_core.c: расчёт htable_size от RAM, nf_conntrack_max, early drop, per-netns счётчик и сообщение table full — https://github.com/torvalds/linux/blob/v6.12/net/netfilter/nf_conntrack_core.c
- Netfilter Project — conntrack(8): команды -L, -C, -S, -E, -F, таблицы conntrack, expect, dying и unconfirmed — https://netfilter.org/projects/conntrack-tools/conntrack-manpage.html
- nftables wiki — Setting packet connection tracking metainformation: notrack в цепочке с priority -300 до conntrack — https://wiki.nftables.org/wiki-nftables/index.php/Setting_packet_connection_tracking_metainformation
- Kubernetes Documentation — kube-proxy: --conntrack-max-per-core, --conntrack-min, --conntrack-tcp-timeout-established — https://kubernetes.io/docs/reference/command-line-tools-reference/kube-proxy/
- Kubernetes Documentation — Using NodeLocal DNSCache in Kubernetes Clusters: обход DNAT и conntrack для DNS — https://kubernetes.io/docs/tasks/administer-cluster/nodelocaldns/
- Debian Packages — Пакеты Debian 13 trixie: conntrack 1:1.4.8-2 и nftables 1.1.3-1 — https://packages.debian.org/trixie/conntrack
- Netfilter Project Releases — conntrack-tools: выпуск 1.4.9 от 4 февраля 2026 года — https://www.netfilter.org/projects/conntrack-tools/downloads.html