
Поменял DNAT в nftables, а часть клиентов всё ещё на старом сервере: где прячется прежний адрес
Вы поправили правило DNAT, перезагрузили ruleset, проверили — новый адрес на месте. А половина пользователей продолжает работать со старым сервером, и на нём в tcpdump всё так же капает трафик. Разберу, почему так происходит (спойлер: nftables ни при чём, дело в nf_conntrack), как за три команды это доказать, как вычистить только нужные потоки, не обрывая заодно свою же SSH-сессию, и в каком порядке я переключаю сервисы, чтобы чистить conntrack вообще не приходилось.
Правило поменяли, а трафик идёт по-старому — это не глюк nftables
Ситуация узнаваемая до зубовного скрежета. Вы правите /etc/nftables.conf, делаете nft -f /etc/nftables.conf, смотрите nft list ruleset — там новый адрес бэкенда, чёрным по белому. Запускаете tcpdump на новом сервере — жиденький ручеёк новых подключений есть. Запускаете на старом — а там полноценный поток, как будто вы ничего не меняли. Первая мысль у большинства: правило не применилось, где-то кэш, надо перезагрузить шлюз. Не надо. Правило применилось.
Разгадка в том, что stateful NAT в Linux принимает решение ровно один раз — на первом пакете потока. Официальная формулировка из nftables wiki: «The first packet of a flow is used to look up for a matching rule which sets up the NAT binding for this flow». Дальше цепочка типа nat для этого потока вообще не проходится: ядро берёт готовое сопоставление адресов из подсистемы отслеживания соединений nf_conntrack и применяет его к каждому следующему пакету. Хук nat — это не фильтр, который работает на каждом пакете. Это регистратор, который срабатывает один раз и записывает результат в состояние.
Отсюда простое, но неочевидное следствие, ради которого стоит переписать себе на лоб: правило и состояние — две разные сущности, и они умеют расходиться. nft list ruleset описывает будущее — как будут обработаны потоки, которые ещё не начались. conntrack -L описывает настоящее — что делается с потоками, которые уже живут. Пока вы не сравнили одно с другим, вы ничего не диагностировали, а просто смотрели на конфиг и надеялись.
Это, кстати, не особенность nftables. Ровно то же самое было в iptables с таблицей nat: там цепочки PREROUTING/POSTROUTING тоже проходятся только для пакетов в состоянии NEW. Переезд на nftables ничего в этой механике не изменил — изменился синтаксис, а nf_conntrack под капотом тот же самый.
- Цепочка `type nat` видит только первый пакет потока (состояние NEW); остальные пакеты транслируются по записи conntrack.
- `nft list ruleset` — это правила для будущих соединений, `conntrack -L` — фактическая трансляция для живых.
- Правка DNAT не трогает установленные потоки: они продолжают ходить на старый адрес, пока запись не удалят или не истечёт её таймер.
- Механика одинакова для iptables и nftables — обе работают поверх nf_conntrack.
Стенд: перенос публикации 1С в «СамокатГраде»
Возьму конкретный случай — магазин самокатов «СамокатГрад» на 26 рабочих мест: торговый зал, склад, сервисная мастерская и пара менеджеров интернет-заказов. Периметр: шлюз на Ubuntu Server 24.04 LTS, ядро 6.8, nftables 1.0.9 (именно эта версия идёт в noble, пакет 1.0.9-1ubuntu0.1), conntrack из пакета conntrack-tools. Внешний интерфейс eth0, внутренний eth1. Наружу опубликована веб-клиентская 1С через HTTPS — ею пользуются менеджеры из дома и кладовщик выездного склада. Задача была бытовая: переехать со старого сервера приложений 10.20.0.11 на новый 10.20.0.21 — больше памяти, свежая платформа. Публичный адрес и имя остаются прежними, меняется только цель DNAT.
Было вот так:
table ip nat {
  chain prerouting {
    type nat hook prerouting priority dstnat; policy accept;
    iifname "eth0" tcp dport 443 dnat to 10.20.0.11:443
  }
  chain postrouting {
    type nat hook postrouting priority srcnat; policy accept;
    oifname "eth0" ip saddr 10.20.0.0/24 masquerade
  }
}
Приоритеты тут не декоративные. По документации nftables ключевое слово dstnat означает -100 и применяется в хуке prerouting, srcnat — 100 в postrouting. Жёсткое требование одно: NAT-цепочка должна иметь приоритет больше -200, потому что на -200 работает сам conntrack и до него пакету ещё не с чем сопоставляться. Вторая частая ошибка: фильтрующая цепочка в prerouting с приоритетом ниже -100 видит адрес назначения ДО трансляции, то есть публичный, а не внутренний, и правила по внутреннему адресу там молча не срабатывают.
Поменяли 10.20.0.11 на 10.20.0.21, загрузили файл целиком через nft -f (это атомарная транзакция — либо весь набор, либо ничего), убедились в nft list ruleset. И тут началось. Новые подключения пошли на новый сервер 10.20.0.21, а те, кто был в системе с утра, продолжали сидеть на старом 10.20.0.11. Четверо продавцов и кладовщик проработали в старой базе сорок минут, за это время пробили несколько чеков и оприходовали поставку самокатов — документы потом переносили в новую базу руками. Мониторинг молчал, потому что смотрел на новый сервер — а на новом трафик был.
conntrack -L | wc -l на шлюзе показал 6 200 записей всего, из них 21 штуку с ответным адресом 10.20.0.11 по 443-му порту. Вот эта 21 запись и была «старым сервером». Никакого кэша, никакой магии — просто 21 живая TCP-сессия с зафиксированным NAT-сопоставлением, каждая со своим таймером.
- Стенд: Ubuntu Server 24.04 LTS, ядро 6.8, nftables 1.0.9, conntrack-tools; eth0 — внешний, eth1 — внутренний.
- Публичный вход 203.0.113.10:443 → DNAT на сервер 1С в сети 10.20.0.0/24.
- Изменение: цель DNAT 10.20.0.11 → 10.20.0.21, публичный адрес и сертификат не менялись.
- Итог без зачистки conntrack: новые сессии на новом сервере, утренние — на старом, данные разъехались по двум базам.
Диагностика за три команды
Я не лезу в дебри, пока не отработал минимальный набор. Он занимает минуту и почти всегда закрывает вопрос.
# 1. Сколько всего записей и не упёрлись ли мы в потолок таблицы
conntrack -C
sysctl net.netfilter.nf_conntrack_max

# 2. Кто ещё ходит на старый бэкенд (фильтр по ответному адресу)
conntrack -L -p tcp --reply-src 10.20.0.11 --reply-port-src 443 -o extended

# 2a. Всё, что клиенты отправляли на публичный адрес (фильтр по исходному назначению)
conntrack -L -p tcp -d 203.0.113.10 --dport 443

# 3. Только те потоки, которые вообще подвергались DNAT
conntrack -L -g        # -g == --dst-nat

# 4. Живая лента событий: куда уходят новые потоки прямо сейчас
conntrack -E -e NEW,DESTROY -p tcp --dport 443
Ключ к чтению вывода — понимать, что каждая запись содержит два кортежа: оригинальное направление и ответное. При DNAT они не совпадают, и именно по этому расхождению видно, куда реально уходит трафик:
tcp 6 431994 ESTABLISHED src=192.168.10.57 dst=203.0.113.10 sport=51344 dport=443 src=10.20.0.11 dst=192.168.10.57 sport=443 dport=51344 [ASSURED] mark=0 use=1Первый кортеж — что отправил клиент: он стучится на публичный 203.0.113.10:443. Второй — откуда придёт ответ: с 10.20.0.11:443. Вот он, «старый адрес», который вы искали в конфиге. Число 431994 — это остаток времени жизни записи в секундах. Дефолт nf_conntrack_tcp_timeout_established в ядре — 432000 секунд, то есть пять суток. Само по себе это не рассосётся ни к обеду, ни к завтрашнему утру.
Отдельно проверьте вторую засаду, о которой вспоминают редко: аппаратный или программный fastpath. Если на шлюзе объявлен flowtable (nft list flowtables, nft list ruleset | grep flow), то установленные потоки уходят на быстрый путь и вообще минуют обычные цепочки. Тогда старый адрес живёт уже в двух местах сразу — и в conntrack, и в offload-таблице. На роутерах с OpenWrt программный offload включается одной галочкой в настройках firewall, и про неё часто забывают. Удаление записи conntrack обычно снимает и программный offload этого потока, но при аппаратном offload поведение зависит от драйвера — такой поток я проверяю отдельно.
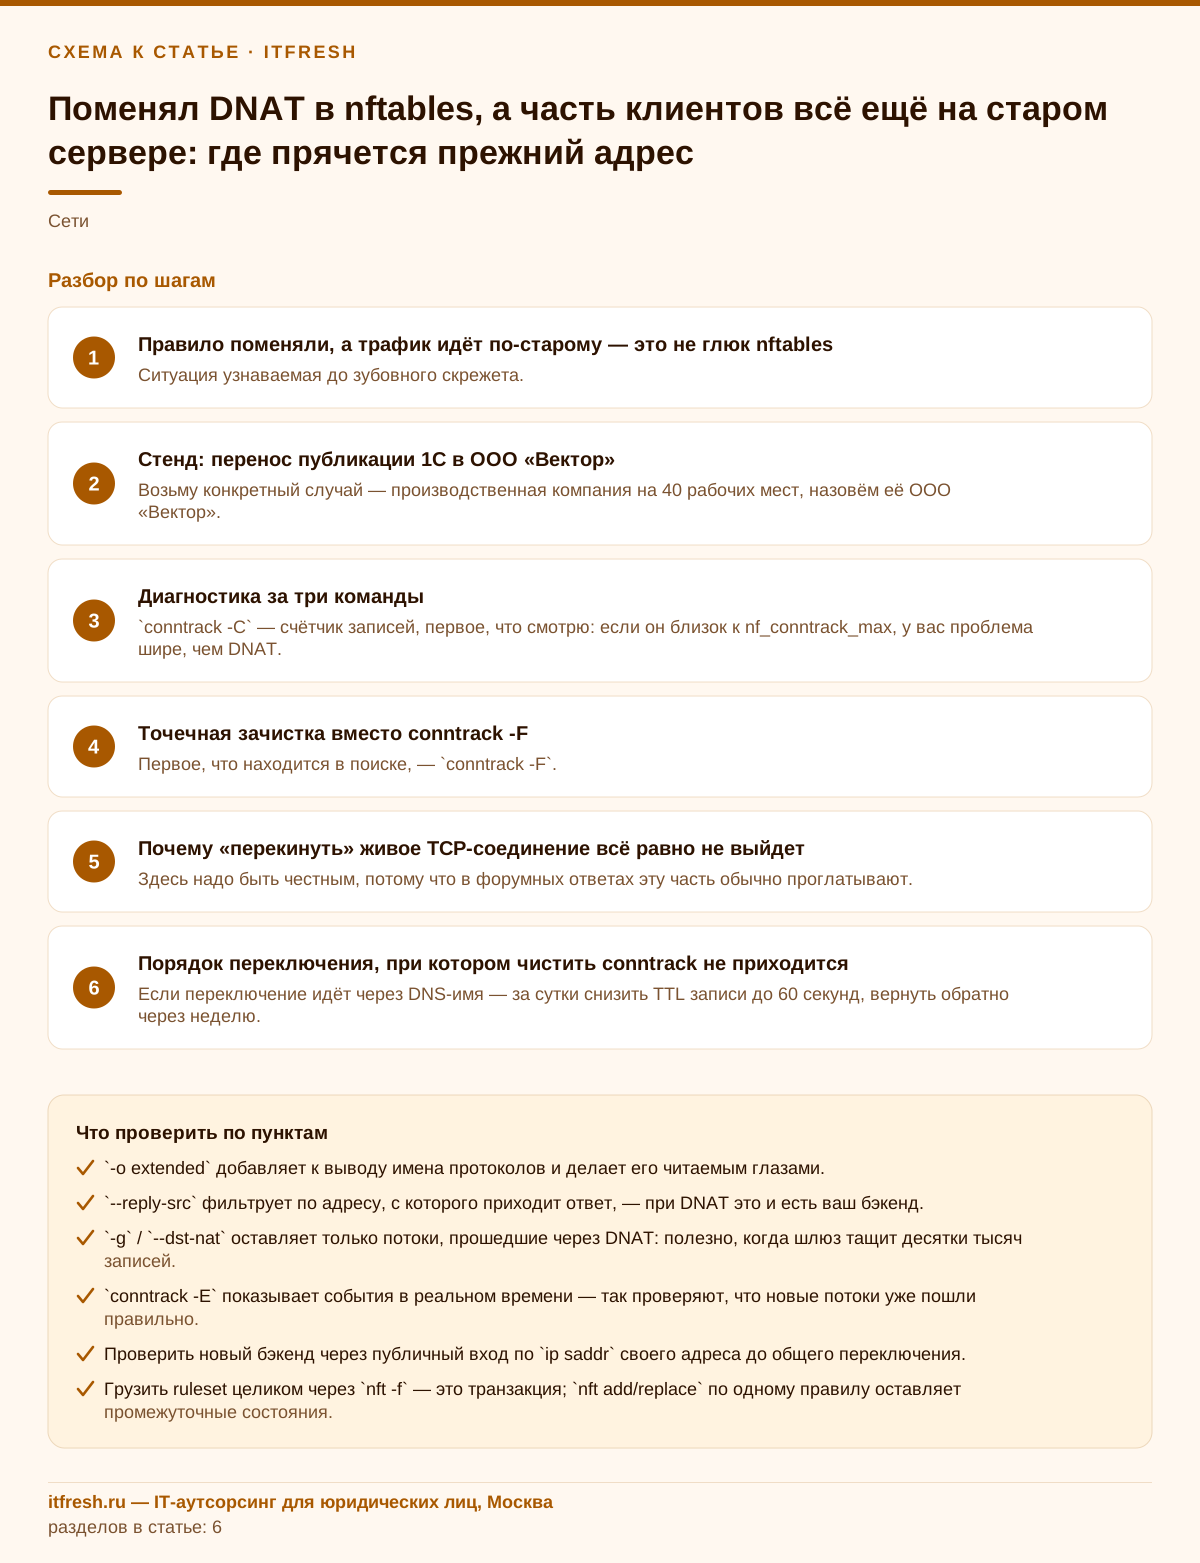
- `conntrack -C` — счётчик записей, первое, что смотрю: если он близок к nf_conntrack_max, у вас проблема шире, чем DNAT.
- `-o extended` добавляет в вывод сведения третьего уровня (семейство `ipv4 2`) — удобно, когда на шлюзе идёт и IPv4, и IPv6.
- `--reply-src` фильтрует по адресу, с которого приходит ответ, — при DNAT это и есть ваш бэкенд.
- `-d` / `--orig-dst` фильтрует по адресу назначения в исходном направлении — то есть по публичному адресу, на который стучится клиент.
- `-g` / `--dst-nat` оставляет только потоки, прошедшие через DNAT: полезно, когда шлюз тащит десятки тысяч записей.
- `conntrack -E` показывает события в реальном времени — так проверяют, что новые потоки уже пошли правильно.
Точечная зачистка вместо conntrack -F
Первое, что находится в поиске, — conntrack -F. Она честно делает то, что написано в мануале: flush the whole given table. Всю таблицу. На шлюзе из моего примера это 6 200 записей: ваша собственная SSH-сессия, туннель до выездного склада, кассы, отправляющие чеки оператору фискальных данных, эквайринг терминалов, RDP бухгалтера. Если в ruleset есть строчка вида ct state invalid drop — а она должна быть — то часть этих соединений после флаша попадёт в INVALID и будет молча убита. Я делал -F на боевом шлюзе ровно один раз, давно, и с тех пор не делаю.
Правильный инструмент — conntrack -D с теми же фильтрами, что и у -L. Порядок действий у меня жёсткий: сначала показать, потом удалить, фильтры символ в символ одинаковые.
# ШАГ 1. Показать ровно то, что собираемся удалить
conntrack -L -p tcp --reply-src 10.20.0.11 --reply-port-src 443 -o extended

# ШАГ 2. Убедиться, что счёт сходится
conntrack -L -p tcp --reply-src 10.20.0.11 --reply-port-src 443 2>/dev/null | wc -l

# ШАГ 3. Удалить те же самые записи
conntrack -D -p tcp --reply-src 10.20.0.11 --reply-port-src 443
На выходе -D печатает удалённые записи и итоговую строку с их количеством (в conntrack-tools она выглядит как «N flow entries have been deleted»). Сверьте N с числом из шага 2 — если оно заметно больше, значит фильтр шире, чем вы думали, и вы прибили лишнее. Такое бывает, когда забывают указать порт и сносят заодно служебные соединения к тому же серверу — SSH, SMB, агент мониторинга.
Полезные варианты фильтра под разные ситуации: --orig-dst 203.0.113.10 — если надо взять всё, что шло на конкретный публичный адрес; -s 192.168.10.57 — если надо аккуратно перекинуть одного тестового пользователя и посмотреть, что будет; --state ESTABLISHED — если хочется не трогать полуоткрытые. Комбинируются свободно, и это гораздо лучше, чем -F с последующим обзвоном офиса.
- `conntrack -F` очищает всю таблицу («Flush the whole given table») — рвёт вообще всё, что идёт через шлюз.
- `conntrack -D` принимает те же фильтры, что и `-L`: сначала листинг, потом удаление с тем же набором ключей.
- Фильтр по бэкенду: `--reply-src` + `--reply-port-src`; по публичному адресу: `-d`; по клиенту: `-s`.
- Число удалённых записей сверяйте с числом из листинга — расхождение означает, что фильтр шире задуманного.
- Свою SSH-сессию на шлюз проверяйте отдельно: `conntrack -L -p tcp --dport 22 -s <ваш_IP>` не должен попадать под фильтр удаления.
Почему «перекинуть» живое TCP-соединение всё равно не выйдет
Здесь надо быть честным, потому что в форумных ответах эту часть обычно проглатывают. Удалили запись из conntrack — и что дальше? Следующий пакет от клиента — это не SYN, а ACK где-то в середине потока. Ядро с дефолтным nf_conntrack_tcp_loose=1 подхватит такой поток как новый (в документации ядра прямым текстом: «If it is set to zero, we disable picking up already established connections»), пройдёт цепочку nat, применит свежее правило и отправит пакет на 10.20.0.21. А там про эту TCP-сессию никто не знает — ни про sequence numbers, ни про окно, ни про TLS-состояние. Ответ будет RST. Клиент увидит обрыв и переподключится — уже на правильный сервер.
То есть зачистка conntrack — это не бесшовный перенос, это управляемый обрыв. Соединение всё равно рвётся, вы лишь выбираете момент: сейчас, под вашим контролем, или через пять суток, когда истечёт таймер, и, скорее всего, посреди рабочего дня. Бесшовно перетащить установленную TCP-сессию с одного бэкенда на другой netfilter не умеет и уметь не может: состояние сессии живёт на сервере, а не на шлюзе. Кто обещает обратное — просто не проверял.
Если у вас nf_conntrack_tcp_loose=0 (встречается в «ужесточённых» шаблонах и в некоторых образах провайдеров), поведение будет чуть другим: пакет попадёт в состояние INVALID и, если есть соответствующее правило, будет отброшен. Обрыв тот же самый, только тише и без RST — клиент отвалится по таймауту. Проверить одной командой: sysctl net.netfilter.nf_conntrack_tcp_loose.
А вот с UDP всё гораздо приятнее, и это тот случай, когда можно спокойно ничего не делать. nf_conntrack_udp_timeout по умолчанию 30 секунд, nf_conntrack_udp_timeout_stream — 120. DNS, SIP, WireGuard, игровой трафик переедут на новый бэкенд сами, максимум за две минуты. Ради UDP-сервисов лезть в conntrack практически никогда не нужно — подождите три минуты и перепроверьте.
- Удаление записи не переносит TCP-сессию: следующий пакет уйдёт на новый сервер, тот ответит RST, клиент переподключится.
- При `nf_conntrack_tcp_loose=1` (по умолчанию) ядро подхватывает середину потока как новое соединение и прогоняет его через nat.
- При `nf_conntrack_tcp_loose=0` такой пакет становится INVALID и отбрасывается, если в ruleset есть `ct state invalid drop`.
- UDP-потоки переезжают сами: таймаут 30 секунд, для «потоковых» — 120 секунд.
Порядок переключения, при котором чистить conntrack не приходится
После истории в «СамокатГраде» я переделал у себя процедуру переезда сервиса за DNAT. Она скучная, но за два года не дала ни одного расхождения данных.
# 0. Проверить новый бэкенд ЧЕРЕЗ ТОТ ЖЕ публичный вход, но только для себя
nft insert rule ip nat prerouting iifname "eth0" ip saddr 203.0.113.77 \
    tcp dport 443 dnat to 10.20.0.21:443

# 1. Переключить всех: правим файл и грузим его целиком, атомарно
nft -f /etc/nftables.conf
nft -a list ruleset | grep dnat        # сверить handle и адрес

# 2. Смотреть, как рассасывается остаток на старом сервере
watch -n5 'conntrack -L -p tcp --reply-src 10.20.0.11 2>/dev/null | wc -l'

# 3. Через согласованное время добить хвост
conntrack -D -p tcp --reply-src 10.20.0.11 --reply-port-src 443
Ключевой шаг здесь — нулевой. Временное правило с фильтром по вашему собственному адресу источника (ip saddr) даёт проверить новый сервер ровно тем же путём, каким пойдут пользователи: тот же публичный IP, тот же сертификат, тот же SNI, те же заголовки от реверс-прокси. Половина «после переключения всё сломалось» ловится именно здесь, за пять минут до переключения, а не после него.
Шаг третий я делаю не молча. Сначала — сообщение пользователям «через 10 минут сессия закроется, сохранитесь и войдите заново», потом уже команда. Разница между «у нас сегодня сбой» и «у нас сегодня плановый переезд» ровно в этом сообщении, технически действия одинаковые.
Чего я принципиально не делаю — не кручу nf_conntrack_tcp_timeout_established в меньшую сторону, чтобы «быстрее рассасывалось». Пять суток по умолчанию стоят не от глупости: под этим таймаутом живут простаивающие, но нужные соединения: RDP-подключения, открытые на ночь, долгие сессии клиентов к серверу 1С, туннели до удалённых точек. Уменьшите до часа — получите массовые обрывы там, где их раньше не было, и будете месяц ловить «иногда вылетает из терминала». Если очень хочется, срок жизни правится точечно, через ct timeout в nftables для конкретного порта, а не глобальным sysctl.
- Если переключение идёт через DNS-имя — за сутки снизить TTL записи до 60 секунд, вернуть обратно через неделю.
- Проверить новый бэкенд через публичный вход по `ip saddr` своего адреса до общего переключения.
- Грузить ruleset целиком через `nft -f` — это транзакция; `nft add/replace` по одному правилу оставляет промежуточные состояния.
- Зафиксировать `conntrack -C` до и после — резкий скачок числа записей после переключения намекает на цикл переподключений.
- Не выключать старый сервер сразу: держать его час-другой доступным, но с запретом на новые подключения.
Когда DNAT не работает вовсе: forward, ip_forward, hairpin и трассировка
Обратная ситуация приходит ко мне не реже: правило DNAT есть, conntrack показывает трансляцию, а клиент получает таймаут. В 9 случаях из 10 виноват не NAT, а то, что стоит после него. Хук prerouting только переписывает адрес назначения, пропускать пакет дальше решает цепочка forward. Если у неё policy drop, а разрешения для транслированных потоков нет, пакет молча умирает. Второй кандидат — выключенная маршрутизация: без net.ipv4.ip_forward=1 шлюз не пересылает пакеты между интерфейсами вообще, по умолчанию параметр равен 0.
Минимальная рабочая схема у меня выглядит так. В forward не надо дублировать адрес и порт бэкенда: достаточно разрешить всё, что прошло DNAT, через ct status dnat — тогда при смене цели правило фильтра править не придётся.
table inet filter {
  chain forward {
    type filter hook forward priority filter; policy drop;
    ct state established,related accept
    ct state invalid drop
    ct status dnat accept
    iifname "eth1" oifname "eth0" accept
  }
}
# Маршрутизация: проверить и закрепить
sysctl net.ipv4.ip_forward
echo 'net.ipv4.ip_forward = 1' > /etc/sysctl.d/99-forward.conf
sysctl --systemОтдельная грабля — hairpin NAT, когда к публичному адресу обращаются изнутри. В «СамокатГраде» кассы и ноутбук кладовщика стоят в том же сегменте 10.20.0.0/24, что и сервер 1С, а ярлык у всех один — на публичное имя. Во-первых, правило iifname "eth0" ... dnat для них не срабатывает: пакет пришёл с eth1, поэтому я матчу по ip daddr 203.0.113.10, а не по интерфейсу. Во-вторых, после DNAT сервер видит адрес кассы из своей же подсети и отвечает ей напрямую, минуя шлюз. Касса ждала ответ от 203.0.113.10, а получила от 10.20.0.21 — TCP такое не принимает, соединение не устанавливается. Лечится маскарадингом таких потоков на шлюзе, чтобы ответ вернулся через него:
table ip nat {
  chain prerouting {
    type nat hook prerouting priority dstnat; policy accept;
    ip daddr 203.0.113.10 tcp dport 443 dnat to 10.20.0.21:443
  }
  chain postrouting {
    type nat hook postrouting priority srcnat; policy accept;
    oifname "eth0" ip saddr 10.20.0.0/24 masquerade
    ip saddr 10.20.0.0/24 ip daddr 10.20.0.21 tcp dport 443 ct status dnat masquerade
  }
}
Когда глазами уже не видно, где теряется пакет, включаю трассировку. nftables умеет помечать пакеты meta nftrace set 1 и показывать их путь по всем цепочкам через nft monitor trace. Цепочку-трассировщик вешаю отдельной таблицей с приоритетом -301, чтобы она стояла раньше всех остальных в prerouting, и удаляю её сразу после разбора:
nft add table inet trace
nft add chain inet trace pre '{ type filter hook prerouting priority -301; }'
nft add rule inet trace pre ip daddr 203.0.113.10 tcp dport 443 meta nftrace set 1
nft monitor trace
# после разбора
nft delete table inet trace
В выводе трассировки хорошо видна та самая механика из начала статьи: цепочку nat prerouting проходит только первый пакет соединения, у последующих её в трассе нет — они транслируются по записи conntrack. Если трасса обрывается на forward с policy drop, ищите недостающее разрешение; если пакет проходит всё, а ответа нет, смотрите conntrack -L -d 203.0.113.10 и tcpdump на бэкенде: чаще всего это hairpin или маршрут сервера по умолчанию не через шлюз.
- `sysctl net.ipv4.ip_forward` должен вернуть 1, иначе шлюз не пересылает пакеты между интерфейсами.
- В forward нужно разрешение для транслированных потоков: `ct status dnat accept` плюс `ct state established,related accept`.
- Для доступа изнутри по публичному адресу матчите DNAT по `ip daddr`, а не по `iifname` внешнего интерфейса.
- Если клиент и сервер в одной подсети, нужен hairpin: `masquerade` или `snat` для потоков со статусом `dnat`.
- У сервера шлюз по умолчанию должен смотреть на этот же шлюз — иначе ответы уйдут другим путём.
- `nft monitor trace` вместе с `meta nftrace set 1` показывает, в какой цепочке и каким правилом решена судьба пакета.
Чек-лист и на что можно забить
Свожу всё в порядок действий, который отдаю своим инженерам. Он умещается на половину страницы и закрывает 90 % случаев «поменял правило, а трафик идёт не туда».
И отдельно — про то, на что можно смело забить, потому что вокруг conntrack накручено много лишней тревоги. Не надо перезагружать шлюз: это то же самое, что conntrack -F, только грубее и с простоем. Не надо выгружать модуль nf_conntrack — на боевом шлюзе он у вас всё равно занят, а если выгрузится, положите весь NAT. Не надо править nf_conntrack_max «на всякий случай»: по умолчанию он рассчитывается от объёма памяти, и если conntrack -C показывает единицы тысяч при потолке в сотни тысяч — трогать нечего.
Не надо и паниковать из-за самих записей conntrack: это нормальный механизм, без него не работают ни NAT, ни stateful-фильтрация. Проблема не в том, что состояние сохраняется, а в том, что администратор про него забывает при изменении правил. Один раз встроите проверку conntrack -L в свою процедуру изменения NAT — и этот класс инцидентов у вас закончится.
- Если DNAT не работает вовсе: `sysctl net.ipv4.ip_forward`, разрешение `ct status dnat accept` в forward, hairpin для внутренних клиентов, затем `nft monitor trace`.
- Убедиться, что правило реально загружено: `nft -a list ruleset` (с handle, чтобы потом точно знать, что правите).
- Посмотреть живые потоки на старый бэкенд: `conntrack -L --reply-src <старый_IP> -o extended`.
- Проверить fastpath: `nft list flowtables` — если он есть, старые потоки минуют цепочки.
- Проверить `sysctl net.netfilter.nf_conntrack_tcp_loose` — от него зависит, будет ли RST или тихий дроп после зачистки.
- Предупредить пользователей, что сессии закроются, и только потом делать `conntrack -D` с проверенным фильтром.
- Убедиться после: `conntrack -L --reply-src <старый_IP> | wc -l` должно дать 0, а `conntrack -E` — показать новые потоки на новый адрес.
- Через сутки проверить старый сервер на предмет случайного трафика — если он есть, где-то остался второй путь (прямой маршрут, hosts, VPN-правило).
Частые вопросы
Я загрузил новый ruleset через nft -f, а трафик всё равно идёт на старый сервер. Правило не применилось?
Применилось. Цепочка типа nat проходится только для первого пакета потока — дальше ядро использует NAT-сопоставление, сохранённое в nf_conntrack. Все соединения, установленные до вашей правки, продолжат ходить на старый адрес. Проверьте командой `conntrack -L --reply-src <старый_IP> -o extended`: если записи есть, вы нашли причину.
Можно ли просто выполнить conntrack -F и не мучиться?
Технически можно, практически — не стоит. `-F` очищает всю таблицу отслеживания соединений: рвутся SSH-сессии администратора, IPsec- и VPN-туннели, коннекты приложений к SQL, RDP-сессии пользователей. Если в ruleset есть `ct state invalid drop`, часть трафика после флаша будет молча отброшена. Используйте `conntrack -D` с фильтрами.
Как удалить только те записи, которые уходят на старый бэкенд?
Отфильтруйте по ответному адресу и порту: `conntrack -D -p tcp --reply-src 10.20.0.11 --reply-port-src 443`. Перед удалением обязательно выполните ту же команду с `-L` вместо `-D` и посчитайте строки — так вы увидите, что именно снесёте. Полезны также `--orig-dst` (публичный адрес), `-s` (конкретный клиент) и `-g` (только DNAT-потоки).
Соединения пользователей при этом разорвутся?
Да. Перенести живую TCP-сессию на другой сервер невозможно в принципе: состояние сессии (sequence numbers, окно, TLS) находится на бэкенде, а не на шлюзе. После удаления записи следующий пакет уйдёт на новый сервер и получит RST, клиент переподключится. Это управляемый обрыв, и его стоит заранее анонсировать пользователям.
Через сколько старые записи исчезнут сами, если ничего не делать?
Для установленных TCP-соединений дефолт `nf_conntrack_tcp_timeout_established` — 432000 секунд, то есть пять суток простоя потока. Ждать бессмысленно. С UDP наоборот: `nf_conntrack_udp_timeout` — 30 секунд, `nf_conntrack_udp_timeout_stream` — 120, так что DNS, SIP и WireGuard переедут сами за пару минут.
Это особенность nftables? В iptables было иначе?
Одинаково. И iptables, и nftables используют одну подсистему nf_conntrack, и в обоих случаях таблица/цепочка NAT проходится только для первого пакета потока (состояние NEW). Разница только в синтаксисе правил, механика состояния общая.
Правило DNAT есть, conntrack показывает трансляцию, а соединение не устанавливается. Где смотреть?
Сначала `sysctl net.ipv4.ip_forward` — должно быть 1. Затем цепочка forward: при `policy drop` нужно разрешение `ct status dnat accept`. Если проблема только у внутренних клиентов, обращающихся на публичный адрес, это hairpin: добавьте в postrouting `masquerade` для таких потоков. Точное место потери пакета покажет `nft monitor trace` с правилом `meta nftrace set 1`.
Я вычистил conntrack, а трафик всё равно идёт на старый адрес. Что ещё?
Проверьте fastpath: `nft list flowtables`. Если объявлен flowtable, установленные потоки уходят на быстрый путь и минуют обычные цепочки. Второй кандидат — второй маршрут в обход шлюза (прямая видимость по L2, запись в hosts, отдельное правило в VPN). Третий — кэш DNS на клиентах, если переключение шло через имя.
Источники
- nftables wiki — Performing Network Address Translation (NAT) — Официальная вики nftables, раздел о NAT: цепочки type nat hook prerouting/postrouting, синтаксис dnat/snat/masquerade и утверждение «The first packet of a flow is used to look up for a matching rule which sets up the NAT binding for this flow». https://wiki.nftables.org/wiki-nftables/index.php/Performing_Network_Address_Translation_(NAT)
- conntrack(8) — руководство по утилите conntrack, conntrack-tools 1.4.9 — Man-страница conntrack(8): команды -L/--dump, -D/--delete, -F/--flush («Flush the whole given table»), -E/--event, -C/--count и фильтры --orig-src/--orig-dst, --reply-src/--reply-dst, --orig-port-src/--orig-port-dst, -p/--proto, --state, -n/--src-nat, -g/--dst-nat, -j/--any-nat, -o extended. https://manpages.debian.org/unstable/conntrack/conntrack.8.en.html
- Linux kernel documentation — Netfilter Conntrack Sysfs variables — Документация ядра по sysctl nf_conntrack: nf_conntrack_tcp_timeout_established = 432000 с (5 суток), nf_conntrack_udp_timeout = 30 с, nf_conntrack_udp_timeout_stream = 120 с, nf_conntrack_tcp_loose («If it is set to zero, we disable picking up already established connections»), расчёт nf_conntrack_buckets от объёма памяти (nf_conntrack_max по умолчанию равен nf_conntrack_buckets). https://docs.kernel.org/networking/nf_conntrack-sysctl.html
- netfilter.org — проект conntrack-tools — Домашняя страница conntrack-tools (утилита conntrack и демон conntrackd), список релизов: 1.4.9, 1.4.8, 1.4.7. https://www.netfilter.org/projects/conntrack-tools/index.html
- Launchpad — пакет nftables в Ubuntu 24.04 LTS (noble) — Версии в noble: 1.0.9-1build1 (release) и 1.0.9-1ubuntu0.1 (updates). https://launchpad.net/ubuntu/noble/+source/nftables
- nftables wiki — Netfilter hooks — Таблица приоритетов (raw -300, mangle -150, dstnat -100, filter 0, security 50, srcnat 100) и требование приоритета NAT-цепочек больше -200 (conntrack). https://wiki.nftables.org/wiki-nftables/index.php/Netfilter_hooks
- nftables wiki — Matching connection tracking stateful metainformation — Выражения ct state и ct status (expected, seen-reply, assured, confirmed, snat, dnat, dying). https://wiki.nftables.org/wiki-nftables/index.php/Matching_connection_tracking_stateful_metainformation
- nftables wiki — Ruleset debug/tracing — Трассировка: meta nftrace set 1 в цепочке с приоритетом -301 и просмотр через nft monitor trace. https://wiki.nftables.org/wiki-nftables/index.php/Ruleset_debug/tracing
- Linux kernel documentation — IP Sysctl — Параметр net.ipv4.ip_forward (пересылка пакетов между интерфейсами, по умолчанию выключена). https://docs.kernel.org/networking/ip-sysctl.html