
Как я готовлю Zimbra к полной потере сервера
После полной потери сервера Zimbra я сначала изолирую старую установку и выбираю пригодную копию, затем восстанавливаю данные подходящим для неё способом. Доступ открываю после проверки доставки и содержимого ящиков. Ниже — план с точками контроля, ответственными и учебным расчётом времени для типографии «Оттиск»: что подготовить заранее и когда остановить неудачное восстановление.
Что должно быть в плане до отказа Zimbra
Я начинаю с договорённости о результате: какие ящики нужны первыми, сколько может стоять переписка и какой промежуток данных допустимо потерять. Для корпоративной почты компании это часть эксплуатации. RTO — предельно допустимое время недоступности, RPO — допустимая потеря данных, выраженная интервалом времени. Их согласуют с бизнесом до аварии. Учения показывают, укладываемся ли мы в эти цели. Время, которое получилось на стенде, само по себе не становится согласованным RTO.
Следом я составляю паспорт установки: редакция и точная сборка Zimbra, уровень патчей, ОС, способ резервирования, состав узлов и расположение томов. Отдельно записываю имена узлов, домены, маршрут входящей почты, сертификаты, расширения и внешнюю авторизацию, если она используется. Слова «обычная Zimbra» для восстановления бесполезны: образ машины, согласованная файловая копия и архив модуля Backup требуют разных процедур. Рядом с паспортом должны лежать доступные установочные пакеты и сведения о необходимых лицензиях.
На каждую копию я завожу карточку: время последней пригодной точки, место хранения, состав данных, зависимости от других частей архива и результат последней проверки восстановления. Проверяю доступ к ней с резервной площадки. Архив на диске погибшего сервера может быть целым и при этом недоступным. Отдельно выясняю, включены ли все почтовые тома и внешние хранилища. Размер каталога ничего не говорит о полноте: письма, сведения о ящиках и настройки должны соответствовать выбранному способу восстановления.
Здесь я разбираю отказ всего сервера: от решения о переключении до разрешения сотрудникам работать. Проверку отдельного ящика мы вынесли в материал про восстановление Zimbra из бэкапа. Для аварийного плана мне дополнительно нужны резервная машина, независимый доступ к инструкции и условия переключения доставки. Если хотя бы один из этих пунктов существует только в голове отсутствующего администратора, я записываю это как незакрытую задачу.
- Цели: допустимый простой, допустимая потеря данных, приоритетные ящики.
- Паспорт: сборка, патчи, ОС, модули и схема размещения данных.
- Копия: пригодная точка, состав, доступ и проверенный способ восстановления.
- Решение: ответственный, условия переключения и порядок возврата.
Как связаны LDAP, хранилище и очередь MTA
LDAP хранит учётные записи и конфигурацию Zimbra. Почтовое хранилище включает содержимое сообщений, метаданные и индексы; это не одна «база Store». MTA принимает и отправляет письма, а внутренняя доставка в почтовый узел использует LMTP. При восстановлении всей системы каталог действительно является важной зависимостью. Но из этой схемы нельзя вывести универсальное правило ручного запуска «LDAP, затем Store, затем MTA, затем веб». Состав служб и действия зависят от развёртывания и выбранной процедуры.
Для штатного управления службами я использую zmcontrol. Команда start запускает настроенные службы узла, status показывает их состояние; restart — предусмотренная команда перезапуска. Сам по себе штатный перезапуск не является причиной повреждения индексов. Если носитель неисправен или база не открывается, повторные старты не устраняют причину: я сохраняю сообщения об ошибках и проверяю среду. Кнопка перезапуска — слабый диагност, хотя всегда под рукой.
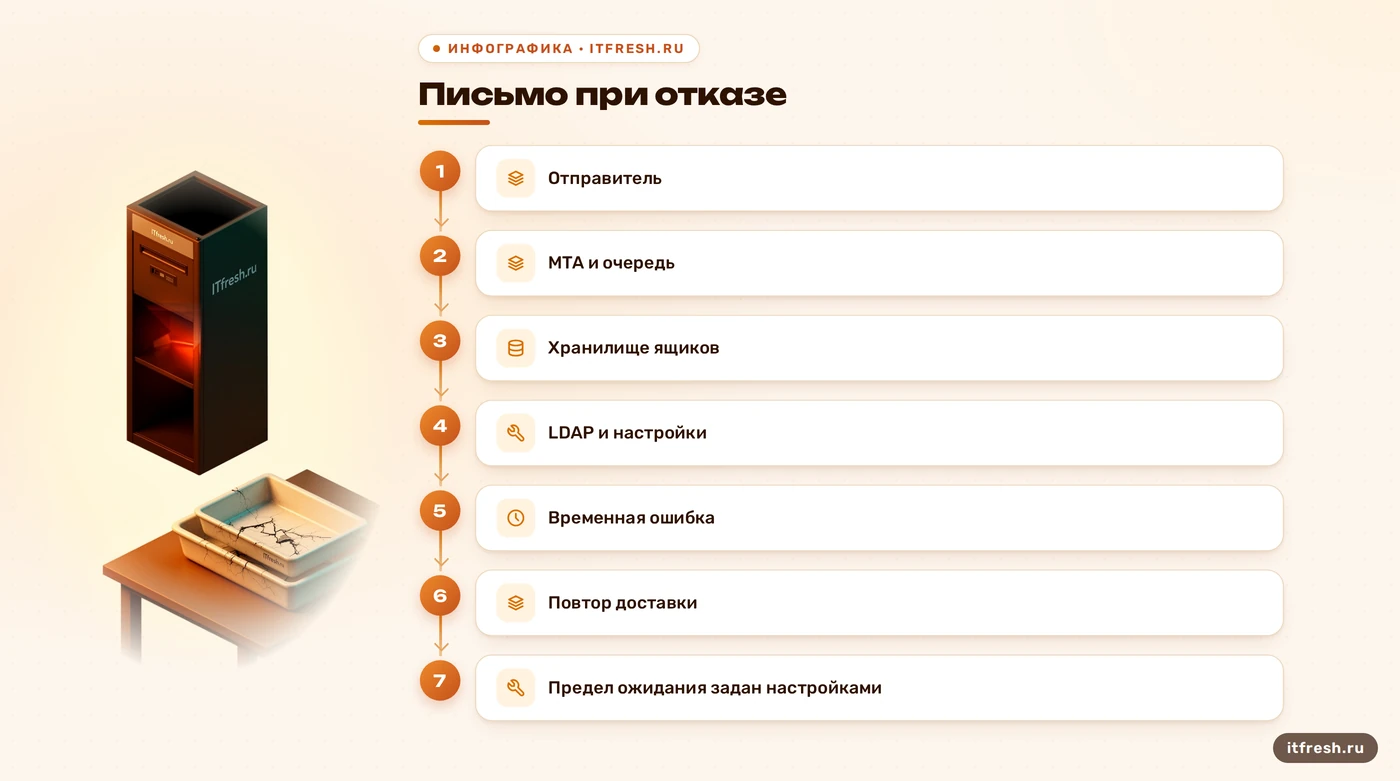
Недоступность почтового хранилища также не означает автоматическую потерю всей входящей почты. При временной ошибке доставки Postfix откладывает сообщение и повторяет попытки. Когда исчерпан настроенный срок нахождения в очереди, возможен возврат отправителю. Поведение зависит от ошибки, состояния очереди, диска и настроек. Я выясняю, где уже принятые письма: на старом MTA, отдельном шлюзе или у отправителей. Архив ящиков не даёт оснований считать принятую, но ещё не доставленную очередь восстановленной.
Поэтому план разделяет восстановление данных и открытие почтового потока. Пока новый узел не проверен, я не направляю в него рабочую доставку и не допускаю независимую работу старого и нового серверов с одними ящиками. Состояние очереди проверяю до переключения и после него; отдельно смотрю возраст ожидающих сообщений и причины задержек. Подход к наблюдению разобран в статье про мониторинг служб и очередей. Для решения о готовности нужен успешный путь письма целиком.
- Каталог: доступны учётные записи и нужная конфигурация.
- Хранилище: открываются письма, вложения и папки.
- Доставка: известна судьба очереди и проходят контрольные письма.
- Доступ: пользователи подключаются только к выбранному рабочему узлу.
Учебный разбор: типография «Оттиск», 36 рабочих мест
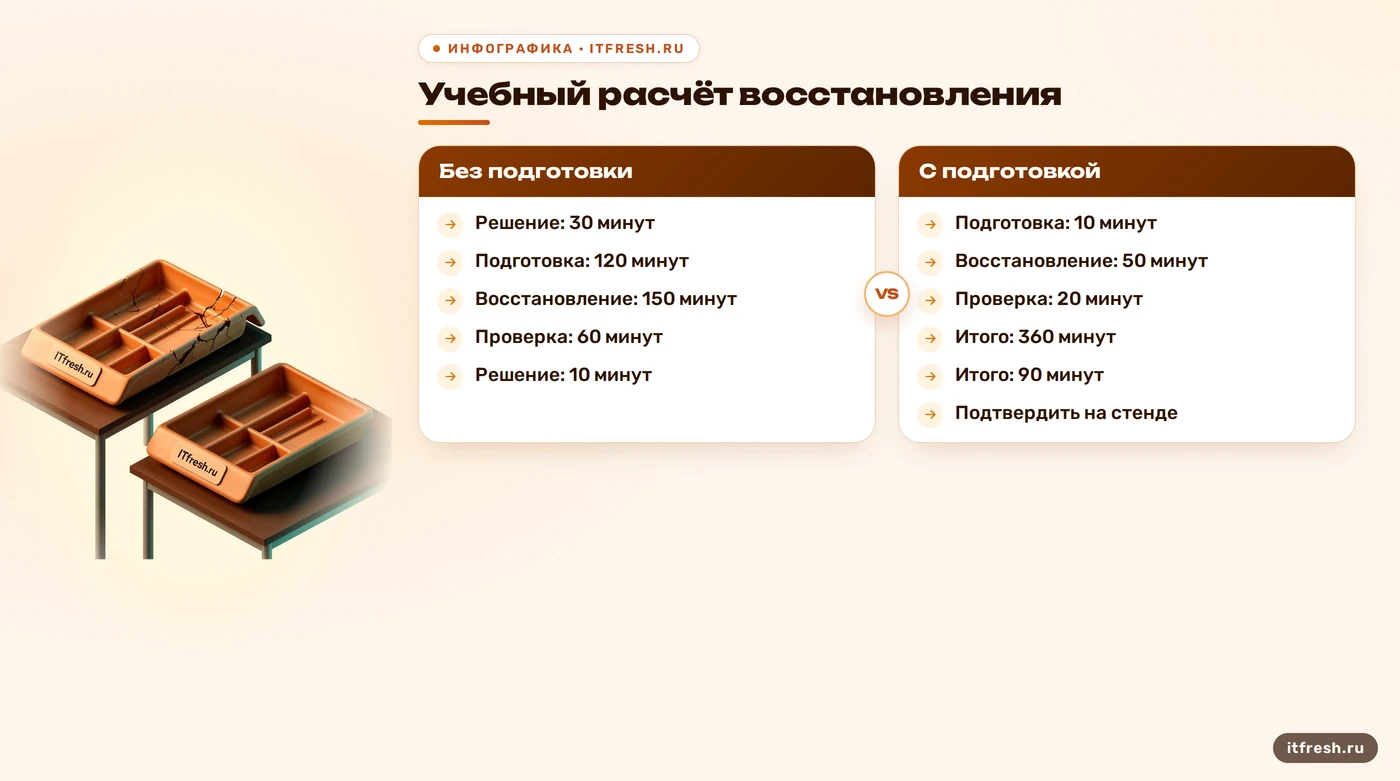
Возьму заданного условного клиента — подмосковную типографию «Оттиск» с 36 рабочими местами. Это учебный сценарий полной потери почтового сервера; числа ниже служат расчётом, а не отчётом о реальной аварии. Допустим, руководство согласовало RTO 90 минут. Копия вынесена с основного сервера, но резервная машина не подготовлена. В таком плане обещание быстрого запуска ничем не обеспечено: сначала предстоит получить ресурсы, установить окружение и проверить доступ к архиву.
Для расчёта заложу 30 минут на обнаружение отказа и решение, 120 минут на подготовку машины, 150 минут на восстановление данных и 60 минут на проверки с переключением. Сумма — 360 минут, то есть 6 часов. Это оценка последовательного сценария; каждый этап затем надо измерить. Я не объявляю эти сроки нормой для Zimbra. Так видно другое: цель 90 минут уже не сходится с планом, даже если сама резервная копия пригодна и импорт завершится без ошибок.
Теперь меняю подготовку: совместимая резервная машина уже развёрнута, доступ к копии проверен, инструкция содержит отдельные действия для настроек и очереди. Для повторного расчёта ставлю 10 минут на решение, 10 на подготовку, 50 на восстановление и 20 на проверку с переключением. Получается 90 минут, но пока это только гипотеза для учения. Объём писем, скорость чтения архива и производительность целевых дисков в этом примере не заданы. Выдавать арифметику за доказанную скорость было бы продажей секундомера без батарейки.
На разборе я назначаю ответственного на каждый этап и записываю, какие зависимости он должен снять заранее. Резервная машина сокращает подготовку, но установленное ПО ещё не делает её «горячим» резервом с актуальными данными. Если измеренное восстановление не помещается в цель, у нас есть предметный выбор: ускорить доступ к копии, изменить способ восстановления, заранее подготовить ресурсы или согласовать другой RTO. Критерии приёмки я при этом сохраняю: урезать проверку ради красивого времени — значит спрятать часть простоя.
- Учебная цель: RTO 90 минут, требует проверки на стенде.
- Без подготовки: 30 + 120 + 150 + 60 = 360 минут.
- С подготовкой: 10 + 10 + 50 + 20 = 90 минут.
- Результат учений: фактическое время, ошибки и список доработок.
Как восстановить сервер, не смешав разные методы
Сначала я прекращаю неконтролируемые изменения старой установки и сохраняю доступные данные с учётом состояния носителя. При признаках отказа диска дополнительные записи могут ухудшить возможность извлечения данных. Затем выбираю одну ветку восстановления: образ машины, согласованная файловая копия либо архив конкретного модуля. Копирование каталога /opt/zimbra с работающего сервера само по себе не гарантирует согласованного состояния баз и сообщений. В инструкции должно быть указано, как получена копия и какие дополнительные тома ей нужны. Архив не обязан угадывать, какой метод мы имели в виду.
Для классического полного восстановления Network Edition руководство требует ту же версию Zimbra, что была на исходном сервере. Это требование конкретного метода. Zextras Backup описывает импорт данных между разными окружениями, однако совместимость установленного модуля, исходной и целевой сборок надо проверить заранее. Я не совмещаю аварийное восстановление с экспериментальным обновлением. Перед действиями фиксирую сборку и состояние служб. На работающей установке следующие команды выполняются от root и только читают сведения:
su - zimbra -c 'zmcontrol -v'
su - zimbra -c 'zmcontrol status'
При замене файлов рабочих баз соответствующие процессы должны быть остановлены до записи восстановленных данных. Для обычной остановки служб узла из root используется su - zimbra -c 'zmcontrol stop'; итоговый штатный запуск — su - zimbra -c 'zmcontrol start'. Между ними выполняется выбранная процедура, а не произвольное копирование архива. Требование остановить вообще всё перед любым восстановлением неверно: импорт через работающий модуль и отдельные этапы классического восстановления требуют доступных зависимостей. Конкретные состояния служб я переношу в инструкцию из руководства своей сборки.
Для уже используемой совместимой связки с Zextras Backup я заранее проверяю работу резервирования изменений. Real Time Scanner отслеживает изменения объектов без остановки рабочей почты, а SmartScan обрабатывает изменения после предыдущего прохода. Это конкретные возможности модуля, а не обещание нулевой потери данных. Проверяю завершение операций, доступность хранилища и актуальность точки. Пользователь zimbra должен иметь права, необходимые выбранной операции; рабочий Backup Path в документации Zextras требует чтения и записи. Я не исправляю отказ доступа раздачей прав всем подряд.
У импорта Zextras есть отдельный этап для конфигурации: настройки сервера и глобальные настройки не применяются автоматически вместе с почтовыми объектами. Я сверяю сохранённую конфигурацию с целевым окружением и восстанавливаю нужное отдельно. Проверяю DNS, имена узлов, сертификаты и маршруты доставки до открытия доступа. После установки сертификата документация предусматривает перезапуск служб Zimbra; общая перезагрузка ОС не является обязательным шагом этой операции. Завершив восстановление, я проверяю работу и создание новой резервной копии, затем разрешаю переключение.
- Зафиксировать отказ и сохранить исходные данные, не переписывая единственную копию.
- Выбрать метод и проверить совместимость окружения.
- Подготовить тома, доступ к архиву и состояния служб для этой процедуры.
- Восстановить данные и отдельно сверить конфигурацию.
- Проверить доставку, доступ и новую копию; разрешить переключение.
Что проверять на учениях и перед открытием доступа
Учения я провожу в отдельной изолированной среде: исходную рабочую систему сохраняю. В тестовой копии исключаю доставку наружу и подключения сотрудников, проверяю изоляцию до запуска восстановленного узла. Одинаковые имена в клоне не должны случайно перехватить рабочую почту. Для сценария с откатом снимка и последующим импортом Zextras путь резервирования должен оставаться независимым от отката: иначе вместе с машиной можно вернуть назад и данные, которыми собирались дополнить восстановление.
Проверка целостности архива и проверка сервиса решают разные задачи. В Zextras Backup Coherency Check проверяет метаданные и файлы содержимого глубже, чем инкрементный SmartScan. Но даже успешная проверка архива не доказывает, что на новой машине правильно настроена доставка. Я сохраняю отчёт об операции и отдельно проверяю результат глазами пользователя. При повреждении копии сначала оцениваю, что можно восстановить из неё и других доступных точек; единственный архив не отдаю под исправления без сохранения исходного состояния.
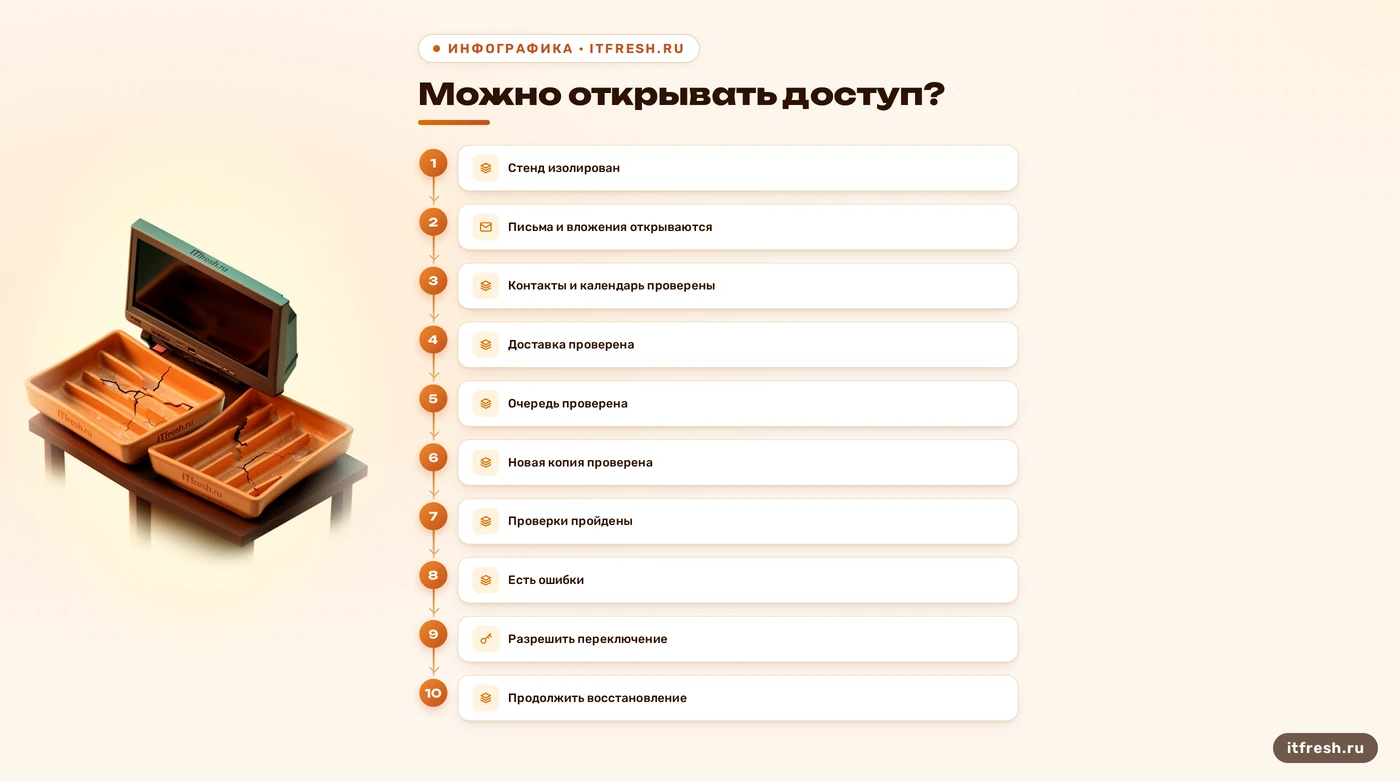
Приёмку строю вокруг контрольных действий: вход в веб-почту, открытие старого письма и вложения, поиск, просмотр папок, проверка контактов и календаря. Включаю ящики с делегированным доступом и правилами, если ими пользуются. Сравниваю выбранные контрольные сообщения с исходным состоянием и смотрю отчёт о пропущенных объектах. Одна открывшаяся страница входа не подтверждает восстановление. Для подготовки такого прогона полезен изолированный тестовый стенд. Зелёный статус службы радует, но вложение за неё не откроет.
Рабочую доставку принимаю отдельным контролируемым этапом: проверяю письмо с внешнего ящика внутрь, ответ наружу и переписку между внутренними ящиками. Для каждого письма фиксирую отправку, появление у получателя и отсутствие необъяснённой задержки в очереди. Измеряю весь простой: обнаружение, решение, подготовку, восстановление, проверку и переключение. Фактическую доступную точку данных сопоставляю с RPO. Я предлагаю повторять учение после существенных изменений и по согласованному графику; квартал может быть рабочим интервалом, но это моя рекомендация, а не обязательная норма Zimbra.
- Изоляция подтверждена до запуска тестовой машины.
- Содержимое ящиков и важные функции проверены.
- Доставка в обе стороны и внутренняя переписка проходят.
- Состояние очереди известно, пропуски объектов разобраны.
- Фактические сроки и точка данных сопоставлены с RTO и RPO.
Кто разрешает переключение и когда нужен откат
В небольшом офисе один человек может выполнять несколько ролей. Я всё равно разделяю решения: руководитель подтверждает допустимый простой и потерю данных, технический ответственный выбирает пригодную точку и ведёт восстановление, назначенный сотрудник сообщает статус. На время работ фиксирую, кто меняет DNS и маршрут доставки. Два независимых исполнителя с разными представлениями о рабочем узле способны создать две расходящиеся версии переписки. Такой параллелизм нам не нужен.
Короткий аварийный лист я храню вне восстанавливаемой почты. В нём — способ получить инструкцию, контакты ответственных, место копий, доступ к резервным ресурсам, проверки и условия переключения. Пароли остаются в защищённом хранилище; отдельно проверяю, как дежурный откроет его при отказе обычного входа. Доступ выдаётся участникам восстановления по их задачам. Совет раздать подробную инструкцию с секретами всем сотрудникам только добавит другую проблему.
Заранее назначаю условия остановки: архив недоступен, восстановление сообщает о пропусках, целевая база не открывается, контрольные письма не проходят или прогноз уже выходит за согласованный срок. При такой ситуации я фиксирую состояние и выбираю следующую доступную точку либо другой подготовленный способ восстановления. Если на новый сервер уже поступили письма, простое возвращение на старый образ оставит их вне рабочей системы. Сначала сохраняю и учитываю новые данные. План отката обязан отвечать на вопрос, что делать с перепиской после переключения.
После открытия доступа наблюдаю очередь, ошибки приложений, вход пользователей и новую резервную копию. Сообщение руководству содержит факты: какие функции доступны, до какой точки вернулись данные, какие проверки пройдены и что ещё требует работы. В журнале оставляю выбранный архив, исполненные действия и причины отклонений. Затем исправляю инструкцию по результатам прогона или аварии. Я хочу передать следующему дежурному работающий порядок действий. Папка с названием «всё проверено» этого результата не создаёт.
- Руководитель согласует цели и допустимые потери.
- Технический ответственный ведёт восстановление и журнал.
- Назначенный исполнитель управляет переключением доставки.
- Результат принимают по проверкам; остаточные проблемы записывают.
Частые вопросы
Нужно ли вручную запускать LDAP, затем Store и MTA?
Я проверяю зависимости и выполняю процедуру для своей сборки и способа восстановления. Штатный запуск служб узла выполняет zmcontrol start. Универсальной очереди ручного запуска для всех установок нет.
Потеряются ли письма, если хранилище ещё недоступно?
Не обязательно. При временной ошибке Postfix откладывает доставку и повторяет попытки. Дальнейшая судьба письма зависит от ошибки, состояния очереди и настроенного срока ожидания. Я проверяю очередь отдельно от архива ящиков.
Можно ли восстановить Zimbra на другой версии или ОС?
Это зависит от метода. Классическое полное восстановление Network Edition требует ту же версию Zimbra. Импорт Zextras Backup допускает разные окружения в рамках совместимости продукта. Я проверяю конкретные сборки и модули на стенде.
Нужно ли останавливать все службы перед восстановлением?
При файловой замене рабочих данных запись нужно остановить до восстановления. Импорт через работающий модуль и некоторые этапы штатного восстановления требуют доступных служб. Состояния задаёт выбранная процедура.
Доказывают ли учения, что RTO выдержан?
Только если измерены все этапы до доступности согласованных функций и результат сравнили с заранее установленным RTO. Я отдельно проверяю точку данных относительно RPO и повторяю учение после существенных изменений.
Источники
- Zimbra — Collaboration Administrator Guide — Классический Backup/Restore и управление zmcontrol: зависимости, состояния служб, требование той же версии при полном восстановлении. Руководство относится к Network Edition 8.8.15, не ко всем современным сборкам. https://zimbra.github.io/adminguide/latest/
- Zextras — Zextras Backup — Проверены Real Time Scanner, инкрементный SmartScan, Coherency Check, требования к Backup Path и отдельная обработка конфигурации. Уточнение фактов экспертной базы о резервировании без остановки и получении настроек. https://docs.zextras.com/suite/html/backup.html
- Zextras — Disaster Recovery with Zextras Suite — Проверены импорт в подготовленную установку, отсутствие автоматического применения глобальных и серверных настроек, изоляция клона и независимость Backup Path от отката снимка. https://community.zextras.com/disaster-recovery/
- Postfix — Configuration Parameters — Проверено поведение при временной ошибке доставки: отложенная очередь, повторные попытки и ограничение времени ожидания. Конкретный срок из настроек по умолчанию в статью не перенесён. https://www.postfix.org/postconf.5.html
- AWS — Recovery objectives — Проверены определения RTO и RPO: допустимый срок недоступности и допустимая потеря данных по времени. Учебные сроки типографии не выдаются за нормы или измерения. https://docs.aws.amazon.com/whitepapers/latest/disaster-recovery-of-on-premises-applications-to-aws/recovery-objectives.html
- Zimbra — Administration Console and CLI Certificate Tools — После установки сертификата описан перезапуск служб Zimbra. Обязательная перезагрузка ОС из этого не следует. https://wiki.zimbra.com/wiki/Administration_Console_and_CLI_Certificate_Tools