
Как я проверяю Zimbra: службы живы, а письма дошли?
Для мониторинга Zimbra я проверяю службы, очередь SMTP, запас места, сертификаты и доставку тестового письма через IMAP. Ответ на ping и статус Running сами по себе не доказывают, что почта работает. Ниже — команды, правила оповещения и учебный разбор для мастерской «Глина дома».
Что проверять, если Zimbra отвечает на ping
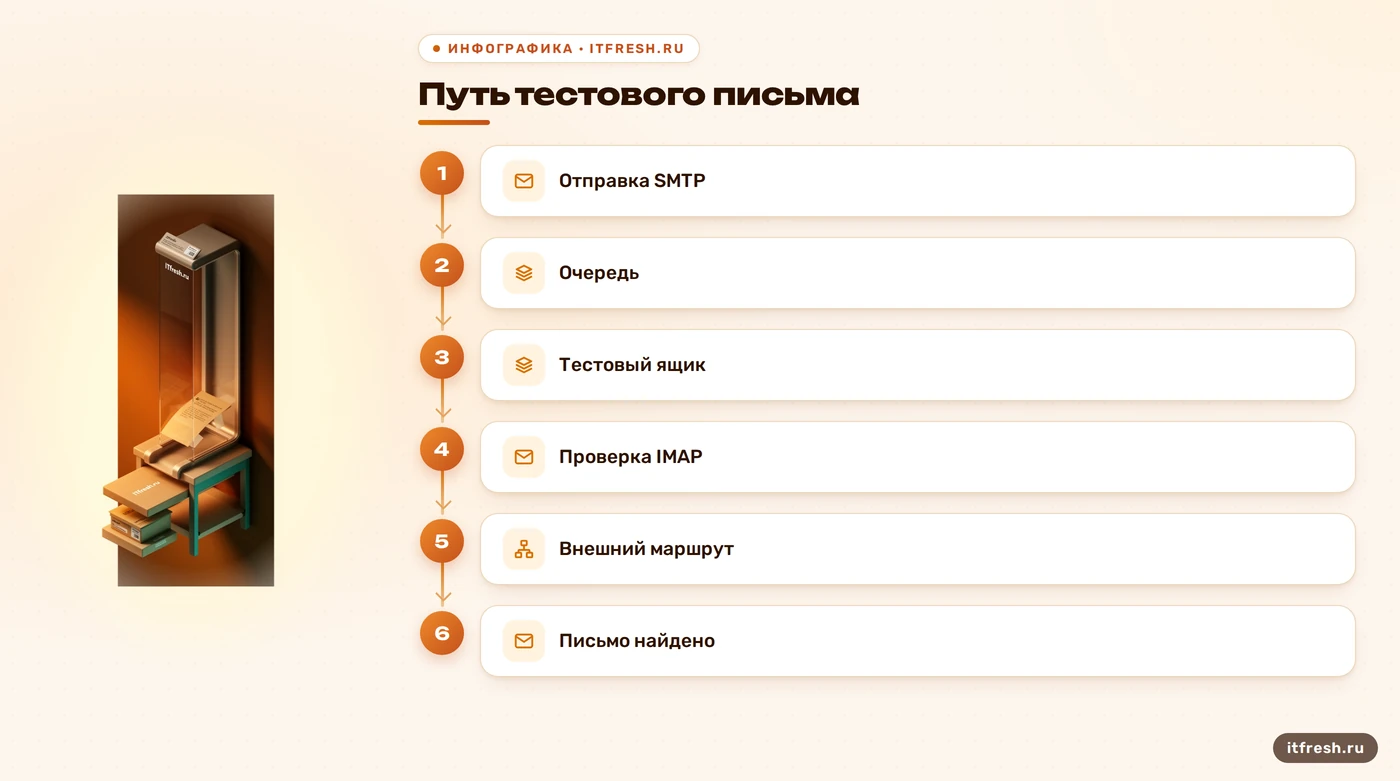
Я строю мониторинг почтовых служб вокруг пути письма: принять соединение, обработать сообщение, доставить его в ящик, дать прочитать. Ping оставляю для проверки сетевой доступности. Он полезен, но не обращается к SMTP и не открывает ящик. Если сеть отвечает, а вход в почту заканчивается ошибкой, противоречия нет: это разные проверки. Отчёт должен показывать, на каком шаге возник сбой, чтобы дежурный сразу выбрал следующую проверку.
Снаружи я проверяю SMTP на порту 25, HTTPS веб-почты на 443 и IMAP поверх TLS на 993, если эти службы используются и доступны по проекту. Отправку сотрудников проверяю через настроенную точку подачи почты: например, 587 с STARTTLS. Это не замена проверке входящего SMTP. Порт 143 относится к IMAP без неявного TLS; возможность STARTTLS зависит от настройки. Перечень портов сверяю с реальной схемой, а административный интерфейс проверяю из разрешённой сети.
Открытое TCP-соединение ещё не означает, что служба выполнила запрос. Для IMAP я проверяю защищённое подключение и вход тестовой учётной записи, для веб-почты — ожидаемый ответ приложения. В проверку TLS включаю имя узла, доверие к цепочке и срок действия сертификата. Сертификат нужно проверять на том адресе, куда подключается пользователь: файл на диске и сертификат, который отдаёт служба, могут различаться. Зелёная лампочка без проверенного действия — дорогой ночник.
Чтобы не выдавать учебный сюжет за отчёт о реальном заказчике, дальше беру условную мастерскую «Глина дома»: 29 рабочих мест, один почтовый узел и отдельный узел мониторинга. Точную установленную сборку Zimbra перед настройкой записываю в паспорт системы; команды ниже сверены с документацией ветки 10. Это пример организации контроля, а не история о доказанной аварии. Для мастерской важны два результата: доступность ящика и прохождение письма через внешний почтовый маршрут.
- Сеть: доступность узла из нужной точки.
- Протокол: ответ, TLS и разрешённая авторизация.
- Приложение: службы, очередь и запас ресурсов.
- Результат: тестовое письмо найдено в ожидаемой папке.
Что действительно показывает zmcontrol status
На самом узле я начинаю со штатной команды. Администратор с правами root переключается в окружение пользователя zimbra, затем запрашивает состояние компонентов:
su - zimbra
zmcontrol status
Команда показывает локальные службы, предусмотренные установленными компонентами и ролью узла. В распределённой установке проверка одного узла не описывает состояние остальных. Список из чужой инструкции не годится как эталон: я сначала фиксирую состав именно этой системы и отмечаю, какие службы должны быть запущены.
В выводе встречаются состояния Running и Stopped. Штатного «красного маркера у Running», по которому можно распознать сбой, здесь нет. IMAP и POP не обязаны появляться отдельными строками: клиентские протоколы связаны с компонентами mailbox и proxy. DNS тоже нельзя автоматически включать в универсальный список служб каждой установки. Если компонент намеренно выключен, оповещение о нём будет ложным. Проверка должна сравнивать фактическое состояние с согласованным списком, иначе она быстро научит всех игнорировать письма об авариях.
Запускать команду просто от root вместо пользователя zimbra я не предлагаю: нужны штатные права и окружение. Объяснение «root показывает неверные сведения о правах» ничего не диагностирует. Если сборщик не может переключить пользователя, не находит команду или получает отказ доступа, я отмечаю ошибку сбора. Подменять её значением «всё работает» нельзя. Для автоматизации даю только необходимые права на проверку и отдельно контролирую время последнего успешного получения результата.
Running я использую как начало диагностики. Компонент может числиться запущенным, пока клиентский запрос завершается ошибкой или задерживается. Поэтому рядом держу результат проверки протокола и длительность ответа. При расхождении сначала сохраняю вывод и журналы за время сбоя, затем выбираю действие. Перезапуск всего набора служб без этих данных может временно убрать симптом и оставить причину неизвестной. Кнопка перезапуска удобна. Особенно когда хочется стереть следы собственной догадки.
Как читать очередь SMTP без потери писем
На MTA-узле я смотрю очередь командой из поставки почтовой системы, а не случайной утилитой от другого установленного MTA:
postqueue -pВ Postfix команда mailq даёт привычный просмотр очереди. Вывод содержит идентификатор сообщения, размер, время поступления, отправителя и оставшихся получателей; после неудачной попытки обычно указана причина задержки. Для первичного разбора я сохраняю несколько характерных записей и связываю их с журналом по идентификатору очереди. Содержимое деловой переписки в уведомление не копирую.
Наличие писем в очереди само по себе нормально: доставка проходит через неё. Важны изменение количества, возраст сообщений и повторяющиеся причины задержки. Deferred означает отложенную доставку с последующими попытками, а не подтверждённую потерю письма. Я различаю задержку у одного внешнего домена и остановку доставки сразу во многие стороны. Во втором случае проверяю общие зависимости: DNS, сеть, фильтрацию и локальные ресурсы. Если нужна подробная диагностика, отдельно разбираю, почему очередь Postfix растёт.
Коды я читаю вместе с текстом SMTP-ответа. По RFC 5321 ответ 421 означает недоступность службы с закрытием соединения и относится к временным отрицательным ответам. Ответ 550 означает, что запрошенное действие не выполнено из-за недоступности ящика; возможны отсутствие адресата, запрет доступа или политика сервера. Это постоянный отрицательный ответ для данной попытки, а не обещание исправления повтором. Конкретную причину уточняю по полному ответу, этапу SMTP-диалога и журналу; одного числа для диагноза мало.
Искать эти причины только в заголовках обычного письма неправильно. Нужны SMTP-журнал, вывод очереди и, если он сформирован, отчёт о недоставке. Я также проверяю, совпадают ли отправитель, получатель и время события: иначе легко разобрать соседнее письмо и объявить проблему решённой. Когда удалённая сторона отказала по своей политике, сначала выясняю основание отказа. Смена адреса отправляющего сервера без разбора причины не является универсальным ремонтом и может добавить новые проблемы с доставкой.
Регулярную очистку очереди из регламента убираю. Удалить ожидающее доставки письмо — значит отменить его доставку; причину задержки это не устранит. Массовое удаление особенно опасно: вместе с нежелательной рассылкой уйдут обычные сообщения. После исправления причины я наблюдаю за повторными попытками и сокращением возраста задержанных писем. Удаление допустимо как отдельное осознанное действие после разбора конкретных сообщений. Пустая очередь после удаления доказывает только успех удаления. Письмам от этого не легче.
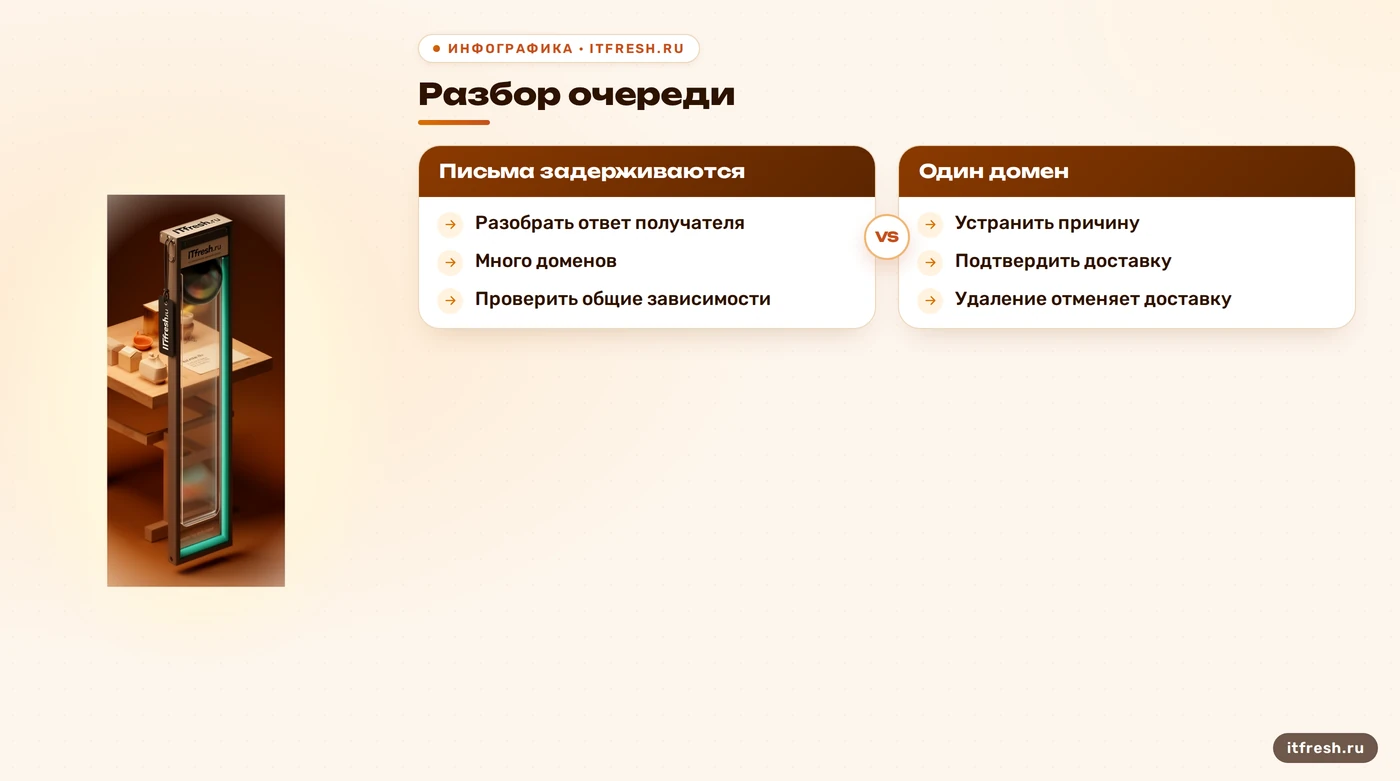
- Сохранить идентификатор, время и причину задержки.
- Отделить проблему одного домена от общей остановки.
- Сопоставить очередь с SMTP-журналом.
- После исправления убедиться, что письма доставляются.
Как контролировать диск, не удаляя рабочую почту
Для файловых систем я проверяю свободные блоки и inode. В Linux с GNU Coreutils для этого подходят две команды:
df -h
df -i
Первая показывает занятое и свободное место в удобных единицах, вторая — использование inode. На файловых системах с ограниченным числом inode их исчерпание мешает создавать новые файлы даже при наличии свободных байтов. В отчёт включаю все тома, на которых лежат данные, очередь, журналы и резервные копии, а не только корневую файловую систему.
Для разового поиска крупного каталога использую, например, du -sh /opt/zimbra/store, если хранилище находится по стандартному пути. Эта команда оценивает занятое место в дереве файлов, а не заменяет df. Рекурсивный обход большого хранилища создаёт дополнительную нагрузку, поэтому не запускаю его часто как основную метрику. Реальные пути томов проверяю в конфигурации: данные могли вынести за пределы стандартного каталога. Сам факт существования папки не означает, что именно там сейчас хранится вся почта.
Порог заполнения выбираю по свободному объёму, скорости роста и времени, за которое можно расширить хранилище. Универсальных безопасных 80 % нет: одинаковая доля на разных томах оставляет разный запас. Закончившееся место вызывает ошибки записи и может нарушить приём или доставку; рассчитывать на сохранение всех функций нельзя. Я предпочитаю предупреждение, после которого ещё остаётся время на работу, и отдельный критический сигнал. Напоминание ровно в момент отказа — это уже протокол происшествия.
Письма старше 90 дней не становятся мусором по календарю. Срок хранения согласую с владельцем данных, удаление выполняю штатными средствами после проверки резервной копии. Файлы в store вручную не трогаю: сообщения связаны с метаданными в базе. Большой индекс сам по себе не доказывает повреждение; для его проверки нужны ошибки и штатная диагностика. При нехватке места сначала выясняю, какой каталог вырос, затем выбираю ротацию журналов, расширение тома или согласованную политику хранения. Переиндексацию оставляю для задачи восстановления поиска.
Как проверить доставку через SMTP и IMAP
Я отправляю служебное письмо на выделенный тестовый ящик и проверяю его получение через IMAP. Каждому запуску даю уникальную метку, чтобы вчерашнее письмо не подтвердило сегодняшнюю доставку. Сохраняю время отправки, результат SMTP и время обнаружения сообщения. Если отправка не состоялась, проверка должна сообщить об этом этапе, а не ждать письмо до общего тайм-аута. У тестовой учётной записи нет административных прав; её секрет храню отдельно от текста скрипта и не вывожу в журнал.
До запуска определяю критерий успеха. Если обещаю пользователю доставку во «Входящие», проверяю именно эту папку и нужную метку. Обнаружение письма в другой папке — другой результат. Отсутствие во «Входящих» само по себе не доказывает, что фильтр удалил сообщение: оно могло задержаться, попасть в спам или быть перемещено правилом. Я сохраняю причину SMTP-отказа и сверяю обработку по журналам. У фильтрации есть наблюдаемые события; легенда о неизбежном молчаливом исчезновении только мешает расследованию.
Внутреннее письмо между двумя ящиками не проходит весь внешний маршрут. Поэтому для проверки обмена с интернетом я предусматриваю контролируемый внешний ящик: отдельно проверяю исходящую доставку и входящее сообщение извне. Внешняя сторона тоже может отказать, и такой результат нужно отличать от локального сбоя. Успешный тест подтверждает конкретный маршрут и момент времени. Он не гарантирует приём у всех адресатов и прохождение любого вложения. Чистый служебный текст не представляет всю деловую переписку.
Интервал и допустимую задержку выбираю по требованиям к обнаружению сбоя и обычной скорости доставки. Проверка раз в сутки оставляет большой промежуток без наблюдения; обещать на этом основании сигнал раньше пользователей нельзя. Тестовые сообщения помечаю и убираю по отдельному правилу, чтобы не засорять ящик. После настройки проверяю не только успешное прохождение, но и получение тревоги при контролируемом отказе теста. Где нужны дополнительные проверки после изменений, использую отдельный стенд проверки почты.
- Уникальная метка каждого отправленного сообщения.
- Отдельные результаты SMTP и поиска через IMAP.
- Явный критерий папки и допустимой задержки.
- Раздельная оценка локального и внешнего маршрутов.
Какие журналы читать при задержках и ошибках входа
Для расследования я заранее составляю карту журналов. В типовой настройке /var/log/zimbra.log собирает в том числе события Postfix и почтовой фильтрации, /opt/zimbra/log/mailbox.log — события mailboxd, /opt/zimbra/log/audit.log — события аутентификации. Наличие /var/log/maillog зависит от настройки системного журналирования; объявлять его обязательным источником всех ошибок входа неправильно. До подключения сбора я воспроизвожу разрешённое тестовое событие и убеждаюсь, что нужная запись действительно появилась в выбранном файле.
Одного поиска слов failed login для всех установок недостаточно. Формат записи зависит от компонента и версии, поэтому правило строю по фактическому образцу: результат входа, учётная запись, источник, протокол и время. Затем проверяю его на успешном и неуспешном входе тестового пользователя. Учитываю ротацию файлов и продолжение чтения после неё, чтобы ночная смена журнала не превратилась в тишину. Если сбор прекращается, об этом должно прийти отдельное сообщение, даже когда ошибок входа пока нет.
Серия неверных паролей с одного адреса требует проверки, но не доказывает взлом. Это может быть клиент со старым сохранённым паролем, несколько сотрудников за общим внешним адресом или попытка подбора. Я смотрю частоту, набор учётных записей, успешные входы рядом с отказами и последующие действия. Автоматическую блокировку проверяю отдельно, чтобы не отключить целый офис. Подробно признаки разбираю в статье, как читать логи Zimbra; здесь журнал нужен как источник сигнала для мониторинга.
При задержке письма связываю события по идентификатору очереди, отправителю, получателю и времени. В уведомление включаю только необходимые сведения для диагностики, без тела письма и паролей. Доступ к журналам ограничиваю, часы узлов сверяю, срок хранения определяю заранее: без этого расследование превращается в поиск событий в разных временных шкалах. Поиск ключевых слов полезен как вспомогательный инструмент. Сам по себе он не объясняет причину и не заменяет проверку того, что письмо прошло нужный этап.
Как настроить оповещения и принять результат работы
В учебной схеме для мастерской я задаю стартовый профиль: сбор состояния служб, очереди и дисков каждую минуту; тестовая отправка каждые пять минут; ожидание письма до трёх минут. Это мои проектные настройки для примера, а не требования Zimbra и не универсальные нормативы. Их проверяю под обычной нагрузкой и меняю, если появляются ложные тревоги или неприемлемые задержки обнаружения. Для каждого сигнала назначаю получателя, порядок реакции и способ эскалации, если дежурный не подтвердил получение.
Порог возраста очереди привязываю к допустимой задержке деловой переписки. Предупреждение о диске связываю с запасом до расширения тома, сертификата — со временем на продление и проверку установки. В карточке тревоги нужны узел, проверка, время, последнее успешное значение и первое действие. Общая фраза «почта сломалась» оставляет всю диагностику на потом. Несвежие данные тоже показываю явно: отсутствие новых значений не равно нулевой очереди. Иначе отключившийся сборщик нарисует самую спокойную смену в своей жизни.
Канал оповещения должен работать при отказе проверяемой почты. Я использую согласованный независимый способ связи и проверяю его доставку. Если недоступен весь узел, зависимые сигналы группирую, сохраняя сами результаты: дежурному нужна причина, а не поток одинаковых уведомлений. После восстановления отправляю сообщение о восстановлении и проверяю накопившиеся письма. Сам мониторинг тоже требует наблюдения: свежесть данных, доступность его узла и работа канала связи входят в приёмку наравне с почтовыми проверками.
Результат для условной мастерской я принимаю по контрольным событиям на тестовых объектах: неверные данные входа тестового ящика, недоступность его проверки, превышение заданного времени ожидания письма. Рабочие службы ради демонстрации не останавливаю и диск не заполняю. На выходе нужны полученная тревога, понятный порядок реакции и сообщение о восстановлении; это критерии приёмки примера, а не выдуманный отчёт об уже достигнутом эффекте. Срок внедрения определяю после проверки доступов и состава системы. Обещание полного контроля «за день» без обследования вычёркиваю.
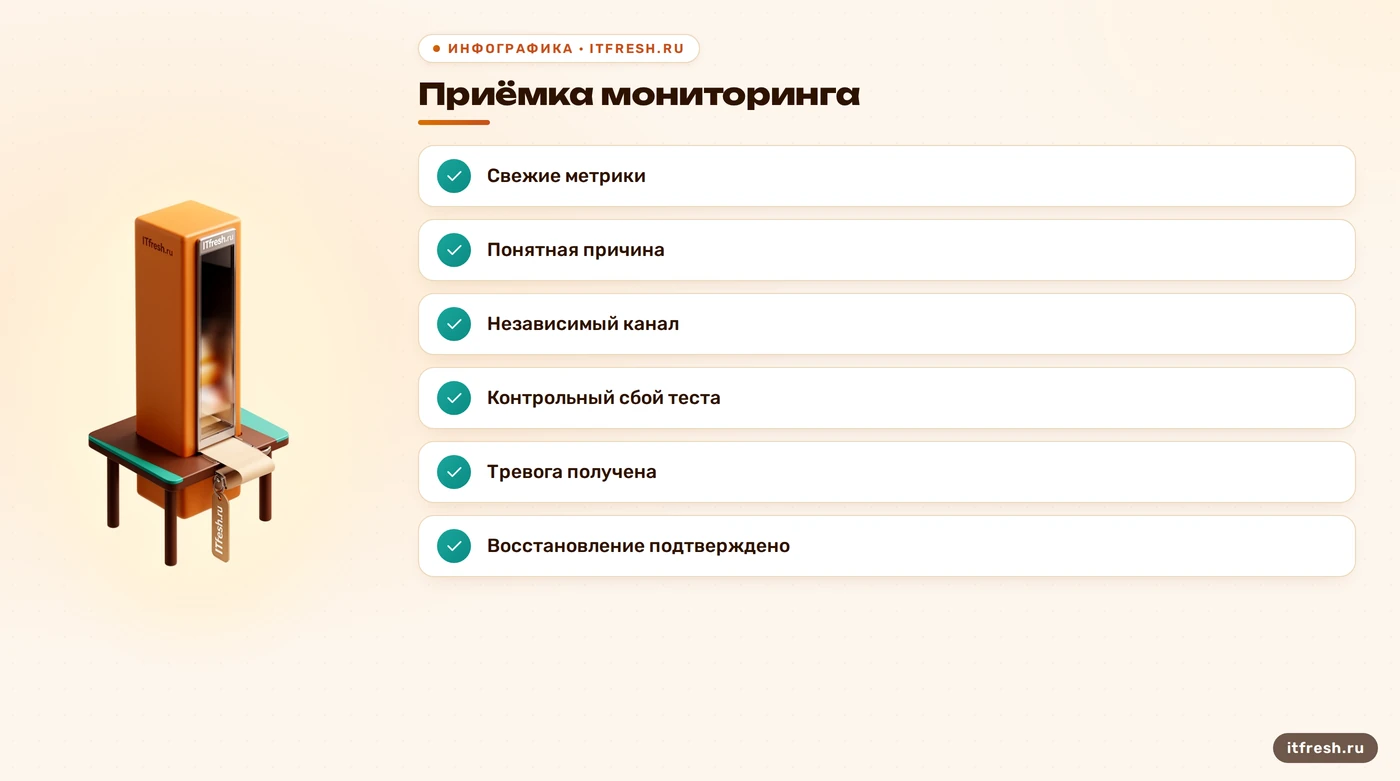
- У каждой проверки есть получатель и порядок реакции.
- Ошибка сбора отличается от исправного состояния.
- Тревога приходит при отказавшей почте.
- Контрольный сбой теста обнаружен и подтверждён.
- Восстановление подтверждено повторной проверкой.
Частые вопросы
Достаточно ли zmcontrol status для мониторинга Zimbra?
Нет. Команда показывает состояние локальных компонентов, а доставку и доступ к ящику я проверяю отдельными запросами и тестовым письмом.
Нужно ли удалять письма, если очередь растёт?
Сначала выясняю причину задержки по очереди и журналу. Удаление отменяет доставку выбранных сообщений и не исправляет причину роста.
Что означают ответы SMTP 421 и 550?
421 — временная недоступность службы с закрытием соединения. 550 — постоянный отрицательный ответ о недоступности ящика, в том числе из-за политики. Нужен полный текст ответа.
При каком заполнении диска включать тревогу?
Я выбираю порог по свободному объёму, скорости роста и времени расширения тома. Дополнительно контролирую inode; одного процента заполнения недостаточно.
Доказывает ли внутреннее тестовое письмо внешнюю доставку?
Нет. Для обмена с интернетом нужны отдельные проверки входящего и исходящего маршрутов через контролируемый внешний ящик.
Куда отправлять тревогу, если почта не работает?
В согласованный независимый канал связи. Его доступность и получение уведомлений я проверяю отдельно от почтового сервера.
Источники
- Zimbra: руководство администратора Daffodil — Состав компонентов, штатные команды, очереди, хранилище, журналы, сертификаты и диагностика индекса. https://zimbra.github.io/documentation/zimbra-10/adminguide.html
- Zimbra: установка и карта портов — Назначение SMTP 25, submission 587, HTTPS 443 и IMAP 143/993; запуск команд в окружении zimbra. https://zimbra.github.io/documentation/zimbra-10/single-server-install.html
- Postfix: справочники очереди — postqueue -p: идентификаторы, время поступления и причина последней задержки; postsuper: последствия удаления сообщений. https://www.postfix.org/postqueue.1.html ; https://www.postfix.org/postsuper.1.html
- RFC Editor: SMTP и IMAP — RFC 5321, раздел 4.2: значения ответов 421 и 550. RFC 9051: поиск сообщений в выбранной папке IMAP. https://www.rfc-editor.org/rfc/rfc5321.html ; https://www.rfc-editor.org/rfc/rfc9051.html
- GNU Coreutils: df и du — df -h показывает использование файловых систем, df -i — inode; du -sh оценивает место, занятое каталогом. https://www.gnu.org/software/coreutils/manual/html_node/df-invocation.html ; https://www.gnu.org/software/coreutils/manual/html_node/du-invocation.html
- Zimbra: события аутентификации — Разбор событий входа в audit.log, mailbox.log и системных журналах; поля учётной записи, источника и протокола. https://wiki.zimbra.com/wiki/Understanding_And_Troubleshooting_Authentication_Log_Events