
Служба не поднялась с start-limit-hit, хотя стоит Restart=on-failure
Утро понедельника, звонок: «портал не работает со вчерашнего вечера». Захожу на машину — systemctl status показывает Active: failed (Result: start-limit-hit), в журнале Failed with result 'start-limit-hit'. А в unit-файле честно прописан Restart=on-failure. Ниже разбираю, почему автоперезапуск в systemd — это не «вечное восстановление», где именно у него стоит потолок, как выглядит реальный простой на 9 часов из-за 40 секунд недоступности базы и как собрать unit, который такой сбой переживает.
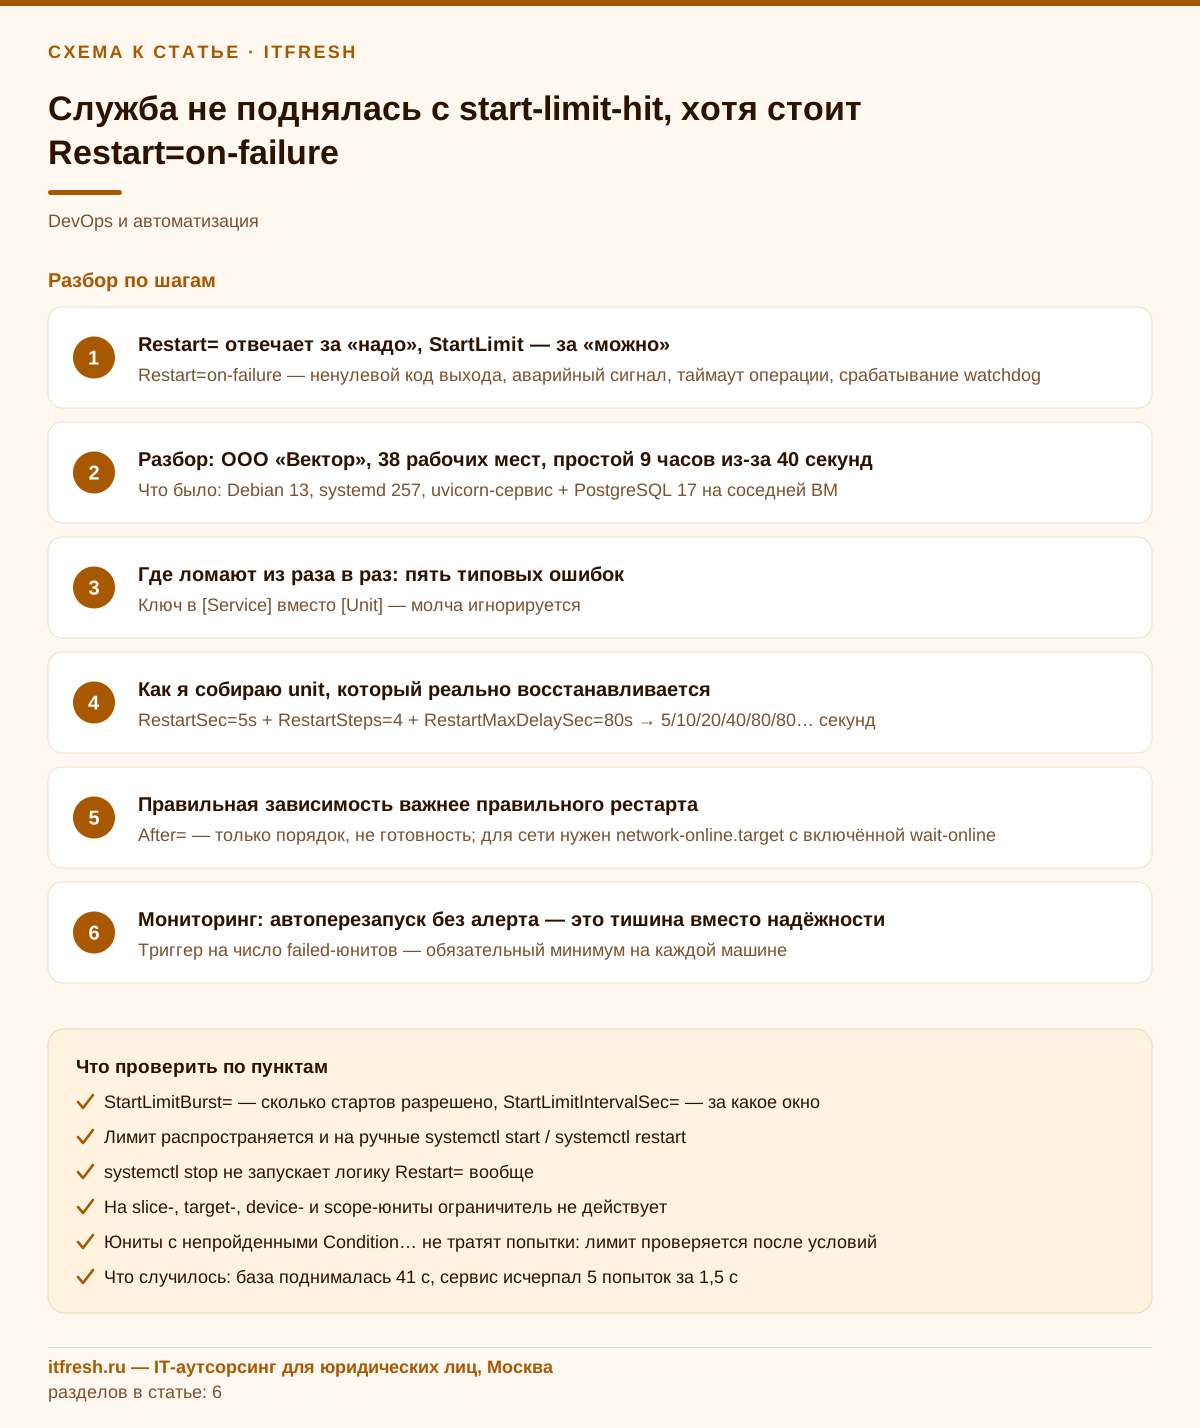
Restart= отвечает за «надо», StartLimit — за «можно»
В systemd за живучесть службы отвечают два независимых механизма, и путают их постоянно. Первый — Restart= в секции [Service]: он решает, надо ли поднимать процесс после того, как тот завершился. Значение on-failure покрывает ненулевой код выхода, завершение по сигналу (включая падение с дампом, кроме SIGHUP/SIGINT/SIGTERM/SIGPIPE), таймаут операции вроде перезагрузки конфигурации и срабатывание watchdog. Второй механизм — ограничитель частоты запусков: StartLimitIntervalSec= и StartLimitBurst=. Он решает, можно ли вообще ещё раз стартовать. И в мануале systemd.service(5) это сказано прямым текстом: «service restart is subject to unit start rate limiting configured with StartLimitIntervalSec= and StartLimitBurst=». То есть Restart= никогда не работает «до победного» — он всегда работает внутри квоты.
Теперь арифметика, из-за которой всё и ломается. По умолчанию в systemd-system.conf заданы DefaultStartLimitIntervalSec=10s и DefaultStartLimitBurst=5, а RestartSec= по умолчанию равен 100 мс. Возьмите службу, которая падает мгновенно — например, приложение, которое не смогло открыть соединение с базой и вышло с кодом 3. Пять попыток по 100 мс укладываются примерно в полсекунды. Через полсекунды после первого падения квота исчерпана, юнит уходит в failed с результатом start-limit-hit, и systemd к нему больше не возвращается. Если проблема была временной и рассосалась через минуту — неважно, вставать уже некому.
Дальше — деталь, которая ломает диагностику. Ограничитель считает все старты, а не только автоматические: «they apply to all kinds of starts (including manual), not just those triggered by the Restart= logic». Поэтому админ, который прибежал и руками набрал systemctl start, получает отказ на исправной уже конфигурации и делает вывод «сервис вообще сломан, надо переустанавливать пакет». Ещё одна деталь в ту же копилку: остановка через systemctl stop вообще не считается сбоем, логика Restart= при ней не срабатывает — это отдельный источник вопросов «почему после моего stop оно не встало обратно».
И третье, что стоит держать в голове: юниты, упёршиеся в лимит, всё ещё могут быть запущены позже — вручную, по таймеру или по сокет-активации, после того как интервал прошёл. С этого момента логика перезапусков включается заново. То есть start-limit-hit — это не «навсегда», это «до следующего внешнего пинка». Проблема в том, что на боевом сервере такой пинок обычно приходит от пользователя, который утром обнаружил, что ничего не работает.
- Restart=on-failure — ненулевой код выхода, аварийный сигнал, таймаут операции, срабатывание watchdog
- StartLimitBurst= — сколько стартов разрешено, StartLimitIntervalSec= — за какое окно
- Лимит распространяется и на ручные systemctl start / systemctl restart
- systemctl stop не запускает логику Restart= вообще
- На slice-, target-, device- и scope-юниты ограничитель не действует
- Юниты с непройденными Condition… не тратят попытки: лимит проверяется после условий
Разбор: галерея «ГалереяГрад», 15 рабочих мест, простой 9 часов из-за 40 секунд
Стенд простой и очень типовой. Художественная галерея «ГалереяГрад», 15 рабочих мест, две виртуалки на арендованном гипервизоре: на одной PostgreSQL 17, на второй — внутренний портал учёта экспонатов, заявок на экскурсии и продажи билетов на Python (uvicorn), обёрнутый в юнит gallery-portal.service. Обе на Debian 13 (systemd 257). Ночью мы делали плановые работы на гипервизоре, обе ВМ ушли в перезагрузку. База после нечистого выключения проходила recovery и открыла порт через 41 секунду. Портал стартовал раньше — и это, вообще говоря, нормальная ситуация, ради которой Restart= и придумывали.
Что показал журнал за предыдущую загрузку — вот ровно те строки, из-за которых всё и встало:
journalctl -u gallery-portal -b -1 --no-pager | tail -n 8

сен 03 03:14:21 gallery-app systemd[1]: gallery-portal.service: Main process exited, code=exited, status=3/NOTIMPLEMENTED
сен 03 03:14:21 gallery-app systemd[1]: gallery-portal.service: Failed with result 'exit-code'.
сен 03 03:14:21 gallery-app systemd[1]: gallery-portal.service: Scheduled restart job, restart counter is at 5.
сен 03 03:14:22 gallery-app systemd[1]: gallery-portal.service: Start request repeated too quickly.
сен 03 03:14:22 gallery-app systemd[1]: gallery-portal.service: Failed with result 'start-limit-hit'.
сен 03 03:14:22 gallery-app systemd[1]: Failed to start Gallery internal portal.
Обратите внимание на секунды: между первым падением и капитуляцией systemd прошло меньше двух секунд. RestartSec в юните задан не был, значит работал дефолтный 100 мс. Первый старт и четыре перезапуска — все пять укладываются в лимит DefaultStartLimitBurst=5 и все до того, как база вообще открыла сокет. К моменту, когда PostgreSQL был готов принимать соединения, портал уже лежал в failed. Никакой мониторинг об этом не сообщил, потому что мониторинга состояния юнитов на этой машине не было вовсе — смотрели только доступность HTTP снаружи, а алерт ушёл в чат, который ночью никто не читает. Утром в 9:10 первый пользователь не смог создать заявку, в 9:25 администратор галереи позвонил нам, в 9:31 всё работало. Итог: девять часов простоя кассы онлайн-билетов и учёта экспонатов из-за сорока секунд запуска базы.
Самое обидное вскрылось при разборе. Полгода назад кто-то из бывших админов уже пытался это чинить — в unit-файле в секции [Service] лежала строка StartLimitIntervalSec=0. Она не делала ничего. Имя StartLimitIntervalSec= парсер systemd знает только в секции [Unit]; в [Service] для совместимости принимаются лишь старые StartLimitInterval=, StartLimitBurst= и StartLimitAction=, а незнакомый ключ игнорируется с предупреждением «Unknown key name» в журнале при загрузке конфигурации. Человек был уверен, что лимит отключён, полгода жил с этой уверенностью, и никто ни разу не проверил. Одна команда systemd-analyze verify показала бы это за секунду.
- Что было: Debian 13, systemd 257, uvicorn-сервис + PostgreSQL 17 на соседней ВМ
- Что случилось: база поднималась 41 с, сервис исчерпал 5 разрешённых стартов меньше чем за 2 с
- Почему не заметили: мониторился только внешний HTTP, состояние юнитов — нет
- Что было сломано «заранее»: StartLimitIntervalSec=0 стоял в [Service] и игнорировался с «Unknown key name»
- Чем закончилось: 9 часов простоя, починка на 20 минут — drop-in с бэкоффом, ожидание зависимости и алерт на failed-юниты
Где ломают из раза в раз: пять типовых ошибок
Ошибка первая — ключ не в той секции. StartLimitIntervalSec= и StartLimitBurst= с systemd 229 живут в [Unit]. В секции [Service] ради обратной совместимости ещё принимаются старые StartLimitInterval=, StartLimitBurst= и StartLimitAction=, а вот StartLimitIntervalSec= там не работает. В интернете полно копипасты десятилетней давности, где всё свалено в [Service], и она честно «работает» ровно в той части, которая относится к Restart=. Ошибка вторая — правка файла прямо в /usr/lib/systemd/system (в Debian/Ubuntu — /lib/systemd/system). Ближайшее обновление пакета всё затрёт, и вы будете ловить тот же инцидент второй раз, уже без подозрений на конфиг. Правильно — drop-in: systemctl edit имя.service создаёт /etc/systemd/system/имя.service.d/override.conf, и только его.
Ошибка третья, самая обидная: правка юнита не сбрасывает счётчик. Вы исправили конфиг, сделали daemon-reload — а служба всё равно отказывается стартовать, потому что квота исчерпана и интервал ещё не истёк. Нужен systemctl reset-failed: по мануалу systemctl(1) он «сбрасывает состояние failed, счётчик ограничения запусков для всех типов юнитов и счётчик перезапусков для сервисных юнитов». Ошибка четвёртая — обратная: reset-failed как ритуал. «Сбросил, стартануло, ушёл». Счётчик обнулили, причину падения не нашли, вечером всё повторится, и так по кругу неделями. reset-failed — это лопата, а не лекарство.
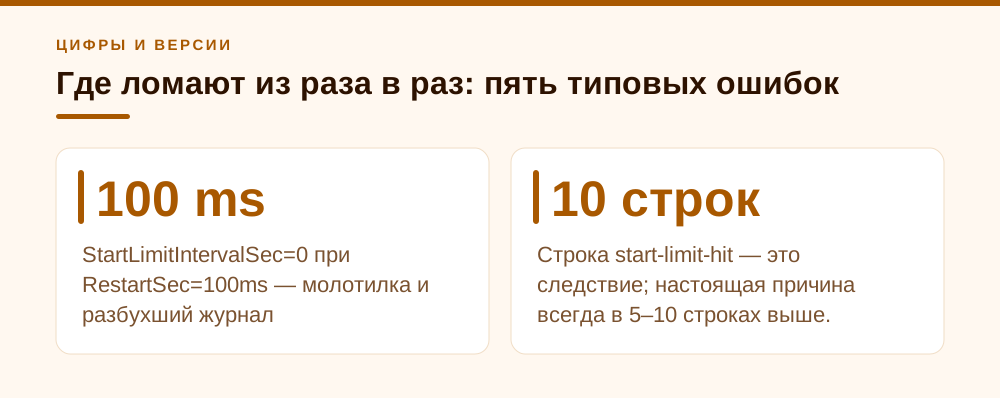
Ошибка пятая — «а давайте вообще отключим лимит». StartLimitIntervalSec=0 в паре с дефолтным RestartSec=100ms даёт бесконечную молотилку: сервис форкается десять раз в секунду, journald пишет мегабайты в минуту, диск под /var/log уходит в потолок, а если приложение при старте трогает базу или лок-файл — вы дополнительно рискуете получить повреждённое состояние. Отключать ограничитель можно, я иногда так делаю, но только вместе с осмысленным RestartSec и бэкоффом. Голый StartLimitIntervalSec=0 — это не отказоустойчивость, это отложенный инцидент.
Набор команд, которым я разбираю такие вещи на месте — быстро и без гаданий:
systemctl edit gallery-portal.service        # drop-in в /etc/systemd/system/...d/override.conf
systemctl daemon-reload
systemctl reset-failed gallery-portal.service
systemd-analyze verify /etc/systemd/system/gallery-portal.service
systemctl show gallery-portal.service \
  -p Restart -p RestartUSec -p NRestarts -p Result \
  -p StartLimitBurst -p StartLimitIntervalUSec
И ещё две тонкости из мануала, которые объясняют половину «а у меня не воспроизводится». Ограничитель проверяется после проверки условий Condition…=, поэтому активации с непройденными условиями попыток не тратят. А когда юнит выгружается сборщиком мусора (на него никто не ссылается, он не запущен и не в failed), его счётчики обнуляются — настраивать rate limit для юнита, который не удерживается в памяти постоянно, попросту бессмысленно.
- StartLimitIntervalSec= в [Service] вместо [Unit] — игнорируется с предупреждением в журнале
- Правка в /lib вместо drop-in — переживёт ровно до обновления пакета
- daemon-reload сделан, reset-failed забыт — сервис всё ещё не стартует
- reset-failed вслепую, без разбора первопричины
- StartLimitIntervalSec=0 при RestartSec=100ms — молотилка и разбухший журнал
Как я собираю unit, который реально восстанавливается
Принцип у меня один: не «увеличить число попыток», а развести попытки во времени. Двадцать попыток за десять секунд не помогут никому — база всё равно не успеет подняться. А вот пять попыток, размазанные на пять минут, покрывают почти любой типовой сбой зависимости. С systemd 254 для этого есть штатный экспоненциальный бэкофф: RestartSteps= и RestartMaxDelaySec=. Мануал показывает это на примере RestartSec=10s, RestartSteps=4, RestartMaxDelaySec=160s: интервалы 10с, 20с, 40с, 80с, 160с и дальше по 160с. Из примера следует, что задержка растёт геометрически с коэффициентом (RestartMaxDelaySec / RestartSec) в степени (1 / RestartSteps) и выходит на потолок RestartMaxDelaySec за RestartSteps шагов. Там же подсказан разумный диапазон: значения RestartSteps от 3 до 5.
Вот мой рабочий шаблон для сервиса приложения — тот самый, который мы положили «ГалереяГраду» в drop-in:
[Unit]
Description=Gallery internal portal
Wants=network-online.target
After=network-online.target
StartLimitIntervalSec=30min
StartLimitBurst=20

[Service]
Type=exec
ExecStart=/opt/gallery/venv/bin/uvicorn app:api --host 127.0.0.1 --port 8080
Restart=on-failure
RestartSec=5s
RestartSteps=4
RestartMaxDelaySec=80s
TimeoutStartSec=60s
Читается так: интервалы между перезапусками пойдут 5с, 10с, 20с, 40с, 80с, дальше по 80 секунд (коэффициент ровно 2, потому что (80/5) в степени 1/4 = 2). Двадцать попыток в окне 30 минут — этого хватает, чтобы пережить и recovery базы, и перезагрузку соседней ВМ, и получасовую пропажу VPN-туннеля до резервной площадки. При этом ограничитель не отключён: если приложение сломано насмерть, через полчаса оно всё же уйдёт в failed, и мы не получим вечный цикл форков. Type=exec выбран сознательно: uvicorn сам не отправляет sd_notify, и с Type=notify юнит завис бы в activating до TimeoutStartSec. Если приложение умеет слать READY=1 и WATCHDOG=1 (через sdnotify/systemd-python или нативно), тогда Type=notify плюс WatchdogSec= — для сервиса, который умеет висеть, не падая, это ценнее любых рестартов.
Отдельно про RestartMode= (тоже с версии 254). Значение direct переводит юнит при автоперезапуске сразу в activating, минуя failed/inactive — зависимые юниты не видят временного отказа и не валятся следом. Штука полезная, но у неё есть цена, о которой в статьях обычно молчат: в режиме direct пропускаются OnSuccess= и OnFailure=. Если вы вешали алерт через OnFailure=tg-alert@%n.service, он замолчит. Я включаю direct только там, где от юнита зависит цепочка других служб, и одновременно переношу оповещение на внешний мониторинг состояния.
И про цифры честно: единого «правильного» набора значений не существует, я его тоже не знаю. Я исхожу из времени восстановления зависимости — окно StartLimitIntervalSec должно быть заметно больше худшего времени восстановления того, от чего сервис зависит. Веб-приложение с локальной базой — 10–15 минут. Сервис, который ждёт сетевую ФС, туннель или соседнюю площадку — 30–60 минут. Есть ещё экзотический, но иногда очень удобный вариант: StartLimitIntervalSec=infinity превращает burst в лимит попыток за всё время жизни юнита, безотносительно частоты.
- RestartSec=5s + RestartSteps=4 + RestartMaxDelaySec=80s → 5/10/20/40/80/80… секунд
- StartLimitIntervalSec ставлю больше худшего времени восстановления зависимости
- StartLimitBurst 15–20 при разведённых во времени попытках — безопасно
- Type=notify + WatchdogSec ловит зависший процесс, но только если приложение само шлёт READY=1/WATCHDOG=1
- RestartMode=direct не тащит временный сбой на зависимые юниты, но глушит OnFailure=
- StartLimitIntervalSec=infinity — если нужен лимит общего числа попыток, а не частоты
Правильная зависимость важнее правильного рестарта
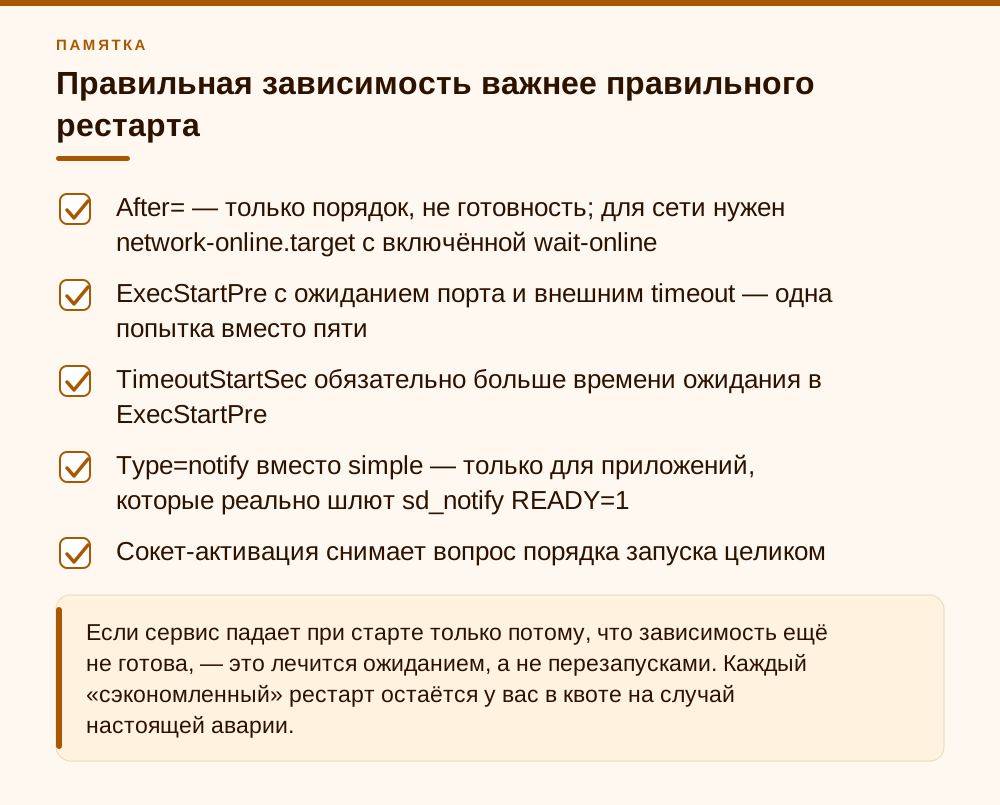
Примерно половина случаев start-limit-hit, которые я разбирал, — вообще не про лимит. Они про то, что служба стартует раньше, чем готово то, что ей нужно. И тут важно понимать ограничение systemd: After= задаёт только порядок запуска юнитов на этой машине. Он ничего не знает про готовность сервиса — тем более про базу на соседней виртуалке, которая про ваш After= вообще не в курсе. After=network.target тоже не означает «сеть поднята и адрес получен»; для этого есть network-online.target, и он не бесплатный — требует включённой службы ожидания (systemd-networkd-wait-online или NetworkManager-wait-online), иначе цель достигается мгновенно и толку от неё ноль.
Мой практический приём: ждать зависимость внутри одной попытки старта, а не полагаться на цепочку перезапусков. Тогда счётчик лимита вообще не расходуется — с точки зрения systemd идёт один долгий, но успешный старт.
[Service]
ExecStartPre=/usr/bin/timeout 120 sh -c 'until pg_isready -h 172.16.20.10 -p 5432 -q; do sleep 2; done'
TimeoutStartSec=180s
Здесь одна попытка старта покрывает две минуты недоступности базы. Обратите внимание на две вещи. Первая — внешний timeout: без него вы получите юнит, который бесконечно висит в activating и держит зависимые цели, а на загрузке это выливается в подвисший boot. Вторая — TimeoutStartSec должен быть заведомо больше, чем ожидание в ExecStartPre, иначе systemd прибьёт старт раньше, чем предусловие успеет отработать; дефолт DefaultTimeoutStartSec в системном менеджере — 90 секунд, и в него легко не уложиться.
Где это не нужно — тоже скажу прямо. Если служба слушает сокет и клиенты умеют ждать, гораздо чище сокет-активация: systemd держит сокет открытым, соединения копятся в очереди, а сама служба поднимается по первому обращению. Тогда вопрос «стартовала ли она раньше базы» просто перестаёт существовать. Для внутренних веб-морд, редко используемых API и сервисных утилит это часто лучший вариант, чем любой тюнинг рестартов.
- After= — только порядок, не готовность; для сети нужен network-online.target с включённой wait-online
- ExecStartPre с ожиданием порта и внешним timeout — одна попытка вместо пяти
- TimeoutStartSec обязательно больше времени ожидания в ExecStartPre
- Type=notify вместо simple — только для приложений, которые реально шлют sd_notify READY=1
- Сокет-активация снимает вопрос порядка запуска целиком
Мониторинг: автоперезапуск без алерта — это тишина вместо надёжности
Главная беда Restart= в том, что он маскирует проблему. Служба падает сорок раз в сутки, встаёт за сто миллисекунд, графики доступности снаружи ровные, никто ничего не знает. А потом она падает пять раз подряд быстрее интервала — и об этом узнают все и сразу, включая директора. Поэтому автоперезапуск я никогда не считаю решением сам по себе: он даёт время на реакцию, но реакция должна кем-то запускаться. Минимальный набор, который я ставлю всем клиентам, снимается тремя командами и заводится в Zabbix или в скрипт по cron раз в пять минут.
# 1. Сколько юнитов в состоянии failed — любое ненулевое значение это алерт
systemctl list-units --state=failed --no-legend --plain | wc -l

# 2. Счётчик перезапусков конкретной службы (рост между опросами = деградация)
systemctl show gallery-portal.service -p NRestarts --value

# 3. Явный признак «лежит и само не встанет»
journalctl -u gallery-portal.service --since -10min --no-pager | grep -c start-limit-hit
Первый пункт — самый ценный по соотношению «польза на минуту работы». Он ловит не только start-limit-hit, но и любую другую службу, свалившуюся в failed: сломанный бэкап, отвалившийся агент мониторинга, не поднявшийся после обновления демон. У меня это один из базовых триггеров на всех обслуживаемых машинах, и срабатывает он регулярно — сильно чаще, чем хотелось бы. Второй пункт ловит «тихую деградацию»: NRestarts растёт, значит служба падает и встаёт, значит там что-то не так, даже если снаружи всё зелёное. Учтите, что NRestarts обнуляется при reset-failed и при перезагрузке — сравнивать надо приросты, а не абсолютные значения.
Штатный способ повесить оповещение изнутри systemd — директива OnFailure= и шаблонный юнит. Выглядит это так, и работает надёжно:
# /etc/systemd/system/tg-alert@.service
[Unit]
Description=Telegram alert for %i

[Service]
Type=oneshot
ExecStart=/usr/local/bin/tg-alert.sh '%i на %H ушёл в failed'
В проблемном юните добавляется OnFailure=tg-alert@%n.service. Два подводных камня, на которых я обжигался лично. Первый: при RestartMode=direct директива OnFailure= не отрабатывает вовсе — алерта не будет. Второй: в обычном режиме OnFailure= срабатывает на каждом падении, и «молотящий» сервис за ночь пришлёт в чат несколько сотен сообщений, после чего чат замьютят вместе со всеми остальными алертами. Поэтому у себя я оповещаю не на каждое падение, а на два события: устойчивое состояние failed и прирост NRestarts выше порога за интервал.
- Триггер на число failed-юнитов — обязательный минимум на каждой машине
- Прирост NRestarts между опросами — ловит тихую деградацию
- Grep по start-limit-hit в журнале — признак «лежит и само не встанет»
- OnFailure= + шаблонный юнит tg-alert@.service — штатное оповещение
- Не алертить на каждое падение: молотящий сервис похоронит чат
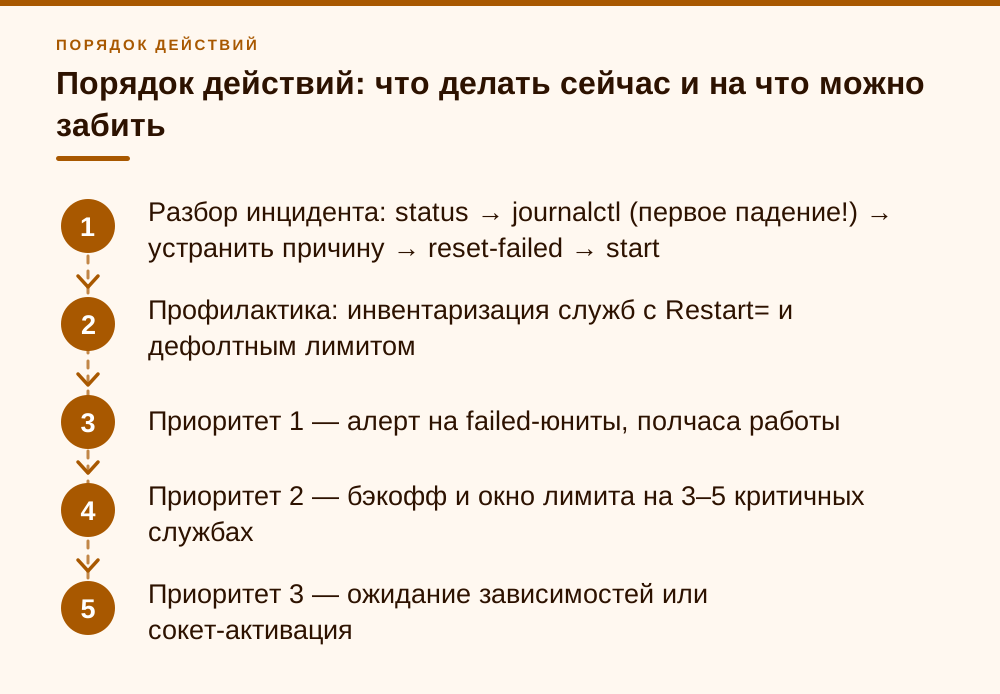
Порядок действий: что делать сейчас и на что можно забить
Если служба уже лежит, действую строго по порядку. Сначала systemctl status — посмотреть Result и когда именно всё случилось. Потом journalctl -u имя -b (или -b -1, если машина с тех пор перезагружалась) и поиск ПЕРВОГО падения в серии: строка start-limit-hit всегда последняя, а причина — на несколько строк выше, в виде кода выхода или сообщения самого приложения. Дальше устраняем причину. И только после этого reset-failed и start. Начинать с reset-failed — самый распространённый способ потратить час и вернуться к тому же состоянию через двадцать минут.
Для профилактики полезно один раз пройтись по всем машинам и посмотреть, у каких служб задан Restart= при дефолтном ограничителе. Такой инвентарный проход у меня занимает вечер на парк из тридцати серверов и обычно вскрывает две-три критичные службы, живущие на дефолтах 5/10s:
for u in $(systemctl list-units --type=service --state=running --no-legend --plain | awk '{print $1}'); do
  printf '%-42s %s\n' "$u" \
    "$(systemctl show "$u" -p Restart -p RestartUSec -p StartLimitBurst -p StartLimitIntervalUSec --value | paste -sd' ')"
done | grep -v ' no '
Теперь про приоритеты, потому что вылизывать все юниты в системе — занятие бессмысленное. Первое и самое важное: алерт на failed-юниты. Это полчаса работы, и он ловит сто процентов подобных простоев, независимо от того, разобрались вы с бэкоффом или нет. Второе: нормальный бэкофф и адекватное окно ограничителя на трёх-пяти действительно критичных службах — база, сервер приложений, шлюз, агент бэкапа. Третье, но уже сильно позже: ожидание зависимостей через ExecStartPre или сокет-активация там, где порядок запуска реально плавает.
А забить можно на всё остальное. Штатные юниты дистрибутива — sshd, cron, chrony, journald, агенты мониторинга — приезжают с настройками, которые сопровождающие пакета продумали лучше, чем мы с вами за пять минут. Трогать их без конкретной причины не надо: любая ваша правка там превращается в drop-in, который придётся помнить и пересматривать при каждом крупном обновлении. Тюнинг рестартов — это точечный инструмент для ваших собственных служб и для приложений, которые вы сами разворачивали, а не косметика для всей системы.
- Разбор инцидента: status → journalctl (первое падение!) → устранить причину → reset-failed → start
- Профилактика: инвентаризация служб с Restart= и дефолтным лимитом
- Приоритет 1 — алерт на failed-юниты, полчаса работы
- Приоритет 2 — бэкофф и окно лимита на 3–5 критичных службах
- Приоритет 3 — ожидание зависимостей или сокет-активация
- Штатные юниты дистрибутива без причины не трогать
Частые вопросы
Я всё починил, но systemctl start возвращает ошибку. Почему?
Потому что ограничитель запусков считает и ручные старты тоже — в мануале systemd.unit(5) это сказано явно. Пока квота StartLimitBurst не восстановилась (то есть пока не прошёл интервал StartLimitIntervalSec), ваш systemctl start будет отбит независимо от того, исправна конфигурация или нет. Решение: systemctl reset-failed имя.service, затем systemctl start.
systemctl reset-failed может что-то сломать?
Нет. Он сбрасывает состояние failed юнита, счётчик ограничения запусков и счётчик перезапусков службы — и всё. На работающий процесс он не влияет, ничего не перезапускает и конфигурацию не меняет. Опасен не он сам, а привычка применять его вместо разбора причины: сброшенный счётчик прячет проблему, которая вернётся.
Можно просто поставить StartLimitIntervalSec=0 и забыть?
Технически да, ноль отключает ограничение полностью. Но только в паре с осмысленным RestartSec (5–30 секунд) и, желательно, с RestartSteps/RestartMaxDelaySec. С дефолтным RestartSec=100ms отключённый лимит превращается в бесконечную молотилку: сервис форкается десять раз в секунду, journald пухнет, диск заканчивается. Я предпочитаю не отключать лимит, а расширять окно — например, 20 попыток за 30 минут.
В какой секции писать StartLimitIntervalSec и StartLimitBurst?
В [Unit]. Туда они переехали в systemd 229. В [Service] ради совместимости со старыми конфигами ещё принимаются StartLimitInterval=, StartLimitBurst= и StartLimitAction=, а StartLimitIntervalSec= там systemd не знает и игнорирует, оставляя предупреждение «Unknown key name» в журнале. Проверить свой файл: systemd-analyze verify /etc/systemd/system/имя.service.
Restart=always вместо on-failure решит проблему?
Нет. Ограничитель запусков общий для всех значений Restart=, и на always он действует ровно так же. Разница между always и on-failure только в том, что always перезапускает службу и после чистого выхода с кодом 0. Если вы упираетесь в start-limit-hit, менять надо не Restart=, а интервалы: RestartSec, RestartSteps, StartLimitIntervalSec и StartLimitBurst.
Как узнать, сколько раз служба уже перезапускалась?
systemctl show имя.service -p NRestarts --value. Значение обнуляется при systemctl reset-failed и при перезагрузке машины, поэтому в мониторинге корректно смотреть прирост между опросами, а не абсолютное число. Дополнительно полезно грепать журнал: journalctl -u имя.service | grep 'Scheduled restart job' — там видно и счётчик, и время каждой попытки.
Источники
- systemd.service(5) — Раздел Restart=, RestartSec=, RestartSteps=, RestartMaxDelaySec=, RestartMode= (добавлены в версии 254), формула экспоненциального бэкоффа и оговорка о подчинении рестартов rate limiting: https://man7.org/linux/man-pages/man5/systemd.service.5.html
- systemd.unit(5) — Секция [Unit], директивы StartLimitIntervalSec=, StartLimitBurst=, StartLimitAction= (добавлены в версии 229), в том числе применимость к ручным стартам, значение infinity, исключение slice/target/device/scope, проверку после Condition… и сброс счётчиков при выгрузке юнита: https://man7.org/linux/man-pages/man5/systemd.unit.5.html
- systemd-system.conf(5) — Значения по умолчанию: DefaultStartLimitIntervalSec=10s, DefaultStartLimitBurst=5, DefaultRestartSec=100ms, DefaultTimeoutStartSec=90s: https://man7.org/linux/man-pages/man5/systemd-system.conf.5.html
- systemctl(1) — Команда reset-failed: сброс состояния failed, счётчика ограничения запусков всех типов юнитов и счётчика перезапусков сервисных юнитов: https://man7.org/linux/man-pages/man1/systemctl.1.html
- Исходники systemd, man/systemd.service.xml — Первоисточник man-страницы с примером RestartSec=10s / RestartSteps=4 / RestartMaxDelaySec=160s (интервалы 10, 20, 40, 80, 160 с) и рекомендацией RestartSteps от 3 до 5: https://github.com/systemd/systemd/blob/main/man/systemd.service.xml
- Red Hat Blog — Set up self-healing services with systemd — практика автоматического восстановления служб и ограничений рестарт-логики: https://www.redhat.com/en/blog/systemd-automate-recovery
- Исходники systemd, src/core/load-fragment-gperf.gperf.in — Таблица ключей unit-файлов: StartLimitIntervalSec= есть только как Unit.*, а в [Service] для совместимости разобраны лишь StartLimitInterval=, StartLimitBurst=, StartLimitAction=: https://github.com/systemd/systemd/blob/main/src/core/load-fragment-gperf.gperf.in