
Поменял unit-файл, сделал reload — а служба работает по-старому: разбираю, где теряется конфигурация
daemon-reload перечитывает unit-файлы в памяти systemd, reload просит приложение перечитать свой конфиг, и ни то ни другое не меняет лимиты и окружение живого процесса — это делает только restart. Разбираю, где теряется правка, как проверить её на PID за минуту и как применять без сюрпризов.
Три слоя, которые все называют «применить конфиг»
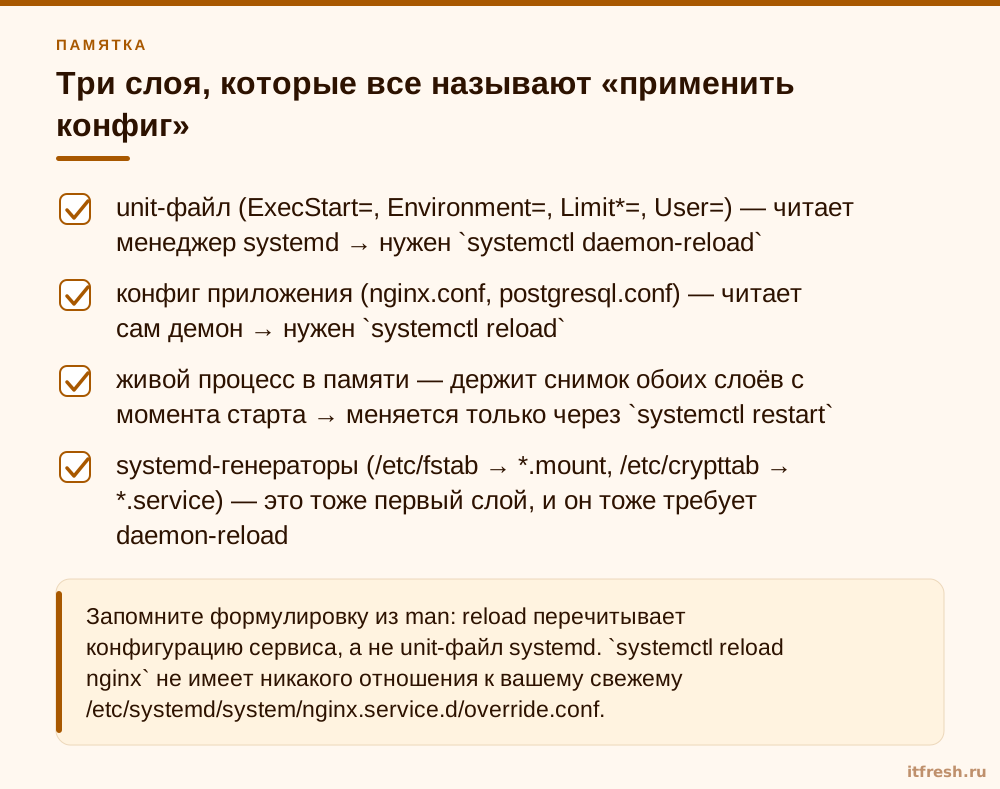
В обслуживании Linux-серверов эта путаница всплывает у меня стабильно раз в квартал. Когда админ говорит «я применил конфиг», он может иметь в виду три принципиально разные вещи, и именно эта путаница съедает часы. Слой первый — unit-файл: то, что лежит в /etc/systemd/system или /lib/systemd/system и описывает, КАК systemd должен запустить процесс. Строки ExecStart=, User=, Environment=, LimitNOFILE=, WorkingDirectory=, Restart=. Этот слой читает менеджер systemd, а не ваше приложение. Слой второй — конфигурация самого приложения: /etc/nginx/nginx.conf, /etc/postgresql/16/main/postgresql.conf, ваш application.yml. Её читает демон, systemd про её содержимое не знает ничего. Слой третий — процесс, который уже живёт в памяти со снимком обоих слоёв, сделанным в момент старта.
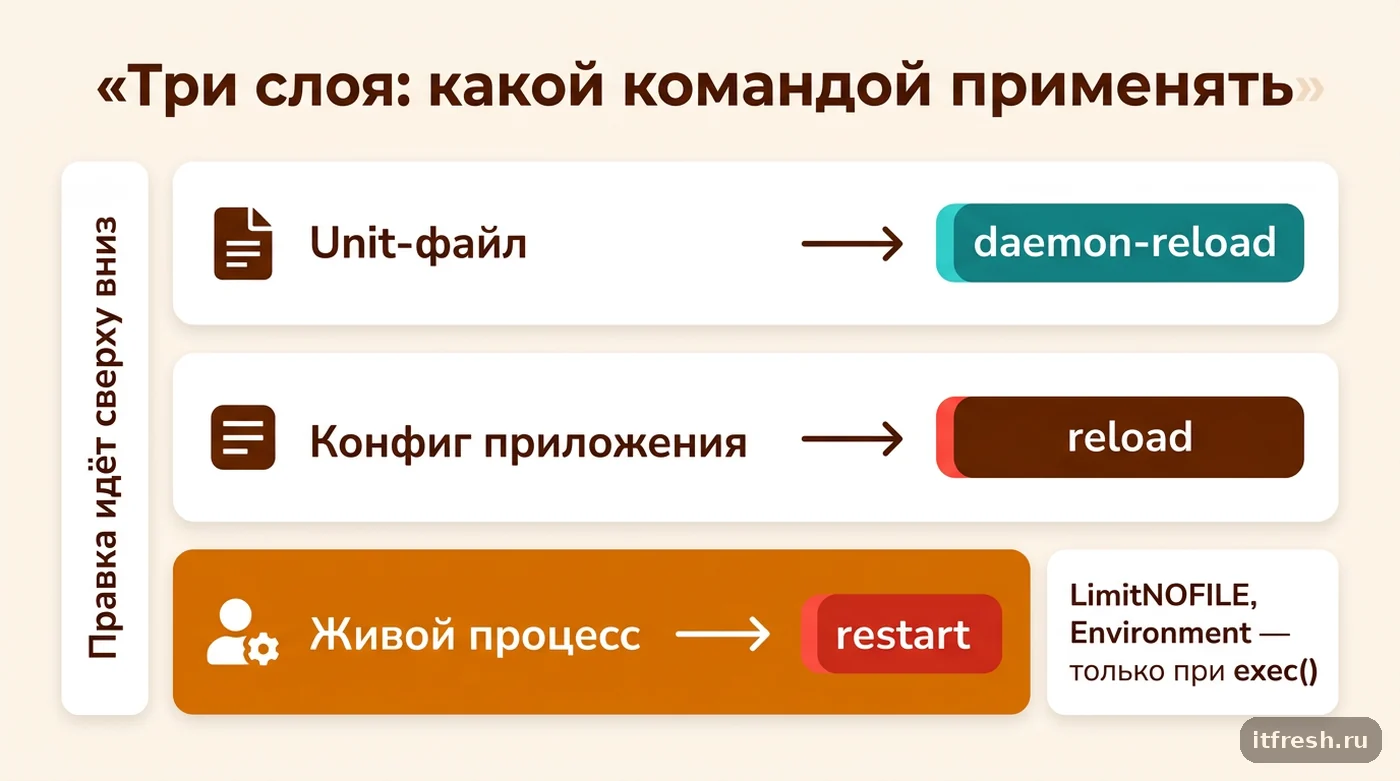
Дальше простая арифметика. У каждого слоя своя команда, и они не заменяют друг друга. systemctl daemon-reload обновляет представление менеджера о первом слое. systemctl reload SERVICE просит приложение перечитать второй слой. systemctl restart SERVICE пересоздаёт третий слой целиком — убивает процесс и поднимает заново уже с новыми первым и вторым. Ошибка, из-за которой обычно и приходит заявка: человек правит первый слой, а применяет командой из второго.
Отдельно упомяну случай, который путает даже опытных: изменения через generator. Правите /etc/fstab — и ждёте, что новая точка монтирования появится сама. Не появится: .mount-юниты собирает systemd-fstab-generator, а генераторы перезапускаются только на daemon-reload. То же с /etc/crypttab и с юнитами, которые кладёт ваш CI прямо файлом мимо systemctl. Любой файл, который читает менеджер, а не приложение, попадает в первый слой со всеми вытекающими.
Проверить, в каком вы слое, можно на пальцах. Если вы редактировали файл в /etc/systemd/system — это первый слой, и вам нужен daemon-reload плюс перезапуск юнита. Если редактировали файл, путь к которому упомянут внутри ExecStart= как аргумент (-c /etc/nginx/nginx.conf) — это второй слой, и вам достаточно reload, если демон его поддерживает. Если вы поменяли оба — сначала daemon-reload, потом restart, и никак иначе.
- unit-файл (ExecStart=, Environment=, Limit*=, User=) — читает менеджер systemd → нужен `systemctl daemon-reload`
- конфиг приложения (nginx.conf, postgresql.conf) — читает сам демон → нужен `systemctl reload`
- живой процесс в памяти — держит снимок обоих слоёв с момента старта → меняется только через `systemctl restart`
- systemd-генераторы (/etc/fstab → *.mount, /etc/crypttab → *.service) — это тоже первый слой, и он тоже требует daemon-reload
Что на самом деле делает daemon-reload — и чего он не делает
Формулировка в systemctl(1) предельно точная: «Reload the systemd manager configuration. This will rerun all generators, reload all unit files, and recreate the entire dependency tree». Три действия: перезапускаются генераторы, перечитываются все unit-файлы, пересобирается дерево зависимостей. Обратите внимание — «all», не только тот юнит, который вы правили. Это глобальная операция над всем менеджером, поэтому на нагруженном хосте с парой тысяч юнитов она может занять заметные доли секунды и на это время подтормозить обработку заданий.
А теперь главное — чего daemon-reload не делает. Он не перезапускает ни одну службу. Он не отправляет процессам сигналов. Он не переписывает окружение уже запущенного демона. После daemon-reload systemd знает про новый ExecStart=, но процесс с диска не перезапускается, потому что это была бы катастрофа: представьте, что вы правите один override, а у вас уезжает половина хоста. Поэтому новые ExecStart=, Environment= со всеми его особенностями, ExecStartPre=, EnvironmentFile=, User=, Group=, WorkingDirectory=, LimitNOFILE= и остальные Limit* применятся только при следующем старте юнита.
Отдельно про cgroup-свойства — MemoryMax=, CPUQuota=, IOWeight=, TasksMax=. Часть из них systemd действительно умеет применять к живому юниту прямо на daemon-reload или через systemctl set-property, потому что это просто запись в файлы cgroup v2, а не аргументы exec(). Но полагаться на это в проде я бы не стал: поведение отличается между версиями, а проверять фактическое значение всё равно придётся руками в /sys/fs/cgroup. Моё правило простое — если изменение критично, применяю его рестартом в согласованное окно и проверяю результат на живом PID, а не в выводе systemctl.
И не путайте daemon-reload с daemon-reexec. Второй перезапускает сам бинарник PID 1, сериализуя и восстанавливая состояние. Это операция для обновления systemd на живой машине, а не для применения ваших правок. В обычной работе она вам не нужна; я её трогаю только после апгрейда пакета systemd, когда явно вижу, что старый PID 1 держит удалённые библиотеки.
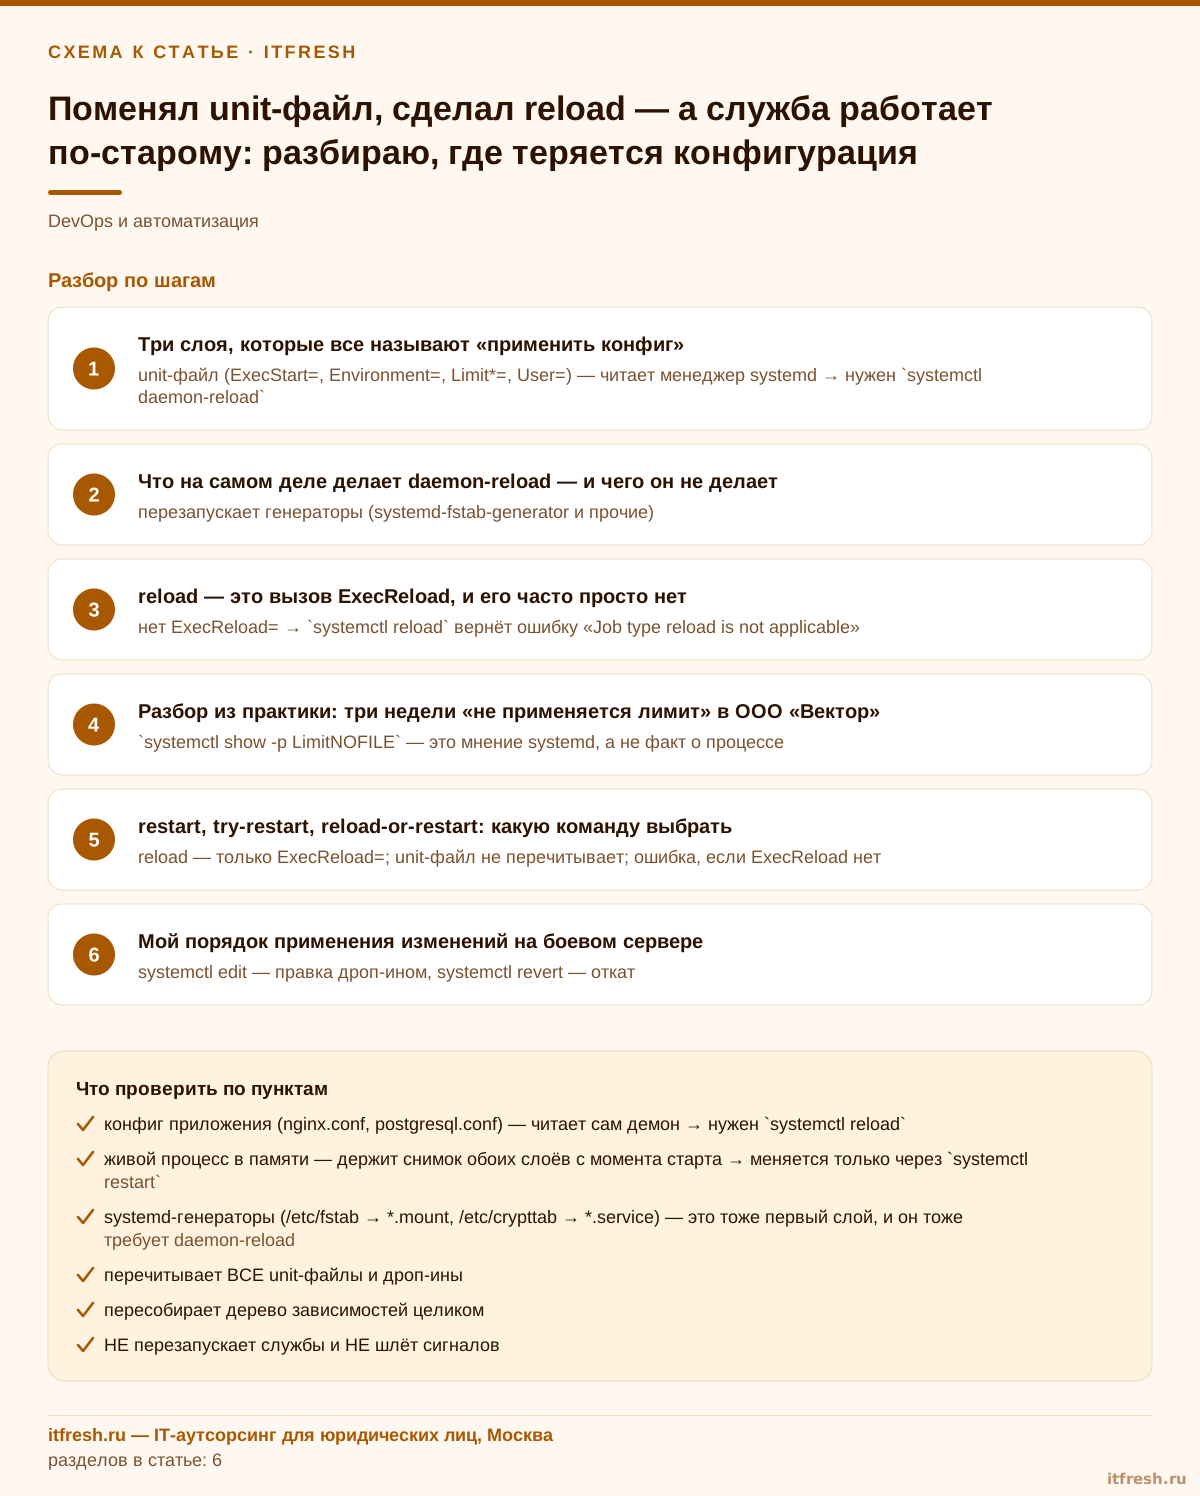
- перезапускает генераторы (systemd-fstab-generator и прочие)
- перечитывает ВСЕ unit-файлы и дроп-ины
- пересобирает дерево зависимостей целиком
- НЕ перезапускает службы и НЕ шлёт сигналов
- НЕ применяет новые Exec*/Environment*/Limit* к уже работающему процессу
reload — это вызов ExecReload, и его часто просто нет
systemctl reload не делает ничего магического. Он смотрит в юните строку ExecReload= и выполняет её. Если ExecReload= в юните не задано, юнит не поддерживает reload как тип задания, и вы получите отказ вида «Job type reload is not applicable for unit exchange.service.» — эта формулировка живёт в src/core/transaction.c и не менялась годами. Хорошая новость: молча проглотить эту ошибку systemctl не может. Плохая: в скриптах и хендлерах Ansible её нередко гасят через || true или ignore_errors, и тогда «reload отработал» превращается в фикцию.
Перед тем как закладывать reload в регламент, проверьте, поддерживает ли его юнит. Это одна команда:
# поддерживает ли юнит reload и что именно он выполнит
systemctl show -p CanReload,ExecReload --value exchange.service

# фактический главный PID и его реальные лимиты — вот это правда
PID=$(systemctl show -p MainPID --value exchange.service)
grep 'Max open files' /proc/$PID/limits
tr '\0' '\n' < /proc/$PID/environ | sort
И ещё один момент, который экономит нервы: перед reload проверяйте конфиг приложения его собственным валидатором, а не надейтесь на systemd. nginx -t, sshd -t, apachectl configtest, named-checkconf — у любого приличного демона такой режим есть. Systemd про синтаксис вашего nginx.conf не знает ровным счётом ничего: он выполнит ExecReload=, демон подавится битым конфигом, и в зависимости от реализации либо продолжит работать со старым (хорошо), либо упадёт (плохо, и вы узнаете об этом от пользователей). Хороший юнит от вендора ставит валидатор прямо в ExecReload= через &&, но самописные юниты этим почти никогда не заморачиваются.
Второй подводный камень — как именно написан ExecReload=. Классика из чужих юнитов: ExecReload=/bin/kill -HUP $MAINPID. Работает, но документация systemd.service(5) прямо предупреждает, что перезагрузка демона отправкой сигнала без уведомления о завершении «is usually not a good choice, because this is an asynchronous operation and hence not suitable when ordering reloads of multiple services against each other». То есть systemctl вернёт вам ноль сразу после отправки сигнала — задолго до того, как приложение реально перечитало конфиг. Если у вас в плейбуке следом идёт smoke-тест, он может отработать по старой конфигурации и радостно позеленеть.
- нет ExecReload= → `systemctl reload` вернёт ошибку «Job type reload is not applicable»
- `ExecReload=/bin/kill -HUP $MAINPID` — асинхронно, systemctl не ждёт завершения перечитывания
- правильно — Type=notify-reload (появился в systemd 253) либо ExecReload=, который синхронно ждёт результата
- ReloadSignal= позволяет заменить сигнал по умолчанию SIGHUP на другой
Разбор из практики: три недели «не применяется лимит»
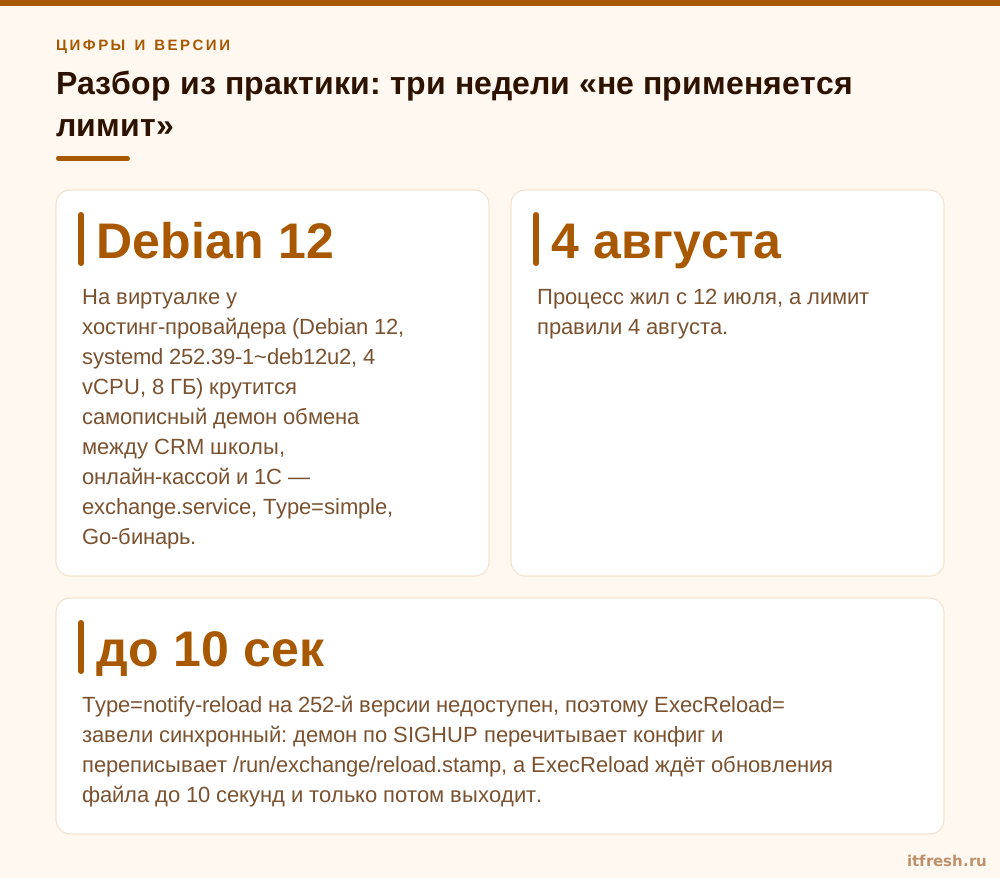
Клиент — школа актёрского мастерства «Дебют театральный», 33 рабочих места, инфраструктуру мы ведём целиком. На виртуалке у хостинг-провайдера (Debian 12, systemd 252.39-1~deb12u2, 4 vCPU, 8 ГБ) крутится самописный демон обмена между CRM школы, онлайн-кассой и 1С — exchange.service, Type=simple, Go-бинарь. В пиковые часы, когда открывалась запись на новый сезон курсов, он валился с «too many open files», логи об этом кричали. Приходящий админ школы поднял LimitNOFILE, сделал systemctl reload exchange, увидел нулевой код возврата и закрыл задачу. Через три недели ко мне пришли с формулировкой «лимит не работает, это баг ядра».
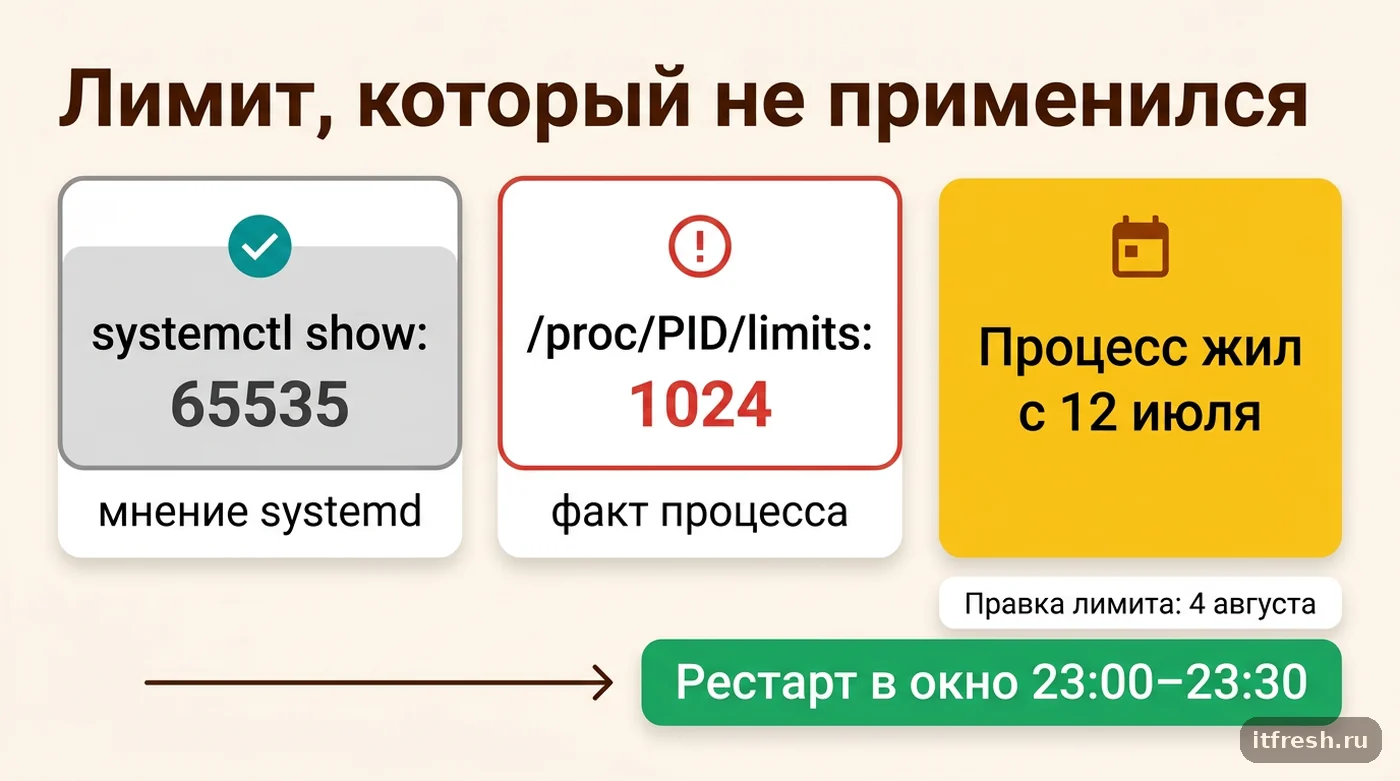
Почему reload вообще «прошёл», выяснилось быстро: в юните было ExecReload=/bin/kill -HUP $MAINPID, а демон SIGHUP просто игнорировал. Сам разбор занял пятнадцать минут и упёрся в две улики. Первая: systemctl show -p LimitNOFILE --value exchange.service отдавал 65535 — потому что daemon-reload на хосте всё-таки случился, но случайно, попутно с apt upgrade другого пакета. Systemd про новый лимит знал. Вторая улика убийственная: grep 'Max open files' /proc/$(systemctl show -p MainPID --value exchange.service)/limits показывал 1024. Процесс жил с 12 июля, а лимит правили 4 августа. Между этими двумя цифрами и пряталась вся драма: systemd знал новое значение, но применить его к уже работающему процессу физически не может — RLIMIT_NOFILE задаётся при exec(), и никак иначе.
Второй грабли клиент словил уже при исправлении: сделал systemctl restart exchange в 14:20, в разгар записи на курсы. Демон отправлял пакеты оплат в 1С без идемпотентности, три пакета оборвались на середине, наутро бухгалтер разбирала дубли оплат. Классическая цена «просто перезапусти» на боевом сервисе в рабочее время. Ну и вишенка — правку он внёс прямо в /lib/systemd/system/exchange.service. Первый же apt upgrade пакета затёр бы её без единого предупреждения.
Что сделали. Перенесли правку в дроп-ин через systemctl edit exchange.service — файл лёг в /etc/systemd/system/exchange.service.d/override.conf, апдейты его не трогают. Type=notify-reload на 252-й версии недоступен, поэтому ExecReload= завели синхронный: демон по SIGHUP перечитывает конфиг и переписывает /run/exchange/reload.stamp, а ExecReload ждёт обновления файла до 10 секунд и только потом выходит. Рестарт с новым лимитом провели в окно 23:00–23:30, когда занятия в школе уже закончились. Добавили в Zabbix проверку NeedDaemonReload по всем юнитам (об этом ниже). За полгода «too many open files» не повторялось ни разу.
# /etc/systemd/system/exchange.service.d/override.conf
# создавать только через: systemctl edit exchange.service
[Service]
LimitNOFILE=65535
Restart=on-failure
RestartSec=5
# синхронный reload: ждём подтверждения от самого демона
ExecReload=/usr/local/sbin/exchange-reload-wait 10- `systemctl show -p LimitNOFILE` — это мнение systemd, а не факт о процессе
- `/proc/PID/limits` и `/proc/PID/environ` — это факт о процессе
- если эти два источника расходятся, значит процесс не перезапускали после daemon-reload
- правки в /lib/systemd/system переживают до первого apt/dnf upgrade, дроп-ины в /etc/systemd/system — навсегда
restart, try-restart, reload-or-restart: какую команду выбрать
Семейство команд выглядит избыточным, пока не наступишь на разницу между ними в скрипте. Разница ровно в двух измерениях: что делать, если юнит поддерживает reload, и что делать, если юнит сейчас не работает. Формулировки из systemctl(1) я привожу дословно, потому что тут важен каждый оборот.
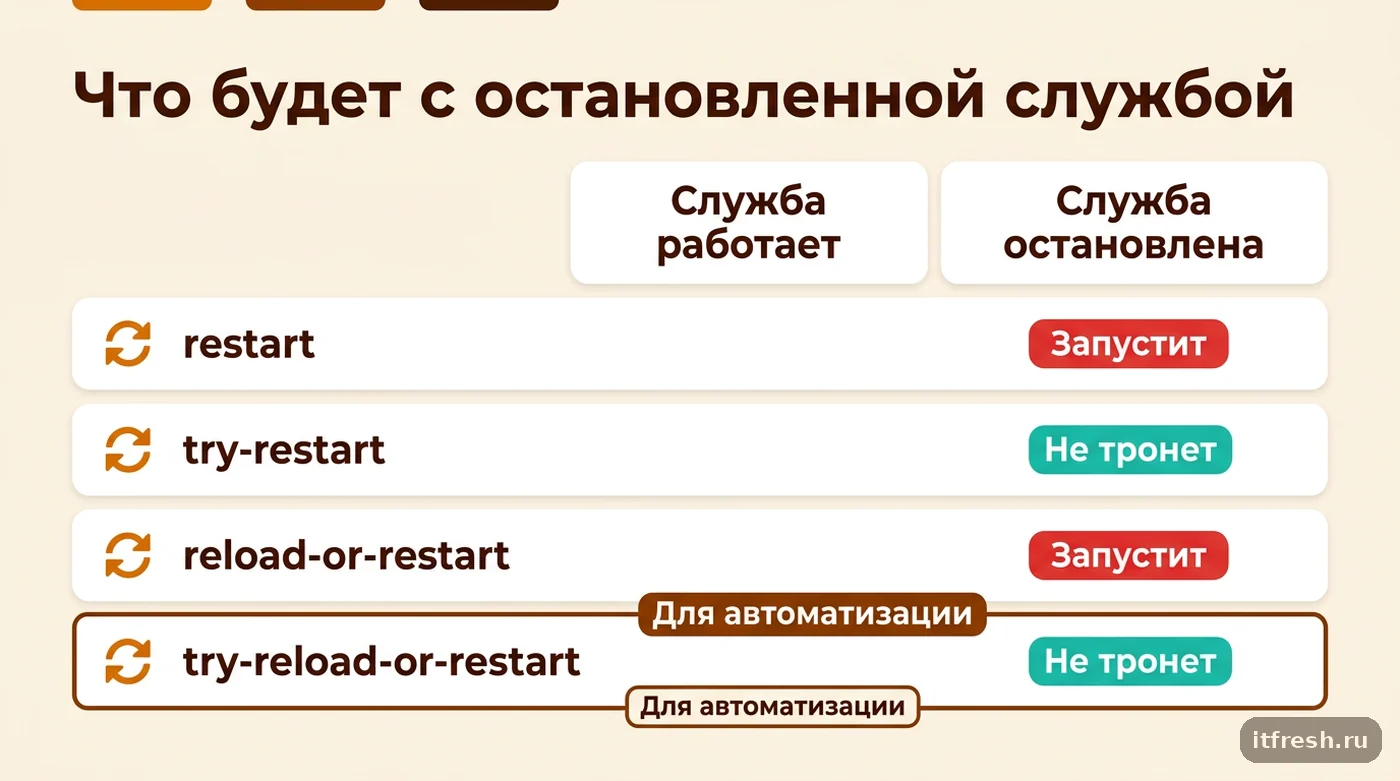
«restart: Stop and then start one or more units specified on the command line. If the units are not running yet, they will be started». Вот это «they will be started» — самая частая мина. У меня был случай, когда сервис намеренно погасили на время миграции данных, а ночной Ansible-плейбук с handler «restart app» поднял его обратно и записал в базу полтерабайта мусора. Кстати, если после stop порт остаётся занятым и start падает, дело уже не в reload, а в том, как systemd гасит процессы. Для скриптов, которые не должны воскрешать мёртвых, есть try-restart: «Stop and then start one or more units specified on the command line if the units are running. This does nothing if units are not running».
«reload-or-restart: Reload one or more units if they support it. If not, stop and then start them instead. If the units are not running yet, they will be started». А «try-reload-or-restart: Reload one or more units if they support it. If not, stop and then start them instead. This does nothing if the units are not running». Вторая — именно то, что кладут в postinst-скрипты пакетов, и именно то, что я рекомендую в любой автоматизации: она применяет изменения максимально мягко и не трогает то, что администратор выключил осознанно.
Про панику вокруг рестартов скажу честно: она часто преувеличена. Если сервис держит короткие HTTP-запросы за балансировщиком, идемпотентен и умеет переживать обрыв — рестарт в рабочее время не событие, и городить вокруг него согласования смысла нет. Опасен рестарт там, где процесс держит длинные транзакции, незакоммиченные батчи или клиентские сессии без реконнекта: обмены с маркетплейсами, выгрузки в 1С, очереди без подтверждения доставки. Вот там окно обязательно. Разделите свои сервисы на эти две корзины один раз — и половина вопросов «а можно перезапустить?» отпадёт сама.
Моя личная шпаргалка по выбору. Правил только конфиг приложения и юнит умеет reload — reload. Правил unit-файл — daemon-reload плюс restart в окно. Пишу автоматизацию, которая ходит по десяткам хостов — try-reload-or-restart, чтобы не поднять погашенное. Нужно гарантированно применить всё и сразу, состояние до этого неважно — restart. Про systemctl daemon-reload в автоматизации помните, что он глобальный: вызывать его один раз в конце прогона, а не после каждой правки каждого юнита.
- reload — только ExecReload=; unit-файл не перечитывает; ошибка, если ExecReload нет
- restart — stop+start; ПОДНИМЕТ остановленный юнит
- try-restart — stop+start только для работающего; остановленный не трогает
- reload-or-restart — reload при поддержке, иначе stop+start; остановленный ЗАПУСТИТ
- try-reload-or-restart — reload при поддержке, иначе stop+start; остановленный оставит остановленным
- daemon-reload — про менеджер, а не про службу; выполнять один раз после всех правок
Мой порядок применения изменений на боевом сервере
Последовательность, которую я держу в голове и в регламентах для инженеров. Она короткая и закрывает ровно те ошибки, из-за которых заявки и приходят.
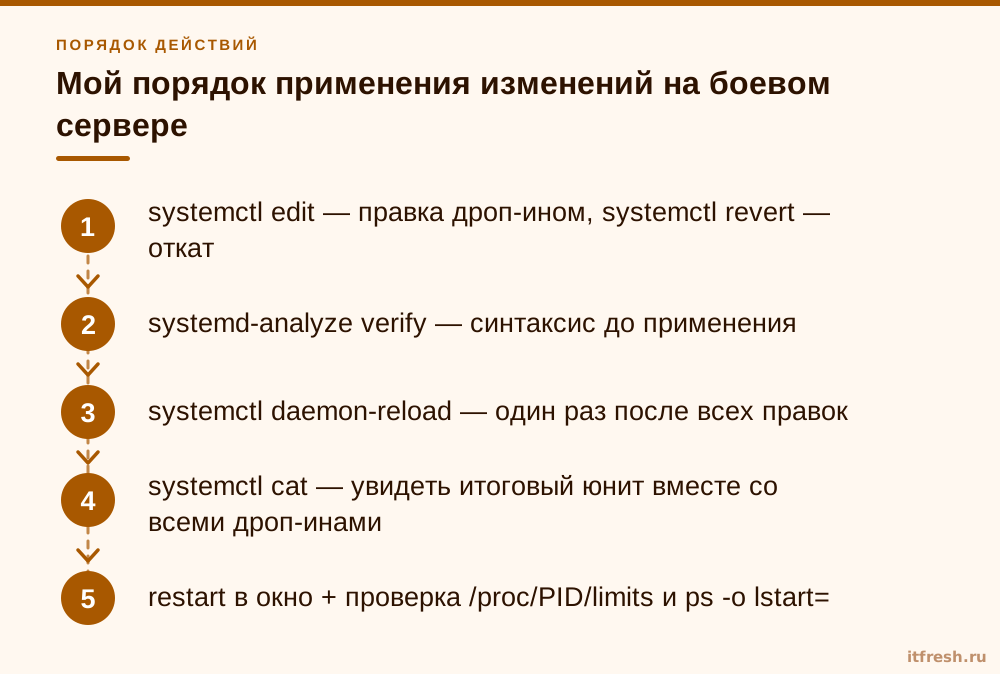
# 1. Правим только через edit — дроп-ин, а не сам unit-файл
sudo systemctl edit exchange.service

# 2. Синтаксис до применения (важно: проверяет и дроп-ины)
sudo systemd-analyze verify exchange.service

# 3. Менеджер перечитывает описания
sudo systemctl daemon-reload

# 4. Смотрим, что systemd ТЕПЕРЬ думает про юнит
systemctl cat exchange.service
systemctl show -p LimitNOFILE,Environment,ExecStart,CanReload --value exchange.service

# 5. Применяем к процессу: reload — если менялся конфиг приложения
#    restart — если менялся unit-файл (в согласованное окно!)
sudo systemctl restart exchange.service

# 6. Проверяем ФАКТ на живом PID, а не мнение systemd
PID=$(systemctl show -p MainPID --value exchange.service)
grep 'Max open files' /proc/$PID/limits
ps -o lstart= -p $PID
Шаг 2 недооценивают зря. systemd-analyze verify ловит опечатки в директивах, недостижимые пути в ExecStart= и битые ссылки на другие юниты ещё до того, как вы дёрнете рестарт. Он не идеален — часть предупреждений шумные, про отсутствующие в системе юниты вроде network-online.target, — но опечатку в имени директивы вроде LimitNOFLE= или неизвестную секцию найдёт мгновенно (пробелы вокруг «=» systemd, кстати, допускает — это не ошибка). Пять секунд против ночного разбора «почему сервис не стартовал».
Шаг 6 — единственный, который отличает «я применил» от «я думаю, что применил». Дата старта процесса из ps -o lstart= мгновенно показывает, был ли рестарт вообще. Если время старта старше времени вашей правки — значит, вы применили ровно ничего. Эту проверку я требую вставлять в чек-лист любой работы с unit-файлами, и она снимает большую часть спорных ситуаций «я же перезапускал».
- systemctl edit — правка дроп-ином, systemctl revert — откат
- systemd-analyze verify — синтаксис до применения
- systemctl daemon-reload — один раз после всех правок
- systemctl cat — увидеть итоговый юнит вместе со всеми дроп-инами
- restart в окно + проверка /proc/PID/limits и ps -o lstart=
Как ловить забытый daemon-reload автоматически
Человеческий фактор тут неустраним, поэтому забытый daemon-reload надо мониторить. У systemd для этого есть готовое свойство. В org.freedesktop.systemd1(5) оно описано так: «NeedDaemonReload is a boolean that indicates whether the configuration file this unit is loaded from (i.e. FragmentPath or SourcePath) has changed since the configuration was read and hence whether a configuration reload is recommended». То есть менеджер сам знает, что файл на диске новее, чем то, что он прочитал.
Именно это свойство systemctl использует, когда печатает предупреждение в статусе. Точный текст живёт в src/systemctl/systemctl-util.c: «Warning: The unit file, source configuration file or drop-ins of %s changed on disk. Run 'systemctl daemon-reload' to reload units.» Проблема в том, что предупреждение видно, только если вы руками зашли и посмотрели systemctl status. Поэтому я снимаю это свойство скриптом по всем юнитам и отдаю в мониторинг.
#!/bin/bash
# /usr/local/sbin/check-need-daemon-reload.sh
# печатает юниты, для которых systemd видит изменившийся файл
systemctl list-units --type=service --all --no-legend --plain \
  | awk '{print $1}' \
  | while read -r u; do
      if [ "$(systemctl show -p NeedDaemonReload --value "$u" 2>/dev/null)" = "yes" ]; then
        echo "$u"
      fi
    done
Дальше по вкусу: UserParameter в Zabbix с триггером на непустой вывод, или systemd-таймер раз в 15 минут с алертом в чат дежурных. У нас это часть базового шаблона на всех Linux-хостах клиентов, и ловит оно ровно тот сценарий, ради которого написана статья: кто-то положил файл, забыл про daemon-reload, и хост неделю живёт с расхождением между диском и памятью менеджера.
Честная оговорка про пределы этой проверки. NeedDaemonReload смотрит на FragmentPath и SourcePath конкретного юнита. Он покажет расхождение после правки unit-файла или дроп-ина, но он ничего не знает про третий слой — про то, что процесс не перезапускали после успешного daemon-reload. Для этого нужна отдельная проверка: сравнивать время старта главного PID с mtime unit-файла. Я держу обе, и вторая срабатывает заметно чаще первой. А если после рестарта служба не поднимается вовсе и уходит в отказ, смотрите разбор ошибки start-limit-hit — это частое продолжение этой истории.
- `systemctl show -p NeedDaemonReload --value UNIT` → yes/no
- предупреждение в `systemctl status` показывает то же самое, но только вручную
- заворачивайте в UserParameter Zabbix или в systemd-таймер с алертом
- вторая проверка обязательна: `ps -o lstart=` главного PID против mtime unit-файла
Частые вопросы
Нужно ли делать daemon-reload после каждой правки unit-файла?
Да. Без него менеджер продолжает работать со старой копией описания юнита, и любой ваш restart поднимет процесс по-старому. Но выполнять daemon-reload достаточно один раз после всех правок — операция глобальная, она перечитывает все юниты и пересобирает дерево зависимостей целиком, а не только ваш сервис.
Почему systemctl reload иногда завершается без ошибки, но ничего не меняет?
Скорее всего, ExecReload= в юните написан как отправка сигнала — например `/bin/kill -HUP $MAINPID`. systemctl возвращает ноль сразу после отправки сигнала, не дожидаясь, пока демон реально перечитает конфиг. Если демон сигнал игнорирует или падает при обработке, вы этого не увидите. Лечится либо синхронным ExecReload=, либо Type=notify-reload на systemd 253 и новее.
Достаточно ли daemon-reload, чтобы применился новый LimitNOFILE или Environment?
Нет. Лимиты ресурсов и переменные окружения задаются процессу в момент exec() и после этого не меняются. Нужен полноценный restart. Проверять результат надо не через systemctl show, а на живом процессе: `grep 'Max open files' /proc/PID/limits` и `tr '\0' '\n' < /proc/PID/environ`.
Как понять, поддерживает ли служба reload вообще?
Командой `systemctl show -p CanReload,ExecReload --value имя.service`. Если CanReload=no, то `systemctl reload` вернёт ошибку «Job type reload is not applicable for unit ...». В скриптах такую ошибку часто гасят через `|| true`, из-за чего создаётся иллюзия успешного применения конфигурации.
Чем restart отличается от try-restart и что безопаснее в автоматизации?
restart поднимет службу, даже если она была остановлена намеренно — это самая частая мина в Ansible-хендлерах и cron-скриптах. try-restart перезапустит только работающую службу и не тронет остановленную. Для массовой автоматизации я рекомендую try-reload-or-restart: мягкое применение изменений без воскрешения того, что администратор выключил осознанно.
Можно ли править файл в /lib/systemd/system?
Технически можно, практически — нет: первое же обновление пакета затрёт правку молча. Используйте `systemctl edit UNIT` для дроп-ина в /etc/systemd/system/UNIT.d/override.conf или `systemctl edit --full UNIT` для полной копии в /etc. Посмотреть итоговую конфигурацию со всеми дроп-инами — `systemctl cat UNIT`, откатить — `systemctl revert UNIT`.
Источники
- systemctl(1) — man7.org — Раздел Unit Commands: точные формулировки daemon-reload («rerun all generators, reload all unit files, and recreate the entire dependency tree»), reload, restart, try-restart, reload-or-restart, try-reload-or-restart. https://man7.org/linux/man-pages/man1/systemctl.1.html
- systemd.service(5) — man7.org — Директивы ExecReload=, ReloadSignal=, Type=notify-reload; предупреждение об асинхронности `kill -HUP $MAINPID` («this is an asynchronous operation and hence not suitable when ordering reloads of multiple services against each other»). https://man7.org/linux/man-pages/man5/systemd.service.5.html
- org.freedesktop.systemd1(5) — man7.org — Свойство NeedDaemonReload (readonly b) и методы Reload(), Restart(), TryRestart(), ReloadOrRestart() шины org.freedesktop.systemd1.Manager. https://man7.org/linux/man-pages/man5/org.freedesktop.systemd1.5.html
- systemd NEWS, CHANGES WITH 253 — CHANGES WITH 253: введение Type=notify-reload и ReloadSignal= (по умолчанию SIGHUP); CHANGES WITH 262: службы Type=notify-reload обязаны ловить или блокировать ReloadSignal= до отправки READY=1. https://github.com/systemd/systemd/blob/main/NEWS
- Исходный код systemd (main) — Точные тексты сообщений: warn_unit_file_changed() в src/systemctl/systemctl-util.c («Warning: The unit file, source configuration file or drop-ins of %s changed on disk...») и «Job type %s is not applicable for unit %s.» в src/core/transaction.c. https://github.com/systemd/systemd
- Версии systemd в дистрибутивах (сентябрь 2026) — Debian 12 bookworm — 252.39-1~deb12u2, Debian 13 trixie — 257.13-1~deb13u1 (https://sources.debian.org/src/systemd/); Ubuntu 22.04 — 249.11, Ubuntu 24.04 — 255.4 (https://launchpad.net/ubuntu/+source/systemd)