
Почему приложение не видит сетевую БД после загрузки, хотя network-online.target уже active
Плановый ребут в ночное окно, утром приложение лежит. systemctl зелёный по всей загрузке, network-online.target достигнут, сеть на месте — а в журнале службы «could not translate host name» и failed. Помогает ручной systemctl restart, и все делают вид, что так и надо. Разбираю, почему связка Wants= и After=network-online.target не даёт того, что от неё ждут, кто в вашей системе реально решает, что она «онлайн», и как я настраиваю юниты, чтобы служба сама переживала тридцать секунд тишины на аплинке.
«Онлайн» в systemd — это про прошедшее время
Начну с формулировки, которую стоит один раз прочитать глазами. В systemd.special(7) про network-online.target написано прямым текстом: «Note that this unit is only useful during the original system start-up logic. After the system has completed booting up, it will not track the online state of the system anymore». Это одноразовая отсечка на старте. Она щёлкнула — и всё, дальше цель просто висит в состоянии active до самого выключения, независимо от того, что происходит с сетью. Провайдер лёг, VLAN переконфигурировали, bond развалился — target по-прежнему active. Никакого мониторинга связности за этим именем не стоит и никогда не стояло.
Второе, что упускают, сформулировано в апстримном документе systemd.io: цель означает, что «network connectivity has been reached, not that it is currently available». Между «интерфейс получил адрес и маршрут» и «PostgreSQL на соседней виртуалке принимает соединения на 5432» лежит целая цепочка: согласование порта на коммутаторе, STP, LACP, файрвол, маршрутизация до другой подсети, DNS, а в конце — сам демон СУБД, который тоже только что ребутнулся и десять секунд поднимает WAL. systemd про эту цепочку не знает ничего и знать не может: у него нет ни одного способа проверить, отвечает ли ваш сервер БД.
И третье, самое обидное. В терминах systemd.special(7) network-online.target — активная цель: её подтягивает потребитель, а не поставщик сети, и в обычной загрузке она вообще не участвует, пока хотя бы один юнит её не запросит. Но собственной логики у неё нет: всю работу выполняет отдельная служба ожидания, которая встраивается перед целью. Если такой службы в системе нет или она выключена — цель достигается мгновенно, за десятки миллисекунд, и ваш After= формально соблюдён. Юнит-файл выглядит правильно, ревьюер кивает, а гарантии нет никакой. Именно этот случай я вижу чаще всего.
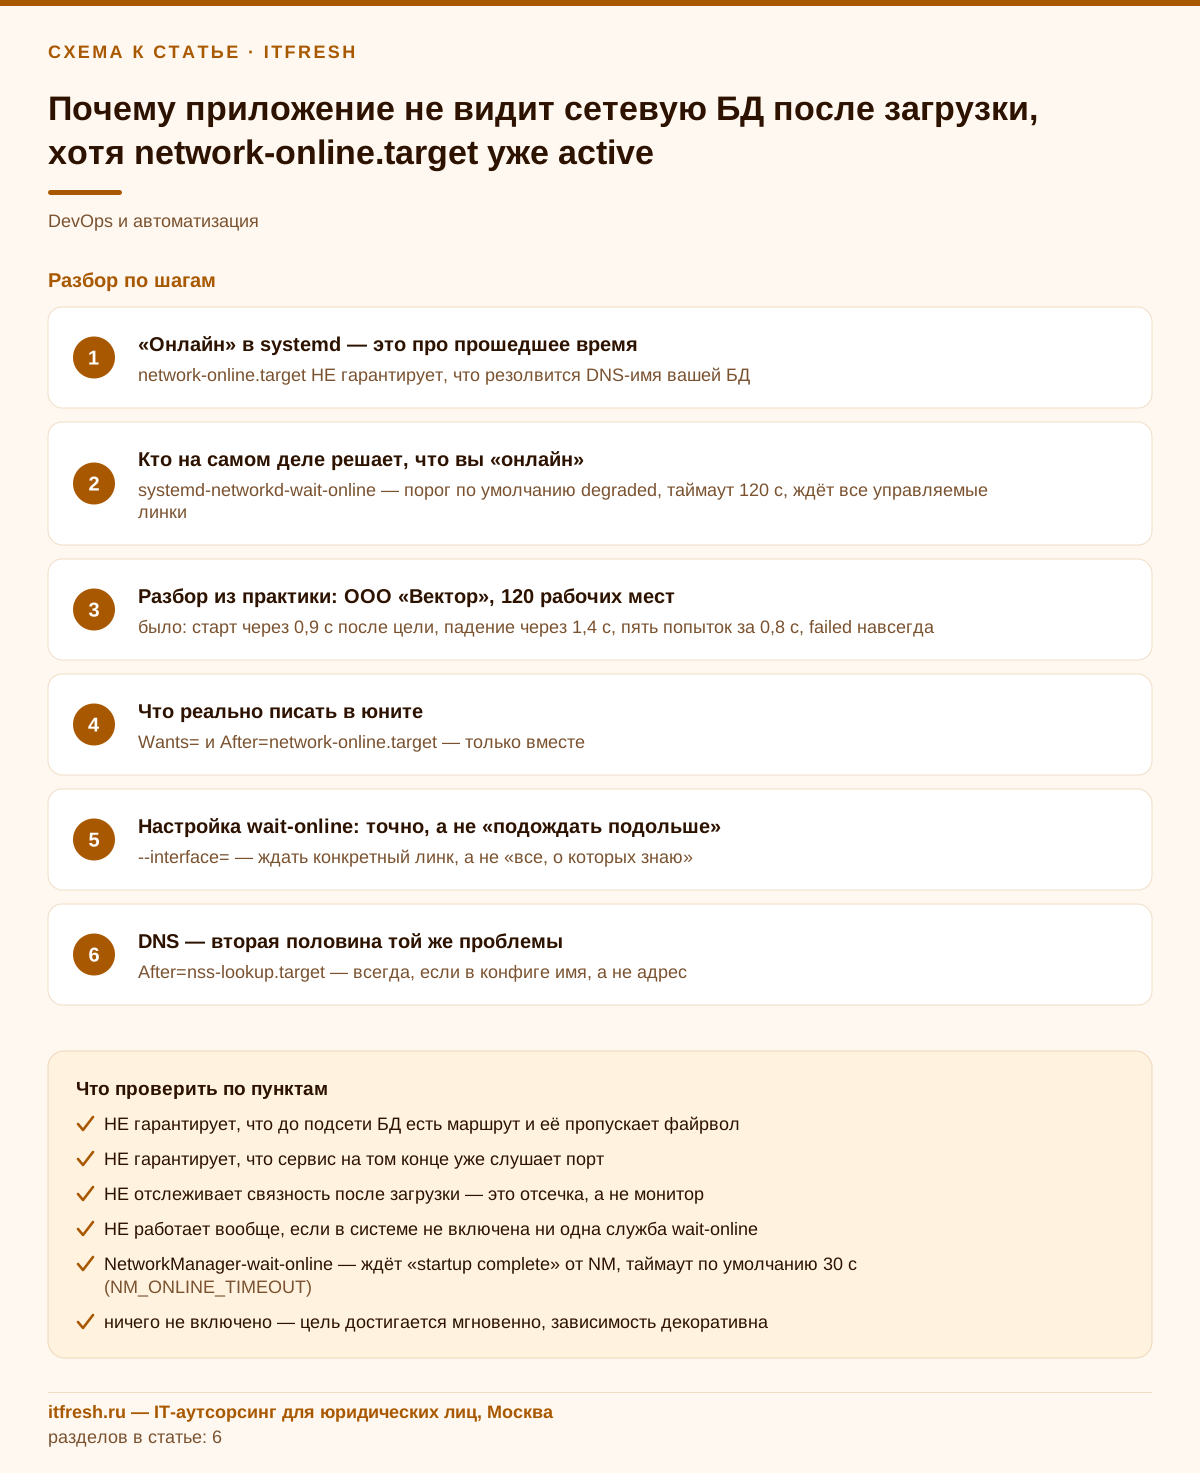
- network-online.target НЕ гарантирует, что резолвится DNS-имя вашей БД
- НЕ гарантирует, что до подсети БД есть маршрут и её пропускает файрвол
- НЕ гарантирует, что сервис на том конце уже слушает порт
- НЕ отслеживает связность после загрузки — это отсечка, а не монитор
- НЕ работает вообще, если в системе не включена ни одна служба wait-online
Кто на самом деле решает, что вы «онлайн»
Смысл слова «онлайн» задаёт та служба ожидания, которая включена, и её настройки. Универсального набора проверок не существует — это прямо сказано в документации systemd. Вариантов на практике три, и они ведут себя по-разному. Первый: systemd-networkd-wait-online.service. По умолчанию он ждёт, пока все известные ему и управляемые networkd линки будут либо полностью настроены, либо перейдут в failed, и пока хотя бы один линк не станет online. Дефолтный порог операционного состояния — degraded, таймаут — 120 секунд. Второй вариант: NetworkManager-wait-online.service. Он держит цель, пока NetworkManager по D-Bus не отрапортует «startup complete», то есть пока все профили и устройства не окажутся активированы или в состоянии disconnected и не ожидается новых событий. Под капотом это nm-online -s -q. У самой утилиты nm-online таймаут по умолчанию 30 секунд, но в апстримном юните NetworkManager-wait-online.service задано Environment=NM_ONLINE_TIMEOUT=60, так что служба ждёт до 60 секунд.
Третий вариант — самый частый на серверах и самый вредный: не включено ничего. Так бывает после сборки образа из cloud-image, после ручной чистки «лишних» юнитов, после миграции с ifupdown, после того как кто-то выключил wait-online, потому что тот тормозил загрузку на 120 секунд. Формально всё цело: цель есть, зависимости прописаны, загрузка быстрая. Фактически цель достигается вместе с basic.target, и приложение стартует ровно тогда же, когда стартовало бы без всяких зависимостей.
Проверяется это тремя командами, и я прошу выполнять их до любых правок юнитов. Смотрим, что установлено, что включено и какая цепочка реально привела к цели.
systemctl list-unit-files | grep -E 'wait-online'
systemctl is-enabled systemd-networkd-wait-online.service NetworkManager-wait-online.service
systemd-analyze critical-chain network-online.target
networkctl status
Ещё одна деталь про networkd, о которую спотыкаются. Порог по умолчанию — операционное состояние не ниже degraded. В терминологии networkd routable — это отдельное, более высокое состояние. То есть линк, который поднял несущую и получил только link-local адрес, при дефолтных настройках уже считается online, и цель будет достигнута. Для bond- и bridge-интерфейсов дефолт ещё мягче — degraded-carrier. Для сервера, которому нужен IPv4-адрес из рабочей подсети, это не то ожидание, которое вам нужно.
- systemd-networkd-wait-online — порог по умолчанию degraded (для bond/bridge — degraded-carrier), таймаут 120 с, ждёт все управляемые линки и хотя бы один online
- NetworkManager-wait-online — ждёт «startup complete» от NM (nm-online -s), в апстримном юните NM_ONLINE_TIMEOUT=60, у голой nm-online дефолт 30 с
- ничего не включено — цель достигается мгновенно, зависимость декоративна
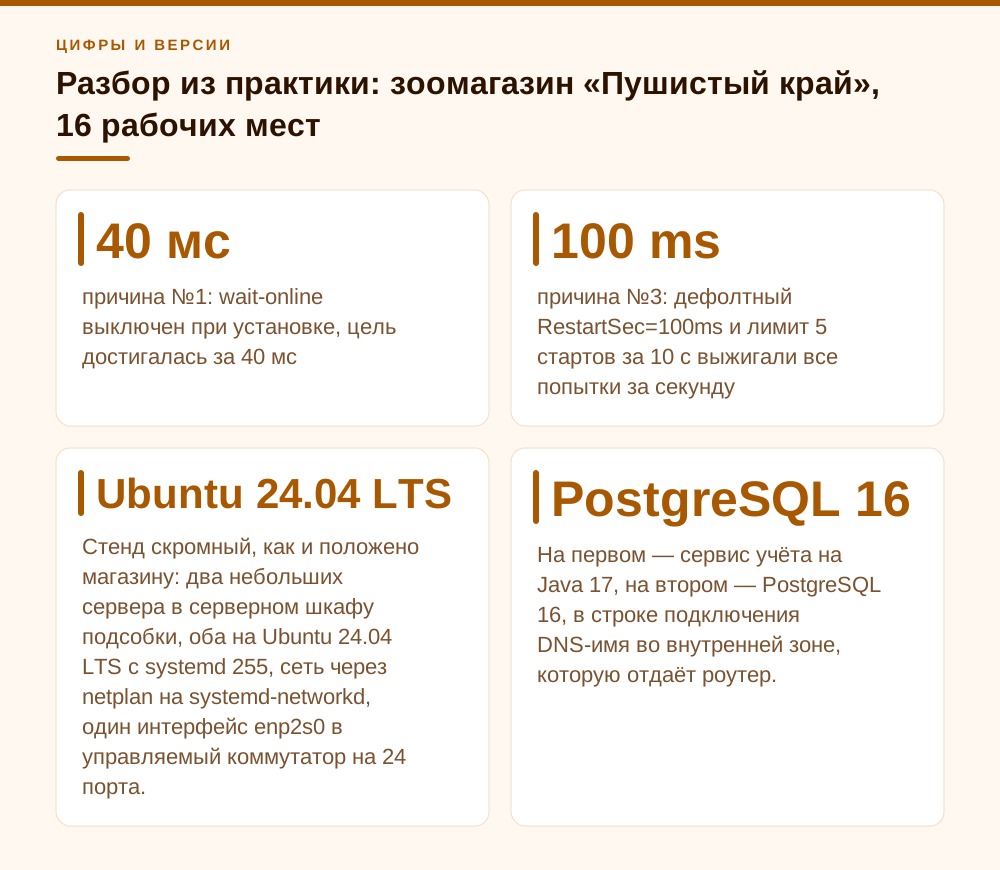
Разбор из практики: зоомагазин «Пушистый край», 16 рабочих мест
Зоомагазин «Пушистый край»: торговый зал, склад кормов и небольшой офис, 16 рабочих мест, включая кассы и планшеты кладовщиков. Мы обслуживаем их инфраструктуру, раз в месяц в ночь на понедельник накатываем обновления и перезагружаем серверы. Жалоба от администратора магазина: после ребута внутренний сервис учёта остатков, который синхронизирует склад с кассами и интернет-витриной, примерно в половине случаев не поднимается, кассиры утром видят устаревшие остатки. Лечится ручным рестартом. Симптом плавающий, поэтому несколько месяцев жили с инструкцией «в понедельник утром зайди и перезапусти».
Стенд скромный, как и положено магазину: два небольших сервера в серверном шкафу подсобки, оба на Ubuntu 24.04 LTS с systemd 255, сеть через netplan на systemd-networkd, один интерфейс enp2s0 в управляемый коммутатор на 24 порта. На первом — сервис учёта на Java 17, на втором — PostgreSQL 16, в строке подключения DNS-имя во внутренней зоне, которую отдаёт роутер. Юнит писал внешний разработчик, и написан он был «по документации»: Wants= и After=network-online.target на месте, Restart=on-failure на месте.
Журнал разложил всё за пять минут. Служба стартовала через 0,9 секунды после того, как цель стала active, падала через 1,4 секунды с UnknownHostException на имени базы. RestartSec не задан, а значит по умолчанию 100 мс. Лимит стартов — дефолтный, пять попыток за десять секунд. Итог: за неполную секунду юнит выжигал все пять попыток и уходил в failed с записью start-limit-hit. Дальше сеть спокойно поднималась, база становилась доступна, но перезапускать было уже некому.
journalctl -b -u stock-sync.service -o short-precise | head -40
# ...
# stock-sync.service: Scheduled restart job, restart counter is at 5.
# stock-sync.service: Start request repeated too quickly.
# stock-sync.service: Failed with result 'start-limit-hit'.
Дальше выяснилось главное. systemd-networkd-wait-online.service в системе был disabled — его выключил подрядчик при установке, «чтобы сервер быстрее грузился». Цель network-online.target достигалась за 40 миллисекунд вместе с остальным базовым набором. Плюс на коммутаторе был включён классический STP, а порты серверов не были помечены как edge: после подъёма линка порт проходил состояния listening и learning, и до прохождения трафика уходило от 28 до 31 секунды. То есть приложение стартовало примерно за полминуты до того, как сеть вообще начинала работать.
Что сделали. Включили и настроили wait-online на enp2s0 с порогом routable и разумным таймаутом; переписали юнит на нормальный бэкофф и сняли лимит стартов; в .network-файле явно пометили, что этот линк обязателен для признания системы онлайн. Порты серверов на коммутаторе потом тоже перевели в edge по отдельной заявке, но принципиально сначала довели до ума сам сервер: приложение после правок спокойно переживает эти тридцать секунд и без изменений на коммутаторе. Результат: восемь перезагрузок подряд без ручного вмешательства, среднее время от включения питания до готовности сервиса — 46 секунд. Инструкцию «зайди утром и перезапусти» убрали, а кассиры перестали продавать корм, которого уже нет на складе.
- было: старт через 0,9 с после цели, падение через 1,4 с, пять попыток меньше чем за секунду, failed до ручного вмешательства
- причина №1: wait-online выключен при установке, цель достигалась за 40 мс
- причина №2: классический STP без edge-портов — 28–31 с до реального прохождения трафика
- причина №3: дефолтный RestartSec=100ms и лимит 5 стартов за 10 с выжигали все попытки за секунду
Что реально писать в юните
Правильный юнит для сервиса, зависящего от удалённой БД, выглядит так. Обратите внимание, что зависимость от цели тут — не главное; главное начинается в блоке рестартов.
[Unit]
Description=Stock sync service
Wants=network-online.target
After=network-online.target nss-lookup.target
StartLimitIntervalSec=0

[Service]
Type=exec
ExecStart=/opt/stock-sync/bin/app
Restart=on-failure
RestartSec=5
RestartSteps=5
RestartMaxDelaySec=120
Разбираю по строкам. Wants= вместе с After= — это ровно та связка, которую рекомендует апстрим: Wants= подтягивает цель в транзакцию, After= упорядочивает запуск после неё. Именно вместе; один After= без Wants= не заставит цель активироваться, если её никто больше не тянет. After=nss-lookup.target добавляю всегда, когда в конфиге приложения фигурирует имя, а не IP: документация говорит, что службы, которым критично разрешение имён, должны упорядочиваться после этой цели, но не подтягивать её через Wants=. Requires=network-online.target я не ставлю: сама цель тянет службу ожидания слабой зависимостью, так что при таймауте wait-online цель всё равно будет достигнута, и Requires= не добавляет ни грамма надёжности — зато жёстко связывает остановку вашей службы с остановкой цели. Type=exec вместо Type=notify выбран сознательно: notify имеет смысл, только если приложение само шлёт sd_notify(READY=1), а обычный Java-сервис этого не делает.
StartLimitIntervalSec=0 снимает лимит перезапусков — это и есть главная строчка. Без неё любая настройка бэкоффа бессмысленна: пять неудачных попыток, и юнит мёртв до утра. RestartSec=5 задаёт стартовую паузу вместо дефолтных 100 миллисекунд. RestartSteps=5 и RestartMaxDelaySec=120 дают экспоненциальный рост паузы от 5 секунд до двух минут — приложение будет упорно стучаться в базу, не устраивая при этом шторма коннектов и не забивая журнал. Обе директивы появились в systemd 254, так что на Debian 12 и RHEL 9 (там systemd 252) их не будет — на этих системах просто оставьте RestartSec=10 и StartLimitIntervalSec=0.
И ещё: StartLimitIntervalSec= и StartLimitBurst= живут в секции [Unit], а не в [Service]. Исторически они были в [Service], в интернете полно копипасты именно оттуда, и я регулярно вижу конфиги, где настройка лежит не в той секции и молча не работает. Проверяйте через systemctl show -p StartLimitIntervalSec your-app.service, а не глазами по файлу.
- Wants= и After=network-online.target — только вместе
- After=nss-lookup.target — если в конфиге имя, а не IP; без Wants=
- Requires=network-online.target — не надо, надёжности не добавляет
- StartLimitIntervalSec=0 в [Unit] — обязательно, иначе бэкофф бесполезен
- RestartSteps= и RestartMaxDelaySec= — только systemd 254 и новее
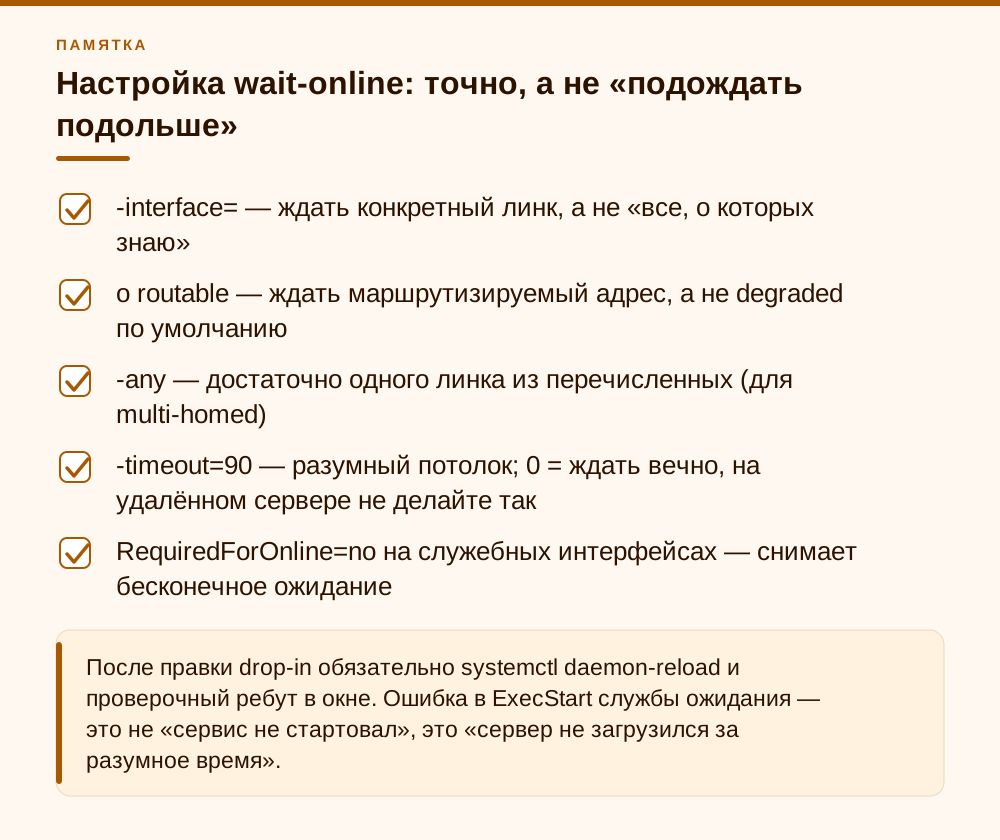
Настройка wait-online: точно, а не «подождать подольше»
Если ожидание всё-таки нужно — а оно нужно для сервисов, которые обязаны биндиться на конкретный адрес или монтировать сетевую ФС, — настраивайте его прицельно. Для systemd-networkd я делаю drop-in с явным интерфейсом, порогом routable и таймаутом, который меня устраивает. Пустой ExecStart= в первой строке обязателен: без него вторая строка не заменит команду, а добавит вторую. Если нужен ровно один интерфейс, есть и готовый шаблон systemd-networkd-wait-online@.service: он запускает ту же утилиту с -i и именем интерфейса из инстанса, например systemd-networkd-wait-online@enp2s0.service.
# /etc/systemd/system/systemd-networkd-wait-online.service.d/override.conf
[Service]
ExecStart=
ExecStart=/usr/lib/systemd/systemd-networkd-wait-online --interface=enp2s0 -o routable --timeout=90
Второй рычаг — сами .network-файлы. Там есть RequiredForOnline=, которая принимает булево значение, минимальное операционное состояние или диапазон состояний через двоеточие. По умолчанию она включена, если ActivationPolicy= не задана либо равна up, always-up или bound. Есть и RequiredFamilyForOnline= со значениями ipv4, ipv6, both и any — по умолчанию any. Для сервера с двумя интерфейсами это ключевые настройки: помечаете рабочий линк как обязательный с требованием IPv4, а служебный или резервный — как необязательный, и wait-online перестаёт зависать на интерфейсе, который в этой конфигурации адрес и не получит.
# /etc/systemd/network/10-enp2s0.network
[Match]
Name=enp2s0

[Link]
RequiredForOnline=routable
RequiredFamilyForOnline=ipv4
Для NetworkManager рычаг ровно один и он грубее — таймаут. Задаётся переменной NM_ONLINE_TIMEOUT в drop-in к NetworkManager-wait-online.service (в апстримном юните стоит 60) либо аргументом -t у nm-online. Сами разработчики NetworkManager в комментарии к юниту пишут, что упор в таймаут обычно означает проблему конфигурации, а не слишком маленькое значение. Смысл ожидания при этом остаётся «NM закончил стартовать», а не «сеть работает»: устройство, ушедшее в disconnected, тоже считается финальным состоянием. Отдельно предупреждаю про --dns у networkd: по man-странице опция ждёт, пока DNS-серверы на каждом интерфейсе станут доступны. Это не значит, что во внутренней зоне уже есть запись вашей БД и что DNS-сервер отдаёт на неё правильный ответ. Для машин с несколькими равноправными аплинками пригодится --any: ожидание завершается, как только online стал хотя бы один из интерфейсов.
И про таймауты честно. Ожидание блокирует загрузку. --timeout=0 означает «ждать бесконечно» — на сервере в удалённом ЦОД это способ не увидеть машину после ребута вообще, если линк не поднялся. Я держу 60–90 секунд: этого хватает на LACP и STP, и при этом система в худшем случае доедет до логина и даст зайти по IPMI-консоли и разобраться.
- --interface= — ждать конкретный линк, а не «все, о которых знаю»
- -o routable — ждать маршрутизируемый адрес, а не degraded по умолчанию
- --any — достаточно одного линка из перечисленных (для multi-homed)
- --timeout=90 — разумный потолок; 0 = ждать вечно, на удалённом сервере не делайте так
- RequiredForOnline=no на служебных интерфейсах — снимает бесконечное ожидание
- --dns — ждать доступности DNS-серверов на линке, но не записей вашей зоны
DNS — вторая половина той же проблемы
Больше половины случаев «приложение не видит БД после ребута», которые я разбирал, упирались не в маршрут, а в имя. Интерфейс поднят, адрес есть, пинг по IP идёт — а getaddrinfo возвращает ошибку, потому что resolved ещё не дочитал конфигурацию линка, или /etc/resolv.conf в этот момент указывает не туда, или DNS в сети — это роутер или контроллер домена, который после общего отключения питания сам ещё грузится. Отсюда правило: если в конфиге приложения стоит имя, After=nss-lookup.target нужен так же, как и зависимость от сетевой цели.
Что смотреть на systemd-resolved: чем на самом деле является /etc/resolv.conf и какие серверы приехали на линк. Симлинк на stub-resolv.conf с адресом 127.0.0.53 — это нормальный режим; настоящий файл с внешним сервером, оставшийся от прошлой конфигурации, — источник половины плавающих проблем.
ls -l /etc/resolv.conf
resolvectl status
resolvectl query db.example.internal
И отдельная мина, про которую редко думают: кэш резолва внутри самого приложения. В JVM поведением управляют networkaddress.cache.ttl и networkaddress.cache.negative.ttl из java.security, и отрицательные ответы там кэшируются по умолчанию — а исторически при включённом SecurityManager положительный кэш вообще был бессрочным. Практический эффект такой: процесс один раз получил отказ в разрешении имени на старте и продолжает получать его из своего кэша ещё какое-то время после того, как DNS уже работает. Если ваш пул соединений при этом не пересоздаёт коннекты, приложение будет выглядеть мёртвым при полностью живой сети. Лечится либо настройкой TTL, либо — что честнее — нормальным ретраем в коде.
Спорный совет, который я всё-таки дам: для одной-двух критичных внутренних БД я иногда прошу поставить в строку подключения IP вместо имени. Да, это ухудшает гибкость и я сам обычно против таких вещей. Но если адрес сервера БД не менялся четыре года и меняться не планирует, а зависимость от DNS на старте регулярно роняет сервис — обмен честный. Только зафиксируйте это в документации на систему, иначе через год при переезде БД будете искать этот IP по всем конфигам.
- After=nss-lookup.target — всегда, если в конфиге имя, а не адрес
- проверить, что /etc/resolv.conf — симлинк на актуальный stub, а не забытый файл
- resolvectl status — какие DNS реально приехали на линк
- проверить кэш резолва внутри рантайма приложения (для JVM — java.security)
NFS и CIFS: remote-fs.target и _netdev
Отдельный класс тех же проблем — сетевые шары в /etc/fstab. Тут systemd делает за вас больше, чем многие думают: по man systemd.mount(5) юниты сетевых монтирований автоматически получают After= на remote-fs-pre.target и network.target, After= и Wants= на network-online.target и Before= на remote-fs.target. Какая ФС сетевая, systemd понимает по её типу — nfs, nfs4, cifs распознаются сами. Опция _netdev нужна там, где по типу этого не видно: ext4 или xfs поверх iSCSI-диска, блочное устройство на удалённой полке. Дописывать _netdev к строке с cifs вреда не принесёт, но и чудес не сделает.
Важная тонкость: всё это упирается в ту же самую network-online.target. Если служба ожидания выключена, монтирование пойдёт в первую секунду загрузки и упадёт, а remote-fs.target при обычной строке fstab попытается дождаться шару, которой нет. Поэтому для шар, без которых сервер может загрузиться, я ставлю nofail и x-systemd.automount: монтирование произойдёт при первом обращении к каталогу, а не на старте. Службе, которая пишет на шару, добавляю RequiresMountsFor= с путём — systemd сам выстроит зависимость от нужного mount-юнита.
# /etc/fstab
//nas.example.internal/backup  /mnt/backup  cifs  credentials=/etc/cifs-backup.cred,_netdev,nofail,x-systemd.automount,x-systemd.mount-timeout=30  0  0
nas.example.internal:/export/photo  /mnt/photo  nfs4  _netdev,nofail,x-systemd.automount  0  0
# systemctl edit stock-sync.service
[Unit]
RequiresMountsFor=/mnt/backupПосле правки fstab обязательно systemctl daemon-reload — fstab превращается в mount-юниты генератором, и без перезагрузки конфигурации systemd продолжит жить со старой картиной. Проверить итог можно через systemctl list-units -t mount,automount и systemctl show -p After,Wants mnt-backup.mount.
- nfs/nfs4/cifs распознаются как сетевые по типу ФС, _netdev нужен для iSCSI и похожих случаев
- сетевые mount-юниты сами получают Wants= и After= на network-online.target
- nofail — загрузка не ждёт и не валится из-за недоступной шары
- x-systemd.automount — монтирование при первом обращении, а не на старте
- RequiresMountsFor= в юните службы — зависимость от нужной точки монтирования
Когда ExecStartPre-ожидание всё-таки уместно
Ниже я ругаю sleep в ExecStartPre, но честное ожидание конкретной зависимости — другое дело. Бывает софт, который при первой неудаче подключения не падает, а переходит в полурабочее состояние: процесс жив, systemd доволен, Restart= не срабатывает, а данные не синхронизируются. Для такого приложения ретраи systemd бесполезны, и единственный способ — не запускать его, пока база не ответила. То же с корпоративным VPN до филиала: интерфейс туннеля поднимается сразу, а до сервера за ним трафик идёт только после рукопожатия.
В таких случаях я ставлю короткую проверку с жёстким потолком по времени: сначала резолвится ли имя, потом открывается ли TCP-порт. Если не дождались — ExecStartPre возвращает ненулевой код, запуск считается неудачным, и дальше работает тот же бэкофф из Restart=on-failure и RestartSec. Для туннеля добавляю порядок относительно его юнита, например After= и Wants= на wg-quick@wg0.service, но полагаюсь всё равно на проверку порта, а не на факт поднятого интерфейса.
# systemctl edit stock-sync.service
[Service]
ExecStartPre=/usr/bin/timeout 60 /bin/sh -c 'until getent hosts db.example.internal >/dev/null && /usr/bin/pg_isready -q -h db.example.internal -p 5432; do sleep 2; done'
TimeoutStartSec=90
Здесь важны три вещи. Потолок timeout 60 меньше, чем TimeoutStartSec=90, иначе systemd убьёт юнит по своему таймауту раньше, чем скрипт вернёт внятный код. Проверка делает реальную работу — getent идёт через NSS так же, как приложение, а pg_isready проверяет, что PostgreSQL принимает соединения, а не просто что порт открыт. И проверка не заменяет Restart=: если база пропадёт через час после старта, ExecStartPre уже ничем не поможет.
- ExecStartPre-ожидание — только с жёстким потолком через timeout
- проверять имя через getent и сервис через его клиент (pg_isready, nc -z для прочих портов)
- потолок ожидания меньше TimeoutStartSec= юнита
- для VPN — порядок относительно юнита туннеля плюс проверка порта за туннелем
- Restart=on-failure и RestartSec остаются обязательными
Мой порядок действий и на что можно забить
Приоритет первый, и он важнее всего остального в статье: сделайте службу устойчивой к недоступности БД. Это Restart=on-failure, RestartSec с бэкоффом и снятый лимит стартов — четыре строки в drop-in. Апстрим systemd говорит ровно то же самое: сервисы должны корректно переживать недоступность удалённых серверов и повторять попытки, а не рассчитывать на то, что сеть будет идеальна в момент старта. Эти четыре строки чинят не только медленную загрузку — они чинят и обрыв канала в три часа дня, и перезагрузку сервера БД, и перенос виртуалки между хостами. Ожидание сети не чинит ничего из этого списка.
Приоритет второй: проверьте, включена ли у вас служба ожидания, и настройте её прицельно, если сервису действительно нужен адрес на старте. Приоритет третий: добавьте After=nss-lookup.target, если работаете по именам, и проверьте резолвер. Всё остальное — по остаточному принципу.
Забить можно и нужно вот на что. На попытку найти в systemd цель, которая означает «удалённый сервис доступен», — такой цели нет и не будет, потому что systemd не знает вашей топологии. На ExecStartPre со sleep 30 — это работает ровно до дня, когда сеть поднимется за 35 секунд, и не работает никогда после; если без ожидания не обойтись, делайте его проверкой с потолком, как в разделе выше. На самописные скрипты с ping в цикле перед стартом: они дублируют логику ретрая, которая уже есть в systemd, и добавляют собственные баги. И на попытки поднять таймаут wait-online до нескольких минут, «чтобы точно»: вы просто меняете один класс инцидентов на другой, где сервер не загружается вовсе.
Полезная привычка напоследок: после любой правки этой цепочки делайте контрольную перезагрузку в окне и снимайте картинку загрузки. Три команды ниже дают всю фактуру для разговора и для отчёта — сколько заняло ожидание сети, что было в критической цепочке и как повёл себя сервис.
systemd-analyze blame | head -20
systemd-analyze critical-chain your-app.service
journalctl -b -u your-app.service -o short-precise- 1. Бэкофф и снятый лимит стартов в юните — четыре строки, чинят большинство случаев
- 2. Проверить и настроить службу wait-online под конкретный интерфейс
- 3. After=nss-lookup.target и проверка резолвера при работе по именам
- 4. Контрольный ребут в окне обслуживания и снятие systemd-analyze
- Не делать: sleep в ExecStartPre, ping-циклы, бесконечные таймауты ожидания
Частые вопросы
Я добавил Wants= и After=network-online.target, но ничего не изменилось. Почему?
Скорее всего, в системе не включена ни одна служба ожидания. Цель пассивная и сама ничего не ждёт — её удерживает systemd-networkd-wait-online.service или NetworkManager-wait-online.service. Проверьте: systemctl is-enabled systemd-networkd-wait-online.service NetworkManager-wait-online.service. Если обе disabled, цель достигается за десятки миллисекунд и ваша зависимость декоративна.
Можно ли поставить Requires=network-online.target вместо Wants=?
Технически можно, практически смысла нет. Сама цель тянет службу ожидания слабой зависимостью, поэтому при таймауте wait-online network-online.target всё равно будет достигнута — Requires= не защитит от раннего старта. Зато остановка цели потянет за собой и вашу службу. Апстрим рекомендует именно Wants= плюс After=, а устойчивость обеспечивается ретраями внутри юнита, а не силой зависимости.
Почему служба уходит в failed раньше, чем сеть успевает подняться?
Из-за дефолтов. RestartSec по умолчанию 100 мс, лимит стартов — 5 попыток за 10 секунд. Пять падений подряд укладываются меньше чем в секунду, и юнит получает start-limit-hit до того, как сеть заработает. Лечится строкой StartLimitIntervalSec=0 в секции [Unit] и внятным RestartSec=5, а на systemd 254 и новее — ещё RestartSteps= и RestartMaxDelaySec= для экспоненциального бэкоффа.
Как заставить wait-online дождаться именно рабочего интерфейса и не зависать на остальных?
Двумя способами сразу. В drop-in к systemd-networkd-wait-online.service указать --interface=<имя> и -o routable с разумным --timeout. И в .network-файлах пометить линки: RequiredForOnline=routable плюс RequiredFamilyForOnline=ipv4 на рабочем, RequiredForOnline=no на служебных и резервных. Тогда ожидание перестанет упираться в интерфейс, который в этой конфигурации адрес и не должен получать.
У меня NetworkManager, а не networkd. Что менять?
Рычагов меньше. Ожидание означает «NetworkManager закончил старт», то есть все профили и устройства перешли в активированное или отключённое состояние. Настраивается по сути только таймаут — через NM_ONLINE_TIMEOUT в drop-in к NetworkManager-wait-online.service (в апстримном юните 60 секунд) либо через -t у nm-online (у самой утилиты дефолт 30 секунд). Всё остальное решается ретраями в юните приложения.
Достаточно ли After=network-online.target, если приложение ходит в БД по DNS-имени?
Нет. Готовность интерфейсов и готовность разрешения имён — разные вещи. Добавьте After=nss-lookup.target (без Wants= — так велит документация) и проверьте резолвер: ls -l /etc/resolv.conf и resolvectl status. И проверьте кэш резолва в самом рантайме: приложение, один раз получившее отказ, может отдавать его из своего кэша ещё долго после того, как DNS заработал.
Нужно ли дописывать _netdev к NFS и CIFS в /etc/fstab?
Для nfs, nfs4 и cifs — не обязательно: systemd распознаёт их как сетевые по типу ФС и сам добавляет Wants= и After= на network-online.target. _netdev нужен, когда тип обычный локальный, а устройство сетевое, например ext4 на iSCSI. Гораздо важнее для шар поставить nofail и x-systemd.automount, чтобы недоступный NAS не задерживал загрузку.
Помогает ли ExecStartPre с ожиданием базы?
Помогает, если приложение при первой неудаче подключения не падает, а зависает в полурабочем состоянии. Делайте проверку с потолком: timeout 60 вокруг цикла с getent hosts и pg_isready (или nc -z для других портов), а TimeoutStartSec= юнита ставьте больше этого потолка. sleep 30 без проверки не помогает, и Restart=on-failure с RestartSec всё равно нужен на случай пропажи базы после старта.
Источники
- systemd upstream: Running Services After the Network Is Up — Официальный документ проекта systemd о network-online.target: рекомендованная связка Wants= и After=, тезис «network connectivity has been reached, not that it is currently available», автоматическое использование цели сетевыми монтированиями из /etc/fstab, рекомендации по устойчивости сервисов к смене сетевой конфигурации. https://systemd.io/NETWORK_ONLINE/
- systemd.special(7) — Раздел network-online.target с оговоркой «this unit is only useful during the original system start-up logic… it will not track the online state of the system anymore», а также network.target, network-pre.target и nss-lookup.target. https://man.archlinux.org/man/systemd.special.7
- systemd-networkd-wait-online.service(8) — Опции --interface=, --ignore=, --any, --timeout= (по умолчанию 120 с), -o/--operational-state= (по умолчанию degraded), --ipv4, --ipv6, --dns (ожидание доступности DNS-серверов на интерфейсе), шаблон systemd-networkd-wait-online@.service и описание поведения по умолчанию. https://man.archlinux.org/man/systemd-networkd-wait-online.service.8
- systemd.network(5) — Секция [Link]: RequiredForOnline= (булево, минимальное операционное состояние или диапазон; зависимость дефолта от ActivationPolicy=), дефолтный порог degraded, для bond/bridge — degraded-carrier; RequiredFamilyForOnline= (ipv4, ipv6, both, any; по умолчанию any). https://man.archlinux.org/man/systemd.network.5
- systemd.service(5) и systemd.unit(5) — RestartSec= (по умолчанию 100ms), RestartSteps= и RestartMaxDelaySec= (добавлены в systemd 254), Restart=on-failure, Type=notify; StartLimitIntervalSec= и StartLimitBurst= в секции [Unit]. https://man.archlinux.org/man/systemd.service.5 и https://man.archlinux.org/man/systemd.unit.5
- NetworkManager-wait-online.service(8) и nm-online(1) — «NetworkManager reports startup complete when all profiles and devices are either activated or in a disconnect state»; nm-online: -s/--wait-for-startup, -t/--timeout (по умолчанию 30 с или NM_ONLINE_TIMEOUT), коды возврата 0/1/2. В апстримном юните NetworkManager-wait-online.service задано NM_ONLINE_TIMEOUT=60. https://man.archlinux.org/man/nm-online.1 и https://github.com/NetworkManager/NetworkManager/blob/main/data/NetworkManager-wait-online.service.in
- systemd.mount(5) — Раздел об fstab: опции _netdev, nofail, x-systemd.automount, x-systemd.mount-timeout=; автоматические зависимости сетевых монтирований (After=remote-fs-pre.target и network.target, Wants=/After=network-online.target, Before=remote-fs.target). https://man.archlinux.org/man/systemd.mount.5