
ExecCondition вернул код 1: почему служба не запустилась, но systemd не считает её упавшей
Ночной выгрузки бэкапа нет одиннадцать суток, а systemctl status по службе показывает бодрое inactive (dead), ни одного failed. Никто не звонил, мониторинг молчал, в журнале — короткая запись про skipped. Так выглядит правильно понятая, но неправильно применённая директива ExecCondition=. Ниже — что именно systemd делает с кодом возврата проверочного скрипта, чем «отказ от запуска» отличается от аварии, как писать сам скрипт, чтобы случайная ошибка curl не притворялась штатным пропуском, и как ловить такие пропуски мониторингом.
Что на самом деле делает ExecCondition= с кодом возврата
Директива ExecCondition= появилась в systemd 243 и живёт в секции [Service]. Её команды выполняются раньше всего остального — до ExecStartPre=, до ExecStart=. Синтаксис тот же, что у ExecStart=, команд может быть несколько, они идут последовательно. Мануал systemd.service(5) описывает поведение буквально как гибрид ExecStartPre= и проверки условия: когда команда ExecCondition= завершается с кодом от 1 до 254 включительно, оставшиеся команды пропускаются, а юнит не помечается как failed. Если команда вернула 255 или завершилась аномально (таймаут, убита сигналом), юнит считается упавшим. Код 0 или код, перечисленный в SuccessExitStatus=, разрешает продолжить запуск.
Разложу это в таблицу, потому что именно здесь у людей ломается модель. Три разных исхода, а не два — и в этом вся соль. У обычного ExecStartPre= исходов ровно два: ноль — продолжаем, что угодно другое — юнит в failed. У ExecCondition= посередине появляется третий, «тихий» исход, ради которого директива и создавалась.
Внутри systemd этот исход — отдельное значение результата. В исходниках есть enum ServiceResult, и рядом с SERVICE_FAILURE_EXIT_CODE, SERVICE_FAILURE_TIMEOUT, SERVICE_FAILURE_SIGNAL там лежит SERVICE_SKIP_CONDITION. Не разновидность провала, а самостоятельная категория. Поэтому снаружи вы увидите Result=exec-condition, состояние inactive (dead), а вовсе не failed. И — важное следствие — задание, которое запускало службу, завершается успешно: в unit.c при переходе юнита в inactive стартовое задание закрывается как JOB_DONE, а как JOB_FAILED — только если юнит ушёл в failed. Отсюда штука, которая обычно и обманывает скрипты обвязки:
Как это выглядит глазами. В systemctl status юнит показывает Active: inactive (dead), а строка Process: ... ExecCondition=/usr/local/sbin/check-master.sh (code=exited, status=1/FAILURE) подсвечена красным — это единственный визуальный след. В журнале по умолчанию остаётся одна строка уровня info: «pgdump-offsite.service: Skipped due to 'exec-condition'.». Сообщение «Condition check process exited, code=exited, status=1/FAILURE» systemd для пропуска пишет на уровне debug, поэтому без повышенного LogLevel вы его не увидите. Для сравнения, упавший ExecStartPre= даёт в журнале notice о выходе процесса и строку «Failed with result 'exit-code'.», а юнит — в failed.
systemctl start pgdump-offsite.service; echo $?
# 0 — даже если ExecCondition вернул 1 и служба ничего не сделала

systemctl is-failed pgdump-offsite.service; echo $?
# inactive
# 1  — то есть «не упала», формально всё хорошо

systemctl show -p Result -p ActiveState -p ExecCondition pgdump-offsite.service
# Result=exec-condition
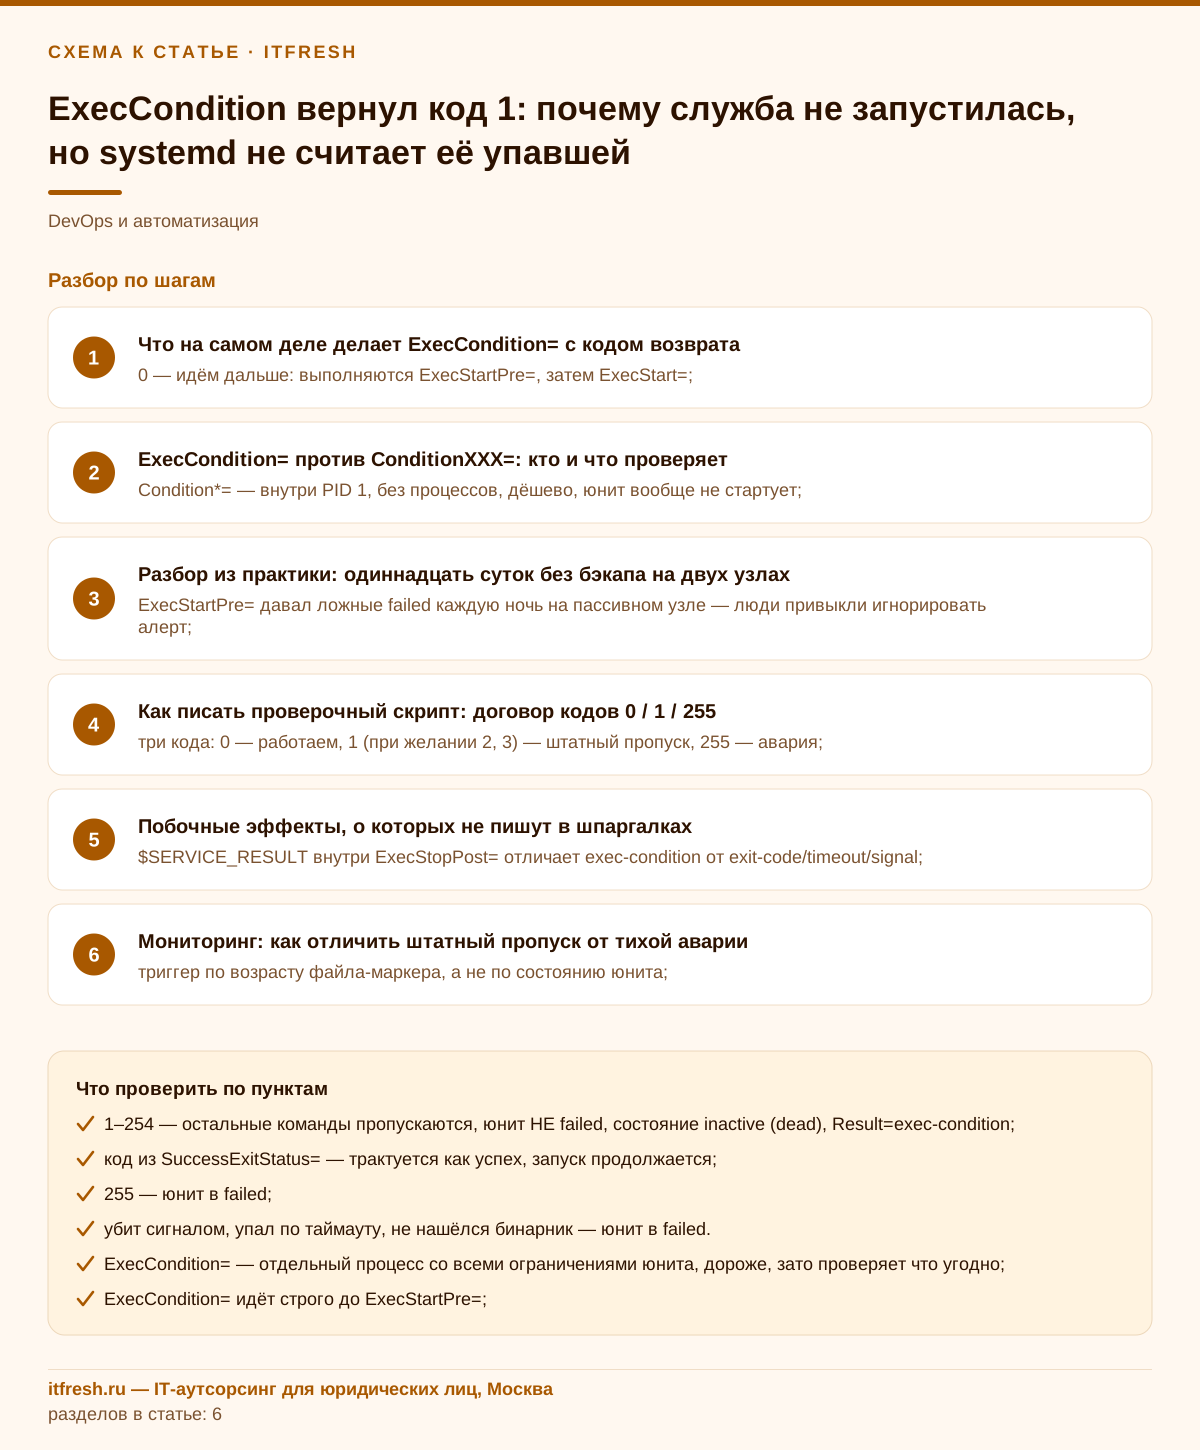
# ActiveState=inactive- 0 — идём дальше: выполняются ExecStartPre=, затем ExecStart=;
- 1–254 — остальные команды пропускаются, юнит НЕ failed, состояние inactive (dead), Result=exec-condition;
- код из SuccessExitStatus= — трактуется как успех, запуск продолжается;
- 255 — юнит в failed;
- убит сигналом или упал по таймауту — юнит в failed; а вот отсутствующий бинарник даёт код 203/EXEC, он попадает в 1–254 и превращается в тихий пропуск.
ExecCondition= против ConditionXXX=: кто и что проверяет
В systemd есть два принципиально разных механизма условного запуска, и их регулярно смешивают в одну кучу. Первый — семейство ConditionPathExists=, ConditionPathIsMountPoint=, ConditionHost=, ConditionKernelCommandLine= и десяток их родственников из секции [Unit]. Их вычисляет сам PID 1, внутри себя, без порождения процессов. Это дёшево, это быстро, это выполняется ещё до того, как systemd вообще решит запускать команды. Второй — ExecCondition= из [Service]: это форк, exec, отдельный процесс со всей вашей обвязкой — cgroup, namespace, User=, ProtectSystem=, окружение. Дороже на порядки, зато вы можете проверить что угодно: ответ API, флаг в базе, состояние кластера, наличие свежего файла на удалённой шаре.
Практический вывод простой: если условие выражается штатным Condition*=, берите Condition*=. Я не пишу ExecCondition=/usr/bin/test -e /mnt/arc/flag, когда есть ConditionPathExists=/mnt/arc/flag. Разница ещё и в наблюдаемости: несработавший Condition*= даёт в журнале строку про unmet condition и юнит вообще не начинает стартовать, а несработавший ExecCondition= — уже полноценный запуск с порождением процесса, cgroup и записью в журнал. И да, начиная с 250–251 систему специально приводили в порядок в части того, что именно транслируется наружу по D-Bus как «skipped»: в анонсе systemd 251 отдельно отмечено, что задания, запущенные через StartUnitWithFlags(), больше не возвращают skipped при несработавшем Condition*=, — сигнал JobRemoved вернули к поведению до v250. Если ваша автоматизация опирается на эти сигналы, версия систем важна.
Второе отличие — порядок. ExecCondition= выполняется перед ExecStartPre=, и это ровно то, чего ждёшь. А вот дальше начинается неочевидное: мануал прямо предупреждает, что при любом ненулевом или аномальном выходе ExecCondition= будут выполнены команды ExecStopPost=, как часть остановки службы. То есть ваш «постскрипт», который отправляет уведомление в Telegram или чистит временные файлы, отработает и на штатном пропуске тоже. Я на этом обжигался: в ExecStopPost= висел алерт «задача завершилась», и он честно приходил каждую ночь с резервного узла, где условие штатно не выполнялось.
Третье — те же рекомендации, что и для ExecStartPre=: не запускайте здесь долгоживущие процессы. ExecCondition= укладывается в общий бюджет TimeoutStartSec=, и если проверка ушла в сеть без таймаута и повисла — юнит уедет в failed по таймауту, то есть в тот самый исход, которого вы избегали.
- Condition*= — внутри PID 1, без процессов, дёшево, юнит вообще не стартует;
- ExecCondition= — отдельный процесс со всеми ограничениями юнита, дороже, зато проверяет что угодно;
- ExecCondition= идёт строго до ExecStartPre=;
- любой ненулевой/аномальный выход ExecCondition= тянет за собой ExecStopPost=;
- проверка считается в TimeoutStartSec= — вешать в ней сетевые ожидания без таймаута нельзя.
Разбор из практики: одиннадцать суток без бэкапа на двух узлах
Рекрутинговая компания, назову её «Найм Профи», 13 рабочих мест, один офис, у нас на обслуживании. Вся работа держится на базе кандидатов и вакансий, поэтому под неё стоят два небольших одинаковых узла Debian 13 (systemd 257), PostgreSQL 17 с потоковой репликацией и плавающий адрес на keepalived. Ночью в 01:30 по таймеру запускается pgdump-offsite.service: делает дамп, шифрует и укладывает во внешнее хранилище. Задача должна выполняться только на текущем мастере — иначе два узла одновременно пишут в одно место и ломают ретеншен.
До нас это было сделано через ExecStartPre= со скриптом check-master.sh. Логика верная, поведение — нет: на резервном узле каждую ночь юнит уходил в failed, в Zabbix прилетал алерт, администратор закрывал его руками. За полгода мы научились закрывать этот алерт не глядя. Классическая усталость от ложных срабатываний. Переписали на ExecCondition= — алерты ушли, все довольны. Ровно до того дня, когда бэкапы перестали делаться совсем.
Что произошло. Скрипт проверки был написан так:
#!/bin/bash
set -euo pipefail

vip=$(curl -s --max-time 5 http://10.20.0.9:8500/v1/kv/db/master?raw)
[ "$vip" = "$(hostname -f)" ]
На резервном узле последняя строка даёт код 1 — штатный пропуск, всё как задумано. А потом в сети переехал DNS-резолвер, curl начал возвращать код 6 (couldn't resolve host), set -e честно завершал скрипт с кодом 6, и systemd видел «код в диапазоне 1–254» — то есть тот же самый штатный пропуск. На обоих узлах. Каждую ночь. Одиннадцать суток подряд юнит аккуратно писал в журнал строку «Skipped due to 'exec-condition'.», оставался в inactive (dead), таймер спокойно планировал следующий запуск, и ни один из наших триггеров, заточенных на systemctl is-failed, ничего не заметил. Обнаружили случайно, при плановой проверке восстановления: последний рабочий архив базы кандидатов оказался двухнедельной давности — для компании, у которой каждый день в работе десятки откликов, это потерянная неделя переписки с соискателями, если бы пришлось восстанавливаться.
Разбор был коротким. Виноват не systemd — он сделал ровно то, что написано в мануале. Виноват договор кодов, которого не было: скрипт использовал «любой ненулевой код» как «не мастер», а любая внутренняя поломка выглядела так же. Починили за час, и с тех пор ни одного незамеченного пропуска.
- ExecStartPre= давал ложные failed каждую ночь на пассивном узле — люди привыкли игнорировать алерт;
- переход на ExecCondition= убрал шум, но убрал заодно и настоящую аварию;
- код 6 от curl попал в диапазон 1–254 и был истолкован как штатный пропуск;
- мониторинг смотрел на is-failed, а не на «когда последний раз реально отработало»;
- нашли не по алерту, а на плановой проверке восстановления.
Как писать проверочный скрипт: договор кодов 0 / 1 / 255
Правило, к которому мы пришли и которое я теперь ставлю всем: у скрипта ровно три легальных кода выхода, и они описаны в комментарии в его же шапке. 0 — условие выполнено, запускаемся. 1 — условие осознанно не выполнено, это норма, пропускаем. 255 — сама проверка не смогла дать ответ; это авария, юнит должен уйти в failed и разбудить дежурного. Всё остальное — недопустимо, и скрипт обязан сам это исключить.
На bash это делается ловушкой. set -euo pipefail оставляем, но добавляем trap, который любой неожиданный выход превращает в 255. Плюс явные таймауты на всё, что ходит в сеть: и на уровне утилиты, и снаружи через timeout, потому что зависшая проверка съест TimeoutStartSec= юнита и всё равно приведёт к failed, только через минуту-полторы простоя.
#!/bin/bash
# 0   — этот узел мастер, работаем
# 1   — этот узел не мастер, штатный пропуск
# 255 — проверка сломалась, это авария
set -euo pipefail
trap 'exit 255' ERR

me=$(hostname -f)
master=$(timeout 8 curl -sf --max-time 5 \
         http://10.20.0.9:8500/v1/kv/db/master?raw) || exit 255
[ -n "$master" ] || exit 255

if [ "$master" = "$me" ]; then
  exit 0
else
  echo "Не мастер (мастер: $master), пропускаю" >&2
  exit 1
fi
Сам юнит после этого выглядит скучно — и это хорошо. Обратите внимание на два момента: команда ExecCondition= не префиксуется дефисом (префикс — игнорирует код возврата и убивает весь смысл директивы), и путь к скрипту абсолютный, потому что PATH внутри юнита не тот, к которому вы привыкли в интерактивной оболочке. И проверьте, что файл действительно существует: если бинарника нет или у него нет права на исполнение, процесс завершается с кодом 203/EXEC, а он, по логике service.c, попадает в диапазон пропуска — опечатка в пути превратится не в failed, а в вечный тихий skip.
[Unit]
Description=Выгрузка дампа PostgreSQL во внешнее хранилище
After=network-online.target postgresql.service
Wants=network-online.target

[Service]
Type=oneshot
User=pgbackup
TimeoutStartSec=45min
ExecCondition=/usr/local/sbin/check-master.sh
ExecStart=/usr/local/sbin/pgdump-offsite.sh
SyslogIdentifier=pgdump-offsite
Если у вашей проверки семантически осмысленных исходов больше двух — например, «мастер», «реплика» и «идёт плановое обслуживание, тоже пропускаем», — не изобретайте флаг-файлы: просто разведите коды 1 и 2 и оба оставьте в диапазоне пропуска. А если какой-то ненулевой код, наоборот, должен означать «всё в порядке, продолжаем», для этого есть SuccessExitStatus= — коды из этого списка ExecCondition= трактует наравне с нулём. Только помните, что SuccessExitStatus= действует и на основной процесс службы тоже, так что не пишите туда лишнего.
- три кода: 0 — работаем, 1 (при желании 2, 3) — штатный пропуск, 255 — авария;
- trap 'exit 255' ERR — обязателен, иначе случайный код 6 от curl станет пропуском;
- timeout на каждой сетевой операции: зависшая проверка = failed по TimeoutStartSec=;
- никакого префикса — перед командой ExecCondition=;
- абсолютные пути, скрипт с chmod 0755 и владельцем root;
- проверять поведение до боя: systemd-analyze verify и ручной прогон скрипта с echo $?.
Побочные эффекты, о которых не пишут в шпаргалках
Первый — ExecStopPost=. Повторю, потому что это стоило нам ночных уведомлений: любой ненулевой или аномальный выход ExecCondition= запускает команды ExecStopPost=. Штатный пропуск с кодом 1 — тоже ненулевой выход. Если у вас там уведомление или запись в учётную систему «задача отработала», оно поедет каждый раз при пропуске. Лечится либо переносом логики в конец ExecStart=, либо анализом переменной $SERVICE_RESULT внутри самого ExecStopPost=-скрипта: при пропуске там будет exec-condition, а при настоящем провале — exit-code, timeout, signal или core-dump. Оговорка: в таблице значений $SERVICE_RESULT в man systemd.exec строки exec-condition нет, но переменная заполняется из того же поля Result, что показывает systemctl show, — перед тем как опираться на это в бою, один раз проверьте на своей версии.
Второй — взаимодействие с Restart=. Тут важна версия. До systemd 251 служба с Restart=always после несработавшего ExecCondition= перезапускалась, и вы получали бесконечный цикл: проверка говорит «не надо», systemd поднимает снова, проверка снова говорит «не надо». В 251 это исправили, приведя поведение ExecCondition= в соответствие с Condition*=. Если вы работаете на чём-то старее — Ubuntu 20.04 (systemd 245), Debian 11 (247) — не сочетайте ExecCondition= с Restart=always. Для разовых задач по расписанию я в принципе держу Type=oneshot без Restart=, и вопрос снимается.
Третий — таймеры. Пропущенный запуск не ломает расписание: юнит не в failed, таймер продолжает работать штатно и в следующий раз попробует снова. Это ровно то поведение, которого от механизма и ждут, и это главный аргумент в пользу ExecCondition= против «проверка внутри ExecStart= с exit 0» — во втором случае вы теряете различие между «сделал» и «не стал делать» уже на уровне systemd.
Типичный пример, который мы ставим клиентам: ночной таймер копирования на NAS. Если NAS выключен на обслуживание или не отвечает сеть — запуск надо пропустить, а не устраивать ложную аварию; если же сломалась сама проверка — нужен failed. Скрипт проверки при этом держим в том же договоре 0/1/255, адрес NAS — из документационного диапазона для примера:
#!/bin/bash
# /usr/local/sbin/check-nas.sh
# 0 — NAS доступен и смонтирован, 1 — NAS недоступен (пропуск), 255 — авария проверки
trap 'exit 255' ERR
NAS=203.0.113.20
MNT=/mnt/nas-backup

if ! timeout 5 ping -c1 -W2 "$NAS" >/dev/null 2>&1; then
  echo "NAS $NAS не отвечает, пропускаю" >&2
  exit 1
fi
mountpoint -q "$MNT" || { echo "$MNT не смонтирован" >&2; exit 255; }
exit 0
# nas-backup.service
[Service]
Type=oneshot
TimeoutStartSec=2h
ExecCondition=/usr/local/sbin/check-nas.sh
ExecStart=/usr/local/sbin/nas-backup.sh
# nas-backup.timer
[Timer]
OnCalendar=*-*-* 02:00
Persistent=true
[Install]
WantedBy=timers.targetЧетвёртый — версии и переносимость. ExecCondition= добавлена в 243, и на старых базах её просто нет: в RHEL-семействе 8 (AlmaLinux 8, Rocky 8, CentOS Stream 8) базовая версия systemd — 239, в Debian 10 — 241. Директива в таком юните будет проигнорирована с руганью в журнале, а служба запустится безусловно — то есть отказ произойдёт в самую опасную сторону. На всём современном парке проблем нет: Debian 12 — 252, Debian 13 — 257, RHEL 9 / AlmaLinux 9 — 252, CentOS Stream 10 — 257, в апстриме к осени 2026 уже 261-я ветка. Но перед раскаткой на зоопарк прогоняйте systemd-analyze verify на каждой платформе — это пять секунд и ноль сюрпризов.
- $SERVICE_RESULT внутри ExecStopPost= отличает exec-condition от exit-code/timeout/signal;
- Restart=always + ExecCondition= до systemd 251 — цикл перезапусков;
- таймер после пропуска работает штатно, расписание не сбивается;
- systemd < 243 (EL8, Debian 10) директиву не знает — служба стартанёт без проверки;
- systemd-analyze verify /путь/к/юниту.service перед раскаткой на разнородный парк.
Мониторинг: как отличить штатный пропуск от тихой аварии
Главный вывод из истории «Найм Профи» — не в юните, а в мониторинге. Проверка вида systemctl is-failed по списку служб для задач с ExecCondition= бесполезна: пропущенный юнит никогда не будет failed, это его штатное состояние. Нужны два независимых сигнала. Первый — сам факт, что где-то в кластере задача выполнилась. Второй — что суммарное число пропусков не выходит за ожидаемое.
Первый сигнал я делаю проще всего: успешный ExecStart= в конце трогает файл-маркер (или пишет метку в общее хранилище), а мониторинг смотрит на возраст этого маркера. Не «служба не упала», а «свежий бэкап есть». Такой триггер невозможно обмануть ни пропуском, ни кодом 6 от curl, ни выключенным таймером — он проверяет результат, а не процесс. Порог ставим с запасом на одну итерацию: для ночной задачи — 30 часов.
Второй сигнал — разбор журнала. Пропуски видно и глазами, и машинно:
# что происходило с юнитом за сутки
journalctl -u pgdump-offsite.service --since -24h -o short-iso

# машинно-читаемый итог последнего запуска
systemctl show -p Result -p ExecMainStatus \
  -p InactiveEnterTimestamp pgdump-offsite.service

# отдельный элемент Zabbix: 1 — был штатный пропуск, 0 — не было
journalctl -u pgdump-offsite.service --since -25h --no-pager \
  | grep -ci "exec-condition"
И третий приём, который я советую всем, у кого задача ходит по нескольким узлам: считайте пропуски по кластеру. Из двух узлов ровно один должен отработать и ровно один — пропустить. Два пропуска за ночь означают, что не отработал никто, даже если формально «ни одна служба не упала». Этот триггер у «Найм Профи» и стоит сейчас, и именно он ловит ситуации, когда проверка врёт одинаково на обоих узлах.
- триггер по возрасту файла-маркера, а не по состоянию юнита;
- отдельный счётчик пропусков по grep exec-condition в журнале;
- проверка «в кластере из N узлов пропусков ровно N-1»;
- плановая проверка восстановления раз в месяц — она ловит то, что не поймал мониторинг;
- алерт на Result=exec-condition там, где пропуск в принципе не предусмотрен.
Когда ExecCondition= не нужен вообще
Скажу прямо: в половине случаев, где я вижу ExecCondition=, он там лишний. Условие «есть ли смонтированный том» закрывается ConditionPathIsMountPoint=. «Только на этой машине» — ConditionHost=. «Только на железе, не в контейнере» — ConditionVirtualization=. «Только если файл-флаг на месте» — ConditionPathExists=. Всё это вычисляет PID 1, без форка, без скрипта, который надо сопровождать и который однажды сломается. Начинайте с них.
Второй случай, когда директива не нужна, — когда «пропуск» на самом деле не пропуск, а нормальная часть работы задачи. Если ваш скрипт умеет сам корректно отработать вхолостую и завершиться с нулём, оставьте это внутри ExecStart=. ExecCondition= нужен ровно тогда, когда вам важно, чтобы systemd знал: запуска не было, ExecStart= не выполнялся вовсе. Это принципиально в двух ситуациях — когда ExecStart= тяжёлый и его нельзя запускать вхолостую, и когда вы строите отчётность по факту запусков.
И честно про спорное. Я знаю коллег, которые вообще не используют ExecCondition=, а всю развилку держат в скрипте с кодом 0 и подробным логом, — аргумент у них тот, что единая точка правды в одном bash-файле проще в сопровождении, чем размазанная по юниту и скрипту логика. Возразить нечему: для одиночного сервера с двумя задачами это рабочая позиция. Разница проявляется на масштабе — когда служб десятки, узлов несколько, а вопрос «эта задача сегодня отработала или сознательно пропустила?» надо задавать не человеку, а машине. Тогда третье состояние в systemd начинает окупаться.
Приоритеты, если начинать прямо сейчас: сначала пройдитесь по юнитам, где стоит ExecCondition=, и проверьте коды возврата скриптов на сломанном сценарии — это ловит настоящие тихие аварии. Потом переведите мониторинг с состояния юнита на возраст результата. Потом уже вычищайте ExecCondition= там, где хватает Condition*=. На последнее можно и забить — работать будет, просто чуть дороже.
- ConditionPathExists= / ConditionPathIsMountPoint= — вместо test -e и mountpoint;
- ConditionHost=, ConditionVirtualization=, ConditionKernelCommandLine= — вместо hostname и grep по /proc;
- AssertXXX= — если несоблюдение условия должно быть именно аварией, а не пропуском;
- обычный ExecStart= с внутренней развилкой — для одиночных серверов и простых задач;
- ExecCondition= — когда нужно, чтобы факт «запуска не было» видел сам systemd.
Частые вопросы
Почему systemctl status показывает inactive (dead), а не failed, хотя служба ничего не сделала?
Потому что так задумано. Код возврата ExecCondition= в диапазоне 1–254 означает «условие не выполнено», и мануал systemd.service(5) прямо говорит: оставшиеся команды пропускаются, а юнит не помечается как failed. Внутри systemd это отдельный результат SERVICE_SKIP_CONDITION, снаружи он виден как Result=exec-condition. Failed вы получите только при коде 255 или аномальном завершении — таймауте или убийстве сигналом. А вот отсутствующий или неисполняемый скрипт проверки даёт код 203/EXEC и тоже считается пропуском, так что опечатка в пути не вызовет failed.
Как отличить штатный пропуск от того, что сам проверочный скрипт сломался?
Только договором кодов, systemd сам этого не различает. Заведите правило: 0 — работаем, 1 — осознанный пропуск, 255 — проверка не смогла дать ответ. В bash-скрипте это делается через set -euo pipefail плюс trap 'exit 255' ERR и явный || exit 255 на сетевых вызовах. Без этого любая случайная ошибка утилиты (например, код 6 у curl при проблеме с DNS) попадёт в диапазон 1–254 и будет истолкована как нормальный пропуск.
Почему мой ExecStopPost= срабатывает даже тогда, когда служба просто пропустила запуск?
Так описано в мануале: ExecCondition= при любом ненулевом или аномальном выходе запускает команды ExecStopPost= как часть остановки службы. Штатный пропуск с кодом 1 — тоже ненулевой выход. Если в ExecStopPost= у вас уведомление, добавьте внутрь проверку переменной $SERVICE_RESULT: при пропуске там будет exec-condition, при настоящем провале — exit-code, timeout, signal или core-dump.
Можно ли использовать ExecCondition= вместе с Restart=always?
На systemd 251 и новее — да, поведение привели в соответствие с Condition*=, и служба после несработавшей проверки не перезапускается. На версиях 243–250 (это Debian 11 с 247 и Ubuntu 20.04 с 245) вы получите бесконечный цикл перезапусков. Для задач по расписанию я в любом случае предпочитаю Type=oneshot без Restart= и таймер сверху.
Что делать, если на сервере systemd старее 243 и ExecCondition= там нет?
Не полагаться на директиву: она будет проигнорирована с сообщением в журнале, а служба запустится безусловно — то есть отказ произойдёт в опасную сторону. Это касается AlmaLinux/Rocky/CentOS Stream 8 (systemd 239) и Debian 10 (241). Варианты: перенести развилку внутрь ExecStart= с корректным нулевым кодом, использовать штатные ConditionXXX= из секции [Unit] или обновить платформу. Перед раскаткой на разнородный парк прогоняйте systemd-analyze verify.
Как мониторить задачи с ExecCondition=, если systemctl is-failed на них не срабатывает?
Мониторить нужно результат, а не состояние юнита. Практически: успешный ExecStart= трогает файл-маркер или пишет метку в хранилище, а триггер смотрит на возраст этой метки с запасом на одну итерацию расписания. Дополнительно заведите счётчик строк exec-condition в журнале за сутки: в кластере из двух узлов пропусков должно быть ровно один, два пропуска означают, что задача не выполнилась нигде.
Как настроить пропуск ночного бэкапа, если NAS недоступен, и не потерять настоящие аварии?
Поставьте в сервис бэкапа ExecCondition= со скриптом, который возвращает 1, когда NAS не отвечает (штатный пропуск, таймер спокойно отработает в следующую ночь), и 255, когда что-то сломано в самой проверке — например, NAS пингуется, но том не смонтирован. Параллельно мониторьте возраст последней успешной копии: несколько пропусков подряд из-за выключенного NAS — это тоже инцидент, хотя юнит ни разу не будет failed.
Источники
- systemd.service(5), ExecCondition= — Официальный мануал freedesktop.org: коды 1–254 — оставшиеся команды пропускаются, юнит не failed; 255 или аномальный выход (таймаут, сигнал) — failed; 0 и SuccessExitStatus= — продолжение; выполнение перед ExecStartPre=; запуск ExecStopPost= при ненулевом выходе; «Added in version 243»: https://www.freedesktop.org/software/systemd/man/latest/systemd.service.html
- systemd NEWS, CHANGES WITH 251 — «Services with Restart=always and a failing ExecCondition= will no longer be restarted, to bring ExecCondition= behaviour in line with Condition*= settings» и возврат сигнала JobRemoved для StartUnitWithFlags() к поведению до v250: https://github.com/systemd/systemd/blob/main/NEWS
- LWN.net: Systemd 251 released — Анонс релиза systemd 251 с полным списком изменений: https://lwn.net/Articles/896043/
- Исходный код systemd, src/core/service.c и service.h — ServiceResult с отдельным SERVICE_SKIP_CONDITION («exec-condition»); в service_sigchld_event выход ExecCondition= с кодом <255 превращается в пропуск, при пропуске Restart= не применяется: https://github.com/systemd/systemd/blob/main/src/core/service.c
- Исходный код systemd, src/core/unit.c — unit_log_skip пишет «Skipped due to '%s'.»; стартовое задание закрывается как JOB_FAILED только при UNIT_FAILED, иначе JOB_DONE: https://github.com/systemd/systemd/blob/main/src/core/unit.c
- systemd.exec(5), $SERVICE_RESULT — Переменные окружения ExecStop=/ExecStopPost=: $SERVICE_RESULT, $EXIT_CODE, $EXIT_STATUS: https://www.freedesktop.org/software/systemd/man/latest/systemd.exec.html
- Debian Packages: systemd — Версии в дистрибутиве: bullseye — 247.3, bookworm — 252.39, trixie — 257.13: https://packages.debian.org/trixie/systemd