
Свой ИИ-сервер для компании вместо облачных нейросетей: что реально работает на двух RTX 3090
Каждый раз, когда сотрудник вставляет договор в облачный чат-бот, ваша компания добровольно сливает данные. Свой ИИ-сервер прекращает это навсегда. Каждый запрос в облачную нейросеть — это документ компании, отправленный на чужой сервер, по чужим правилам и с чужими лимитами. Свой ИИ-сервер для компании меняет это: языковая модель, поиск по внутренним документам, расшифровка совещаний и генерация изображений работают на вашем железе, а данные никуда не уходят. Рассказываем, что на самом деле работает на сервере с двумя RTX 3090, который мы эксплуатируем каждый день, и где на этом пути грабли.
Облачный ИИ — это утечка по расписанию
Сотрудник вставляет в облачный чат договор, чтобы найти рискованные пункты. Бухгалтер загружает выписку, чтобы разобрать расходы. Менеджер отдаёт запись звонка на расшифровку. Каждое такое действие отправляет данные компании провайдеру нейросети — с его политикой хранения, его юрисдикцией и его лимитами. Запретить сотрудникам пользоваться ИИ уже невозможно; можно только дать им свой.
Свой ИИ-сервер — это не исследовательская лаборатория. Это обычный сервер с видеокартами, на котором работают проверенные открытые модели. Ниже — как он устроен у нас.
И главное отличие от облака: когда у облачного провайдера ИИ авария или новые ограничения, ваши процессы встают. Свой сервер работает, пока работает ваше электричество и ваш канал.
Утечка, которую вы оплачиваете сами
Запретить сотрудникам пользоваться нейросетями уже невозможно — они слишком полезны. Значит, они уже сейчас отправляют в чужие облака договоры, выписки, переписку и код. Вы не знаете, что именно, сколько и куда. Это не паранойя — это ежедневная практика большинства офисов.
Единственный способ остановить это — дать сотрудникам свой ИИ, который работает внутри компании. Не хуже облачного для рабочих задач и без единого байта наружу. Ниже — как он устроен у нас, со всеми цифрами и ошибками.
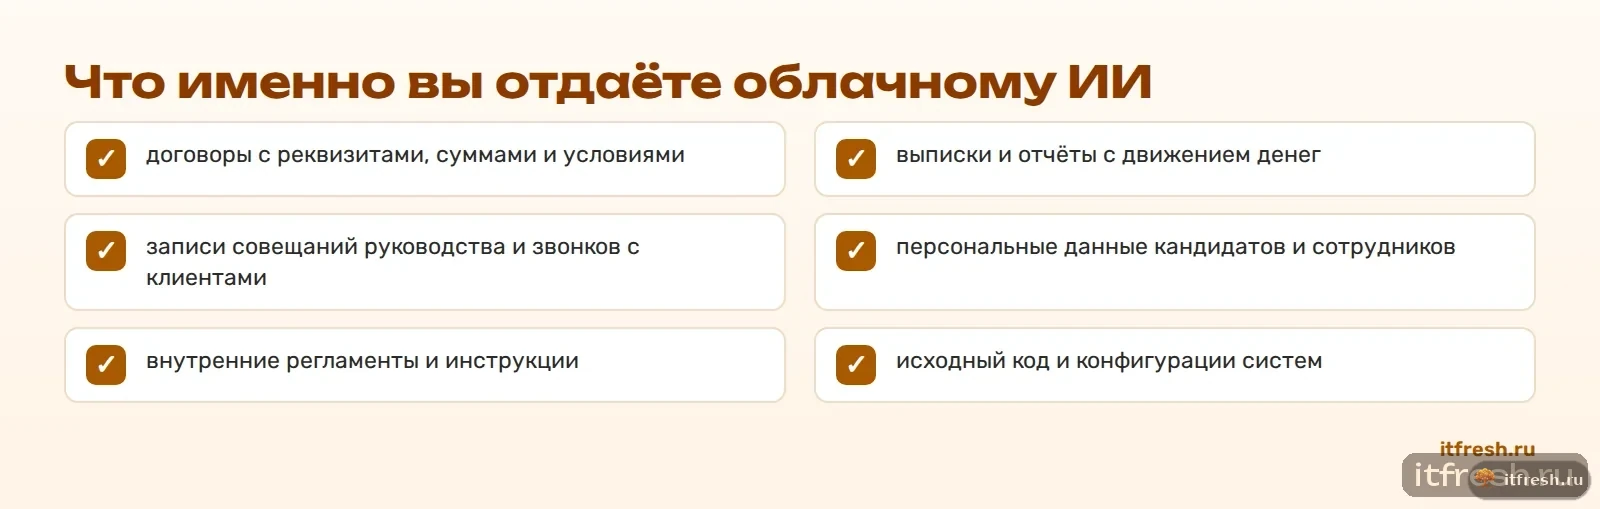
Что именно вы отдаёте облачному ИИ
Если посмотреть на типичное использование нейросетей в офисе, список того, что уходит наружу, впечатляет.
- договоры с реквизитами, суммами и условиями
- выписки и отчёты с движением денег
- записи совещаний руководства и звонков с клиентами
- персональные данные кандидатов и сотрудников
- внутренние регламенты и инструкции
- исходный код и конфигурации систем
Железо
Две видеокарты RTX 3090 по 24 ГБ видеопамяти, 64 процессорных ядра, около 500 ГБ оперативной памяти, два пула ZFS: рабочий на 3,6 ТБ и пул резервных копий на 9 ТБ. Видеокарты — потребительские, не серверные: это сильно дешевле, а для моделей среднего размера 48 ГБ суммарной видеопамяти хватает. Большой объём оперативной памяти нужен для расшифровки на процессоре, баз данных и кэшей.
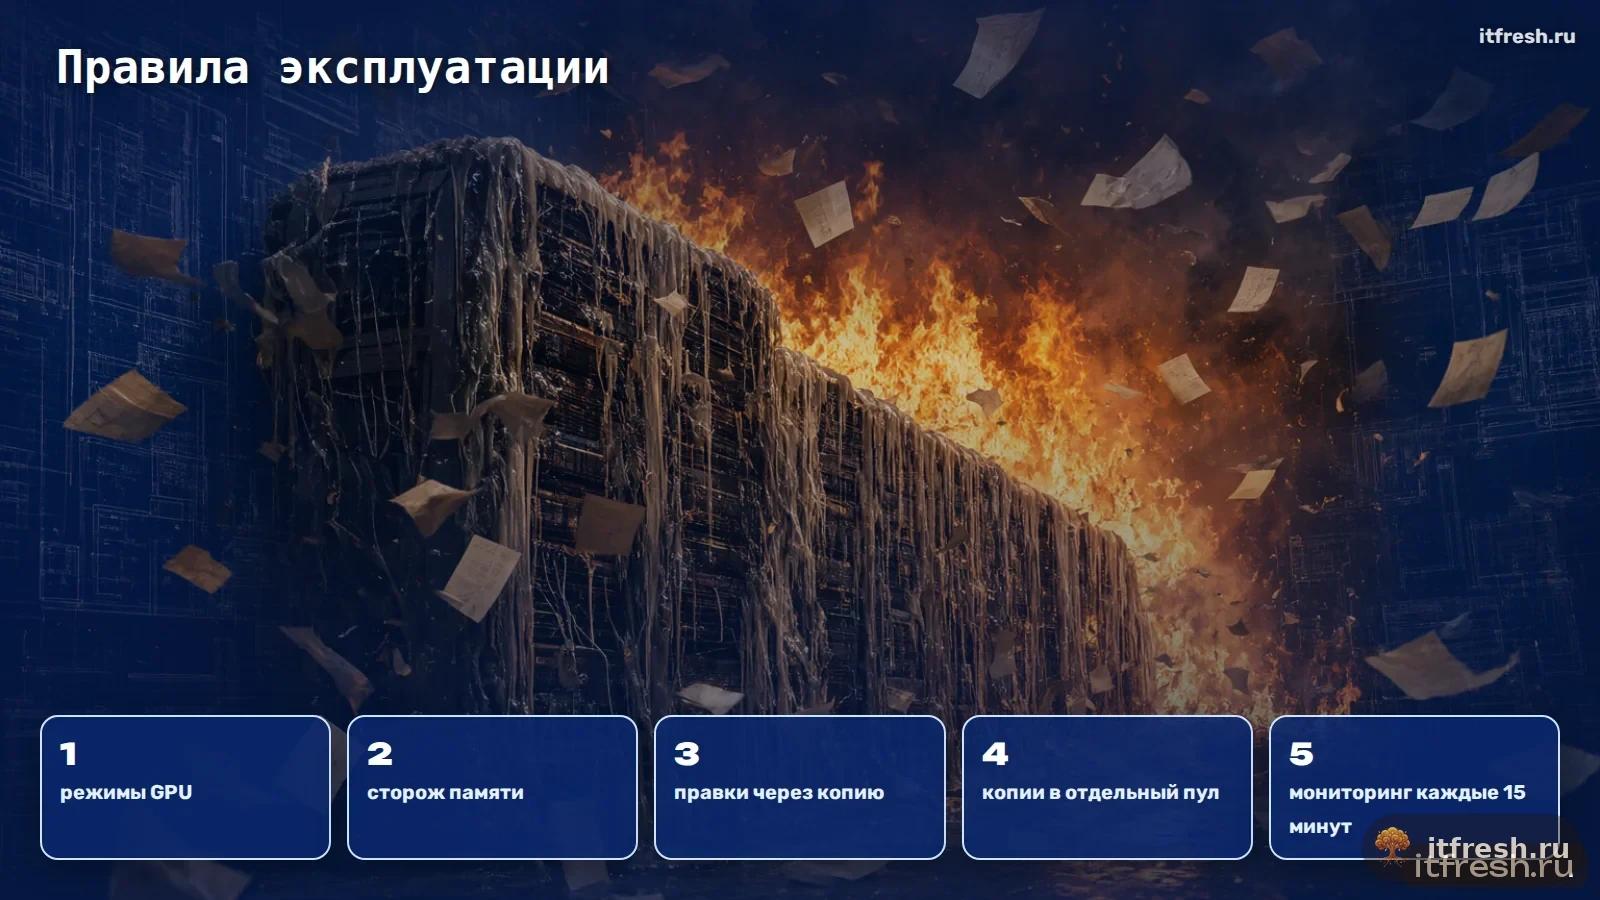
Главный урок по железу: оперативной памяти много не бывает. Однажды задача обработки чертежей в 24 параллельных процессах съела всю память, и сервер завис до аппаратной перезагрузки. После этого на сервере работает сторож, который не даёт свободной памяти опуститься ниже порога.
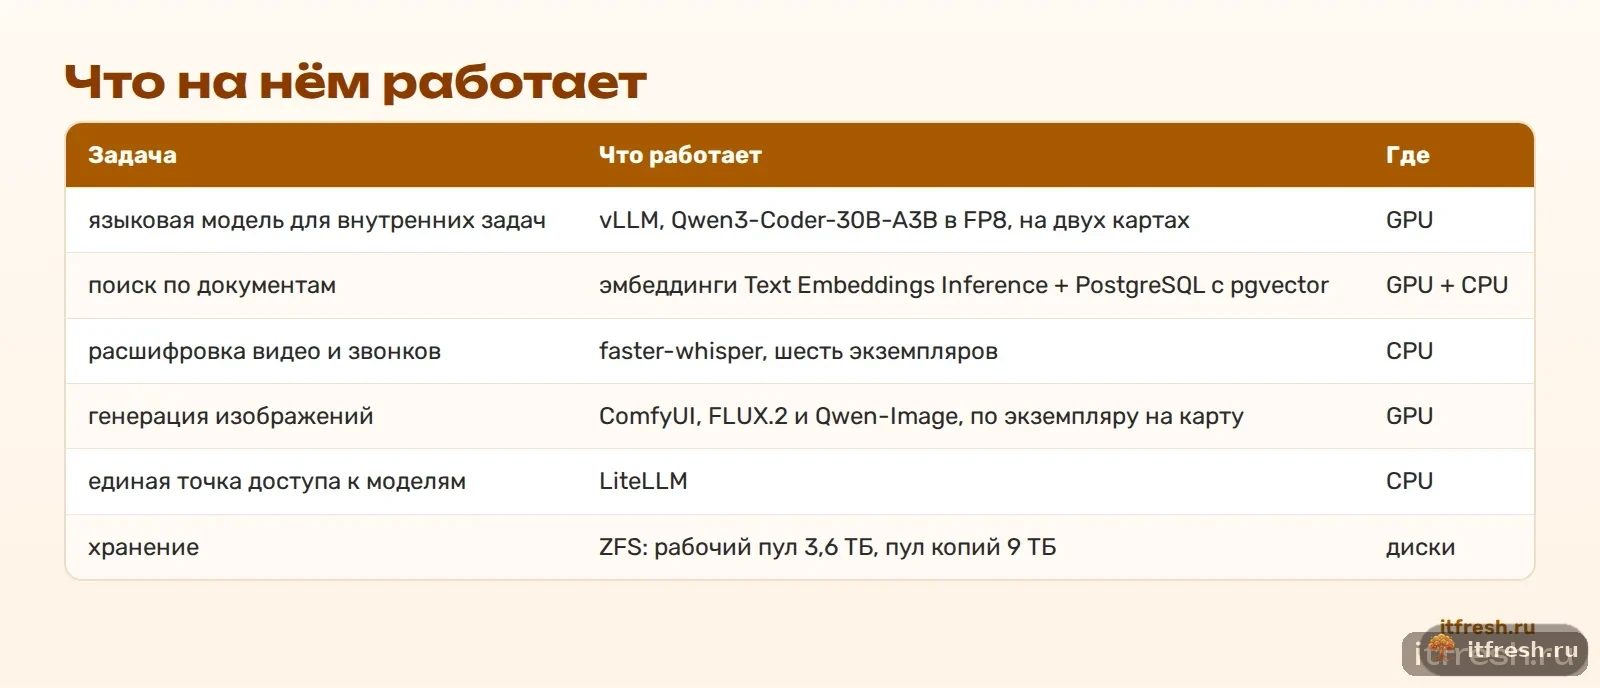
Что на нём работает
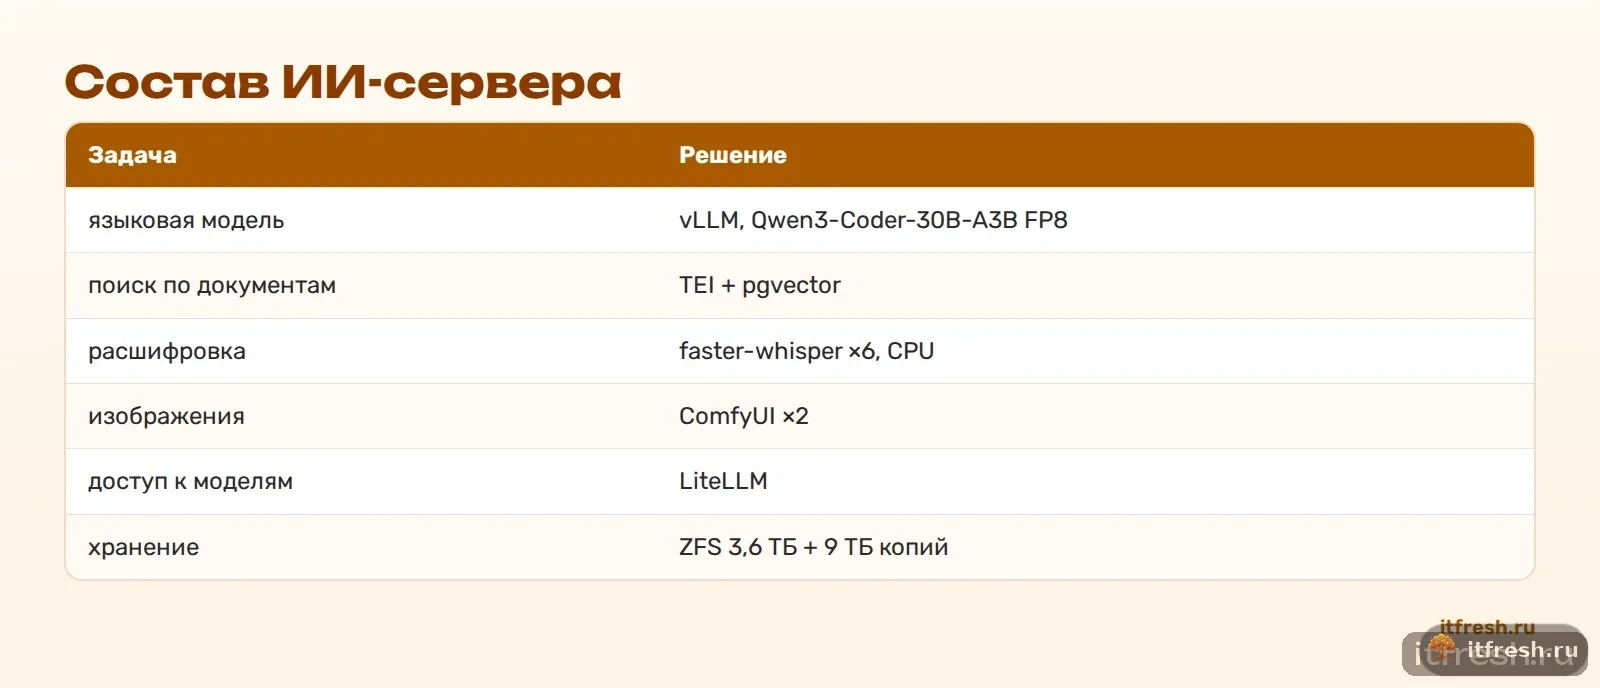
| Задача | Что работает | Где |
|---|---|---|
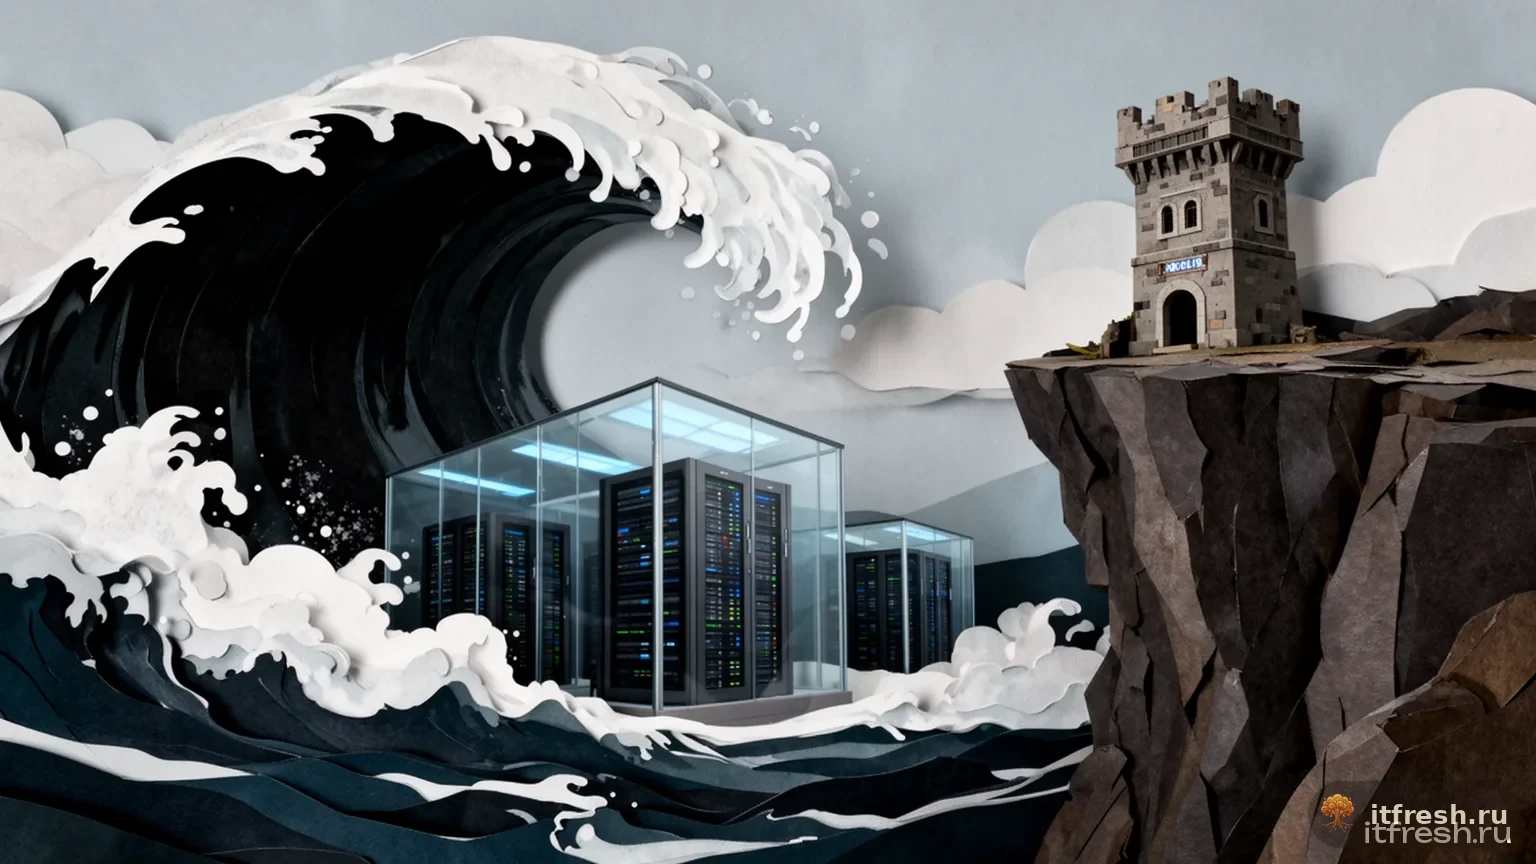
| языковая модель для внутренних задач | vLLM, Qwen3-Coder-30B-A3B в FP8, на двух картах | GPU |
| поиск по документам | эмбеддинги Text Embeddings Inference + PostgreSQL с pgvector | GPU + CPU |
| расшифровка видео и звонков | faster-whisper, шесть экземпляров | CPU |
| генерация изображений | ComfyUI, FLUX.2 и Qwen-Image, по экземпляру на карту | GPU |
| единая точка доступа к моделям | LiteLLM | CPU |
| хранение | ZFS: рабочий пул 3,6 ТБ, пул копий 9 ТБ | диски |
Всё работает в контейнерах Docker. Модели и данные лежат на ZFS, снимки делаются по расписанию и уходят в пул копий.
Языковая модель: vLLM и Qwen3-Coder
Для внутренних задач — разбор документов, классификация, извлечение фактов, помощь разработчикам — работает vLLM с моделью Qwen3-Coder-30B-A3B в формате FP8, распределённой на обе видеокарты. Это модель с архитектурой «смесь экспертов»: из 30 миллиардов параметров на каждый токен работают около трёх, поэтому она быстрая, а качество — на уровне заметно более крупных моделей. vLLM даёт OpenAI-совместимый API, так что любые программы, умеющие работать с облачным ИИ, подключаются к своему серверу заменой адреса.
Для оценки нагрузки мы следим за метриками vLLM: заполнение кэша внимания, число вытеснений запросов, длина очереди. Если вытеснения растут, модель перегружена параллельными запросами, и их число нужно ограничить.
Поиск по документам
Тысячи документов компании превращаются в векторы — числовые представления смысла — с помощью модели эмбеддингов, которая работает на видеокарте через Text Embeddings Inference. Векторы хранятся в PostgreSQL с расширением pgvector. Когда сотрудник задаёт вопрос, система находит самые близкие по смыслу фрагменты документов и передаёт их языковой модели, которая отвечает со ссылками на источники.
На этом сервере работает база знаний на 128 тысяч документов и 3,5 миллиона фрагментов. Подробнее о таком подходе — в статье о чат-боте по внутренним документам.
Расшифровка видео и звонков на процессоре
Расшифровку мы сознательно вынесли с видеокарт на процессор: шесть экземпляров faster-whisper работают параллельно на 64 ядрах. Это медленнее, чем на видеокарте, но видеокарты свободны для языковой модели, а расшифровка идёт круглосуточно в фоне и справляется с потоком. Записи совещаний и обучающие видео превращаются в текст и попадают в ту же базу знаний.
Подробнее о расшифровке совещаний — в статье о расшифровке совещаний и звонков.
Генерация изображений
Для иллюстраций сайта и презентаций работает ComfyUI — по экземпляру на каждую видеокарту — с моделями FLUX.2 и Qwen-Image. За день на двух картах мы рисуем сотни иллюстраций в разных стилях с автоматическим отбором лучших кадров по оценке эстетики. Какая модель лучше и почему, мы подробно разобрали в статье о тесте нейросетей на RTX 3090.
Главная проблема: видеокарт всегда мало
Языковая модель на обеих картах занимает почти всю видеопамять. Генератор изображений на каждой карте — тоже. Одновременно они не помещаются. Мы решили это режимами: в режиме базы знаний на картах работают языковая модель и эмбеддинги, в режиме контента — генераторы изображений. Переключение — одной командой, которая аккуратно ставит фоновые процессы на паузу, останавливает одни контейнеры, запускает другие и возвращает всё обратно.
Сторож видеокарт следит, чтобы на них не запускалось ничего постороннего: если в режиме базы знаний на карте появился чужой процесс, он не убивает идущее задание, а дожидается его окончания и сообщает в мессенджер.
Единая точка доступа
Чтобы программы компании не знали, где именно работает модель, все запросы идут через LiteLLM — шлюз с OpenAI-совместимым API. Он маршрутизирует запросы к нужной модели, ведёт учёт и ограничивает нагрузку. Если модель переехала на другой сервер или её заменили, программы этого не замечают.
Какие задачи мы решаем на нём
Конкретные задачи, которые этот сервер выполняет каждый день, а не в презентации.
- сбор и оценка материалов для отраслевых баз знаний: сотни документов в час проходят оценку релевантности моделью
- извлечение фактов и связей из документов для поиска
- расшифровка обучающих видео и вебинаров в текст
- поиск по базе знаний с ответами и ссылками на источники
- иллюстрации для статей сайта в десятке стилей
- помощь в разработке: разбор кода и скриптов
Контроль качества ответов
Своя модель не отменяет проверки качества — наоборот, её проще измерить. Мы прогоняем набор контрольных вопросов с известными ответами и смотрим, где модель ошиблась. Однажды такая проверка показала, что помощник по базе знаний отказывался отвечать на половину вопросов, ответы на которые в базе были: порог близости фрагментов был слишком строгим. После настройки порогов доля ложных отказов резко упала. Без регулярной проверки такие проблемы годами живут незамеченными.
Локальные агенты: польза и опасность
На сервере работают и агенты — языковые модели, которые сами выполняют задачи: пишут скрипты, разбирают ошибки, правят конфигурации. Это мощный инструмент и прямая угроза рабочим системам. Агент, который «исправил» рабочий скрипт напрямую, остановил загрузку почти двух тысяч документов. С тех пор правило жёсткое: агент работает только с копией, результат проверяется тестом на небольшой выборке, выкатка — с резервной копией и командой отката, всё записывается в журнал. Агенты не трогают файлы с секретами.
Мониторинг
Каждые пятнадцать минут проверяются загрузка видеокарт, доступность языковой модели и её метрики, состояние контейнеров расшифровки, очереди задач и число обработанных документов. Отклонения — сообщением в мессенджер. Цель по загрузке видеокарт — не меньше 90 %: простаивающая карта на дорогом сервере — это деньги, выброшенные на ветер.
Выход в интернет для сбора материалов
Базы знаний собираются из открытых источников, и серверу нужен выход в интернет. Часть источников недоступна из одной страны или ограничивает частые запросы, поэтому загрузка идёт через несколько выходов с повторными попытками, с соблюдением правил robots.txt и паузами между запросами к одному сайту. Важно: исходящий доступ есть только у процессов загрузки, а модели и данные наружу не смотрят.
Резервные копии моделей и данных
Модели можно скачать заново, а вот базы знаний, расшифровки и настройки — нет. Поэтому снимки ZFS рабочего пула делаются по расписанию и копируются в отдельный пул, а ключевые базы данных выгружаются ещё и на другую площадку. Восстановление проверяется. Скачанные веса моделей тоже лучше хранить локально: их версии в публичных хранилищах меняются, а старые иногда исчезают.
Почему не одна большая модель
Соблазн — поставить самую большую модель, какая влезет. На практике лучше несколько специализированных: компактная быстрая модель для массовой оценки документов, эмбеддинги для поиска, отдельная модель для расшифровки, генераторы для картинок. Большая универсальная модель занимает всю видеопамять и обрабатывает в разы меньше запросов в час, а для задачи «оценить релевантность тысячи документов» её интеллект избыточен. Мы подбираем модель под задачу, а не задачу под модель.
Грабли
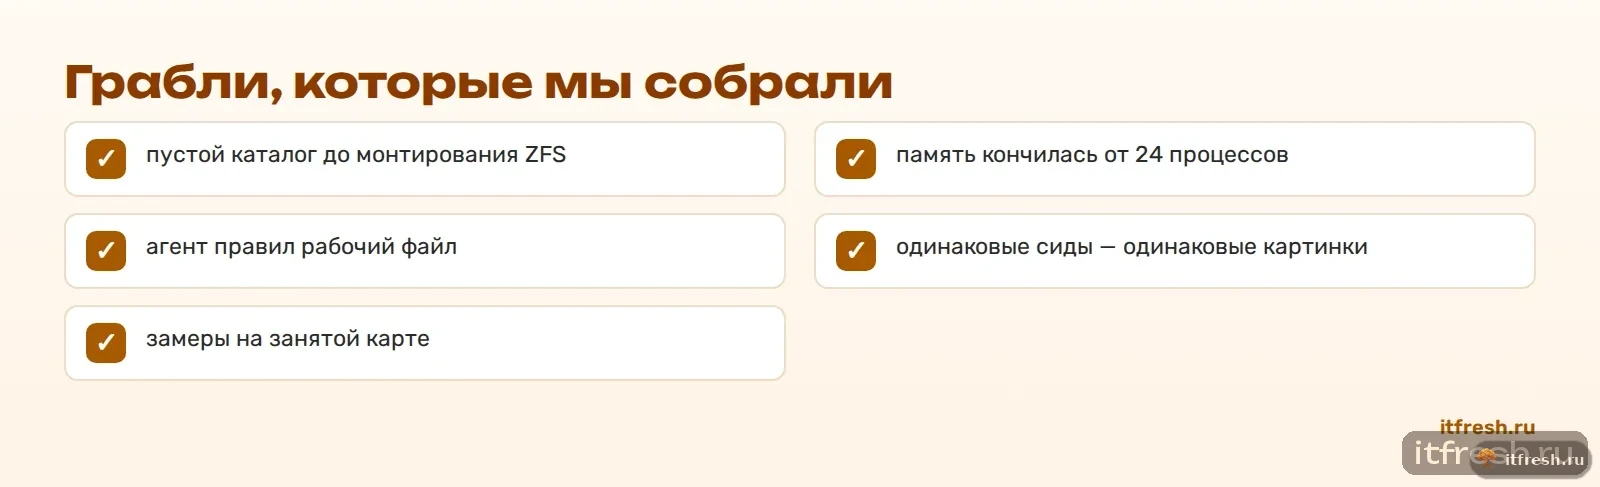
Самое ценное в этом разделе — ошибки, которые стоили нам часов.
- после перезагрузки сервера подключение каталога данных срабатывало раньше, чем монтировался пул ZFS, и программы видели пустую папку — лечится зависимостью монтирования от ZFS в fstab
- 24 параллельных процесса обработки чертежей съели всю память — сервер завис; теперь сторож памяти
- агент-помощник переписал рабочий скрипт загрузки документов вместо копии — 1 891 документ упал с ошибкой; теперь правки только через копию, тест и журнал
- одинаковые запросы с одинаковым сидом дали одинаковые картинки в разных статьях — сиды теперь уникальны
- параллельные задания на той же видеокарте испортили замеры скорости — тесты только на свободной карте
Безопасность своего ИИ
Сервер с моделями доступен только из внутренней сети и через VPN. API моделей закрыт ключами, у каждой программы свой. Данные — на зашифрованных или физически контролируемых дисках, копии — в отдельном пуле и на другой площадке. Журналы запросов хранятся у вас: в отличие от облачного ИИ, вы точно знаете, кто и что отправлял в модель. Подробнее о конфиденциальности локальных моделей — в статье о локальных моделях и конфиденциальности.
Сколько это стоит в обслуживании
Главные регулярные расходы — электричество, место в стойке или офисе и время администратора. Две RTX 3090 под нагрузкой потребляют сотни ватт каждая, и это нужно учесть при выборе площадки. Обновления моделей и программ выходят часто, и их нужно тестировать: новая версия ComfyUI или vLLM может потребовать других параметров. Поэтому у нас каждое обновление проходит через копию и тест, а не ставится сразу на рабочий сервер.
С чего начать компании
Не нужно сразу строить сервер на две видеокарты. Начните с одной задачи, где облачный ИИ особенно опасен для данных: разбор договоров, расшифровка совещаний, поиск по внутренней документации. Для неё хватит одной видеокарты на 24 ГБ. Как развернуть локальную модель в небольшой компании, — в статье о локальной языковой модели для малого бизнеса. Когда задач станет больше, сервер масштабируется второй картой и расписанием режимов.
Итог
Свой ИИ-сервер на двух потребительских видеокартах закрывает основные задачи компании: языковая модель для документов и кода, поиск по базе знаний, расшифровка, генерация изображений. Данные остаются внутри, лимиты задаёте вы, фильтров чужих правил нет. Цена — грамотная эксплуатация: расписание видеокарт, сторожа памяти, правки через копию. Это та же логика, что со своей почтой: контроль вместо зависимости.
Частые вопросы
Какое железо нужно для своего ИИ-сервера?
Для начала — одна видеокарта на 24 ГБ. У нас две RTX 3090, 64 ядра, около 500 ГБ памяти и ZFS для данных и копий.
Какая языковая модель работает на двух RTX 3090?
У нас — Qwen3-Coder-30B-A3B в FP8 через vLLM, распределённая на обе карты. Это «смесь экспертов»: быстрая при хорошем качестве.
Можно ли одновременно держать языковую модель и генератор картинок?
На двух картах по 24 ГБ — нет. Мы переключаем режимы: база знаний или генерация контента.
Почему расшифровка на процессоре?
Чтобы видеокарты оставались для языковой модели. Шесть экземпляров faster-whisper на 64 ядрах справляются с потоком в фоне.
Подключатся ли программы, рассчитанные на облачный ИИ?
Да: vLLM и LiteLLM дают OpenAI-совместимый API, достаточно сменить адрес и ключ.
Что главное в эксплуатации?
Расписание видеокарт, сторож памяти, правки только через копию и тест, копии данных в отдельный пул и на другую площадку.