
Генерация изображений на своём сервере: тест FLUX.2, Qwen-Image, Ideogram и HunyuanImage на одной RTX 3090
Облачные генераторы решают за вас, что можно рисовать. Мы проверили, что получается, когда решаете вы. Облачные генераторы картинок решают за вас, что можно рисовать, сколько это стоит и когда сервис будет доступен. Генерация изображений на своём сервере снимает все три вопроса — если правильно выбрать модель. Мы прогнали шесть открытых моделей на одной видеокарте RTX 3090: замерили скорость, оценили эстетику автоматически и устроили слепое сравнение. Результат неожиданный: лидер внешних рейтингов проиграл модели, которая работает в четыре раза быстрее.
Почему не облачный генератор
Облачный генератор удобен ровно до того момента, когда он отказывается рисовать. Фильтры безопасности срабатывают на безобидные запросы, тарифы меняются, доступ из России то есть, то нет, а каждый ваш запрос — с описанием продукта, интерьера клиента или будущей рекламной кампании — уходит на чужой сервер. Для компании, которая делает много изображений — сайт, каталог, презентации, — это зависимость того же сорта, что почта в чужом облаке.
Свой сервер с видеокартой работает иначе: никаких лимитов кроме железа, никаких фильтров кроме ваших правил, никаких данных наружу. Вопрос только один — какая модель даст лучший результат на доступном оборудовании. Его мы и проверили.
Хватит спрашивать разрешения у чужой нейросети
Вы описываете иллюстрацию для своего сайта — а облачный сервис отвечает отказом, потому что его фильтр увидел в «горящем дата-центре» что-то опасное. Или тариф кончился. Или сервис недоступен из вашей страны на этой неделе. Ваш маркетинг зависит от настроения чужого модератора.
Своя видеокарта убирает всё это разом. Никаких фильтров, кроме ваших правил, никаких лимитов, кроме железа, никаких данных наружу. Осталось выбрать модель — и здесь нас ждали сюрпризы.
Стенд и методика
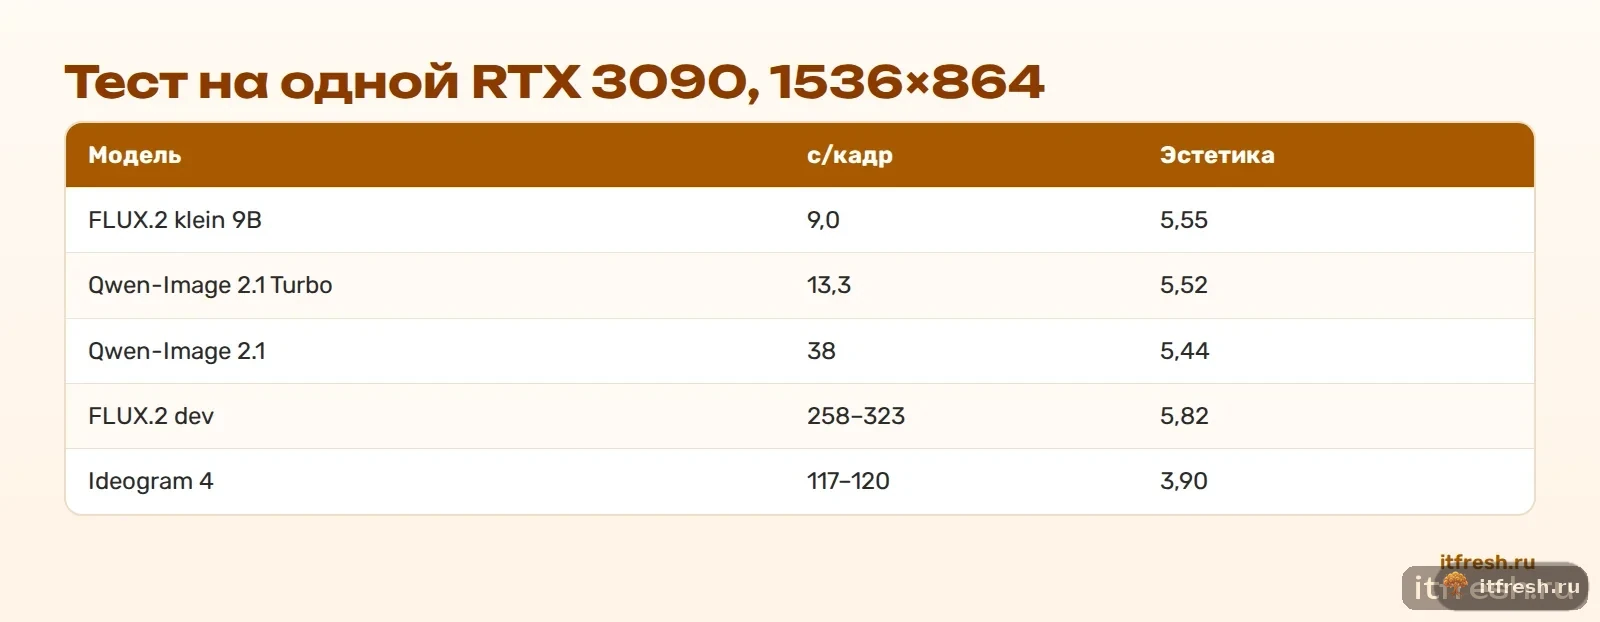
Сервер с двумя видеокартами RTX 3090 по 24 ГБ, ComfyUI версии 0.39 в контейнере, разрешение 1536×864 — формат обложки статьи. Пятнадцать запросов из реальной серии статей: восемь обложек и семь иллюстраций, без текста и логотипов. Четыре сида на запрос для быстрых моделей.
Время — чистое выполнение задания по журналу ComfyUI, медиана, без первой загрузки модели и без ожидания в очереди. Эстетика — автоматическая оценка LAION aesthetic predictor: нейросеть CLIP ViT-L/14 с линейной головой, обученная предсказывать, насколько изображение понравится людям. Слепое сравнение — листы с перемешанными вариантами, выбор лучшего до раскрытия, какая модель что нарисовала.
Кандидаты
Мы взяли модели с открытыми весами из верхней части рейтинга Artificial Analysis Text-to-Image на начало октября 2026 года: Qwen-Image-2.1, Ideogram 4, FLUX.2 [dev], HunyuanImage 3.0 Instruct и компактную FLUX.2 [klein] 9B. Плюс Qwen-Image-2.1 Turbo — ускоренный вариант на восемь шагов.
Внешний рейтинг ставил на первое место Qwen-Image-2.1, FLUX.2 [klein] 9B была в нём заметно ниже. Проверим, совпадёт ли это с практикой.
Результаты
| Модель | Настройки | Секунд на кадр | Эстетика | Слепое сравнение | Итог |
|---|---|---|---|---|---|
| FLUX.2 [klein] 9B | GGUF Q8_0, 4 шага | 9,0 | 5,55 | 17 побед из 23 | победитель по скорости и качеству |
| Qwen-Image-2.1 Turbo | bf16, 8 шагов | 13,3 | 5,52 | 3 из 20 | быстро, но проигрывает вслепую |
| Qwen-Image-2.1 | bf16, 25 шагов | 38 | 5,44 | 2 из 18 | лидер внешнего рейтинга, вслепую проиграл |
| FLUX.2 [dev] | fp8, 40 шагов | 258–323 | 5,82 | 1 из 3 | лучшая эстетика, в 30 раз медленнее |
| Ideogram 4 | int8, 20 шагов | 117–120 | 3,90 | — | большинство кадров — заглушка фильтра безопасности |
| HunyuanImage 3.0 | — | — | — | — | не поместилась: 47 ГБ при 24 ГБ видеопамяти |
Эстетика — среднее по кадрам, по шкале предиктора. Слепое сравнение — сумма по трём турам с разным числом запросов. Время — на одной RTX 3090.
Победитель: FLUX.2 [klein] 9B
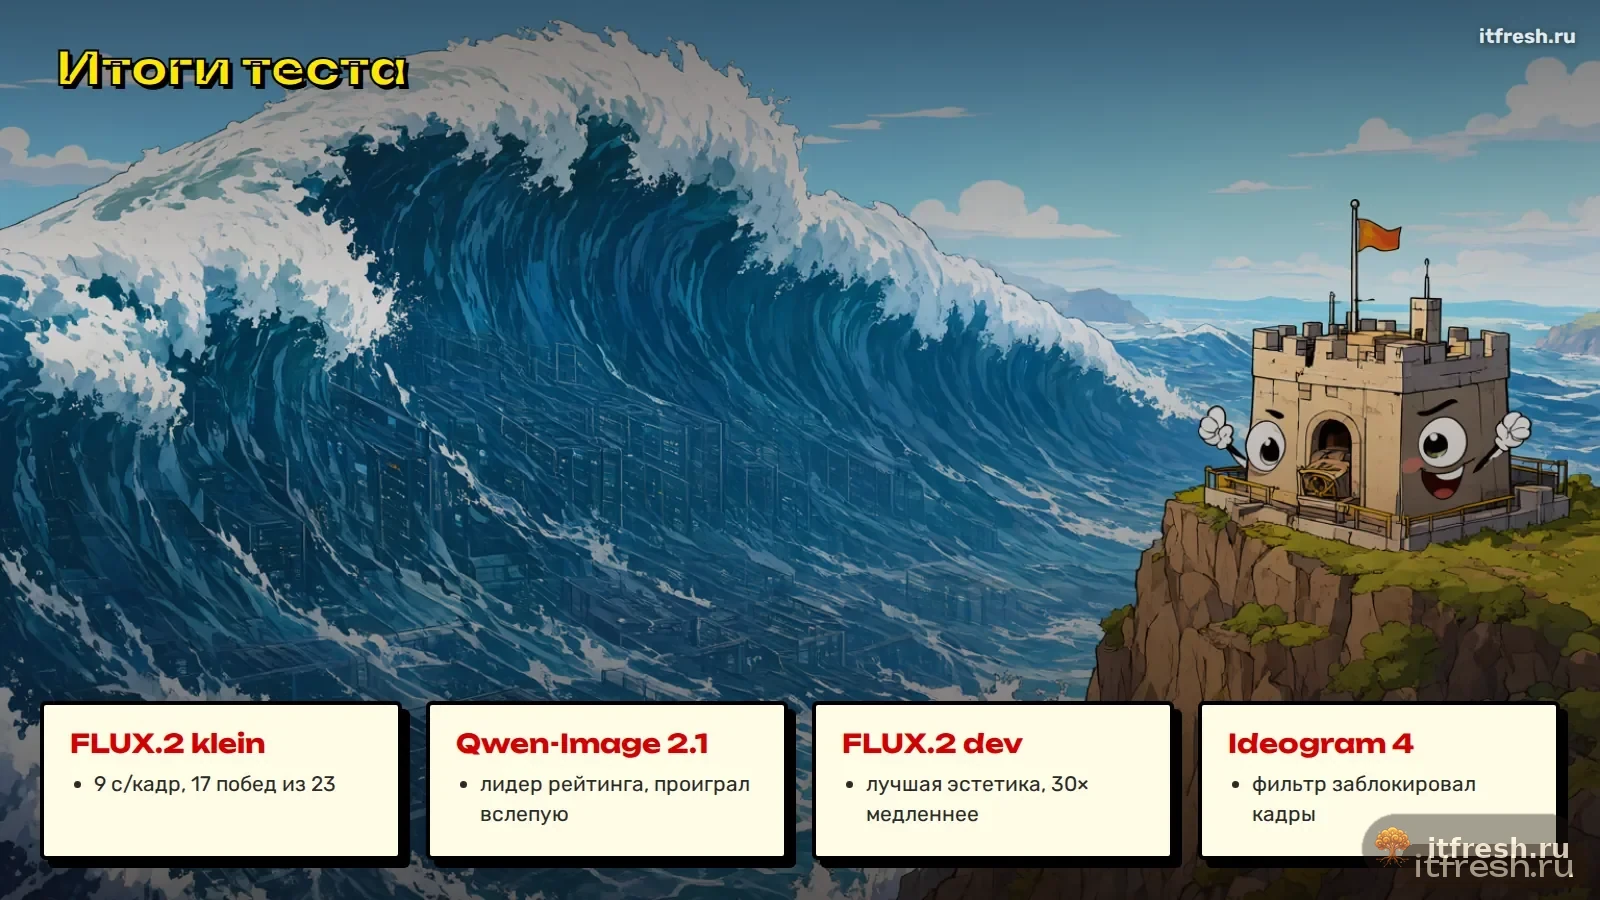
Компактная модель на 9 миллиардов параметров в квантовании Q8_0 рисует кадр 1536×864 за 9 секунд — шесть-семь кадров в минуту на одной видеокарте. При этом в слепом сравнении она выиграла 17 раз из 23, обойдя и лидера рейтинга, и свою старшую сестру. Эстетика по предиктору — 5,55, на уровне остальных.
Секрет в дистилляции: модель обучена выдавать результат за четыре шага вместо сорока, и на практике это почти не стоит качества для иллюстраций. Для задачи «много хороших картинок быстро» это идеальный выбор.
Лидер рейтинга проиграл вслепую
Qwen-Image-2.1 в полной версии на 25 шагов — лидер внешнего рейтинга — в нашем слепом сравнении выиграл всего дважды из восемнадцати, при скорости 38 секунд на кадр. Его ускоренная версия Turbo быстрее и почти не отличается по эстетике, но тоже проигрывает klein вслепую.
Это хороший урок: рейтинги строятся на других запросах и других задачах. Модель, которая побеждает в общем зачёте, может проиграть на ваших конкретных сюжетах. Проверяйте на своих данных.
FLUX.2 [dev]: лучшая эстетика, но в 30 раз медленнее
Старшая FLUX.2 [dev] на сорока шагах дала лучшую среднюю эстетику — 5,82. Но кадр занимает от 258 до 323 секунд на одной RTX 3090: модель не помещается целиком в видеопамять и частично выгружается. Для обложек, где важен каждый кадр, это приемлемо. Для сотен иллюстраций — нет.
Мы используем её именно так: обложки и ключевые кадры — FLUX.2 [dev], массовые иллюстрации — klein и Qwen в разных стилях.
Ideogram 4: цензура в открытой модели
Самая неожиданная находка. Ideogram 4 с открытыми весами в большинстве наших запросов вернул не картинку, а заглушку «Image blocked by safety filter». Запросы безобидные: горящий дата-центр, серверная стойка, бухта на закате. Встроенный фильтр безопасности модели решил, что это опасно. Эстетика по оставшимся кадрам — 3,90, худший результат теста.
Вывод жёсткий: даже на своём сервере модель может нести чужие правила. Проверяйте, нет ли во взятой модели встроенных фильтров, которые решают за вас, что рисовать.
HunyuanImage 3.0: не поместилась
HunyuanImage 3.0 Instruct даже в 4-битной версии весит 47 ГБ — вдвое больше видеопамяти одной RTX 3090. Запустить её на нашем стенде без серьёзных ухищрений нельзя. Для таких моделей нужны карты с 48–80 ГБ памяти или несколько карт с распределением модели. Это важный практический фильтр: прежде чем выбирать модель по рейтингу, проверьте, влезет ли она в ваше железо.
Скорость в цифрах
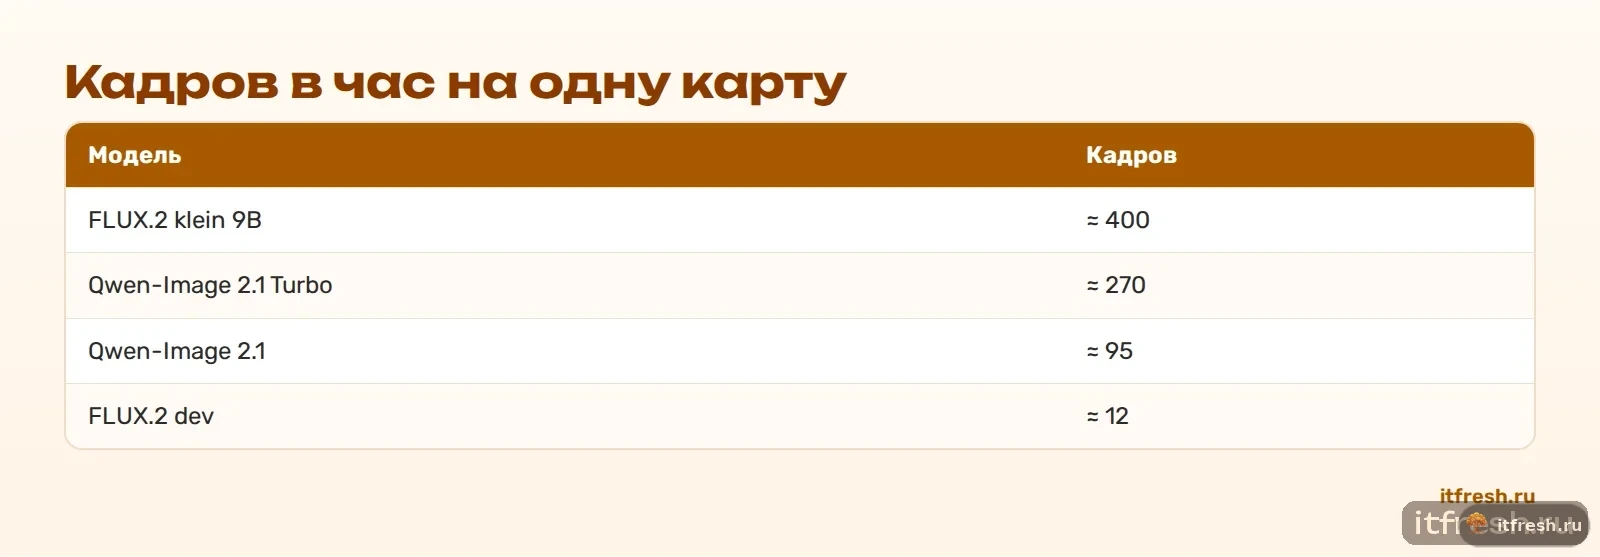
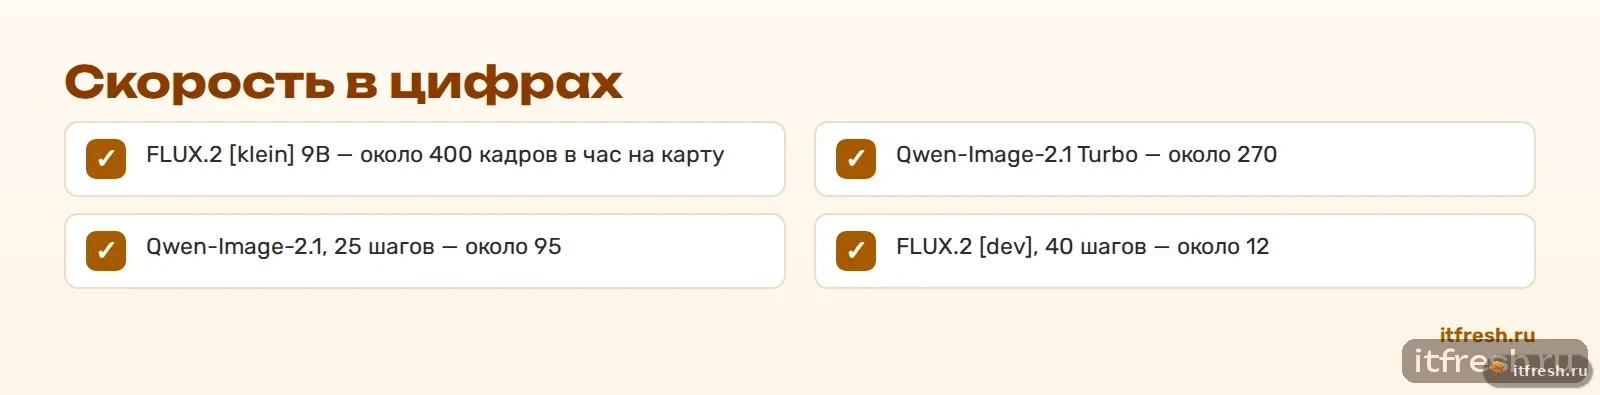
Что значат секунды на кадр в реальной работе. За час одна RTX 3090 рисует примерно 400 кадров klein, 270 кадров Qwen Turbo, 95 кадров Qwen на 25 шагов или 12 кадров FLUX.2 [dev]. Две видеокарты — вдвое больше. Для серии из сорока статей по десять-пятнадцать иллюстраций с несколькими вариантами каждой это разница между вечером и неделей.
- FLUX.2 [klein] 9B — около 400 кадров в час на карту
- Qwen-Image-2.1 Turbo — около 270
- Qwen-Image-2.1, 25 шагов — около 95
- FLUX.2 [dev], 40 шагов — около 12
Как мы отбираем лучшие кадры автоматически
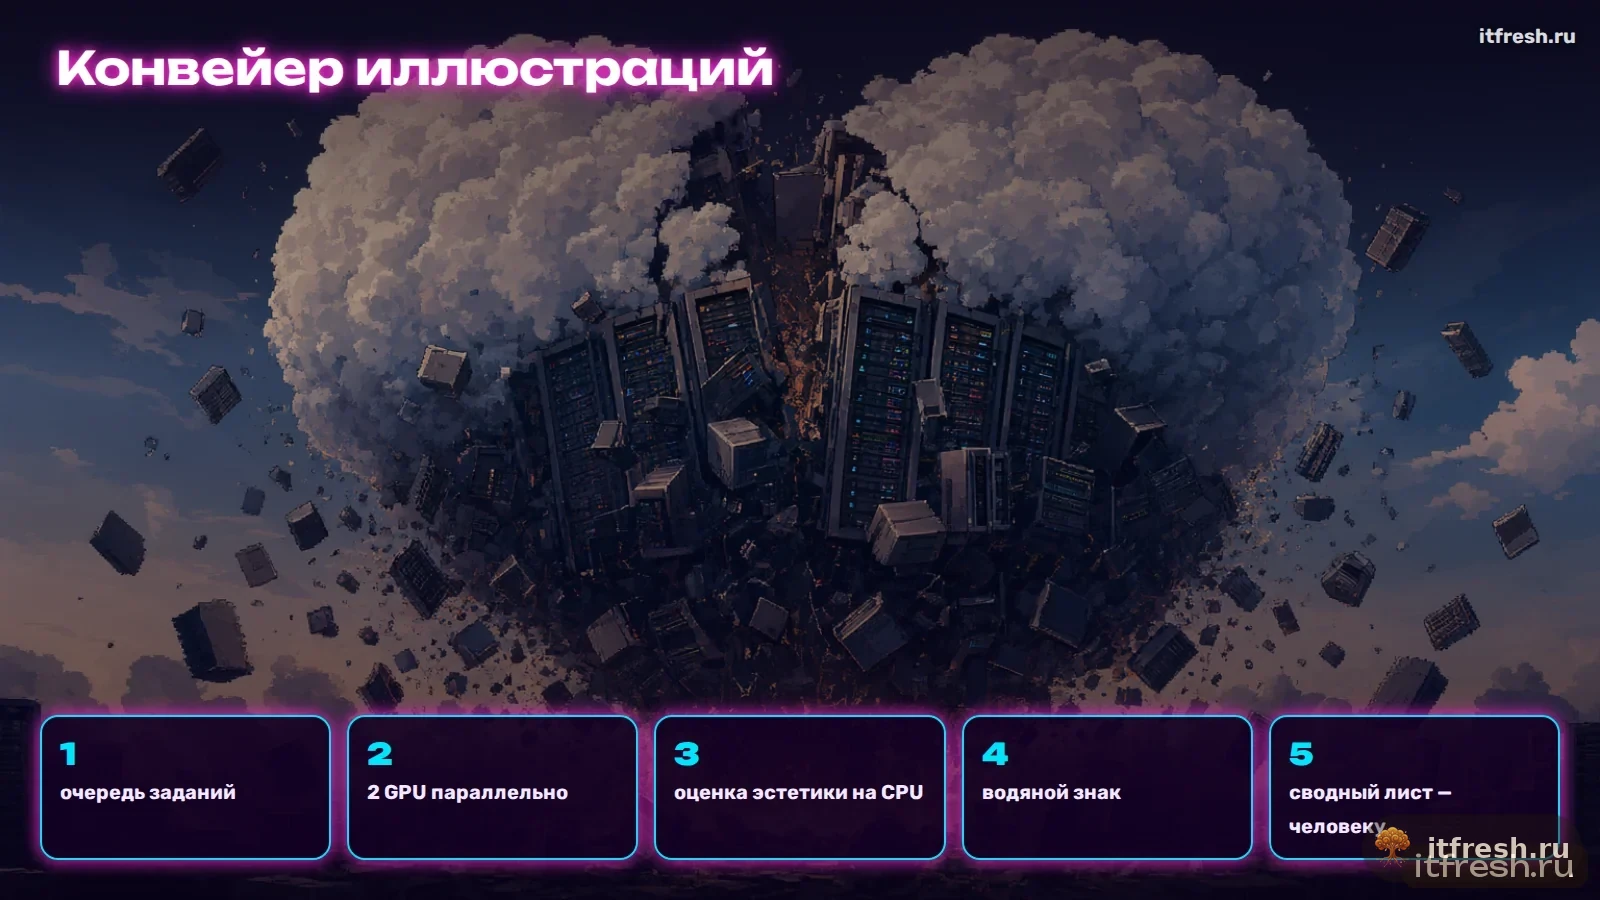
Генерировать по несколько вариантов и выбирать руками — долго. Мы рисуем два-восемь вариантов каждого сюжета с разными сидами и ранжируем их тем же предиктором эстетики. Лучший идёт в статью, второй — на подложку инфографики. Человек смотрит только сводный лист статьи и отбраковывает редкие неудачи: псевдотекст, лишние пальцы, логотипы.
Это работает на CPU: оценка нескольких сотен кадров занимает минуты и не отнимает видеокарту у генерации.
Разные модели — разные стили
Ещё одно практическое наблюдение: модели по-разному сильны в разных стилях. FLUX.2 [klein] хороша в фотореализме, карандаше, изометрии и бумажной аппликации. Qwen-Image Turbo уверенно рисует мультфильм, комикс, неон и стиль «Матрицы». Полная Qwen-Image на 25 шагах — акварель, масло и чертёж. FLUX.2 [dev] — кинематографичные кадры с драматичным светом. Мы закрепили за каждым стилем свою модель — так в одной статье соседствуют картинки разных моделей, и ни одна не выглядит однообразно.
Что нужно для своего генератора
Минимум — сервер с одной видеокартой на 24 ГБ: RTX 3090 или 4090. Этого хватает для klein, Qwen и FLUX.2 [dev] с выгрузкой части модели. Docker, ComfyUI, модели на быстром диске — веса занимают десятки гигабайт. Очередь заданий и скрипт, который раздаёт задания по картам и складывает результаты. Если сервер общий с другими задачами — например, с языковой моделью, — нужно расписание: видеокарта не может одновременно держать большую языковую модель и генератор изображений.
Подробнее о том, как пробросить видеокарту в виртуальную машину, — в статье о пробросе GPU в Proxmox.
Свой ИИ — не только картинки
Тот же сервер с видеокартами запускает языковые модели для внутренних задач, расшифровку совещаний и поиск по документам компании — без отправки данных в чужое облако. Как это устроено для малого бизнеса — в статьях о локальной языковой модели для бизнеса и о локальных моделях и конфиденциальности. Поиск по внутренним документам — в статье о чат-боте по документам компании.
Квантование: почему Q8_0 и fp8
Полные веса современных моделей не помещаются в 24 ГБ вместе с текстовым кодировщиком. Поэтому мы использовали квантованные версии: FLUX.2 [klein] в формате GGUF Q8_0 и FLUX.2 [dev] в fp8. Восьмибитное квантование почти не отличается от полной точности на глаз, зато вдвое экономит память и ускоряет загрузку. Четырёхбитные версии ещё легче, но на иллюстрациях с мелкими деталями разница уже заметна — для коммерческих картинок мы их не берём.
Грабли, на которые мы наткнулись
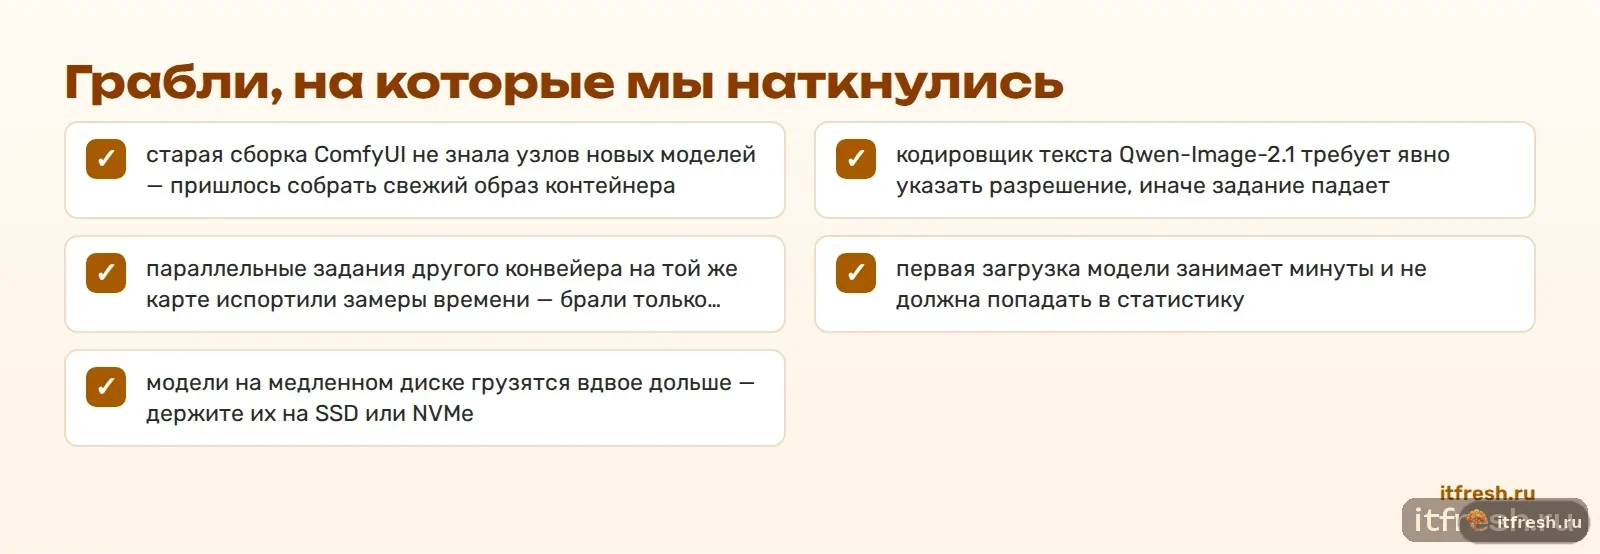
Тест занял не час, а целый день — из-за практических мелочей, о которых стоит знать заранее.
- старая сборка ComfyUI не знала узлов новых моделей — пришлось собрать свежий образ контейнера
- кодировщик текста Qwen-Image-2.1 требует явно указать разрешение, иначе задание падает
- параллельные задания другого конвейера на той же карте испортили замеры времени — брали только чистые прогоны
- первая загрузка модели занимает минуты и не должна попадать в статистику
- модели на медленном диске грузятся вдвое дольше — держите их на SSD или NVMe
Одна карта или две
Две видеокарты не ускоряют одно задание — каждая модель работает на своей карте целиком. Зато они вдвое увеличивают пропускную способность: мы запускаем две очереди заданий, по одной на карту, и раздаём задания поровну. Для генерации сотен изображений это почти идеальное масштабирование. Для одной огромной модели вроде HunyuanImage 3.0 две карты по 24 ГБ без специальной настройки распределения не помогут.
Как устроить очередь заданий
Для массовой генерации ComfyUI удобнее использовать как сервер, а не через веб-интерфейс. Задания описываются списком: путь к файлу, модель, текст запроса, сид. Скрипт отправляет их в API ComfyUI, сортируя по модели, чтобы не перегружать веса между заданиями, ждёт результата и сохраняет картинку. На каждую видеокарту — свой экземпляр ComfyUI и своя очередь. Сиды мы делаем уникальными для каждой статьи, иначе одинаковый запрос с одинаковым сидом даёт одинаковую картинку в разных статьях — мы наступили на это и пересоздали шесть десятков дублей.
После очереди — автоматическая оценка эстетики, сборка статьи и водяной знак сайта на каждом изображении. Человек подключается только на финальном просмотре.
Где модели ошибаются
Ни одна модель не идеальна, и типичные дефекты стоит знать. Псевдотекст — надписи из несуществующих букв на вывесках и экранах; лечится словами «без текста и букв» в запросе и отбраковкой. Лишние или сросшиеся пальцы у людей; проще избегать крупных планов рук. Логотипы, похожие на реальные бренды, — недопустимы в коммерческих картинках, поэтому «без логотипов» тоже пишется в каждом запросе. За весь объём серии такие дефекты попадались в единицах процентов кадров и отсеивались при просмотре сводного листа.
Выводы
Коротко — что мы вынесли из теста.
- для массовых иллюстраций на RTX 3090 — FLUX.2 [klein] 9B: быстрее всех и лучше вслепую
- для обложек и ключевых кадров — FLUX.2 [dev], если есть время
- внешний рейтинг не заменяет проверки на своих сюжетах
- проверяйте встроенные фильтры: Ideogram 4 заблокировал большинство безобидных запросов
- проверяйте размер модели до выбора: HunyuanImage 3.0 не влезает в 24 ГБ
- автоматическая оценка эстетики экономит часы ручного отбора
Частые вопросы
Какая нейросеть лучше всего рисует на RTX 3090?
В нашем тесте — FLUX.2 [klein] 9B: 9 секунд на кадр 1536×864 и 17 побед из 23 в слепом сравнении.
Можно ли запустить FLUX.2 [dev] на 24 ГБ?
Да, с выгрузкой части модели, но кадр занимает 258–323 секунды. Подходит для обложек, не для сотен иллюстраций.
Почему Ideogram 4 не рисовал?
Встроенный фильтр безопасности заблокировал большинство наших безобидных запросов, вернув заглушку вместо картинки.
Влезет ли HunyuanImage 3.0 в одну видеокарту?
Нет: 4-битная версия весит 47 ГБ при 24 ГБ видеопамяти RTX 3090.
Как автоматически выбрать лучший кадр?
Предиктором эстетики LAION на основе CLIP: он оценивает каждый вариант, лучший идёт в работу. Работает на CPU.
Зачем свой генератор, если есть облачные?
Нет лимитов и чужих фильтров, данные не уходят наружу, сервис не зависит от доступности и тарифов облака.