
Авария провайдера связи площадки: два реальных сбоя по 30 минут, как мы их диагностировали и почему свой сервер тоже нужно резервировать
Мы не будем притворяться: свой сервер тоже может остаться без связи. Разница в том, что мы видим всё сами и не ждём новостей. Мы много пишем о том, что облако — единая точка отказа. Честность требует сказать: свой сервер тоже зависит от провайдера связи площадки. Авария провайдера связи 2 сентября и 5 октября 2026 года отрезала от интернета все адреса площадки, где стоят несколько наших серверов, — на 35 и 31 минуту. Разбираем, что мы видели, как за минуты отличили аварию провайдера от своей поломки, на какой ложный след едва не повелись и что из этого следует для своей почты и своих серверов.
Что случилось
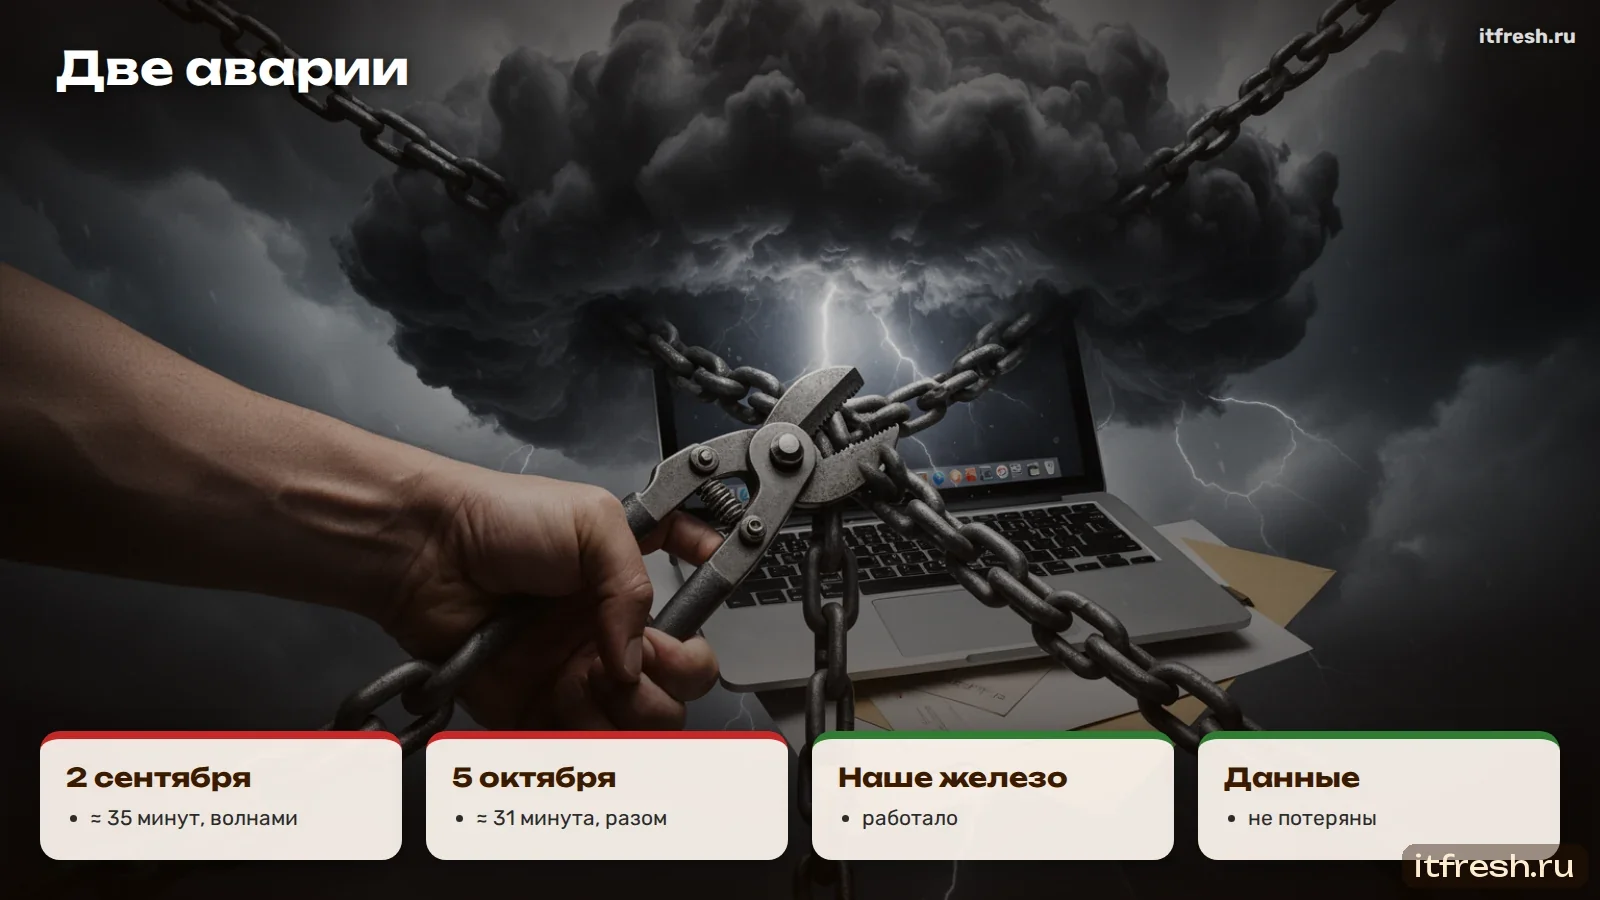
2 сентября 2026 года около 18:20 по Москве перестали отвечать сразу несколько серверов на одной площадке: почтовый сервер, сайты клиентов, системы мониторинга. Через 35 минут всё восстановилось волнами — сначала одна группа адресов, через несколько минут другая. 5 октября около 18:26 по Москве история повторилась: все адреса этого провайдера, включая его собственный сайт, стали недоступны на 31 минуту, затем ожили одновременно.
Наше оборудование на площадке в обоих случаях работало без сбоев. Не работала связь между площадкой и интернетом.
Обе аварии пришлись на рабочее время — около шести вечера по Москве, когда почта и сайты ещё активно используются. Для клиентов это выглядело как внезапная недоступность всего сразу.
Честность — наше оружие против облака
Облачные провайдеры редко рассказывают о своих авариях подробно. Мы расскажем о своих: дважды за полтора месяца площадка одного провайдера связи падала на полчаса, и наши серверы на ней оставались без интернета. Это правда, и мы её не прячем.
Но посмотрите на разницу: через пять минут мы точно знали, что наше железо живо, где проблема и чего ждать. Внутренние процессы не остановились ни на секунду. А из этих аварий родилось решение — вторая площадка у другого провайдера. Вот что такое контроль.
Первые минуты: свой сбой или чужой
Главный вопрос в начале любой аварии — где проблема: в вашем оборудовании, у провайдера или где-то по пути. От ответа зависит, что делать: перезагружать серверы, звонить провайдеру или ждать. Неправильный ответ стоит дорого: перезагрузка исправного оборудования во время аварии провайдера ничего не даёт, но добавляет риск, что что-то не поднимется.
Мы отвечаем на этот вопрос по одной и той же методике — она заняла несколько минут.
Шаг 1. Пробы с двух независимых точек
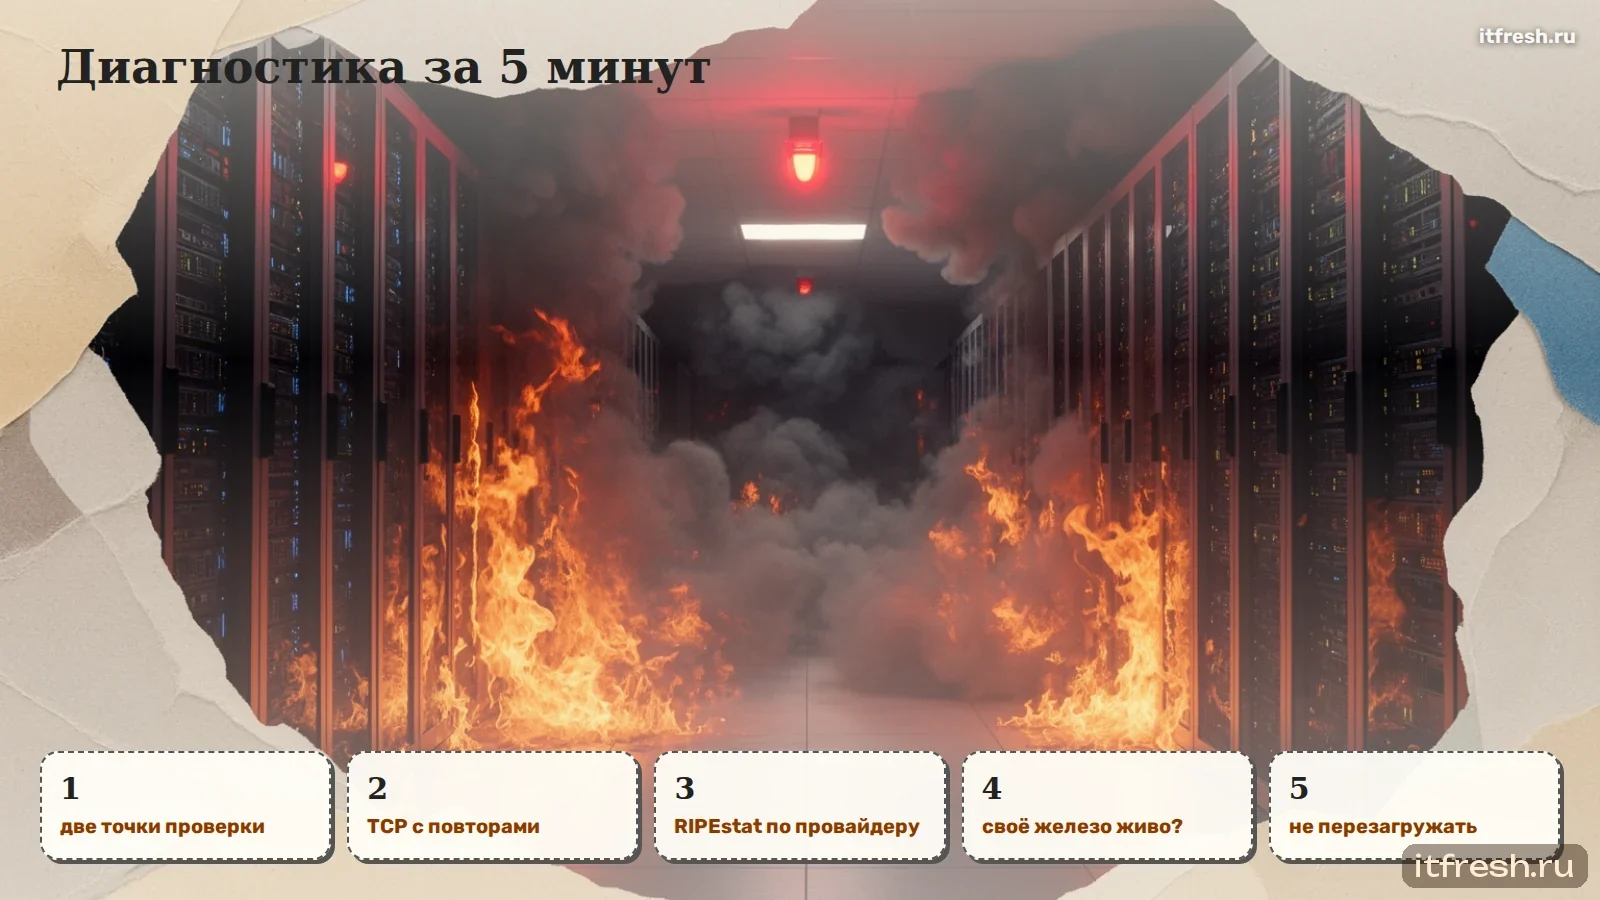
Проверяйте доступность не с одного компьютера, а минимум с двух точек в разных странах и у разных провайдеров. Если адрес недоступен с одной точки и доступен с другой — проблема на пути от первой точки, а не на площадке. Если недоступен отовсюду — проблема на площадке или у её провайдера.
# 1. проба с двух независимых точек (разные страны и провайдеры)
for h in host1.company.ru host2.company.ru; do nc -vz -w 5 $h 443; done
# 2. TCP с повторами: при частичных потерях одна попытка врёт
for i in 1 2 3 4 5 6; do nc -z -w 3 host1.company.ru 443 && echo ok && break; sleep 2; done
# 3. чей это адрес и что с префиксами провайдера (RIPEstat)
curl -s "https://stat.ripe.net/data/prefix-overview/data.json?resource=203.0.113.10"
Важная деталь: при частичных потерях пакетов одна попытка соединения может не пройти даже у живого сервера. Проверяйте несколькими попытками с паузами — иначе легко принять потери за полную недоступность.
Шаг 2. Ложный след: «проблема транзита»
Во второй аварии первая гипотеза была неверной: раз с нашего управляющего сервера в одной стране российские адреса не отвечают, значит, проблема в транзите от него до России. Гипотезу проверили второй точкой в Европе — оттуда те же адреса тоже были мертвы. Значит, транзит ни при чём, проблема у провайдера площадки. Проверка с одной точки дала бы неверный вывод и потерянное время на разбор «своей» сети.
Правило, которое мы закрепили: при недоступности хоста сначала пробы с двух независимых точек и проверка провайдера по его автономной системе, и только потом выводы.
Шаг 3. Чей адрес и что с провайдером
Публичные сервисы маршрутной информации — например, RIPEstat — показывают, какой автономной системе принадлежит адрес и какие ещё префиксы у этого провайдера. Если недоступны все адреса одного провайдера, включая его собственный сайт, — это его авария, а не ваша. В нашем случае все четыре проверенных адреса принадлежали одной автономной системе, и сайт провайдера тоже не отвечал.
Шаг 4. Живо ли своё оборудование
Если есть доступ к оборудованию на площадке изнутри или через другой канал, проверьте его состояние. В первой аварии маршрутизатор на площадке показывал нагрузку процессора 1 %, пустую таблицу соединений и свежие записи о соседних устройствах — оборудование было живо и просто не получало трафик снаружи. Шлюзы провайдера при этом отвечали, а клиентские адреса — нет: проблема была между шлюзом и площадкой.
Вывод из этого шага: перезагружать ничего не нужно. Наше дело — сообщить клиентам и ждать.
Что продолжало работать
Самое интересное: серверы на площадке продолжали работать. Внутренние конвейеры — обработка документов, построение базы знаний, расчёты — шли без перерыва, потому что не зависели от внешней связи. Остановилось только то, что требует интернета: сбор материалов, доступ пользователей снаружи, отправка почты. После восстановления связи всё продолжилось само, без ручного вмешательства, — потому что службы спроектированы так, чтобы переживать обрыв сети.
Что это значит для почты
Почтовый сервер на площадке, у которой пропала связь, перестаёт принимать и отправлять письма. Но в отличие от облака, здесь всё под вашим контролем. Входящие письма не теряются: отправляющие серверы повторяют попытки, и за 30 минут почти все письма доставляются после восстановления. Если у домена есть резервный MX на другой площадке, письма принимаются им сразу, без задержки для отправителей. Исходящие письма сотрудников стоят в очереди программ и уходят после восстановления.
Подробно об устройстве резерва — в статье о резервном MX и второй площадке.
Восстановление волнами
В первой аварии связь вернулась не сразу ко всем адресам, а волнами по группам с интервалом в несколько минут: сначала почтовый сервер, затем часть сайтов, затем остальные. Это типичная картина, когда провайдер восстанавливает маршруты или оборудование по сегментам. Практический вывод: если одна группа адресов ожила, а ваш сервер ещё нет — подождите десять минут, прежде чем делать выводы о своей поломке. Во второй аварии все адреса ожили одновременно — значит, причина была в общем узле.
Как сообщить клиентам и сотрудникам
Первые десять минут аварии — время, когда пользователи начинают звонить и писать. Короткое сообщение снимает большую часть паники: что недоступно, что причина у провайдера связи площадки, что данные не потеряны, что восстановление ожидается и вы сообщите о нём. Отправлять такое сообщение нужно через канал, который работает: мессенджер, а не почта на пострадавшем сервере. Мы отправили оповещение через несколько минут после начала и отдельное — о восстановлении.
Что проверить после восстановления
Когда связь вернулась, не считайте инцидент закрытым. Проверьте, что все службы на серверах поднялись и работают, что очереди почты разошлись, что фоновые процессы продолжили работу, а не зависли на оборванных соединениях, что синхронизация и копии выполнились. У нас после обеих аварий все конвейеры продолжили сами, но проверка заняла несколько минут и подтвердила это фактами, а не надеждой.
Что требовать от провайдера
После аварии запросите у провайдера причину и меры, чтобы она не повторилась. Сравните с договором: какое время доступности обещано и что положено при нарушении. Две аварии по полчаса за месяц в рабочее время — повод для серьёзного разговора и для того, чтобы ускорить переезд критичных сервисов на вторую площадку. Ваши записи об авариях — время начала, охват, длительность — главный аргумент в этом разговоре.
Почему трассировка не помогла
Классический инструмент — трассировка маршрута — в этой ситуации дал мало. С одной точки трассировка обрывалась на ядре сети своего хостинга, что выглядело как проблема по пути. С другой точки — где-то в другом месте. Трассировка показывает, где пропадают ответы на служебные пакеты, а не где сломана связь: многие маршрутизаторы на них просто не отвечают. Пробы с нескольких точек и проверка всех адресов провайдера дали ответ быстрее и надёжнее.
Как устроить проверку у себя
Для такой диагностики не нужны дорогие системы. Достаточно двух-трёх недорогих виртуальных машин у разных провайдеров в разных странах, с которых раз в минуту проверяется доступность ключевых адресов: почтового сервера, сайта, VPN, панели управления. Результаты сравниваются: если адрес недоступен со всех точек — авария на площадке, если с одной — проблема на пути. Оповещение уходит в мессенджер дежурному. Настройка занимает день, а экономит часы в каждой аварии.
Сколько стоит полчаса без связи
Для площадки с почтовым сервером, сайтами и системами клиентов полчаса без связи — это недоставленные вовремя письма, недоступные сайты с заявками, остановленный сбор данных и вопросы от клиентов. Деньги здесь считаются так же, как при любом простое: выручка, которая проходит через эти системы за час, плюс время сотрудников. Если аварии повторяются, вторая площадка окупается быстро — особенно для почты, где резервный MX и копия ящиков у другого провайдера стоят недорого.
Вывод 1. Свой сервер — не значит одна площадка
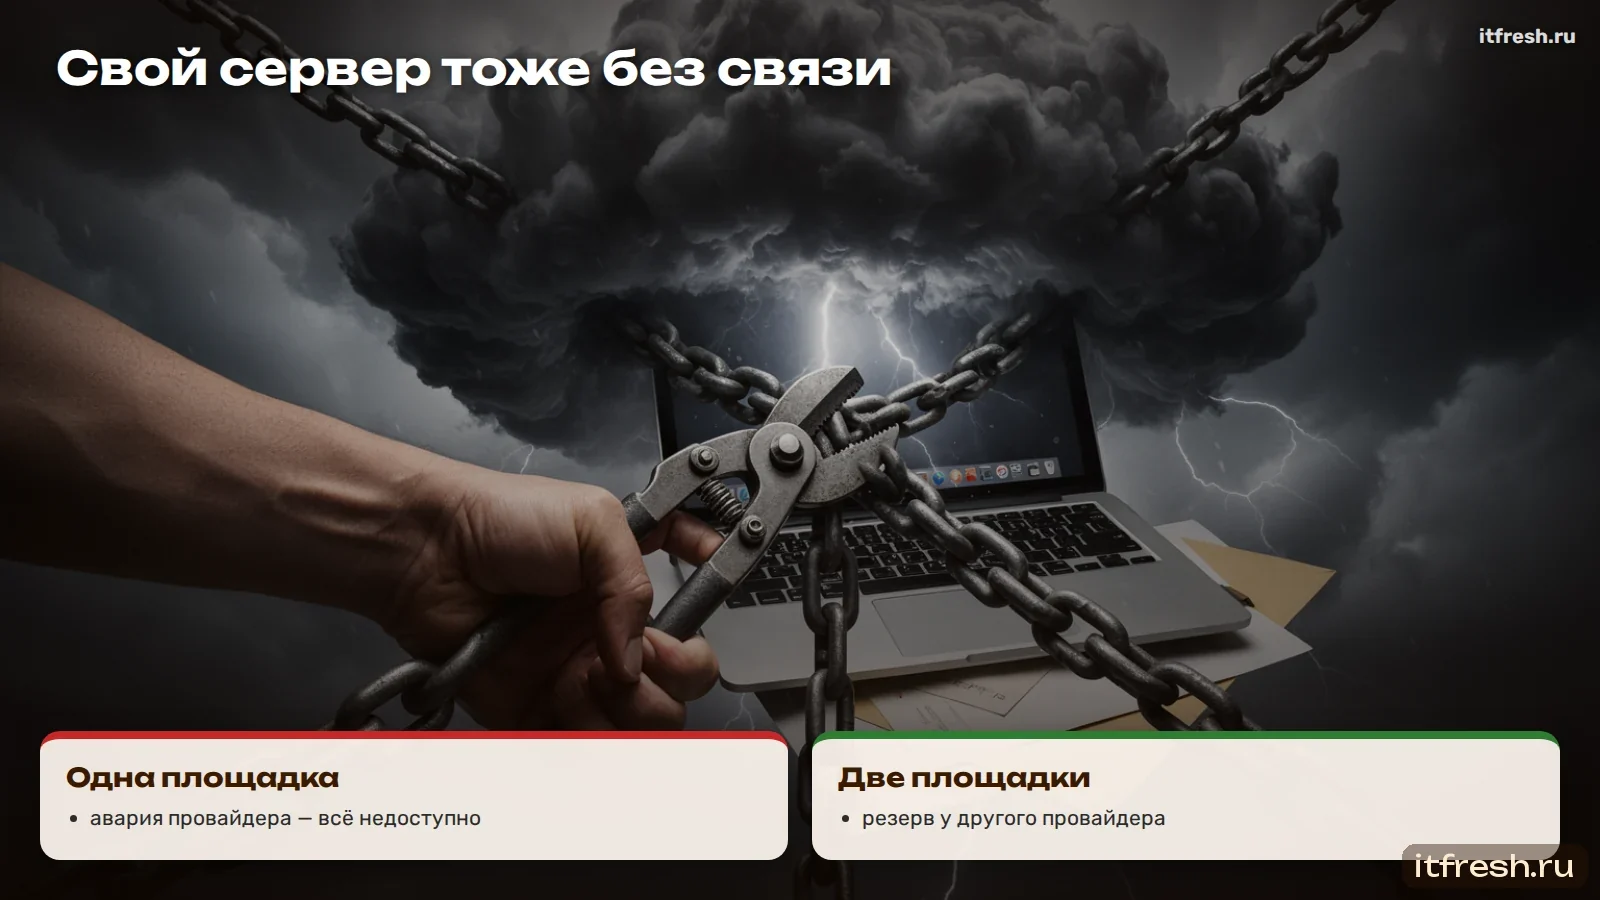
Своя почта и свои серверы надёжнее облака не потому, что не ломаются, а потому, что вы решаете, как их резервировать. Одна площадка — одна точка отказа, независимо от того, ваш там сервер или облачный. Поэтому критичные сервисы — почта, база знаний, сайты — должны иметь копию на площадке другого провайдера и порядок переключения.
Вывод 2. Мониторинг с независимых точек
Мониторинг, который работает с той же площадки, в аварию молчит вместе с ней. Проверки доступности должны идти с нескольких внешних точек у разных провайдеров, а оповещения — приходить в канал, не зависящий от площадки: мессенджер, а не почту на пострадавшем сервере. Мы получили оповещение об аварии через несколько минут и сообщение о восстановлении — сразу после него.
Вывод 3. Записывайте и сравнивайте
Вторая авария повторила первую почти один в один: то же время суток, та же длительность около получаса, тот же охват. Это видно только потому, что первая была записана с временем, охватом и методикой. Такие записи — аргумент в разговоре с провайдером и основание для решения о второй площадке. Если провайдер падает раз в месяц на полчаса в рабочее время, это уже не случайность, а характеристика площадки.
Вывод 4. Не трогайте исправное
Во время аварии провайдера руки тянутся что-то делать: перезагрузить маршрутизатор, перезапустить серверы. Если проверки показали, что ваше оборудование живо, — не трогайте его. Перезагрузка во время чужой аварии не ускорит восстановление, а может добавить свою проблему: служба не поднимется, диск не смонтируется. Мы сталкивались с тем, что после перезагрузки каталог данных монтировался раньше, чем файловая система, и программы видели пустую папку.
Чек-лист на случай недоступности площадки
Короткий порядок действий, который стоит распечатать.
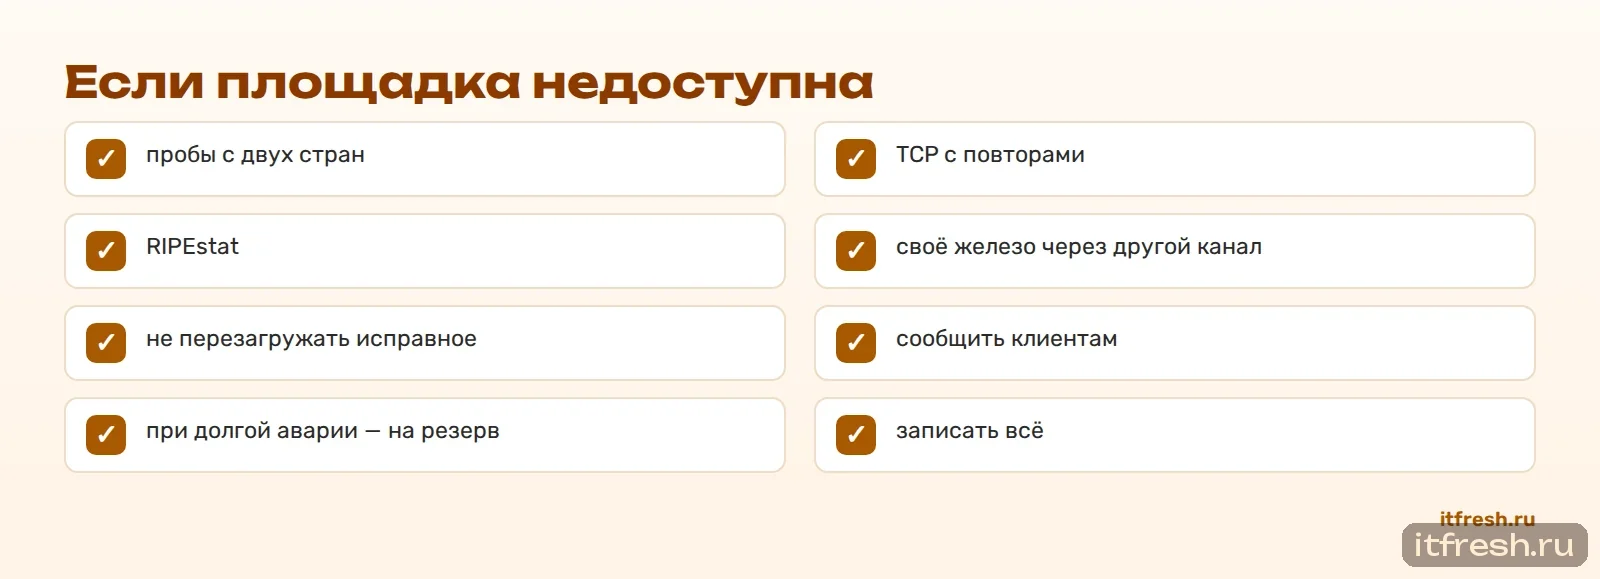
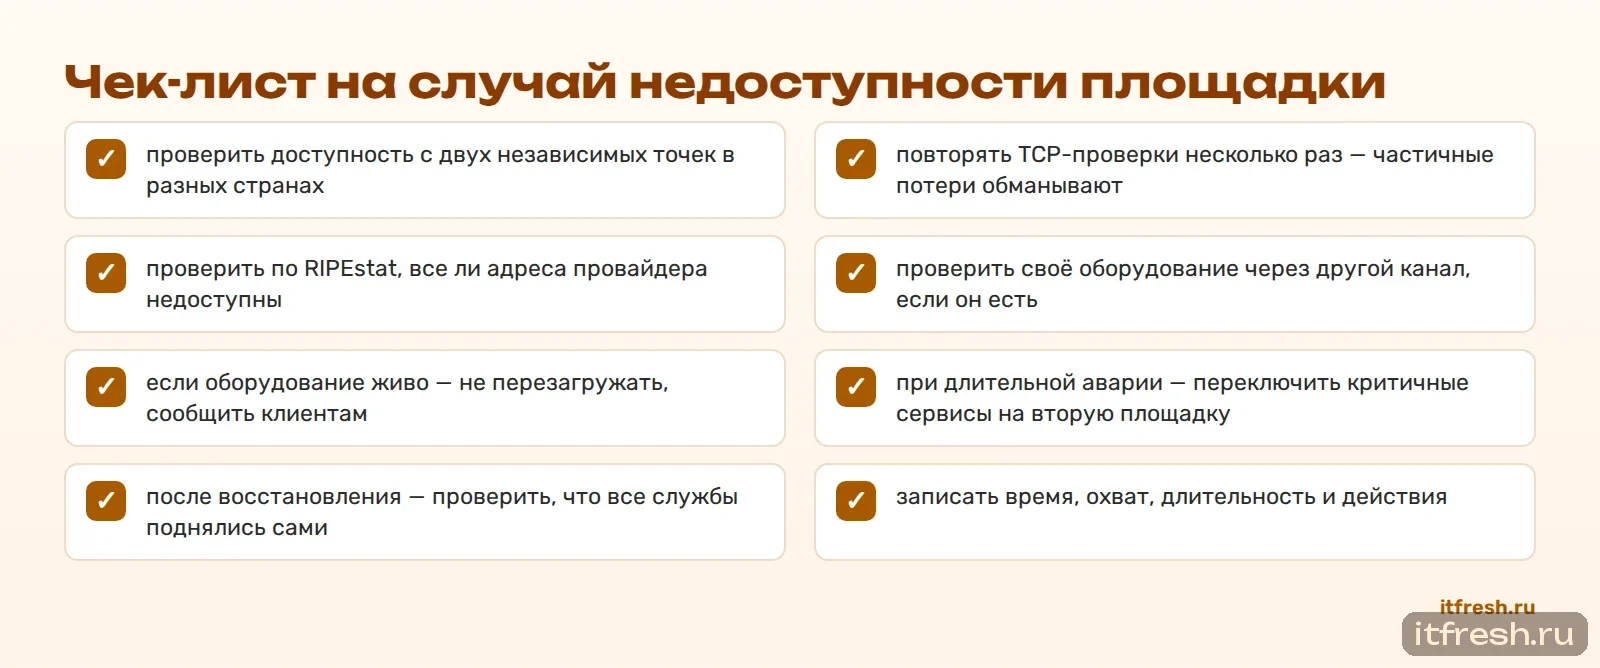
- проверить доступность с двух независимых точек в разных странах
- повторять TCP-проверки несколько раз — частичные потери обманывают
- проверить по RIPEstat, все ли адреса провайдера недоступны
- проверить своё оборудование через другой канал, если он есть
- если оборудование живо — не перезагружать, сообщить клиентам
- при длительной аварии — переключить критичные сервисы на вторую площадку
- после восстановления — проверить, что все службы поднялись сами
- записать время, охват, длительность и действия
Облако против своего: честное сравнение
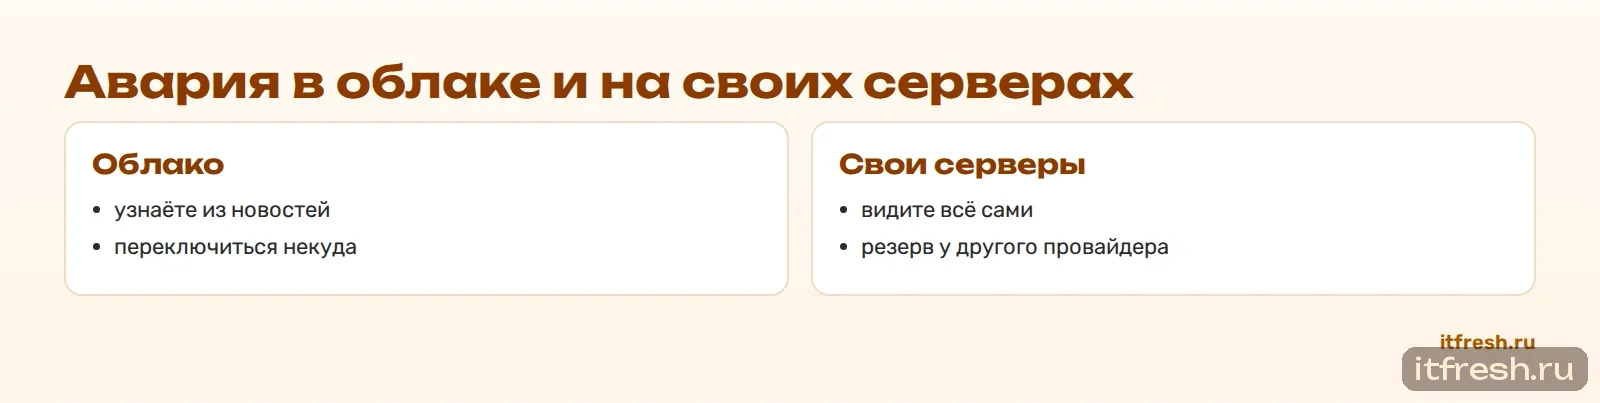
В облаке такая авария выглядит так же — только вы не можете проверить своё оборудование, не можете переключиться на свою вторую площадку и узнаёте о причинах из новостей. На своих серверах авария провайдера связи — это полчаса ожидания с полным пониманием происходящего и, при правильной архитектуре, автоматический переход на резерв. Об устройстве плана Б — в статье о непрерывности бизнеса, о выборе площадки — в статье о почтовом сервере на VPS.
Частые вопросы
Как понять, что авария у провайдера, а не у меня?
Проверить доступность с двух независимых точек в разных странах и посмотреть по RIPEstat, недоступны ли все адреса провайдера, включая его сайт.
Почему одной проверки мало?
При частичных потерях одна попытка соединения может не пройти и у живого сервера. Нужны несколько попыток с паузами.
Нужно ли перезагружать серверы во время аварии провайдера?
Нет, если проверки показали, что оборудование живо. Перезагрузка не ускорит восстановление и может добавить своих проблем.
Теряется ли почта при получасовой аварии?
Как правило, нет: отправители повторяют попытки. С резервным MX на другой площадке письма принимаются без задержки.
Зачем вторая площадка, если свой сервер надёжен?
Сервер может быть исправен, но без связи. Вторая площадка у другого провайдера защищает от аварии связи.
Откуда должен работать мониторинг?
С нескольких внешних точек у разных провайдеров, с оповещениями в канал, не зависящий от пострадавшей площадки.