
База знаний из открытых источников на своём ИИ-сервере: 170 тысяч документов, 435 тысяч фактов и ни одного запроса в облако
Облачная нейросеть уверенно отвечает на любой вопрос — и вы никогда не знаете, не выдумала ли она ответ. Отраслевая экспертиза сегодня рассыпана по тысячам статей, форумов, документов и видео — и облачные нейросети охотно предлагают «просто спросить у них». Но ответ облака — это чужая выборка источников, чужие фильтры и ваши вопросы на чужом сервере. Мы пошли другим путём: наша база знаний из открытых источников живёт на своём ИИ-сервере, в ней около 170 тысяч документов по девяти темам и 435 тысяч проверяемых фактов. Рассказываем, как устроен конвейер и где мы набили шишки.
Почему не спросить облачную нейросеть
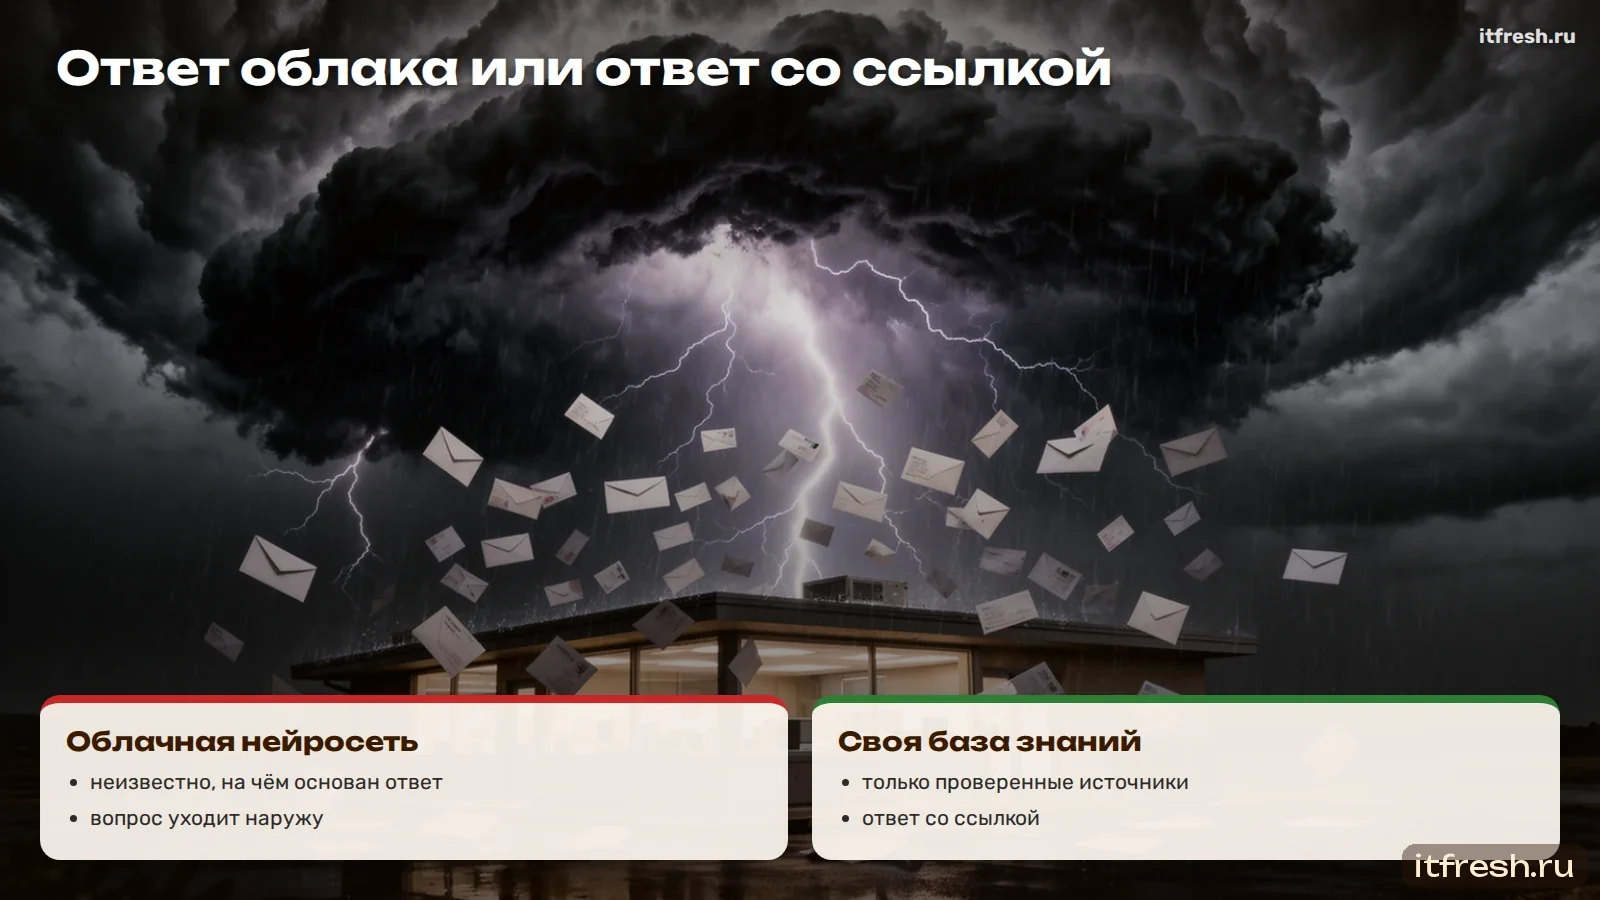
Облачная нейросеть отвечает уверенно, но вы не знаете, на чём основан ответ, насколько он свеж и не придуман ли он. Для бухгалтерии, маркировки товаров или настройки почтового сервера цена такой ошибки — штраф, остановленная отгрузка или потерянная почта. Кроме того, каждый вопрос с подробностями вашей ситуации уходит провайдеру.
Своя база знаний решает обе проблемы: ответы строятся только на документах, которые прошли отбор, со ссылками на источник, а вопросы не покидают сервер.
И третья проблема облака — доступность. Когда у облачного провайдера авария или новые ограничения, вопрос остаётся без ответа ровно тогда, когда он нужен. Своя база работает, пока работает ваш сервер.
Уверенная ложь опаснее незнания
Спросите облачный чат-бот о ставке налога, о порядке маркировки или об ошибке в 1С — он ответит гладко и уверенно. Иногда правильно. Иногда — придумав закон, которого нет, или ошибку, которой не бывает. Без ссылок на источники вы не отличите одно от другого, пока не получите штраф.
Мы построили свою базу знаний именно потому, что не можем позволить себе уверенную ложь. Каждый ответ — только по проверенным документам, со ссылкой, на своём сервере. Если ответа нет — система так и говорит.
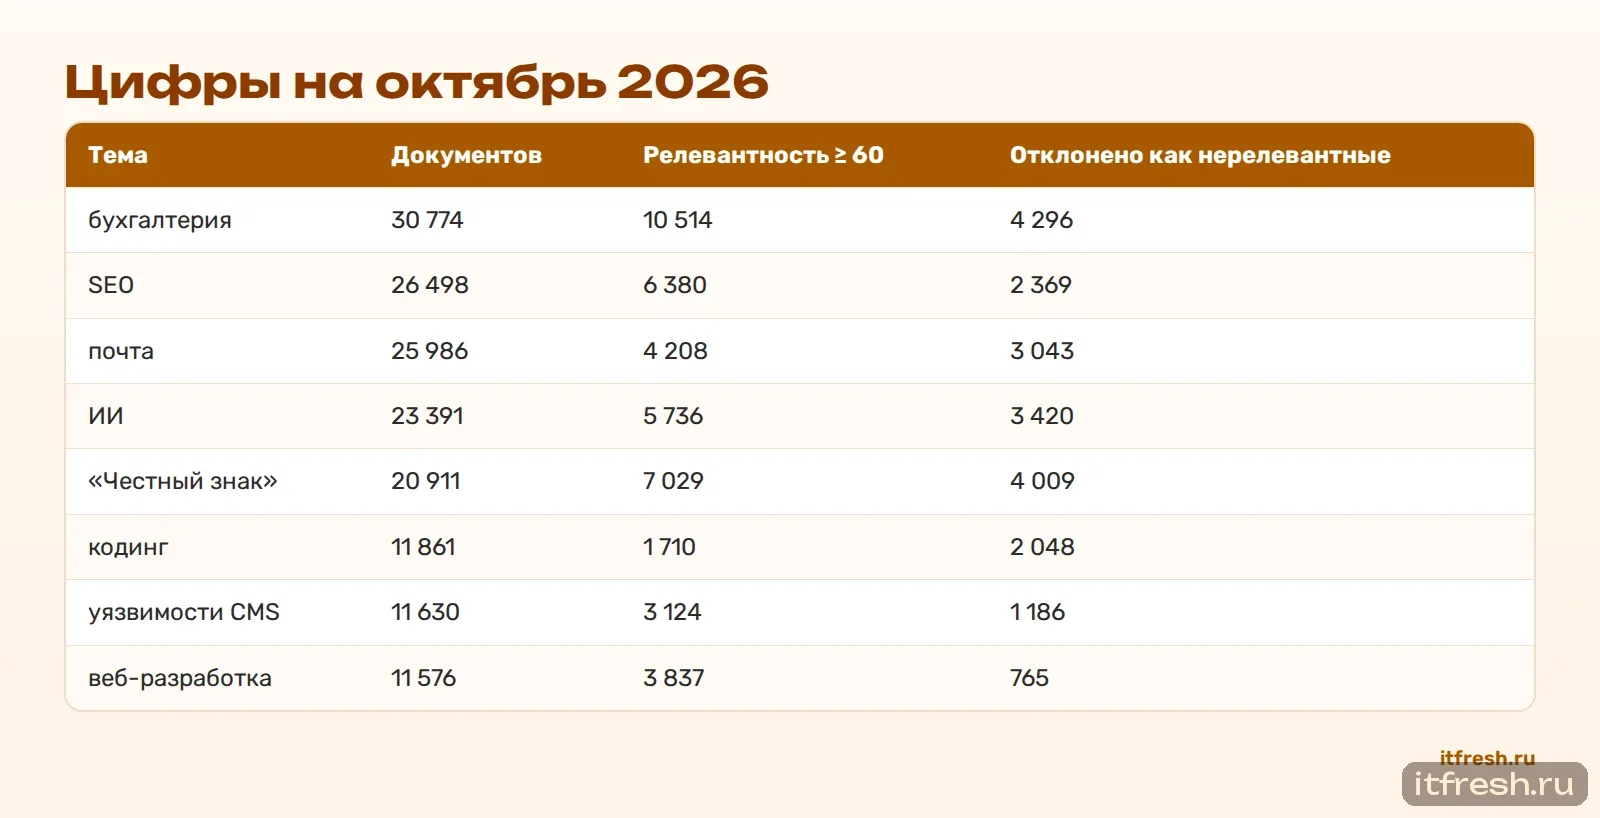
Цифры на октябрь 2026
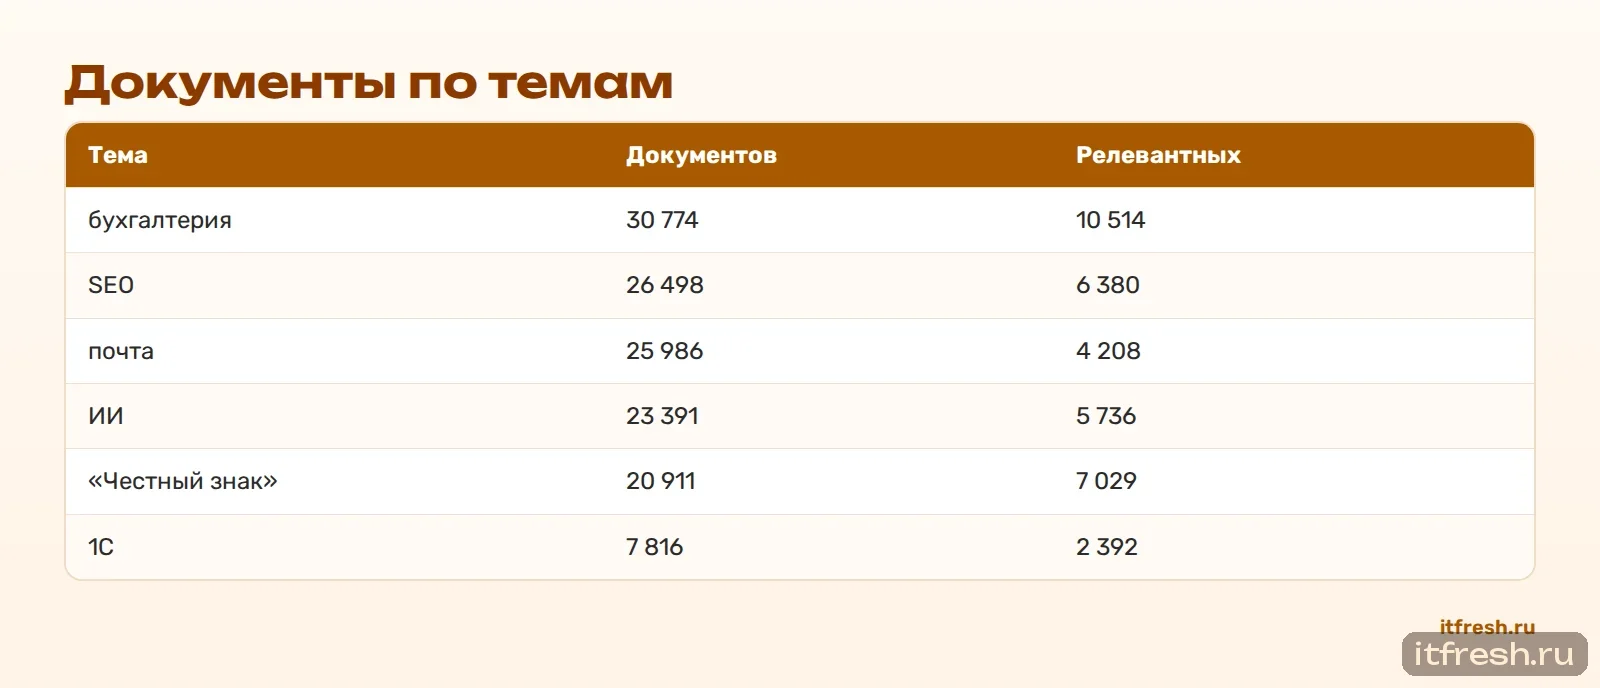
| Тема | Документов | Релевантность ≥ 60 | Отклонено как нерелевантные |
|---|---|---|---|
| бухгалтерия | 30 774 | 10 514 | 4 296 |
| SEO | 26 498 | 6 380 | 2 369 |
| почта | 25 986 | 4 208 | 3 043 |
| ИИ | 23 391 | 5 736 | 3 420 |
| «Честный знак» | 20 911 | 7 029 | 4 009 |
| кодинг | 11 861 | 1 710 | 2 048 |
| уязвимости CMS | 11 630 | 3 124 | 1 186 |
| веб-разработка | 11 576 | 3 837 | 765 |
| 1С | 7 816 | 2 392 | 524 |
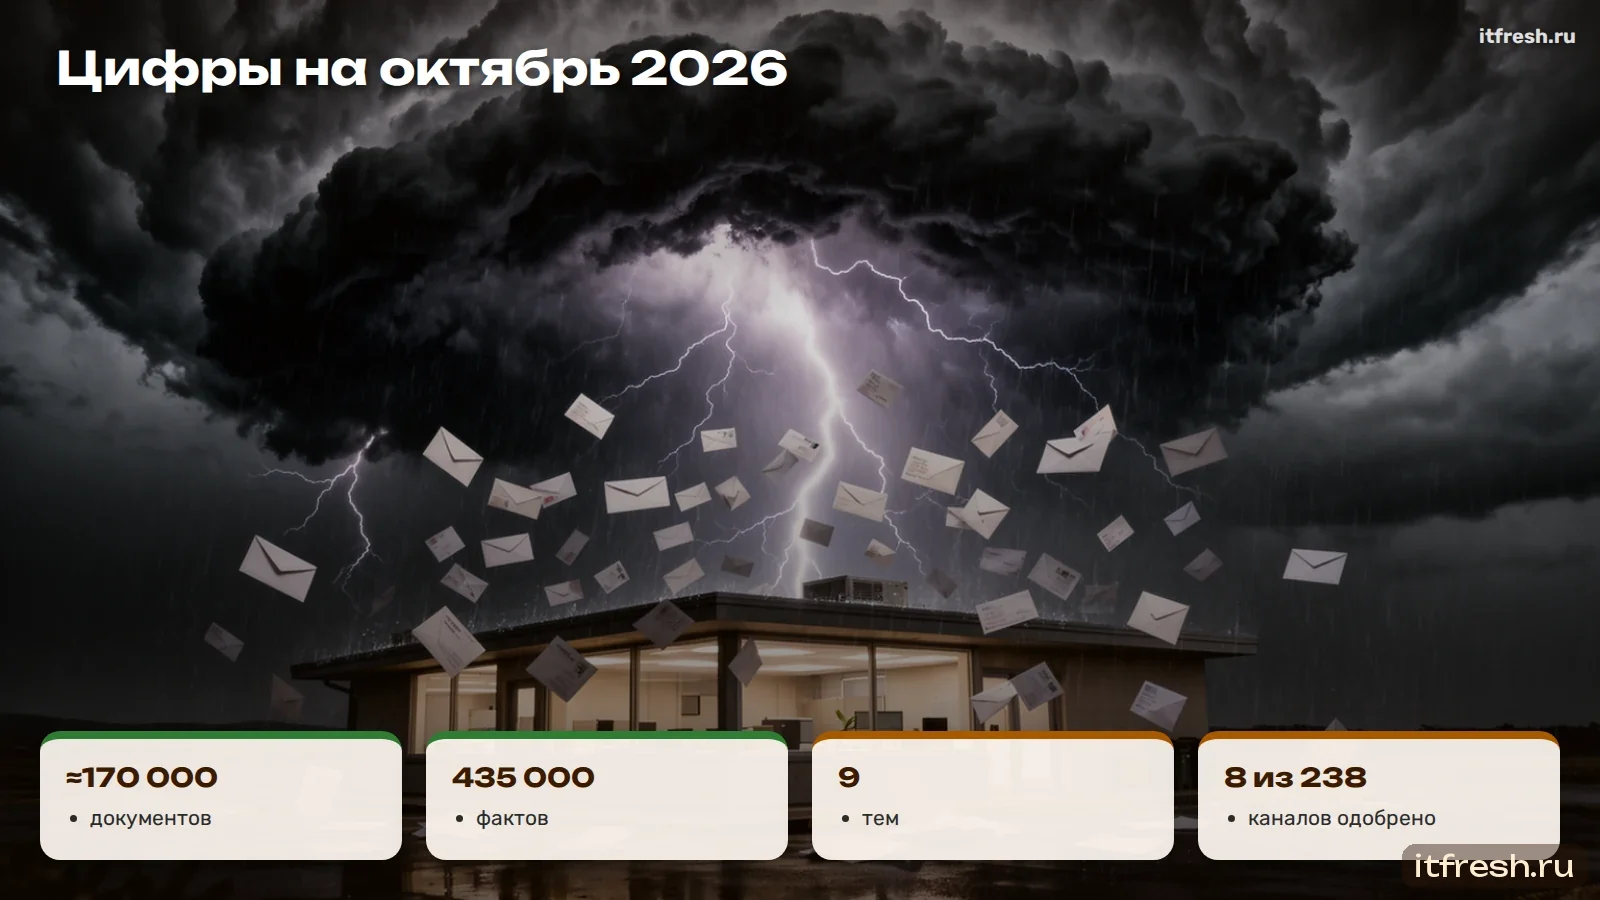
Всего — около 170 тысяч документов и 435 тысяч извлечённых фактов. Релевантность — оценка языковой модели от 0 до 100; в работу идут документы с оценкой 60 и выше, ниже 40 — отклоняются.
Почему именно эти темы
Темы выбраны по тому, с чем к нам приходят клиенты: бухгалтерия и 1С, маркировка «Честный знак», почта и её безопасность, уязвимости систем управления сайтами, веб-разработка, SEO, ИИ и разработка. В каждой из них ошибка дорого стоит, а информация быстро устаревает: меняются законы, версии программ, требования систем маркировки. База знаний обновляется постоянно, и мы видим, какие документы новые, а какие устарели.
Как составляются запросы
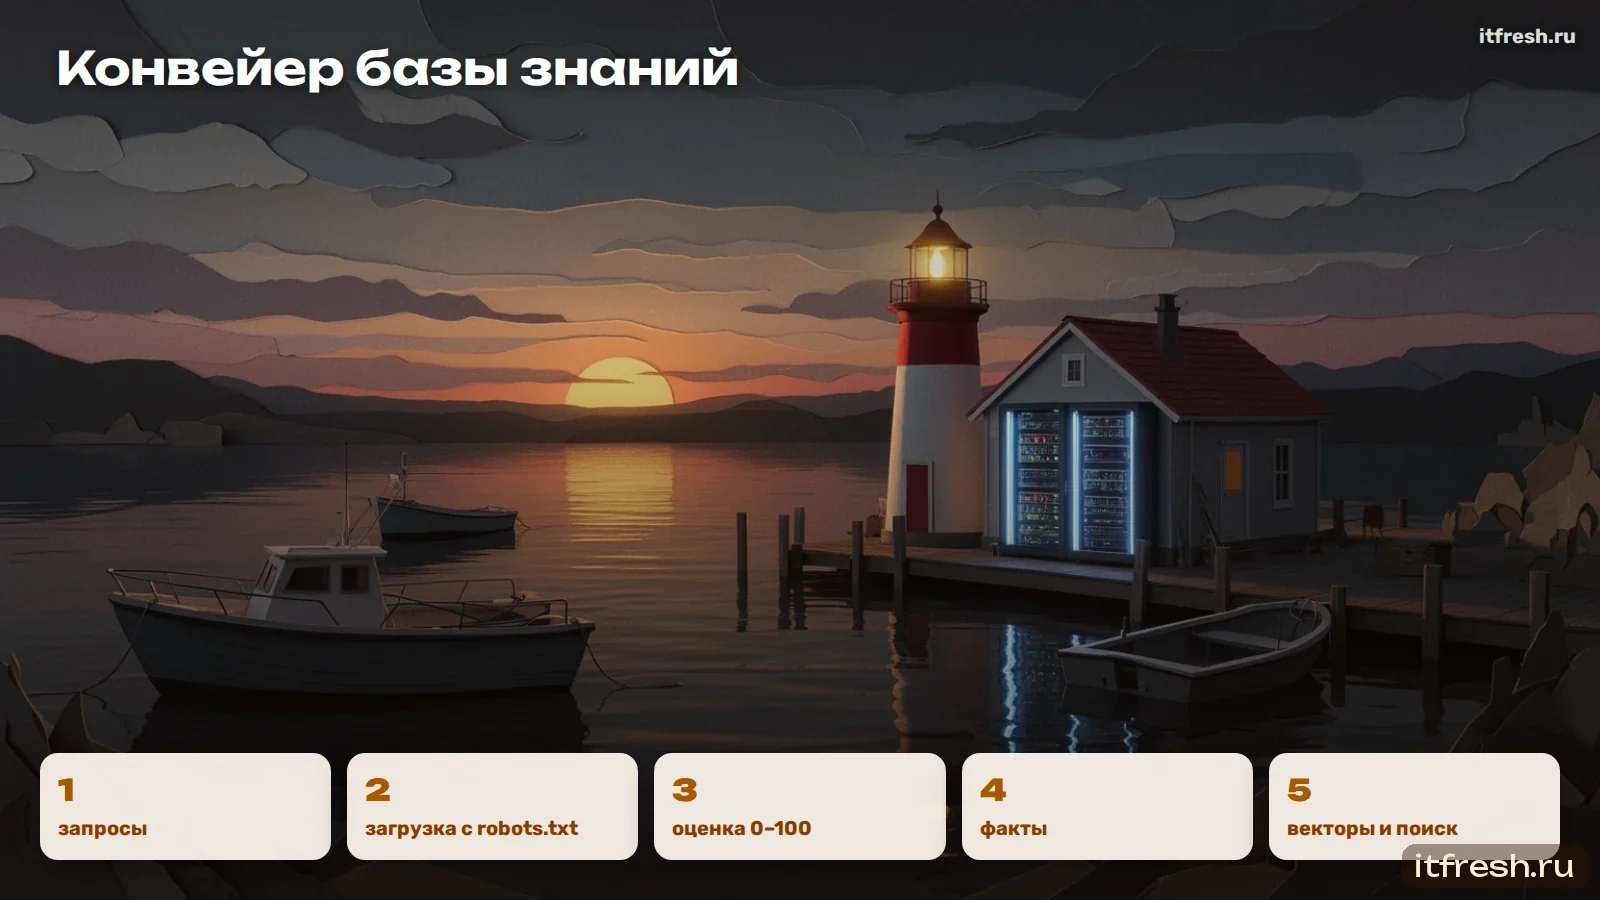
Качество базы начинается с запросов. Общий запрос вроде «маркировка товаров» приносит рекламу и новости. Узкий — «ошибка 1С при выводе из оборота кода маркировки» — приносит разборы практиков на форумах. Поэтому для каждой темы запросы строятся слоями: общие понятия, частые задачи, конкретные ошибки и их коды, нормативные документы, сравнения решений. Языковая модель помогает расширить список, но финальный список проверяет человек — иначе модель уводит тему в сторону.
Шаг 1. Поиск источников
Для каждой темы составляется список поисковых запросов — от общих до узких профессиональных. Конвейер прогоняет их через поисковые системы и собирает ссылки: статьи, форумы, документацию, нормативные акты, PDF. Дубли ссылок отсекаются сразу. На этом шаге важно разнообразие запросов: узкие формулировки находят практические разборы, которые не попадают в выдачу по общим.
Шаг 2. Загрузка с уважением к источникам
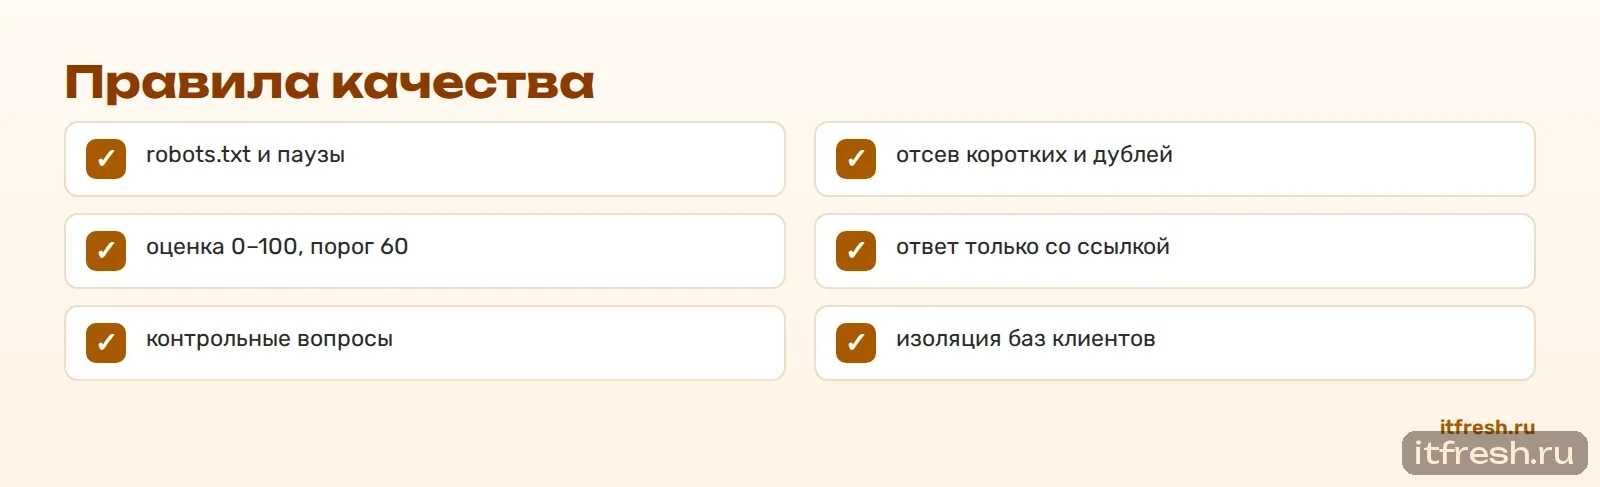
Загрузчик скачивает страницы и извлекает основной текст без меню и рекламы, PDF разбирает отдельно. Он соблюдает правила robots.txt сайтов, держит паузу в три секунды между запросами к одному домену и представляется честным User-Agent. Тексты используются только во внутреннем индексе и не публикуются. Слишком короткие страницы — меньше 400 символов — отбрасываются, дубли по хэшу текста отмечаются как повторы.
Часть источников недоступна из одной страны или ограничивает частые запросы, поэтому загрузка повторяется через другие выходы, но не больше двух попыток на документ.
Шаг 3. Оценка релевантности
Каждый загруженный документ оценивает языковая модель на своём сервере: насколько он полезен для темы, какого он типа — статья, ветка форума, документация, закон, — какая подтема. Оценка идёт пачками по восемь документов. Документы с оценкой ниже 40 отклоняются, от 60 и выше — идут дальше. На этом шаге отсеивается больше половины мусора: реклама без сути, новости ни о чём, страницы не по теме.
Модели иногда возвращают битый ответ на большую пачку. Тогда пачка автоматически делится пополам и оценивается заново — это простое правило сняло большую часть потерь на этом шаге.
Шаг 4. Факты
Из релевантных документов модель извлекает факты — короткие проверяемые утверждения со ссылкой на документ: какой срок, какая ставка, какой параметр, какая ошибка и как она лечится. Факты проще проверять и сравнивать, чем целые документы: противоречащие факты из разных источников сразу видны. Сейчас в базе 435 тысяч таких фактов.
Шаг 5. Векторы и поиск
Фрагменты документов и факты превращаются в векторы моделью эмбеддингов и складываются в PostgreSQL с pgvector. На вопрос пользователя система находит близкие по смыслу фрагменты и факты и передаёт их языковой модели, которая формулирует ответ строго по ним, со ссылками. Если подходящих фрагментов нет, правильный ответ — «в базе нет данных», а не выдумка.
Шаг 6. Видео и эксперты
Много практической экспертизы — в видео: вебинары, разборы, курсы. Конвейер находит каналы по теме, языковая модель оценивает, экспертный ли это канал или общий развлекательный, и только одобренные каналы попадают в расшифровку. Строгость здесь важна: из 238 проверенных каналов одобрено 8, отклонено 223, ещё 7 на проверке. Расшифровка идёт на процессоре шестью потоками faster-whisper, текст проходит тот же путь, что и документы.
Шаг 7. Досье по подтемам
Поверх базы строятся досье: для каждой крупной подтемы модель собирает раздел строго по проверенным фактам со ссылками. Это готовый материал для инженеров и для статей — не пересказ интернета, а свод фактов с источниками, который можно проверить.
Проверка качества на контрольных вопросах
Раз в несколько дней по базе прогоняется набор контрольных вопросов с заранее известными ответами и источниками. Проверяется три вещи: нашла ли система правильные фрагменты, правильно ли модель сформулировала ответ, не отказалась ли она отвечать там, где ответ в базе есть. Одна такая проверка показала, что помощник отказывался отвечать на половину вопросов с ответами в базе: порог близости был слишком строгим. После настройки доля ложных отказов резко упала. Без таких проверок база тихо деградирует, и никто этого не замечает.
Когда видеокарты заняты
Видеокарты сервера нужны не только базе знаний — на них же рисуются иллюстрации и работают другие задачи. Чтобы конвейер не вставал, оценка релевантности умеет работать на процессорных версиях моделей: медленнее, но непрерывно. Когда видеокарты освобождаются, основной поток оценки на большой модели возобновляется с того места, где был поставлен на паузу.
Доступ и безопасность
База знаний доступна сотрудникам через внутренний сервис с авторизацией, а внешним специалистам — только к своей теме и только на чтение. Учётные записи базы данных разделены: конвейер пишет, помощник читает, специалист видит только свою тему. Сервер с базой не принимает подключения из интернета, а выход наружу есть только у загрузчика. Секреты подключения хранятся в менеджере паролей, а не в файлах конфигурации.
Что это даёт клиентам
Для клиентов это значит быстрые и проверяемые ответы: на вопрос про ошибку в 1С, настройку почтового сервера или требование маркировки инженер находит в базе разборы практиков и нормативные документы со ссылками за минуты, а не за часы поиска. Статьи на нашем сайте тоже опираются на эту базу — поэтому в них конкретные цифры, команды и ссылки, а не общие слова.
Как устроено хранение
Всё хранится в одной базе PostgreSQL: таблица документов с текстом, статусом, оценкой и метаданными, таблица фактов со ссылками на документы, таблица каналов-экспертов, таблицы векторов для поиска. Статус документа показывает, на каком шаге он находится: новый, загружен, оценён, отклонён как дубль или нерелевантный, готов к векторизации. Это позволяет в любой момент увидеть, где копится очередь, и перезапустить нужный шаг, не трогая остальные. База лежит на ZFS со снимками по расписанию, копии уходят в отдельный пул.
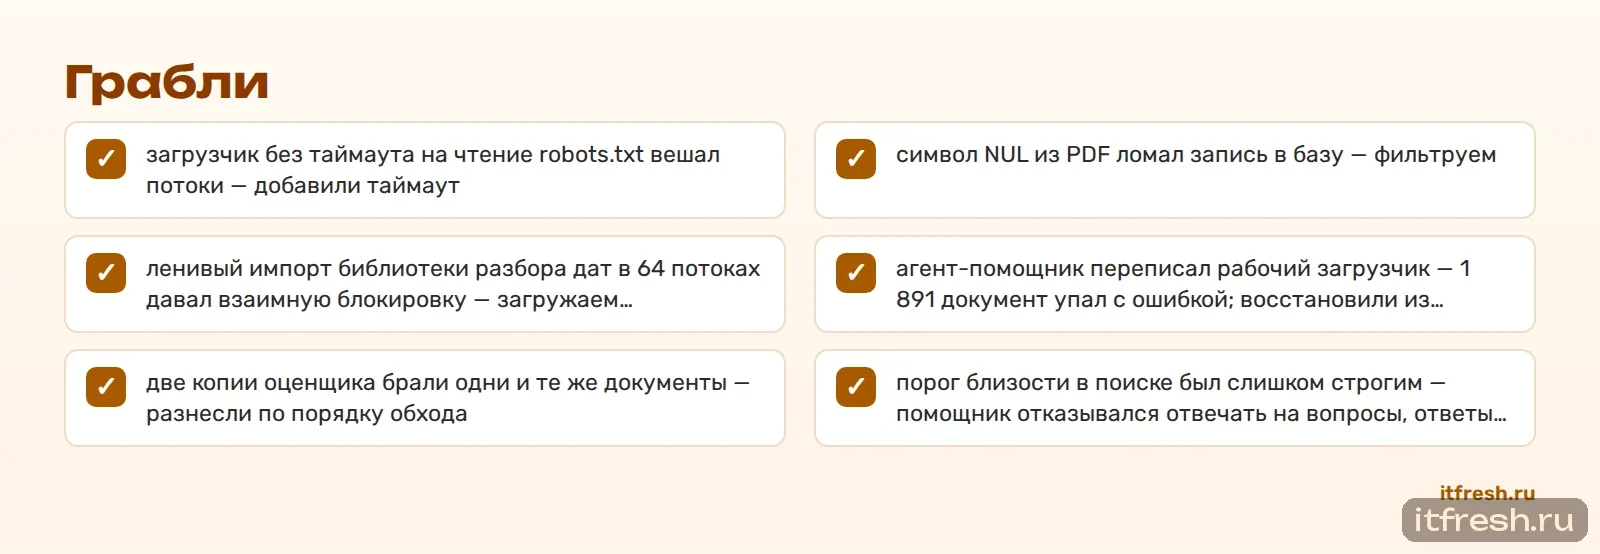
Грабли
Самые дорогие ошибки, которые мы сделали и исправили.
- загрузчик без таймаута на чтение robots.txt вешал потоки — добавили таймаут
- символ NUL из PDF ломал запись в базу — фильтруем
- ленивый импорт библиотеки разбора дат в 64 потоках давал взаимную блокировку — загружаем заранее
- агент-помощник переписал рабочий загрузчик — 1 891 документ упал с ошибкой; восстановили из копии, правила изменений ужесточили
- две копии оценщика брали одни и те же документы — разнесли по порядку обхода
- порог близости в поиске был слишком строгим — помощник отказывался отвечать на вопросы, ответы на которые были в базе
Сколько ресурсов это требует
Конвейер работает на сервере с двумя RTX 3090: языковая модель для оценки и фактов — на видеокартах, модель эмбеддингов — там же, расшифровка — на 64 ядрах процессора, загрузка — сетевые потоки. Когда видеокарты заняты другой работой, оценка продолжается медленнее на процессорных моделях. Устройство сервера — в статье о своём ИИ-сервере на двух RTX 3090.
Как этим пользоваться в компании
Тот же подход работает для внутренних документов: регламенты, договоры, инструкции, переписка с клиентами. Разница только в источнике — вместо поиска в интернете документы берутся из файловых хранилищ и систем компании. Как сделать помощника по внутренним документам — в статье о чат-боте по документам компании. Для небольшой компании хватит одной видеокарты — в статье о локальной языковой модели для малого бизнеса.
Качество важнее объёма
Соблазн — набрать как можно больше документов. Но база знаний ценна не размером, а тем, насколько ей можно верить. Поэтому у нас на каждом шаге отсев: короткие страницы, дубли, нерелевантные документы, неэкспертные каналы. Регулярная проверка на контрольных вопросах показывает, не начал ли помощник выдумывать или отказываться. И главное правило: ответ без ссылки на источник — не ответ.
Устаревание и обновление
Знания устаревают: выходит новая версия 1С, меняется порядок работы с маркировкой, обновляется почтовая сборка. Поэтому у каждого документа хранится дата публикации и дата загрузки, а при поиске свежие источники получают приоритет. Подтемы, где идут изменения, конвейер периодически перепроверяет новыми запросами. Факты из разных лет, противоречащие друг другу, помечаются: ответ должен опираться на актуальный, а старый оставаться для истории.
Что нельзя делать
Несколько принципов, которые мы держим жёстко. Не публиковать чужие тексты из базы — она внутренняя, для поиска и проверки фактов. Не обходить запреты сайтов на сбор. Не давать модели отвечать без источника. Не позволять автоматическим агентам править рабочие скрипты конвейера напрямую — только через копию, тест и журнал. Не смешивать базы разных клиентов: база по документам конкретной компании изолирована от общей отраслевой.
Как начать у себя
Начните с одной темы и сотни-другой документов, а не с девяти тем сразу. Отработайте весь путь: загрузка, оценка, факты, поиск, ответ со ссылкой, контрольные вопросы. Когда качество устраивает, масштабируйте — добавляйте темы, источники, видео. Для старта хватит сервера с одной видеокартой на 24 ГБ, а сбор и оценка могут идти в фоне круглые сутки. Пример чат-бота по базе знаний — в статье о чат-боте по базе знаний компании.
Итог
Своя база знаний из открытых источников — это не замена специалисту, а его усилитель: быстрый поиск по десяткам тысяч проверенных документов с фактами и ссылками, без отправки вопросов в чужое облако. Её можно построить на одном сервере с видеокартами и открытых моделях. Главное — дисциплина на каждом шаге конвейера и регулярная проверка качества.
Частые вопросы
Сколько документов в базе знаний?
Около 170 тысяч документов по девяти темам и 435 тысяч извлечённых фактов на октябрь 2026 года.
Как отсеиваются нерелевантные документы?
Языковая модель на своём сервере ставит оценку 0–100: ниже 40 — отклоняется, от 60 — идёт в работу.
Соблюдаются ли права источников?
Загрузчик уважает robots.txt, делает паузы между запросами к сайту, тексты используются только во внутреннем индексе и не публикуются.
Как в базу попадают видео?
Через одобренные экспертные каналы: из 238 проверенных одобрено 8. Видео расшифровывается на процессоре faster-whisper.
Что делать, если в базе нет ответа?
Помощник должен честно ответить, что данных нет, а не выдумывать. Это проверяется контрольными вопросами.
Можно ли так сделать базу по документам компании?
Да, тот же конвейер работает с внутренними регламентами, договорами и инструкциями на вашем сервере.