
Внутренняя платформа разработки без лишней сложности
Platform Engineering нужен небольшой команде не ради модного названия, а когда люди снова и снова вручную настраивают окружения, собирают релизы и ищут нужные инструкции. Я покажу, какие повторяющиеся задачи имеет смысл упорядочить, как собрать минимальный рабочий процесс и по каким признакам понять, что платформу пора расширять.
Что платформа даёт небольшой команде
Platform Engineering — это работа над внутренними инструментами и правилами, которые помогают разработчикам получать нужное окружение, запускать проверки и выпускать изменения одинаковым способом. Внутренняя платформа может быть набором шаблонов, документации и автоматизации; отдельный портал самообслуживания ей не обязателен. Начинаю с повторяемых операций, а не с покупки новой системы. Если команда раз в неделю по-разному собирает один и тот же релиз, проблема уже видна без презентации на сорок слайдов.
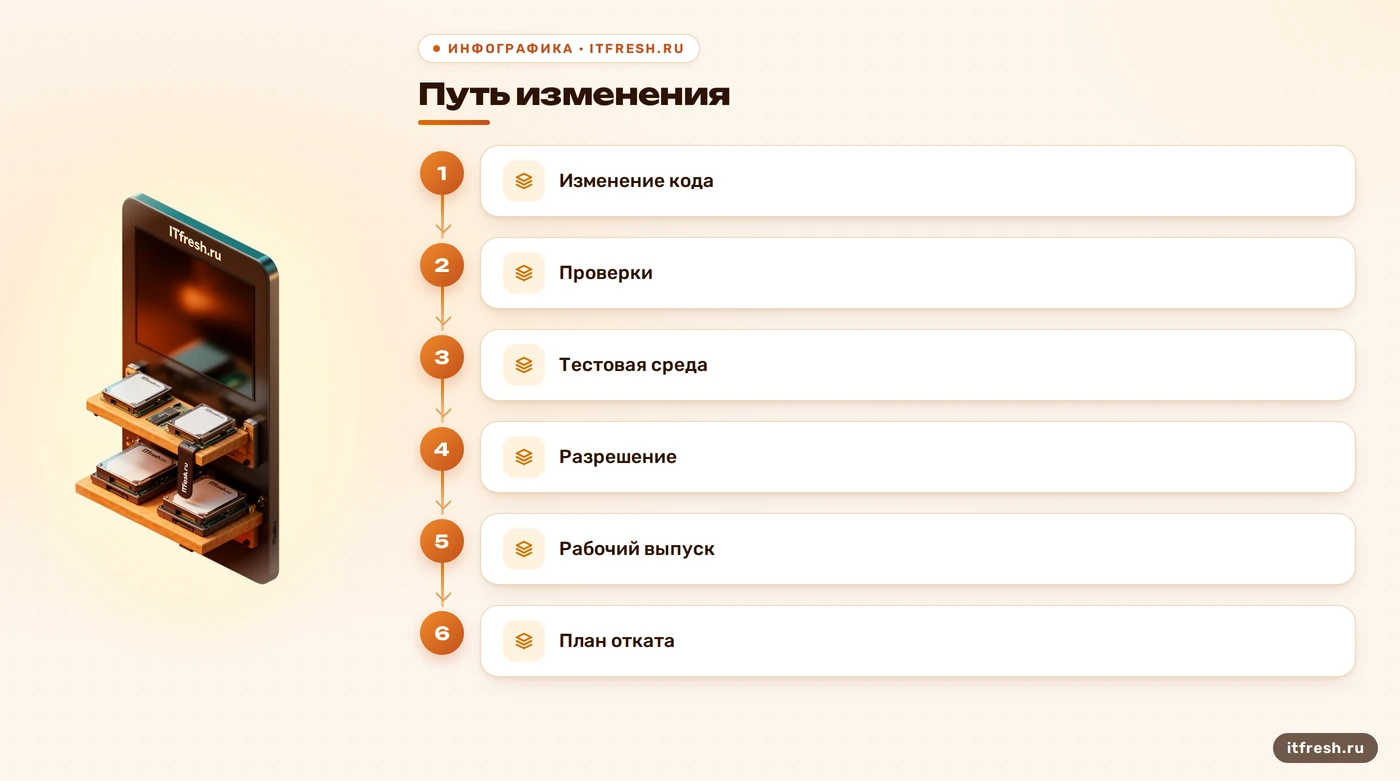
Польза появляется там, где повторяются ручные действия: подготовка тестовой среды, проверка кода, сборка пакета, публикация и передача дежурному. Я фиксирую порядок, владельца каждого шага и способ отката. Для одного проекта это может быть короткая инструкция и скрипт. Для нескольких — общий шаблон CI/CD и единая структура конфигурации. Слово «платформа» не превращает маленькую автоматизацию в отдельный департамент.
Не обещаю, что после настройки разработчик станет выпускать каждую функцию за час. На скорость влияют проверки, согласования, архитектура и готовность продукта. Зато можно сделать сам путь изменения понятным: видно, где оно проверяется, кто разрешил выпуск и что делать при ошибке. Это убирает часть случайных действий и облегчает передачу проекта между сотрудниками.
Я бы начал с одной заметной боли и сравнил процесс до и после по фактическим данным: сколько ручных шагов, где чаще ждут и на каком этапе возникают возвраты. Не надо приписывать результат платформе, если одновременно изменили команду, продукт и график релизов. Иначе красивые проценты останутся красивыми только в статье.
- Запишите повторяющиеся операции и их владельцев.
- Выберите один процесс, который чаще всего задерживает работу.
- Опишите проверку результата и порядок возврата изменений.
Как устроен небольшой практический сценарий
В исходном черновике ООО «Сапфир» описывалось как веб-агентство с измеренными результатами: конкретным сроком проекта, процентом падения инцидентов и ускорением релизов. Проверяемых материалов, подтверждающих эти показатели, нет, поэтому я не выдаю их за реальный опыт. Ниже — учебный сценарий для компании из поля company: он показывает возможный порядок работ, но не обещает фактический эффект и не является подтверждённым кейсом.
Представим, что команда «Сапфира» вручную передаёт изменения на тестовый сервер, а параметры окружения хранятся в нескольких местах. Первый шаг — описать один проект: от коммита до проверки на тестовом стенде. Затем выбрать одно хранилище исходников, завести простой CI-процесс и согласовать, кто может разрешить выпуск в рабочую среду. Конкретные инструменты выбирают по текущему стеку, имеющимся навыкам и требованиям к доступу.
Пайплайн может последовательно запускать линтер или тесты, собирать артефакт и передавать его на тестовую среду. Названия этапов вроде lint, test и deploy — условные: набор проверок задаёт сам проект. Для выпуска в рабочую среду полезно отдельно определить разрешение, окно работ и способ отката. Кнопка Deploy без этих договорённостей лишь переносит ручную ошибку в интерфейс.
После пилота фиксируют не рекламный процент, а наблюдаемые показатели: сколько действий выполняется вручную, сколько раз запуск прерывался и сколько времени занял конкретный выпуск. Сравнение имеет смысл, только если одинаково считать интервалы и похожие изменения. Если измерений нет, так и пишем: процесс стал повторяемым, а экономию времени ещё нужно проверить. Честная оговорка полезнее точного числа, взятого с потолка.
- Описать один путь изменения от коммита до проверки.
- Добавить автоматические проверки, которые уже нужны проекту.
- Разделить тестовый запуск и разрешение на рабочий выпуск.
Какие инструменты выбрать и где границы
Для исходников и проверок подойдёт Git-сервис с CI/CD; GitLab Self-Managed, например, включает возможности CI/CD в продукт, но отдельные функции могут зависеть от уровня подписки. Для выбранной редакции заранее сверяйте матрицу возможностей. Существующий GitHub-репозиторий тоже можно подключить к GitLab CI/CD через зеркалирование, однако GitLab относит настройку CI/CD для внешних репозиториев к Premium и Ultimate. Поэтому утверждение «любой тариф умеет всё» было бы неверным.
Docker Compose удобно использовать, когда проекту нужно согласованно запускать приложение и связанные с ним службы на одной машине или в среде разработки. Это описание конкретного инструмента, а не рекомендация переносить на него любую рабочую систему. Решение о контейнерах принимают по требованиям проекта и эксплуатации; автоматизация должна помогать повторить сборку, а хранение данных, резервные копии и обновления требуют отдельного плана.
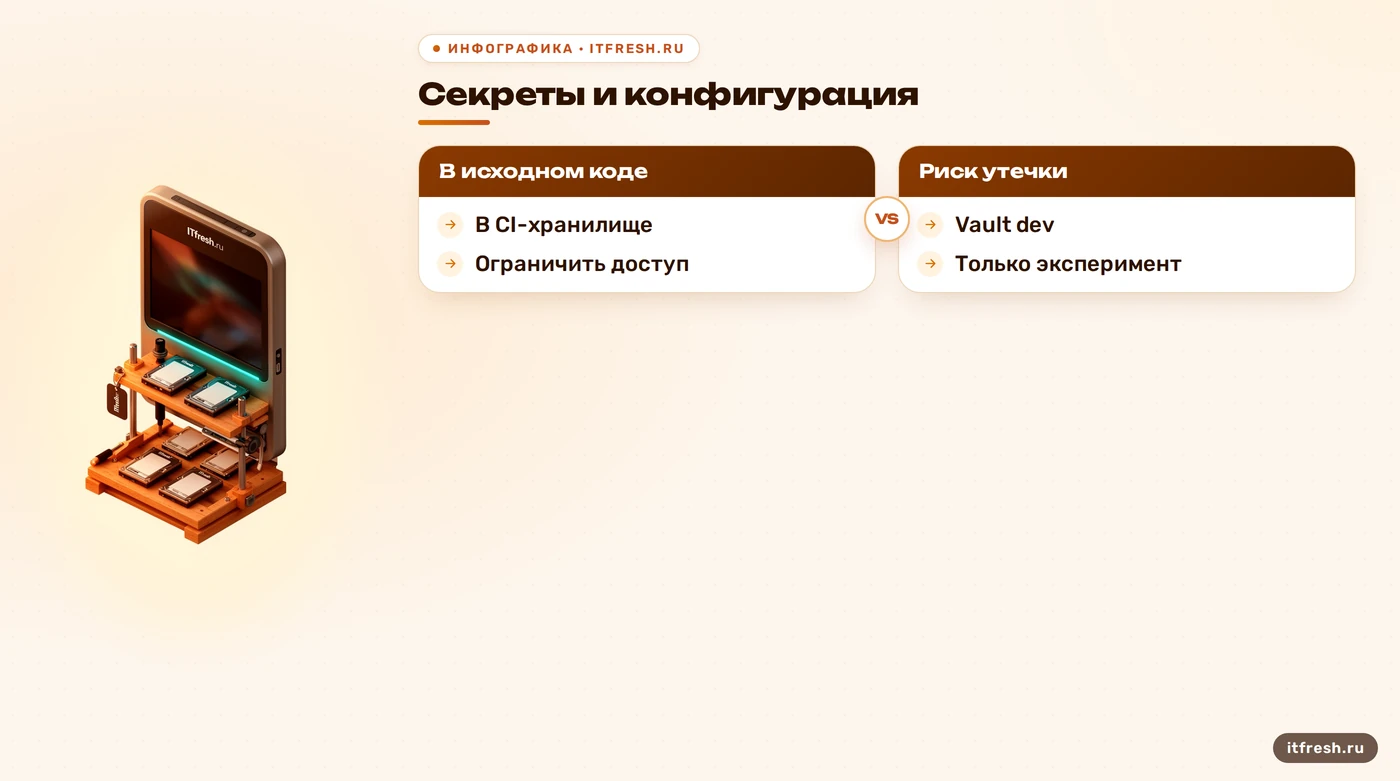
Секреты — пароли, токены и ключи — нельзя записывать в исходный код или помещать в публично доступные файлы. Для небольшой команды начните с доступов, которые предоставляет выбранный CI-сервис, ограничьте круг пользователей и проверьте, кто может читать значения. HashiCorp Vault в режиме dev годится для экспериментов: он использует память, работает с небезопасными настройками и теряет данные при остановке. Для рабочей среды этот режим прямо запрещён документацией.
Prometheus собирает метрики с настроенных целей через раздел scrape_configs; само наличие Prometheus не означает, что он автоматически увидит все приложения. Надо понять, какой компонент отдаёт метрики, по какому адресу он доступен и что считать сбоем. Grafana может показать эти данные на панелях, но красивый график без порога и ответственного — просто обои с цифрами.
Не выбирайте Kubernetes по числу сервисов из случайной таблицы. Он добавляет собственные компоненты и обязанности по эксплуатации, поэтому решение зависит от отказоустойчивости, масштабирования, распределения команды и уже используемой инфраструктуры. Если текущая задача — одинаково запускать несколько процессов на одном сервере, начните с более простого инструмента. Когда появится измеримая причина менять устройство системы, вернитесь к выбору.
- Git-сервис и CI/CD — хранить исходники и запускать проверки.
- Docker Compose — описывать связанные контейнеры проекта.
- Prometheus — собирать метрики с явно настроенных целей.
- Менеджер секретов — хранить чувствительные значения с контролем доступа.
План внедрения: от одной боли к рабочему процессу
Сначала составьте карту текущего процесса на одном проекте: от изменения в коде до результата, доступного пользователю. Отметьте ручные передачи, ожидания, повторяющиеся ошибки и места, где нужен человек. Не измеряйте «эффективность инженера» по числу коммитов: это не ответит, где теряется время. Для более широкого списка практик можно посмотреть материал об автоматизации CI/CD — применяйте только то, что подходит вашему процессу.
Затем договоритесь о минимальном стандарте: какие проверки обязательны, кто отвечает за шаблоны, куда записывают настройки и кто разрешает рабочий выпуск. Разделите параметры, которые безопасно хранить рядом с проектом, и секреты, для которых нужны защищённое хранилище и ограниченные права. Удобство не отменяет контроль: если любой участник может изменить production-секрет, автоматизация не исправила модель доступа.
Настройте один пайплайн и сначала запускайте его на тестовом проекте или безопасной среде. Перед переносом проверьте, что сборка получает нужные зависимости, переменные не попадают в журналы, а артефакт можно идентифицировать. Для метрик заранее определите цель сбора и проверьте, что она доступна Prometheus. Для GitLab CI/CD используйте актуальную документацию именно своей редакции и версии: названия пунктов меню и доступность функций меняются.
Проверьте восстановление, а не только создание резервной копии. Для репозитория, конфигураций и данных приложений могут требоваться разные процедуры восстановления. Зафиксируйте, кто выполняет восстановление и каким способом проверить результат. Бэкап, который никогда не пробовали вернуть, пока остаётся гипотезой. Эту простую мысль обычно вспоминают как раз тогда, когда срочно нужно вернуть проект.
После пилота спросите команду, какой ручной шаг действительно исчез, где запуск всё ещё ломается и что мешает поддержке. Если шаблон сложен в изменении и понятен только одному автору, это не стандарт, а новая зависимость. Сократите его до нужного уровня или назначьте владельца и документацию. Добавляйте сервисы по фактической потребности — не потому, что их назвали в презентации.
Поддерживайте инструкции рядом с кодом или в согласованном месте, а изменения платформы проводите как изменения продукта: с проверкой, ответственным и планом отката. Не переносите на общий шаблон настройки одного необычного проекта, пока не ясно, что они нужны другим. Один общий путь для типового случая и отдельное, документированное исключение часто полезнее универсальной конструкции, которую никто не решается менять.
- Описать процесс и выбрать одну точку потерь.
- Создать шаблон проверки и тестовый запуск.
- Проверить доступы, секреты, восстановление и откат.
- Собрать обратную связь и решить, что менять дальше.
Когда платформу пока не стоит строить
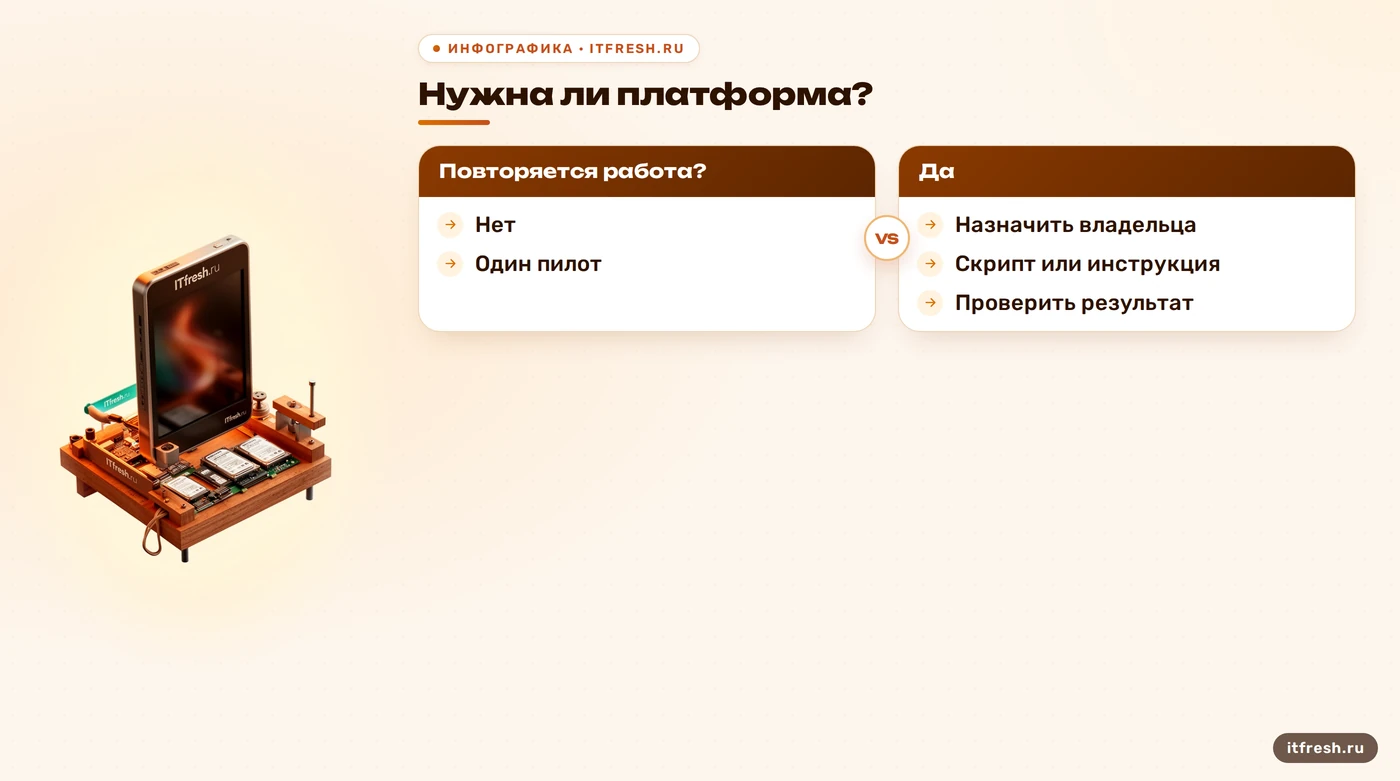
Если задачи почти не повторяются, команда мала и текущий порядок не создаёт задержек или заметных ошибок, отдельная платформа может добавить обслуживания без ощутимой пользы. Число разработчиков и бюджет в рублях сами по себе не дают правильного порога: у одной команды повторяется десяток одинаковых релизов, у другой несколько проектов живут независимо. Смотрите на повторяемость работы, цену ручных ошибок и наличие людей, готовых поддерживать автоматизацию.
Иногда достаточно одного скрипта, документации и понятного владельца. Это полноценное улучшение процесса, даже если никто не называет его платформой. Если скрипт знают только по имени файла, хранится у одного сотрудника и не имеет безопасного способа запуска, запишите назначение и ограничения. Решение должно пережить отпуск автора, иначе автоматизация всего лишь спрятала ручную операцию.
Не копируйте архитектуру крупной компании с другой нагрузкой и другими обязанностями. Сложный кластер не делает деплой предсказуемым сам по себе, а три дашборда не заменяют дежурство и порядок реакции. Сначала определите, какое решение сотрудник примет по сигналу мониторинга. Если ответа нет, не плодите сигналы. Для связанных технических задач полезно сравнить подходы в статье про Docker и CI, сверяя их с собственным окружением.
Остановитесь и пересмотрите решение, если общий шаблон мешает особенностям продукта, CI запускает дорогие ненужные проверки или никто не отвечает за обновления. Это не провал внедрения: платформа должна обслуживать работу, а не требовать работу ради своего существования. Оставьте полезные части и удалите лишнее. Иногда правильный итог аудита — не новый сервис, а ясная инструкция и один ответственный.
- Нет повторяемого процесса — нет задачи для платформы.
- Нет владельца поддержки — сначала назначьте его.
- Если простой вариант решает боль, не усложняйте.
Частые вопросы
Нужен ли Kubernetes для внутренней платформы?
Не обязательно. Выбирайте оркестрацию по требованиям к отказоустойчивости, масштабированию и эксплуатации, а не по универсальному порогу числа сервисов.
Можно ли оставить репозиторий на GitHub и использовать GitLab CI/CD?
Да, GitLab документирует подключение внешних репозиториев через зеркалирование. Эта функция требует Premium или Ultimate; проверьте тариф и ограничения до настройки.
Подходит ли Vault dev для хранения рабочих секретов?
Нет. Режим dev работает в памяти, использует небезопасные настройки и теряет данные после остановки. Используйте его только для экспериментов.
С чего начать внедрение в небольшой команде?
Выберите один повторяющийся процесс, опишите его шаги и добавьте автоматические проверки там, где они дают понятный результат.
Как понять, что пилот помог?
Сравните одинаковые показатели до и после: ручные шаги, сбои запуска и время конкретных выпусков. Учитывайте другие изменения процесса и не приписывайте весь эффект одному инструменту.
Источники
- GitLab: установка в Docker — Проверены варианты установки GitLab Self-Managed с Docker Compose, требования к установке и пример запуска: https://docs.gitlab.com/install/docker/installation/
- GitLab: CI/CD для внешних репозиториев — Проверены поддержка внешних Git-репозиториев через зеркалирование и ограничение уровня подписки Premium/Ultimate: https://docs.gitlab.com/ci/ci_cd_for_external_repos/
- Docker Compose Quickstart — Проверены описание приложения с несколькими службами, конфигурация и команды запуска Compose: https://docs.docker.com/compose/gettingstarted/
- HashiCorp Vault: dev server mode — Проверены ограничения dev-режима: данные хранятся в памяти, режим небезопасен и не предназначен для production: https://developer.hashicorp.com/vault/docs/concepts/dev-server
- Prometheus: First steps — Проверены параметры scrape_configs и scrape_interval в конфигурации сбора метрик: https://prometheus.io/docs/introduction/first_steps/