Zabbix или Prometheus: что выбрать для мониторинга офиса и серверов малого бизнеса
Если у вас офис с Windows-серверами, 1С и парой коммутаторов — берите Zabbix, он один закроет и SNMP, и Windows, и алертинг из коробки. Prometheus эффективнее для контейнеров и микросервисов, но там, где инфраструктура — это железо, а не Kubernetes, он добавляет работы, а не снимает её. Ниже — таблица по всем параметрам и разбор на живом кейсе с 31 рабочим местом.
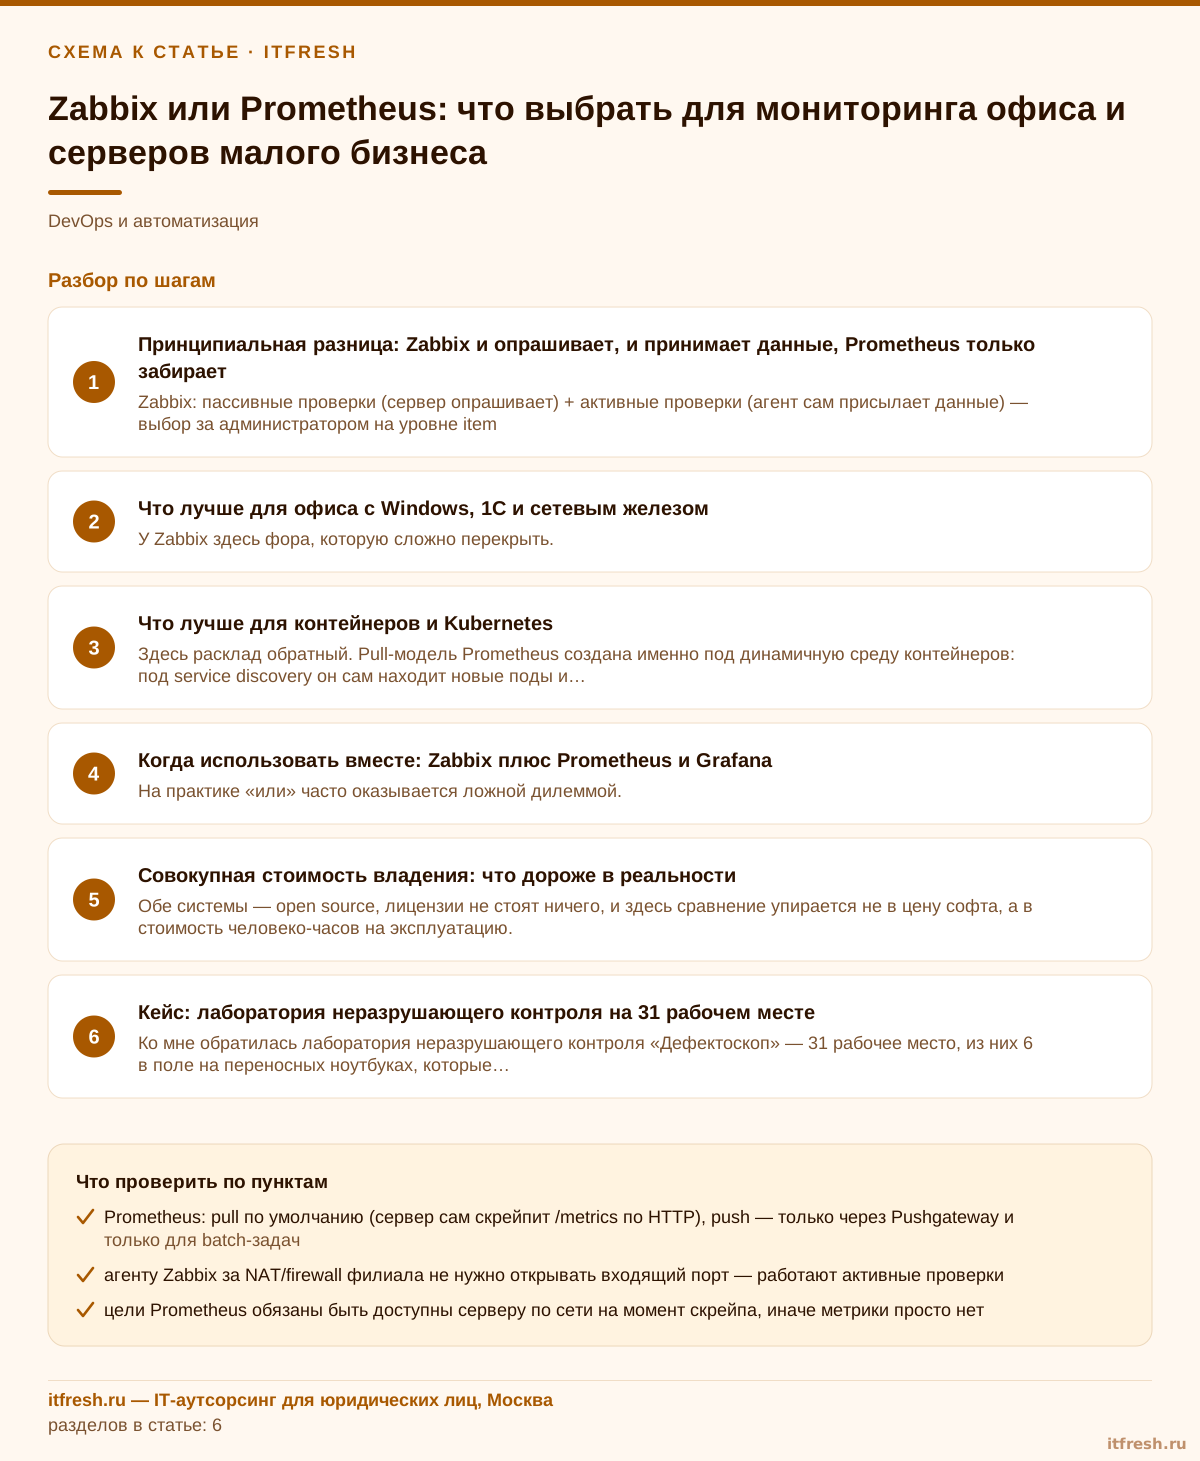
Принципиальная разница: Zabbix и опрашивает, и принимает данные, Prometheus только забирает
Я больше пятнадцати лет ставлю мониторинг в офисах до 50 рабочих мест, и вопрос «Zabbix или Prometheus» задают мне через один. Отвечаю сразу: это не конкуренты в одной нише, это инструменты с разной философией сбора данных, и путаница возникает именно потому, что оба умеют собирать метрики, рисовать графики и слать алерты. Если вам нужен мониторинг серверов и сети под ключ, для офиса с Windows и 1С я в девяти случаях из десяти веду клиента к Zabbix — но давайте по порядку, почему.
Zabbix — гибридная система: сервер может сам опрашивать агенты и устройства (пассивные проверки, pull), а может ждать, пока агенты сами пришлют данные по расписанию (активные проверки, push). Агент за NAT или файрволом филиала не проблема — ставите активные проверки, и агент сам открывает соединение наружу, действующая документация Zabbix прямо рекомендует такую схему для узлов за firewall. Пассивные проверки, наоборот, удобны, когда сервер должен быть уверен, что данные свежие прямо сейчас, и инициирует опрос сам.
Prometheus устроен принципиально иначе: сервер сам ходит по целям и забирает метрики по HTTP через pull-модель — это описано на первой странице официальной документации как базовый принцип архитектуры. Единственное исключение — Pushgateway, промежуточный буфер для короткоживущих batch-задач, которые не успевают дожить до следующего опроса. Push через Pushgateway — не замена pull-модели, а костыль для конкретного случая, и в документации это прямо оговорено.
У Zabbix есть и третий канал — trapper-элементы данных: сервер не опрашивает и не ждёт агента, а просто принимает значение, которое ему прислала внешняя утилита zabbix_sender. Это удобно, когда метрику генерирует не агент, а скрипт бэкапа, резервное копирование СУБД или самописный отчёт — команда zabbix_sender -z server -s hostname -k trap_key -o value кладёт значение в Zabbix без развёртывания полноценного агента на источнике. В Prometheus для такого же сценария снова нужен Pushgateway, то есть отдельный компонент, который надо ставить и поддерживать сверх основного сервера.
- Zabbix: пассивные проверки (сервер опрашивает) + активные проверки (агент сам присылает данные) — выбор за администратором на уровне item
- Prometheus: pull по умолчанию (сервер сам скрейпит /metrics по HTTP), push — только через Pushgateway и только для batch-задач
- агенту Zabbix за NAT/firewall филиала не нужно открывать входящий порт — работают активные проверки
- цели Prometheus обязаны быть доступны серверу по сети на момент скрейпа, иначе метрики просто нет
Что лучше для офиса с Windows, 1С и сетевым железом
У Zabbix здесь фора, которую сложно перекрыть. Zabbix Agent 2 — агент нового поколения, переписанный на Go, с плагинной архитектурой; при этом он полностью совместим по функциям с классическим агентом и поддерживает и активные, и пассивные проверки — это прямо написано в разделе документации про Agent 2. SNMP встроен в сервер как тип элемента данных: поддерживаются SNMPv1, SNMPv2c и SNMPv3 с тремя уровнями безопасности (noAuthNoPriv, AuthNoPriv, AuthPriv), а для обхода десятков портов коммутатора используются нативные bulk-запросы (GetBulkRequest) — не нужно городить отдельный экспортер и его конфиг, как в мире Prometheus.
Для MS SQL в Zabbix есть официальные шаблоны (MSSQL by ODBC и MSSQL by Zabbix agent 2 — в интерфейсе Data collection → Templates), которые сразу снимают метрики производительности БД, блокировки, очереди; для самой 1С официального шаблона нет — берут community-шаблоны или пишут пару своих элементов данных, но это надстройка над тем же агентом, а не отдельный сервис; я подробно разбирал, как ставить метрики MS SQL и 1С через Zabbix на реальном сервере. В Prometheus для этого нужен отдельный компонент — windows_exporter (community, но фактически стандарт де-факто) для Windows-метрик и mssql-экспортер для MS SQL, каждый со своим конфигом, портом и жизненным циклом как отдельного сервиса, который тоже придётся мониторить.
Вот сухое сравнение по параметрам, которые реально влияют на выбор для офиса до 50 рабочих мест: | Параметр | Zabbix | Prometheus | |---|---|---| | Модель сбора | pull (сервер опрашивает) + push (активные проверки агента) | pull по умолчанию, push только через Pushgateway для batch | | Агенты/экспортеры | Agent 2 (Go, плагины) или классический Agent, обратная совместимость | exporter на каждый тип цели (node_exporter, windows_exporter, mssql_exporter, snmp_exporter…) | | Хранение и retention | SQL-БД (MySQL/MariaDB/PostgreSQL) с настраиваемым housekeeping, опционально TimescaleDB для партиционирования | локальная TSDB, retention по умолчанию 15 дней, non-clustered, для долгого хранения нужен remote write во внешнюю СУБД | | Язык запросов | фильтры и функции в интерфейсе, скрипты на JavaScript в препроцессинге | PromQL — полноценный функциональный язык для векторов и агрегаций | | Алертинг | триггеры внутри сервера, эскалации, медиатипы «из коробки» | правила в самом Prometheus + отдельный компонент Alertmanager (группировка, дедупликация, silence, inhibition) | | SNMP/сетевое железо | встроенный тип item, bulk-запросы, SNMP-дискавери | нужен отдельный snmp_exporter и его YAML с MIB | | Windows/1С/MS SQL | официальные шаблоны для Windows и MS SQL, для 1С — community | сторонние exporter'ы, конфигурировать и поддерживать самому | | Веб-интерфейс | встроенный фронтенд с дашбордами, картами сети, проблемами | нет встроенного полноценного UI для дашбордов — обычно ставят Grafana поверх | | Масштабирование | Zabbix proxy для филиалов и разгрузки сервера, буферизация при обрыве связи | горизонтально через федерацию/Thanos/Mimir, штатно каждый сервер — автономный узел | | Порог входа для малого офиса | один сервер, один процесс установки, всё видно сразу | нужно поднять минимум Prometheus + exporter'ы + Alertmanager + Grafana как отдельные сервисы |
Для филиала без выделенного айтишника у меня в паре с Zabbix почти всегда стоит Zabbix proxy — он буферизует данные при обрыве связи с центральным сервером и разгружает основной сервер, когда узлов становится много. У Prometheus прямого аналога proxy для такого сценария нет: федерация и Thanos решают другую задачу — масштабирование самого Prometheus, а не буферизацию при плохом канале филиала.
Что лучше для контейнеров и Kubernetes
Здесь расклад обратный. Pull-модель Prometheus создана именно под динамичную среду контейнеров: под service discovery он сам находит новые поды и эндпоинты в кластере и начинает их скрейпить, не требуя ручной регистрации каждого хоста, как это принято в классическом Zabbix-подходе с узлами сети. Многомерная модель данных — метрика плюс набор label — прямо предназначена для того, чтобы различать десятки реплик одного и того же сервиса без создания отдельного item на каждую копию.
PromQL здесь — не украшение, а рабочий инструмент: официальная документация описывает четыре типа значений выражения (instant vector, range vector, scalar, string) и на этом языке пишутся и обычные графики, и условия алертинга. Для агрегации по namespace, поду, контейнеру, версии релиза PromQL считается практически отраслевым стандартом — большинство готовых дашбордов Grafana для Kubernetes уже написаны именно на нём.
Zabbix тоже можно завести в Kubernetes — есть официальный Helm-чарт и агент для контейнеров, — но это будет решение «на вырост» с лишней инфраструктурой: SQL-БД под историю, отдельный веб-фронтенд, ручная модель узлов там, где Prometheus и так уже интегрирован с экосистемой через service discovery. Для лаборатории или офиса на 31 рабочее место без единого контейнера вопрос обычно снимается сам — там просто нет объекта мониторинга, под который Prometheus оптимизирован.
Ещё один довод в пользу Prometheus для контейнерной нагрузки — remote write: сервер умеет отдавать поток метрик во внешнее хранилище (VictoriaMetrics, Thanos, Mimir и другие совместимые системы), решая тем самым проблему 15-дневного хранения по умолчанию без превращения самого Prometheus в кластер. Для одного офиса с парой контейнеров это обычно избыточно, а для растущего SaaS-продукта на Kubernetes — стандартная часть архитектуры, которую в Zabbix решать не приходится, потому что история там изначально в SQL-БД с собственным housekeeping.
Когда использовать вместе: Zabbix плюс Prometheus и Grafana
На практике «или» часто оказывается ложной дилеммой. Я закрываю инфраструктурный слой — серверы, сеть, СХД, ИБП, Windows, 1С, MS SQL — через Zabbix, потому что там один инструмент вместо пяти отдельных экспортеров. А если у клиента параллельно есть контейнерная нагрузка (свой сайт на Docker, тестовый K8s-кластер у разработчиков) — туда ставлю Prometheus локально, без попытки натянуть его на всю остальную инфраструктуру.
Свести оба источника в одном дашборде можно без танцев с бубном: у Grafana есть официальный плагин-датасорс для Zabbix (разработчик — Grafana Labs, актуальная версия 6.8.0 требует Grafana не ниже 11.6.0), который умеет показывать метрики, проблемы и события Zabbix рядом с панелями на PromQL. Получается один экран, где слева — загрузка канала и статус ИБП из Zabbix, справа — латентность сервиса из Prometheus; я показывал, как строить дашборды для руководителя на Grafana и Prometheus, тот же принцип работает и со сведённым источником Zabbix.
Обратная схема — заменить весь Zabbix Prometheus'ом ради единообразия — на практике почти всегда проигрывает по трудозатратам: под SNMP, Windows-хосты и 1С придётся поднимать и поддерживать отдельный зоопарк exporter'ов, которые сами становятся точкой отказа и объектом мониторинга. Я иду от задачи: инфраструктура — Zabbix, динамичные контейнерные нагрузки — Prometheus, свод — Grafana там, где двух отдельных интерфейсов уже многовато.
Совокупная стоимость владения: что дороже в реальности
Обе системы — open source, лицензии не стоят ничего, и здесь сравнение упирается не в цену софта, а в стоимость человеко-часов на эксплуатацию. Zabbix после первичной установки требует одного администратора, который знает интерфейс: шаблоны, триггеры, карты сети настраиваются в одном UI, документация и community у продукта на русском языке обширны, найти специалиста на рынке проще и дешевле, чем узкого эксперта по PromQL и экосистеме Prometheus.
Стоимость Prometheus начинает расти нелинейно, как только вы выходите за пределы «поставили один сервер и смотрим графики»: нужен Alertmanager отдельным сервисом, Grafana отдельным сервисом, exporter на каждый тип цели отдельным процессом с апдейтами, а если требуется хранить историю дольше 15 дней по умолчанию — ещё и внешняя система через remote write (VictoriaMetrics, Thanos, Mimir), которую тоже кто-то должен администрировать. Для команды с DevOps-экспертизой это не проблема — это их профиль. Для офиса, где системный администратор один и он же занимается принтерами и 1С, это статья расходов на дополнительного специалиста или на подрядчика.
Отдельно считаю железо: локальная база Zabbix в SQL-СУБД и локальная TSDB Prometheus обе довольно экономны по диску — Prometheus, по документации, тратит в среднем 1-2 байта на сэмпл, — но у Zabbix порог входа по инфраструктуре ниже: один сервер БД, который многие компании и так уже держат для других задач, против отдельного стека из четырёх-пяти сервисов у Prometheus-связки.
Если объём истории в Zabbix вырастает настолько, что обычная SQL-БД начинает тормозить на отчётах за год, у меня в контракте появляется TimescaleDB как расширение PostgreSQL — она партиционирует историю и тренды на чанки по времени, документация Zabbix прямо описывает это как способ ускорить работу на больших объёмах. Компрессия чанков при этом работает только в сборке TimescaleDB под лицензией Timescale License (Community edition), в сборке под Apache 2.0 её нет — Zabbix сам напишет об этом предупреждение в лог и не даст включить сжатие во фронтенде. Для малого офиса на 31 рабочее место я обычно обхожусь вовсе без TimescaleDB: обычный PostgreSQL и штатный housekeeping с разумными сроками хранения истории и трендов — там объёмы не настолько велики, чтобы усложнять схему.
Кейс: лаборатория неразрушающего контроля на 31 рабочем месте
Ко мне обратилась лаборатория неразрушающего контроля «Дефектоскоп» — 31 рабочее место, из них 6 в поле на переносных ноутбуках, которые синхронизируются с офисом по VPN раз в день. В офисе — сервер 1С с базой протоколов испытаний на MS SQL, файловый сервер под архив снимков и актов, управляемый коммутатор на 24 порта, два ИБП с SNMP-картами и котельная с датчиками по Modbus-шлюзу, отдающим значения тоже по SNMP. Никакого Kubernetes и контейнеров в проекте не было и не планировалось — вся инфраструктура физическая или виртуальная на одном гипервизоре.
Я поставил Zabbix: сервер на отдельной виртуальной машине, база — PostgreSQL, Agent 2 на сервере 1С и файловом сервере (активные проверки — сервер за NAT офисного роутера, открывать порт внутрь не хотелось), SNMP-опрос коммутатора, обоих ИБП и Modbus-шлюза без единого дополнительного компонента. На сервер 1С и MS SQL взял официальный шаблон Zabbix для MS SQL — метрики блокировок и длинных запросов встали за один вечер, без написания собственного экспортера.
На развёртывание, шаблоны и первую неделю тонкой настройки триггеров ушло четыре рабочих дня. Отдельный повод для этого решения: сисадмин лаборатории — один человек, без бэкграунда в PromQL и Kubernetes, ему нужен был инструмент, куда он сам сможет добавить новый узел через веб-интерфейс, не читая документацию по написанию YAML для нового exporter'а. Спустя два месяца эксплуатации триггер на заполнение диска файлового сервера один раз сработал за 40 минут до реального переполнения — время, которого хватило, чтобы почистить архив без остановки записи актов.
Частые вопросы
Можно ли использовать Prometheus вместо Zabbix для мониторинга офиса с Windows и 1С?
Технически да, но каждую задачу — Windows, SNMP-железо, MS SQL — придётся закрывать отдельным exporter'ом, который сам становится сервисом на поддержке. Zabbix эти задачи закрывает встроенными механизмами: агентом, типом item SNMP и готовыми шаблонами, поэтому для офиса без выделенного DevOps-специалиста порог входа у Zabbix ниже.
Zabbix и Prometheus — это pull или push модели?
Prometheus работает по pull-модели: сервер сам ходит и забирает метрики по HTTP, push доступен только через отдельный компонент Pushgateway для короткоживущих задач. Zabbix — гибрид: пассивные проверки — это pull (сервер опрашивает агент), активные проверки — это push (агент сам присылает данные по расписанию), выбор делается на уровне конкретного item.
Сколько по умолчанию хранит историю Prometheus?
По умолчанию локальная TSDB Prometheus хранит данные 15 дней — это задаётся флагом --storage.tsdb.retention.time, при отсутствии которого и retention.size применяется именно это значение. Для долгого хранения нужен remote write во внешнюю систему (например VictoriaMetrics), Zabbix же хранит историю и тренды в SQL-БД с настраиваемым housekeeping без ограничения по умолчанию в 15 дней.
Нужен ли Alertmanager, если алертинг есть и в самом Prometheus?
Prometheus только вычисляет правила и генерирует алерты, а группировкой, дедупликацией, тишиной (silence) и подавлением связанных алертов (inhibition) занимается отдельный компонент Alertmanager — без него оповещения будут приходить по каждому сработавшему правилу отдельно, без группировки по инциденту.
Можно ли смотреть данные Zabbix и Prometheus в одной Grafana?
Да, у Grafana Labs есть официальный плагин-датасорс для Zabbix, который выводит метрики, проблемы и события Zabbix на одних дашбордах с панелями на PromQL от Prometheus — удобно, если часть инфраструктуры физическая, а часть — контейнерная нагрузка.
Что проще поддерживать одному системному администратору без DevOps-фона?
Zabbix: один сервер, один веб-интерфейс, готовые шаблоны на Windows/1С/MS SQL/SNMP-железо и русскоязычное сообщество. Экосистема Prometheus — это несколько отдельных сервисов (сервер, Alertmanager, exporter'ы, обычно Grafana), каждый со своим конфигом, и она рассчитана на команду с профильной экспертизой в контейнерных нагрузках.
Источники
- Zabbix Documentation: Lifecycle and release policy — Zabbix 7.0 LTS — релиз 4 июня 2024, полная поддержка до 30 июня 2027, ограниченная до 30 июня 2029; Zabbix 8.0 LTS запланирован на Q3 2026 (на 23.09.2026 ещё не выпущен, актуальная фича-версия документации — 7.4); политика «LTS раз в 1,5 года, поддержка 5 лет», между LTS — два стандартных релиза в год. https://www.zabbix.com/life_cycle_and_release_policy
- Zabbix Documentation: Agent 2 — Agent 2 написан на Go, плагинная архитектура, полная обратная совместимость с классическим агентом, поддержка и активных, и пассивных проверок. https://www.zabbix.com/documentation/current/en/manual/concepts/agent2
- Zabbix Documentation: Passive and active checks — Пассивные проверки — сервер/прокси опрашивает агент; активные — агент сам получает список items и присылает данные по расписанию; активные проверки рекомендованы для агентов за firewall/NAT. https://www.zabbix.com/documentation/current/en/manual/appendix/items/activepassive
- Zabbix Documentation: SNMP items и требования (requirements) — Поддержка SNMPv1/v2c/v3 (три уровня безопасности для v3), нативные bulk-запросы GetBulkRequest для walk/discovery в v2/v3, GetNext для v1; поддерживаемые БД сервера — MySQL/MariaDB/PostgreSQL, включая TimescaleDB как расширение PostgreSQL. https://www.zabbix.com/documentation/current/en/manual/config/items/itemtypes/snmp и https://www.zabbix.com/documentation/current/en/manual/installation/requirements
- Zabbix Documentation: Proxies — Zabbix proxy буферизует данные при обрыве связи, разгружает сервер, работает в активном или пассивном режиме — сценарий для филиалов и распределённой сети. https://www.zabbix.com/documentation/current/en/manual/distributed_monitoring/proxies
- Prometheus Documentation: Overview, Storage, Querying basics — Pull-модель сбора, Pushgateway только для batch-задач; локальная TSDB, retention по умолчанию 15 дней (флаг --storage.tsdb.retention.time), ~1-2 байта на сэмпл; PromQL — instant vector/range vector/scalar/string. Актуальная стабильная версия на проверку (github.com/prometheus/prometheus/releases) — 3.14.0 от 17.08.2026. https://prometheus.io/docs/introduction/overview/, https://prometheus.io/docs/prometheus/latest/storage/, https://prometheus.io/docs/prometheus/latest/querying/basics/
- Prometheus Documentation: Alerting overview и Alertmanager — Prometheus вычисляет правила и отправляет алерты в отдельный компонент Alertmanager, который занимается группировкой, дедупликацией, silence и inhibition. https://prometheus.io/docs/alerting/latest/alertmanager/
- Prometheus Documentation: Exporters and integrations — Официальный и community-список exporter'ов: node_exporter (официальный), windows_exporter (community), mssql-экспортер для MS SQL, snmp_exporter (официальный) для сетевого железа. https://prometheus.io/docs/instrumenting/exporters/
- Grafana Labs: Zabbix data source plugin — Официальный плагин Grafana Labs для показа метрик/проблем/событий Zabbix в Grafana, версия 6.8.0 (обновлён 21.09.2026), требует Grafana не ниже 11.6.0 (>=11.6.0). https://grafana.com/grafana/plugins/alexanderzobnin-zabbix-app/