
Как добавить CPU или память работающему Pod в Kubernetes 1.35
Да, в Kubernetes 1.35 можно изменить CPU и память работающего Pod без его пересоздания. Но фраза «in-place resize» не означает «контейнер никогда не перезапустится». Я, Семёнов Евгений Сергеевич, в рабочих кластерах отношусь к этой функции как к способу менять cgroup и планирование, а не как к гарантии непрерывности приложения. Ниже покажу, где именно задаётся политика рестарта, почему успешный ответ API ещё ничего не доказывает и как я проверяю фактически применённые ресурсы.
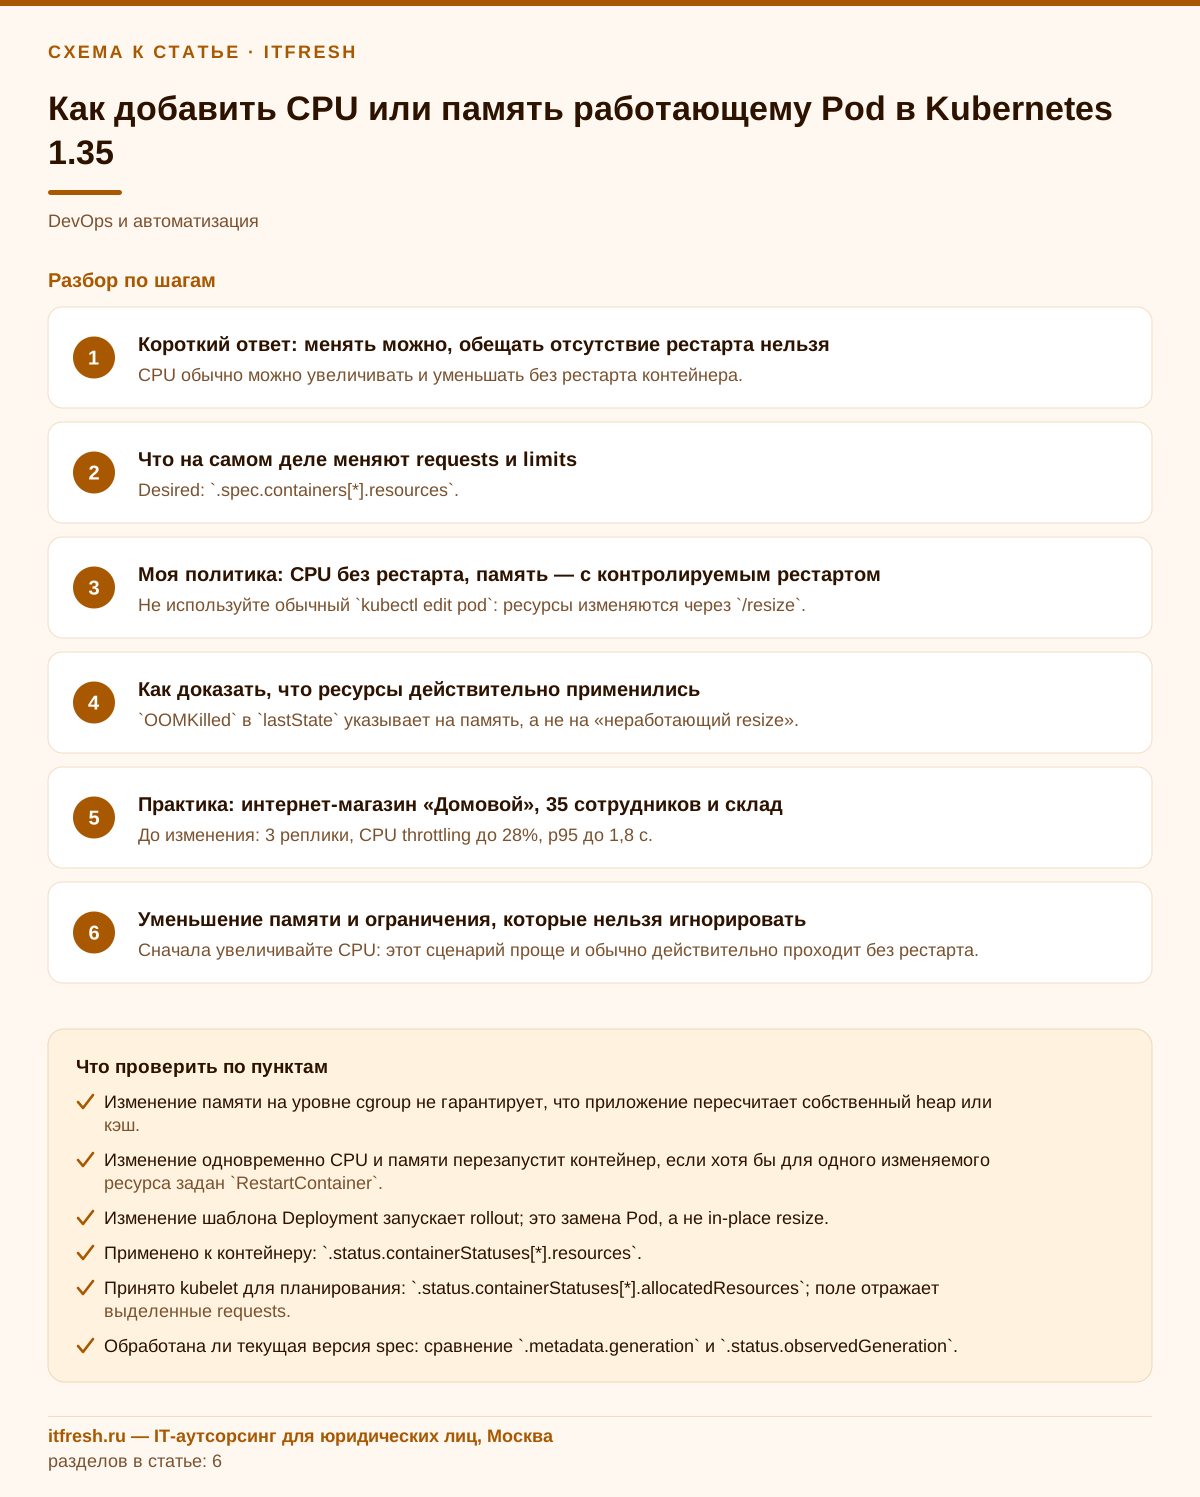
Короткий ответ: менять можно, обещать отсутствие рестарта нельзя
Путь у функции длинный: KEP-1287, feature gate InPlacePodVerticalScaling, alpha в Kubernetes 1.27, beta в 1.33 (тогда же появился отдельный subresource /resize) и статус stable в 1.35. Функция позволяет менять requests и limits для CPU и памяти у контейнеров уже запущенного Pod. Новый Pod для этого создавать не обязательно. В штатной конфигурации Kubernetes 1.35 отдельно включать feature gate не нужно: он включён по умолчанию на control plane и узлах. Но обновлять нужно сам Pod через специальный subresource /resize, а не обычным редактированием Deployment.
Само слово in-place относится к объекту Pod и механизму применения ресурсов. Оно не превращает контейнер в бессмертный процесс. Kubernetes может перезапустить контейнер согласно resizePolicy; процесс может завершиться из-за OOM; liveness-проба способна убить его после усиления CPU throttling; наконец, контроллер может заменить весь Pod после изменения шаблона Deployment. Это четыре разных сценария, которые регулярно смешивают в один.
Политика NotRequired означает: для применения этого конкретного изменения ресурсов рестарт не требуется. Это не запрет на рестарт. Если container runtime понимает, что обновить ресурсы без рестарта невозможно, корректное поведение — вернуть ошибку, после чего kubelet повторит попытку. Однако независимые причины завершения процесса никуда не исчезают. Поэтому я никогда не принимаю отсутствие RestartContainer в конфигурации за SLA без прерываний.
- CPU обычно можно увеличивать и уменьшать без рестарта контейнера.
- Изменение памяти на уровне cgroup не гарантирует, что приложение пересчитает собственный heap или кэш.
- Изменение одновременно CPU и памяти перезапустит контейнер, если хотя бы для одного изменяемого ресурса задан `RestartContainer`.
- Изменение шаблона Deployment запускает rollout; это замена Pod, а не in-place resize.
Что на самом деле меняют requests и limits
После resize в системе существуют как минимум два важных состояния. spec.containers[*].resources показывает желаемые значения — то, что запросил оператор или контроллер. status.containerStatuses[*].resources показывает ресурсы, реально применённые к работающему контейнеру. Между ними может пройти время. Более того, kubelet может отложить или отклонить изменение. Если смотреть только в spec, легко объявить работу законченной, хотя контейнер продолжает жить со старым лимитом.
Для CPU request влияет прежде всего на планирование и относительный вес CPU, а limit превращается в квоту cgroup. Увеличили request с 500m до 900m — это не добавление отдельного физического ядра в виртуальную машину. Увеличили limit с 1 до 2 CPU — контейнеру разрешили потреблять больше процессорного времени, если оно есть на узле. При уменьшении CPU limit процесс не погибает автоматически, но может попасть под сильный throttling. Затем начинают истекать тайм-ауты, проваливается liveness-проба, и наблюдатель видит «рестарт из-за resize», хотя непосредственной причиной стала проба.
С памятью жёстче. Memory request участвует в размещении Pod и оценке давления на узел, а memory limit ограничивает cgroup. Повышение лимита расширяет доступный контейнеру потолок, но JVM, Python-процесс или приложение с фиксированным внутренним пулом не обязано воспользоваться добавкой. Пост в блоге Kubernetes о переходе функции в GA отдельно отмечает, что Java и Python не поддерживают изменение доступной памяти без рестарта на уровне рантайма. Именно поэтому для памяти я обычно выбираю управляемый рестарт, а не красивую, но сомнительную безрестартность.
- Desired: `.spec.containers[*].resources`.
- Применено к контейнеру: `.status.containerStatuses[*].resources`.
- Принято kubelet для планирования: `.status.containerStatuses[*].allocatedResources`; поле отражает выделенные requests.
- Обработана ли текущая версия spec: сравнение `.metadata.generation` и `.status.observedGeneration`.
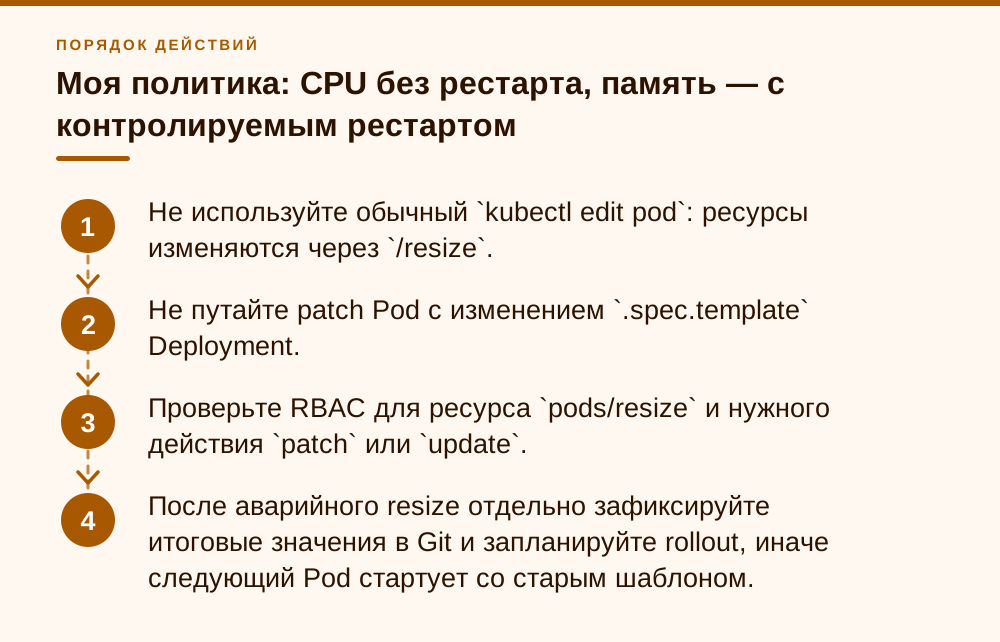
Моя политика: CPU без рестарта, память — с контролируемым рестартом
Для обычного веб-приложения я задаю политику явно: CPU — NotRequired, память — RestartContainer. Значение по умолчанию для обоих ресурсов — NotRequired, но оставлять важное эксплуатационное решение неявным я не люблю. Через полгода разработчик увидит конфигурацию и сразу поймёт ожидаемое поведение. resizePolicy следует заложить в шаблон до создания Pod: у уже созданного Pod это поле неизменяемо.
Базовый фрагмент Deployment у меня выглядит так:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: policy-api
  namespace: crm
spec:
  replicas: 3
  template:
    spec:
      containers:
        - name: api
          image: registry.example.com/crm/policy-api:4.8.2
          resizePolicy:
            - resourceName: cpu
              restartPolicy: NotRequired
            - resourceName: memory
              restartPolicy: RestartContainer
          resources:
            requests:
              cpu: 500m
              memory: 1Gi
            limits:
              cpu: 1500m
              memory: 1536Mi
Живой Pod я изменяю через /resize. Для флага --subresource=resize нужен kubectl версии 1.32 или новее. Например, увеличение CPU выглядит так:
POD=$(kubectl get pod -n crm -l app=policy-api -o jsonpath='{.items[0].metadata.name}')
kubectl patch pod "$POD" -n crm --subresource=resize --type=merge -p \
'{"spec":{"containers":[{"name":"api","resources":{"requests":{"cpu":"900m"},"limits":{"cpu":"2"}}}]}}'- Не используйте обычный `kubectl edit pod`: ресурсы изменяются через `/resize`.
- Не путайте patch Pod с изменением `.spec.template` Deployment.
- Проверьте RBAC для ресурса `pods/resize` и нужного действия `patch` или `update`.
- После аварийного resize отдельно зафиксируйте итоговые значения в Git и запланируйте rollout, иначе следующий Pod стартует со старым шаблоном.
Как доказать, что ресурсы действительно применились
Сначала я сравниваю desired и actual, затем смотрю состояние resize и только потом метрики приложения. Один kubectl get pod без выбранных полей слишком многословен, а kubectl top показывает потребление, не лимит. Удобнее получить компактный срез через jq:
kubectl get pod "$POD" -n crm -o json | jq '{
  uid: .metadata.uid,
  generation: .metadata.generation,
  observedGeneration: .status.observedGeneration,
  desired: [.spec.containers[] | {name, resources}],
  actual: [.status.containerStatuses[] | {
    name,
    resources,
    allocatedResources,
    restartCount,
    containerID,
    lastState
  }],
  resizeConditions: [.status.conditions[]? |
    select(.type == "PodResizePending" or .type == "PodResizeInProgress")]
}'
Если spec уже новый, а status.containerStatuses[*].resources старый, resize ещё не закончен. Условие PodResizePending с причиной Deferred означает, что изменение сейчас не помещается, но kubelet будет повторять попытку. Infeasible означает, что на этом узле запрос принципиально невыполним, например он превышает его ёмкость или конфликтует с поддерживаемой политикой. PodResizeInProgress показывает, что kubelet принял ресурсы, но runtime ещё не завершил применение. В Kubernetes 1.35 полезно также проверить, догнал ли status.observedGeneration текущую metadata.generation.
Затем я смотрю события и cgroup. Второе — дополнительная проверка, потому что пути и доступность файлов зависят от runtime и конфигурации cgroup namespace:
kubectl events -n crm --for pod/"$POD"
kubectl exec -n crm "$POD" -c api -- sh -c \
  'printf "cpu.max: "; cat /sys/fs/cgroup/cpu.max; printf "memory.max: "; cat /sys/fs/cgroup/memory.max; printf "memory.current: "; cat /sys/fs/cgroup/memory.current'
Чтобы понять характер прерывания, сравниваю UID Pod, containerID, restartCount, lastState.terminated.reason и события. Тот же UID плюс новый container ID и выросший restartCount — перезапуск контейнера внутри Pod. Новый UID — Pod заменил контроллер.
- `OOMKilled` в `lastState` указывает на память, а не на «неработающий resize».
- События probe failure объясняют косвенный рестарт после CPU throttling.
- Новый ReplicaSet и новый UID означают rollout Deployment.
- Исчезновение resize conditions само по себе недостаточно: финальные значения должны совпасть в `status.containerStatuses[*].resources`.
Практика: CRM страхового брокера «СтрахКонсалт» у подрядчика в Kubernetes
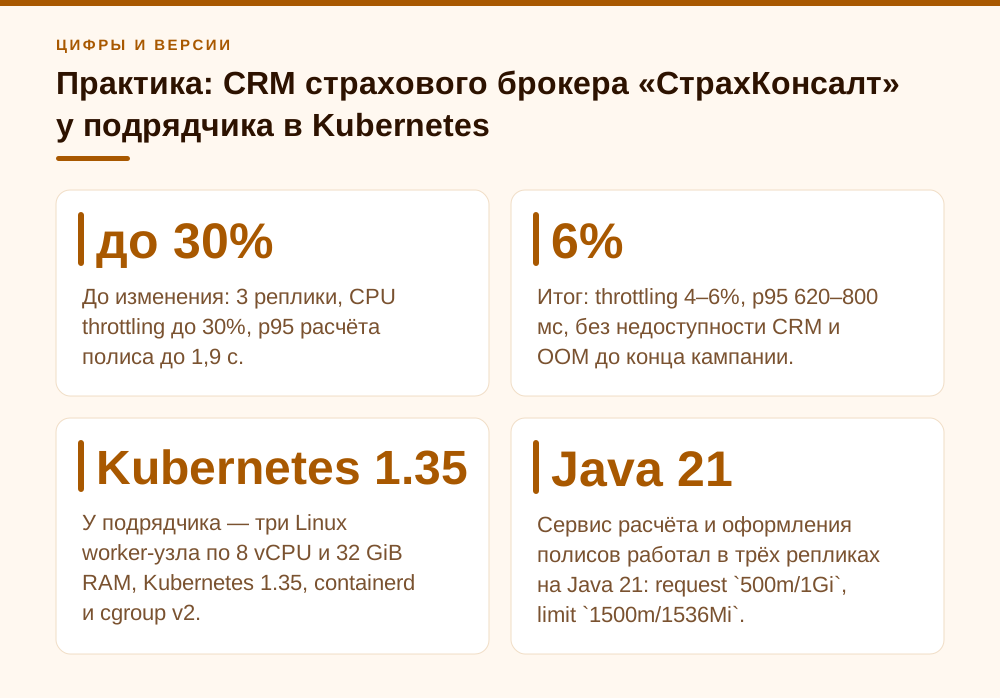
Пример основан на типовой ситуации; «СтрахКонсалт» — условный страховой брокер на 38 рабочих мест, технические детали обезличены и округлены. Честно о роли: сам брокер Kubernetes не эксплуатирует. CRM с расчётом полисов, базой клиентов и выгрузками в страховые компании разработал и держит подрядчик в своём управляемом кластере, а мы как IT-аутсорсер отвечаем за рабочие места, доступы и контроль SLA со стороны заказчика. Команды в кластере выполнял инженер подрядчика; я готовил сценарий, чек-лист проверки и разбирал результаты вместе с ним. У подрядчика — три Linux worker-узла по 8 vCPU и 32 GiB RAM, Kubernetes 1.35, containerd и cgroup v2. Это параметры проекта, а не минимальные требования функции. Сервис расчёта и оформления полисов работал в трёх репликах на Java 21: request 500m/1Gi, limit 1500m/1536Mi.
Проблема проявилась в конце квартала, когда менеджеры брокера массово переоформляли корпоративные договоры ОСАГО и ДМС и одновременно запускали пакетные расчёты по автопаркам клиентов. Время формирования расчёта в CRM (p95) выросло с 450 мс до 1,9 с, сотрудники жаловались на «зависающую карточку клиента». По Prometheus доля периодов CPU throttling у одной реплики доходила до 30 %, при этом на её узле оставалось около 3 CPU allocatable. Разработчик подрядчика первым делом изменил ресурсы в Helm values и запустил upgrade. Получился обычный rollout: старые Pod исчезли, появились новые UID, у пары менеджеров оборвались открытые формы. Команда решила, что in-place resize «всё равно перезапускает Pod». Нет. Они просто не использовали /resize. Это самая частая ошибка, которую я вижу.
Шаблон вернули к исходной ревизии, и для каждой из трёх живых реплик через /resize подняли CPU request с 500m до 900m, limit — с 1500m до 2. Политика CPU была NotRequired. Через несколько секунд status.containerStatuses[*].resources показал новые значения, restartCount остался прежним, UID и container ID не изменились. Доля throttling опустилась до 4–6 %, p95 через десять минут стабилизировался около 700 мс. Ошибок 5xx во время операции не зафиксировали, повторных жалоб от менеджеров в тот день не было.
С памятью поступили иначе. JVM запускалась с -XX:MaxRAMPercentage=70.0, поэтому простое расширение cgroup не было для нас достаточным основанием считать heap перенастроенным. В заранее созданной ревизии для memory стоял RestartContainer. Вне рабочего времени брокера по очереди подняли request до 1536Mi, limit до 2Gi; каждый Pod сохранил UID, но контейнер получил новый ID, а restartCount вырос на единицу. Readiness-probe выводила реплику из балансировки на 11–14 секунд, две другие продолжали обслуживать запросы. Затем подрядчик закрепил значения в Git и провёл плановый rollout, чтобы новые Pod наследовали конфигурацию. До конца квартальной кампании OOM не было, p95 в часы пик держался в диапазоне 620–800 мс. Для брокера отдельно важно, что ни один из этих шагов не требовал доступа к персональным данным клиентов: работали только с ресурсами и метриками.
- До изменения: 3 реплики, CPU throttling до 30 %, p95 расчёта полиса до 1,9 с.
- CPU resize: `500m → 900m` request, `1500m → 2` limit, без рестартов.
- Memory resize: `1Gi → 1536Mi` request, `1536Mi → 2Gi` limit, с управляемым рестартом контейнера вне рабочего времени.
- Итог: throttling 4–6 %, p95 620–800 мс, без недоступности CRM и OOM до конца кампании.
- Организационный вывод: в договор с подрядчиком добавили порядок срочного resize и обязательную фиксацию значений в Git.
Уменьшение памяти и ограничения, которые нельзя игнорировать
В Kubernetes 1.35 уменьшение memory limit разрешено, в отличие от ранних вариантов функции. Но защита остаётся best effort. При NotRequired kubelet перед уменьшением сравнивает текущее потребление с новым лимитом. Если контейнер уже использует больше, изменение пропускается, а Pod может остаться в PodResizeInProgress. Даже если проверка прошла, память способна резко вырасти сразу после неё. Тогда контейнер получит OOM kill. Я считаю риск не катастрофическим, но вполне реальным — особенно у JVM, воркеров очередей и приложений с крупным файловым кэшем.
Поэтому в production я не уменьшаю memory limit работающего критичного процесса только ради красивой утилизации. Сначала смотрю минимум неделю на p95 и p99 working set, учитываю heap, native memory, page cache и всплеск при сборке мусора. Затем выбираю RestartContainer и провожу изменение по одной реплике. Безрестартовое уменьшение оставляю для хорошо исследованных процессов, у которых есть собственный механизм динамического освобождения памяти и достаточный запас между наблюдаемым пиком и новым лимитом.
Есть и формальные ограничения. Resize поддерживает только CPU и память; исходный QoS-класс менять нельзя. Для Guaranteed requests должны оставаться равны limits. Burstable нельзя превратить в Guaranteed, а BestEffort — снабдить ресурсами через resize. Нельзя полностью удалить уже заданные requests или limits. Не поддерживаются Windows Pod, non-restartable init containers и ephemeral containers; sidecar containers изменять можно. Есть ограничения для static CPU Manager, static Memory Manager и swap. При нехватке ресурсов запрос станет Deferred или Infeasible — Kubernetes 1.35 не обязан выселять соседний Pod, чтобы освободить место.
- Сначала увеличивайте CPU: этот сценарий проще и обычно действительно проходит без рестарта.
- Память увеличивайте только после проверки поведения конкретного рантайма.
- Память уменьшайте с запасом и наблюдением; для критичных сервисов выбирайте контролируемый рестарт.
- Не пытайтесь resize превратить в замену HPA, VPA, Cluster Autoscaler и нормальному capacity planning.
- Пока не подтверждены три вещи — ёмкость узла, фактический status ресурсов и причина последнего рестарта, — обсуждать тонкие настройки рано.
VPA и режим InPlaceOrRecreate: автоматизация поверх resize
Ручной /resize хорош для срочных случаев, но постоянно подбирать ресурсы руками никто не будет. Эту работу берёт на себя Vertical Pod Autoscaler. Классически VPA в режиме Recreate применял рекомендации через выселение Pod — то есть рестартом. С появлением in-place resize в VPA добавили режим updateMode: InPlaceOrRecreate: updater сначала пытается изменить ресурсы через subresource /resize, а если это невозможно (например, запрос Infeasible или resize застрял), откатывается к старому пути с пересозданием Pod. По документации VPA режим появился как alpha в VPA 1.4.0 за feature gate InPlaceOrRecreate, в VPA 1.5.0 стал beta и включён по умолчанию, позже gate удалили. Перевод этого режима VPA в beta был одним из критериев GA в самом KEP-1287.
Важно не перепутать ожидания. InPlaceOrRecreate не обещает отсутствие рестартов: слово «OrRecreate» в названии прямо говорит, что при неудаче Pod будет пересоздан, а для памяти по-прежнему действует resizePolicy контейнера. Кроме того, VPA не стоит сочетать с HPA, который масштабирует по тем же метрикам CPU или памяти — это ограничение прямо упомянуто в KEP. Для небольшой CRM на три реплики я обычно начинаю с VPA в режиме Off: неделю собираю рекомендации, сверяю их с метриками и только потом включаю автоматическое применение.
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: policy-api
  namespace: crm
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: policy-api
  updatePolicy:
    updateMode: InPlaceOrRecreate
  resourcePolicy:
    containerPolicies:
      - containerName: api
        minAllowed:
          cpu: 500m
          memory: 1Gi
        maxAllowed:
          cpu: "2"
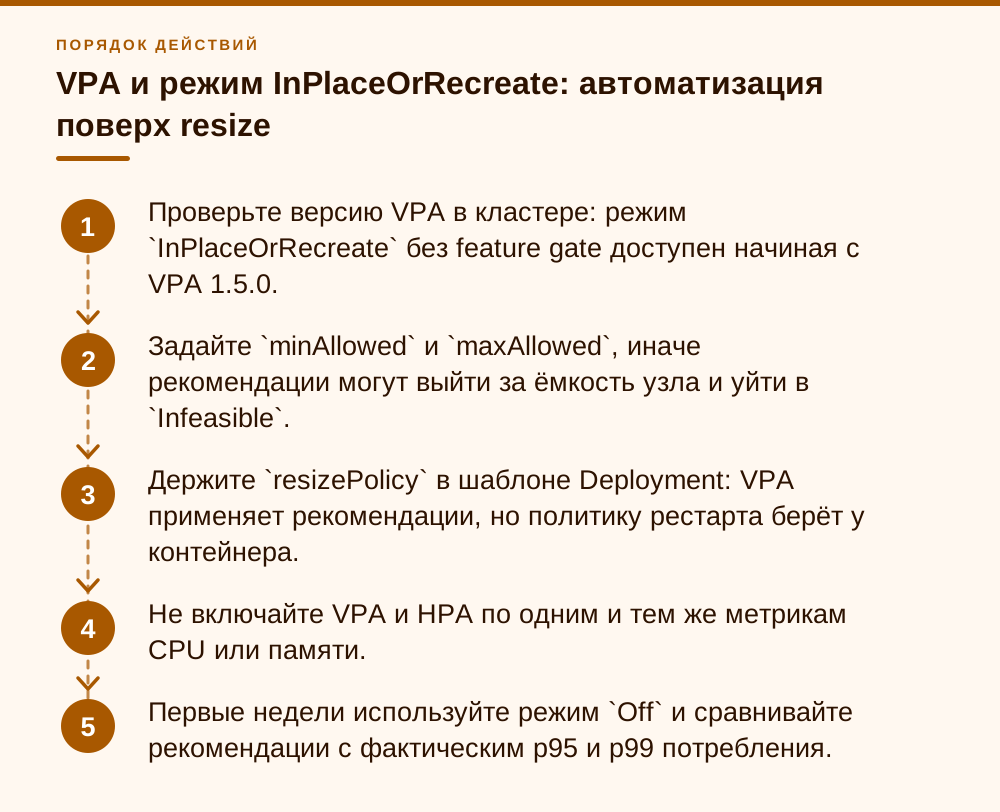
memory: 2Gi- Проверьте версию VPA в кластере: режим `InPlaceOrRecreate` без feature gate доступен начиная с VPA 1.5.0.
- Задайте `minAllowed` и `maxAllowed`, иначе рекомендации могут выйти за ёмкость узла и уйти в `Infeasible`.
- Держите `resizePolicy` в шаблоне Deployment: VPA применяет рекомендации, но политику рестарта берёт у контейнера.
- Не включайте VPA и HPA по одним и тем же метрикам CPU или памяти.
- Первые недели используйте режим `Off` и сравнивайте рекомендации с фактическим p95 и p99 потребления.
Частые вопросы
Можно ли увеличить CPU работающему Pod без рестарта?
Да. Отправьте изменение через subresource `/resize`, заранее задайте для CPU `restartPolicy: NotRequired` и подтвердите результат по `status.containerStatuses[*].resources`. Успешного ответа от API недостаточно.
Почему контейнер перезапустился при in-place resize?
Чаще всего для памяти задан `RestartContainer`, CPU и память изменили одним запросом, процесс получил OOM, упала liveness-проба либо оператор изменил шаблон Deployment и запустил rollout. Сравните UID Pod, container ID, `restartCount`, `lastState` и события.
Можно ли изменить resizePolicy у уже работающего Pod?
Нет, поле `resizePolicy` неизменяемо. Его нужно заранее добавить в шаблон Deployment, StatefulSet или другого контроллера, после чего создать новую ревизию Pod.
Почему spec показывает новый лимит, а приложение видит старый?
`spec` хранит желаемое состояние. Фактически применённые значения находятся в `status.containerStatuses[*].resources`. Resize мог быть отложен, признан невыполнимым или ещё применяться container runtime.
Безопасно ли уменьшать memory limit без рестарта?
Не гарантированно. Kubernetes 1.35 проверяет текущее потребление, но между проверкой и применением возможен всплеск памяти. Для критичного приложения я предпочитаю запас, наблюдение и последовательный контролируемый рестарт реплик.
Можно ли через resize поменять QoS-класс Pod или добавить ресурсы BestEffort-поду?
Нет. QoS-класс фиксируется при создании Pod и resize его не меняет: у Guaranteed requests должны остаться равными limits, Burstable нельзя сделать Guaranteed, а BestEffort-поду нельзя добавить ресурсы. Также нельзя удалить уже заданные requests или limits. Для смены класса нужен новый Pod.
Работает ли in-place resize на Windows-узлах и с VPA?
Windows Pod in-place resize не поддерживают. С VPA функция работает через режим `updateMode: InPlaceOrRecreate`: он пробует `/resize`, а при неудаче пересоздаёт Pod. Без feature gate режим доступен начиная с VPA 1.5.0.
Источники
- Kubernetes v1.35 Documentation — Resize CPU and Memory Resources assigned to Containers; версия документации 1.35, разделы Pod resize status, Container resize policies, Limitations и примеры `/resize`: https://v1-35.docs.kubernetes.io/docs/tasks/configure-pod-container/resize-container-resources/
- Kubernetes Blog — Kubernetes 1.35: In-Place Pod Resize Graduates to Stable; изменения между beta и GA, уменьшение memory limit, ограничения рантаймов и узлов: https://kubernetes.io/blog/2025/12/19/kubernetes-v1-35-in-place-pod-resize-ga/
- Kubernetes v1.35 Release Announcement — Kubernetes v1.35: Timbernetes; раздел Stable: In-place update of Pod resources и Pod observed generation: https://kubernetes.io/blog/2025/12/17/kubernetes-v1-35-release/
- Kubernetes Enhancement Proposal — KEP-1287 In-place Update of Pod Resources; API `/resize`, состояния ресурсов, неизменяемость resizePolicy, семантика NotRequired и RestartContainer: https://github.com/kubernetes/enhancements/blob/master/keps/sig-node/1287-in-place-update-pod-resources/README.md
- Kubernetes Autoscaler (VPA) Documentation — Vertical Pod Autoscaler features: режим обновления InPlaceOrRecreate, стадии alpha/beta по версиям VPA и feature gate: https://github.com/kubernetes/autoscaler/blob/master/vertical-pod-autoscaler/docs/features.md