
Почему две replicas в Docker Compose не дают failover за Nginx
Вы подняли две реплики, остановили одну — и получили 504 или секундные задержки. Вторая реплика работает, но Nginx продолжает обращаться к старому IP. Я, Семёнов Евгений Сергеевич, директор ООО «АйТи-Фреш», покажу, откуда берётся залипание, какой конфиг я выбираю и что реально получилось при проверке отказа на Docker-стенде.
Две реплики — это количество процессов, а не обещание доступности
В строке deploy.replicas: 2 нет ни проверки вашего API, ни правил повторной отправки запроса. Локальный Docker Compose действительно умеет запускать несколько экземпляров сервиса: совет «replicas работает только в Swarm» для актуального Compose устарел. Но команда docker compose up не превращает один сервер в кластер с непрерывным восстановлением заданного числа реплик. Перезапуск завершившегося контейнера обеспечивает отдельно настроенная restart policy. Балансировку HTTP в нашей схеме выполняет Nginx.
Compose создаёт для проекта пользовательскую bridge-сеть. Реплики доступны соседним контейнерам по имени сервиса app; в нашем стенде DNS возвращает два IP. При пересоздании адрес может измениться, имя остаётся прежним. Отследить изменение и переподключиться должен потребитель имени — здесь Nginx. Docker прямо описывает эту ответственность в документации сетей Compose. Копирование endpoint_mode: vip из примера Swarm не добавляет локальному Compose сетевую инфраструктуру Swarm.
Я разделяю три задачи: найти актуальные адреса, выбрать доступную реплику и решить, допустимо ли повторить конкретный запрос. Пока они свалены в слово «балансировка», проверка заканчивается двумя зелёными контейнерами в docker ps. Для меня это только начало. Нужно остановить одну реплику и посмотреть одновременно клиентский ответ, выбранный upstream и время обработки: HTTP 200 вполне способен скрывать регулярные походы на давно мёртвый адрес.
- Обнаружение: Docker DNS сообщает адреса, Nginx обновляет свой список.
- Выбор: Nginx распределяет запросы и временно исключает сбойные адреса по результатам обращений.
- Повтор: правила proxy_next_upstream определяют, когда можно попробовать другую реплику.
Где залипает IP и почему reload временно помогает
Вот конфигурация, с которой удобно воспроизвести проблему. Имя app выглядит динамическим, но эта запись задаёт статически разрешаемый upstream:
upstream app_pool {
    server app:8080 max_fails=1 fail_timeout=3s;
}
При загрузке конфигурации Nginx получает адреса имени. Если их несколько, появляются несколько upstream-серверов, а не один случайно выбранный IP. Автоматического отслеживания последующих изменений DNS здесь нет.
Допустим, при старте получены 172.20.0.2 и 172.20.0.3. Первую реплику остановили, Docker DNS уже возвращает только второй адрес. Статический пул Nginx продолжает содержать оба. После ошибки первый адрес временно исключается, затем снова получает шанс. fail_timeout задаёт окно учёта ошибок и период исключения; это не частота фоновых healthcheck. Проверкой становится очередной пользовательский запрос. Такое поведение описано в документации пассивных проверок Nginx.
Отсюда важная поправка к популярному объяснению: остановка одной из двух реплик не обязана давать 50 % ошибок. Стандартное proxy_next_upstream error timeout уже допускает повтор на другом сервере. Внешне всё может оставаться зелёным, а отдельные запросы будут ждать таймаут подключения. Ещё неприятнее последовательная замена контейнеров: Nginx способен остаться со списком адресов, которых уже вообще нет. Успешный первый эксперимент этого не исключает.
Reload перечитывает конфигурацию и заново разрешает статическое имя. Поэтому кажется, будто проблема вылечена. Я допускаю такой приём для восстановления сервиса прямо сейчас, но постоянный reload после каждого изменения контейнеров требует отдельной надёжной автоматизации. Одна добавленная директива resolver тоже не переключает статический upstream в динамический режим. Для выбранного ниже решения необходим параметр resolve у server; именно он включает отслеживание адресов.
Стенд «Игла и нить»: воспроизводим проблему без клиентской легенды
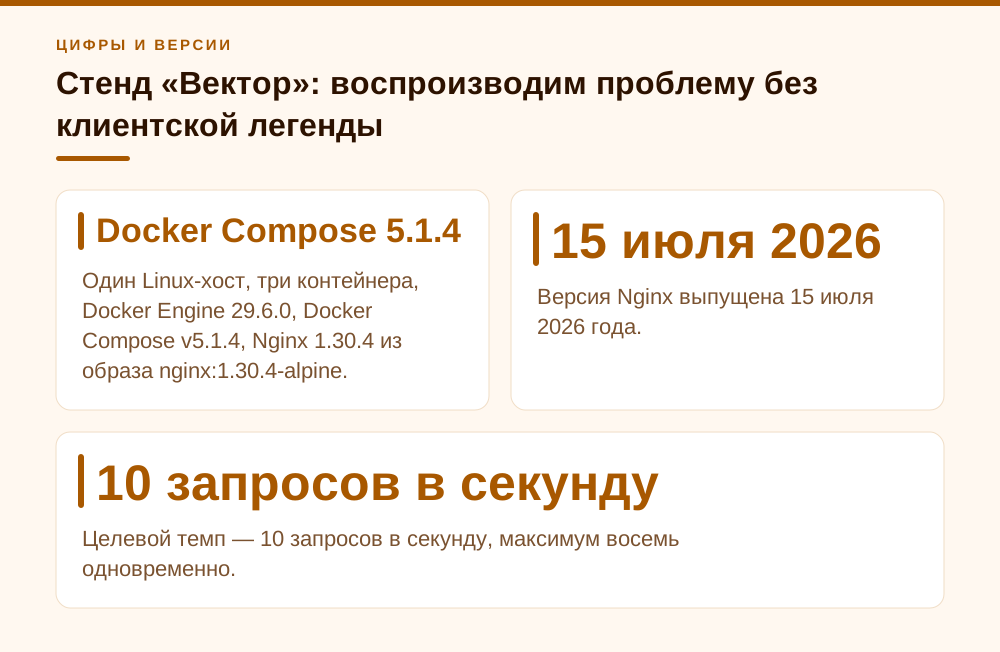
Для разбора я собрал лабораторный стенд «Игла и нить». Название условное; это выполненный технический эксперимент, не история внедрения у названного заказчика. Один Linux-хост, три контейнера, Docker Engine 29.6.0, Docker Compose v5.1.4, Nginx 1.30.4 из образа nginx:1.30.4-alpine. Версия Nginx выпущена 15 июля 2026 года. Это конкретная проверенная сборка, а не рекомендация навсегда закрепиться на ней: обновления безопасности проверяйте по официальной истории выпусков.
Вместо бизнес-приложения две реплики Nginx возвращают hostname контейнера. Так видно распределение запросов, а база данных и прикладной код не мешают исследовать сетевой механизм. Всего я отправил 400 GET: для каждого варианта конфигурации 40 до остановки и 160 после. Целевой темп — 10 запросов в секунду, максимум восемь одновременно. Это проверка поведения при отказе, не замер пропускной способности; требования к CPU и памяти настоящего приложения из неё выводить нельзя.
Файл compose.yaml ниже запускает две реплики и публикует только gateway на случайном свободном порту loopback. У app нет container_name: фиксированное имя несовместимо с масштабированием. Одинаковый опубликованный порт хоста у двух реплик тоже конфликтовал бы. Порт 8080 доступен gateway внутри общей сети без ports и без обязательного expose. Ограничения описаны в спецификации сервисов Compose.
services:
  app:
    image: nginx:1.30.4-alpine
    restart: unless-stopped
    deploy:
      replicas: 2
    volumes:
      - ./backend.conf:/etc/nginx/conf.d/default.conf:ro
    healthcheck:
      test: ["CMD", "wget", "-q", "-O", "/dev/null", "http://127.0.0.1:8080/"]
      interval: 1s
      timeout: 1s
      retries: 10
  gateway:
    image: nginx:1.30.4-alpine
    restart: unless-stopped
    ports:
      - "127.0.0.1::80"
    volumes:
      - ./gateway.conf:/etc/nginx/nginx.conf:ro
    depends_on:
      app:
        condition: service_healthy
Рядом сохраняю backend.conf. Endpoint намеренно примитивный; выдавать hostname публичным пользователям в рабочем приложении не требуется. Проверка готовности здесь совпадает с проверкой HTTP-ответа, а для настоящего API я использую отдельный endpoint с осмысленным критерием готовности обслуживать запросы. Частота healthcheck в одну секунду выбрана для короткого эксперимента, а не как стандарт для всех сервисов.
server {
    listen 8080;
    location / {
        default_type text/plain;
        return 200 "$hostname\n";
    }
}
Мой выбор: динамический upstream и ограниченные повторы
Для небольшой установки на одном сервере я выбираю штатный динамический upstream Nginx. Его проще сопровождать, чем собственный обработчик Docker events с генерацией конфигов. В открытом Nginx параметр resolve доступен начиная с 1.27.3, выпущенной 26 ноября 2024 года; покупать Plus ради этой функции уже не требуется. Это подтверждает официальное объявление Nginx. Версию проверяйте внутри контейнера, а не по установленному на хосте пакету.
Ниже полный gateway.conf, заменяющий /etc/nginx/nginx.conf. Один worker оставлен специально для понятного эксперимента. Для статического контрольного прогона я убирал zone, resolver, resolver_timeout и слово resolve, сохраняя остальные настройки. При смене конфигурации выполняю nginx -t, затем nginx -s reload внутри gateway. Журнал содержит время, запрос, итоговый статус, адреса upstream, их статусы и длительности:
worker_processes 1;
events { worker_connections 1024; }
http {
    log_format timing '$msec|$request|$status|$upstream_addr|$upstream_status|$upstream_response_time|$request_time';
    access_log /var/log/nginx/access.log timing;
    error_log /var/log/nginx/error.log warn;

    upstream app_pool {
        zone app_pool 64k;
        resolver 127.0.0.11 valid=2s ipv6=off;
        resolver_timeout 1s;
        server app:8080 resolve max_fails=1 fail_timeout=3s;
    }

    server {
        listen 80;
        location / {
            proxy_pass http://app_pool;
            proxy_connect_timeout 1s;
            proxy_read_timeout 2s;
            proxy_send_timeout 2s;
            proxy_next_upstream error timeout;
            proxy_next_upstream_tries 2;
            proxy_next_upstream_timeout 3s;
        }
    }
}
Zone хранит конфигурацию и состояние пула в общей памяти и нужна для resolve. Resolver 127.0.0.11 — встроенный DNS Docker внутри контейнера пользовательской сети; на Nginx, установленном непосредственно на хосте, этот адрес автоматически не заработает. Публичный DNS имя app тоже не знает. ipv6=off соответствует IPv4-стенду, в IPv6-сети копировать его не следует. Назначение адреса подтверждено в документации Docker DNS, требования resolve — в справочнике upstream.
Здесь три разных таймера. valid=2s переопределяет срок DNS-кэша, resolver_timeout=1s ограничивает ожидание DNS, fail_timeout=3s относится к пассивному исключению upstream. Ни один не обещает переключение ровно за две секунды. Две попытки в proxy_next_upstream_tries включают первую; proxy_next_upstream_timeout ограничивает окно допуска повторов, а не полную длительность ответа. Read timeout задаёт ожидание между чтениями. Мои короткие значения подходят мгновенному тестовому ответу: для отчётов, загрузок и медленного API их надо пересчитать, иначе вы сами создадите таймауты. Справочник proxy.
Что получилось: старый IP исчез, но четыре запроса потерялись
Для повторения сохраните три файла в отдельном каталоге. Эти команды показывают версии, проверяют конфигурацию и DNS, затем останавливают только одну реплику. Docker stop выбран сознательно: ручная остановка подавляет автоматический перезапуск, поэтому restart policy не маскирует эксперимент. Это поведение описано в документации Docker. Нагрузку запускайте из второго терминала; одиночный curl ниже — только проверка доступности.
docker compose up -d
docker compose exec gateway nginx -v
docker compose exec gateway nginx -t
docker compose exec gateway nslookup app 127.0.0.11
gateway_address=$(docker compose port gateway 80)
curl -sS "http://$gateway_address/"
victim_id=$(docker compose ps -q app | head -n 1)
docker stop -t 2 "$victim_id"
docker compose exec gateway nslookup app 127.0.0.11
docker compose logs --since 30s gateway
# После проверки вернуть остановленную реплику:
docker start "$victim_id"
В моём прогоне останавливалась реплика 172.20.0.2, живая имела адрес 172.20.0.3. До остановки обе конфигурации распределили 40 запросов ровно 20/20. Со статическим upstream после stop клиент получил 160 ответов HTTP 200 из 160. Однако восемь запросов сначала использовали умерший адрес. Новые обращения к нему наблюдались даже через 6,3 и 11,3 секунды после завершения stop; максимальная клиентская длительность составила 1020 мс. Вот реальная строка: первый upstream закончился 504, второй вернул 200, пользователь увидел успех.
1788597850.226|GET /?phase=static_after&i=110 HTTP/1.1|200|172.20.0.2:8080, 172.20.0.3:8080|504, 200|1.000, 0.002|1.001После включения динамического upstream результат оказался менее красивым, чем обещают рецепты «добавьте resolve». Из 160 запросов после остановки 156 получили HTTP 200, четыре — HTTP 504. Умерший IP использовали пять запросов. Последний из них начался примерно через 1,05 секунды после stop; начиная со следующего, стартовавшего через 1,15 секунды, оставшиеся 151 запрос прошли только на живую реплику и завершились успешно. Повторного reload после остановки не было. Это наблюдаемые времена выбора upstream, не точное измерение момента обновления DNS.
Я оставляю эти четыре ошибки в результате. Без отдельной отладочной трассировки нельзя честно объявить установленной их внутреннюю причину. Эксперимент подтверждает прекращение длительного использования старого IP, но не гарантирует бесшовное переключение уже начатых запросов. Поэтому динамический пул я выбираю для корректного сопровождения состава реплик, а допустимость переходных ошибок проверяю отдельно. Если вам обещают ноль ошибок только по наличию resolve, попросите протокол остановки под запросами, а не снимок двух работающих контейнеров.
Что ещё нужно, чтобы это можно было оставить в работе
Healthcheck в Compose полезен, но сам по себе не удаляет unhealthy-контейнер из Docker DNS и не перезапускает живой процесс. Depends_on с service_healthy управляет ожиданием при запуске, а не постоянной маршрутизацией. Если приложение зависло, но контейнер работает, имя может продолжать разрешаться. Это следует из механизма healthcheck Docker и правил запуска Compose. Для исключения по прикладной готовности потребуется соответствующая проверка у балансировщика или механизм discovery, который учитывает readiness.
С повторами я осторожен. Для корректно реализованного GET повтор обычно допустим; создание платежа или заказа требует прикладной идемпотентности. Не добавляйте non_idempotent ради исчезновения ошибок из графика. После отправки POST, PATCH или LOCK upstream Nginx по умолчанию ограничивает повтор; до отправки запроса ошибка подключения ещё может позволить другую попытку. После начала передачи ответа клиенту переключение тоже не исправит уже оборванный ответ. Эти ограничения зафиксированы в правилах proxy_next_upstream. Для операций записи я сначала проектирую ключ идемпотентности и хранение результата.
Отдельно проверяю сам DNS: valid не является гарантией удаления IP при любой ошибке резолвера. В Nginx 1.30.4 NXDOMAIN убирает адреса данного имени, а при других ошибках разрешения прежний набор может сохраняться до следующей попытки; это видно в исходном коде upstream zone. Но для небольшой установки я не начинаю с отдельного кластера DNS. Сначала добиваюсь наблюдаемого восстановления на штатном Docker DNS и проверяю, что оставшаяся реплика выдерживает всю рабочую нагрузку.
Мой порядок внедрения простой: рабочий динамический пул, журнал попыток, контролируемый отказ, затем проверка настоящих пользовательских операций. Обе реплики должны обходиться без незаменимого состояния на локальном диске или в памяти одного процесса. Если требуется переживать отказ сервера, план нужен уже для нескольких хостов, входного балансировщика, данных и сессий. Для небольшого внутреннего сервиса Compose вполне уместен. Просто пределы доступности должны быть записаны и проверены, а не выведены из цифры 2 в YAML.
- Проверить остановку и зависание реплики: это разные виды отказа.
- При пересоздании сверить фактический IP: Docker может повторно выдать прежний адрес и скрыть дефект теста.
- Измерять клиентские 5xx, задержки и повторные upstream-попытки вместе.
- После восстановления проверить возвращение обеих реплик в распределение без ручного reload.
Keepalive к upstream и особый случай одного peer
В рабочей конфигурации upstream стоит добавить директиву keepalive 32 — она задаёт число простаивающих keepalive-соединений, которые каждый worker process держит открытыми к бэкенду, вместо установки нового TCP-соединения на каждый запрос. Чтобы keepalive реально заработал через proxy_pass, дополнительно нужны proxy_http_version 1.1 и сброс заголовка: proxy_set_header Connection "";. Без этой пары директив Nginx продолжит отправлять заголовок Connection: close и закрывать соединение после каждого ответа, даже при заданном keepalive.
Стоит помнить и об особом случае: когда в группе upstream остаётся только один живой peer, параметры max_fails и fail_timeout для него не действуют — Nginx не может исключить единственный доступный сервер. Активная проверка health_check, которая опрашивала бы бэкенды до прихода реального запроса, в открытой версии Nginx недоступна и остаётся функцией NGINX Plus — в open source приходится полагаться только на пассивное обнаружение ошибок, описанное выше.
Частые вопросы
Нужен ли Nginx Plus для динамического DNS?
Нет. Параметр server resolve доступен в открытом Nginx начиная с 1.27.3. Для показанного решения также нужны zone и resolver. Стенд проверен на Nginx 1.30.4.
Достаточно добавить resolver 127.0.0.11?
Нет. Статическая запись server app:8080 от этого не начнёт автоматически обновлять адреса. В приведённой конфигурации нужен параметр resolve, а upstream должен использовать общую память zone.
Почему restart: unless-stopped не решает проблему?
Эта политика управляет перезапуском контейнера, но не обновляет список адресов Nginx. При ручном docker stop автоматический перезапуск подавляется; статус unhealthy сам по себе тоже не запускает перезапуск.
Если после остановки реплики у вас растут 502/504 или задержки, я помогу проверить конфигурацию и воспроизвести отказ на стенде. Пришлите compose.yaml и конфигурацию Nginx — предложу исправления и сценарий приёмки.
Бесплатная консультация →
Источники
- Docker Docs: Networking in Compose — Разделы Default network and service discovery и Updating containers on the network: имена сервисов, изменение адресов и ответственность за переподключение.
- Docker Docs: Networking overview — Раздел DNS services: встроенный DNS 127.0.0.11 в пользовательских сетях Docker.
- Docker Docs: Compose services и startup order — Параметры container_name, ports, healthcheck, depends_on и condition: service_healthy.
- Nginx: ngx_http_upstream_module — Параметры server resolve, max_fails, fail_timeout; директивы zone, resolver и resolver_timeout.
- Nginx: ngx_http_proxy_module — Директивы proxy_next_upstream, proxy_next_upstream_tries, proxy_next_upstream_timeout и таймауты проксирования.
- Nginx: официальная история выпусков — Версия 1.27.3 от 26.11.2024: resolve в открытой версии; версия 1.30.4 от 15.07.2026: сборка лабораторного стенда.
- Docker Docs: Start containers automatically — Раздел Restart policy details: влияние ручной остановки контейнера на автоматический перезапуск.
- Moby: исходный код healthcheck — Файл daemon/health.go: изменение статуса здоровья контейнера и генерация события.
- Nginx 1.30.4: исходный код динамического upstream — Файл src/http/modules/ngx_http_upstream_zone_module.c, тег release-1.30.4: обновление адресов и обработка ошибок DNS.