
Почему контейнер получает OOMKilled и как это исправить
OOMKilled означает, что контейнер завершился из-за нехватки памяти; часто он упёрся в установленный memory limit, но сначала нужно проверить статус и условия на узле. Я начинаю с конкретного контейнера, сравниваю график памяти с лимитом и только потом меняю конфигурацию. В статье — команды, разбор рантаймов и пример расчёта.
Что означает OOMKilled и почему одного кода 137 мало
Когда мы берёмся за внедрение Kubernetes и open-source, я сразу разделяю два понятия: превышение лимита контейнера и нехватку памяти на узле. В Linux Kubernetes передаёт ограничения памяти через cgroups, а ядро применяет их. Если потребление контейнера пересекает лимит и возникает давление на память, ядро может завершить процесс; в статусе контейнера Kubernetes обычно показывает reason: OOMKilled. Это совпадает с практическим правилом экспертной базы: запись OOMKilled означает принудительное завершение контейнера из-за нехватки памяти, но сама по себе ещё не объясняет, почему она возникла. В базе знаний сайта отдельно зафиксирован важный пограничный случай: при общей нехватке памяти узла и отсутствии memory limits системный OOM killer может выбрать приложение, а не тот процесс базы, который администратор ожидает увидеть виновником. Это не правило выбора конкретной службы: документация ядра описывает выбор задачи ради сохранения работоспособности системы. Поэтому без лимитов нельзя надёжно полагаться на то, что пострадает именно «самый прожорливый» процесс.
Код выхода 137 часто сопровождает такую остановку: в примерах Kubernetes он указан вместе с reason OOMKilled. Но число 137 без статуса не доказывает OOM. Оно согласуется с завершением сигналом SIGKILL, который может прийти и по другой причине — например, процесс принудительно завершили извне. Поэтому проверяю lastState.terminated.reason, exitCode, время завершения и события, а не делаю вывод по одной цифре. Ядро не обязано оставить приложению возможность красиво попрощаться.
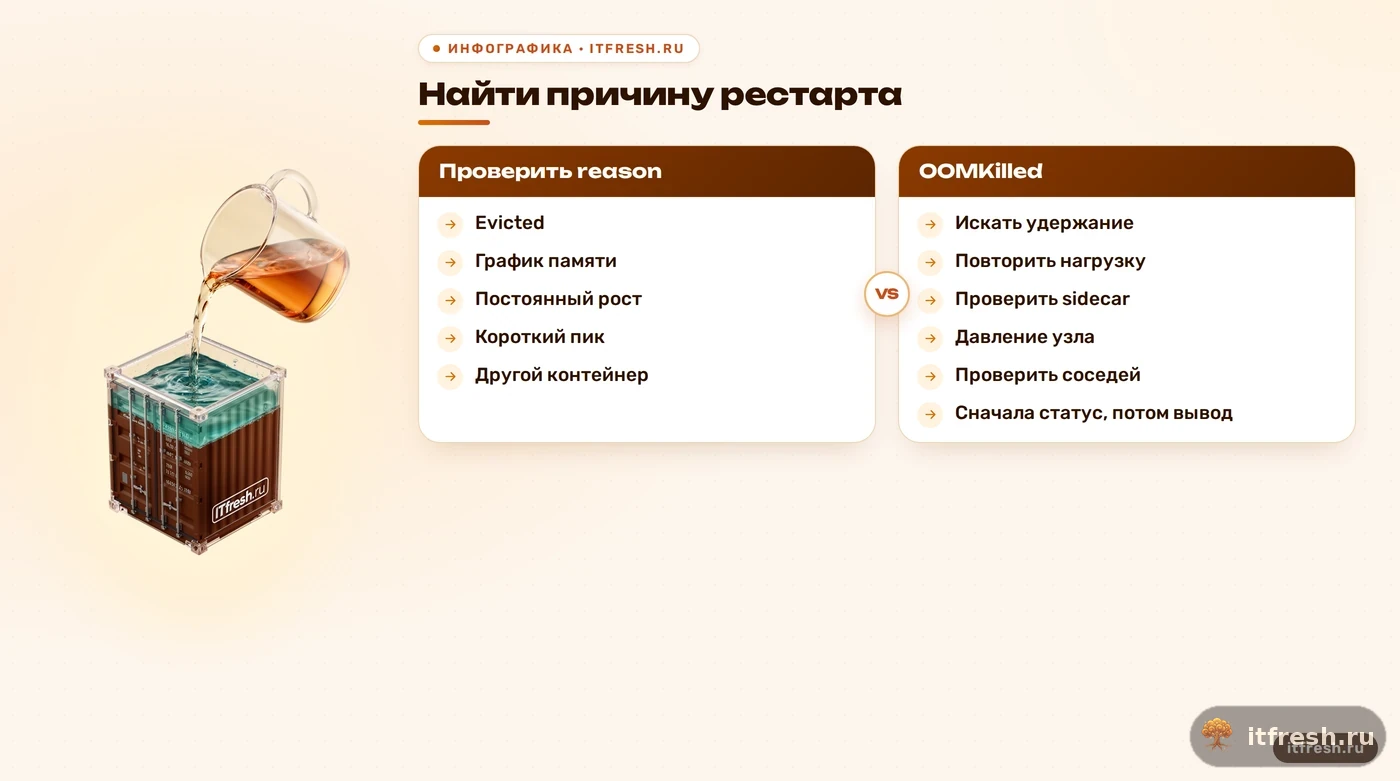
OOMKilled и Evicted тоже не синонимы. В первом случае контейнер завершён при проблеме с памятью; часто причина — его лимит. Во втором kubelet выселяет под при давлении ресурсов на узле. Если контейнер использовал больше своего request, а узел в целом испытывает нехватку памяти, вероятность eviction выше. В обоих случаях смотрю состояние узла и события, но диагноз и дальнейшие действия различаются.
Как проверить падение командами kubectl
Начинаю с подробного статуса пода. В Last State проверяю причину завершения и код, а также имя контейнера: в одном Pod может быть приложение, прокси и агент сбора логов. Если контейнер перезапускается, kubectl logs --previous иногда ещё покажет его предыдущий вывод. При SIGKILL последних строк может не оказаться — это ожидаемо, а не повод заключать, что логирование сломано. Три команды для первого прохода: Если статус пода — CrashLoopBackOff, это описание повторных рестартов, а не диагноз: причиной может быть OOM, но также настройки пробы или запуск приложения. Отдельно разбираю проверку startupProbe и CrashLoopBackOff.
kubectl describe pod <pod> -n <ns>
kubectl get pod <pod> -n <ns> -o jsonpath="{range .status.containerStatuses[*]}{.name}{" reason="}{.lastState.terminated.reason}{" exit="}{.lastState.terminated.exitCode}{"\n"}{end}"
kubectl logs <pod> -c <container> -n <ns> --previous
kubectl get events -n <ns> --sort-by=.metadata.creationTimestamp
Дальше сверяю время рестарта с графиком потребления. kubectl top pod -n <ns> требует работающий Metrics Server и показывает недавний срез; у этой команды нет истории, поэтому по ней нельзя восстановить короткий пик, случившийся ночью. Для исторического разбора нужна система мониторинга с подходящей частотой сбора. В Prometheus обычно начинают с container_memory_working_set_bytes, но не объявляют эту линию точным эквивалентом лимита: working set — оценка потребления, а детали учёта зависят от kubelet и контейнерного рантайма.
Сопоставьте график с лимитом из манифеста и проверьте состояние узла. Ровный рост, который не снижается после завершения нагрузки, — повод искать утечку или неосвобождаемый кеш. Короткая вершина вокруг тяжёлой операции указывает на пиковый сценарий. Устойчивое приближение к лимиту может означать, что рабочая нагрузка и выделенная память не согласованы. Сам график не доказывает ни утечку, ни её отсутствие: я проверяю, что происходило в приложении в тот же период.
- reason OOMKilled — изучите лимит и профиль нагрузки
- reason Evicted — проверьте давление памяти узла
- Пик совпал с задачей — повторите именно этот сценарий
- Память растёт постоянно — ищите удерживаемые объекты
Почему под проходит тест, но падает под нагрузкой
Разберу типовой сценарий, а не клиентский кейс. Допустим, сервис расчёта маршрутов на Java на тестовом стенде обрабатывает небольшие наборы данных и работает с малым числом параллельных запросов. В рабочее время одновременно приходят более крупные задания, приложение создаёт больше объектов, растут очереди и стеки потоков. Один и тот же код при разных объёмах данных и параллельности может иметь совсем разный пик памяти. «В тесте не упало» — это описание теста, а не гарантия запаса.
Вторая причина — неполная картина по контейнеру. Память потребляют не только объекты Java-кучи: есть метаданные классов, стеки потоков, JIT и прямые буферы. Отдельно учитываются процессы и объекты вне кучи. Если приложение запущено рядом с сайдкарами, нельзя складывать цифры всего Pod и приписывать их главному процессу: выясните, какой контейнер получил OOMKilled, и смотрите его ресурсы. Иначе можно увеличить лимит не тому участнику.
Третья причина — тестируют задержку, но не память. Я повторяю нагрузку с похожими размерами входных данных, параллельностью и длительностью, а на графике отмечаю конкретные фазы: запуск, прогрев, пик и время после пика. Важно сохранить профиль реальных задач, не копируя персональные данные. Если проблема возникает только при импорте большого файла, тест из десятка коротких запросов её не проверит. Измерять нужно ту операцию, от которой приложение задыхается, а не ту, которую удобнее запускать.
Как согласовать лимит с JVM, Node.js и Go
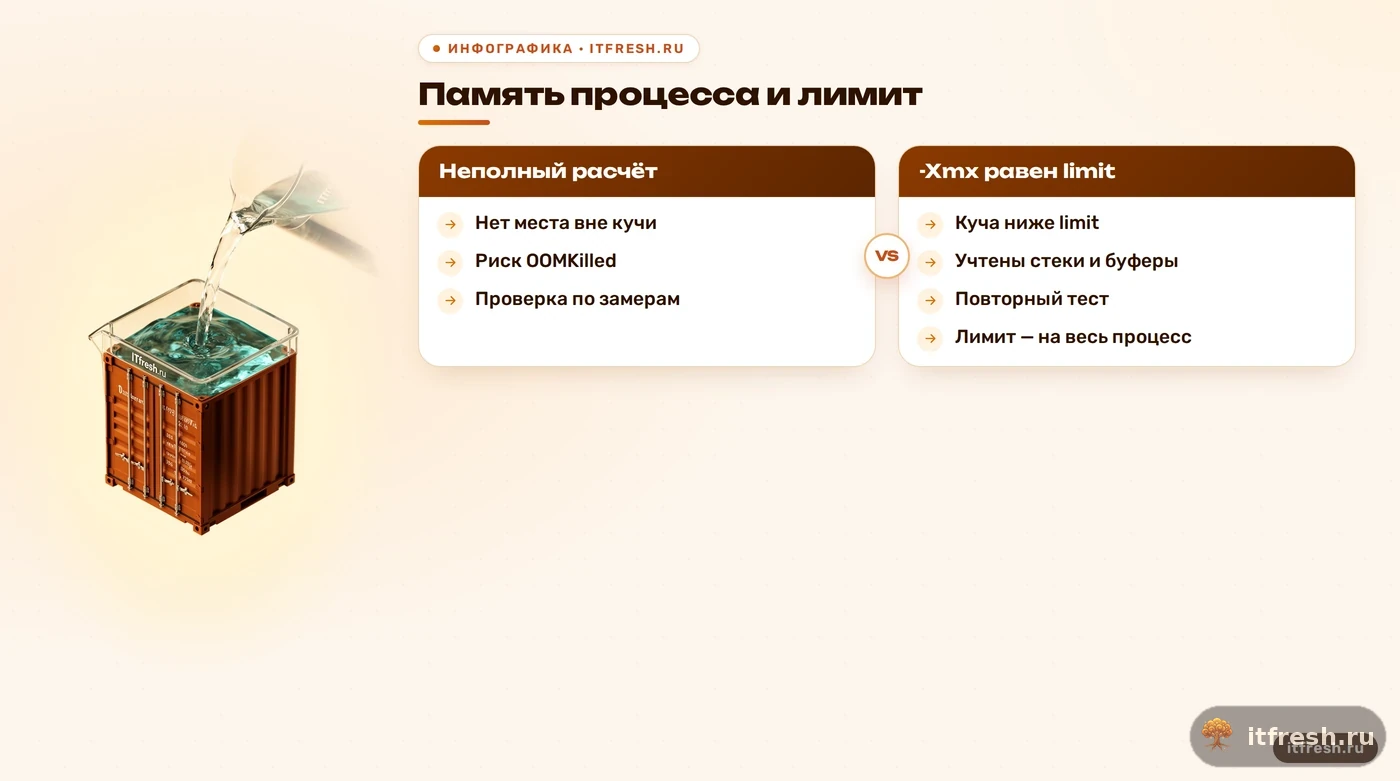
Лимит контейнера — потолок всего потребления, а не размер управляемой кучи. Поэтому я не ставлю -Xmx равным memory limit: кроме кучи JVM использует память на метаданные, стеки потоков, компиляцию и прямые буферы. В документации Oracle у -XX:MaxRAMPercentage указан размер максимальной Java-кучи как доля памяти, которую JVM определила доступной; документированное значение по умолчанию — 25 процентов. Это параметр для настройки, а не обещание, что вся остальная память автоматически останется в нужном запасе.
На Java я сначала проверяю версию JVM и видит ли она ограничения контейнера, затем задаю размер кучи с запасом на потребителей вне кучи. Универсальных 60–75 процентов я не назначаю: подходящая доля зависит от приложения, лимита, числа потоков и прямых буферов. Если поставить слишком высоко — за пределы лимита могут выйти другие области памяти; слишком низкая куча способна увеличить частоту сборки мусора и ухудшить задержку. Замер под профилем нагрузки полезнее красивого круглого числа.
В Node.js --max-old-space-size ограничивает старую область V8, а не всю память процесса. Официальная документация предупреждает: по мере приближения к установленному пределу V8 активнее собирает мусор. Значит, значение выбирают ниже лимита контейнера и проверяют вместе с внешней памятью процесса. У Go переменная GOMEMLIMIT появилась в Go 1.19; это мягкое ограничение памяти, управляемой рантаймом, оно не включает все внешние источники и не заменяет cgroup limit. Ни одна из этих настроек не превращает лимит Kubernetes в безопасную цифру автоматически.
Для Python не существует одной настройки «размер всей кучи», которая решит проблему для любого приложения. Я измеряю RSS процесса и число воркеров, проверяю объёмы одновременно обрабатываемых объектов и временных буферов. Если каждый worker держит копию крупного набора данных, добавление процессов может умножить потребление. Профилировщик и ограничение параллельности обычно дают больше пользы, чем увеличение числа реплик наугад.
Как выставить requests и limits без универсального процента
requests.memory участвует в планировании Pod: scheduler использует запрос, решая, помещается ли нагрузка на узел. Если на узле есть свободная память, контейнер может потребить больше request. limits.memory задаёт ограничение, которое на Linux обеспечивается ядром через cgroups; в отличие от CPU throttling, память ограничивается реактивно и превышение может привести к OOM kill. Поэтому request — не гарантированный физический резерв, а limit — не цель потребления.
Requests и limits не обязаны совпадать. Для класса QoS Guaranteed должны совпасть CPU и memory requests с limits у каждого контейнера, включая init-контейнеры. Это полезное свойство при выборе QoS, но не универсальная рекомендация для каждого сервиса: равные значения сокращают возможность использовать свободную память узла сверх request. QoS влияет на поведение при давлении узла, однако не лечит внутреннюю утечку и не отменяет собственный лимит контейнера.
Вместо «пик плюс 20–30 процентов» я беру наблюдения за репрезентативный цикл нагрузки, отдельно смотрю на запуск, фоновые задачи и редкие тяжёлые операции. Затем учитываю контейнеры Pod, накладные расходы рантайма и доступную память узла. Например, если измерения в повторяемом тесте показывают рабочий пик около 1,2 GiB, значение 1536 MiB можно проверить как стартовую гипотезу, но не выдавать за готовый норматив: тест надо повторить с запасом данных и параллельности, проверить перезапуски и поведение соседей. Число без такого контекста — декорация в YAML.
resources:
  requests:
    memory: "1536Mi"
    cpu: "500m"
  limits:
    memory: "1536Mi"
    cpu: "1000m"
Когда истории использования нет, сначала запускаю контролируемую нагрузку. VPA в режиме Off продолжает рассчитывать рекомендации, но не применяет их автоматически; их можно просмотреть в статусе ресурса. Это вспомогательная оценка по доступной истории, а не магическое предсказание редкого пика. LimitRange задаёт ограничения и может назначать значения по умолчанию в namespace, но проверьте его действие на конкретном Pod: значения по умолчанию способны скрыть отсутствие явной настройки в манифесте. В поддерживающих это кластерах ресурсы Pod можно менять на ходу; изменение ресурсов Pod без пересоздания упрощает применение настройки, но не подбирает корректный лимит вместо замеров.
- request помогает планировщику оценить размещение
- limit ограничивает потребление контейнера на Linux
- Guaranteed требует равенства CPU и memory request/limit
- VPA Off показывает рекомендацию без автоматического применения
Что ещё занимает память внутри Pod
Первый скрытый потребитель — emptyDir с medium: Memory. Kubernetes монтирует такой том как tmpfs, и записанные туда файлы учитываются в памяти контейнера, который их создал. Временная выгрузка или большой промежуточный файл поэтому может приблизить контейнер к лимиту, хотя приложение не строит огромную кучу. Я проверяю размер и срок жизни временных данных, а не только график JVM. Быстрый tmpfs удобен, пока его содержимое кто-то не начинает считать бесплатным.
Второй — сайдкары и init-контейнеры. Проверяйте статусы каждого контейнера по имени: если OOMKilled получил агент логов, увеличение лимита приложению ничего не исправит. Также учитывайте, что Pod имеет общий request, складывающий запросы контейнеров, а индивидуальные memory limits задаются для контейнеров. В частности, ограничение памяти Pod распространяется и на страницы памяти томов, поддержанных памятью. Сверьте манифест со способом сбора метрик, прежде чем суммировать значения. Если рядом с приложением работает сайдкар, не путайте его ресурсы с масштабированием: HPA и метрики сайдкара решают отдельную задачу и не заменяют проверку лимита памяти контейнера.
Третий кандидат — файловый кеш и память вне управляемой кучи. working_set — полезный сигнал для наблюдения, но его нельзя трактовать как точное показание «приложение заняло именно столько», не учитывая метод сбора. Сопоставляйте метрику с лимитом, cgroup-данными, runtime-профилем и временем события. Если процесс держит память вне кучи, heap dump может выглядеть спокойным, хотя общая память контейнера растёт.
Если память последовательно растёт между одинаковыми циклами нагрузки и не возвращается к привычному уровню, подозреваю удержание объектов, кеш без границ или утечку. Снимите heap dump или профиль в подходящий момент и сравните наборы объектов; для нативной памяти Java потребуются другие диагностические данные. Само повышение лимита лишь отодвигает повторение, а иногда делает последствия тяжелее для всего узла. Большое ведро — не ремонт крана.
Порядок действий: от статуса к исправлению
Условный расчёт: допустим, тест с данными и параллельностью, похожими на рабочие, показал около 1,2 GiB working set у приложения. Я не объявляю это «пиком навсегда»: проверяю отдельные тяжёлые задачи, контейнеры-соседи и запас узла. Затем оцениваю, подходит ли лимит 1536 MiB, согласую с ним параметры JVM и провожу повторный тест. Если новый прогон всё ещё заканчивается OOMKilled, смотрю, какая память росла и какой процесс её потреблял, а не добавляю ещё один случайный гигабайт.
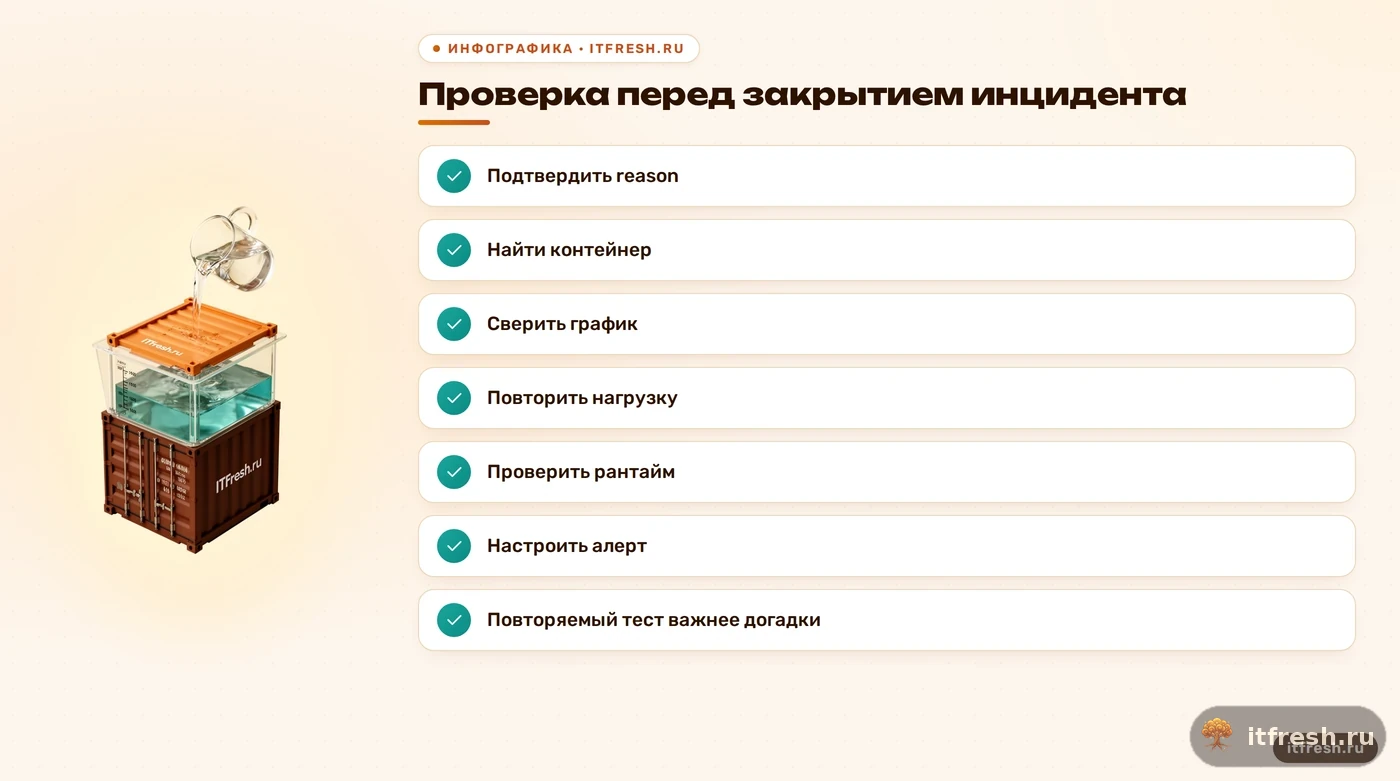
Мой порядок такой: подтвердить reason у конкретного контейнера; посмотреть события узла и Pod; восстановить график за момент падения; повторить нагрузочный профиль; проверить настройки рантайма и временные тома; пересчитать requests и limits; повторить тест и поставить оповещение на устойчивое приближение к лимиту. Порог алерта выбирайте по скорости роста и времени реакции команды: 90 процентов не является универсальным стандартом. Медленный рост и короткий пик требуют разных сигналов.
Если узел теряет память, изучаю общий запас и requests соседних Pod; если падает один контейнер на своём лимите — исследую его нагрузку и процессы; если OOM получил sidecar — исправляю именно его конфигурацию. Я также отделяю аварийный обход от окончательного решения: временно поднятый лимит должен сопровождаться повторным тестом и сроком пересмотра. Иначе временная мера быстро получает статус «так и было задумано».
Итоговая проверка — не один зелёный запуск. Я жду завершения обычного цикла работы, проверяю, что тяжёлая операция прошла, рестарты не растут, а график после нагрузки возвращается к ожидаемому уровню. Если обнаружена утечка, задача считается открытой, пока не найдена причина удержания памяти. Стабильность подтверждают повторяемые наблюдения, а не бодрый отчёт сразу после перезапуска.
Частые вопросы
Что означает OOMKilled в Kubernetes?
Контейнер завершился из-за нехватки памяти. Часто он превысил собственный memory limit, но проверьте reason, события и состояние узла.
Exit code 137 всегда означает OOM?
Нет. Код часто встречается при SIGKILL и может сопровождать OOMKilled, но причину подтверждайте полем reason в статусе контейнера.
Чем OOMKilled отличается от Evicted?
OOMKilled относится к завершению контейнера при проблеме с памятью. Evicted означает, что kubelet выселил Pod из-за давления ресурсов на узле.
Можно ли увидеть ночной пик через kubectl top?
Нет, kubectl top показывает недавние метрики без истории. Для уже прошедшего пика нужен мониторинг с сохранёнными данными.
Нужно ли всегда делать requests равными limits?
Нет. Такое равенство памяти и CPU у каждого контейнера — одно из условий QoS Guaranteed, но подходящие значения выбирают по профилю нагрузки и размещению.
Поможет ли увеличить лимит при утечке памяти?
Это может отсрочить следующий OOM, но не устранит удержание памяти. Нужно найти ростущие объекты, кеш или внешнее потребление и повторить нагрузочный тест.
Источники
- Kubernetes: Resource Management for Pods and Containers — Проверены requests, limits, OOMKilled и потребление memory-backed emptyDir: https://kubernetes.io/docs/concepts/configuration/manage-resources-containers/
- Kubernetes: Assign Memory Resources to Containers and Pods — Проверен пример OOMKilled с exit code 137 и просмотр состояния контейнера: https://kubernetes.io/docs/tasks/configure-pod-container/assign-memory-resource/
- Linux Kernel: Concepts overview — Проверено, что глобальный OOM killer выбирает задачу для завершения при исчерпании памяти: https://docs.kernel.org/admin-guide/mm/concepts.html
- Oracle Java: The java Command — Проверены назначение и значение по умолчанию -XX:MaxRAMPercentage в Java 21: https://docs.oracle.com/en/java/javase/21/docs/specs/man/java.html
- Node.js: Command-line API — Проверено назначение --max-old-space-size для старой области V8: https://nodejs.org/api/cli.html
- Go 1.19 Release Notes — Проверено появление мягкого лимита памяти и GOMEMLIMIT в Go 1.19: https://go.dev/doc/go1.19