
Промахнулись с размером PVC: откат неудачного расширения тома в Kubernetes 1.35 без удаления заявки
Лишний ноль в размере PVC — и вот контроллер по кругу долбится в хранилище, которого нет, квота namespace съедена вся целиком, а коллеги уже предлагают «просто пересоздать заявку». Пересоздавать не надо. С Kubernetes 1.34 механизм отката неудачного расширения тома стал GA и в ветке 1.35 работает без всяких фича-гейтов: вы просто уменьшаете запрошенный размер обратно, и кластер сам всё чинит. Ниже — как это устроено на уровне полей PVC, какие тут есть жёсткие ограничения, разбор аварии с хранилищем проектов ландшафтного бюро на 400 Ги и старый ручной сценарий через Retain, который всё ещё нужен, когда новый механизм не спасает.
Что реально происходит, когда вы промахнулись с размером
Начнём с механики, иначе дальше будет непонятно, почему одни действия разрешены, а другие API-сервер отбивает. У PersistentVolumeClaim есть четыре поля, вокруг которых крутится вся история расширения. .spec.resources.requests.storage — сколько вы попросили. .status.capacity.storage — сколько по факту есть у тома прямо сейчас, это правда о железе. .status.allocatedResources.storage — размер, до которого кластер уже пообещал расширить том и под который зарезервировал квоту. И .status.allocatedResourceStatuses — карта состояний операции изменения размера, ключ storage.
Когда вы правите запрос вверх, external-resizer (сайдкар рядом с контроллером вашего CSI-драйвера) записывает новую цифру в allocatedResources, ставит статус ControllerResizeInProgress и вызывает у драйвера ControllerExpandVolume. Дальше три варианта. Драйвер отвечает «ок» — статус переезжает в NodeResizePending, kubelet на ноде растягивает файловую систему, статус становится NodeResizeInProgress, потом обнуляется, а .status.capacity подтягивается до нового размера. Драйвер возвращает временную ошибку — resizer просто пишет событие и пробует снова. А вот если драйвер вернул терминальный код gRPC — INVALID_ARGUMENT, OUT_OF_RANGE или NOT_FOUND — операция помечается как ControllerResizeFailed, и попытки продолжаются, но уже с увеличенным бэкоффом.
Вот в этом состоянии заявка и зависает. Обратите внимание на ключевую вещь: allocatedResources остался равным вашей ошибочной цифре. Именно он, а не реальный размер тома, участвует в подсчёте квоты — по формуле max(spec.resources, status.allocatedResources). Это сделано намеренно, чтобы никто не гонял туда-сюда расширение и сжатие, обходя ResourceQuota. Побочный эффект вы и видите: вы просили 6 Ти по ошибке, тома как не было, так и нет, а квота requests.storage в неймспейсе висит занятой на 6 Ти, и следующий PVC в этом неймспейсе уже не создаётся.
Ещё один нюанс про ноду. Kubelet берётся расширять файловую систему только тогда, когда статус в NodeResizePending или NodeResizeInProgress И одновременно pv.Spec.Capacity больше pvc.Status.Capacity. Если нода упала с терминальной ошибкой и записала NodeResizeFailed, сама она из этого состояния не выйдет — ждёт, пока контроллер в external-resizer сверит состояние и вернёт заявку в NodeResizePending. Поэтому «перезапустить kubelet» тут обычно бесполезное занятие.
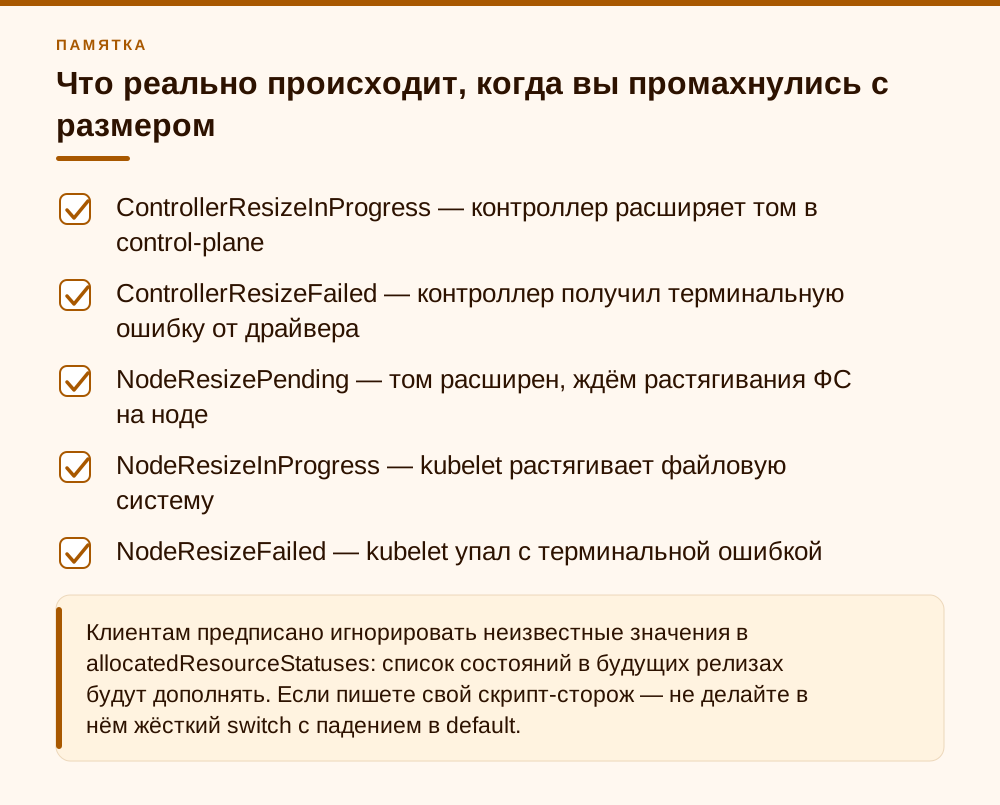
- ControllerResizeInProgress — контроллер расширяет том в control-plane
- ControllerResizeFailed — контроллер получил терминальную ошибку от драйвера
- NodeResizePending — том расширен, ждём растягивания ФС на ноде
- NodeResizeInProgress — kubelet растягивает файловую систему
- NodeResizeFailed — kubelet упал с терминальной ошибкой
- пустая строка / ключа нет — операция завершена успешно
Главное правило: уменьшать можно запрос, но не том
Самая частая путаница, которую я слышу от админов: «раз в 1.34 разрешили уменьшать размер PVC, значит, наконец-то завезли сжатие томов». Нет. Не завезли и, судя по настроению SIG Storage, не завезут в обозримом будущем. Уменьшать разрешили только цифру в заявке — то есть намерение, — и только пока это намерение ещё не исполнено. Сам PersistentVolume не сжимается никогда: если хранилище уже честно выделило вам 600 Ги, вернуть их обратно средствами Kubernetes нельзя, только пересоздавать том и переливать данные.
Отсюда вытекает жёсткое ограничение, о которое спотыкаются на первой же попытке. Новый запрошенный размер должен быть строго больше .status.capacity. Вернуться ровно к исходной цифре нельзя. Если том был 10 Ги, вы попросили 100 Ги и расширение упало, то откатиться можно до 11 Ги или любого значения выше 10 Ги, но не до самих 10 Ги. Формально доступный коридор выглядит так: status.capacity < новый запрос ≤ предыдущий (провалившийся) запрос. И работает это только пока бэкенд не успел завершить неудачную операцию: если хранилище всё-таки домучило расширение до огромного размера, откатывать уже нечего.
Механизм описан в KEP-1790, фича-гейт называется RecoverVolumeExpansionFailure. По kep.yaml история такая: alpha в 1.23 (выключен по умолчанию), beta в 1.32 (включён по умолчанию), GA в 1.34. В ветке 1.35 (релиз «Timbernetes», вышел 17 декабря 2025 года; последний патч на момент написания — 1.35.8 от 11 августа 2026-го) он работает без каких-либо флагов. На 1.23–1.31 гейт существует, но выключен, и включать alpha-фичу на проде ради одной аварии я бы не стал — там такие ситуации разбираются руками через Retain, о чём отдельный раздел ниже.
И маленькое, но важное про версии компонентов. Само расширение PVC стабильно с 1.24, но механизм отката затрагивает сразу несколько компонентов: kube-apiserver (валидация уменьшения), kube-controller-manager, external-resizer в составе CSI-драйвера и kubelet. Если сайдкар резайзера старый, он просто не знает про allocatedResources и статусы, и откат не отработает так, как описано в документации. Порядок обновления стандартный: control-plane, потом ноды (kubelet не новее apiserver), потом сайдкары драйвера. Точную минимальную версию csi-resizer смотрите в release notes конкретного драйвера — у ceph-csi, TopoLVM, Longhorn и облачных драйверов она своя.
Отдельно про онлайн и офлайн расширение, потому что от этого зависит, увидите ли вы место без простоя. Если CSI-драйвер умеет онлайн-расширение (capability ONLINE у ControllerExpandVolume и поддержка NodeExpandVolume на смонтированном томе), kubelet растягивает ext4 или XFS под работающим подом. Если драйвер поддерживает только офлайн-режим, .status.capacity не обновится, пока том не отмонтируют: заявка будет висеть в NodeResizePending, пока вы не пересоздадите под. Это нормальное состояние, а не авария, и путать его с NodeResizeFailed не надо.
- Уменьшать можно только `.spec.resources.requests.storage`, сам PV не сжимается никогда
- Новое значение должно быть строго больше `.status.capacity`
- Откат возможен, пока бэкенд не завершил расширение до ошибочного размера
- `allowVolumeExpansion: true` в StorageClass обязателен, иначе API отклонит любую правку размера
- На 1.34+ фича GA и включена всегда, на 1.32–1.33 это beta (включена по умолчанию), на 1.23–1.31 alpha (выключена)
Разбор аварии: лишний ноль в PVC хранилища проектов
Клиент — бюро ландшафтного проектирования «ПейзажБюро», 12 рабочих мест: архитекторы, дендролог, визуализатор и бухгалтер. Сразу оговорюсь: своего Kubernetes у бюро нет и быть не должно. Проекты (DWG, генпланы, фотофиксация участков, рендеры) лежат в сервисе файлового хранения, который бюро арендует у подрядчика, а подрядчик крутит его в Kubernetes. Мы у бюро на IT-аутсорсинге и по договору с подрядчиком имеем read-only доступ к их неймспейсу, чтобы участвовать в разборах. Кластер у подрядчика типовой: три control-plane, три воркера, Kubernetes 1.35.6, локальные NVMe и TopoLVM в качестве CSI. В неймспейсе бюро живёт StatefulSet filestore с PVC data-filestore-0 на 400 Ги, StorageClass topolvm-nvme с allowVolumeExpansion: true, на неймспейс висит ResourceQuota requests.storage: 10Ti.
Пятница, вечер, накануне сдачи проекта парка визуализатор выгружает пачку рендеров, и том заполняется на 86 %. Дежурный подрядчика идёт расширять до 800 Ги и в манифесте пишет 8000Gi. Квота в 10 Ти это пропускает — admission не возражает. TopoLVM смотрит на volume group ноды, где всего 1,8 Ти, и возвращает терминальный OUT_OF_RANGE. Заявка встаёт в ControllerResizeFailed, allocatedResources фиксируется на 8000Gi. Первый видимый симптом прилетел не от дизайнеров, а к нам: ночная задача выгрузки резервной копии проектов не смогла создать временный PVC — exceeded quota: requests.storage. Из 10 Ти квоты свободными оставались около 2 Ти вместо ожидаемых 9,6.
Диагностика заняла минуту — ровно потому, что смотреть надо не в describe пода, а в статус заявки:
kubectl get pvc data-filestore-0 -n peyzazh \
  -o jsonpath='{.spec.resources.requests.storage}{"\t"}{.status.capacity.storage}{"\t"}{.status.allocatedResources.storage}{"\t"}{.status.allocatedResourceStatuses}{"\n"}'
# 6000Gi	300Gi	6000Gi	{"storage":"ControllerResizeFailed"}
Лечение — одна команда, которую выполнил дежурный подрядчика, пока мы были с ним на связи. Никаких удалений PVC, никаких манипуляций с PV, файловый сервис всё это время продолжал работать, и сотрудники бюро об инциденте узнали только из утреннего отчёта:
kubectl patch pvc data-filestore-0 -n peyzazh --type=merge \
  -p '{"spec":{"resources":{"requests":{"storage":"800Gi"}}}}'
Дальше кластер отработал сам. Примерно через сорок секунд статус переехал в ControllerResizeInProgress, allocatedResources пересчитался на 800Gi, и в этот же момент отпустило квоту — задачу резервного копирования мы перезапустили вручную, и она прошла. Ещё через полторы минуты статус стал NodeResizePending, kubelet онлайн растянул XFS под работающим подом, поле статусов опустело, .status.capacity показал 800Gi. От нашего алерта до закрытия — 14 минут, простоя сервиса ноль, перезапуска пода не потребовалось.
Для бюро на 12 человек выводы из этой истории не про Kubernetes, а про договор с подрядчиком. Мы добились трёх вещей: доступ на чтение к статусам PVC и квоте, уведомление о любых изменениях размера томов и отдельный пункт в регламенте о проверке резервной копии после таких работ. Сорвавшаяся ночная копия накануне сдачи проекта — ровно тот риск, который маленькая компания замечает последней.
- Симптом: не создаётся соседний PVC, ошибка `exceeded quota: requests.storage`
- Причина: `allocatedResources` застрял на ошибочных 8000Gi в `ControllerResizeFailed`
- Лечение: `kubectl patch` запроса до 800Gi, выше `.status.capacity` в 400Gi
- Проверка: пустой `allocatedResourceStatuses`, capacity 800Gi, квота освобождена
- После: ручной перезапуск пропущенной резервной копии и её проверка
Диагностика по шагам: куда смотреть и в каком порядке
Порядок действий, который я держу в голове и который отдал дежурным как чек-лист. Первое — снять полную картину по заявке одной командой, как выше. Если allocatedResourceStatuses пустой, а размеры сходятся, значит проблема вообще не в расширении и надо идти в другое место. Второе — прочитать события PVC: там будет и текст ошибки от драйвера, и понимание, терминальная она или контроллер просто крутится по кругу.
kubectl describe pvc data-filestore-0 -n peyzazh | sed -n '/Events/,$p'
kubectl -n kube-system logs deploy/topolvm-controller -c csi-resizer --tail=200
kubectl get resourcequota -n peyzazh -o yaml | grep -A3 requests.storage
Третье — понять, на чьей стороне затык. ControllerResize* — это control-plane и сам драйвер, лечится правкой запроса. NodeResize* — том уже расширен, но файловая система на ноде не растянута; тут смотрите логи kubelet на конкретной ноде и место в самой ФС, а также поддерживает ли драйвер онлайн-расширение. Для RWX-томов, где CSI-драйвер отвечает NodeExpansionRequired: false, kubelet вообще не дёргается — на PV висит аннотация volume.kubernetes.io/node-expansion-not-required.
Четвёртое — регулярный сторож по всему кластеру, а не только по той заявке, на которую пожаловались. Готовой метрики под allocatedResourceStatuses в kube-state-metrics я на момент написания не нашёл, поэтому у нас это простой CronJob с jq, который раз в пять минут собирает все PVC с непустым статусом и отправляет алерт дежурному. Выглядит так:
kubectl get pvc -A -o json | jq -r '
  .items[]
  | select(.status.allocatedResourceStatuses != null)
  | [ .metadata.namespace,
      .metadata.name,
      (.status.capacity.storage // "-"),
      (.status.allocatedResources.storage // "-"),
      (.status.allocatedResourceStatuses.storage // "-") ]
  | @tsv'
Эта штука ловит не только аварии, но и «подвисшие» расширения, которые формально в процессе, но идут уже сутки — что для локального LVM ненормально и означает, что кто-то забыл про ноду с заполненной VG. Один такой висяк у нас нашёлся в тестовом неймспейсе через неделю после внедрения сторожа; никто про него не знал полтора месяца.
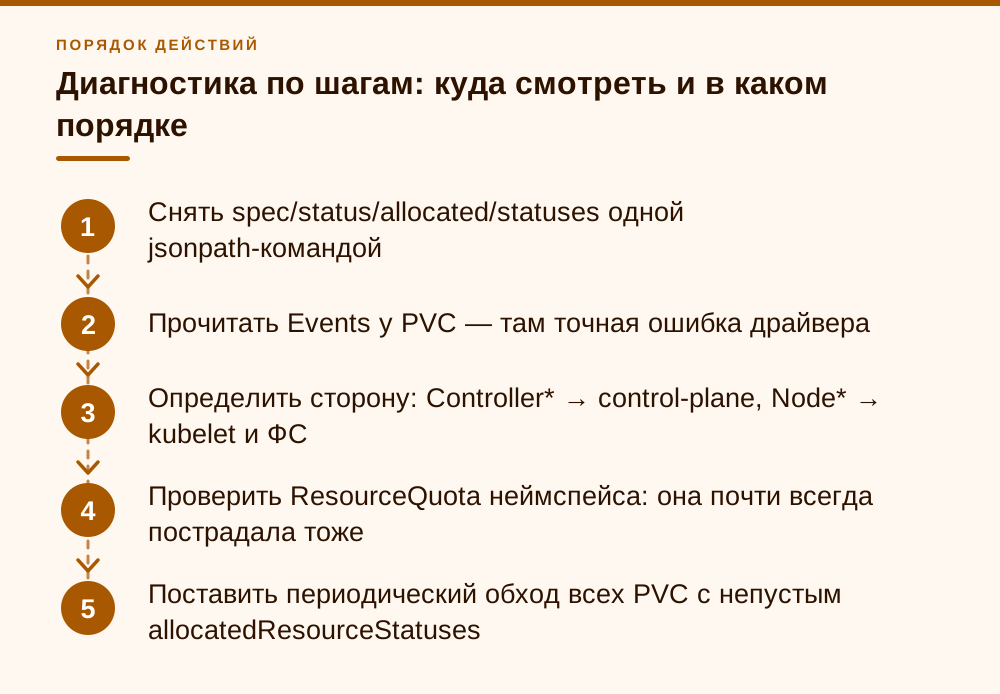
- Снять spec/status/allocated/statuses одной jsonpath-командой
- Прочитать Events у PVC — там точная ошибка драйвера
- Определить сторону: Controller* → control-plane, Node* → kubelet и ФС
- Проверить ResourceQuota неймспейса: она почти всегда пострадала тоже
- Поставить периодический обход всех PVC с непустым allocatedResourceStatuses
Когда откат не спасает: ручной сценарий через Retain
Механизм отката бессилен в двух случаях. Первый: хранилище всё-таки довело неудачное расширение до конца — том физически стал огромным, и .status.capacity уже равен вашей ошибочной цифре. Второй: вам действительно нужно меньше, чем сейчас на томе, то есть нужно то самое сжатие, которого в Kubernetes нет. Тогда остаётся классический ручной путь, описанный в документации по PersistentVolumes: подменить PV под новой заявкой, сохранив данные.
Последовательность именно такая и порядок шагов нарушать нельзя, иначе PV уедет в Released и, при политике Delete, будет снесён вместе с диском:
PV=$(kubectl get pvc data-filestore-0 -n peyzazh -o jsonpath='{.spec.volumeName}')

# 1. защищаем данные
kubectl patch pv "$PV" -p '{"spec":{"persistentVolumeReclaimPolicy":"Retain"}}'

# 2. удаляем заявку (том остаётся)
kubectl delete pvc data-filestore-0 -n peyzazh

# 3. отвязываем PV от старой заявки
kubectl patch pv "$PV" --type=json -p '[{"op":"remove","path":"/spec/claimRef"}]'

# 4. создаём новую PVC с нужным размером и volumeName: $PV
#    (манифест применяем отдельно)

# 5. возвращаем исходную политику
kubectl patch pv "$PV" -p '{"spec":{"persistentVolumeReclaimPolicy":"Delete"}}'
Скажу прямо, где здесь настоящий риск, а где его раздувают. Раздувают вокруг шага 2: «удалять PVC с рабочими проектами страшно». При выставленном Retain это безопасно, том никуда не денется, проверяется одной командой до удаления. А вот настоящая мина — шаг 1, если его пропустить. Дефолтная политика у динамически созданных PV почти всегда Delete, и удаление заявки в этом случае уносит диск с данными за секунды, без подтверждений и без корзины. Именно поэтому в наших регламентах шаг 1 вынесен в отдельный пункт с обязательной проверкой вывода kubectl get pv $PV -o jsonpath='{.spec.persistentVolumeReclaimPolicy}' перед тем, как трогать PVC.
Второй подводный камень — StatefulSet. Он сам создаёт заявки по шаблону volumeClaimTemplates, и имя новой PVC должно совпадать до символа: data-filestore-0, а не data-filestore-0-new. И размер в шаблоне StatefulSet тоже придётся править, иначе контроллер при следующем масштабировании начнёт спорить с вами о цифрах. Правка volumeClaimTemplates у существующего StatefulSet в общем случае запрещена — придётся пересоздавать объект с --cascade=orphan, оставив поды жить. Это отдельная операция, планируйте её в окно.
- Проверить reclaim policy у PV и перевести его в Retain
- Убедиться, что есть свежая проверенная резервная копия данных
- Удалить PVC и снять `claimRef` с PV
- Создать PVC с тем же именем и `volumeName`, дождаться Bound
- Вернуть исходную reclaim policy и поправить `volumeClaimTemplates`
Как не попадать в это второй раз
Приоритеты я расставляю так. Первое и самое дешёвое — квота с адекватным потолком. Не «10 Ти на всякий случай», а величина, которая реально помещается в ваше железо. В кейсе «ПейзажБюро» квота 10 Ти на неймспейс при физических 1,8 Ти в VG ноды была бесполезной формальностью: она пропустила заведомо невыполнимый запрос. Поставьте requests.storage близко к тому, что вы действительно можете выделить, и ошибка на лишний ноль будет отбита ещё на admission — заявка даже не уйдёт в failed-состояние и квоту не съест.
Второе — PVC не должны редактироваться руками на проде вообще. Всё через Git и pull request, где второй человек глазами видит diff 400Gi → 8000Gi. Это не про идеологию GitOps, а про то, что человек, который в 21:40 правит размер тома в терминале, промахивается на порядок примерно раз в год гарантированно. Стоимость ревью — минута, стоимость промаха — от четверти часа до ночного окна с Retain-плясками.
Третье — проверьте заранее, что расширение у вас вообще работает, а не выяснится в момент аварии. allowVolumeExpansion: true в StorageClass — обязательное условие, без него любая правка размера просто отклонится. Прогоняйте раз в квартал на тестовом PVC полный цикл: расширение вверх, заведомо провальное расширение, откат вниз. Пять минут, зато вы знаете, что ваш конкретный драйвер отдаёт терминальные коды правильно и статусы двигаются. Не все вендорские драйверы одинаково честны: некоторые вместо OUT_OF_RANGE возвращают INTERNAL или RESOURCE_EXHAUSTED, и тогда заявка не встаёт в ControllerResizeFailed, а вечно ретраится, что диагностируется тяжелее.
Четвёртое — про версии. По странице релизов kubernetes.io ветка 1.35 поддерживается до 28 февраля 2027 года, а актуальной на момент написания статьи является 1.37 (1.37.0 вышла 26 августа 2026). За два месяца до EOL ветка уходит в maintenance mode, где выходят только критичные исправления. Если вы на 1.35, учтите ещё и то, что проект объявлял её последним релизом с поддержкой containerd 1.x — перед переходом на 1.36 проверьте версию containerd на нодах. Планировать апгрейд стоит сейчас, а не в феврале 2027-го.
- ResourceQuota requests.storage — по реальному объёму пула, а не «с запасом»
- allowVolumeExpansion: true в каждом StorageClass, где вы планируете рост
- Правки размеров PVC — только через Git с ревью
- Квартальный прогон полного цикла расширение/провал/откат на тестовом PVC
- Сторож по allocatedResourceStatuses во всех неймспейсах
- План апгрейда с 1.35: EOL 28.02.2027, до этого — проверка containerd 2.x на нодах
Что здесь спорно и о чём стоит знать заранее
Честно про неоднозначные места. Первое: единого мнения о том, насколько агрессивно надо ставить квоты, нет. Жёсткая квота ловит опечатки на входе, но она же будет резать легитимный рост в три часа ночи, когда база упирается в диск, а поставить новый лимит некому. Я выбираю жёсткую квоту плюс дежурного с правом её поднять — но у команды без круглосуточного дежурства выбор может быть обратным, и это нормально.
Второе: наименование статусов. В alpha-реализации KEP-1790 (1.23–1.31) значения назывались ControllerResizeInfeasible и NodeResizeInfeasible; с переходом в beta в 1.32 их переименовали, и в текущем API это ControllerResizeFailed и NodeResizeFailed. Если вы читаете старые статьи или у вас в мониторинге зашиты «Infeasible», проверьте, что скрипты не молчат из-за переименования. И ещё раз: документация прямо просит игнорировать незнакомые значения, список будут расширять.
Третье: возврат квоты и «уменьшение» на уровне бухгалтерии ресурсов работает, но фактически выделенное место хранилище вам не вернёт. Если драйвер успел выкроить лишнее до того, как вы поправили запрос, вы получите том большего размера, чем нужно, и оплачивать (или занимать в пуле) будете именно его. В облаках это прямые деньги, на своём железе — просто съеденное место в VG. Отсюда практический вывод: реагировать на ControllerResizeFailed надо не «в понедельник», а сразу.
И четвёртое, о чём почти не пишут. Расширение тома — это не только про CSI, но и про приложение внутри. PostgreSQL, MS SQL и файловые сервисы вроде Nextcloud прекрасно переживают онлайн-рост файловой системы, а вот некоторые самописные сервисы кешируют размер тома при старте и после расширения продолжают считать, что места нет. Если после успешного расширения df -h в поде показывает новую цифру, а приложение всё равно ругается на нехватку — это уже не Kubernetes, это перезапуск пода и разговор с разработчиками.
- Жёсткая квота против ночного роста: выбор зависит от наличия дежурного
- Статусы Infeasible из alpha переименованы в Failed начиная с 1.32
- Возврат квоты не возвращает место, уже выделенное бэкендом
- Приложение может не увидеть новое место без перезапуска пода
Частые вопросы
Можно ли уменьшить PVC, если расширение прошло успешно?
Нет. Механизм отката работает только для незавершённого или провалившегося расширения. Как только том фактически вырос и это отражено в .status.capacity, уменьшить его средствами Kubernetes нельзя — сжатие томов не поддерживается. Останется только создать новый PVC нужного размера и перелить данные.
Нужно ли включать фича-гейт RecoverVolumeExpansionFailure в Kubernetes 1.35?
Нет. Механизм стал GA в 1.34 и в 1.35 работает всегда. В 1.32–1.33 он в beta и включён по умолчанию. В 1.23–1.31 это alpha, гейт выключен, а значения статусов назывались Infeasible — там надёжнее ручной сценарий через Retain.
Почему после неудачного расширения перестали создаваться другие PVC в неймспейсе?
Квота считается как max(spec.resources, status.allocatedResources), и зависшая заявка держит её по ошибочной цифре. Пока вы не исправите .spec.resources.requests.storage на разумное значение, квота остаётся занятой. После правки контроллер пересчитывает allocatedResources и квота освобождается — обычно в течение минуты.
До какого минимального размера можно откатить неудачный запрос?
Строго больше текущего .status.capacity. Если том был 10 Ги, а вы попросили 100 Ги и расширение упало, откатиться можно до 11 Ги или больше, но ровно до 10 Ги — нельзя. Точное значение фактической ёмкости всегда смотрите в .status.capacity, а не в манифесте.
Нужно ли перезапускать под, чтобы расширение доехало до файловой системы?
В большинстве современных драйверов — нет, файловая система растягивается онлайн под работающим подом. Перезапуск нужен, если ваш CSI-драйвер не поддерживает online expansion либо если приложение внутри пода закешировало размер тома при старте и не видит новое место, хотя df уже показывает правильную цифру.
Что делать, если статус завис в NodeResizeFailed?
Ждать реконсиляции со стороны external-resizer: kubelet сам из этого состояния не выходит, контроллер должен вернуть заявку в NodeResizePending. Параллельно смотрите логи kubelet на конкретной ноде — чаще всего причина в самой файловой системе или в том, что нода не видит увеличенное блочное устройство.
Почему заявка висит в ControllerResizeInProgress и не переходит в Failed?
Драйвер возвращает нетерминальную ошибку, например RESOURCE_EXHAUSTED при исчерпании квоты облачного провайдера. Терминальными KEP-1790 считает только INVALID_ARGUMENT, OUT_OF_RANGE и NOT_FOUND. Смотрите события PVC и логи csi-resizer; если размер ошибочный — уменьшите запрос, если верный — решайте вопрос с квотой у провайдера.
Источники
- Kubernetes Documentation — Concepts → Storage → Persistent Volumes, разделы «Expanding Persistent Volume Claims» и «Recovering from Failure when Expanding Volumes» (требование allowVolumeExpansion, ручной сценарий через Retain/claimRef/volumeName, наблюдение за .status.allocatedResourceStatuses и событиями PVC): https://kubernetes.io/docs/concepts/storage/persistent-volumes/
- Блог Kubernetes — «Kubernetes v1.34: Recovery From Volume Expansion Failure (GA)», 19 сентября 2025 — переход KEP-1790 в GA, уменьшение запроса без вмешательства администратора, возврат квоты, ограничение «новый размер выше .status.capacity»: https://kubernetes.io/blog/2025/09/19/kubernetes-v1-34-recover-expansion-failure/
- Kubernetes API Reference — PersistentVolumeClaim v1, поля status.allocatedResources и status.allocatedResourceStatuses, полный перечень значений ClaimResourceStatus (ControllerResizeInProgress, ControllerResizeFailed, NodeResizePending, NodeResizeInProgress, NodeResizeFailed) и требование игнорировать неизвестные значения: https://kubernetes.io/docs/reference/kubernetes-api/config-and-storage-resources/persistent-volume-claim-v1/
- KEP-1790, kubernetes/enhancements — sig-storage/1790-recover-resize-failure (kep.yaml: alpha v1.23, beta v1.32, stable v1.34) — правила валидации уменьшения spec.resources.requests.storage, формула квоты max(spec.resources, status.allocatedResources), терминальные коды gRPC INVALID_ARGUMENT / OUT_OF_RANGE / NOT_FOUND, условия работы kubelet и аннотация volume.kubernetes.io/node-expansion-not-required: https://github.com/kubernetes/enhancements/tree/master/keps/sig-storage/1790-recover-resize-failure
- Kubernetes Releases — Страница релизов и жизненного цикла версий: 1.35 патч 1.35.8 от 11.08.2026, EOL 28.02.2027; актуальная ветка 1.37.0 от 26.08.2026: https://kubernetes.io/releases/
- Блог Kubernetes — «Kubernetes v1.35: Timbernetes (The World Tree Release)», 17 декабря 2025: https://kubernetes.io/blog/2025/12/17/kubernetes-v1-35-release/