
После sidecar HPA перестал масштабировать по CPU: где нужен ContainerResource
Если после добавления sidecar HPA перестал добавлять реплики, дело в формуле: Utilization считается как сумма потребления всех контейнеров пода к сумме их requests. Sidecar без request выключает метрику, а «лёгкий» sidecar занижает её. Лечится метрикой ContainerResource по основному контейнеру — ниже арифметика, кейс, манифест и грабли.
Почему HPA перестал масштабировать после добавления sidecar
Сценарий, который я видел уже раз пять, и каждый раз он выглядит одинаково — чаще всего его приносят клиенты, которым мы помогаем с внедрением Kubernetes и open-source. В пятницу в Deployment добавили sidecar — прокси авторизации, sidecar сервис-меша, агент трейсинга, лог-шиппер, неважно. В понедельник приходит нагрузка, приложение задыхается, p95 уезжает в потолок, а количество реплик стоит колом. Дежурный смотрит kubectl get hpa, видит там либо <unknown>/75%, либо вполне приличные 62%/75% — и уходит копать в базу, в сеть, в ingress. Теряет день. А сломалось ровно в момент добавления sidecar.
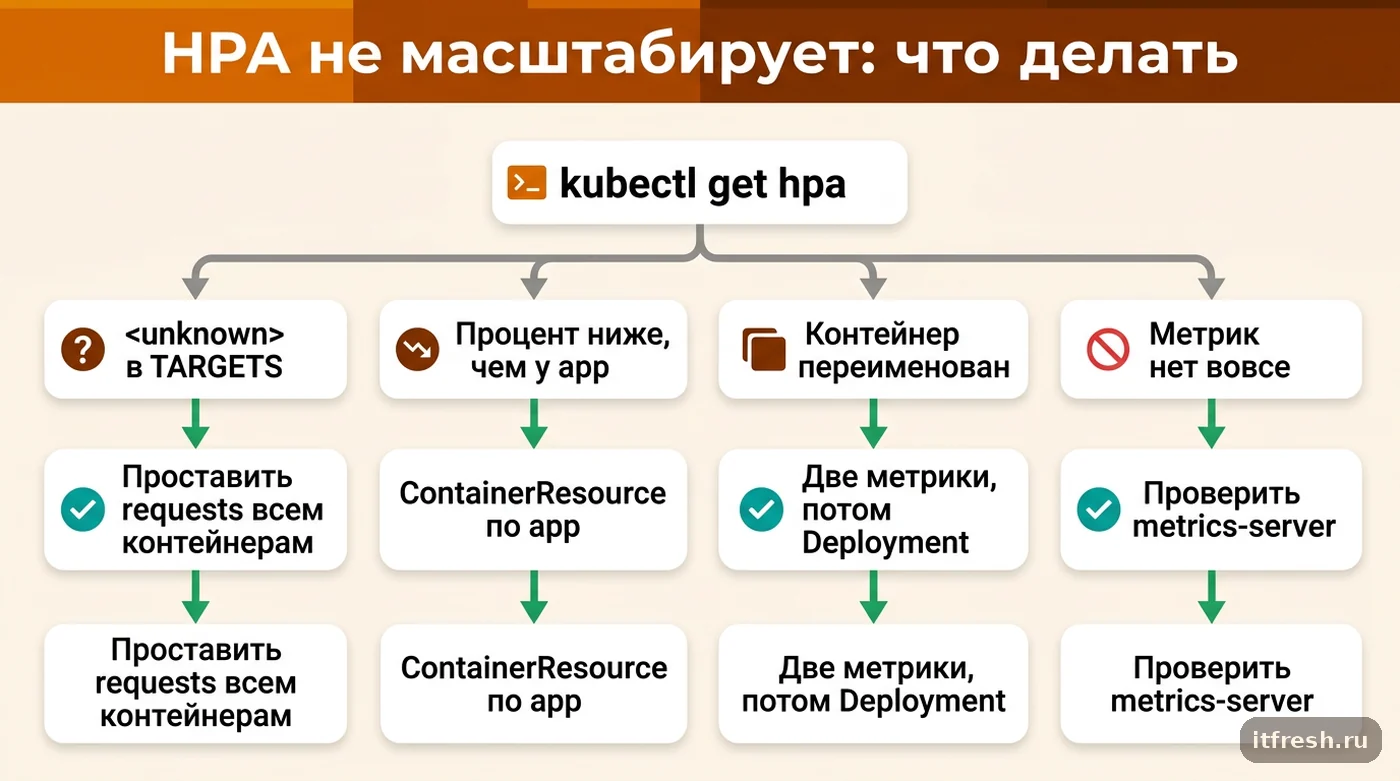
Отказов тут на самом деле два, и они разные. Первый — жёсткий: sidecar приехал вообще без resources.requests.cpu. Тогда утилизация пода не определена в принципе, и документация про это говорит прямым текстом: «if some of the Pod's containers do not have the relevant resource request set, CPU utilization for the Pod will not be defined and the autoscaler will not take any action for that metric». В kubectl describe hpa вы увидите условие ScalingActive=False с причиной вида FailedGetResourceMetric и текстом про missing request for cpu. HPA просто выключается по этой метрике. Хорошая новость — это заметно.
Второй отказ — тихий, и он опаснее. Sidecar приехал с корректным request, всё формально валидно, HPA живой, проценты показывает. Только эти проценты больше не про ваше приложение. Sidecar добавил свой request в знаменатель, а потребляет он при этом копейки — и общая цифра поехала вниз ровно тогда, когда основной контейнер начал упираться. Ничего не падает, алертов нет, просто автомасштабирование стало отвечать с опозданием или не отвечать вовсе. Такое живёт в проде месяцами.
Диагностика занимает две минуты и делается вот так:
kubectl get hpa donate-api -n prod -o wide
kubectl describe hpa donate-api -n prod | sed -n '/Conditions/,$p'
# главное — разложить потребление по контейнерам, а не по подам
kubectl top pod -n prod -l app=donate-api --containers
# и сверить с тем, что реально запрошено
kubectl get deploy donate-api -n prod -o jsonpath=\
'{range .spec.template.spec.containers[*]}{.name}{"\t"}{.resources.requests.cpu}{"\n"}{end}'- `<unknown>/75 %` в выводе `kubectl get hpa` — у какого-то контейнера нет CPU request. Отказ жёсткий и видимый.
- Проценты есть, но заметно ниже, чем показывает `kubectl top pod --containers` для основного контейнера, — знаменатель раздут sidecar-ом. Отказ молчаливый.
- Реплики скачут ночью на пустом трафике — sidecar (обычно лог-шиппер на ротации или агент сбора метрик) тянет метрику вверх сам по себе.
Как HPA считает CPU Utilization для пода из нескольких контейнеров
Метрика типа Resource с target.type: Utilization считается не так, как думает большинство. Во-первых, знаменатель — это **requests**, а не limits. Во-вторых, при нескольких контейнерах в поде это не «максимум по контейнерам» и не «средняя по контейнерам», а отношение суммы к сумме: суммарное потребление всех контейнеров пода делится на суммарный request всех контейнеров пода. Дальше HPA усредняет это по всем готовым подам и подставляет в формулу desiredReplicas = ceil(currentReplicas × currentMetricValue / desiredMetricValue), а если отношение достаточно близко к единице — в пределах допуска, по умолчанию 10 % — не делает вообще ничего.
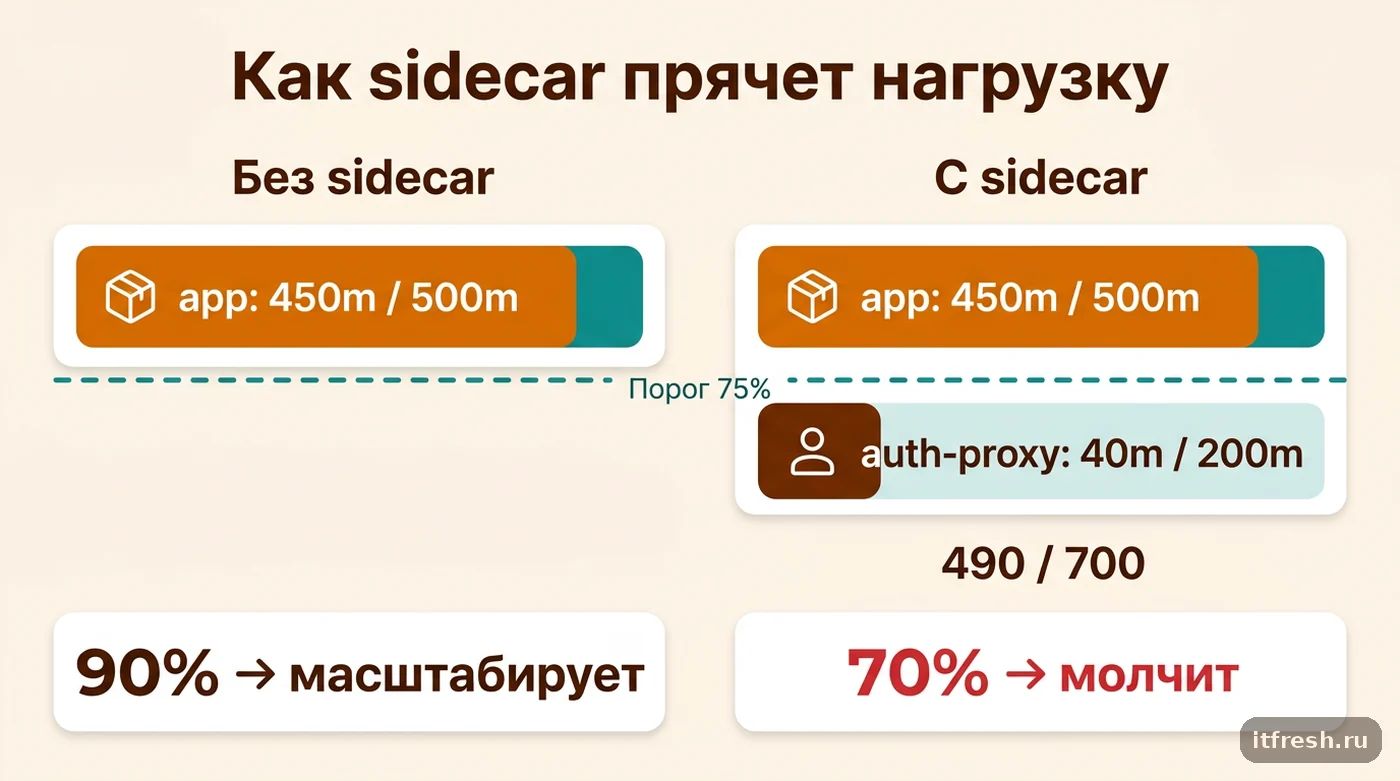
Разберём на числах, потому что так нагляднее. Был один контейнер app: request 500m, под нагрузкой ест 450m. Утилизация 90 %, порог 75 % — HPA бодро добавляет реплики. Приехал sidecar auth-proxy с request 200m, который при той же нагрузке ест 40m. Считаем: (450 + 40) / (500 + 200) = 490/700 = 70 %. Приложение как упиралось в свой request, так и упирается, а HPA видит 70 % при пороге 75 % и спокойно спит. Мы не поменяли ни строчки в коде приложения и ни цифры в его requests — но автомасштабирование выключилось.
Эффект тем сильнее, чем «легче» sidecar относительно своего request. И он двусторонний: тот же sidecar, который занижает метрику под нагрузкой, будет завышать её на простое, если у него есть фоновая активность — ротация логов, периодический скрейп, переподключение к control plane меша. Я видел стенд, где ночью на нулевом трафике HPA держал на две реплики больше положенного просто потому, что fluent-bit раз в минуту дожимал буфер.
И третья мелочь, про которую забывают: допуск в 10 % работает поверх уже искажённой цифры. То есть даже если вы аккуратно подкрутите порог с 75 % на 68 %, чтобы «скомпенсировать sidecar», компенсация будет верной ровно для одного профиля нагрузки. Изменилось соотношение работы app и sidecar — расчёт снова врёт. Подкручивание порога здесь не решение, а отсрочка. Кстати, если хочется поменять requests без пересоздания подов, в свежих версиях для этого есть изменение ресурсов работающего Pod — но на арифметику HPA это никак не влияет: знаменатель просто станет другим.
- Знаменатель — requests, не limits. Если у вас request 500m и limit 2000m, HPA считает от 500m и спокойно доведёт контейнер до троттлинга.
- Несколько контейнеров = сумма/сумма. Один «тяжёлый по request, лёгкий по факту» sidecar портит всю картину.
- Нет request хотя бы у одного контейнера — метрики пода нет вообще, HPA бездействует.
- Допуск 10 % (флаг kube-controller-manager `--horizontal-pod-autoscaler-tolerance`; с 1.33 можно задать поле `tolerance` в `spec.behavior` за feature gate `HPAConfigurableTolerance`, в 1.37 оно стало стабильным) добавляет сверху ещё одну мёртвую зону.
Кейс: платёжный сервис и 6 реплик при трафике ×3,5
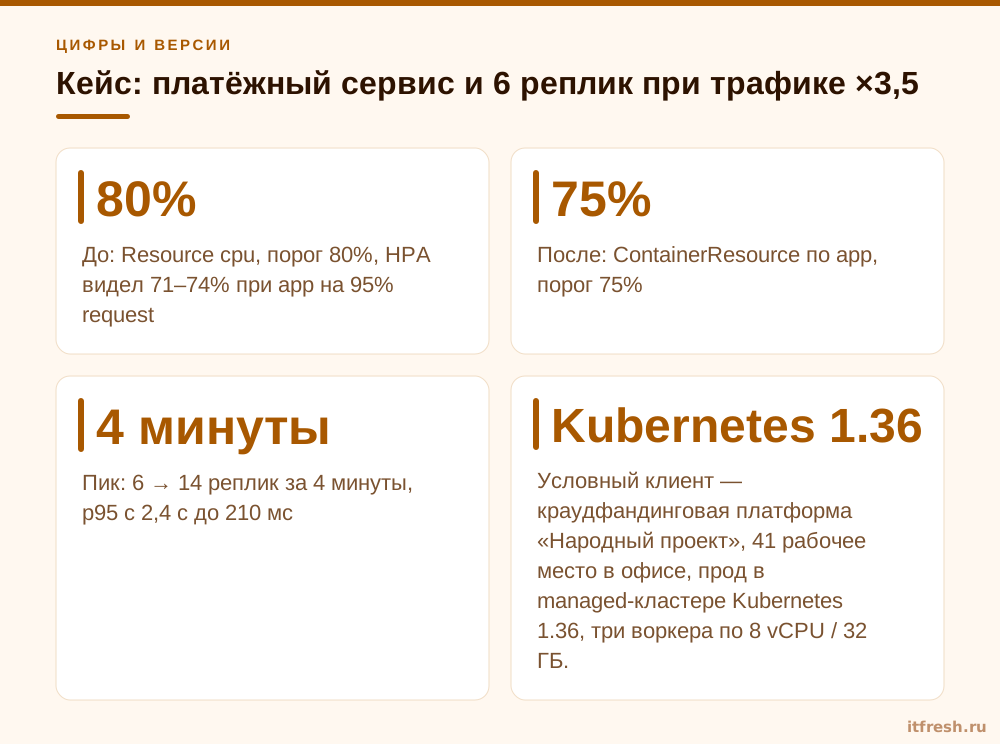
Условный клиент — краудфандинговая платформа «Народный проект», 41 рабочее место в офисе, прод в managed-кластере Kubernetes 1.36, три воркера по 8 vCPU / 32 ГБ. Ключевой сервис — donate-api, через который проходят платежи жертвователей: Deployment на 6 реплик, HPA с minReplicas: 3, maxReplicas: 20, метрика Resource cpu, averageUtilization: 80. Контейнер app — request 1000m, limit 2000m. Так он прожил больше года без претензий.
В пятницу разработчики выкатили два sidecar: auth-proxy (request 300m, limit 500m) и fluent-bit для отгрузки логов — его выкатили вообще без секции resources. Хронология дальше. Выходные: HPA показывает <unknown>/80%, никто не смотрит. Понедельник, финал крупного сбора и рассылка по всей базе, трафик вырос в 3,5 раза: p95 на странице оплаты улетает со 180 мс до 2,4 с, реплик по-прежнему 6 при потолке 20. Меня подключили примерно через час.
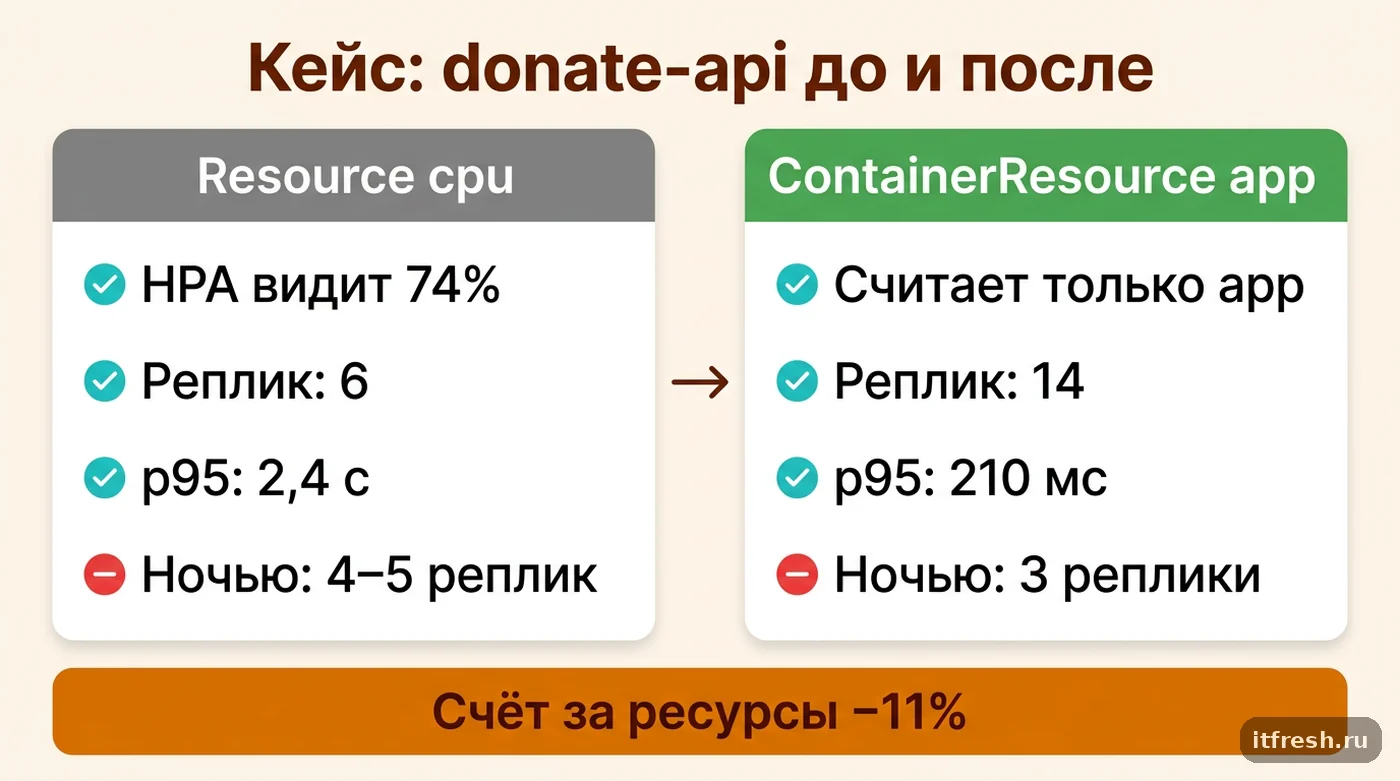
Первое, что я сделал, — kubectl top pod --containers. Картина: app ест 940–960m при request 1000m, auth-proxy — 55–70m при request 300m, fluent-bit — 20–30m при отсутствующем request. describe hpa подтвердил: ScalingActive=False, причина FailedGetResourceMetric, в тексте — missing request for cpu в контейнере fluent-bit. Прописали fluent-bit request 100m — HPA ожил через полторы минуты и показал… 71–74 % при пороге 80 %. Жёсткий отказ починили и сразу въехали в тихий: (950 + 60 + 25) / (1000 + 300 + 100) = 1035/1400 ≈ 74 %. Приложение на 95 % от своего request, а HPA считает, что всё в порядке.
Крутить порог я не стал, а перевёл HPA на ContainerResource по контейнеру app с целью 75 %. В следующий пик того же дня: 6 реплик → 14 за четыре минуты (упёрлись в policy scale-up, а не в потолок), p95 вернулся к 210 мс. Плюс побочный эффект, которого не ждали: пропали лишние ночные реплики. Оказалось, HPA месяцами держал ночью 4–5 реплик вместо трёх, потому что fluent-bit на ротации логов подтягивал общую метрику. За следующий месяц счёт за вычислительные ресурсы снизился примерно на 11 % — не главный результат, но директору он понравился больше, чем починенный p95.
Честно про спорный момент: minReplicas мы после этого подняли с 3 до 4. Формально ContainerResource решил задачу и без этого, но реакция HPA всё равно измеряется десятками секунд (об этом ниже), и запас в одну реплику на старте пика дешевле, чем минута деградации на странице оплаты. Это компромисс, а не «правильная настройка».
- До: Resource cpu, порог 80 %, HPA видел 71–74 % при app на 95 % request
- После: ContainerResource по app, порог 75 %
- Пик: 6 → 14 реплик за 4 минуты, p95 с 2,4 с до 210 мс
- Ночью: 3 реплики вместо 4–5, счёт за ресурсы −11 %
ContainerResource: рабочий манифест и проверка
Тип метрики ContainerResource делает ровно то, чего не хватает: позволяет назвать конкретный контейнер и считать утилизацию только по нему — его потребление к его request. Sidecar в расчёт не попадает вообще. В документации это описано прямым текстом: «if you have a web application and a sidecar container that provides logging, you can scale based on the resource use of the web application, ignoring the sidecar container and its resource use».
Манифест целиком — вот он, autoscaling/v2:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: donate-api
  namespace: prod
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: donate-api
  minReplicas: 4
  maxReplicas: 20
  metrics:
    - type: ContainerResource
      containerResource:
        name: cpu
        container: app          # ИМЯ КОНТЕЙНЕРА, а не Deployment
        target:
          type: Utilization
          averageUtilization: 75
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 0
      policies:
        - type: Percent
          value: 100
          periodSeconds: 30
    scaleDown:
      stabilizationWindowSeconds: 300
      policies:
        - type: Percent
          value: 25
          periodSeconds: 60
Про версии и доступность. Тип ContainerResource появился как alpha в Kubernetes 1.20 под feature gate HPAContainerMetrics, в 1.27 стал beta и включённым по умолчанию, а в 1.30 перешёл в stable; сам feature gate после этого убрали из кода (в 1.32 его уже нет). То есть в любой поддерживаемой сейчас ветке — 1.35, 1.36 и вышедшей 26 августа 2026 года 1.37 — он работает из коробки, никаких флагов включать не нужно. Если у вас managed-кластер на старой версии ниже 1.27, начните с обновления, а не с HPA.
Проверка занимает один apply — сначала в dev-namespace, потом в проде:
kubectl apply -f hpa-containerresource.yaml
sleep 60
kubectl describe hpa donate-api -n dev | grep -A3 Metrics
# ожидаемая строка:
#   resource cpu of container "app" on pods (as a percentage of request): 74% (740m) / 75%
kubectl get hpa donate-api -n dev -o jsonpath='{.status.conditions}' | jq
Если имя контейнера указано с ошибкой или у него нет request, вы это увидите сразу: HPA повиснет с ScalingActive=False и внятной причиной в conditions.
И ещё: метрики в spec.metrics можно комбинировать. HPA считает рекомендацию по каждой и берёт максимальную. Так что нормальная схема — ContainerResource по app как основная плюс, если очень хочется, ContainerResource по sidecar со своим порогом. Только не смешивайте Resource и ContainerResource по одному и тому же ресурсу: получите два расчёта, один из которых заведомо искажён sidecar, и когда он окажется выше, именно он и будет решать, сколько реплик держать.
- ContainerResource: stable с Kubernetes 1.30, флаги не нужны
- В `container:` — имя контейнера из спецификации пода
- Целевому контейнеру request обязателен
- Несколько метрик: HPA берёт максимальную рекомендацию
Грабли после перехода на ContainerResource
**Переименование контейнера убивает HPA молча.** Это самая неприятная из всех. Имя контейнера в containerResource.container — обычная строка, никакой связи с Deployment у неё нет. Переименовали app в api при рефакторинге чарта — метрика исчезла, HPA замер на текущем количестве реплик. Документация даёт правильный порядок действий: сначала обновите HPA так, чтобы он отслеживал и старое, и новое имя (две метрики в spec.metrics), потом катите Deployment с новым именем, и только после этого убирайте старую метрику из HPA. Тот же порядок работает и когда контейнер временно убирают из пода.
**Требование request никуда не делось — оно просто сузилось.** ContainerResource не отменяет необходимость resources.requests.cpu, он лишь перестаёт требовать его от всех контейнеров сразу. У целевого контейнера request обязан быть, иначе получите ровно ту же ошибку про missing request. Зато sidecar теперь можно жить без CPU request — хотя я бы всё равно проставил, из-за QoS-класса и вытеснения.
**Sidecar больше не под наблюдением HPA — вообще.** Мы сознательно выкинули его из расчёта, а значит, если он сам упрётся в свой limit и начнёт троттлиться, автомасштабирование этого не увидит. У auth-proxy в примере выше limit был 500m — на утроенном трафике он подходил к 380m, и это стоило отдельного алерта в мониторинге (container_cpu_cfs_throttled_seconds_total). Не заведёте такой алерт — рано или поздно получите латентность, происхождение которой будете искать неделю.
**Нативные sidecar-контейнеры устроены иначе.** С Kubernetes 1.33 нативные sidecar (init-контейнеры с restartPolicy: Always) стабильны, и живут они не в spec.containers, а в spec.initContainers. Правила расчёта эффективного request пода для init-контейнеров отдельные, а что именно попадёт в расчёт HPA — зависит от версии кластера. Универсальный ответ давать не буду: проверяйте на своём кластере kubectl top pod --containers и kubectl describe hpa. Если по условиям HPA видно, что нативный sidecar учитывается в метрике пода, — работает то же правило суммы, и ContainerResource нужен. Если нет — половина проблемы решилась сама.
**Скорость реакции.** Тут любят завышать ожидания. HPA-контроллер пересчитывает раз в 15 секунд, а metrics-server по умолчанию скрейпит kubelet раз в 60 секунд (--metric-resolution, снижать ниже 15 секунд разработчики не рекомендуют — это разрешение самих метрик kubelet). Плюс усреднение, плюс допуск, плюс время старта пода. Реальная задержка от «нагрузка приехала» до «новый под принял трафик» — полторы-три минуты. Если вам нужно быстрее, ContainerResource не поможет: нужен запас по minReplicas, прогретые ноды или проактивное масштабирование по внешней метрике вроде длины очереди. Про базовые вещи вроде этой я подробнее писал в заметках о том, как Kubernetes ведёт себя в продакшене в первый год.
Когда ContainerResource не нужен и что делать вместо
Не надо переводить на ContainerResource всё подряд. Если sidecar реально масштабируется вместе с приложением — например, это прокси, через который идёт весь трафик, и его потребление пропорционально нагрузке, — обычный Resource считает правильно, и трогать ничего не нужно. Проблема возникает именно там, где потребление sidecar живёт своей жизнью относительно нагрузки на приложение. Простой тест: постройте два графика — CPU app и CPU sidecar за неделю. Если они коррелируют, забейте.
Второй вариант обхода — метрика с target.type: AverageValue вместо Utilization. Она сравнивает абсолютное потребление на под с заданным значением и вообще не требует requests. Это законный способ, но вы теряете относительность: поменяли размер пода — надо руками пересчитывать целевое значение. Я использую его только там, где requests по каким-то причинам не проставить.
Отдельно скажу про память, потому что вопрос задают всегда. Масштабирование по памяти в большинстве случаев — ловушка, и ContainerResource её не чинит. У JVM, Go, .NET и Node потребление памяти определяется поведением сборщика мусора, а не текущей нагрузкой: вверх метрика едет охотно, вниз — почти никогда. Получите кластер, который вырос под пик и больше не сжался. По памяти имеет смысл масштабировать только приложения с честной корреляцией «запрос → выделенная память», и таких мало.
Если же вам важна не столько метрика CPU, сколько предсказуемость, смотрите в сторону масштабирования по прикладным показателям — глубина очереди, RPS, время в очереди, количество активных соединений. Через custom/external metrics или KEDA это делается штатно и почти всегда честнее, чем любой CPU-based автоскейл. CPU — это прокси-метрика, и она врёт тем сильнее, чем сложнее устроен под.
И банальность, которую всё равно приходится повторять: уберите spec.replicas из манифеста Deployment, если им управляет HPA. Иначе GitOps-инструмент будет каждый цикл синхронизации возвращать реплики к значению из репозитория, а вы будете думать, что это HPA сходит с ума. Такие же «невидимые» изменения поведения после обновлений встречаются и в RBAC — например, когда после 1.35 отвалились exec и port-forward: формально ничего не сломано, а работа встала.
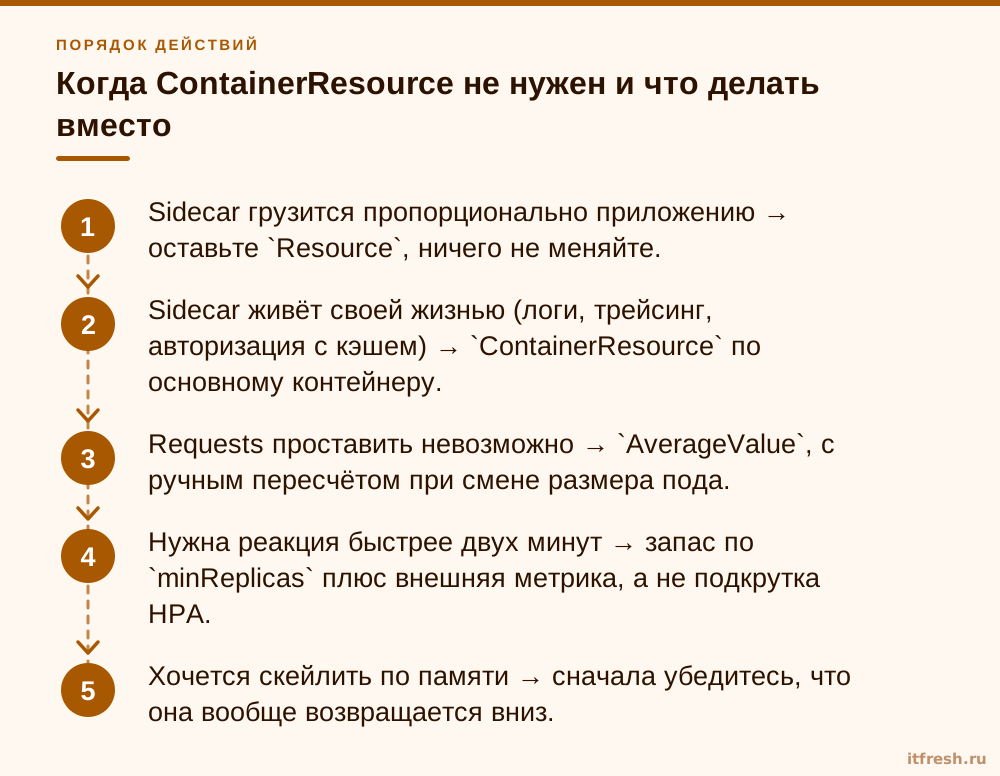
- Sidecar грузится пропорционально приложению → оставьте `Resource`, ничего не меняйте.
- Sidecar живёт своей жизнью (логи, трейсинг, авторизация с кэшем) → `ContainerResource` по основному контейнеру.
- Requests проставить невозможно → `AverageValue`, с ручным пересчётом при смене размера пода.
- Нужна реакция быстрее двух минут → запас по `minReplicas` плюс внешняя метрика, а не подкрутка HPA.
- Хочется скейлить по памяти → сначала убедитесь, что она вообще возвращается вниз.
Чек-лист: что делать в первую очередь
Порядок, по которому я разбираю такие инциденты. Он выстроен по принципу «сначала то, что даёт ответ за минуту, потом то, что требует выкатки».
Первые четыре пункта — диагностика, она бесплатная и делается прямо в проде. Пятый и шестой — правки, их катите в dev-namespace и смотрите на describe hpa в течение хотя бы двух минут: раньше метрика просто не успеет обновиться, и вы решите, что не работает. Седьмой и восьмой — гигиена, без которой вы вернётесь к этой же статье через полгода.
На что можно забить, если времени в обрез: на тонкую настройку behavior, на подбор идеального averageUtilization (75 % — нормальная отправная точка для CPU) и на масштабирование по памяти. На что забивать нельзя ни при каких обстоятельствах: на алерт по условию ScalingActive и на порядок действий при переименовании контейнера.
- 1. `kubectl get hpa -A` — ищем `<unknown>` в колонке TARGETS по всему кластеру, а не только в проблемном namespace. Обычно находится ещё два-три сервиса.
- 2. `kubectl describe hpa <name>` — читаем блок Conditions целиком, там прямым текстом написано имя контейнера без request.
- 3. `kubectl top pod --containers` — раскладываем потребление по контейнерам и сравниваем с requests. Именно здесь виден тихий отказ.
- 4. Считаем руками: сумма потребления / сумма requests. Сходится с тем, что показывает HPA? Значит, диагноз верный.
- 5. Проставляем requests всем контейнерам, у кого их нет, — это чинит жёсткий отказ и заодно QoS-класс пода.
- 6. Переводим HPA на `ContainerResource` по основному контейнеру, порог 70–80 % для CPU.
- 7. Заводим алерт на `ScalingActive=False` и на CPU-троттлинг sidecar — обе проблемы иначе не видны.
- 8. Убираем `spec.replicas` из манифеста Deployment и фиксируем в код-ревью правило: новый sidecar едет только с проставленными requests.
Частые вопросы
HPA пишет «missing request for cpu» — это точно из-за sidecar?
Причина всегда одна: у какого-то контейнера пода нет resources.requests.cpu. Имя контейнера указано в блоке Conditions вывода kubectl describe hpa. Sidecar — самый частый виновник, потому что его добавляют вебхуком или патчем чарта без resources.
Можно ли просто снизить порог averageUtilization и не трогать тип метрики?
Можно, но это отсрочка. Компенсация порогом верна для одного соотношения нагрузки app и sidecar: поменялся трафик или обновился sidecar — расчёт снова врёт. Если sidecar не масштабируется вместе с приложением, нужен ContainerResource.
ContainerResource доступен в моей версии Kubernetes?
Да, если у вас Kubernetes 1.27 и новее: с 1.27 тип включён по умолчанию (beta), с 1.30 — stable, feature gate HPAContainerMetrics удалён. В ветках 1.35–1.37 ничего включать не нужно.
Что будет, если контейнер, указанный в containerResource.container, исчезнет или его переименуют?
HPA перестанет получать метрику и замрёт на текущем числе реплик. Порядок: добавить в HPA метрику и по старому, и по новому имени, выкатить Deployment, затем убрать старую метрику. И заведите алерт на ScalingActive=False.
Насколько быстро HPA среагирует после перехода на ContainerResource?
Не станет быстрее: контроллер HPA пересчитывает раз в 15 секунд, metrics-server по умолчанию собирает данные раз в 60 секунд, плюс допуск и старт пода. Реально — полторы-три минуты; для быстрой реакции нужен запас по minReplicas.
Нужно ли теперь вообще ставить requests sidecar-контейнерам?
Для ContainerResource — не нужно, он их игнорирует. Для планировщика, QoS-класса и порядка вытеснения — нужно. Ставьте скромные, но осмысленные значения.
Источники
- Kubernetes: Horizontal Pod Autoscaling — Алгоритм desiredReplicas, Utilization относительно requests, отсутствие метрики при незаданном request, container resource metrics и порядок переименования контейнера, период 15 с, допуск 10 %. https://kubernetes.io/docs/concepts/workloads/autoscaling/horizontal-pod-autoscale/
- Kubernetes: Feature Gates (removed) — HPAContainerMetrics: alpha 1.20, beta 1.27 (default true), stable 1.30, удалён после 1.31; HPAConfigurableTolerance: alpha 1.33, stable 1.37. https://kubernetes.io/docs/reference/command-line-tools-reference/feature-gates-removed/
- Kubernetes API Reference: HorizontalPodAutoscaler v2 — MetricSpec type ContainerResource, поля container, name, target. https://kubernetes.io/docs/reference/kubernetes-api/workload-resources/horizontal-pod-autoscaler-v2/
- Kubernetes: Sidecar Containers — Нативные sidecar — init-контейнеры с restartPolicy: Always, stable с 1.33. https://kubernetes.io/docs/concepts/workloads/pods/sidecar-containers/
- metrics-server FAQ — --metric-resolution по умолчанию 60 с, ниже 15 с не рекомендуется. https://github.com/kubernetes-sigs/metrics-server/blob/master/FAQ.md
- Kubernetes Blog: Kubernetes v1.37 — Дата выхода 1.37 — 26 августа 2026. https://kubernetes.io/blog/2026/08/26/kubernetes-v1-37-release/