
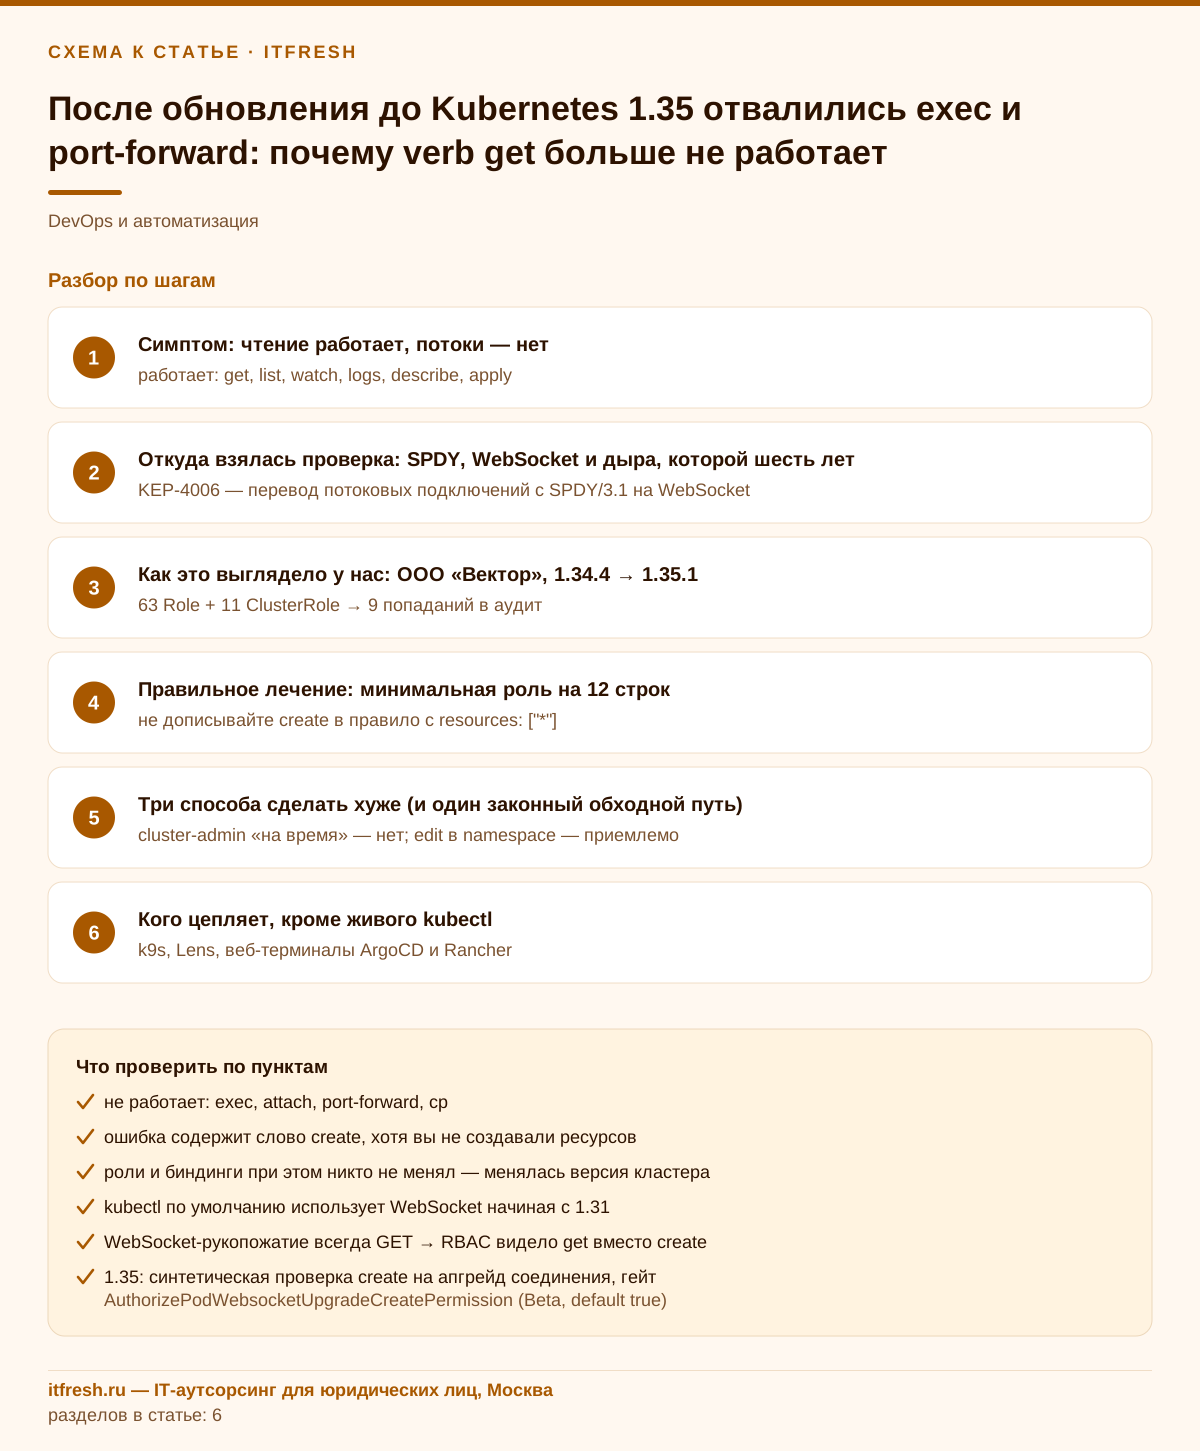
После обновления до Kubernetes 1.35 отвалились exec и port-forward: почему verb get больше не работает
Роль не меняли, сервис-аккаунт тот же, токен тот же — а kubectl exec в прод-под отвечает Forbidden. Знакомо? Это не сломанный вебхук и не протухший сертификат: в Kubernetes 1.35 появилась дополнительная проверка прав на потоковые подключения, и она включена по умолчанию. Ниже — что именно изменилось, как за минуту это диагностировать, какую роль выписать вместо cluster-admin и кого, кроме живых разработчиков, эта проверка бьёт молча по ночам.
Симптом: чтение работает, потоки — нет
Картинка всегда одна и та же. В субботу обновили control plane, в понедельник к девяти утра — очередь из тикетов «не могу зайти в под». При этом kubectl get pods работает, kubectl logs работает, kubectl describe работает. Умирают ровно три вещи: exec, attach и port-forward. Плюс, что замечают не сразу, kubectl cp — он внутри тот же remotecommand, что и exec.
Ошибка выглядит примерно так (точный текст немного плавает от версии kubectl к версии, но суть в слове create):
Error from server (Forbidden): pods "api-7f9c4d8b6-h2xkq" is forbidden:
User "dev@example.com" cannot create resource "pods/exec"
in API group "" in the namespace "prod"
У port-forward формулировка бывает мягче — что-то вроде unable to upgrade connection, и вот тут-то люди и уходят в сторону: начинают винить ingress, service mesh, апстрим-прокси, MTU. Теряют полдня. А проверяется всё одной командой.
Диагностика занимает пятнадцать секунд — достаточно спросить API-сервер от своего имени и от имени нужного субъекта (запись pods/exec и флаг --subresource=exec равнозначны):
kubectl auth can-i create pods --subresource=exec -n prod
kubectl auth can-i create pods --subresource=portforward -n prod
# для чужой учётки или сервис-аккаунта:
kubectl auth can-i create pods --subresource=exec -n prod \
  --as=system:serviceaccount:ci:deployer
Если на первую команду приходит no, а на kubectl auth can-i get pods --subresource=exec — yes, дальше можно не искать. Это оно. Не сеть, не kubelet, не сертификаты API-сервера к кубелету.
- работает: get, list, watch, logs, describe, apply
- не работает: exec, attach, port-forward, cp
- ошибка содержит слово create, хотя вы не создавали ресурсов
- роли и биндинги при этом никто не менял — менялась версия кластера
Откуда взялась проверка: SPDY, WebSocket и дыра, которой шесть лет
Чтобы понять, почему get внезапно перестал быть достаточным, надо вспомнить, как вообще устроены потоковые подключения в Kubernetes. Исторически exec, attach и port-forward апгрейдили HTTP-соединение до SPDY/3.1 — протокола, который Google похоронил больше восьми лет назад и который никогда не был стандартизован. Практическая беда SPDY в том, что современные прокси, гейтвеи и балансировщики его просто не умеют: как только между вами и API-сервером появляется приличный L7-прокси, kubectl exec и kubectl cp начинают загадочно виснуть. Ради этого и затеяли KEP-4006 — перевод двунаправленных потоков на WebSocket (RFC 6455).
Переезд шёл несколько релизов. Клиентская сторона: KUBECTL_REMOTE_COMMAND_WEBSOCKETS появился в 1.29 как альфа и был выключен, в 1.30 стал бетой и включился по умолчанию; KUBECTL_PORT_FORWARD_WEBSOCKETS — альфа в 1.30, бета и включён с 1.31. Серверная сторона: гейт PortForwardWebsockets — бета с 1.31, по умолчанию true. То есть примерно с 1.31 обычный kubectl уже ходит в кластер по WebSocket, а не по SPDY, и большинство про это даже не знает.
И вот тут вылезла старая дыра. RFC 6455 требует, чтобы WebSocket-рукопожатие начиналось методом GET — иного варианта спецификация не предусматривает. А API-сервер Kubernetes отображает HTTP-метод на RBAC-глагол механически: POST становится create, GET становится get. Итог: SPDY-запрос на exec шёл через POST и требовал create, а точно такой же по смыслу WebSocket-запрос шёл через GET и требовал всего лишь get. Обычная роль «только чтение» с verbs [get, list, watch] на все ресурсы — а такие в проде пишут постоянно — тихо давала право выполнять команды внутри контейнеров. Первый отчёт об этом завели ещё в 2019 году (issue #78741, его тогда быстро закрыли), а в 2025-м тема всплыла заново в issue #133515 — люди заметили, что метод запроса у kubectl exec сменился с POST на GET. Исправление пришло отдельным PR #134577 в цикле 1.35.
В 1.35 (релиз «Timbernetes», 17 декабря 2025) дыру закрыли: при запросе на апгрейд соединения к pods/exec, pods/attach или pods/portforward API-сервер выполняет дополнительную, синтетическую проверку глагола create. Формулировка из CHANGELOG-1.35 близка к дословной: подресурсы pods/exec, pods/attach и pods/portforward теперь требуют create и для SPDY, и для WebSocket-запросов; раньше SPDY требовал create, а WebSocket — только get. Управляет этим фичегейт AuthorizePodWebsocketUpgradeCreatePermission: стадия Beta, значение по умолчанию true, появился сразу в Beta в 1.35. В документации к 1.37 он всё ещё Beta, а KEP-4006 целится в stable в 1.37 — так что проверяйте таблицу фичегейтов именно своей версии. Сам changelog прямо просит: до апгрейда на 1.35 убедиться, что все самописные Role и ClusterRole, которые должны давать exec, attach или port-forward, содержат глагол create.
- KEP-4006 — перевод потоковых подключений с SPDY/3.1 на WebSocket
- kubectl по умолчанию использует WebSocket для exec/attach/cp с 1.30, для port-forward — с 1.31
- WebSocket-рукопожатие всегда GET → RBAC видело get вместо create
- 1.35: синтетическая проверка create на апгрейд соединения, гейт AuthorizePodWebsocketUpgradeCreatePermission (Beta, default true)
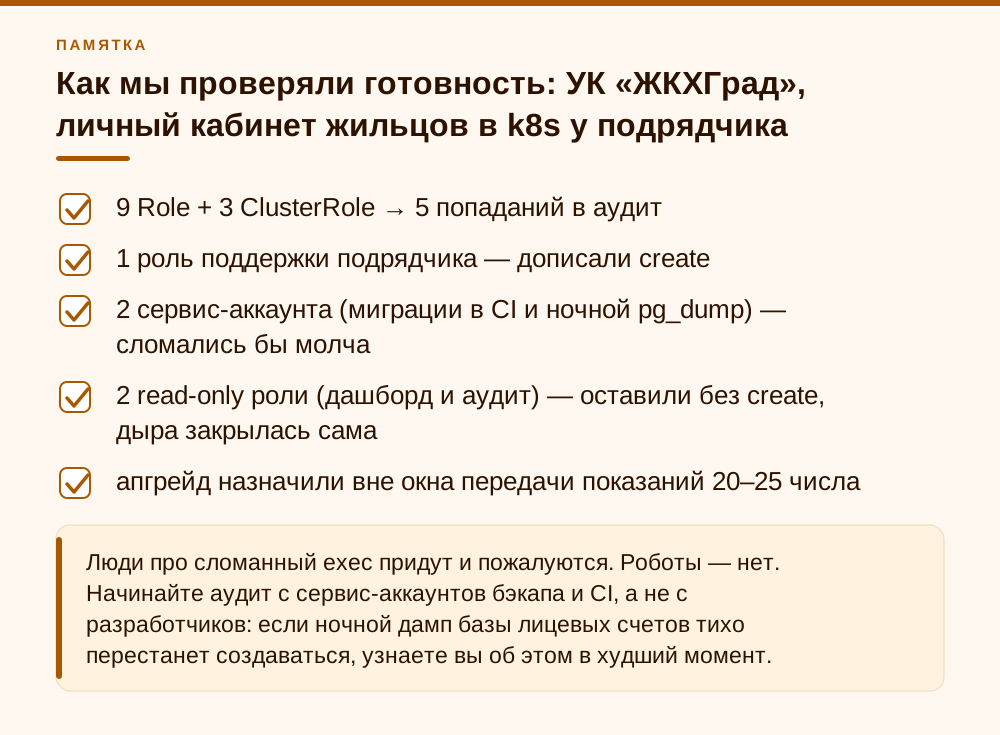
Как мы проверяли готовность: УК «ЖКХГрад», личный кабинет жильцов в k8s у подрядчика
Сразу оговорюсь, чтобы не было иллюзий: у управляющей компании на 13 рабочих мест собственного Kubernetes нет и быть не должно. У «ЖКХГрад» мы ведём офис — рабочие места, почту, 1С, резервное копирование. А личный кабинет жильцов (показания счётчиков, заявки в диспетчерскую, квитанции и онлайн-оплата) разработал и хостит подрядчик: небольшой кластер на kubeadm из одного control-plane и трёх worker-узлов, четыре namespace — prod, stage, ci и monitoring. Подрядчик запланировал обновление 1.34 → 1.35, а директор УК попросил нас как ИТ-службу заказчика оценить риски: в период передачи показаний, с 20-го по 25-е число, простой кабинета означает звонки в диспетчерскую и очередь в офисе.
Доступ нам выдали только на чтение — отдельный сервис-аккаунт для аудита. Первое, что я сделал, — не полез в логи, а прогнал инвентаризацию ролей. Скрипт простой, кладу его целиком, он с тех пор живёт в нашем пред-апгрейдном чек-листе:
#!/usr/bin/env bash
set -euo pipefail
kubectl get clusterroles -o json > /tmp/cr.json
kubectl get roles -A -o json  > /tmp/r.json

jq -r '
  .items[]
  | . as $role
  | ($role.rules // [])[]
  | select(((.resources // []) | any(startswith("pods/exec") or startswith("pods/attach") or startswith("pods/portforward"))) or ((.resources // []) | index("*")))
  | select(((.verbs // []) | index("create")) == null)
  | select(((.verbs // []) | index("*")) == null)
  | [$role.kind, ($role.metadata.namespace // "-"), $role.metadata.name, ((.resources // []) | join(",")), ((.verbs // []) | join(","))]
  | @tsv
' /tmp/cr.json /tmp/r.json | sort -u
Самописных объектов в кластере оказалось немного: 9 Role и 3 ClusterRole, не считая встроенных и приехавших из Helm-чартов. Выхлоп — пять строк. И разбираются они, что важно, на три принципиально разные кучки, лечить которые надо по-разному.
Первая кучка — роль support-troubleshoot для двух разработчиков подрядчика в namespace prod: они заходят в под бэкенда, когда жилец жалуется, что показания «не ушли». Там exec нужен по делу, create дописали — минута работы. Вторая кучка — роботы, и она важнее: сервис-аккаунт CI, который после выкладки запускает миграции базы через kubectl exec, и сервис-аккаунт ночной CronJob, выполняющей pg_dump внутри пода с PostgreSQL перед выгрузкой копии в объектное хранилище. Обе роли содержали только get на pods/exec. После апгрейда первая сломала бы ближайший релиз, а вторая — молча, в 03:00, все ночные копии базы лицевых счетов. Третья кучка — две роли, которые я рекомендовал НЕ чинить: веб-дашборд мониторинга с правилом resources ["*"], verbs ["get","list","watch"] и наш собственный аудиторский аккаунт с таким же шаблоном. До 1.35 оба фактически давали shell в прод-поды с персональными данными жильцов. Этот пункт я вынес отдельной строкой в письмо директору УК: закрытие дыры — аргумент за апгрейд, а не против.
Итог: около двух часов на аудит и отчёт, подрядчик внёс правки в роли до обновления, фичегейт не трогали, cluster-admin никому не выдавали. Обновление прошло вне окна передачи показаний, миграции в CI и ночной дамп отработали с первого раза — это мы проверили утром по логам CronJob и по размеру свежей копии. Для УК такой формат вообще правильный: разработку держит подрядчик, а заказчику нужен кто-то, кто сможет независимо проверить, что апгрейд не сломает кабинет жильцов и резервное копирование.
- 9 Role + 3 ClusterRole → 5 попаданий в аудит
- 1 роль поддержки подрядчика — дописали create
- 2 сервис-аккаунта (миграции в CI и ночной pg_dump) — сломались бы молча
- 2 read-only роли (дашборд и аудит) — оставили без create, дыра закрылась сама
- апгрейд назначили вне окна передачи показаний 20–25 числа
Правильное лечение: минимальная роль на 12 строк
Никакой магии здесь нет. Нужно, чтобы в правиле, покрывающем подресурсы потоков, стоял глагол create. Я держу get рядом с ним осознанно: сам WebSocket-запрос физически является GET, к тому же часть инструментов ещё может свалиться на SPDY, и я не хочу гадать, какой транспорт выберет конкретная версия клиента. Два глагола вместо одного ничего не стоят, а нервов экономят много.
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: dev-troubleshoot
  namespace: prod
rules:
  - apiGroups: [""]
    resources: ["pods", "pods/log"]
    verbs: ["get", "list", "watch"]
  - apiGroups: [""]
    resources: ["pods/exec", "pods/attach", "pods/portforward"]
    verbs: ["get", "create"]
Отдельно про роли с масками. Классическая заготовка «только чтение» выглядит как resources ["*"] с verbs [get, list, watch] — и именно она раньше нечаянно раздавала exec. Соблазн велик: дописать create в тот же блок и разойтись. Не делайте так ни при каких обстоятельствах. Вы выдадите create на все ресурсы кластера разом: секреты, сервис-аккаунты, роль-биндинги. Если exec действительно нужен — режьте правило на два: широкое на чтение и узкое на подресурсы потоков, как в примере выше.
Проверка после правки — той же командой auth can-i, но обязательно от имени реального субъекта, а не от себя-админа. Имперсонация требует прав на impersonate, у админа кластера они есть:
# точечно
kubectl auth can-i create pods --subresource=exec -n prod \
  --as=dev@example.com --as-group=contractor:developers

# полный список того, что субъект может в namespace
kubectl auth can-i --list -n prod \
  --as=system:serviceaccount:ci:deployer

# и сразу боевая проверка
kubectl exec -n prod deploy/api -- sh -c 'echo ok'
Два yes и один ok — вопрос закрыт. Если can-i отвечает yes, а живой exec всё равно Forbidden, вот тогда уже смотрите на вебхуки авторизации и внешние прокси: у Teleport, Rancher и подобных обвязок бывает своя прослойка со своими правилами.
- не дописывайте create в правило с resources: ["*"]
- держите get и create вместе на подресурсах потоков
- проверяйте через --as, а не от админа
- встроенные роли edit и admin create на pods/exec уже содержат — их править не нужно
- встроенная роль view exec не даёт и не должна
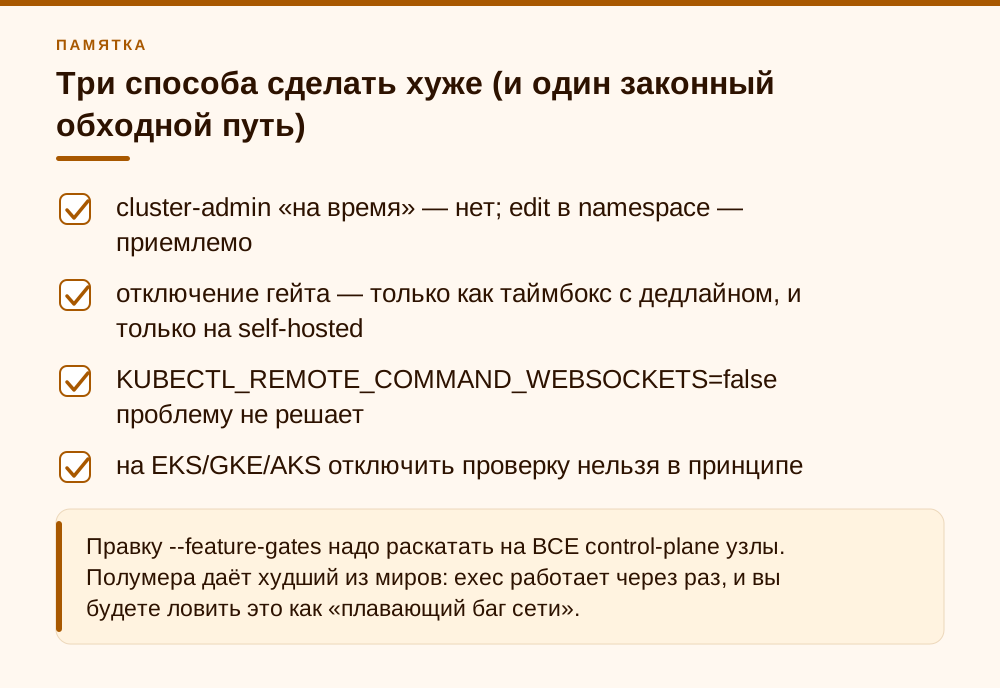
Три способа сделать хуже (и один законный обходной путь)
Способ первый и самый популярный: выдать cluster-admin «на время, пока разберёмся». Разберутся через час, снимут через полгода — если вообще вспомнят. Я за пятнадцать лет ни разу не видел, чтобы временный cluster-admin сняли в тот же день. Если совсем горит и надо разблокировать релиз прямо сейчас — выдайте встроенную роль edit в конкретном namespace: в ней create на pods/exec уже есть, а радиус поражения на порядок меньше.
Способ второй: выключить фичегейт и забыть. Технически это делается правкой манифеста статик-пода на каждом control-plane узле:
# /etc/kubernetes/manifests/kube-apiserver.yaml
spec:
  containers:
    - command:
        - kube-apiserver
        - --feature-gates=AuthorizePodWebsocketUpgradeCreatePermission=false
После сохранения файла kubelet перезапустит под API-сервера сам; делать это надо на всех узлах control plane, иначе поведение будет плавать от запроса к запросу — в зависимости от того, на какой инстанс попал клиент. Считаю такой шаг допустимым ровно в одном сценарии: у вас сотни ролей, окно обслуживания закончилось, и нужна неделя на аккуратный аудит. С тикетом, с дедлайном и с ответственным. Гейт сейчас Beta и включён по умолчанию; по обычной практике Kubernetes при переходе фичи в GA гейт фиксируют в true, а потом удаляют — жить с ним выключенным вечно не получится.
Способ третий, и вот он самый обидный, потому что выглядит умным: заставить клиента откатиться на SPDY.
KUBECTL_REMOTE_COMMAND_WEBSOCKETS=false kubectl exec -it -n prod deploy/api -- shЭто не помогает. Совсем. SPDY ходит через POST, POST всегда отображался в create — то есть роль без create по SPDY не работала никогда, и в 1.35 changelog прямо фиксирует: create требуется для обоих транспортов. Единственное, для чего этот флаг ещё годится, — отладка совместимости со старыми прокси, если вдруг WebSocket не проходит через ваш периметр.
И честное замечание про managed-кластеры. В EKS, GKE и AKS у вас нет доступа к флагам kube-apiserver, а фичегейт задаётся именно там. Значит, рассчитывать на обходной путь нельзя: только правка RBAC. И значит, аудит ролей надо делать ДО того, как провайдер подтянет control plane на 1.35 в вашем канале обновлений, а не после.
- cluster-admin «на время» — нет; edit в namespace — приемлемо
- отключение гейта — только как таймбокс с дедлайном, и только на self-hosted
- KUBECTL_REMOTE_COMMAND_WEBSOCKETS=false проблему не решает
- на EKS/GKE/AKS отключить проверку нельзя в принципе
Кого цепляет, кроме живого kubectl
Под удар попадает всё, что внутри использует client-go с пакетами remotecommand и portforward, — а это половина экосистемы. Из того, что я разбирал руками или видел у коллег: k9s и Lens (шелл в под из UI), веб-терминалы в ArgoCD, Rancher и Headlamp, консоль в Kubernetes Dashboard, Telepresence и mirrord, все обвязки вокруг kubectl cp, самописные операторы, которые лезут в под за диагностикой, и — отдельной строкой — бэкапные хуки. Velero с pre/post-хуками, скрипты, которые перед снапшотом делают FLUSH TABLES WITH READ LOCK или pg_backup_start внутри контейнера, любые ночные джобы с exec.
Разница в том, как вы об этом узнаёте. Разработчик, у которого не открывается шелл, приходит к вам в течение десяти минут. Ночная джоба ретраится трижды, пишет Forbidden в лог, который никто не читает, и уходит спать. Копия при этом формально создаётся — просто без корректного сброса на диск. Поэтому порядок приоритетов у меня такой: сначала сервис-аккаунты бэкапов, потом сервис-аккаунты CI/CD, потом уже люди. Люди сами напомнят.
С дашбордами есть нюанс, который стоит понимать заранее. Одни ходят в API от имени пользователя (прокидывают его OIDC-токен), и тогда проверка create применяется к конкретному человеку — чинится его роль. Другие работают под собственным сервис-аккаунтом, и тогда проверку проходит или не проходит сам дашборд: либо шелл пропадёт у всех разом, либо, если сервис-аккаунту когда-то выдали широкое чтение, окажется, что через дашборд exec был доступен любому, кто в него вошёл. У «ЖКХГрад» был как раз второй случай — именно поэтому такую роль мы не чинили, а выносили на обсуждение. С CI похоже: у раннеров GitLab, Jenkins или GitHub Actions в кластере свой сервис-аккаунт, и падение шага с exec или kubectl cp выглядит в пайплайне как обычная ошибка деплоя.
Практический приём для инвентаризации по субъектам, а не по ролям: пройтись auth can-i по списку сервис-аккаунтов, которые реально что-то делают в кластере.
for ns in $(kubectl get ns -o name | cut -d/ -f2); do
  for sa in $(kubectl get sa -n "$ns" -o name | cut -d/ -f2); do
    ans=$(kubectl auth can-i create pods --subresource=exec -n "$ns" \
      --as="system:serviceaccount:$ns:$sa" 2>/dev/null || echo err)
    getv=$(kubectl auth can-i get pods --subresource=exec -n "$ns" \
      --as="system:serviceaccount:$ns:$sa" 2>/dev/null || echo err)
    if [ "$getv" = "yes" ] && [ "$ans" != "yes" ]; then
      echo "BROKEN: $ns/$sa"
    fi
  done
done
Вывод BROKEN — это ровно те аккаунты, у которых exec работал до 1.35 и перестал после. Прогон по небольшому кластеру на несколько namespace занимает секунды, на крупном — пару минут. По каждому такому аккаунту дальше решение принимаете вы: дописать create или, наоборот, порадоваться, что закрылась лишняя привилегия.
- k9s, Lens, веб-терминалы ArgoCD, Rancher, Headlamp, Kubernetes Dashboard
- Telepresence, mirrord, kubectl cp и всё вокруг него
- Velero pre/post-хуки и самописные скрипты консистентных дампов
- CI-джобы, выполняющие миграции БД через exec в под
- операторы и контроллеры со своими сервис-аккаунтами
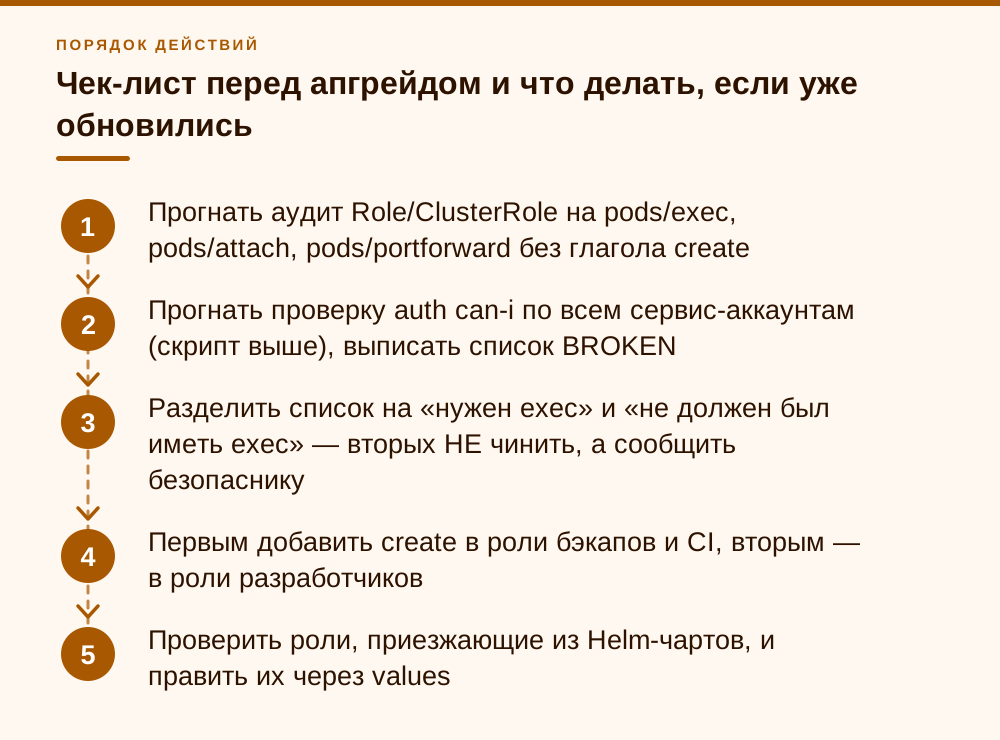
Чек-лист перед апгрейдом и что делать, если уже обновились
Если вы ещё на 1.33 или 1.34 — у вас идеальная позиция, потому что аудит можно сделать заранее и без единого простоя. Порядок действий, который я теперь вписываю в регламент апгрейда любого кластера, укладывается в один вечер. Если вы уже на 1.35 и всё горит — начинайте с третьего пункта, он снимает боль за минуты, а остальное доделаете спокойно.
Отдельно про календарь. Kubernetes 1.35 «Timbernetes» вышел 17 декабря 2025 года; апстрим поддерживает минорную версию патчами около 14 месяцев, то есть ориентировочно до начала 2027-го — точную дату end of life смотрите на странице релизов kubernetes.io, она иногда сдвигается. Облачные провайдеры (EKS, GKE, AKS) добавляют новые версии по своим календарям с задержкой в несколько недель или месяцев, у AKS вдобавок есть LTS-версии с иным жизненным циклом. Смысл простой: если у вас или у вашего подрядчика managed-кластер на автообновлении, 1.35 приедет сама, и лучше встретить её с готовыми ролями.
На что можно смело забить: на разговоры о том, что «Kubernetes опять всё сломал». Изменение маленькое, локализованное, чинится одним глаголом в манифесте роли, и оно объективно делает кластер безопаснее — просто вскрывает то, что у большинства и так было настроено неправильно. На что забивать нельзя: на сервис-аккаунты. Именно они превращают пятнадцатиминутную задачу в аварию через две недели.
- 1. Прогнать аудит Role/ClusterRole на pods/exec, pods/attach, pods/portforward без глагола create
- 2. Прогнать проверку auth can-i по всем сервис-аккаунтам (скрипт выше), выписать список BROKEN
- 3. Разделить список на «нужен exec» и «не должен был иметь exec» — вторых НЕ чинить, а сообщить безопаснику
- 4. Первым добавить create в роли бэкапов и CI, вторым — в роли разработчиков
- 5. Проверить роли, приезжающие из Helm-чартов, и править их через values
- 6. Проверить обвязки: ArgoCD, Rancher, Teleport, Headlamp, Kubernetes Dashboard, свои веб-терминалы
- 7. Только после этого обновлять control plane
Частые вопросы
Достаточно ли добавить только create, или get на pods/exec тоже нужен?
Добавляйте оба. Документирована именно дополнительная проверка create поверх обычной авторизации, а обычная авторизация WebSocket-запроса идёт по методу GET. Роль только с create теоретически может сработать, но проверять это в проде — сомнительное развлечение: два глагола вместо одного не расширяют привилегии ни на грамм, потому что и get, и create на pods/exec означают ровно одно и то же право — выполнить команду в контейнере.
Можно ли откатиться на SPDY, чтобы не трогать роли?
Нет. SPDY-запрос идёт методом POST и отображается в глагол create, то есть роль без create по SPDY не работала никогда. Changelog 1.35 фиксирует это прямо: create требуется для обоих транспортов. Переменная KUBECTL_REMOTE_COMMAND_WEBSOCKETS=false полезна только для отладки совместимости со старыми прокси.
Надо ли править встроенные роли edit, admin, view?
Нет. У встроенных edit и admin право create на pods/exec есть изначально — они работают как работали. У view exec нет и быть не должно. Ломаются только самописные роли, чаще всего собранные по шаблону «get, list, watch на всё».
У меня managed-кластер в облаке. Как отключить эту проверку?
Своими силами — никак. В EKS, GKE и AKS доступа к флагам kube-apiserver нет, а фичегейт задаётся именно там. Единственный путь — привести RBAC в порядок. Поэтому аудит ролей нужно проводить до того, как провайдер подтянет control plane на 1.35 в вашем канале обновлений.
Как быстро найти все роли, которые сломаются?
Двумя способами, и лучше обоими. Первый — выгрузить Role и ClusterRole в JSON и через jq отфильтровать правила, где есть pods/exec, pods/attach или pods/portforward, но нет create. Второй, более честный, — пройтись kubectl auth can-i с флагом --as по всем сервис-аккаунтам и сравнить ответы для get и create: где get даёт yes, а create — no, там всё и сломается.
Стоит ли вообще откладывать переход на 1.35 из-за этого?
Нет. Правка занимает минуты на роль, а изменение закрывает реальную эскалацию привилегий, которая жила в кластерах годами. Откладывать апгрейд разумно по другим причинам — совместимость операторов, CSI-драйверов, ingress-контроллеров, — но не из-за RBAC на потоки.
Мы не разработчики, кабинет клиентов у подрядчика в Kubernetes. Что проверить нам как заказчику?
Попросите у подрядчика три вещи до апгрейда на 1.35: вывод аудита Role/ClusterRole на pods/exec, pods/attach, pods/portforward без create; список сервис-аккаунтов CI и резервного копирования с ответом kubectl auth can-i create pods --subresource=exec; план проверки ночных бэкапов после обновления. Отдельно договоритесь о дате вне пиковых периодов — для УК это окно передачи показаний. Если своей экспертизы нет, такую проверку может провести ИТ-подрядчик заказчика с доступом только на чтение.
Источники
- Kubernetes CHANGELOG-1.35 (release notes) — Раздел Urgent Upgrade Notes / Changes by Kind: «Kube-apiserver: the subresources pods/exec, pods/attach, and pods/portforward now require create permission for both SPDY and Websocket API requests… gated by the AuthorizePodWebsocketUpgradeCreatePermission feature-gate, which is enabled by default», PR #134577. https://github.com/kubernetes/kubernetes/blob/master/CHANGELOG/CHANGELOG-1.35.md
- Kubernetes v1.35 — Feature Gates — Раздел «Feature gates for graduated or deprecated features / Alpha or Beta features», строка AuthorizePodWebsocketUpgradeCreatePermission: Stage Beta, Default true, начиная с 1.35. Там же PortForwardWebsockets (Beta, true, с 1.31). https://v1-35.docs.kubernetes.io/docs/reference/command-line-tools-reference/feature-gates/
- KEP-4006: Transition from SPDY to WebSockets — kubernetes/enhancements, SIG API Machinery. Раздел «v1.35 Synthetic RBAC CREATE Authorization Check»: синтетическая проверка create при WebSocket-апгрейде для pods/exec, pods/attach, pods/portforward под гейтом AuthorizePodWebsocketUpgradeCreatePermission (default true); клиентские переменные KUBECTL_REMOTE_COMMAND_WEBSOCKETS (alpha 1.29, beta 1.30) и KUBECTL_PORT_FORWARD_WEBSOCKETS (alpha 1.30, beta 1.31). https://github.com/kubernetes/enhancements/blob/master/keps/sig-api-machinery/4006-transition-spdy-to-websockets/README.md
- kubernetes/kubernetes issue #133515 — «Request method of kubectl exec changed from POST to GET now?» — обсуждение того, что WebSocket-рукопожатие идёт методом GET и авторизуется как get; issue закрыт в июле 2025, само исправление вошло в 1.35 через PR #134577. https://github.com/kubernetes/kubernetes/issues/133515
- kubernetes/kubernetes issue #78741 — «Users can exec into pods with the websocket endpoint even without pods/exec create privileges» — исходный отчёт о проблеме, июнь 2019 года. https://github.com/kubernetes/kubernetes/issues/78741
- Kubernetes Blog: Kubernetes 1.31 — Streaming Transitions from SPDY to WebSockets — Официальное объяснение перехода на WebSocket и того, почему SPDY ломается за прокси; в 1.31 гейты TranslateStreamCloseWebsocketRequests и PortForwardWebsockets в beta и включены по умолчанию, kubectl использует WebSocket по умолчанию. https://kubernetes.io/blog/2024/08/20/websockets-transition/
- Sysdig: Kubernetes 1.35 — What's new (security features) — Разбор AuthorizePodWebsocketUpgradeCreatePermission со ссылкой на KEP-4006 и перечислением сопутствующих гейтов; подтверждает default true и рекомендацию проверить RBAC до апгрейда. https://www.sysdig.com/blog/kubernetes-1-35-whats-new
- Kubernetes v1.35 «Timbernetes» — анонс релиза — Дата релиза 17 декабря 2025 года, 60 доработок (17 stable, 19 beta, 22 alpha). https://kubernetes.io/blog/2025/12/17/kubernetes-v1-35-release/