
Что делать после взлома CMS: порядок без потери улик
Если CMS взломали, сначала остановите дальнейший ущерб и зафиксируйте состояние системы, а затем меняйте файлы и пароли. Сделайте копии доступных логов, базы и файлов, отметьте время и действия. Ни один отдельный лог не покажет всю атаку, но вместе они помогут восстановить последовательность событий.
Первые действия: ограничьте ущерб и зафиксируйте состояние
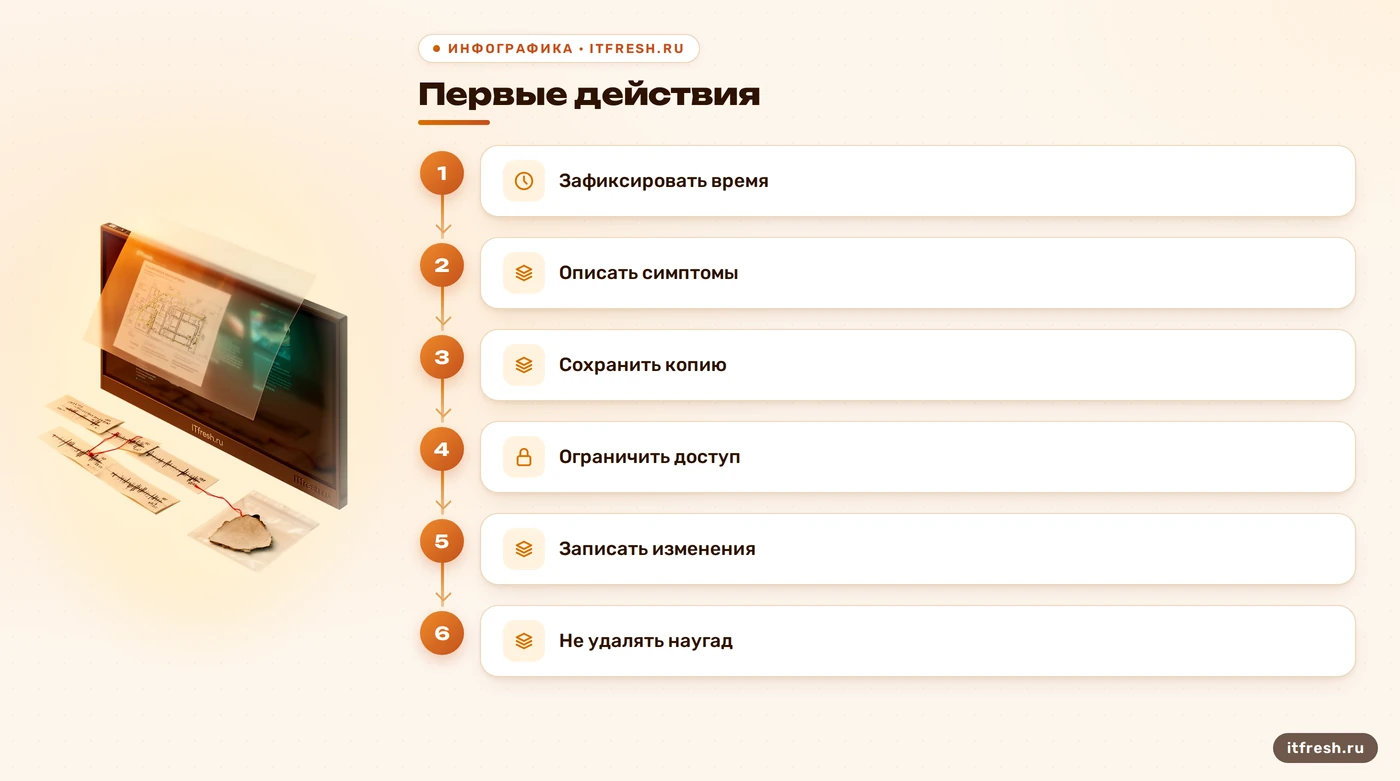
Странная переадресация, чужая страница или предупреждение поисковика — повод считать сайт скомпрометированным, но не повод наугад удалять файлы. Сначала зафиксируйте время обнаружения, часовой пояс, симптомы и уже выполненные действия. Сохраните скриншоты и уведомления, запишите, кто и когда подключался. Это простые детали, но через день «вроде утром» превращается в бесполезную хронологию. Я начинаю с журнала действий: расследованию мешает не только злоумышленник, но и десяток добрых рук, каждая из которых что-то поправила.
Если есть подготовленная процедура реагирования или специалист по безопасности, подключите его до чистки. По возможности снимите копию состояния файлов, базы и доступных журналов до изменений; копируйте на отдельное хранилище с ограниченным доступом, а не в ту же папку сайта. Не обещаю, что обычный архив станет судебным доказательством: для этого важны способ сбора, целостность и документирование передачи. NIST отдельно рекомендует фиксировать обращение с материалами и учитывать динамичность состояния системы. Если нужна помощь с оценкой и сохранением данных, подключите специалистов по информационной безопасности. В бытовом инциденте задача проще: не потерять исходные данные и честно записать, что именно было сделано.
Не удаляйте подозрительный файл «для проверки» и не запускайте очиститель, который молча перезаписывает найденное. Вредоносный файл может быть лишь одним из следов; удаление не закрывает исходную уязвимость или скомпрометированную учётную запись. Вместо этого отметьте путь и время файла, сохраните копию вместе с метаданными, если умеете сделать это безопасно, и ограничьте доступ к ней. Если сервер продолжает отправлять вредоносный контент, приоритет меняется: изоляция пользователей важнее идеальной съёмки. Тут нет магического порядка на все случаи — оцените непосредственный риск и фиксируйте каждое вмешательство.
- Отметьте время обнаружения и часовой пояс
- Запишите уже сделанные изменения
- Сохраните исходные копии отдельно от сайта
- Не запускайте массовую чистку до фиксации
Как изолировать сайт, не усугубив инцидент
Изоляция нужна, чтобы прекратить вредоносную работу сайта и снизить риск для посетителей. Иногда достаточно закрыть публичный доступ на уровне веб-сервера и оставить страницу обслуживания; иногда приходится отключать приложение целиком или ограничивать исходящие соединения. Выбор зависит от признаков атаки, архитектуры и того, затронут ли общий сервер. Не выдавайте режим обслуживания за универсальное лечение: если вредоносный код срабатывает в фоновом задании или через административную учётную запись, заглушка проблему не устраняет.
В nginx можно настроить ответы и ограничения доступа, но точная конфигурация зависит от существующих блоков server и location, прокси и способа запуска CMS. Перед применением проверьте конфигурацию и предусмотрите, кто сохранит доступ для расследования. Ограничение панели по доверенному адресу может помочь, если адреса администраторов известны и список не оставляет лишних лазеек; при смене сети можно закрыть доступ и себе. Для Apache правила зависят от версии и места настройки. Не вставляйте готовый фрагмент из статьи в рабочий конфиг без проверки контекста: синтаксис — не талисман.
Если подозрение касается всего узла, а не одного виртуального сайта, согласуйте изоляцию с теми, кто отвечает за сервер и соседние приложения. Отключение сетевого интерфейса, остановка служб или выключение машины могут пресечь активность, но также изменить доступные данные и повлиять на другие сервисы. Не перезагружайте автоматически «на всякий случай»: это может убрать volatile-состояние из памяти, а может вообще не решить проблему. Если атака продолжается и есть риск для пользователей или соседних систем, выбирайте быстрое ограничение ущерба, одновременно фиксируя решение, время и причину.
Я не обещаю, что закрытие сайта убережёт его от поисковой отметки или «реабилитирует за месяцы»: это зависит от фактического заражения и действий поисковика. Для поискового робота важен ответ сайта, а для расследования — сохранённые данные. Не меняйте robots.txt в надежде скрыть компрометацию: это не блокировка атакующего и не способ устранить вредоносный код. Начинайте с оценки границ инцидента и доступного окна на сбор данных.
- Определите, заражён сайт или весь сервер
- Ограничьте публичный доступ по ситуации
- Сохраните проверенный путь для специалистов
- Зафиксируйте время и способ изоляции
Какие данные копировать и как не потерять контекст
Соберите то, что реально ведётся в вашей конфигурации: журналы веб-сервера, системные события, журнал CMS и данные базы, если там включено нужное логирование. Имена вроде access.log, error.log, auth.log и secure встречаются часто, но это не универсальные пути и не гарантия наличия файлов. Их расположение зависит от дистрибутива, веб-сервера, контейнеров, панели хостинга и ротации логов. Ищите фактические настройки и спросите хостинг, какие журналы он хранит и как быстро удаляет старые записи.
Журнал веб-сервера обычно помогает увидеть время, URL, код ответа и сетевые атрибуты запроса в пределах настроенного формата. Он не назовёт человека за запросом и не докажет, что именно этот запрос стал точкой входа. Журнал приложения может содержать попытки входа и действия пользователей, но только если соответствующее событие записывалось. Поэтому веб-логи, аудит CMS и системные события дополняют друг друга. OWASP отдельно подчёркивает, что журналирование приложения даёт сведения, которых нет в одних только логах веб-сервера. Это один из фактов, который часто теряется за советом «скачайте access.log».
Скопируйте файлы сайта и доступный дамп базы, сохранив структуру и отметив способ получения. Не называйте это гарантированно чистой резервной копией: снимок заражённой системы нужен для анализа, а восстановление обычно делают из проверенного источника после оценки изменений. Если есть снимки виртуальной машины или резервные копии, зафиксируйте дату и место хранения, но не восстанавливайте поверх текущего состояния до сохранения последнего. Отдельно выясните, какие каталоги исключены из резервирования. «У нас есть бэкап» иногда означает архив только базы, а иногда — архив, который давно не открывали.
Сессии и кэш не надо собирать без разбора. В них могут быть секреты, персональные данные и активные маркеры входа. Сохранение таких материалов оправдано, если они нужны расследованию и есть безопасное хранилище с ограниченным доступом; иначе минимизируйте сбор и обратитесь к специалисту. Не публикуйте архивы в тикете хостинга и не пересылайте их обычной почтой. Зафиксируйте хеши, если у вас есть утверждённая процедура и инструмент, а также кто получил копию. Логи сами могут содержать токены и идентификаторы сессий — сначала ограничьте доступ, потом разбирайте содержимое.
- Журналы веб-сервера и приложения
- Системные события и аудит входов
- Файлы и база данных сайта
- Настройки логирования и ротации
- Резервные копии и снимки, если есть
Разбор случая: что показали логи сайта «Бережный чемодан»
В кейсе «Бережный чемодан» — пункт проката оборудования на 14 рабочих мест — поводом для проверки стали перенаправления посетителей на посторонние страницы. Администратор уже удалил несколько файлов, но это не прекратило симптом. Мы остановили публичную выдачу и сохранили оставшиеся доступные данные. Важная оговорка: после удаления исходное состояние уже было изменено, поэтому нельзя было восстановить каждый шаг атаки. Так и выглядит цена поспешной уборки: не конец расследования, но меньше опор для выводов.
В журнале доступа мы увидели повторные обращения к набору URL и сопоставили время запросов с изменениями файлов и доступными записями CMS. Сам по себе повторяющийся запрос не доказал эксплуатацию конкретного модуля. Он только дал направление поиска. Сравнение с чистой копией и перечнем установленных расширений помогло выделить подозрительные изменения. Мы нашли дополнительную административную учётную запись и проверили, когда она появилась и какие действия с ней связаны. Наличие такой записи — признак для расследования, а не самостоятельное доказательство личности или масштаба доступа.
В исходном черновике причиной назывался бэкдор в файле сессии и уязвимый плагин, не обновлявшийся год. Подтверждений этим конкретным деталям нет, поэтому я их убрал. Не буду выдавать правдоподобную историю за установленный факт. В материалах инцидента фиксируют наблюдения отдельно от гипотез: «найден новый администратор» — наблюдение; «его создал атакующий через такой-то модуль» — вывод, которому нужны доказательства. Смешать их легко, особенно когда очень хочется быстро назвать виновника.
Для читателя результат практический: сначала ограничить показ заражённого содержимого, потом сохранить то, что осталось, затем свести временную шкалу из логов, файлов и событий CMS. Если расследование не подтверждает точку входа, так и пишите. Закройте подтверждённые способы доступа и продолжите проверку, а не объявляйте «всё чисто» по одному просканированному каталогу. В каталоге есть отдельная инструкция о том, как очистить сайт от вредоносного кода; здесь же задача уже: сохранить исходные следы и не подменить ими догадки.
Как оценить масштаб и отделить факт от догадки
Проверьте границы доступа: какие сайты размещены на узле, какие системные учётные записи могли читать или менять их файлы, где хранятся общие секреты и резервные копии. Если CMS работает с ограниченными правами, это уменьшает возможный ущерб, но не доказывает, что соседние сайты не затронуты. Если процесс приложения имел широкие права, рассматривайте соответствующую область как потенциально затронутую и привлеките администратора узла. Не начинайте с перечня процессов, которые выглядят необычно: сначала выясните, какие службы и задачи ожидаемы именно на этой системе.
В CMS проверьте список пользователей, роли, время создания учётных записей и недавние изменения контента. В базе не запускайте случайные запросы на удаление: сначала сохраните копию и сравните данные с чистой резервной версией или журналами изменений, если они доступны. Для файлов сравнивайте текущие данные с доверенным дистрибутивом или резервной копией той же версии. Различия — повод изучить файл, не автоматический вердикт «вирус». Обновление CMS, смена владельца файла или штатная работа редактора тоже оставляют следы.
Составьте таблицу «наблюдение — источник — уверенность — следующий шаг». Например: «есть новая учётная запись — журнал CMS и база — высокая уверенность в факте появления — выяснить автора и использованные права». Так проще не перепутать событие с объяснением. Сохраняйте исходные строки логов, а для отчёта делайте отдельные выдержки с контекстом. Перед передачей материалов проверьте, не содержат ли они пароли, токены или данные пользователей. Документируйте часовой пояс: время в веб-журнале и панели хостинга может отображаться по-разному.
Не обещайте руководителю точную дату проникновения, если логи ротировались или аудит был выключен. Укажите интервал, который подтверждается данными, и пробелы: например, отсутствует журнал приложения или архив запросов старше срока ротации. Это не слабый отчёт, а честный. Оценка должна ответить на рабочие вопросы: какие учётные записи отозвать, какие сайты перепроверить, откуда брать чистую копию и что ещё нужно мониторить. Ссылка на признаки взлома по логам nginx и Apache пригодится для первичного чтения журналов, но она не заменит анализ конкретной конфигурации.
- Проверьте соседние сайты и общие учётные записи
- Сверьте администраторов и изменения контента
- Сравнивайте файлы с доверенным источником
- Отделяйте наблюдение от объяснения
Смена паролей и возвращение сайта в работу
Смену секретов планируйте после сохранения нужных следов и с чистого устройства или среды. Если есть основания считать учётные данные скомпрометированными, отзовите доступы CMS, хостинга, SSH, базы и сторонних сервисов, которые могли быть доступны с сайта. Начните с наиболее привилегированных учётных записей и не используйте заражённый сервер для ввода новых паролей. База знаний подтверждает практическое правило менять пароли после взлома, но момент и список зависят от того, что мог прочитать атакующий. Одной ротацией паролей активный вредоносный код не обезвредить.
Ротация секретов может оборвать рабочие интеграции, поэтому составьте перечень зависимостей: задания импорта, почтовая отправка, платёжные или аналитические сервисы, резервное копирование. Меняйте ключи и пароли в контролируемом порядке, проверяя, что старые доступы отозваны. Файлы конфигурации, включая .env или wp-config.php, сначала сохраните для анализа в защищённой копии; не выкладывайте их в переписку. Если ключи шифрования или сертификаты могли быть доступны злоумышленнику, вопрос об их замене решают по фактической модели риска и последствиям, а не автоматически «на всякий случай».
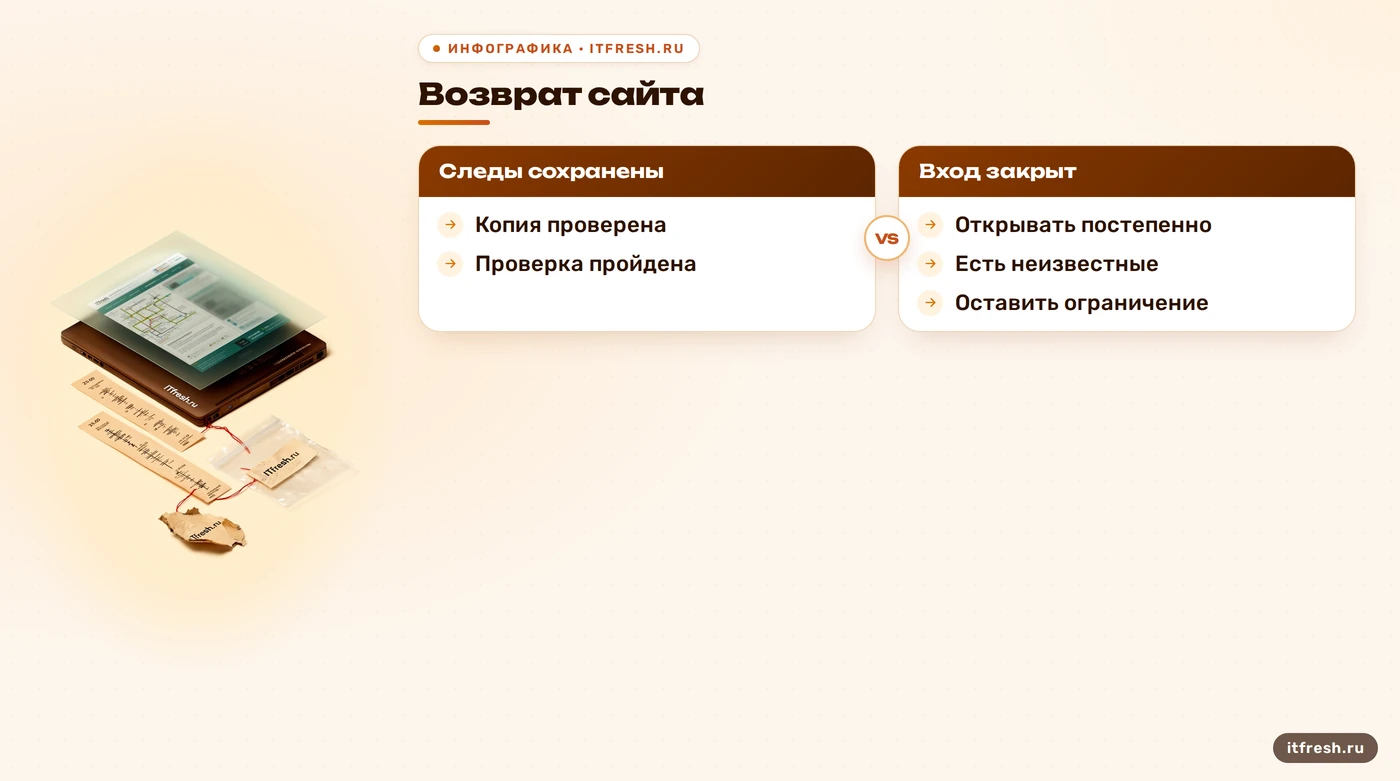
Для восстановления используйте проверенные файлы и базу, устраните известный способ входа и обновите CMS с расширениями по штатной процедуре. Сравните конфигурацию, учётные записи и права, проверьте исходящие соединения и критичные сценарии сайта. Сначала поднимайте копию в изолированной среде, затем возвращайте внешний доступ постепенно и наблюдайте за логами. В плане первых действий при взломе сайта отдельно разобрана подготовка к восстановлению; здесь важно не пропустить контроль после возврата.
Закройте инцидент не фразой «антивирус ничего не нашёл», а списком проверенных пунктов и остаточных неизвестных. Запишите, какие данные сохранили, что восстановили, какие секреты отозвали и когда снова открыли сайт. Если часть логов отсутствовала, укажите это и настройте нужное журналирование после восстановления, проверив, что записи доступны и защищены от постороннего чтения. У срока хранения нет универсальной цифры: он зависит от требований бизнеса, объёма, рисков и правил обработки данных. Решение оформляют как политику хранения, а не как случайную рекомендацию «полгода всем».
- Отзывайте скомпрометированные доступы из чистой среды
- Восстанавливайте из проверенных источников
- Открывайте сайт после контрольной проверки
- Зафиксируйте пробелы в данных и меры наблюдения
Частые вопросы
Что делать в первую очередь, если CMS взломали?
Ограничьте вредоносную выдачу, отметьте время и уже сделанные действия, сохраните доступные файлы, базу и логи. Не начинайте с удаления подозрительных файлов.
Можно ли сразу удалить найденный вредоносный файл?
Сначала сохраните его копию и контекст, если это безопасно. Удаление не устраняет точку входа, а для расследования обратимо теряет данные.
Нужно ли выключать или перезагружать сервер?
Решение зависит от того, продолжается ли атака и затронут ли весь узел. Отключение может снизить ущерб, но изменить доступные данные; зафиксируйте причину и время.
Где искать логи взломанного сайта?
Проверьте фактические настройки веб-сервера, системы, CMS и панели хостинга. Пути и имена журналов различаются, а часть логов могла уже ротироваться.
Сколько хранить логи после инцидента?
Универсального срока нет. Установите его в политике с учётом требований бизнеса, объёма логов, рисков и правил обработки данных.
Источники
- NIST SP 800-86 — Руководство по сбору и сохранению цифровых материалов, фиксации действий и учёту передачи доказательств: https://csrc.nist.gov/pubs/sp/800/86/final
- NIST SP 800-61 Rev. 3 — Актуальные рекомендации по подготовке, реагированию и восстановлению после инцидентов: https://csrc.nist.gov/pubs/sp/800/61/r3/final
- OWASP Logging Cheat Sheet — Роль журналов приложения, защита журналов и чувствительные данные, которые нельзя бездумно сохранять: https://cheatsheetseries.owasp.org/cheatsheets/Logging_Cheat_Sheet.html
- nginx: ngx_http_core_module — Официальная документация директив обработки HTTP-ответов и ошибок nginx: https://nginx.org/en/docs/http/ngx_http_core_module.html
- WordPress: Hardening — Официальное руководство по обновлениям, резервному копированию и рискам общего хостинга WordPress: https://developer.wordpress.org/advanced-administration/security/hardening/