
SLOG не спасёт, если sync=disabled: как на самом деле ZFS хранит подтверждённые транзакции базы
Если на датасете с базой стоит sync=disabled, отдельный SSD под SLOG не делает ничего: журнал ZFS обходится целиком, и подтверждённые базой транзакции живут в оперативной памяти до очередной фиксации. Ниже разбираю, как работает ZIL, чем sync=disabled отличается от logbias=throughput, как это проверить командами и что поставить вместо «ускорения».
Что делает SLOG и почему он не кэш записи
Начну с мифа, который я слышу чаще всего: «у нас в сервере стоит отдельный SSD под журнал, значит запись защищена». Нет. SLOG — это не защита и не кэш, это просто другое место для журнала намерений (ZIL). Если вы строите 1С и PostgreSQL на Linux, понимать разницу нужно до того, как вы нажмёте первую клавишу в zpool, а не после первой аварии.
Документация OpenZFS говорит прямо: ZIL удовлетворяет требованиям POSIX к надёжности записи и существует в любом пуле; по умолчанию он выделяется из блоков самого пула. Синхронная запись — это fsync() или O_SYNC: пока данные не лежат на стабильном носителе, вызов не возвращается. Отдельный лог-вдев (SLOG) нужен лишь затем, чтобы эта маленькая запись шла на быстрое устройство, а не на медленные диски основного пула. Там же сказано: «A SLOG is not a write cache».
Асинхронные записи в ZIL вообще не попадают. Они копятся в памяти и уходят на диск вместе с очередной группой транзакций. И ещё одна деталь, которую почти никто не помнит: ZIL читается только после сбоя, чтобы доиграть то, что не успело зафиксироваться. В нормальной работе SLOG только пишется. Поэтому «ускорение чтения за счёт SLOG» — это отдельная легенда, для чтения у ZFS есть кэш ARC и, по желанию, cache-устройства.
Отсюда простое следствие. SLOG ускоряет только те записи, которые приложение само объявило синхронными, и только если ZFS обязан их дождаться. Стоит снять этот обязательный режим — и SSD превращается в красивую деталь, которая скучает в корпусе. Бывает, что железо дороже защиты, которую оно якобы даёт. Меня это до сих пор веселит.
Что именно отключает sync=disabled
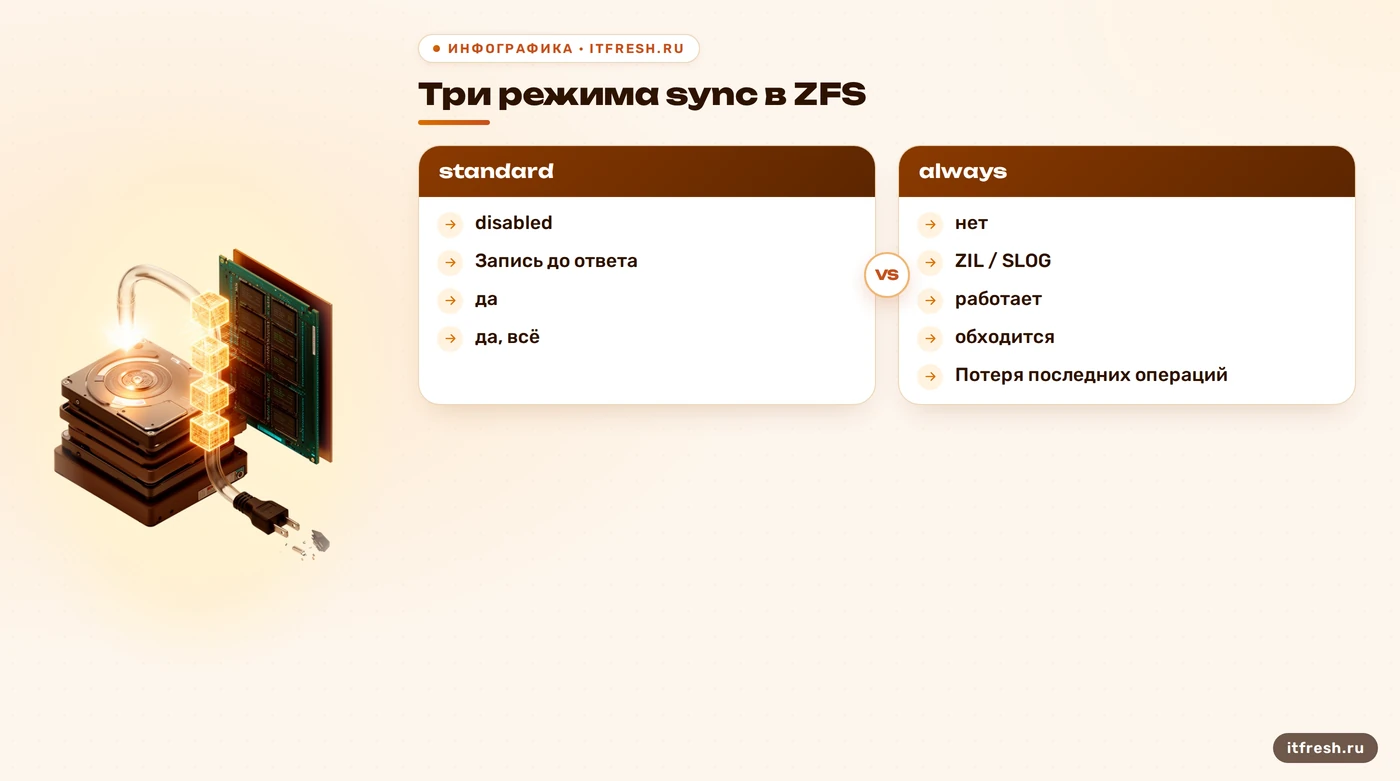
У свойства sync три значения. По справочнику zfsprops: standard — поведение по POSIX, все синхронные запросы пишутся на стабильный носитель; always — каждая транзакция файловой системы записывается и сбрасывается до возврата системного вызова; disabled — синхронные запросы отключены, транзакции фиксируются на стабильном носителе «только периодически». В документации про disabled есть фраза, которую я бы повесил над столом тестировщика: это «очень опасно», потому что ZFS игнорирует требования синхронности от приложений вроде баз данных и NFS, и применять опцию стоит только при понимании рисков.
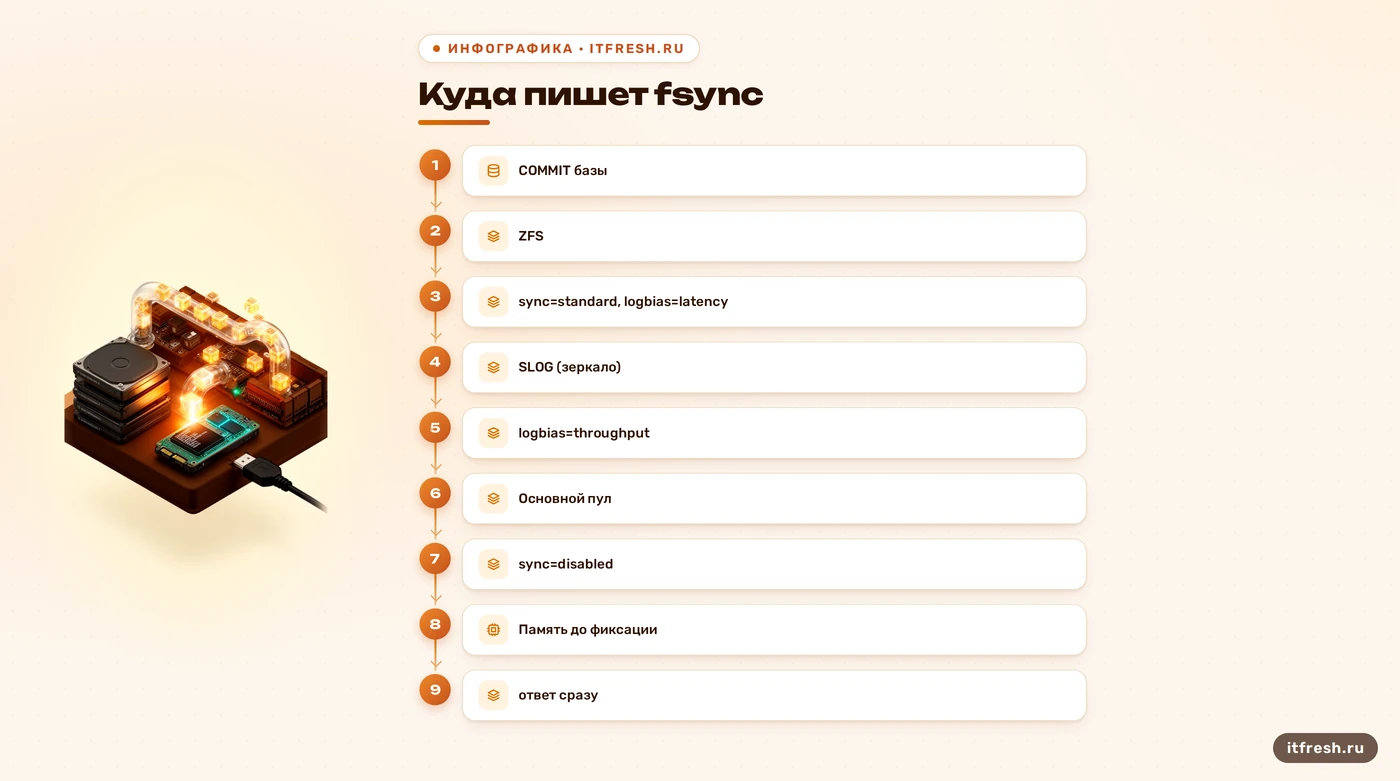
Что это значит для базы. СУБД делает COMMIT, пишет запись в журнал транзакций, вызывает fsync и после возврата отвечает клиенту «готово». При sync=disabled fsync возвращается сразу, ZIL не задействуется вовсе, а клиент уже получил подтверждение. Данные при этом лежат в памяти, и до следующей фиксации группы транзакций их защищает только бесперебойное питание и удача. Наличие SLOG здесь ничего не меняет: пишущий в него код просто не вызывается.
Цена вопроса — последние секунды подтверждённых операций. Сколько именно, зависит от интервала фиксации, и я не буду называть число, которого не проверял в вашей версии: смотрите параметры модуля OpenZFS своей сборки. Важнее другое. PostgreSQL в своей документации разделяет два режима: synchronous_commit = off не создаёт риска порчи базы, при сбое теряются недавние «подтверждённые» транзакции, а состояние базы такое, будто их корректно откатили; а вот отключение fsync может привести к невосстановимой порче данных. Снаружи sync=disabled на ZFS выглядит как synchronous_commit=off, но делается на уровне ниже и без ведома базы. Приложение не знает, что гарантии сняты, и не может на это отреагировать. Для бухгалтерской базы, где «проведено» значит «проведено», это плохая сделка.
Про порчу структуры. Сама ZFS при потере питания остаётся консистентной благодаря copy-on-write, в этом её сильная сторона. Теряются свежие записи, а не целостность файловой системы. Но база живёт поверх файловой системы со своими ожиданиями порядка записей. Если вы заодно разрешили приложению считать, что fsync выполнен, то отвечаете за логику восстановления сами. И сюда же относятся клиенты, которым вы успели ответить «операция проведена».
- standard — синхронные запросы приложения исполняются честно, ZIL работает, SLOG (если есть) ускоряет;
- always — синхронно записывается всё, включая то, что приложение не просило; медленнее, нужен очень быстрый SLOG;
- disabled — fsync возвращается сразу, ZIL обходится, SLOG не используется; подтверждённые операции хранятся в памяти до очередной фиксации.
Чем logbias=throughput отличается от sync=disabled
Эти два параметра путают постоянно, и зря. logbias — подсказка ZFS, как обрабатывать синхронные запросы на этом датасете. Значение latency (по умолчанию) означает: использовать лог-устройства пула, если они есть, для малой задержки. Значение throughput: не использовать лог-устройства для хранения записываемых данных. Синхронность при этом сохраняется — ответ приложению всё так же приходит после записи на стабильное хранилище, только уже в основной пул, а не на SLOG.
Для PostgreSQL это бывает осмысленно. В руководстве OpenZFS по настройке нагрузок для базы с большими обновлениями предлагается поэкспериментировать с logbias=throughput на датасете с данными, чтобы не писать дважды; там же предупреждено, что мелкие обновления при таком режиме могут вызвать сильную фрагментацию. То есть это тюнинг под конкретный профиль, который проверяют, а не включают по ощущениям. Для журнала транзакций (pg_wal), где мелких синхронных записей большинство, оставляйте latency, иначе вся польза от SLOG пропадёт.
Разница простая. sync=disabled снимает обязательство: записать можно когда-нибудь. logbias=throughput меняет только место, куда ZFS пишет обязательную запись. Первое меняет гарантию, второе меняет путь. Если коллега говорит, что «мы же только обошли SLOG», уточните, что именно он трогал. Это два разных свойства, и после них разные последствия при отключении питания.
Соседний вопрос про «SLOG вообще нужен?». Нужен не всем. По документации OpenZFS его стоит рассматривать, если нагрузка использует fsync или O_SYNC и пул построен на механических дисках. Если пул целиком на NVMe, выигрыш скромнее, и лучше сначала замерить, чем покупать. Про сам подход к выбору ZFS под файловый сервер я писал в статье про ZFS для файлового сервера, но база с её синхронной записью требует отдельного разговора.
Как проверить свои датасеты за пять минут
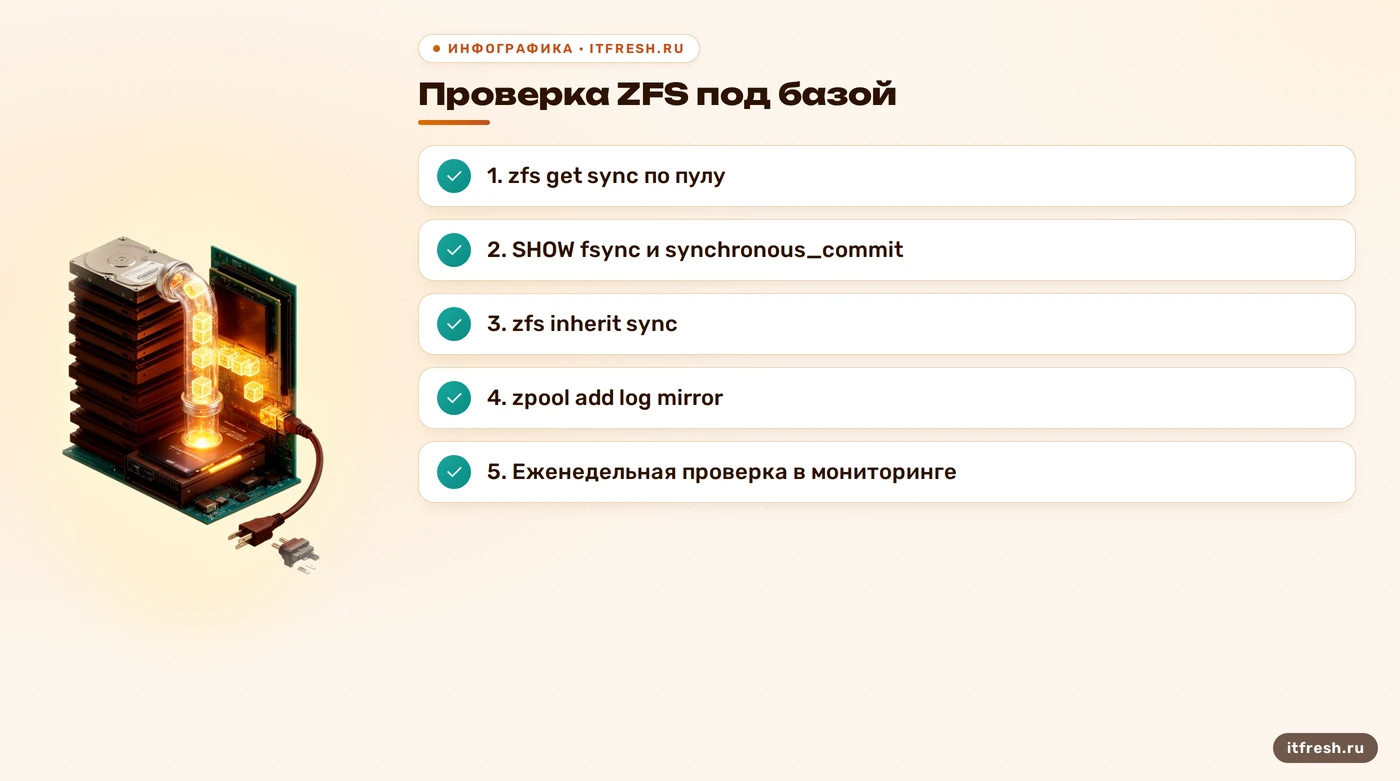
Первое, что я делаю на любом сервере с ZFS и базой, — смотрю, не выставил ли кто-то sync вручную. Чужие «временные» настройки живут годами: поставили на время миграции и забыли. Команда ниже показывает значение и, что важнее, источник: local означает, что свойство задали явно, inherited — что оно пришло от родителя, default — стандартное.
zfs get -r -o name,property,value,source sync,logbias,recordsize tankЕсли нужно найти только то, что менялось руками, отфильтруйте по источникам. Ключ -s принимает список источников, остальные свойства пропускаются.
zfs get -r -s local,received -o name,value sync tankНашли sync=disabled на датасете с базой — верните наследуемое значение. В документации zfs-inherit команда выглядит как zfs inherit [-rS] свойство датасет; если родитель тоже disabled, то лучше выставьте значение явно.
zfs inherit sync tank/pgdata
zfs set sync=standard tank/pgdata
zfs get -o name,value,source sync tank/pgdata
Вторая проверка — как база ведёт себя сама. В PostgreSQL командой SHOW synchronous_commit смотрите режим фиксации; по умолчанию там on. Там же полезно убедиться, что fsync не выключен: документация прямо называет его отключение причиной возможной невосстановимой порчи данных после сбоя питания. Если вы видите fsync = off в конфигурации «для скорости», это в разы хуже любого sync=disabled, а в паре они вообще способны превратить базу в сувенир.
psql -U postgres -c "SHOW synchronous_commit;"
psql -U postgres -c "SHOW fsync;"
psql -U postgres -c "SHOW full_page_writes;"
Третья проверка — реальная задержка записи на пуле во время работы. Команда zpool iostat с ключами -v и -l показывает статистику по каждому вдеву и средние задержки; интервал задаётся числом секунд. Помните, что первый отчёт — это среднее с момента загрузки, чтобы его скрыть, добавьте -y.
zpool iostat -v -l -y tank 5И последнее — измерить, на что способна синхронная запись именно у вас. У PostgreSQL для этого есть утилита pg_test_fsync: она показывает среднее время синхронизации файла для каждого метода wal_sync_method. Файл для теста укажите на той файловой системе, где лежит или будет лежать pg_wal, иначе вы замерите чужой диск. Длительность одного теста по умолчанию 5 секунд, меняется ключом -s.
pg_test_fsync -f /tank/pgwal/pg_test_fsync.out -s 5Разбор: бухгалтерская консультация с «безопасным тюнингом»
Условный пример, цифры собраны из типовых проектов. Бухгалтерская консультация «БухГрупп», 12 рабочих мест, 1С на PostgreSQL на одном сервере с ZFS. Зеркало из двух HDD по 4 ТБ, без отдельного журнала. Предыдущий подрядчик сделал нагрузочный тест — пакетное проведение документов за квартал — и получил 41 минуту. Потом добавил один SSD на 480 ГБ как лог-устройство и в тот же вечер выставил sync=disabled на датасете с базой, повторил тест и получил 9 минут. В отчёте это назвали «оптимизацией дисковой подсистемы с использованием SSD». Я читал этот отчёт дважды. В нём не было ни слова о том, что SSD в этом тесте вообще не участвовал.
Когда мы пришли к ним на обслуживание, первым делом сняли zfs get по всему пулу. Выяснилось, что sync=disabled на датасете с базой стоит как local, а на датасете с журналом транзакций — унаследован от родителя. То есть защита была снята с обоих. Тревогу у заказчика вызвал не сам факт, а вопрос: «А если выключится свет?» Свет у них уже выключался дважды за год, а ИБП на сервере был рассчитан минут на десять. Мы объяснили без драмы: по документации потеряются последние подтверждённые операции, которые ещё не были зафиксированы, но у бухгалтерии это именно те документы, которые человек только что провёл и по которым уже закрыл окно.
Что сделали за два рабочих дня. Вернули sync=standard на обоих датасетах. Разнесли данные и журнал транзакций по разным датасетам, как рекомендует руководство OpenZFS для PostgreSQL. Для журнала оставили logbias=latency, а SLOG превратили в зеркало из двух SSD, потому что одиночное лог-устройство — это единственная точка отказа в схеме, которую мы строили ради надёжности. Команда была вида zpool add -n tank log mirror ... в режиме пробного прогона, и только затем без -n.
Результат тоже без чудес: те же 41 минута стали около 14, потому что синхронная запись теперь идёт на SSD, а не на два медленных диска. Не девять минут, зато девять минут с честным подтверждением. Заказчик согласился на разницу за пять минут, когда ему показали сумму потенциальной переделки закрытого квартала. Отчётность, переделанная вручную, стоит дороже любого SSD. Отдельно мы вынесли в регламент правило: любое изменение sync на датасетах с базой — только с записью в журнале изменений.
Что поставить вместо sync=disabled
Если скорость нужна, а честная синхронная запись её не даёт, у вас есть нормальные варианты, и ни один не требует снимать гарантии. Первый и самый дешёвый: добавить лог-устройство и сделать его зеркалом. Документация zpool create показывает пример с зеркалом лог-вдевов (log mirror), а в zpoolconcepts сказано, что лог-устройств может быть несколько и их можно зеркалировать. Перед выполнением на боевом пуле запускайте zpool add с ключом -n: он показывает конфигурацию, которая получится, не меняя пул.
zpool add -n tank log mirror /dev/disk/by-id/nvme-ssd-A /dev/disk/by-id/nvme-ssd-BБерите накопители с низкой задержкой и защитой от потери питания (power-loss protection) — это прямо рекомендует и страница OpenZFS про ZIL и SLOG. Причина простая: SSD без защиты может подтвердить запись, которая лежит в его внутреннем кэше, и тогда вы получите ту же потерю подтверждённых операций, но на другом уровне. Смешно: заплатили за журнал, а он подтверждает записи так же вольно, как sync=disabled.
Второй вариант — решить задачу на уровне базы там, где можно управлять риском по транзакциям. PostgreSQL умеет synchronous_commit = off, и по документации это не портит базу, а лишь допускает потерю последних подтверждённых транзакций. Поэтому для некритичных операций, например, журнала действий пользователей, такой режим можно включить для сессии, а для проведения документов оставить on. Решение принимает владелец данных, а не файловая система, и это принципиальная разница. Подробнее про безопасный тест копий баз без вреда для рабочей есть в статье про тестовую базу 1С для обновлений.
Третий вариант — честно признать, что sync=disabled допустим там, где данные можно пересоздать: временный датасет для сборки, кэш, каталог для распаковки дистрибутивов. Я включаю его только на таких датасетах и пишу в описании датасета, зачем. Ещё из практики настройки под PostgreSQL: руководство OpenZFS предлагает рекордсайз 32K или 64K (или стандартный 128K) и lz4-сжатие для датасетов с данными и журналом, а full_page_writes = off допускает, только если recordsize не меньше 8K и конфигурация не переедет на не-ZFS. Это совет с оговорками, проверяйте его на своей версии и своём профиле, а не копируйте вслепую.
Если хотите, чтобы я посмотрел вашу ZFS-конфигурацию и сказал, где у вас «временно» отключена защита, — напишите нам. Аудит занимает обычно один рабочий день, в итоге вы получите список датасетов, рисков и план исправлений.
Регламент: как не вернуть всё обратно через полгода
Конфигурацию мало исправить, её нужно удержать. Опасный сценарий выглядит так: через полгода кто-то жалуется на медленную проводку, новый сотрудник гуглит «ZFS slow database» и находит первый же совет — sync=disabled. Совет работает, жалобы пропадают, и всё возвращается в исходное состояние. Поэтому в наших проектах есть простая, скучная проверка: раз в неделю скрипт мониторинга выполняет zfs get -r -s local sync и сообщает, если на каком-либо датасете значение отличается от ожидаемого. Если у вас есть мониторинг, отправьте это в него; здесь достаточно одного пользовательского параметра.
Второй элемент — отдельное лог-устройство нужно мониторить так же, как диски данных. Если SLOG деградирует, вы узнаете об этом по росту задержек в zpool iostat -l, а не по сообщению пользователя. Для этого мы ставим пороги на задержку записи и на состояние пула, и не доверяем фразе «пул ONLINE, значит всё хорошо». Не путайте это со свойством пула failmode: по zpoolprops оно управляет поведением при катастрофическом отказе пула (потеря связи с устройствами), а не при выходе из строя одного лог-устройства. Типичная картина такая: если одиночный SLOG умирает в обычной работе, ZFS возвращается к журналу в основном пуле и становится медленнее, а вот совпадение отказа SLOG со сбоем питания может стоить последних синхронных записей. Детали поведения проверьте в своей версии OpenZFS — и именно поэтому мы ставим лог зеркалом.
Третий элемент — резервная копия. SLOG и сама ZFS не заменяют бэкап: снимки живут в том же пуле, что и данные. Бэкап делают все, проверяет его почти никто, так что раз в месяц разворачивайте копию базы на тестовом сервере и сверяйте контрольные суммы оборотов. Для 1С это занимает час, а бухгалтерия, которая слышит «копия проверена и открывается», спит спокойнее, чем при любых разговорах о SSD.
И напоследок приоритеты. Сначала проверьте sync и fsync, потом поставьте зеркало лога, затем разнесите данные и журнал, и только после этого играйте с recordsize и logbias. Всё остальное — тонкая настройка, которая даст проценты, тогда как первые три шага избавляют от потери данных.
Частые вопросы
Защищает ли SLOG данные при sync=disabled?
Нет. При sync=disabled синхронные запросы приложения не требуют записи на стабильный носитель, ZIL обходится целиком, и лог-устройство не используется. Подтверждённые операции остаются в памяти до очередной фиксации.
Чем logbias=throughput отличается от sync=disabled?
logbias=throughput лишь запрещает использовать лог-устройства для хранения данных, синхронность сохраняется: запись идёт в основной пул. sync=disabled снимает саму гарантию, ответ приложению приходит до записи на диск.
Можно ли отключать sync для базы в тестовой среде?
Можно, если данные легко пересоздать, и вы не используете замеры для выводов о боевой производительности. Тест с sync=disabled не показывает реальную скорость подтверждённой записи, поэтому для сравнений его применять нельзя.
Нужен ли SLOG, если пул на SSD или NVMe?
Не всегда. OpenZFS советует рассматривать SLOG при синхронной нагрузке на механических дисках. На быстрых накопителях выигрыш скромнее, поэтому сначала замерьте задержки командой zpool iostat -v -l.
Как вернуть безопасное значение sync?
Командой zfs inherit sync датасет вернётся значение родителя, или явно zfs set sync=standard датасет. Затем проверьте результат через zfs get -o name,value,source sync датасет.
Источники
- OpenZFS: свойства sync, logbias, recordsize (zfsprops) — Значения sync (standard, always, disabled), предупреждение об опасности disabled, поведение logbias: https://openzfs.github.io/openzfs-docs/man/master/7/zfsprops.7.html
- OpenZFS: ZIL, SLOG и кэширование — «A SLOG is not a write cache», ZIL читается только после сбоя, sync=disabled пропускает ZIL: https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Pool%20Structure/Caching.html
- OpenZFS: концепции пула (Intent Log) — Журнал в основном пуле по умолчанию, несколько зеркалируемых лог-устройств: https://openzfs.github.io/openzfs-docs/man/master/7/zpoolconcepts.7.html
- OpenZFS: настройка под нагрузку (PostgreSQL) — Раздельные датасеты данных и WAL, recordsize, full_page_writes, logbias=throughput: https://openzfs.github.io/openzfs-docs/Performance%20and%20Tuning/Workload%20Tuning.html
- PostgreSQL: параметры WAL — fsync, synchronous_commit (on по умолчанию), full_page_writes: https://www.postgresql.org/docs/current/runtime-config-wal.html
- PostgreSQL: pg_test_fsync — Синтаксис и ключи -f, -s утилиты проверки скорости синхронизации: https://www.postgresql.org/docs/current/pgtestfsync.html