
Один SSD как special vdev к RAIDZ2: почему это не ускорение, а точка отказа
Сисадмин видит на полке свободный NVMe и хочет «ускорить» им медленный RAIDZ2. Логика понятная: у ZFS же есть кэши, SSD под метаданные — это ведь как L2ARC, только лучше. Проблема в том, что special vdev — не кэш. Это полноправный top-level vdev, единственный экземпляр метаданных пула, и его смерть означает смерть всего массива, включая данные на всех исправных дисках. Ниже — как я считаю избыточность и объём под special, что делать, если одиночный SSD уже воткнут, почему на raidz-пуле это решение необратимо, и разбор внедрения на файловом сервере рекрутинговой компании на 24 рабочих места с цифрами до и после.
«У нас есть лишний SSD, воткни его в массив — пусть ускоряет»
Эту просьбу я слышу примерно раз в квартал, и формулировка почти всегда одна и та же. Массив на восьми SAS-дисках в RAIDZ2 тормозит на обходе каталогов, ночной бэкап не укладывается в окно, у кого-то в шкафу лежит NVMe от старого сервера — давай подцепим его под метаданные. За просьбой стоит подмена понятий, и она стоит людям пулов.
В ZFS есть три разных сущности, которые в разговорах сваливают в кучу. L2ARC — это кэш чтения второго уровня: вылетел диск L2ARC, пул моргнул статистикой и поехал дальше, ни один байт данных не потерян. SLOG — отдельное устройство под ZIL: его потеря в современных версиях стоит вам незакоммиченных синхронных записей в момент аварии, но не пула. А special vdev — это третья сущность, и она из другой категории: это часть основного хранилища, а не довесок к нему.
Документация OpenZFS на этот счёт не оставляет пространства для трактовок: «Losing it loses the pool, exactly as losing any other top-level vdev would» и прямым текстом — «Never add one as a single device to a redundant pool». То есть RAIDZ2, который спокойно переживает одновременный отказ двух дисков из восьми, после добавления одиночного SSD переживает ровно ноль отказов этого SSD. Уровень надёжности всего массива опускается до уровня самого слабого top-level vdev, и это теперь потребительский NVMe без защиты питания.
Меня в этой истории пугает не сам риск, а то, как он маскируется. Первые полгода всё летает, все довольны, про SSD забывают. Он не в мониторинге, потому что «это же кэш». Потом контроллер уходит в read-only по износу или просто исчезает с шины — и zpool status показывает FAULTED на пуле, где физически исправны все данные. Восстановления нет: метаданные, без которых эти данные нельзя интерпретировать, лежали только там.
- L2ARC (`zpool add tank cache …`) — кэш чтения: потеря устройства не затрагивает целостность пула.
- SLOG (`zpool add tank log …`) — отдельное устройство под ZIL: при его отказе в момент аварии теряются лишь последние синхронные записи, пул остаётся жив.
- Special vdev (`zpool add tank special …`) — top-level vdev основного хранилища: его потеря означает потерю всего пула.
- Dedup vdev (`zpool add tank dedup …`) — тоже top-level vdev с таблицами дедупликации и с теми же требованиями к избыточности, что у special.
Что физически лежит в special vdev и почему это не кэш
Порядок размещения по документации выглядит так. В special class уезжают таблицы дедупликации (если нет отдельного dedup vdev), все метаданные, indirect-блоки пользовательских данных, ZIL при отсутствии отдельного log-устройства, и опционально — мелкие блоки данных, если задано свойство special_small_blocks. Всё остальное идёт в normal class, то есть на ваши шпиндели. Формулировка из man zpoolconcepts(7) в master-ветке (размещение ZIL на special появилось в 2.4, в 2.2/2.3 его нет): «Allocations in the special class are dedicated to specific block types. By default, this includes all metadata, the indirect blocks of user data, intent log (in absence of separate log device), and deduplication tables».
Обратите внимание на два умолчания, которые часто пропускают. Модульные параметры zfs_user_indirect_is_special и zfs_ddt_data_is_special включены по умолчанию (значение 1). Это значит, что даже если вы не трогали special_small_blocks и считаете, что «там одни метаданные», на SSD уже лежат indirect-блоки пользовательских данных — служебные блоки-указатели, без которых нельзя собрать ни один файл размером больше одной записи. Проверить на своей машине можно так:
cat /sys/module/zfs/parameters/zfs_user_indirect_is_special
cat /sys/module/zfs/parameters/zfs_ddt_data_is_special
cat /sys/module/zfs/parameters/zfs_special_class_metadata_reserve_pct
zfs version
Что это означает на практике. Метаданные — это карта пула: dnode-блоки, объекты MOS, spacemaps, ZAP-объекты каталогов. Без dnode нельзя узнать, где лежат блоки файла. Без indirect-блока нельзя собрать файл больше recordsize. ZFS по умолчанию держит для метаданных две копии (ditto-блоки) и старается разложить их по разным vdev — но класс размещения жёстче географии: обе копии останутся внутри special-класса. Если в классе одно устройство, обе копии лежат на одном устройстве и умирают вместе с ним. Ditto-блоки спасают от битого сектора, а не от потери диска.
И сразу разведу два сценария, которые в форумных тредах постоянно путают. Заполнение special-класса и физическая потеря special vdev — это совершенно разные вещи с разными последствиями. Когда special кончается по месту, новые аллокации просто начинают уходить в normal class: деградация скорости, ноль потерь. Когда special умирает физически — пул недоступен целиком. Первое лечится мониторингом, второе — только избыточностью, заранее.
- Всегда в special class (если он есть): метаданные пула — dnode, MOS, spacemaps, ZAP-объекты каталогов.
- По умолчанию тоже там: indirect-блоки пользовательских данных (`zfs_user_indirect_is_special=1`) и таблицы DDT при отсутствии dedup vdev (`zfs_ddt_data_is_special=1`).
- В актуальной документации (ветка 2.4): ZIL при отсутствии отдельного log-устройства.
- Только по явному запросу: мелкие блоки файлов и zvol, если на датасете задано `special_small_blocks` больше нуля.
- Всё остальное — большие блоки данных — идёт в normal class, на шпиндели.
Правило избыточности: не ниже, чем у обычных vdev
Документация формулирует требование однозначно: «A special vdev must be at least as redundant as the pool's normal vdevs». Разворачиваю в конкретику. Пул из RAIDZ1 переживает отказ одного диска — значит, special минимум двухдисковое зеркало. Пул из RAIDZ2 переживает два отказа — значит, формально нужен уровень «два отказа», то есть трёхстороннее зеркало. RAIDZ3 — четырёхстороннее. Зеркало из двух дисков при RAIDZ2 буквой документации не соответствует. Man zpoolconcepts(7) говорит то же чуть мягче: «The redundancy of this device should match the redundancy of the other normal devices in the pool».
Здесь я скажу честно: единого мнения в отрасли нет, и большинство инсталляций, которые я вижу, живут на двухстороннем зеркале под RAIDZ2. Моя рабочая позиция такая. Если пул до полусотни терабайт, есть проверенный бэкап и восстановление занимает часы, а не дни, — двухстороннее зеркало из корпоративных NVMe с защитой питания я считаю приемлемым компромиссом и делаю так сам. Если пул единственная копия данных, или восстановление растянется на несколько суток простоя, или это RAIDZ3 (то есть заказчик уже заплатил за паранойю) — только три диска. Разница в деньгах — один NVMe на 960 ГБ–1,92 ТБ. Разница в последствиях — весь массив.
Хорошая новость: ZFS сопротивляется самостоятельно. Попытка добавить одиночное устройство в special-класс redundant-пула упирается в проверку уровня репликации, и команда отказывается работать без принудительного флага: по man zpool-add(8) это -f («specify a conflicting replication level»), а в свежих версиях для этого же случая есть отдельный ключ --allow-replication-mismatch. Сначала всегда прогоняйте план в режиме dry-run:
# посмотреть, что получится, ничего не меняя
zpool add -n tank special mirror \
  /dev/disk/by-id/nvme-MTFDKBA1T9TFR_A \
  /dev/disk/by-id/nvme-MTFDKBA1T9TFR_B

# так делать НЕ надо: конфликт уровня репликации, потребует -f
# или --allow-replication-mismatch
zpool add tank special /dev/disk/by-id/nvme-single
Момент, когда рука дописывает -f, — это и есть момент принятия риска за весь пул. Я за пятнадцать лет ни разу не видел, чтобы эти ключи набирали осознанно: его набирают, потому что «команда не сработала».
- Только корпоративные SSD/NVMe с защитой питания (PLP) — метаданные это мелкая случайная запись, потребительские диски на ней выгорают и врут о сбросе кэша.
- Диски в зеркале — из разных партий, а лучше разных моделей: одинаковые диски с одинаковой нагрузкой умирают почти синхронно.
- Одинаковый ashift с остальным пулом — иначе потом не сработает даже то удаление vdev, которое в принципе разрешено.
- Ресурс от 1 DWPD и обязательный мониторинг SMART/wear leveling с алертом заранее, а не по факту отказа.
- Адресация только по /dev/disk/by-id — after reboot имена nvme0n1 переезжают, и вы добавите не тот диск.
Разбор из практики: рекрутинговая компания на 24 рабочих места
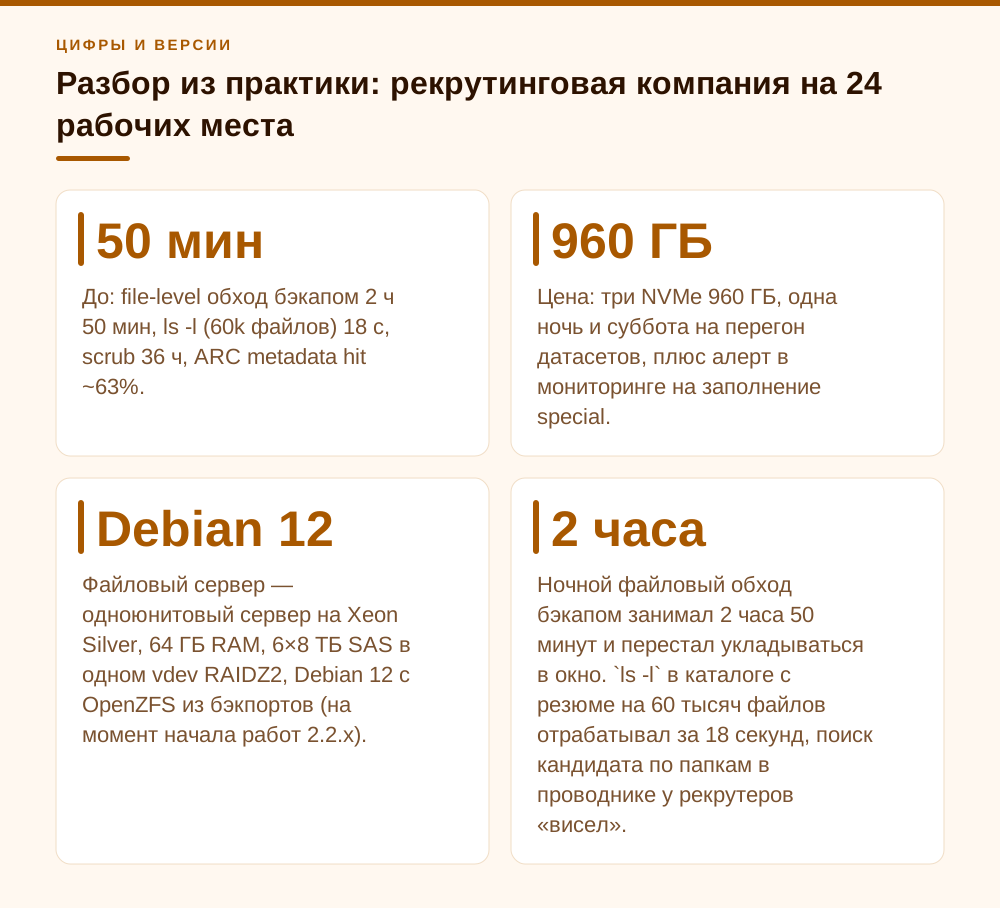
Стенд, который я разбирал прошлой зимой. Рекрутинговая компания «КадроваяГавань», 24 рабочих места: рекрутеры, аккаунт-менеджеры, бухгалтерия. Файловый сервер — одноюнитовый сервер на Xeon Silver, 64 ГБ RAM, 6×8 ТБ SAS в одном vdev RAIDZ2, Debian 12 с OpenZFS из бэкпортов (на момент начала работ 2.2.x). Пул tank: около 29 ТиБ полезной ёмкости, занято 19 ТиБ. Внутри — архив резюме, сканов анкет и договоров примерно на 9 миллионов мелких файлов, записи видеособеседований, репозиторий резервных копий рабочих мест и пара виртуалок (CRM и 1С), отданных по NFS на гипервизор.
Жалобы были ровно те, что обычно и приводят к разговору про special vdev. Ночной файловый обход бэкапом занимал 2 часа 50 минут и перестал укладываться в окно. ls -l в каталоге с резюме на 60 тысяч файлов отрабатывал за 18 секунд, поиск кандидата по папкам в проводнике у рекрутеров «висел». Scrub шёл полтора суток. ARC был выкручен на 40 ГБ, метаданные в нём упирались в потолок постоянно, hit rate по метаданным болтался около 63 %. То есть машина не считала — она бегала головками по шпинделям за dnode-блоками.
Прежде чем что-то покупать, я всегда меряю, сколько метаданных в пуле реально. Гадать по формуле «примерно процент» — плохая идея: доля зависит от recordsize и среднего размера файла и легко уходит в разы. Считает zdb, но предупреждаю сразу: это часы работы и десятки гигабайт RAM, я гонял на реплике, а не на боевом сервере в рабочее время.
# статистика блоков по типам: метаданные, indirect, DDT (медленно и тяжело!)
zdb -Lbbbs tank | tee /var/tmp/tank-blocks.txt

# быстрый ориентир по заполнению уже существующих классов
zpool list -v tank
zfs get -r recordsize,special_small_blocks tank
Вышло около 110 ГБ метаданных на 19 ТиБ данных — примерно 0,56 %. Плюс мы планировали включить special_small_blocks=16K на датасете с мелочью (сканы-превью, выгрузки из CRM, конфиги), это добавляло ещё примерно 70 ГБ с запасом на рост. Итого нужно было около 200 ГБ полезной ёмкости, взяли 960 ГБ — метаданные растут вместе с числом файлов, архив резюме у кадровиков только пухнет, а места на вырост в special должно быть много, потому что расширять его потом неудобно.
Поставили три NVMe Micron 7450 PRO 960 ГБ из разных партий, трёхстороннее зеркало (пул единственная быстрая копия, восстановление из внешнего бэкапа заняло бы больше суток простоя всей компании — это ровно тот случай, когда я не экономлю на третьем диске). ashift совпал с пулом, 12. И вот тут — самый важный практический момент всей статьи, из-за которого половина внедрений даёт эффект «ну, немного быстрее»: добавление special vdev не переносит туда существующие метаданные. На SSD попадает только то, что записано после добавления. Старые 110 ГБ остались лежать на шпинделях.
zpool add tank special mirror \
  /dev/disk/by-id/nvme-Micron_7450_A \
  /dev/disk/by-id/nvme-Micron_7450_B \
  /dev/disk/by-id/nvme-Micron_7450_C

zfs set special_small_blocks=16K tank/misc
zpool list -v tank
Перегоняли данные, чтобы метаданные переехали: датасеты по очереди через zfs send | zfs recv в новый датасет с переименованием, в свежих ветках для этого есть zfs rewrite (в 2.4 к ней добавили ключ -P). Заняло одну ночь и субботу по архиву резюме. Результат через две недели работы: обход бэкапом 2:50 → 24 минуты, ls -l на 60 тысячах файлов 18 с → 0,6 с, scrub 36 часов → 17 часов. Через полгода special заполнен на 24 %, износ NVMe по SMART — 1 %.
- До: file-level обход бэкапом 2 ч 50 мин, ls -l (60k файлов) 18 с, scrub 36 ч, ARC metadata hit ~63 %.
- После: 24 мин, 0,6 с, 17 ч, ARC metadata hit 93 % (часть промахов теперь стоит доли миллисекунды, а не 8–12 мс seek).
- Цена: три NVMe 960 ГБ, одна ночь и суббота на перегон датасетов, плюс алерт в мониторинге на заполнение special.
- Что не изменилось: линейная скорость чтения больших файлов (видеособеседования) — она упирается в шпиндели и special на неё не влияет.
Обратной дороги нет: почему на raidz-пуле это решение навсегда
Даже если вы всё сделали правильно, есть второе свойство, которое надо принять до, а не после. Man zpool-remove(8) говорит: «Top-level vdevs can only be removed if the primary pool storage does not contain a top-level raidz or draid vdev, all top-level vdevs have the same ashift size, and the keys for all encrypted datasets are loaded». Страница Special vdev в документации OpenZFS добавляет прямо: на raidz-пуле special vdev снять нельзя никогда, добавление — решение навсегда. Удаление поддержано для зеркальных и одиночных top-level vdev, включая dedup и special, — но только пока основное хранилище пула не содержит raidz или draid. Ваш RAIDZ2 — ровно тот случай, когда removal недоступен в принципе.
Перевожу на человеческий: special vdev, добавленный к RAIDZ2-пулу, снимается только вместе с пулом. Никакого «попробуем, не понравится — уберём» здесь нет. Пересоздание пула даже на 29 ТиБ, как в кейсе выше, — это второй такой же массив под перелив или сутки-двое простоя. Поэтому решение о special на raidz я всегда обсуждаю как архитектурное, наравне с выбором самой топологии, и фиксирую письменно.
Даже там, где removal формально доступен (пул из зеркал), есть два дополнительных условия, о которые спотыкаются: у всех top-level vdev должен совпадать ashift, и ключи шифрования всех датасетов должны быть загружены. Взяли NVMe с 4K-сектором в пул с ashift=9 — и вы уже никуда его не денете.
Теперь главное — что делать, если одиночный SSD в special уже стоит. Не паниковать и не пересоздавать пул. Одиночное устройство превращается в зеркало командой zpool attach онлайн, с ресилвером и без остановки сервиса. Ресилвер special обычно занимает минуты или десятки минут — там сотни гигабайт, не десятки терабайт. Это работа на один вечер, и делать её надо сегодня, а не «в план на квартал».
# превратить одиночный special в зеркало, без остановки
zpool attach tank /dev/disk/by-id/nvme-single /dev/disk/by-id/nvme-new
zpool status tank # смотрим resilver и появление mirror под special- Проверьте прямо сейчас: `zpool status tank` — есть ли раздел `special` и сколько под ним устройств.
- Одно устройство под special в redundant-пуле — это инцидент, а не техдолг: у вас деградированная по надёжности конфигурация, которая выглядит здоровой.
- Лечится онлайн: `zpool attach tank <существующий-special> <новый-диск>`, дальше ресилвер.
- Пока второй диск не приехал — убедитесь, что бэкап пула актуален и восстановление проверялось.
Сколько брать места и что происходит, когда оно кончается
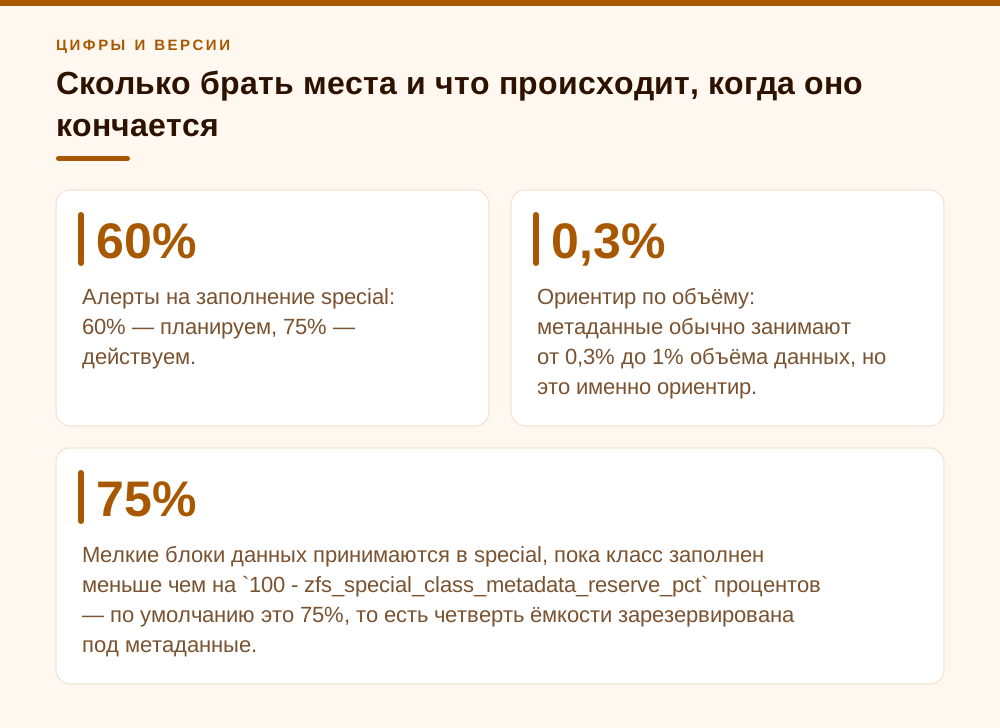
Ориентир по объёму: метаданные обычно занимают от 0,3 % до 1 % объёма данных, но это именно ориентир. Доля растёт, когда много мелких файлов и когда снижен recordsize: у датасета с recordsize=16K метаданных пропорционально больше, чем у видеоархива с recordsize=1M. Если в пуле включена дедупликация (я её почти никогда не включаю), к этому добавляется таблица DDT, которая по умолчанию тоже живёт в special-классе и может съесть его целиком. Считайте zdb, а не пальцем.
Свойство special_small_blocks принимает значения от 0 до 16 МиБ, по умолчанию 0. Ключевая деталь из man zfsprops(7): порог применяется к размеру блока после сжатия и шифрования, а не к исходному. И типичная ошибка, которую я вижу постоянно: выставить special_small_blocks равным или большим recordsize датасета. Это означает «весь датасет целиком на SSD» — special забивается за неделю, а человек искренне не понимает, что произошло.
Что происходит при заполнении. Мелкие блоки данных принимаются в special, пока класс заполнен меньше чем на 100 - zfs_special_class_metadata_reserve_pct процентов — по умолчанию это 75 %, то есть четверть ёмкости зарезервирована под метаданные. Параметр описан в man zfs(4) ветки 2.3 со значением 25 %; в man master-ветки его уже нет, поэтому на своей версии проверяйте наличие и значение в /sys/module/zfs/parameters/. Метаданные продолжают идти в special и после этого порога, пока место вообще есть. Когда места нет совсем — по man zpoolconcepts(7) аллокации «spill back into the normal class», то есть уходят, на шпиндели. Пул при этом жив, ничего не теряется, вы просто постепенно возвращаетесь к исходной производительности.
Мониторинг у меня простой: zpool list -v показывает заполнение по каждому vdev отдельно, включая special. Алерт на 60 % — это точка, где ещё можно спокойно уменьшить special_small_blocks на самом прожорливом датасете или запланировать замену дисков зеркала на более ёмкие (заменяются по одному через zpool replace, с автоматическим ростом после autoexpand). Алерт на 75 % — это уже «мелочь поехала на HDD, разбирайся сегодня».
- 0,3–1 % от объёма данных — метаданные; точную цифру берите из `zdb -Lbbbs`, а не из статей (включая эту).
- special_small_blocks ставьте заведомо меньше recordsize: 16K или 32K при recordsize=128K — рабочие значения.
- Свойство наследуемое и работает только на новые записи: включили на существующем датасете — старая мелочь останется на HDD.
- Резерв 25 % ёмкости под метаданные — дефолт zfs_special_class_metadata_reserve_pct (man zfs(4) 2.3); без причины не трогайте, а на новых версиях сначала проверьте, что параметр вообще существует.
- Алерты на заполнение special: 60 % — планируем, 75 % — действуем.
Когда я не ставлю special vdev вообще
Половина запросов «поставь нам SSD под метаданные» закрывается без special vdev, и это нормальный исход. Если пул целиком на SSD или NVMe — смысла нет, метаданные и так лежат на флеше. Если данных немного (условно до 10 ТБ) и RAM хватает, чтобы метаданные жили в ARC — дешевле и безопаснее добрать памяти: планка на 64 ГБ стоит меньше пары корпоративных NVMe и никак не влияет на живучесть пула. Смотрите на долю попаданий по метаданным в arcstats, прежде чем что-то покупать.
Если очень хочется ускорить обход каталогов, но не хочется завязывать целостность пула на SSD, есть промежуточный вариант: L2ARC с secondarycache=metadata. Персистентный L2ARC переживает перезагрузку (l2arc_rebuild_enabled), прогревается сам, и — главное — его потеря не стоит вам ничего, кроме прогрева заново. Он медленнее special (промах — это поход на шпиндель, а не гарантированное попадание) и не помогает записи, но для сценария «чтобы ls не тормозил» этого часто достаточно.
zpool add tank cache /dev/disk/by-id/nvme-cache
zfs set secondarycache=metadata tank/share
cat /sys/module/zfs/parameters/l2arc_rebuild_enabled
И про версии, потому что поведение отличается. Ветка 2.4 (2.4.0 вышла в декабре 2025, точечные релизы 2.4.x — по лето 2026) добавила размещение ZIL на special vdev, расширила special_small_blocks на запись zvol и значения не степени двойки, а также сняла запрет на raidz/draid-топологию для самих special и dedup vdev (PR #17496). Последнее не отменяет правила избыточности: под RAIDZ2 я по-прежнему ставлю трёхстороннее зеркало — оно проще в attach/replace и быстрее на мелкой случайной записи; параллельно живут ветки 2.3.x и 2.2.x, и в проде я до сих пор чаще всего вижу именно 2.2.x из репозиториев Debian и сборок TrueNAS. Перед тем как копировать команды из любой статьи, выполните zfs version и сверьтесь с man своей версии, а не с master-веткой документации.
Итоговый порядок действий, если вы всё-таки решились: посчитать метаданные через zdb, взять корпоративные NVMe с запасом по объёму, собрать зеркало (два диска — минимум, три — для RAIDZ2 по букве документации), добавить, перегнать данные, включить мониторинг заполнения и SMART. И зафиксировать в документации, что пул теперь нельзя обслуживать «как раньше»: special с него не снимается.
- Пул целиком на SSD — special не нужен.
- Мало данных и хватает RAM под ARC — добавьте памяти, это дешевле и безопаснее.
- Нужна только скорость чтения метаданных без риска для пула — L2ARC с secondarycache=metadata.
- Нужна скорость записи метаданных и мелких блоков, есть бюджет на зеркало и готовность к необратимости — special vdev.
- Нет бюджета на второй диск под special — не делайте вообще ничего, это самый безопасный из вариантов.
Частые вопросы
Я уже добавил один SSD как special к RAIDZ2. Пул надо пересоздавать?
Нет. Выполните `zpool attach tank <текущий-special-диск> <новый-диск>` — одиночное устройство превратится в зеркало онлайн, с ресилвером на несколько минут или десятков минут. Пересоздание понадобится только если вы хотите вообще убрать special: на пуле с raidz-vdev удаление top-level vdev не поддерживается (man zpool-remove(8)).
Что будет, если special vdev заполнится под завязку?
Ничего страшного: новые аллокации, предназначенные для special class, начнут уходить в normal class, то есть на обычные диски. Производительность постепенно вернётся к исходной, данные не теряются и пул не деградирует. Мелкие блоки данных перестают приниматься раньше — при заполнении примерно на 75 %, потому что четверть ёмкости по умолчанию зарезервирована под метаданные (zfs_special_class_metadata_reserve_pct=25 в ветке 2.3; на своей версии проверьте параметр в /sys/module/zfs/parameters).
Двухстороннего зеркала под RAIDZ2 достаточно или нужно трёхстороннее?
По букве документации — трёхстороннее: избыточность special не должна быть ниже избыточности обычных vdev, а RAIDZ2 переживает два отказа. На практике большинство живёт на двухстороннем, и при корпоративных NVMe с PLP, проверенном бэкапе и быстром восстановлении я считаю это допустимым компромиссом. Если пул — единственная копия данных или восстановление займёт сутки и больше, берите три диска.
Почему после добавления special vdev почти ничего не ускорилось?
Потому что special получает только новые записи. Существующие метаданные остаются там, где были записаны, — на шпинделях. Нужно перезаписать данные: `zfs send | zfs recv` в новый датасет или `zfs rewrite` в свежих ветках OpenZFS. До перезаписи вы увидите эффект только на новых файлах.
Чем special vdev отличается от L2ARC с secondarycache=metadata?
L2ARC — кэш: его потеря не влияет на целостность пула, промах просто уводит запрос на диски. Special vdev — основное хранилище: там лежит единственный экземпляр метаданных, и его потеря означает потерю всего пула. Special быстрее и ускоряет в том числе запись, L2ARC безопаснее. Если задача — «чтобы ls и обход каталогов не тормозили», начните с L2ARC и ARC.
Можно ли расширить special vdev, если места стало мало?
Добавить второй special vdev в пул можно, но правильнее заменить диски зеркала на более ёмкие по одному через `zpool replace` с включённым autoexpand — так вы не плодите точки отказа. Поэтому объём под special берут с запасом сразу: подрасти по месту потом заметно сложнее, чем добавить обычный vdev.
Источники
- OpenZFS Docs — Special vdev — Basic Concepts → Pool Structure → Special vdev: порядок размещения (DDT, метаданные, indirect-блоки, small blocks), требование «A special vdev must be at least as redundant as the pool's normal vdevs», «Never add one as a single device to a redundant pool», «Losing it loses the pool», порог приёма мелких блоков 100 − zfs_special_class_metadata_reserve_pct (75 % по умолчанию), «on a raidz pool, a special vdev can never be removed». https://openzfs.github.io/openzfs-docs/Basic%20Concepts/Pool%20Structure/Special%20vdev.html
- man zpoolconcepts(7), OpenZFS master — Раздел «Special Allocation Class» (master): «Allocations in the special class are dedicated to specific block types. By default, this includes all metadata, the indirect blocks of user data, intent log (in absence of separate log device), and deduplication tables»; «The redundancy of this device should match the redundancy of the other normal devices in the pool»; при заполнении аллокации «spill back into the normal class». https://openzfs.github.io/openzfs-docs/man/master/7/zpoolconcepts.7.html
- man zpool-remove(8), OpenZFS — «Top-level vdevs can only be removed if the primary pool storage does not contain a top-level raidz or draid vdev, all top-level vdevs have the same ashift size, and the keys for all encrypted datasets are loaded». https://openzfs.github.io/openzfs-docs/man/master/8/zpool-remove.8.html
- man zpool-add(8), OpenZFS master — Ключ -f: «Forces use of vdevs, even if they appear in use, have conflicting ashift values, or specify a conflicting replication level»; ключ -n (dry-run); --allow-replication-mismatch. https://openzfs.github.io/openzfs-docs/man/master/8/zpool-add.8.html
- man zfsprops(7) — special_small_blocks — «Blocks smaller than or equal to this value after compression and encryption will be assigned to the special allocation class»; допустимые значения 0 … 16 MiB, значение по умолчанию 0; перед установкой свойства special vdev должен быть добавлен в пул. https://openzfs.github.io/openzfs-docs/man/master/7/zfsprops.7.html
- man zfs(4) — модульные параметры — zfs_ddt_data_is_special=1 и zfs_user_indirect_is_special=1 (master); zfs_special_class_metadata_reserve_pct=25 % описан в ветке 2.3; l2arc_rebuild_enabled — persistent L2ARC. https://openzfs.github.io/openzfs-docs/man/master/4/zfs.4.html и https://openzfs.github.io/openzfs-docs/man/v2.3/4/zfs.4.html
- OpenZFS 2.4.0 — release notes — Релиз 2.4.0 (18 декабря 2025): «Allow ZIL on special vdevs when available», расширение special_small_blocks на запись zvol и значения не степени двойки, «Relax topology restrictions on special/dedup vdevs» (#17496), ключ -P у zfs rewrite; Linux 4.18–6.18, FreeBSD 14/15/16. https://github.com/openzfs/zfs/releases/tag/zfs-2.4.0
- Klara Systems — Understanding ZFS vdev Types — Обзорная статья по типам vdev (normal, special, dedup, log, cache, spare) и различию между кэширующими и обязательными vdev. https://klarasystems.com/articles/openzfs-understanding-zfs-vdev-types/