
Я поменял recordsize в ZFS — а файлы остались прежними. И zfs rewrite это не чинит
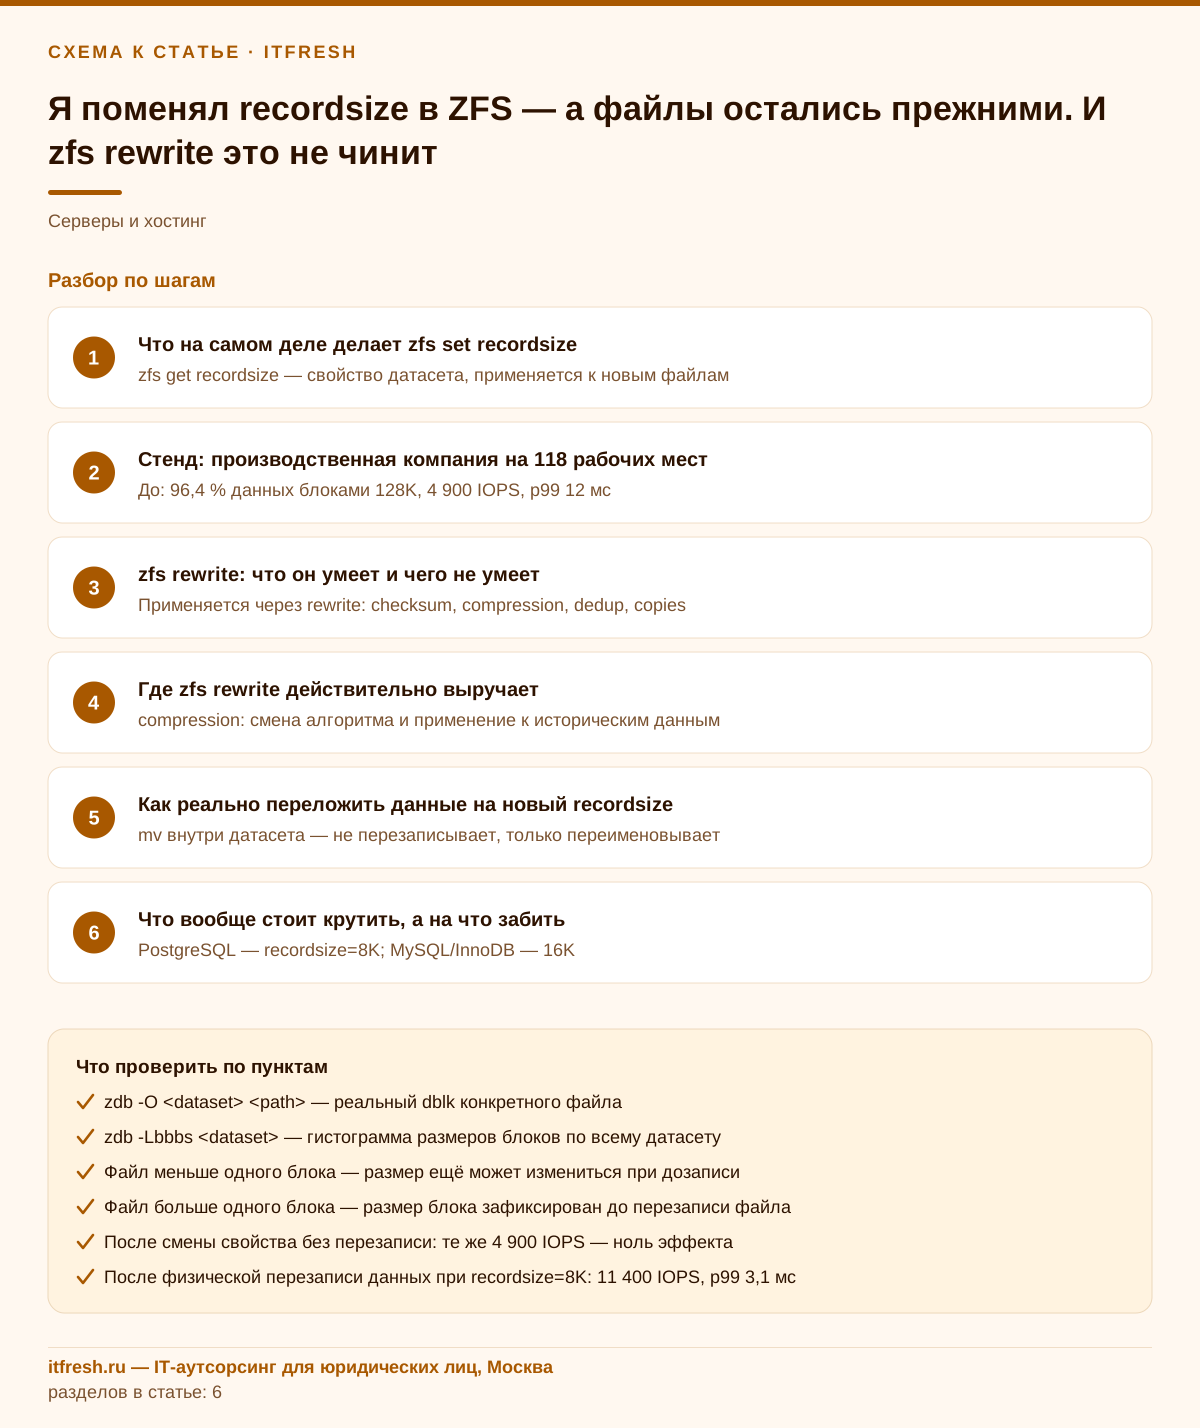
Знакомая сцена: админ вычитал, что для PostgreSQL нужен recordsize=8K, выполнил zfs set, прогнал fio — и получил ровно те же цифры, что были. Дальше начинается самое дорогое: «значит, дело в дисках», «значит, нужен NVMe», «значит, надо докупать память под ARC». А дело не в железе. Дело в том, что recordsize описывает будущее, а не прошлое. Разберу на своём стенде, что именно происходит с блоками, почему подкоманда zfs rewrite здесь не спасает (и в каких случаях всё-таки спасает), и как переложить существующие данные на новый размер блока без сюрпризов с местом в пуле.
Что на самом деле делает zfs set recordsize
Короткий ответ, ради которого половина читателей сюда и пришла: recordsize — это не «размер блока датасета». Это верхняя граница размера логического блока для файлов, которые будут созданы после того, как вы выполнили zfs set. Уже лежащие на диске файлы не переразбиваются. Никогда. Ни через час, ни после скраба, ни после ребута, ни после экспорта и импорта пула. Формулировка в мануале предельно однозначная: «Changing the file system's recordsize affects only files created afterward; existing files are unaffected».
Механика такая. Размер блока конкретного файла определяется в момент, когда файл впервые получает данные. Пока файл целиком помещается в один блок, ZFS хранит его одним блоком ближайшей вверх степени двойки (не меньше размера сектора, заданного ashift), и этот размер ещё может подрасти при дозаписи. Но как только файл перерос один блок — размер блока для него фиксируется навсегда и равен текущему recordsize датасета. Файл на 4 ГБ, записанный при recordsize=128K, так и останется набором 128-килобайтных блоков, даже если вы завтра поставите датасету 1M, а послезавтра 16K.
Отсюда вытекает главная диагностическая привычка, которую я вбиваю всем, кто трогает ZFS: не верьте выводу zfs get. Он показывает свойство датасета, то есть намерение, а не факт на диске. Факт показывает zdb. Смотрите на колонку dblk — это реальный размер блока данных объекта. Учтите, что статистика блоков через zdb -b обходит пул и на больших пулах идёт долго: запускайте её в спокойное время.
# Что заявлено на датасете (намерение)
zfs get -o property,value recordsize tank/pgdata

# Что реально у конкретного файла (факт); путь — относительно корня датасета
zdb -O tank/pgdata base/16401/2613
#   Object  lvl   iblk   dblk  dsize  dnsize  lsize   %full  type
#      117    3   128K   128K  1.02G     512  1.02G  100.00  ZFS plain file
#                        ^^^^ вот это и есть правда

# Список объектов датасета с колонкой dblk
zdb -dd tank/pgdata | head -40

# Гистограмма размеров блоков (статистика по пулу)
zdb -Lbbbs tank | grep -A30 'Block Size Histogram'- zfs get recordsize — свойство датасета, применяется к новым файлам
- zdb -O <dataset> <path> — реальный dblk конкретного файла
- zdb -dd <dataset> — таблица объектов датасета с реальным dblk; zdb -Lbbbs <pool> — гистограмма размеров блоков
- Файл меньше одного блока — размер ещё может измениться при дозаписи
- Файл больше одного блока — размер блока зафиксирован до перезаписи файла
Стенд: салон красоты на 23 рабочих места
Возьму случай из практики, клиента назову условно — салон красоты «Грация», 23 рабочих места: администраторы на ресепшене, мастера с планшетами для записи, бухгалтер и управляющая. Учёт — 1С:УНФ на PostgreSQL, база на момент разбора 42 ГБ, рядом на том же пуле — фотоархив работ мастеров и сканы договоров примерно на 900 ГБ. Сервер скромный: один Xeon E-2336, 64 ГБ RAM, четыре SATA SSD по 1,92 ТБ в двух зеркалах (не raidz — под базу я raidz не ставлю, на мелкой случайной записи паритет съедает всё преимущество). Гипервизор Proxmox VE 9 с ZFS из ветки 2.3, ashift=12.
Датасет tank/pgdata создавался три года назад по умолчанию, то есть с recordsize=128K. Жалоба типовая: «вечером, когда администраторы закрывают смену и сверяют кассу, 1С встаёт колом, отчёт по выручке мастеров считается полторы минуты». Приходящий админ к моменту нашего подключения уже прочитал пару статей, выставил zfs set recordsize=8K tank/pgdata, перезапустил postgresql, прогнал fio — и получил на случайном чтении блоками 8K те же 3 800 IOPS и p99 около 14 мс, что и до правки. Вывод, который он озвучил владелице: «SATA SSD не тянут, нужен новый сервер с NVMe, это около трёхсот пятидесяти тысяч».
Первое, что я сделал — не полез в fio, а посмотрел zdb. По объектам датасета картина была однозначной: 95,8 % данных лежит блоками по 128K, а 8-килобайтные блоки — жалкие 4,2 %, то, что успело дописаться за неделю после правки свойства. Настройка была сделана правильная, но физически не могла ни на что повлиять: PostgreSQL читает страницами по 8 КБ, а ZFS для каждой такой страницы поднимала с диска, распаковывала и проверяла контрольную сумму 128-килобайтного блока. Классическая read amplification в шестнадцать раз, которая ещё и ARC засоряет — в кэш попадают 128K ради 8K полезных.
Дальше — эксперимент, чтобы цифра была не теоретическая. Создал соседний датасет tank/pgdata_new с recordsize=8K, перелил туда базу через pg_basebackup (данные записались заново, с нуля), переключил кластер. Тот же fio на том же железе: 8 900 IOPS на случайном чтении, p99 упал до 3,8 мс. Отчёт по выручке, на который жаловались, стал считаться за 20–25 секунд вместо полутора минут. Новый сервер не понадобился: ушло около двух часов работы плюс ночное окно после закрытия салона на переключение.
- До: 95,8 % данных блоками 128K, 3 800 IOPS, p99 14 мс
- После смены свойства без перезаписи: те же 3 800 IOPS — ноль эффекта
- После физической перезаписи данных при recordsize=8K: 8 900 IOPS, p99 3,8 мс
- Отчёт по выручке мастеров в 1С: ~90 секунд → 20–25 секунд
- Стоимость решения: пара часов работ и ночное окно вместо нового сервера
zfs rewrite: что он умеет и чего не умеет
Теперь про подкоманду, ради которой многие и открывают такие статьи. zfs rewrite появилась в выпуске OpenZFS 2.3.4 (25 августа 2025 года), автор — iXsystems. Идея простая и очень нужная: перезаписать блоки файла «как есть», без изменения содержимого, в новом месте и, возможно, с новыми свойствами — как если бы их атомарно прочитали и записали обратно. До неё единственным способом применить новые свойства к старым данным была ручная копия файлов, со всеми вытекающими проблемами прав, xattr, жёстких ссылок и открытых дескрипторов.
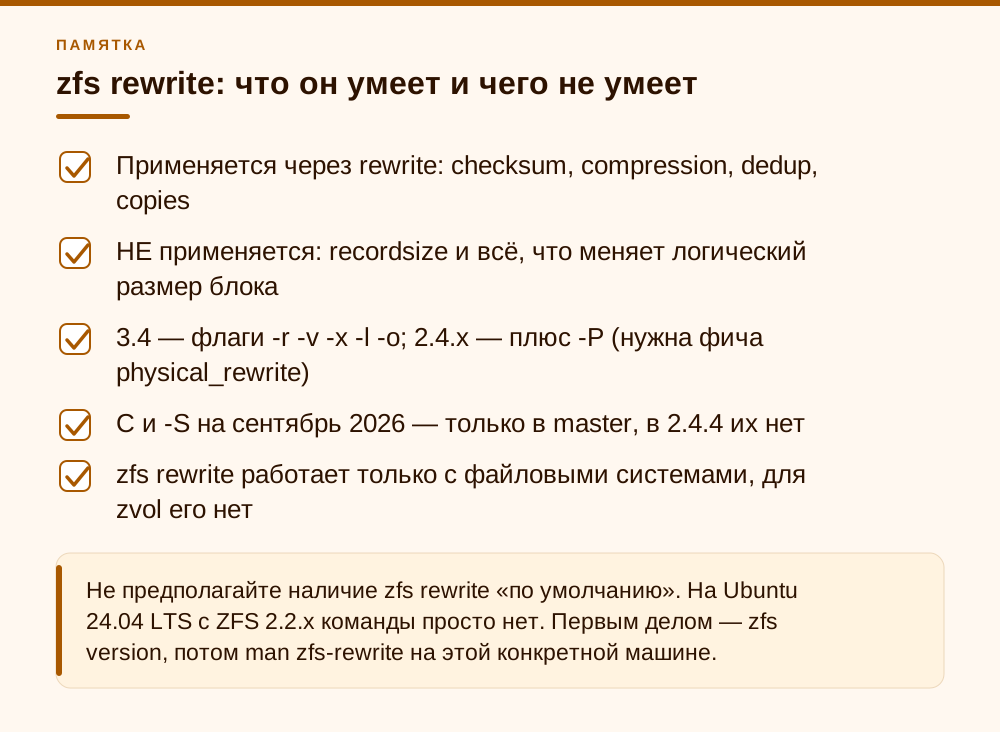
Но вот ключевая фраза из мануала, которую пропускают: «Rewrite works by replacing an existing block with a new block of the same logical size». Того же логического размера. Дальше мануал перечисляет, что применится: checksum, compression, dedup и copies — потому что все они работают над данными и метаданными, не меняя логический размер блока. И отдельной строкой: «Changes to properties that affect the size of a logical block, like recordsize, will have no effect».
То есть на вопрос «поможет ли zfs rewrite после смены recordsize» ответ ровный и без оговорок: нет. Не поможет. Команда честно отработает, потратит IO, поднимет счётчик записанных байт, обновит время рождения блоков — и оставит вам ровно те же 128K. Я специально проверял на копии базы салона: прогнал zfs rewrite -rv по каталогу с базой на исходном датасете, потом zdb — гистограмма не изменилась ни на процент.
Второй важный момент — набор флагов зависит от версии, и это не косметика. В 2.3.4 их было пять: -r, -v, -x, -l, -o. В ветке 2.4 (актуальный стабильный выпуск на сентябрь 2026 — 2.4.4 от 21 августа 2026) добавился -P: физическая перезапись с сохранением logical birth time, чтобы переписанные блоки не улетали целиком в следующий инкрементальный zfs send. Он опирается на фичу пула physical_rewrite (com.truenas:physical_rewrite), которая становится active при первом использовании -P. Флаги -C (пропускать блоки, разделяемые через block cloning) и -S (пропускать блоки, разделяемые со снапшотами) на момент написания есть в master, но в 2.4.4 их ещё нет — не рассчитывайте на них заранее, проверяйте man на своей машине.
- Применяется через rewrite: checksum, compression, dedup, copies
- НЕ применяется: recordsize и всё, что меняет логический размер блока
- 2.3.4 — флаги -r -v -x -l -o; 2.4.x — плюс -P (нужна фича physical_rewrite)
- -C и -S на сентябрь 2026 — только в master, в 2.4.4 их нет
- zfs rewrite работает только с файловыми системами, для zvol его нет
Где zfs rewrite действительно выручает
Я не хочу, чтобы после предыдущего раздела сложилось впечатление, что команда бесполезная. Она отличная — просто её область применения другая. Самый частый мой сценарий: включили на датасете compression=zstd-3 вместо старого lz4 (или вообще вместо off), и надо, чтобы это подействовало на терабайт уже лежащего архива. Раньше это была ночная возня со скриптом на find и cp во временный файл с последующим mv, с риском потерять права и xattr. Сейчас это одна команда.
# Проверяем версию — команда есть с 2.3.4
zfs version

# Меняем свойство
zfs set compression=zstd-3 tank/archive

# Применяем к уже лежащим данным, рекурсивно, без выхода за точку монтирования
zfs rewrite -rvx /tank/archive

# Смотрим, что получилось
zfs get -o property,value compressratio,used,logicalused tank/archive
Второй сценарий — миграция на special vdev. Добавили в пул зеркало из NVMe под метаданные и мелкие блоки, выставили special_small_blocks=32K. Свойство работает только для новых записей: уже записанные мелкие блоки файлов остаются на медленных дисках. rewrite перезаписывает блоки файлов, и те, что попадают под порог special_small_blocks, при перезаписи размещаются в special-классе. Оговорюсь честно: это не полная миграция метаданных. Команда работает с блоками данных файлов, а не с объектами пула целиком, поэтому ждать «100 % метаданных на NVMe» я бы не стал — результат надо мерить zdb -Lbbbs с разбивкой по классам, а не на глаз.
Третий — смена checksum на sha256/blake3 или добавление copies=2 на критичном датасете. И четвёртый, более редкий: дефрагментация в узком смысле — перенос блоков в новое место, чтобы разгрузить перекошенный по заполнению vdev после zpool add. Здесь rewrite тоже честно делает свою работу, потому что логический размер блоков не меняется.
- compression: смена алгоритма и применение к историческим данным
- checksum: переход на sha256/blake3 без пересоздания датасета
- copies: поднять число копий для важного датасета
- dedup: применить/снять дедупликацию к уже записанному
- special_small_blocks: перетащить метаданные и мелкие блоки на NVMe (частично)
Как реально переложить данные на новый recordsize
Способ ровно один: физически перезаписать файлы. Но в деталях сидят три ловушки, на которых я видел, как люди теряют целые ночные окна впустую.
Ловушка первая — mv внутри одного датасета. Это переименование, метаданные, ноль записанных блоков данных. Ловушка вторая, самая коварная и новая: cp на современных ядрах по умолчанию идёт с --reflink=auto, а ZFS с 2.2 умеет block cloning через ioctl FICLONE, и в 2.3 модульный параметр zfs_bclone_enabled по умолчанию единица. Итог: cp внутри пула создаёт клон, ссылающийся на те же самые блоки, и вы получаете новый файл со старым размером блока. Работа выполнена, эффект нулевой. Обязательно --reflink=never. Ловушка третья — zfs send | zfs recv. Репликация идёт поблочно и не пересобирает блоки под recordsize приёмника: 128K останутся 128K, мелкие блоки не склеятся в крупные. Единственное исключение работает в обратную сторону: без флага -L блоки крупнее 128K при отправке режутся до 128K — так случайно можно «потерять» recordsize=1M на архиве, но уменьшить 128K до 8K так нельзя.
# 1. Новый датасет с нужным recordsize
zfs create -o recordsize=8K -o compression=lz4 tank/pgdata_new

# 2. Перелив с ОБЯЗАТЕЛЬНЫМ отключением reflink
cp -a --reflink=never /tank/pgdata/. /tank/pgdata_new/
#   либо rsync — но БЕЗ --inplace, чтобы файл создавался заново
rsync -aHAX --numeric-ids /tank/pgdata/ /tank/pgdata_new/

# 3. Проверяем факт, а не намерение
zdb -dd tank/pgdata_new | head -40

# 4. Переключаем и убираем старое
zfs set mountpoint=/tank/pgdata_old tank/pgdata
zfs set mountpoint=/tank/pgdata     tank/pgdata_new
Про rsync отдельно: ключ --inplace здесь враг. Он пишет в существующий файл, а у существующего файла размер блока уже зафиксирован — получите тот же нулевой результат, что и с dd conv=notrunc. Файл должен быть создан заново. И ещё: если данные лежат под СУБД, я предпочитаю не копировать файлы датафайлов вообще, а делать штатный дамп-восстановление или pg_basebackup на новый датасет. Дешевле по нервам и заодно даёт свежую статистику и чистые индексы.
- mv внутри датасета — не перезаписывает, только переименовывает
- cp без --reflink=never — может склонировать блоки и не изменить ничего
- rsync --inplace, dd conv=notrunc — пишут в существующий файл, размер блока не меняется
- zfs send | zfs recv — поблочно, под recordsize приёмника не пересобирает (без -L лишь режет блоки >128K до 128K)
- Рабочий путь: новый датасет + cp -a --reflink=never / rsync без --inplace / штатный дамп СУБД
Что вообще стоит крутить, а на что забить
Мой практический приоритет такой. Первое и единственное, ради чего стоит вообще заводиться с recordsize — это датасеты под СУБД и под образы виртуальных машин. Там разница действительно кратная, и я её каждый раз вижу в замерах. PostgreSQL работает страницами по 8 КБ — ставлю 8K. MySQL/InnoDB работает страницами по 16 КБ — ставлю 16K. Под qcow2-образы виртуалок 64K обычно оптимальнее дефолта. Под холодные архивы и крупные медиафайлы вроде фотоархива салона, наоборот, имеет смысл поднимать до 1M: меньше метаданных, лучше коэффициент сжатия, выше линейная скорость. А вот файловую базу 1С (.1CD) я до 1M не поднимаю: там случайный доступ к страницам внутри большого файла, и крупный блок даст ту же read amplification — оставляю дефолт или подбираю замером.
Второе — на что можно спокойно забить. Файлопомойка с офисными документами, обменники, каталоги профилей, бэкап-репозитории с большими файлами: дефолтные 128K там ведут себя нормально, и разницу вы, скорее всего, не измерите вообще. Тратить ночное окно на перелив терабайтов ради теоретического выигрыша — плохая сделка. Максимум recordsize=1M на архивный датасет при его создании, и то в первую очередь ради сжатия и уменьшения объёма метаданных.
И важная оговорка про мелкий recordsize: он не бесплатный. При 8K сжатие работает хуже (zstd на 8 КБ данных выжимает заметно меньше, чем на 128 КБ), метаданных становится больше, объём указателей растёт, требования к ARC под dnode и indirect-блоки растут тоже. Ставить 8K «на всякий случай» на весь пул — типичная ошибка людей, прочитавших одну статью про базы. Разносите нагрузки по разным датасетам, у каждого свой recordsize; в одном пуле это ничего не стоит.
Отдельная тема — zvol. Там свойство называется volblocksize, по умолчанию с версии 2.2 оно равно 16 КБ, задаётся при создании тома и потом не меняется вообще никак. И zfs rewrite к zvol неприменим: разработчики прямо говорят, что команда пока только для файловых систем, технических препятствий расширить её нет, но и планов тоже. Значит, у zvol единственный путь — создать новый том с нужным volblocksize и перелить данные внутри гостевой ОС или через dd.
- PostgreSQL — recordsize=8K; MySQL/InnoDB — 16K
- Образы ВМ (qcow2, raw на файловой системе) — 64K
- Архивы, фото и видео, крупные неизменяемые файлы — 1M (файловые базы 1С — не 1M, там случайный доступ)
- Общий файловый ресурс, профили, обменники — оставьте дефолтные 128K
- zvol: volblocksize задаётся только при создании, rewrite не применим
Грабли, о которые бьются чаще всего
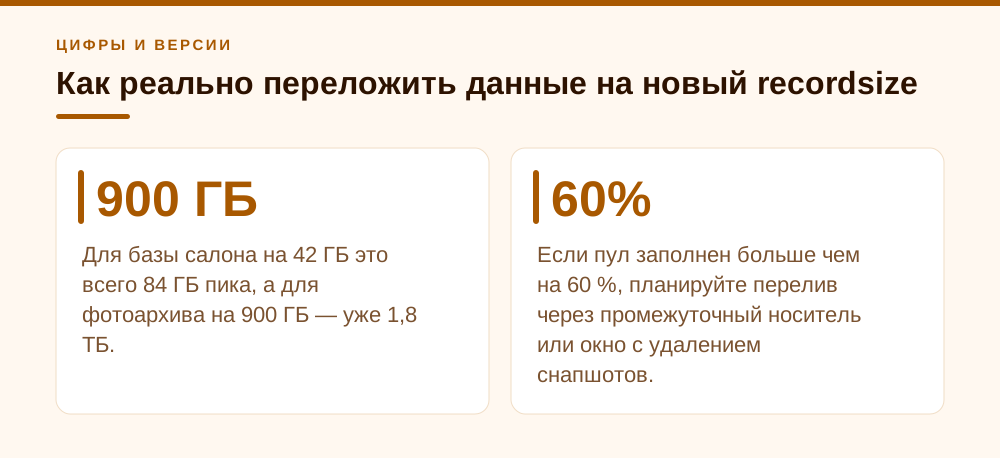
Снапшоты. Любой rewrite или перелив данных при живых снапшотах означает, что старые блоки останутся живы столько, сколько живёт самый старый снапшот. Фотоархив на 900 ГБ с месячной глубиной снапшотов после полной перезаписи легко превращается в 1,8 ТБ занятого места, и это не утечка, это ровно то, что вы попросили. Перед крупной перезаписью я либо чищу снапшоты, либо считаю место с запасом и предупреждаю клиента, что used временно вырастет вдвое.
Инкрементальная репликация. По умолчанию rewrite обновляет logical birth time блоков, и они считаются изменёнными. Следующий инкрементальный zfs send после rewrite по терабайтному датасету уедет на приёмник целиком. Если канал до резервной площадки узкий — это авария на сутки. Ровно для этого в 2.4.0 добавили -P: он сохраняет logical birth time, и переписанные блоки не попадают в инкремент. Цена — фича пула physical_rewrite: после первого -P она становится active и возвращается в enabled только когда уничтожены все датасеты, где её применяли. Фича помечена как read-only compatible, то есть ZFS без её поддержки сможет импортировать такой пул только на чтение. Если пул может понадобиться поднять на старой системе для восстановления — взвешивайте.
Версии и дистрибутивы. Проверяйте zfs version на конкретной машине, а не в вики дистрибутива. Ubuntu 24.04 LTS едет на 2.2.x — rewrite там нет. Proxmox VE 9 привёз ветку 2.3, где команда уже есть. TrueNAS SCALE свежих релизов идёт на 2.3+. Актуальный стабильный OpenZFS на сентябрь 2026 — 2.4.4. И помните, что man на вашей машине — источник истины важнее любой статьи, включая эту: набор флагов между 2.3.4, 2.4.4 и master различается.
И последнее, методологическое. Любую правку свойства ZFS проверяйте через zdb до и после, а замеры производительности делайте на данных, которые реально прошли через новое свойство. Иначе вы измеряете прошлое и принимаете по нему решения о закупке железа. Именно этот механизм — «настройка сделана, эффекта нет, значит нужно железо» — я вижу в чужих инфраструктурах чаще, чем любые реальные аппаратные проблемы.
- zfs version — есть ли вообще rewrite на этой машине (нужна 2.3.4+)
- zdb -dd <dataset> и zdb -Lbbbs <pool> — снимок размеров блоков ДО работ
- zfs list -t snapshot — что удержит старые блоки и сколько это стоит
- zpool list -o name,size,alloc,free,cap — хватит ли места на удвоение
- Расписание репликации — поставить на паузу, если rewrite идёт без -P
- zdb -dd / zdb -Lbbbs — снимок ПОСЛЕ и только затем повторный замер fio
Частые вопросы
Поможет ли zfs rewrite применить новый recordsize к старым файлам?
Нет. Мануал zfs-rewrite(8) говорит прямо: команда заменяет блок новым блоком того же логического размера, поэтому изменения свойств, влияющих на логический размер блока (в частности recordsize), эффекта не дают. Команда отработает без ошибок, потратит IO, но гистограмма блоков в zdb останется прежней. Единственный способ — физическая перезапись файлов на датасете с новым recordsize.
С какой версии OpenZFS доступна подкоманда zfs rewrite?
С выпуска 2.3.4 (25 августа 2025 года). В более старых установках её просто нет — например, на Ubuntu 24.04 LTS с ZFS 2.2.x. Проверяйте командой zfs version на конкретной машине. Учтите также, что набор флагов рос: в 2.3.4 доступны -r, -v, -x, -l, -o; флаг -P (сохранение logical birth time, использует фичу пула physical_rewrite) появился в 2.4.0; флаги -C и -S на сентябрь 2026 есть только в master.
Какие свойства zfs rewrite всё-таки применяет к уже записанным данным?
Те, что работают с данными и метаданными, не меняя логический размер блока: checksum, compression, dedup и copies. Это делает команду отличным инструментом для смены алгоритма сжатия на историческом архиве, перехода на blake3, включения второй копии на критичном датасете или частичного переноса метаданных на special vdev после его добавления.
Почему я скопировал файлы через cp, а размер блока не изменился?
Скорее всего, сработал block cloning. Современный cp по умолчанию использует --reflink=auto, ZFS начиная с 2.2 поддерживает ioctl FICLONE, а в 2.3 параметр zfs_bclone_enabled по умолчанию равен единице. В результате копия ссылается на те же самые блоки старого размера. Копируйте с явным cp -a --reflink=never либо используйте rsync без ключа --inplace.
Изменится ли размер блока, если сделать zfs send | zfs recv на новый датасет?
Нет, если речь об уменьшении или «выравнивании» блоков под recordsize приёмника. Репликация идёт поблочно: датасет создан с recordsize=8K, данные приехали через send, а в zdb по-прежнему 128K. Единственное, что делает send без флага -L, — режет блоки крупнее 128K до 128K, то есть архив с recordsize=1M может приехать 128-килобайтными блоками. Чтобы получить нужный размер блока, данные надо записать заново на уровне файловой системы.
Насколько сильно вырастет занятое место после перезаписи данных?
В худшем случае вдвое от объёма перезаписанного, и держаться это будет столько, сколько живёт самый старый снапшот, удерживающий старые блоки. При переливе через отдельный датасет пик занимаемого места — сумма старого и нового. Планируйте работы, когда пул заполнен не более чем на 60 %, либо предварительно чистите снапшоты.
Источники
- OpenZFS: zfsprops(7), свойство recordsize — Мануал OpenZFS: «Changing the file system's recordsize affects only files created afterward; existing files are unaffected»; о compression — «Changing this property affects only newly-written data»; volblocksize «cannot be changed once the volume has been written». https://openzfs.github.io/openzfs-docs/man/master/7/zfsprops.7.html
- OpenZFS: zfs-rewrite(8) — Мануал OpenZFS, ветка master, раздел NOTES: «Rewrite works by replacing an existing block with a new block of the same logical size… These include checksum, compression, dedup and copies. Changes to properties that affect the size of a logical block, like recordsize, will have no effect». Описание флагов -C, -P, -S, -l, -o, -r, -v, -x. https://openzfs.github.io/openzfs-docs/man/master/8/zfs-rewrite.8.html
- OpenZFS 2.3.4 — Introduce zfs rewrite subcommand — Страница релиза zfs-2.3.4 от 25 августа 2025: строка «Introduce zfs rewrite subcommand (#17246)», совместимость с ядрами Linux 4.18–6.16 и FreeBSD 13.3+. Синопсис в этом теге — только флаги -r -v -x -l -o. https://github.com/openzfs/zfs/releases/tag/zfs-2.3.4
- OpenZFS 2.4.0 — zfs rewrite -P — Страница релиза zfs-2.4.0: «Add zfs rewrite -P which preserves logical birth time when possible to minimize incremental stream size (#17565)». Синопсис ветки 2.4 — zfs rewrite [-Prvx] [-l length] [-o offset], без -C и -S: https://openzfs.github.io/openzfs-docs/man/v2.4/8/zfs-rewrite.8.html . Релиз: https://github.com/openzfs/zfs/releases/tag/zfs-2.4.0
- OpenZFS: zpool-features(7), фича physical_rewrite — Описание фичи com.truenas:physical_rewrite (READ-ONLY COMPATIBLE: yes): сохраняет logical birth time при zfs rewrite -P, становится active при первом применении -P. https://openzfs.github.io/openzfs-docs/man/master/7/zpool-features.7.html
- Klara Systems: Tuning recordsize in OpenZFS — Профильная статья: recordsize по умолчанию 128 KiB, рекомендации 16K для MySQL InnoDB, 8K для PostgreSQL, 64K для qcow2-образов, 1M для общего хранения и крупных файлов; «you must actually re-write the existing files», репликация сохраняет исходные размеры блоков. https://klarasystems.com/articles/tuning-recordsize-in-openzfs/
- OpenZFS Discussion #17841 — How do you use zfs rewrite on volumes — Ответ мейнтейнера robn: «For now, zfs rewrite is only for filesystems. There's no particular technical reason it couldn't be extended to volumes, but I don't know if there are any plans to do so». https://github.com/openzfs/zfs/discussions/17841
- OpenZFS: zfs-send(8), флаг -L — Мануал zfs send: без -L блоки крупнее 128 KiB разбиваются на меньшие при отправке; с -L передаются как есть (приёмнику нужна фича large_blocks). https://openzfs.github.io/openzfs-docs/man/master/8/zfs-send.8.html