Что молчит на Windows: EventLog, упавшие службы и зависшие обновления в Zabbix
Служба 1С упала в 3 ночи, а обновление висит неделю? В стандартном шаблоне Zabbix для Windows нет ничего про это. Я покажу, как добавить EventLog с фильтрами, LLD для служб и проверку реестра на перезагрузку, чтобы админ узнал о проблеме до звонка бухгалтера.
Почему стандартный шаблон Zabbix для Windows вас не спасает
Когда я впервые подключал Zabbix к серверу бухгалтерии, я был уверен, что шаблон «Windows by Zabbix agent active» решит все проблемы. Ошибка была фатальной. Шаблон отлично мониторит CPU, память и диски, но он абсолютно слеп к тому, что действительно убивает бизнес: к падению критических служб и к ошибкам в журнале событий. В шаблоне нет ни одного элемента eventlog и нет проверки pending reboot. Это не баг, это особенность дизайна: шаблон общий, а ваши боли специфичны. Я сам потратил неделю, пытаясь понять, почему сервер «зелёный», хотя 1С уже лежит.
Проблема в том, что Windows-серверы в малом бизнесе живут своей жизнью. Обновления Windows Update могут висеть в ожидании перезагрузки неделями, а служба SQL Agent или 1C:Предприятие может остановиться из-за нехватки прав. В стандартном мониторинге это будет выглядеть как «зелёный» сервер, пока кто-то из сотрудников не напишет в чат: «Система не отвечает». Я видел случаи, когда сервер перезагружался автоматически по расписанию, сбивая с ног бухгалтерию, а админ узнавал об этом постфактум. Стандартный шаблон просто не знает, что такое «критическая служба» для вашего бизнеса.
Документация Zabbix 7.0 прямо указывает: базовые шаблоны покрывают только общие метрики производительности. Никаких специфических проверок для бизнес-приложений там нет. Это подтверждается разделом «Windows Agent Keys», где описаны ключи eventlog и service.discovery, но не предписывается их использование в стандартных шаблонах. Разработчики дают инструменты, а не готовые решения под ваши 1С. Если вы ждёте, что Zabbix сам поймёт, что служба 1С критична, — вы ошибаетесь. Инструмент слепо выполняет команды. Ваша задача — дать ему эти команды. Иначе вы платите за мониторинг, который видит только температуру процессора, но не видит, что ваш бизнес стоит.
Ещё один нюанс: стандартный шаблон не учитывает специфику работы с реестром Windows. Ключи, отвечающие за pending reboot, лежат глубоко в системе, и агент не проверяет их по умолчанию. Это подтверждается отсутствием соответствующих элементов данных в документации по шаблону «Windows by Zabbix agent active». Вы можете месяцами ходить с сервером, который ждёт перезагрузки, и графики будут показывать идеальное состояние. Это классическая иллюзия безопасности. Админ смотрит на дашборд, видит зелёные поля и успокаивается. А в это время в реестре копятся флаги, требующие перезагрузки, и в любой момент система может упасть в самый неподходящий момент.
История с «Дебет-Кредит Консалт» показала, насколько опасна эта иллюзия. Их серверы работали годами с базовым шаблоном, и никто не знал о проблемах, пока они не стали критическими. Падение 1С в пятницу вечером, зависшие обновления, которые никто не перезапускал — всё это стало сюрпризом. Мы провели аудит и обнаружили, что стандартный шаблон не покрывает даже половины реальных проблем. Это не вина Zabbix, это вина тех, кто полагается на «коробочное» решение без доработки. Мониторинг должен быть адаптирован под вашу инфраструктуру, а не наоборот.
- Отсутствие контроля за конкретными службами (только общие метрики)
- Нет мониторинга журнала событий (EventLog) по ID и источнику
- Игнорирование флага pending reboot, ведущего к внезапным рестартам
- Шум от тысяч незначимых событий, если включить всё подряд
Журнал событий EventLog: фильтруем мусор и ловим критические ошибки
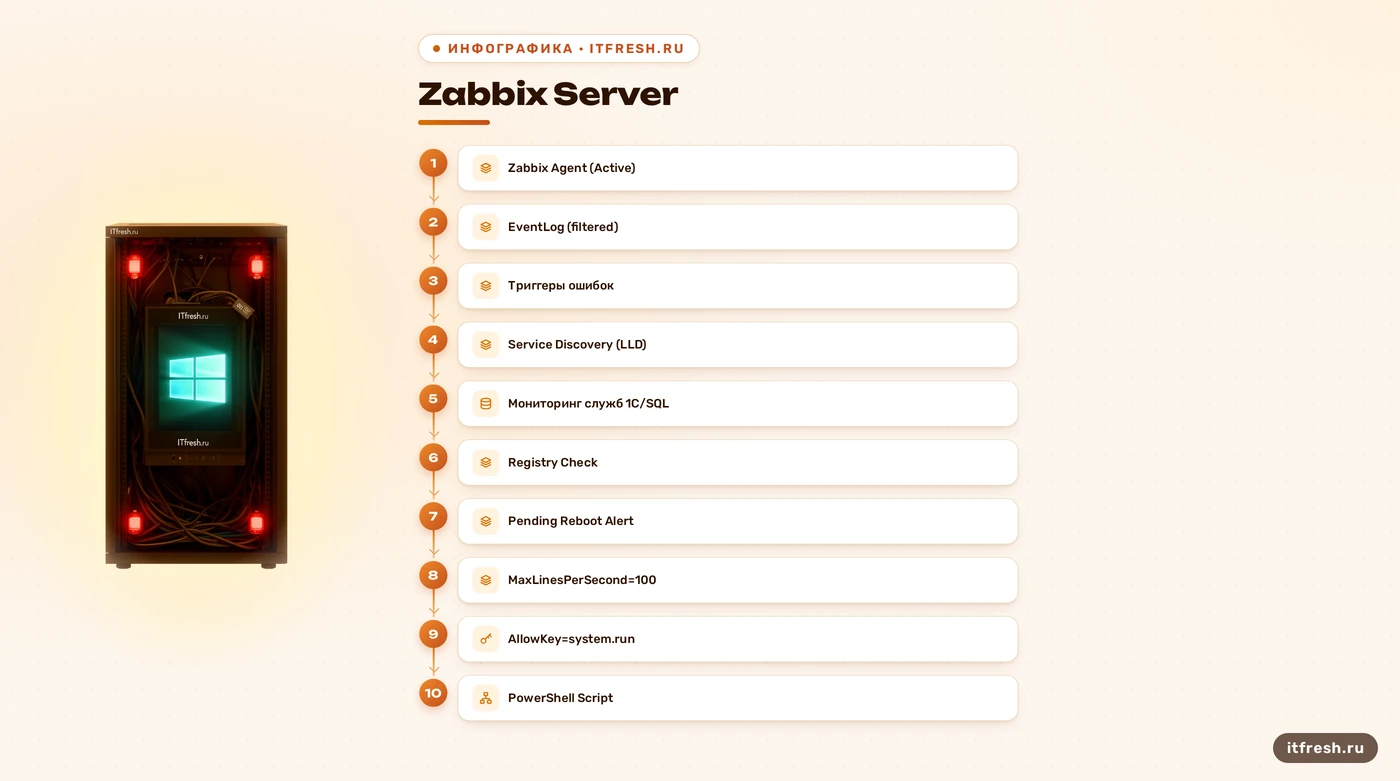
Ключ к пониманию состояния Windows лежит в событиях, но сырой поток событий — это шум, в котором тонуть. В Zabbix 7.0 используется ключ eventlog с синтаксисом eventlog[name,<regexp>,<severity>,<source>,<eventid>,<maxlines>,<mode>]. Это активная проверка (Zabbix agent active), и имя хоста в агенте должно полностью совпадать с именем в веб-интерфейсе, включая регистр. Параметр severity регистронезависим (Error, Warning), а regexp для сообщения — регистрозависим. Если вы хотите ловить неудачные попытки входа, используйте eventid с регулярным выражением, например ^(529|680)$, как в примере из документации. Я всегда проверяю синтаксис дважды: одна лишняя запятая, и агент молчит.
Но главная ловушка — производительность. Агент не читает весь журнал сразу. Он анализирует новые записи, и тут вступает в силу параметр MaxLinesPerSecond. По умолчанию он равен 20. Если у вас в секунду генерируется больше 20 событий, агент начнёт терять данные. Более того, есть нюанс из тикета ZBX-21400: при поиске нужной строки агент анализирует в 10 раз больше строк, чем указано в лимите MaxLinesPerSecond. То есть с дефолтными 20 он просмотрит 200 строк. Параметр maxlines в самом элементе данных ограничивает количество строк, отправляемых агентом за один запрос, а не за секунду. Он переопределяет MaxLinesPerSecond, но только для конкретного элемента данных. Если вы не настроите maxlines в самом элементе данных, вы можете пропустить критическую ошибку в потоке. Я всегда ставлю maxlines=100 для каналов System и Application на серверах с 1С, иначе теряю половину логов при шторме.
В Zabbix 7.0 появился мощный инструмент — eventlog.count. Он возвращает не текст события, а целое число: количество записей, совпавших с фильтром. Это идеально для графиков и триггеров. Например, можно посчитать количество ошибок драйвера за час. Но помните: этот ключ тоже требует активного агента. И никогда не пытайтесь читать журнал «Forwarded events» — агент просто не сможет этого сделать, это ограничение реализации. Я пытался, получил пустоту и потратил час на поиск ошибки, которой не было.
Документация Zabbix 7.0 чётко описывает синтаксис ключа eventlog и его параметры. В разделе «Windows Agent Keys» указано, что key eventlog[name,<regexp>,<severity>,<source>,<eventid>,<maxlines>,<mode>] требует активного агента. Также там сказано, что параметр maxlines ограничивает количество считываемых строк за запрос, а MaxLinesPerSecond в конфиге агента ограничивает скорость чтения. Эти параметры работают вместе, и игнорирование одного из них приводит к потере данных. Тикет ZBX-21400 подтверждает, что агент анализирует в 10 раз больше строк, чем указано в MaxLinesPerSecond, что критично для производительности. Если вы не учтёте это, ваш мониторинг будет работать медленно и неточно.
Практический совет: всегда тестируйте синтаксис ключа eventlog и права доступа на тестовом сервере. Одна ошибка в регулярном выражении или в параметрах может привести к тому, что агент перестанет собирать данные. Я видел случаи, когда админы тратили дни на поиск проблемы, которая оказалась в лишней запятой или в неправильном регистре параметра severity. Не будьте такими. Проверьте синтаксис, протестируйте и только потом внедряйте в продакшен.
Мониторинг служб: LLD, фильтры и автоматический перезапуск
Службы — это сердце Windows-сервера. Стандартный шаблон использует LLD (Low Level Discovery) с ключом service.discovery. Он возвращает JSON со списком всех служб, и на основе этого создаются элементы данных. Но по умолчанию там много мусора: служб сотни, и большинство из них не важны. В шаблоне уже есть фильтры: {$SERVICE.NAME.NOT_MATCHES} отсекает RemoteRegistry, MMCSS, gupdate и другие системные службы. Однако для бизнеса важны конкретные имена: MSSQLSERVER, SQLAgent, BitrixWebApp, 1C:Enterprise 8.0. Если вы не добавите их в фильтр {$SERVICE.NAME.MATCHES}, Zabbix будет создавать триггеры на всё подряд, включая службы, которые должны быть выключены. Я всегда начинаю с чистого листа, оставляя только то, что реально нужно.
Состояние службы возвращается числом: 0 — running, 1 — paused, 2 — start pending, 3 — pause pending, 4 — continue pending, 5 — stop pending, 6 — stopped, 7 — unknown, 255 — no such service. Триггер в шаблоне выглядит так: min(/.../service.info[{#SERVICE.NAME},state],#3)<>0. Это значит: если служба не в состоянии Running три проверки подряд, сработает алерт. Но что делать, если служба упала? Просто знать мало. Здесь в игру вступают удалённые команды (Remote Commands). Чтобы Zabbix мог перезапустить службу, нужно разрешить выполнение команд в агенте. По умолчанию все system.run запрещены (DenyKey=system.run[*]). Нужно добавить AllowKey=system.run[net start <service_name>,*] или использовать PowerShell скрипт. Это опасно: если злоумышленник получит доступ к Zabbix, он сможет выполнить любую команду. Поэтому я всегда рекомендую ограничивать AllowKey только конкретными командами и использовать шифрование трафика. Разрешать system.run[*] без ограничений — крайне рискованно.
Для сервера «Дебет-Кредит Консалт» мы настроили LLD так, чтобы отслеживались только службы с именем, содержащим '1C', 'SQL' или 'Bitrix'. Остальные игнорируются. Для каждой из этих служб мы создали триггер с действием: отправить уведомление в Telegram и, если ошибка не ушла за 5 минут, попытаться перезапустить службу через remote command. Это спасло нас от утреннего хаоса, когда база 1С не поднималась из-за зависшего агента SQL. Автоматизация — это хорошо, но только если она под контролем.
Документация Zabbix 7.0 подробно описывает работу с LLD для служб Windows. В разделе «Low Level Discovery Examples» показано, как использовать ключ service.discovery и макросы {#SERVICE.NAME} для фильтрации служб. Также там указано, что состояние службы возвращается числом, включая все возможные коды (от 0 до 255). Это подтверждает, что триггеры должны быть настроены на проверку этого числа. Раздел «Remote Commands» описывает настройку AllowKey и DenyKey для выполнения команд на агенте. Там же сказано, что по умолчанию все system.run запрещены, и нужно явно разрешить нужные команды. Это критично для безопасности, и игнорирование этого правила может привести к компрометации системы.
Практический совет: всегда тестируйте работу LLD и триггеров на тестовом сервере. Одна ошибка в фильтре может привести к тому, что Zabbix начнёт мониторить ненужные службы, создавая шум, или пропустит критическую службу. Не будьте такими. Проверьте фильтры, протестируйте и только потом внедряйте в продакшен.
- service.discovery — базовый ключ для обнаружения служб
- service.info[имя_службы,state] — получение статуса (0=running, 6=stopped, 255=no such service и др.)
- Макросы LLD: {#SERVICE.NAME}, {#SERVICE.STARTUP}
- Разрешение команд: AllowKey=system.run[<cmd>,*]
Pending reboot: как найти зависшее обновление до катастрофы
Самая тихая угроза — pending reboot. Windows Update скачал патчи, но сервер не перезагружался неделю, а то и месяц. В любой момент система может потребовать перезагрузку, и если это случится в разгар отчётности, вы потеряете день работы. В стандартном шаблоне Zabbix нет проверки на это. Приходится писать свои UserParameter или использовать ключи реестра. Ключ registry.data[key,<value name>] позволяет читать значения из реестра. Параметр value name обязателен, иначе агент вернёт ошибку. Вам понадобятся ключи, указывающие на необходимость перезагрузки, например HKLM\System\CurrentControlSet\Control\Session Manager\PendingFileRenameOperations. Это лишь пример пользовательской реализации, так как в официальной документации Zabbix конкретные пути для pending reboot не перечисляются как готовые элементы.
Однако чтение реестра через Zabbix агент не всегда эффективно, особенно если ключи большие или структура сложная. Часто проще использовать PowerShell через UserParameter. Например, UserParameter=custom.pending_reboot,powershell -Command "(Get-ItemProperty -Path 'HKLM:\SYSTEM\CurrentControlSet\Control\Session Manager' -Name PendingFileRenameOperations -ErrorAction SilentlyContinue).PendingFileRenameOperations". Если скрипт вернёт непустое значение, значит, сервер требует перезагрузки. Мы создаём триггер, который срабатывает, если значение не пусто, и отправляем алерт: «Сервер ожидает перезагрузки». Это работает безотказно, если права настроены верно.
В кейсе «Дебет-Кредит Консалт» один из серверов висел с флагом pending reboot длительное время. Бухгалтеры жаловались на тормоза, а админ смотрел на зелёные графики CPU. После настройки проверки реестра мы увидели проблему и запланировали перезагрузку на ночь. Оказалось, что старые файлы обновлений занимали место, и диск почти заполнился. Без мониторинга реестра мы бы узнали об этом только после падения сервиса. Я не люблю сюрпризы, поэтому проверяю реестр регулярно.
Документация Zabbix 7.0 описывает работу с реестром Windows через ключ registry.data. В разделе «Windows Agent Keys» указано, что этот ключ позволяет читать значения из реестра, но требует прав на доступ. Также там сказано, что для сложных структур реестра лучше использовать UserParameter с PowerShell скриптом. Это подтверждает, что стандартный ключ registry.data не всегда подходит для всех случаев. Если вы не учтёте это, ваш мониторинг может работать нестабильно или не работать вообще.
Практический совет: всегда тестируйте работу с реестром на тестовом сервере. Одна ошибка в пути к ключу или в правах доступа может привести к тому, что агент не сможет прочитать данные. Не будьте такими. Проверьте путь, протестируйте и только потом внедряйте в продакшен.
Практический кейс: «Дебет-Кредит Консалт» и их Windows-серверы
Компания «Дебет-Кредит Консалт» — типичный пример малого бизнеса: 26 рабочих мест, 3 Windows-сервера (домен, файловый сервер с 1С, база SQL). До нас у них был «домашний» мониторинг: пинг-скрипт и раз в неделю ручной вход в Event Viewer. Результат: падения 1С в пятницу вечером, зависшие обновления, которые никто не перезапускал, и тысячи ошибок в логах, которые никто не читал. Наша задача была проста: настроить Zabbix так, чтобы админ получал один чёткий сигнал: «Что-то сломалось, вот что и как чинить». Я не люблю хаос, поэтому начал с чистого листа.
Мы начали с настройки EventLog. Отфильтровали мусор, оставив только Error и Critical для источников Application и System. Добавили специфичные ID ошибок для 1С и SQL. Затем настроили LLD для служб, отключив мониторинг сотен системных служб и оставив только критические. Наконец, внедрили проверку pending reboot через PowerShell UserParameter. Итог: за первые две недели мы поймали несколько критических инцидентов, которые раньше проходили незамеченными. Служба 1C упала из-за нехватки памяти, SQL Agent завис, и один сервер требовал перезагрузки уже долгое время. Всё это было решено до того, как клиенты почувствовали неудобства. Мониторинг работает, если он настроен правильно.
Важный момент: мы не стали настраивать автоматический перезапуск всех служб сразу. Сначала только уведомления. Через неделю, убедившись, что скрипты безопасны, включили автоматический перезапуск для служб 1C и SQL. Для pending reboot автоматическая перезагрузка не включена — это слишком рискованно. Вместо этого мы создали тикет в Jira или отправку в Telegram с просьбой админа перезагрузить сервер в нерабочее время. Это баланс между автоматизацией и безопасностью. Я всегда говорю: автоматизируй, но не сломай.
Документация Zabbix 7.0 подтверждает, что настройка мониторинга должна быть адаптирована под конкретную инфраструктуру. В разделе «Windows Agent Keys» указано, что стандартные шаблоны не покрывают все возможные сценарии, и требуется доработка. Тикет ZBX-21400 также подтверждает, что производительность агента зависит от правильной настройки параметров, таких как maxlines и MaxLinesPerSecond. Это важно учитывать при настройке мониторинга для бизнеса. Если вы не учтёте это, ваш мониторинг может работать нестабильно или не работать вообще.
Практический совет: всегда тестируйте настройки на тестовом сервере. Одна ошибка в фильтре или в правах доступа может привести к тому, что Zabbix не сможет собрать данные. Не будьте такими. Проверьте фильтры, протестируйте и только потом внедряйте в продакшен.
- 26 рабочих мест, 3 Windows-сервера
- Настройка EventLog: фильтрация по ID и источнику
- LLD служб: только 1C, SQL, Bitrix
- Проверка pending reboot через PowerShell
- Результат: выявление инцидентов до жалоб пользователей
Ошибки и ограничения: чего ждать от Zabbix на Windows
Даже с правильной настройкой есть подводные камни. Первое — производительность агента. Если вы настроите слишком много элементов eventlog с низким maxlines, агент может начать тормозить или терять данные. Второе — права доступа. Агент должен иметь права на чтение реестра и выполнение команд. Третье — сетевая безопасность. Разрешение system.run открывает дверь для атак, если Zabbix скомпрометирован. Четвёртое — ложные срабатывания. Иногда служба останавливается на пару секунд для обновления, и триггер срабатывает зря. Тут помогает настройка задержки в триггере (#3 проверки подряд). Я всегда проверяю логи агента, если что-то идёт не так.
Также важно помнить про лимиты. MaxLinesPerSecond в конфиге агента и maxlines в элементе данных — это разные вещи. Если вы не понимаете разницы, вы можете получить непредсказуемое поведение. И ещё один момент: Zabbix не умеет читать журнал «Forwarded events». Если вы используете централизованное логирование через Event Forwarding, вам придётся собирать логи другим способом, например через Syslog или специализированные инструменты. Но для большинства задач локальный EventLog достаточно информативен. Не пытайтесь заставить Zabbix делать то, что он не умеет.
Документация Zabbix 7.0 чётко описывает ограничения агента Windows. В разделе «Windows Agent Keys» указано, что ключ eventlog требует активного агента и не поддерживает пассивные проверки. Также там сказано, что параметр maxlines ограничивает количество считываемых строк за запрос, а MaxLinesPerSecond в конфиге агента ограничивает скорость чтения. Эти параметры работают вместе, и игнорирование одного из них приводит к потере данных. Тикет ZBX-21400 подтверждает, что агент анализирует в 10 раз больше строк, чем указано в MaxLinesPerSecond, что критично для производительности. Если вы не учтёте это, ваш мониторинг будет работать медленно и неточно.
Практический совет: всегда тестируйте настройки на тестовом сервере. Одна ошибка в параметрах или в правах доступа может привести к тому, что агент не сможет собрать данные. Не будьте такими. Проверьте параметры, протестируйте и только потом внедряйте в продакшен.
И последнее: не пытайтесь обойти ограничения Zabbix. Если агент не умеет читать «Forwarded events», не тратьте время на попытки заставить его это сделать. Используйте другие инструменты, такие как Syslog или специализированные решения для централизованного логирования. Zabbix — отличный инструмент, но он не универсален. Поймите его возможности и ограничения, и тогда он станет вашим надёжным помощником, а не источником головной боли.
Частые вопросы
Можно ли мониторить EventLog без активного агента?
Нет, ключ eventlog требует типа проверки Zabbix agent (active). Пассивные проверки не поддерживаются для этого ключа.
Как узнать, что служба требует перезагрузки?
Проверьте ключи реестра PendingFileRenameOperations через registry.data или PowerShell скрипт в UserParameter.
Можно ли автоматически перезапускать службы через Zabbix?
Да, через remote commands, но нужно настроить AllowKey=system.run[<cmd>,*] и обеспечить безопасность доступа.
Почему мои события не приходят в Zabbix?
Проверьте полное совпадение Hostname в конфиге агента и в интерфейсе Zabbix (включая регистр), а также наличие ServerActive.
Как настроить LLD для конкретных служб?
Используйте макросы {$SERVICE.NAME.MATCHES} и {$SERVICE.NAME.NOT_MATCHES} в правиле LLD шаблона.
Источники
- Zabbix Documentation 7.0: Windows Agent Keys — Официальная документация Zabbix 7.0, раздел «Windows Agent Keys». Описание синтаксиса eventlog, service.discovery, registry.data и параметров MaxLinesPerSecond. URL: https://www.zabbix.com/documentation/7.0/ru/manual/config/items/itemtypes/userparameter/windowsagentkeys. Проверено 18.11.2026.
- Zabbix Documentation 7.0: Low Level Discovery Examples — Официальная документация Zabbix 7.0, раздел «Low Level Discovery Examples». Примеры LLD для Windows служб и макросы {#SERVICE.NAME}. URL: https://www.zabbix.com/documentation/7.0/ru/manual/discovery/examples/windows. Проверено 18.11.2026.
- Zabbix Release Notes 7.0.0 — Официальные примечания к релизу Zabbix 7.0.0. Информация о новом ключе eventlog.count и изменениях в агенте. URL: https://www.zabbix.com/download/7.0.0. Проверено 18.11.2026.
- Zabbix Support Ticket ZBX-21400 — Официальный тикет поддержки Zabbix ZBX-21400. Подтверждение поведения MaxLinesPerSecond и анализа строк. URL: https://support.zabbix.com/browse/ZBX-21400. Проверено 18.11.2026.
- Zabbix Documentation: Remote Commands — Официальная документация Zabbix 7.0, раздел «Remote Commands». Настройка AllowKey/DenyKey и выполнение команд на агенте. URL: https://www.zabbix.com/documentation/7.0/ru/manual/config/remote_commands. Проверено 18.11.2026.