
Как снизить нагрузку Zabbix и не потерять важные события
Zabbix сам по себе не обязан тормозить сервер: сначала найдите, где копится работа — в опросе, обработке, базе или оповещениях. Я покажу, что проверить до покупки железа, какие настройки действительно влияют на нагрузку и почему менять их наугад опасно.
С чего начинается перегрузка Zabbix
Zabbix складывает работу из нескольких частей: сервер опрашивает элементы, обрабатывает значения и триггеры, пишет историю в базу, а веб-интерфейс читает эти данные. К ним добавляются прокси и агенты, если они есть. Поэтому фраза «Zabbix грузит сервер» пока ничего не диагностирует. Это может быть занятый процесс сервера, медленные запросы к базе, очередь необработанных значений, слишком частый сбор или тяжёлый экран с длинным периодом. Нагрузка также зависит от числа узлов, элементов, типов проверок, задержек ответов и того, сколько истории хранится. Универсальной цифры ядер или гигабайтов для всех установок нет; размер оценивают по фактическому объёму данных и поведению процессов.
Я начинаю с системных графиков и раздела очереди Zabbix, затем смотрю внутренние метрики сервера и журнал. Если очередь растёт, выясняю, какие проверки опаздывают; если очередь пуста, но база отвечает медленно, разбираю уже базу и её диски. Сравниваю картину в обычное и пиковое время, потому что короткий снимок легко вводит в заблуждение. Отдельно проверяю, не собирает ли несколько шаблонов одно и то же, и не опрашивается ли устройство чаще, чем его состояние успевает измениться. Для такой диагностики полезно заранее [настроить мониторинг Zabbix](/uslugi/monitoring-zabbix/), но начать можно с текущих встроенных экранов. Железо добавляют после того, как понятен конкретный предел. Перед разбором убедитесь, что карта мониторинга отражает реальную конфигурацию: у каждого хоста должны быть выбран подходящий шаблон и осмысленные макросы, если шаблон на них опирается. Иначе один и тот же шаблон может дать разные результаты на похожих узлах, а причина будет выглядеть как перегрузка. При подключении нового хоста сверьте техническое имя хоста с параметром Hostname агента: для активных проверок это имя участвует в обработке запросов. Эти две проверки просты, но часто экономят больше времени, чем немедленное увеличение ресурсов.
- Сверить очередь и задержки обработки.
- Найти самые частые и повторяющиеся элементы.
- Сопоставить нагрузку сервера, базы и дисков.
Интервалы опроса: не путайте их с RefreshActiveChecks
Частоту получения конкретного значения задают в настройке элемента данных, а не одним магическим параметром агента. Сначала разделите показатели по смыслу: доступность критичного сервиса должна обнаруживаться быстро, а редко меняющийся объём архива не обязан опрашиваться каждую минуту. Начните с интервалов в шаблоне или элементе, учитывая допустимую задержку обнаружения и число узлов. Если интервалы увеличить, мониторинг будет реже замечать короткие сбои — это честная цена снижения числа проверок. Не копируйте чужие «30 секунд для всего»: важность и частота изменения у разных метрик разные.
RefreshActiveChecks в конфигурации агента отвечает за обновление списка активных проверок, который агент получает от сервера или прокси. Это не интервал опроса каждого элемента и не команда «собирать метрики раз в две минуты». Значение 120 означает период обновления списка в секундах; оно не превращает проверки в двухминутные и не заменяет интервалы элементов. Механизм выдачи списков активных проверок зависит от версии сервера и агента, поэтому не переносите значение между конфигурациями без проверки руководства для установленной пары версий. Менять её ради снижения нагрузки наугад бессмысленно: сначала определите, растёт ли именно трафик конфигурации или сама обработка значений. Когда я нахожу чрезмерную частоту, я фиксирую исходное значение, меняю один класс элементов и сравниваю очередь, задержку и время реакции на тестовый сбой. Такой порядок показывает, помогло ли изменение, и позволяет быстро вернуть его, если цена оказалась слишком высокой. Массовая правка всех шаблонов сразу лишает нас контрольной точки. После изменения проверьте последние данные у нескольких хостов и состояние связанных триггеров. Для активных проверок убедитесь, что агент получает список от правильного сервера или прокси и что узел в интерфейсе называется так же, как агент сообщает о себе.
- Критичные проверки — по требуемому времени реакции.
- Редко меняющиеся показатели — реже, если допустима задержка.
- Проверять число элементов после подключения шаблона.
История, тренды и база данных
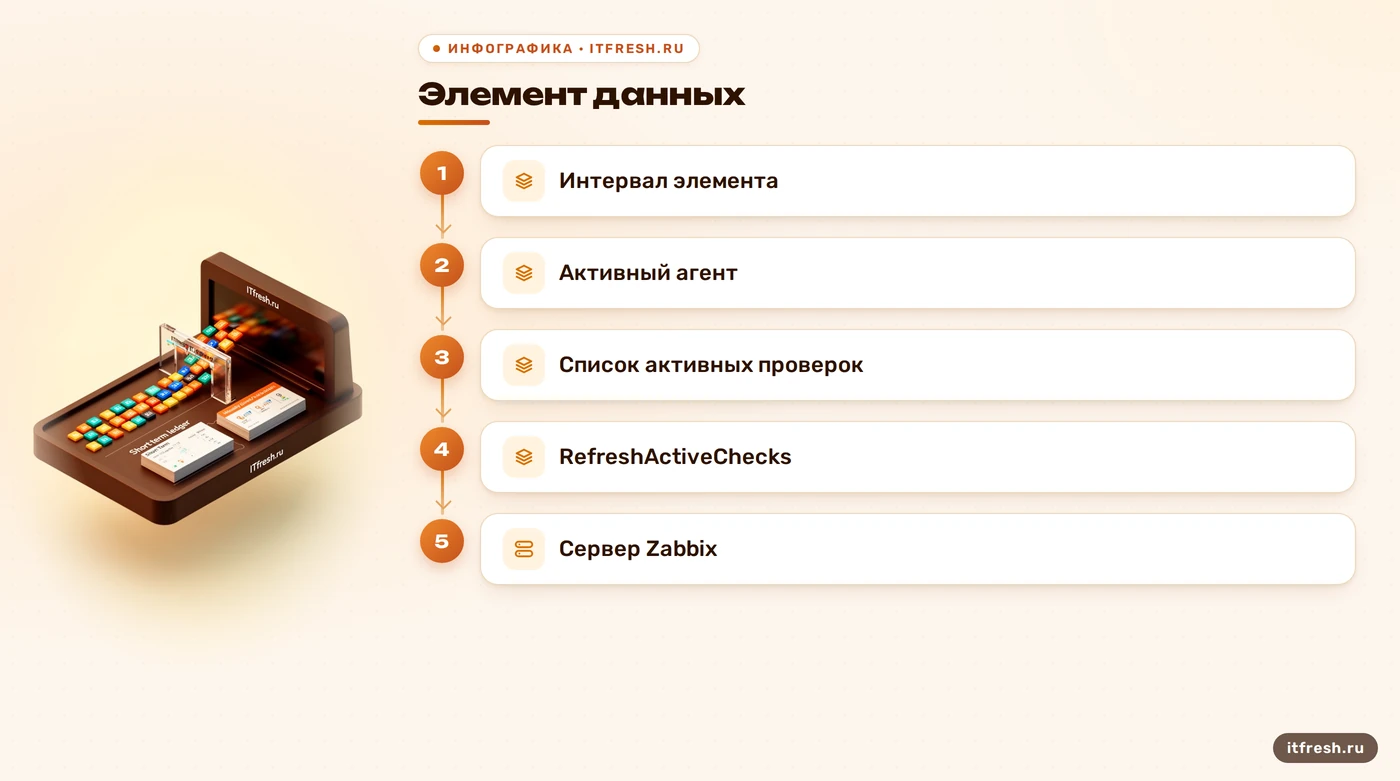
История хранит отдельные полученные значения. Тренды в Zabbix сокращают объём долгосрочных числовых данных: для каждого часа сохраняются минимум, максимум, среднее и число значений. Поэтому обычно имеет смысл хранить подробную историю столько, сколько нужно для разбора инцидентов, а тренды — дольше, если важны долгие графики. Срок выбирают по задаче и доступному месту, а не по выдуманному правилу «семь дней всем». Нулевой срок истории тоже не безобиден: без истории обычные функции триггеров не смогут анализировать значения. Убедитесь, что нужные графики и правила продолжают работать после изменения политики хранения.
В штатной схеме Zabbix уже создаёт и использует нужные индексы таблиц. Совет вручную добавить индекс на history_uint(clock) нельзя выдавать как универсальное ускорение: он может дублировать существующую структуру, увеличить цену записи и усложнить обновление. Сначала проверьте, где именно тормозит запрос, как устроены таблицы и что рекомендует документация для используемой версии и СУБД. Управление сроками истории и трендов находится в свойствах элементов и настройках Housekeeper; отдельного переключателя «среднее за пять минут» в настройках группы хостов нет. Если объём базы растёт, проверьте сроки хранения, темп поступления значений, очистку устаревших данных и дисковую подсистему. Секретного SQL-заклинания здесь нет — только измерение и аккуратное изменение. Не удаляйте историю только потому, что диск занят: сперва оцените срок хранения, скорость поступления значений и требования к расследованию инцидентов. Если старые детальные значения нужны редко, можно сократить этот срок и оставить более длинное хранение трендов, но проверьте, что графики за старый период действительно строятся из трендов. У разных типов элементов правила хранения и доступность трендов различаются. До правки сделайте резервную копию и зафиксируйте нынешние параметры, особенно если база обслуживает критичный мониторинг. После очистки убедитесь, что Housekeeper справляется, свободное место стабилизировалось, а графики и триггеры работают ожидаемо. Если база медленно пишет новые значения, дополнительный индекс может сделать ситуацию хуже: каждая запись должна поддерживать и его. Запросите план конкретного медленного запроса, проверьте статистику и версию СУБД, а затем сравните результат с документацией Zabbix. Не выполняйте DDL-операции на рабочей базе по совету из статьи без резервной копии и оценки времени блокировок. Для TimescaleDB, секционирования и внешней настройки хранения правила зависят от версии и выбранного способа интеграции. В типовой установке начните со штатного Housekeeper и параметров хранения, а нестандартную схему обсуждайте отдельно с ответственным за базу администратором.
- История — детальные значения на короткий срок.
- Тренды — часовые сводки для долгих периодов.
- Индексы вручную — только после диагностики схемы и запросов.
Триггеры: меньше шума, яснее реакция
Триггер должен описывать условие проблемы, а не просто реагировать на любое движение графика. Для краткого всплеска можно проверять среднее или минимум за выбранный период; для восстановления — задать отдельное условие, чтобы событие не мигало около границы порога. Например, выражение avg(/Zabbix server/system.cpu.load[all,avg1],5m)>5 проверяет среднее значение этого элемента за последние пять минут. Число 5 здесь не универсальный предел: допустимый уровень зависит от числа процессоров, типа нагрузки и того, что именно измеряет элемент. Перед включением триггера проверьте выражение на данных и решите, кому и при каких условиях оно должно отправлять уведомление.
Не используйте trend() для пятиминутного сглаживания. Функции трендов считают по часовым сводкам, поэтому их минимальный период — час; для короткого окна нужна функция истории вроде avg() или min(). Не переносите старые примеры delta() в актуальную конфигурацию без проверки доступности функции для вашей версии. У Zabbix есть поддерживаемые функции истории и трендов, и они решают разные задачи. Сглаживание тоже не всегда полезно: если сервис падает на две минуты, среднее за час может замаскировать событие. Я настраиваю период под время, за которое команда действительно должна отреагировать, а не под желание сделать график красивее. До включения порога уточните смысл измерения. Процессорная загрузка в процентах и средняя очередь загрузки — разные показатели, и значение 5 у них означает разное. Для хоста с несколькими ядрами один высокий короткий пик не всегда требует звонка ночью; длительная высокая нагрузка может быть важнее. Поэтому я выбираю триггер от ожидаемого поведения сервиса и проверяю его на реальных исторических данных. Условия восстановления задают с небольшим запасом, если краткое колебание границы приводит к многократному открытию и закрытию события. Триггер должен помогать принять решение: перезапустить службу, проверить базу или просто понаблюдать. Период в функции должен соответствовать её данным. Функции истории могут анализировать короткие окна последних значений, а трендовые функции работают с почасовыми сводками и годятся для сравнения долгосрочных периодов. Они не взаимозаменяемы. В документации есть отдельная таблица поддерживаемых функций; её и проверяйте при переносе старого выражения на новую версию. Также проверьте, как часто выражение пересчитывается и какой элемент запускает пересчёт. В результате порог будет чувствительным к нужному событию, а база не станет выполнять лишнюю аналитику только ради красивой формулы.
- Проверить единицы измерения элемента и смысл порога.
- Для короткого окна применять историю, для долгого анализа — тренды.
- При необходимости задать отдельное условие восстановления.
Оповещения и контроль самого Zabbix
Для отправки события Zabbix нужны действие, работающий тип доставки и назначенные пользователю реквизиты канала. Встроенные способы включают почту, SMS, скрипт и webhook; конкретный мессенджер подключается подходящим media type, а не командой zabbix_sender. Эта утилита передаёт значения в Zabbix, например данные пользовательской проверки, но сама по себе не отправляет уведомления в Slack или Telegram. Если используется скрипт оповещения, его каталог задаётся параметром AlertScriptsPath на сервере, а скрипт запускает Zabbix. Значит, он расходует ресурсы серверных процессов оповещения; считать его асинхронным без проверки реализации нельзя. Токен интеграции храните в защищённом месте, а доставку проверьте тестовым событием.
Повторы, паузы и эскалации настраивают в операциях действия. Фиксированные Maximum repetitions=3 и Repeat interval=300 не являются универсальными полями или правильными значениями для любого события; число шагов и интервал выбирают по политике реакции и настройкам конкретной версии. Слишком частые повторы превращают сигнал в шум, слишком редкие — задерживают реакцию. Сам Zabbix тоже нужно наблюдать: встроенные элементы могут показывать длину очереди и занятость процессов. Добавьте эти показатели к наблюдению, затем задайте пороги, которые означают реальную задержку или устойчивую занятость. Условный пример для студии «Импульс-Сервис»: перед масштабированием мы выясняем, забивается ли очередь проверок или база не успевает записывать значения. Только после этого выбираем действие — пересмотреть интервалы, сроки хранения, число процессов или ресурсы базы. Если событие не приходит, проверьте цепочку по шагам: событие создано, операция действия подходит под условие, пользователь выбран получателем, у него задан канал, а media type включён и прошёл тест. Для webhook отдельно проверьте адрес, секреты, тело запроса и ответ удалённой стороны. Для скрипта проверьте права пользователя Zabbix, путь AlertScriptsPath, код завершения и журналы процесса. Сбой скрипта не исправляется увеличением частоты опроса. Для резервирования важного канала можно настроить дополнительные операции или эскалацию с ответственным сроком реакции; конкретный маршрут согласуйте с дежурной командой, иначе автоматизация лишь быстрее разошлёт непонятный сигнал. Встроенные метрики помогают отличить общую загрузку машины от занятости конкретного пула процессов и очередей. Но часть внутренних элементов сама может быть дорогой на крупной установке; включайте только нужные измерения и следите за их влиянием. Сопоставьте время роста очереди с журналом сервера, базой и сетью. Если очередь не растёт, а CPU занят, смотрите процесс и тип нагрузки; если очередь растёт только у одного вида проверок, ищите медленные узлы или недостаток соответствующих poller-процессов. Это диагностический план, а не повод бездумно увеличивать число процессов: дополнительные процессы потребляют память и могут увеличить конкуренцию за базу. Перед масштабированием зафиксируйте базовую линию: число значений в секунду, время ожидания, размер очереди, использование CPU и дисковую задержку. Измените один фактор и повторите наблюдение в похожий период. Если проблема в шаблонах, отключение ненужных элементов даст более чистый результат; если в задержках устройств — увеличение poller-процессов не устранит медленный ответ сети; если в базе — дополнительные ресурсы сервера приложения не ускорят диск. В HA-режиме узлы Zabbix Server используют одну базу; это не кластер с репликацией данных, которую можно включить «без лицензий». HA повышает доступность процесса сервера, но не заменяет резервное копирование базы и отдельный план восстановления. В условном разборе студии «Импульс-Сервис» я не обещаю заранее, что достаточно добавить ядро или перенести базу. Мы сначала сохраняем рабочую конфигурацию, выбираем несколько показательных хостов и снимаем очередь с нагрузкой компонентов. Затем отдельно проверяем шаблоны, длительность хранения, обработку значений и доставку тестового события. Только после сравнения с исходной картиной выбираем изменение и фиксируем его результат. Так владелец получает проверяемую причину и понятное действие, а не счёт за кластер, который может просто ускорить запись ненужных метрик.
- Проверить тип доставки, пользователя и действие.
- Отправить тестовое уведомление.
- Следить за очередью и занятостью процессов.
- Масштабировать только после подтверждения узкого места.
Частые вопросы
Что именно задаёт RefreshActiveChecks?
Период, с которым агент обновляет список активных проверок. Частоту получения конкретного элемента задаёт его интервал обновления.
Как Zabbix сокращает объём старых данных?
История хранит отдельные значения, а тренды — часовые минимум, максимум, среднее и число значений для числовых данных. Сроки хранения задаются отдельно.
Можно ли ускорить Zabbix индексом на history_uint?
Не добавляйте индекс вслепую. Сначала изучите план проблемного запроса и штатную схему своей версии: дополнительный индекс может не помочь и замедлить запись.
Подходит ли trend() для среднего за пять минут?
Нет. Функции трендов работают с часовыми сводками и периодом от часа. Для короткого окна используйте подходящую функцию истории, например avg().
Как проверить, что Zabbix сам не отстаёт?
Наблюдайте очередь и занятость процессов через внутренние элементы Zabbix, а также сопоставляйте их с состоянием базы и дисков.
Источники
- Zabbix 7.0: агент и настройка хоста — Проверено назначение RefreshActiveChecks, совпадение Hostname агента с именем хоста и связывание шаблонов: https://www.zabbix.com/documentation/7.0/en/manual/appendix/config/zabbix_agentd ; https://www.zabbix.com/documentation/7.0/en/manual/config/hosts/host
- Zabbix 7.0: история и тренды — Проверены история, часовая агрегация трендов, сроки хранения и установка штатной схемы базы: https://www.zabbix.com/documentation/7.0/en/manual/config/items/history_and_trends ; https://www.zabbix.com/documentation/7.0/en/manual/appendix/install/db_scripts
- Zabbix 7.0: функции триггеров и трендов — Проверены выражения истории и ограничения функций, использующих почасовые сводки: https://www.zabbix.com/documentation/7.0/en/manual/config/triggers/expression ; https://www.zabbix.com/documentation/7.0/en/manual/appendix/functions/trends
- Zabbix 7.0: типы доставки уведомлений — Проверены типы Email, SMS, Script и Webhook, необходимые для доставки оповещений: https://www.zabbix.com/documentation/7.0/en/manual/config/notifications/media
- Zabbix 7.0: Zabbix sender — Проверено назначение утилиты zabbix_sender — передача данных серверу или прокси для обработки: https://www.zabbix.com/documentation/7.0/en/manual/concepts/sender
- Zabbix 7.0: внутренние элементы — Проверены внутренние элементы для наблюдения за очередями и процессами Zabbix: https://www.zabbix.com/documentation/7.0/en/manual/config/items/itemtypes/internal