
Как найти причину таймаута между Nginx и приложением
`upstream timed out` означает, что Nginx не получил очередные данные от upstream в пределах настроенного интервала. Это еще не диагноз: задержку может создавать приложение, база, сеть или неверно выбранный таймаут. Я начинаю с журнала и замеров, а конфигурацию меняю только после того, как понимаю, где именно теряется время.
Что означает upstream timed out в журнале Nginx
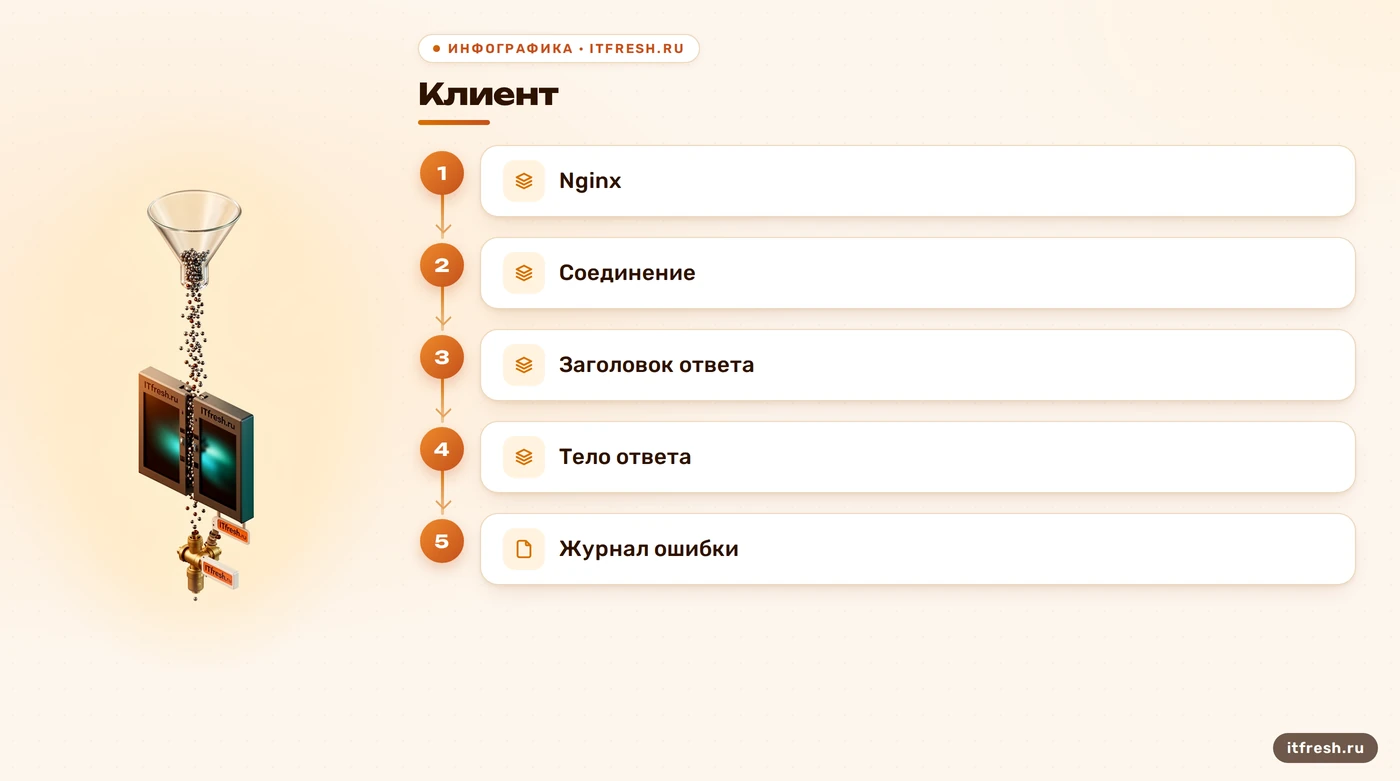
Сообщение upstream timed out говорит о превышении времени ожидания ответа от upstream — сервера, к которому Nginx передал запрос. Уточнение после while важно: connecting to upstream указывает на этап соединения, while reading response header from upstream — на ожидание заголовков ответа, а while reading upstream может относиться к чтению тела. Это разные участки пути. Поэтому одной строкой «увеличьте таймаут» проблему не диагностируют. Nginx здесь работает как обратный прокси и передает запрос приложению; запись в журнале описывает, на каком этапе он перестал ждать. Номер системной ошибки в скобках зависит от ОС, поэтому не превращайте одно значение вроде 110 в универсальный код причины.
Сначала сопоставьте время ошибки с access log и журналом приложения. Проверьте $request_time, $upstream_connect_time, $upstream_header_time и $upstream_response_time, если эти поля включены в формат журнала. Сравните их на нескольких проблемных запросах: долгое подключение, долгое ожидание первого заголовка и долгое чтение уже начавшегося ответа — не одно и то же. Убедитесь, что смотрите правильный виртуальный хост и правильный upstream, а системное время на узлах синхронизировано. Если ошибка редкая, сохраните несколько примеров вместе с URI без секретных параметров, временем и статусом. Один длинный запрос не доказывает, что медленным стало всё приложение. Перезагрузка может убрать симптом на минуту; диагностикой она от этого не становится.
Не считайте upstream timed out тождественным HTTP 504 во всех случаях: клиентский ответ зависит от конфигурации и от того, успел ли Nginx отправить заголовки. Посмотрите статус, завершение запроса и upstream-поля рядом, а не только одну строку error log. Если проблема возникает у одного маршрута, сравните его с соседним при той же нагрузке. Если одновременно замедлились разные маршруты, проверьте общие зависимости: пул соединений, базу и сетевой путь. Так расследование остается привязанным к наблюдаемым данным, а не к догадке по тексту ошибки.
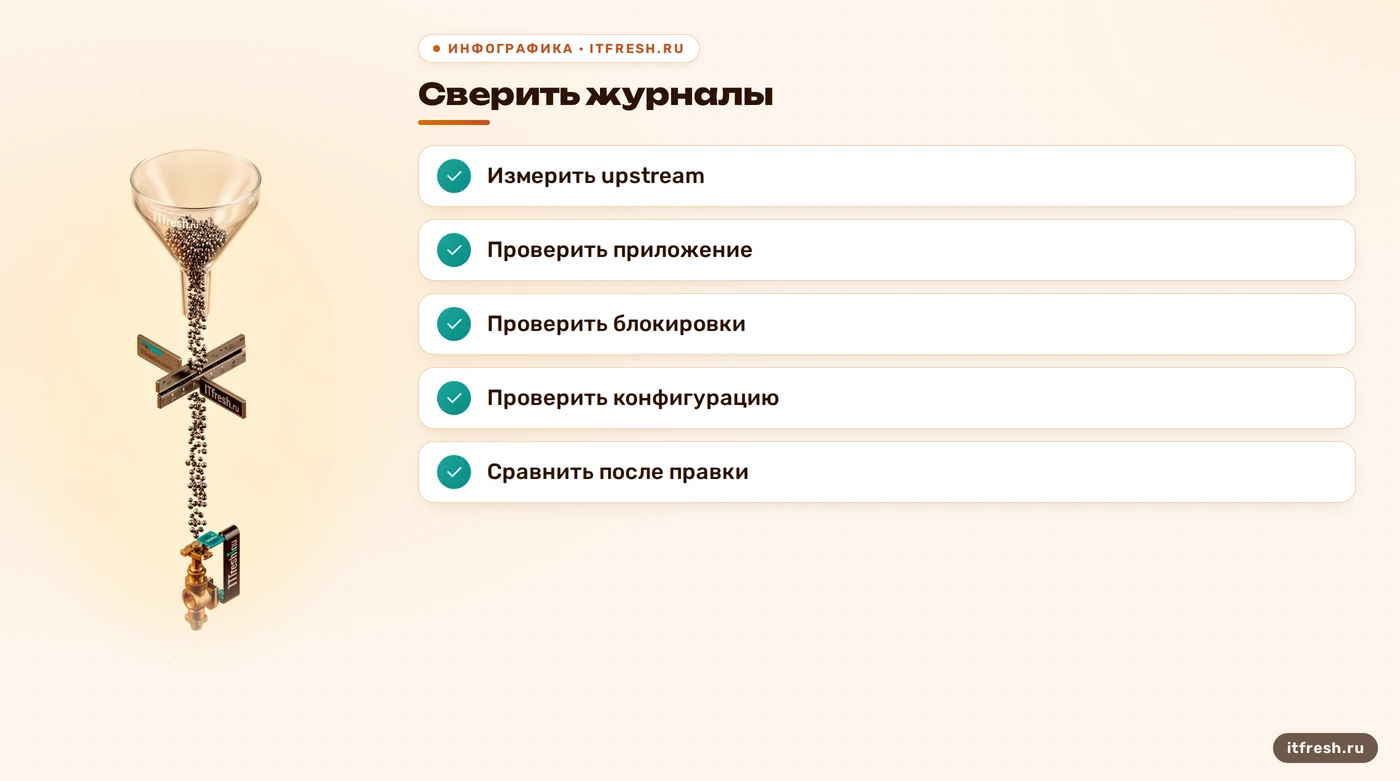
- Сопоставьте время ошибки с запросом в access log
- Разделите connect, header и response time
- Проверьте журнал приложения и доступность upstream
Какие таймауты менять и где их задавать
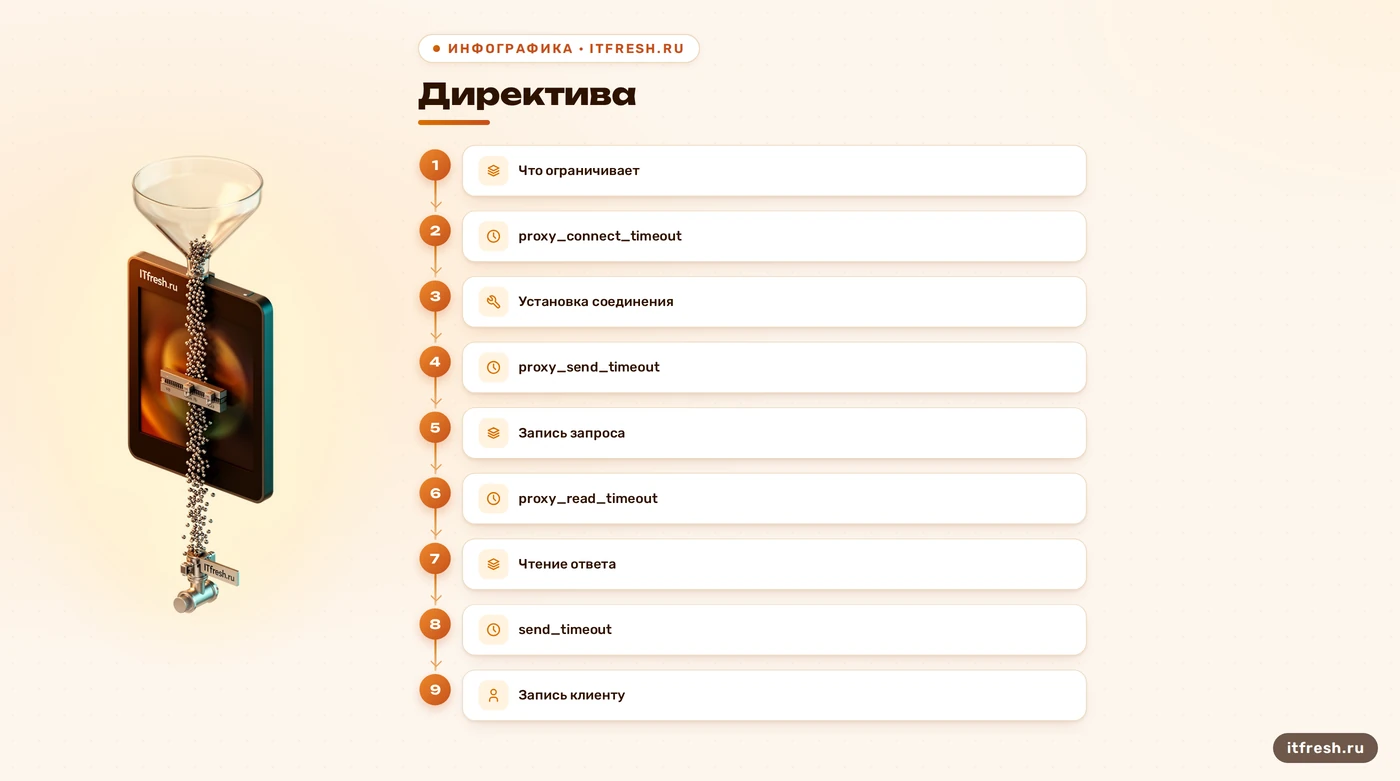
У директив разные обязанности. proxy_connect_timeout ограничивает установление соединения с проксируемым сервером. proxy_send_timeout задает интервал между операциями записи запроса в upstream. proxy_read_timeout — интервал между операциями чтения ответа от upstream, а не максимальную длительность всего ответа. Для этих proxy-директив документация NGINX указывает значение по умолчанию 60s; у send_timeout отдельный смысл — ожидание между операциями записи ответа клиенту. Эти параметры действуют в контекстах http, server и location, но менять их лучше на минимальном подходящем уровне. Не копируйте числа из чужого конфига: у долгого экспорта и обычного API разные требования, а общий таймаут может затронуть несвязанные маршруты.
Для медленного ответа сначала выясните, что именно долго: подключение, появление заголовков или дальнейшая передача данных. Затем задайте целевой интервал в location конкретного маршрута, проверьте конфигурацию командой nginx -t и применяйте изменение штатным способом для вашей системы. Сверьте результат на тех же запросах и следите за числом одновременно ожидающих операций. Таймаут — не педаль ускорения: нажал сильнее, приложение быстрее не стало. Более длинное ожидание не ускорит приложение; оно только позволит соединению ждать дольше и может увеличить занятые ресурсы при всплеске запросов. Я не назначаю одно «правильное» значение в секундах без профиля нагрузки и требований приложения. Если причина — блокировка базы или внешний сервис, лечить это таймаутом всё равно что растянуть очередь и объявить её производительнее.
Сверьте реальный proxy_pass и выбранный location: приоритеты location и передача URI влияют на то, какой обработчик получит запрос. Не публикуйте в тикетах полные заголовки авторизации, cookie и тела запросов. Для сравнения достаточно времени, безопасного идентификатора, статуса и маршрута без чувствительных параметров. Если access log пока не содержит upstream-времена, добавляйте их осознанно в формат журнала и проверьте, что формат совместим с вашей системой сбора логов.
- proxy_connect_timeout — установка соединения
- proxy_send_timeout — запись запроса в upstream
- proxy_read_timeout — пауза между чтениями ответа
- send_timeout — запись ответа клиенту
Как отделить задержку приложения от сети и базы
Проведите запрос с узла Nginx к тому же адресу upstream и зафиксируйте DNS-разрешение, время подключения и время до первого байта. Это проверит маршрут, но не заменит наблюдение за реальным запросом: приложение может зависеть от конкретных данных, очереди задач или внешнего API. На стороне приложения сопоставьте идентификатор запроса, если он передается безопасно, с собственными журналами и временем выполнения обработчика. На стороне системы посмотрите CPU, память, дисковый ввод-вывод, очереди и число открытых соединений. Метрики наподобие http_request_duration_seconds не возникают автоматически от установки Prometheus: их должен публиковать инструментируемый сервис или экспортер, а название и метки нужно знать для конкретной системы.
Если приложение использует PostgreSQL, проверяйте активные запросы и блокировки. Представление pg_locks показывает сведения о текущих удерживаемых и ожидающих блокировках; сам по себе запрос SELECT * FROM pg_locks не объясняет, кто кого блокирует и почему. Сопоставьте PID, состояние сессии и длительность запроса с журналом приложения, а при необходимости разберите план и транзакции вместе с ответственным за базу. strace -p PID -c суммирует системные вызовы процесса, но не профилирует SQL и не раскрывает «медленный запрос» напрямую. На рабочем сервисе сначала оцените влияние диагностики и права доступа. Не меняйте уровень изоляции транзакций наугад: это может поменять поведение приложения и привести к новым ошибкам.
Для proxy-параметров NGINX допускает суффиксы времени, например s и ms; задавайте значение явно и проверьте загруженную конфигурацию после изменения. Учтите, что директива на более узком уровне конфигурации может переопределить унаследованную настройку. Поэтому проверяйте именно эффективный файл и подключаемые фрагменты, а не только один знакомый nginx.conf. Записывайте исходное значение и причину изменения, чтобы откат не превратился в археологию по истории терминала.
- Сравните connect time и время до первого байта
- Сверьте запрос с журналами приложения
- Для PostgreSQL изучите сессии и блокировки
- Проверяйте влияние диагностических команд
Keepalive и повторная отправка: настройки с оговорками
Директива keepalive в блоке upstream задает кэш неактивных соединений к upstream на каждый worker-процесс. Это не общий лимит всех соединений к приложению и не команда «держать ровно столько соединений». Для HTTP-переиспользования важны версия NGINX и заголовок Connection: в актуальной документации поведение HTTP keepalive включено по умолчанию начиная с NGINX 1.29.7; для старых версий обычно задают proxy_http_version 1.1 и очищают заголовок Connection. Значит, совет «добавьте keepalive 32; и всё заработает» без проверки версии и контекста неполон. Значение выбирают с учетом числа workers, нагрузки и того, сколько соединений способен обслужить сам backend.
proxy_next_upstream timeout; позволяет считать таймаут неудачной попыткой и при соблюдении условий попробовать следующий сервер. Но NGINX может передать запрос дальше, только пока еще не начал отправлять ответ клиенту; уже отправленное тело запроса тоже ограничивает повтор. Особенно осторожно относитесь к POST и другим операциям с побочными эффектами: повтор способен создать дубликат операции, а резервный сервер может не иметь актуального состояния. Не включайте ретраи как универсальную страховку. Проверьте семантику конкретного метода, идемпотентность обработчика, состояние репликации и поведение при частичном ответе. Директива proxy_next_upstream_tries ограничивает число попыток; значение 0 означает, что такого ограничения директивой нет. Настроенный retry — это политика обработки ошибки, а не автоматическая гарантия отказоустойчивости.
Чтобы найти блокирующую сессию PostgreSQL, полезно связать pg_locks с pg_stat_activity и проверить поля ожидания и текст выполняемого запроса с учетом прав доступа. Не завершайте backend-процесс, пока не оценили транзакцию и последствия отмены. Блокировка может быть нормальной частью конкурентной работы, а не неисправностью сама по себе. Для медленного SQL важны план выполнения, объем данных и статистика; изменение индексов без плана тоже не универсальный рецепт.
- Проверьте версию NGINX и upstream HTTP
- Не путайте idle keepalive cache с общим лимитом
- Разрешайте повторы только для безопасных операций
Безопасная проверка изменений и наблюдение
Обычный error_log ... debug не включается наугад в рабочей среде. Для debug-журнала NGINX должен быть собран с поддержкой --with-debug; проверьте параметры сборки через nginx -V и инструкцию поставщика пакета. Включайте подробный журнал коротким окном, с ограниченным охватом и контролем объема: он быстро разрастается и содержит технические детали запросов. Уровень debug не гарантирует, что в любом пакете появятся ожидаемые записи. Путь /var/log/nginx/error.log также не универсален: журнал может идти в другой файл, syslog или стандартный поток контейнера. Сначала выясните фактическую конфигурацию error_log, права и ротацию. Затем проверьте синтаксис и примените конфиг способом, принятым на этом сервере.
Проверяйте исправление на контролируемом трафике и сравнивайте одинаковые показатели до и после: время соединения, время до заголовка, полное время upstream, долю ошибок и ресурсную нагрузку. wrk и ab могут генерировать нагрузку, но сами по себе не создают реалистичный профиль: учитывайте сценарии, число одновременных клиентов, прогрев, кэш и безопасную тестовую среду. Не запускайте агрессивный тест на чужом или нагруженном сервисе без согласования окна и лимитов. Оставьте наблюдение за ошибками и не отключайте оповещения только потому, что график однажды выровнялся. Если таймауты вернулись, ищите, что изменилось: поток запросов, база, внешний вызов или конфигурация upstream. Успешная проверка — повторяемый результат под ожидаемой нагрузкой, а не красивое число из одного прогона.
В HTTP keepalive повторно используется TCP-соединение, когда протокол, заголовки и приложение допускают такое поведение. Переиспользование снижает стоимость новых установлений соединений, но не делает запрос быстрее, если обработчик ждет базу. Кэш keepalive учитывается на worker; умножьте выбранный размер на число процессов и сопоставьте результат с лимитами backend. Также проверьте таймаут неактивности на стороне приложения: если оно закрывает соединение раньше, Nginx может получить закрытый сокет и установить новое.
- Проверьте сборку NGINX перед debug-логом
- Ограничьте время и объем подробного логирования
- Сравнивайте одинаковые запросы до и после
Частые вопросы
Что означает `upstream timed out`?
Nginx не получил очередные данные от проксируемого сервера за заданный интервал. Уточнение `while` показывает этап, на котором истекло ожидание.
Какой таймаут отвечает за ожидание ответа?
Обычно проверяют `proxy_read_timeout`: это максимальная пауза между чтениями от upstream, а не лимит полной длительности ответа.
Нужно ли всегда включать debug-лог?
Нет. Для него нужна сборка NGINX с `--with-debug`; подробное логирование включают ограниченно и проверяют поддержку в установленном пакете.
Поможет ли `keepalive 32` от таймаутов?
Сам по себе параметр не исправит медленный обработчик. Это кэш неактивных соединений; проверьте версию NGINX, HTTP-настройки и возможности backend.
Можно ли повторять запрос на резервный сервер после timeout?
Только если повтор безопасен и запрос еще можно передать дальше. Для операций с побочными эффектами сначала проверьте идемпотентность и состояние данных.
Источники
- NGINX: ngx_http_proxy_module — Официальная документация: proxy таймауты, условия повторной передачи запроса и ограничения для тела запроса. https://nginx.org/en/docs/http/ngx_http_proxy_module.html
- NGINX: ngx_http_upstream_module — Официальная документация: keepalive cache, ограничения параметра и HTTP-настройки upstream. https://nginx.org/en/docs/http/ngx_http_upstream_module.html
- NGINX: A debugging log — Официальная инструкция: сборка с --with-debug, настройка уровня debug и проверка поддержки. https://nginx.org/en/docs/debugging_log.html
- PostgreSQL: блокировки и статистика активности — Официальное руководство по представлениям pg_locks и pg_stat_activity: https://www.postgresql.org/docs/current/explicit-locking.html ; https://www.postgresql.org/docs/current/monitoring-stats.html
- NGINX: ngx_http_log_module — Официальная документация по переменным журнала запросов и измерениям upstream. https://nginx.org/en/docs/http/ngx_http_log_module.html
- strace(1) Linux manual page — Руководство по трассировке системных вызовов и суммарному режиму -c: https://man7.org/linux/man-pages/man1/strace.1.html