
Почему Nginx в Docker получает Address not available под нагрузкой
В `error.log` появляется `connect() failed (99: Cannot assign requested address) while connecting to upstream`, а в чате уже предлагают ещё раз поднять `nofile`. Я, Семёнов Евгений Сергеевич, директор ООО «АйТи-Фреш», в этот момент прошу остановиться. Код 99 говорит не о том, что backend отказал, и не о том, что Nginx исчерпал файловые дескрипторы. Чаще всего Linux не смог выделить исходящий локальный порт. Но Docker добавляет ещё два слоя — NAT и conntrack, поэтому по одному HTTP 502 гадать нельзя. Ниже покажу порядок, который быстро локализует слой отказа и не требует крутить все sysctl подряд.
Errno 99 — не нехватка файловых дескрипторов
Я начинаю с полного текста ошибки, включая имя системного вызова. Для незабинденного Internet-сокета Linux документирует EADDRNOTAVAIL: при connect() ядро попыталось автоматически назначить ephemeral port и не нашло свободного в ip_local_port_range. Это локальный отказ до нормального разговора с upstream. Поэтому фраза «upstream упал» здесь обычно неверна: пакет мог вообще не выйти из namespace контейнера. Именно так описан код в connect(2).
У nofile другой почерк: socket() failed (24: Too many open files) или accept4() failed (24: Too many open files). worker_connections тоже отдельный потолок; он считает и клиентские, и upstream-соединения, а фактическое число ограничено лимитом открытых файлов процесса. Это прямо оговорено в документации ядра Nginx. Поднять Compose ulimits.nofile, забыв про worker_connections, бессмысленно, но даже идеальная настройка обоих параметров не создаст ни одного нового TCP-порта.
Есть исключение, о котором легко забыть: proxy_bind с удалённым из контейнера IP. Тогда bind() также возвращает EADDRNOTAVAIL. Я проверяю nginx -T, адреса и маршрут, особенно после миграции VRRP или смены сети. Смотрите на глагол в логе: bind(...) failed ведёт к адресу, connect() failed (99...) без явной привязки — к ephemeral pool. А Connection refused и Connection timed out — уже другие ветки расследования. Смешивать их в одну «сетевую ошибку Nginx» дорого.
Где на самом деле заканчиваются порты, NAT и conntrack
У bridge-контейнера свой network namespace: сокеты, номера портов и часть /proc/sys/net. Типичный диапазон Linux — 32768 60999, то есть 28 232 значения. Соединение уникально по протоколу и source/destination IP:port, поэтому один локальный порт можно использовать с разными endpoint. Но к одной паре source IP → 10.40.12.34:8080 пространство быстро заканчивается. Базовый TIME-WAIT-таймер Linux — 60 секунд; расчёт относится к non-loopback без допустимого reuse. При 1 000 активных закрытий в секунду 28232 / 1000 ≈ 28 с предсказывает кейс; константа видна в исходном коде Linux.
Для обычного rootful Docker Engine на Linux пакет из bridge обычно проходит MASQUERADE: адрес контейнера заменяется адресом хоста. NAT подбирает уникальный внешний tuple; пространство конечно для одного egress-IP, протокола и destination IP:port. Пять контейнеров расширят внутренние пулы, но не внешний адрес. Так errno 99 можно убрать и упереться в SNAT. NAT allocator не ограничен host ip_local_port_range, поэтому расширять его на хосте «для MASQUERADE» бесполезно. Rootless, Docker Desktop, host, macvlan/ipvlan и routed bridge требуют отдельной схемы; базовый путь описан в Docker Docs.
Conntrack — третий ресурс. nf_conntrack_count привязан к network namespace; для bridge/MASQUERADE я читаю его в initial namespace хоста, а значение из контейнера не показывает NAT-таблицу. Под давлением может расти early_drop; если ядро не освободило запись, оно дропает пакет и пишет о полной таблице. Лог rate-limited, его отсутствие не алиби; insert_failed бывает и при конфликте tuple. Поэтому conntrack или NAT allocator обычно даёт SYN retransmit и timeout, не немедленный errno 99. Socket TIME-WAIT контейнера тоже не равен состоянию conntrack: upstream default его host-таймера — 120 секунд. Проверяйте runtime; детали видны в коде conntrack и NAT.
Четвёртая причина — churn из-за отсутствия upstream keepalive. Клиент может держать HTTPS-соединение с Nginx хоть час; это ничего не говорит о второй TCP-ноге от Nginx к приложению. До Nginx 1.29.7 для HTTP upstream требовались keepalive в блоке upstream, HTTP/1.1 и очищенный Connection. Начиная с 1.29.7 keepalive включён по умолчанию: 32 idle-соединения на worker, а HTTP/1.1 стал стандартом. В stable 1.30.4 это уже есть, но на старых образах 1.26/1.28 — нет. Для implicit upstream из прямого proxy_pass http://IP:port и runtime-переменной автоматический кеш не создаётся, поэтому я объявляю именованный upstream. Изменение версии разобрано в официальной публикации Nginx.
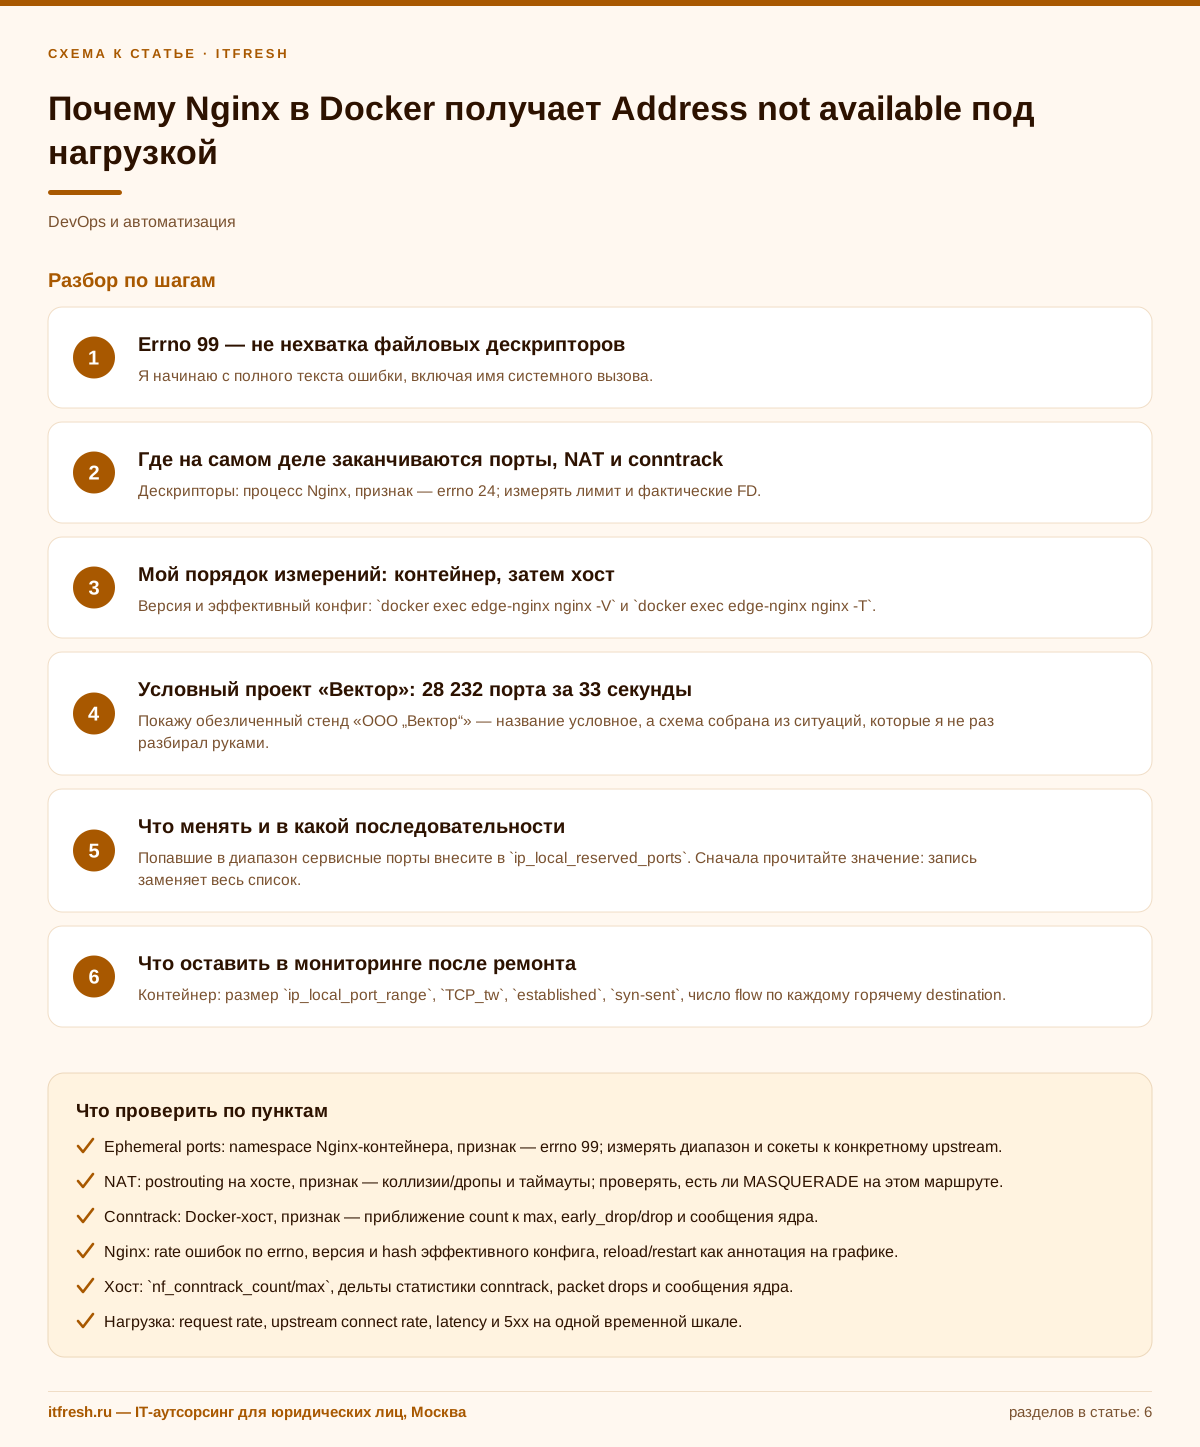
- Дескрипторы: процесс Nginx, признак — errno 24; измерять лимит и фактические FD.
- Ephemeral ports: namespace Nginx-контейнера, признак — errno 99; измерять диапазон и сокеты к конкретному upstream.
- NAT: postrouting на хосте, признак — коллизии/дропы и таймауты; проверять, есть ли MASQUERADE на этом маршруте.
- Conntrack: Docker-хост, признак — приближение count к max, early_drop/drop и сообщения ядра.
Мой порядок измерений: контейнер, затем хост
Первые пять минут я ничего не меняю. Фиксирую время ошибки, RPS, полный upstream-адрес и эффективный конфиг. Нужны именно nginx -T и nginx -V, а не файл из Git: include, переменная в proxy_pass или старый смонтированный volume часто меняют картину. Одновременно смотрю, не исчез ли IP из proxy_bind. Один срез на простое и три-четыре среза во время разгона нагрузки полезнее красивого графика после аварии.
Затем захожу в network namespace контейнера. В минимальном Alpine-образе может не быть ss, поэтому запускаю его с хоста через nsenter. Считаю общий TCP_tw, но решение принимаю по паре source IP → destination IP:port. Если диапазон содержит 28 232 порта, а в этой паре видно 27–28 тысяч соединений и число растёт вместе с errno 99, доказательство уже сильное. Низкий FD и свободный conntrack его укрепляют.
Лишь после этого перехожу в начальный namespace хоста: сравниваю conntrack count/max, снимаю дельту conntrack -S, читаю kernel log и смотрю правила NAT. Значение count/max без динамики почти бесполезно: 70 % стабильного фона бывает безопаснее, чем рост с 20 до 60 % за минуту. И наоборот, таблица на 30 % не оправдывает её удвоение. Мне нужны корреляция со стартом теста и совокупность сигналов, а не одна большая цифра.
- Datapath, версия, конфиг: `docker inspect -f '{{.HostConfig.NetworkMode}}' edge-nginx`; `docker exec edge-nginx nginx -V`; `docker exec edge-nginx nginx -T`. Опции сети: `docker network inspect NETWORK --format '{{json .Options}}'`.
- PID и namespace: `PID=$(docker inspect -f '{{.State.Pid}}' edge-nginx)`; затем через `nsenter -t "$PID" -n` прочитать `ip_local_port_range`, `ip_local_reserved_ports` и `/proc/net/sockstat`.
- Сокеты контейнера: `nsenter -t "$PID" -n ss -s`; TIME-WAIT — `nsenter -t "$PID« -n ss -Htan state time-wait | wc -l`; конкретная пара — `nsenter -t »$PID" -n ss -Htan state all 'src 172.20.0.10 and dst 10.40.12.34:8080' | wc -l`.
- FD конкретных workers: получить host PID через `docker top edge-nginx -eo pid,comm`, затем проверить `grep 'Max open files' /proc/PID/limits` и `ls /proc/PID/fd | wc -l` для каждого worker.
- Conntrack на хосте: `sysctl net.netfilter.nf_conntrack_count net.netfilter.nf_conntrack_max net.netfilter.nf_conntrack_buckets`; дельта — два `conntrack -S`; лог — `journalctl -k --since '-10 min' | grep -E 'nf_conntrack.*table full'`.
- `iptables-save -c -t nat` или `nft list ruleset` доказывает путь MASQUERADE, не исчерпание портов. Отдельного sysctl «NAT ports used» нет; кратко фильтрую tuple: `conntrack -L -p tcp -d 10.40.12.34 --dport 8080 --src-nat -o extended`. Если картина спорная, одновременно снимаю SYN внутри netns и на egress хоста.
Условный проект «Коробочный цех»: 28 232 порта за 30 секунд
Покажу обезличенный стенд «ООО „Коробочный цех“» — название условное, а схема собрана из ситуаций, которые я не раз разбирал руками. Виртуальная машина: 8 vCPU, 16 Гбайт RAM, Ubuntu Server 24.04 LTS, Linux 6.8, Docker Engine 29.6.2. В bridge-сети Nginx имел 172.20.0.10; работал образ nginx:1.26.3-alpine, четыре workers, внешний Java API — 10.40.12.34:8080. Генератор держал 400 клиентских keepalive-соединений и 1 000 запросов/с, p95 приложения был 38 мс.
Команда уже выставила nofile 262144 и worker_connections 32768. В location присутствовали proxy_http_version 1.1 и пустой Connection, но в upstream не было keepalive. Это классическая половина настройки: backend разрешает сохранить TCP-соединение, а старый Nginx не кладёт его в upstream cache и закрывает после ответа. Мы измерили около 950 новых соединений/с. Через 27 секунд TCP_tw переваливал за 25 тысяч, на 30-й появлялся errno 99, а доля 502 доходила до 8,1 %.
В момент сбоя ss показывал 28 117 записей для 172.20.0.10 → 10.40.12.34:8080, из них 27 984 TIME-WAIT. Диапазон был 32768–60999. У workers вместе — меньше 4 300 FD; host nf_conntrack_count — 41 806 при max=buckets=262144, а early_drop, insert_failed и drop не росли. Дождались возврата socket states и host conntrack к baseline, расширили диапазон до 10240–65535: отказ сдвинулся на 58-ю секунду. Хороший эксперимент — ведро стало больше, кран остался открыт.
На том же Nginx 1.26.3 изменили только конфиг keepalive и повторили тест: при 3 500 запросах/с 30 минут connect rate был 3–6/с, TIME-WAIT — около 220, conntrack — фоновые 9–11 тысяч. Среднее upstream-время — 34 мс, p95 — 44 мс; errno 99 и сетевых 502 не было. Затем обновились до stable 1.30.4 и тем же профилем подтвердили отсутствие регрессии. Диапазон оставили как запас, но причинный эффект отдельно доказал keepalive.
- Исходный фрагмент: `upstream api_backend { server 10.40.12.34:8080; } location /api/ { proxy_http_version 1.1; proxy_set_header Connection ""; proxy_pass http://api_backend; }`.
- Исправленный фрагмент: `upstream api_backend { server 10.40.12.34:8080; keepalive 64; keepalive_requests 1000; keepalive_timeout 30s; } location /api/ { proxy_http_version 1.1; proxy_set_header Connection ""; proxy_pass http://api_backend; }`.
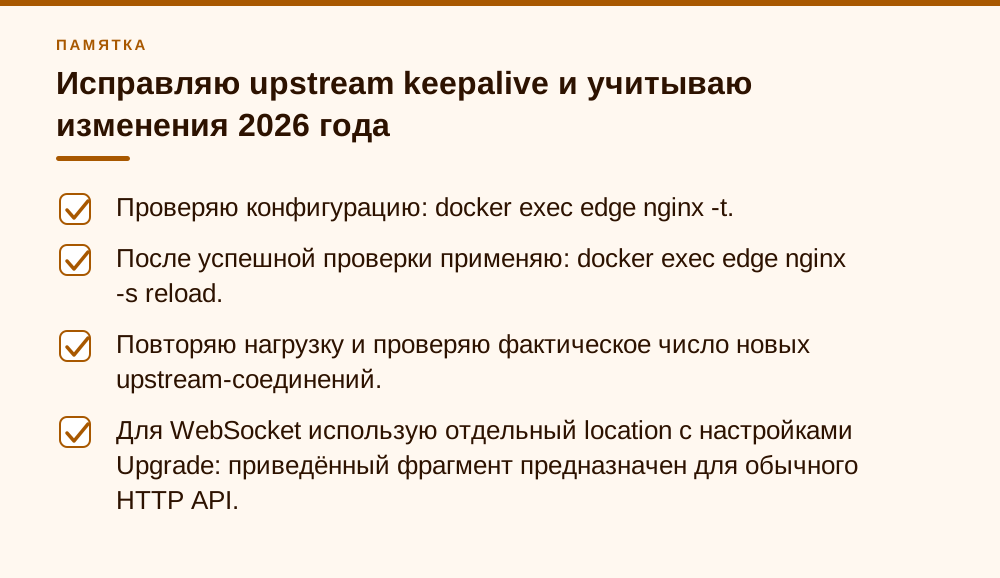
- Проверка перед reload: `nginx -t`; применение без обрыва активных запросов: `nginx -s reload`; затем тот же профиль нагрузки, а не короткий smoke test.
Что менять и в какой последовательности
Мой первый выбор — убрать лишние открытия TCP. RPS × среднее upstream-время даёт лишь стартовую оценку активной конкуренции по закону Литтла, не размер idle cache; деление на workers тоже приблизительно. В компании «Коробочный цех» 3500 × 0,034 ≈ 119 активных соединений суммарно, а измеренный пик самого занятого worker был 46. Я начал с keepalive 64 и подтвердил падение connect rate. Тысячу ставить незачем. Затем сверяю общий пул с лимитом backend: директива ограничивает только idle-соединения, не активные.
На 5 сентября 2026 года stable Nginx — 1.30.4, mainline — 1.31.5. С 1.29.7 upstream keepalive включён по умолчанию, но образов 1.26/1.28 ещё много. Я оставляю HTTP/1.1, очищенный Connection и явный keepalive: намерение видно при ревью. Переносимый keepalive 64 на 1.30+ может делить кеш между location; если нужна новая изоляция, пишите keepalive 64 local, но старые версии local не знают. Backend без persistent connections сначала придётся исправить или заменить.
Вторым шагом расширяю ip_local_port_range именно в namespace сервиса, если расчёт и тест показывают нужный запас. Нижнюю границу нельзя выбирать вслепую: сверяю локальные listeners и ip_local_reserved_ports. Диапазон 10240 65535 дал 55 296 значений и подошёл нашему стенду, но это не универсальный рецепт. Docker Compose умеет задавать namespaced net.* через sysctls; после redeploy я обязательно читаю значение из работающего namespace, а не верю YAML.
Третий шаг зависит от потолка. nf_conntrack_max — лимит flow, buckets/hashsize — размер хеша, не второй лимит; один flow считается один раз, но хешируется в обоих направлениях. Поднимать только max можно ценой длинных цепочек и CPU, поэтому читаю оба и считаю память. Для SNAT нужны дополнительные egress-IP либо маршрутизация; новый узел за тем же внешним NAT не поможет. --network host убирает Docker NAT, но не conntrack firewall, делит портовый pool с хостом и запрещает container net.* sysctl. Это архитектурное решение.
- Compose: `services: { edge: { sysctls: { net.ipv4.ip_local_port_range: "10240 65535" }, ulimits: { nofile: { soft: 262144, hard: 262144 } } } }`; форма сокращена.
- Попавшие в диапазон сервисные порты внесите в `ip_local_reserved_ports`. Сначала прочитайте значение: запись заменяет весь список.
- Несколько реальных upstream IP увеличивают пространство удалённых tuple и дают отказоустойчивость. Один DNS VIP, один NAT gateway или пять контейнеров за одним egress-IP не равны пяти независимым путям.
- Держите `proxy_set_header` в одном include: при любой такой директиве в `location` родительский набор не наследуется. Общий WebSocket-map с `Connection: close` тоже убивает keepalive обычного HTTP; WebSocket location я отделяю.
- Для conntrack алертируйте count/max, скорость роста, `early_drop`, `drop` и kernel log; `insert_failed` отдельно может означать tuple collision. Настройки меняйте на хосте.
Что оставить в мониторинге после ремонта
После успешного теста я оставляю четыре временных ряда: частоту EADDRNOTAVAIL в error.log, TCP states в namespace Nginx, скорость создания соединений к каждому upstream и conntrack count/max с ошибками на хосте. Одного stub_status мало: он показывает клиентские соединения, но не upstream pool и TIME-WAIT. Метрика должна сохранять source IP и destination IP:port, иначе перегретая пара потеряется в общей сумме.
Порог я привязываю к проверенному профилю. Для такого портового пула начинаю предупреждение примерно при 70 % доступного диапазона и аварийный уровень при 85 %, если рост устойчивый; для conntrack использую похожие стартовые ориентиры, но добавляю прогноз времени до заполнения. Это не стандарты Linux, а эксплуатационные границы, которые дают дежурному время. Если normal load уже держится на 65 %, не поднимайте порог до 95 % — уменьшайте churn или добавляйте адресное пространство.
Итого мой порядок жёсткий: точный errno и effective config; сокеты и порты внутри контейнера; затем conntrack и NAT на хосте; только потом изменение настроек. В большинстве HTTP-прокси, которые я видел, явный и рассчитанный upstream keepalive даёт больше, чем десяток сетевых sysctl. На nofile можно перестать смотреть, когда фактические FD низкие и в логе код 99. На NAT нельзя забить, если несколько контейнеров выходят через один адрес к одному внешнему API. Всё остальное — уже оптимизация после измерений.
- Контейнер: `ip_local_port_range`, `TCP_tw`, `established`, `syn-sent`, число flow по каждой паре source IP → destination IP:port.
- Nginx: rate ошибок по errno, версия и hash эффективного конфига, reload/restart как аннотация на графике.
- Хост: `nf_conntrack_count/max`, дельты статистики conntrack, packet drops и сообщения ядра.
- Нагрузка: request rate, upstream connect rate, latency и 5xx на одной временной шкале.
Частые вопросы
Почему увеличение nofile не убирает Address not available?
Это разные ресурсы. Исчерпанный `nofile` даёт errno 24 `Too many open files`; errno 99 при `connect()` без bind означает, что нет доступного ephemeral port.
Может ли переполненный conntrack дать тот же 502?
Тот же 502/504 — да, тот же механизм — обычно нет. Полный conntrack даёт drops, SYN retransmit, timeout и сообщения ядра. Немедленный errno 99 сначала ведёт в namespace контейнера.
Сколько ставить в upstream keepalive?
Измерьте активные соединения по workers и connect rate. Если метрик нет, `RPS × средняя latency` оценит активную конкуренцию, но не размер кеша. `keepalive N` — idle connections на worker.
Нужно ли вручную включать keepalive в Nginx 1.30?
С 1.29.7 для именованного upstream default — HTTP/1.1 и 32 idle-соединения на worker. Я задаю параметры явно ради рассчитанной ёмкости и совместимости со старыми образами.
Поможет ли tcp_tw_reuse или уменьшение tcp_fin_timeout?
`tcp_fin_timeout` относится к orphaned FIN-WAIT-2, не TIME-WAIT. `tcp_tw_reuse=1` ядро не советует менять без экспертного разбора; сначала устраняйте churn через HTTP keepalive.
Если Nginx под нагрузкой падает в 502, команда «АйТи-Фреш» разложит путь соединения по namespace, NAT и conntrack и найдёт фактический потолок. Мы настроим keepalive и сетевые лимиты, проведём повторный нагрузочный тест и оставим метрики, по которым проблему видно до аварии.
Бесплатная консультация →
Источники
- [connect(2) — Linux man-pages](https://man7.org/linux/man-pages/man2/connect.2.html) — EADDRNOTAVAIL при невозможности назначить ephemeral port; актуальная редакция Linux man-pages, 2026
- [IP Sysctl — документация ядра Linux](https://docs.kernel.org/networking/ip-sysctl.html) — ip_local_port_range, ip_local_reserved_ports, tcp_tw_reuse и tcp_fin_timeout; актуальная ветка документации
- [TCP constants — исходный код ядра Linux](https://github.com/torvalds/linux/blob/master/include/net/tcp.h) — TCP_TIMEWAIT_LEN равен 60 секундам; актуальная mainline-ветка исходного кода
- [Network namespaces — Linux man-pages](https://man7.org/linux/man-pages/man7/network_namespaces.7.html) — Изоляция сетевого стека, сокетов, портов и /proc/sys/net между namespace; редакция 2026
- [Netfilter Conntrack Sysfs variables — ядро Linux](https://docs.kernel.org/networking/nf_conntrack-sysctl.html) — nf_conntrack_count, nf_conntrack_max, buckets и таймауты; актуальная документация 2026
- [Исходный код Netfilter conntrack и NAT](https://github.com/torvalds/linux/tree/master/net/netfilter) — Поведение при заполнении таблицы, early eviction, NF_DROP и подбор уникального NAT tuple; mainline Linux
- [conntrack(8) — Netfilter](https://netfilter.org/projects/conntrack-tools/conntrack-manpage.html) — Официальный синтаксис count, stats, фильтров src-nat и state для conntrack-tools
- [iptables-extensions(8)](https://man7.org/linux/man-pages/man8/iptables-extensions.8.html) — Семантика SNAT и MASQUERADE, выбор translated source port; актуальная Linux man-pages
- [Модуль ngx_http_upstream_module — Nginx](https://nginx.org/en/docs/http/ngx_http_upstream_module.html#keepalive) — keepalive, keepalive_requests, keepalive_timeout; изменение значений по умолчанию с 1.29.7
- [Модуль ngx_http_proxy_module — Nginx](https://nginx.org/en/docs/http/ngx_http_proxy_module.html#proxy_http_version) — proxy_http_version, proxy_set_header, proxy_bind и proxy_socket_keepalive; документация актуальна для 1.31
- [Core functionality — Nginx](https://nginx.org/en/docs/ngx_core_module.html#worker_connections) — worker_connections и worker_rlimit_nofile; актуальная документация Nginx
- [Официальные релизы Nginx 2026](https://nginx.org/2026.html) — 1.30.4 stable от 15.07.2026 и 1.31.5 mainline от 02.09.2026; проверено 05.09.2026
- [Nginx: upstream keepalive по умолчанию с 1.29.7](https://blog.nginx.org/blog/keep-alive-to-upstreams-is-now-default-in-nginx-1-29-7) — Официальное объявление от 24.03.2026: HTTP/1.1, кеш 32 соединения на worker и параметр local
- [Docker: Port publishing and mapping](https://docs.docker.com/engine/network/port-publishing/) — Bridge NAT, MASQUERADE, routed mode и исходящий адрес контейнера; документация 2026
- [Docker Engine 29 release notes](https://docs.docker.com/engine/release-notes/29/) — Версии Docker Engine 29.x, включая 29.6.2 от 16.07.2026; проверено 05.09.2026
- [Docker: Host network driver](https://docs.docker.com/engine/network/drivers/host/) — Общий network namespace с хостом, отсутствие Docker NAT и ограничения host mode; документация 2026
- [Docker Compose services reference](https://docs.docker.com/reference/compose-file/services/#sysctls) — Синтаксис sysctls и ulimits, ограничение namespaced-параметрами; документация 2026