
Почему WebSocket за nginx живёт ровно минуту
Если WebSocket подключается, получает `101 Switching Protocols`, а через 60 секунд тишины отваливается, я первым делом проверяю `proxy_read_timeout`. Обычные страницы при этом совершенно закономерно работают: они успевают закончить HTTP-запрос задолго до тайм-аута. Я, Семёнов Евгений Сергеевич, директор ООО «АйТи-Фреш», разберу всю цепочку — от Upgrade до heartbeat — и покажу конфигурацию, которую использую сам.
Ровно 60 секунд — это уже почти диагноз
Когда разработчик говорит мне: «Сокет иногда рвётся», вариантов действительно много. Когда он добавляет: «Примерно через минуту, если ничего не происходит», круг подозреваемых резко сужается. У proxy_read_timeout в nginx значение по умолчанию — 60 секунд. Директива определяет не максимальную продолжительность WebSocket-сессии, а допустимый промежуток между двумя операциями чтения данных от upstream-сервера. Если приложение ничего не передало nginx за этот интервал, nginx закрывает соединение.
Именно направление потока здесь чаще всего понимают неправильно. Upstream — это ваше WebSocket-приложение за nginx. Документация nginx формулирует условие обрыва так: соединение закрывается, если с проксируемого сервера данные не передавались в течение 60 секунд. Поэтому надёжный способ держать канал — данные в обратном направлении: от приложения через nginx к клиенту. Это может быть полезное событие, WebSocket Ping или ответ приложения на клиентский heartbeat. Одностороннее «молчаливое» сообщение от браузера к приложению по документации таймер не сбрасывает, и я на такое поведение не рассчитываю.
Обычная страница живёт иначе. Браузер отправил запрос, приложение вернуло HTML или JSON за 200 миллисекунд, запрос завершился. Никакой минуты ждать не требуется. WebSocket после рукопожатия остаётся открытым часами, поэтому впервые сталкивается с тайм-аутом тишины. Это не загадочная несовместимость nginx с WebSocket и обычно не проблема TLS.
- Обрыв около 60 секунд при отсутствии серверных сообщений — сначала проверяю `proxy_read_timeout`.
- Обрыв через одинаковый другой интервал — ищу соответствующий idle timeout на балансировщике, firewall, ingress или в приложении.
- Разброс от нескольких секунд до нескольких минут — проверяю сеть, перезапуски процесса, перегрузку event loop и клиентскую логику reconnect.
Что делают Upgrade и ответ 101
WebSocket начинается как HTTP-запрос. Клиент просит сменить протокол заголовком Upgrade: websocket и указывает Connection: Upgrade. Сервер, согласившись, отвечает HTTP-статусом 101 Switching Protocols, после чего по тому же TCP-соединению идут уже WebSocket-фреймы. Код 101 означает только успешное переключение протокола. Он не резервирует соединение навечно, не отключает тайм-ауты и не является WebSocket-кодом закрытия вроде 1000 или 1006.
Заголовки Upgrade и Connection относятся к hop-by-hop: обычный HTTP-прокси не обязан передавать их следующему узлу. Поэтому nginx должен сформировать их для upstream явно. Если этого не сделать, приложение обычно увидит простой HTTP-запрос и вернёт 200, 400 или 426. В таком случае WebSocket вообще не установился. Если же в DevTools уже виден 101, базовая механика Upgrade сработала; минутный последующий обрыв надо диагностировать отдельно.
Я использую map, а не безусловный Connection "upgrade" во всём виртуальном хосте. Для запросов без заголовка Upgrade переменная принимает значение close, а для WebSocket — upgrade. Так обычный HTTP-трафик не получает бессмысленную команду переключения. map размещается в контексте http, а не внутри server или location.
- Запрос с Upgrade дошёл до nginx.
- nginx явно передал Upgrade и Connection приложению.
- Приложение подтвердило переход корректным ответом 101.
- После 101 nginx туннелирует WebSocket-фреймы, но продолжает применять тайм-ауты ввода-вывода.
Какой тайм-аут за что отвечает
proxy_connect_timeout ограничивает установление соединения nginx с upstream. Он важен, когда backend недоступен или медленно принимает TCP-соединение, но к обрыву уже работающего WebSocket через минуту отношения не имеет. proxy_send_timeout действует между операциями записи запроса в upstream, то есть в направлении от nginx к приложению. proxy_read_timeout действует между операциями чтения ответа от upstream — это главный кандидат при серверной тишине.
keepalive_timeout часто меняют по привычке, но он управляет HTTP keep-alive между отдельными запросами клиента. После успешного Upgrade это уже не ожидание следующего HTTP-запроса, поэтому лечить им минутный WebSocket-обрыв я не советую. client_body_timeout тоже мимо: у рукопожатия WebSocket нет долго загружаемого тела. send_timeout может закрыть соединение, если nginx слишком долго не способен передать данные клиенту, например клиент перестал читать, но это другая неисправность.
Важно, что тайм-аут считается не на всю передачу и не от момента подключения. Каждый принятый от upstream фрагмент данных запускает отсчёт заново. Сокет может жить месяц при регулярном трафике и закрыться через 60 секунд во время первой спокойной паузы. Поэтому ошибка иногда проявляется только ночью, на экране ожидания или у пользователей, которым редко приходят события.
TCP keepalive я не считаю заменой heartbeat. Он работает ниже WebSocket, имеет отдельные системные интервалы и прежде всего помогает обнаруживать неотвечающий TCP-узел. Приложению всё равно полезно знать, отвечает ли WebSocket-клиент, а nginx нужен своевременный поток данных от upstream. Протокольный Ping решает обе задачи понятнее.
Отдельная история — балансировщики перед nginx. У каждого свой idle timeout, и срабатывает самый короткий. Application Load Balancer в AWS по умолчанию закрывает простаивающее соединение через 60 секунд — симптом неотличим от proxy_read_timeout, хотя nginx здесь ни при чём. В HAProxy для туннелей после Upgrade действует timeout tunnel, а если он не задан — timeout client/timeout server. В Kubernetes ingress-nginx тайм-ауты задаются аннотациями nginx.ingress.kubernetes.io/proxy-read-timeout и proxy-send-timeout (в секундах), а не правкой конфига внутри пода. Поэтому я сначала рисую маршрут от браузера до приложения и выписываю лимит каждого узла, и только потом выбираю период heartbeat — он должен быть меньше минимального из них.
- Handshake не состоялся — проверяйте HTTP/1.1, Upgrade, Connection и ответ приложения.
- Handshake состоялся, но upstream молчит — проверяйте `proxy_read_timeout`.
- nginx не может передать данные приложению — смотрите `proxy_send_timeout` и состояние backend.
- Соединение переживает nginx, но рвётся на другом интервале — составляйте карту всех промежуточных idle timeout.
- Обрыв ровно через 60 секунд при уже увеличенном `proxy_read_timeout` — проверяйте балансировщик или ingress перед nginx: у многих из них тоже дефолт 60 секунд.
Практика: юридическая консультация «Правовая опора», 30 рабочих мест
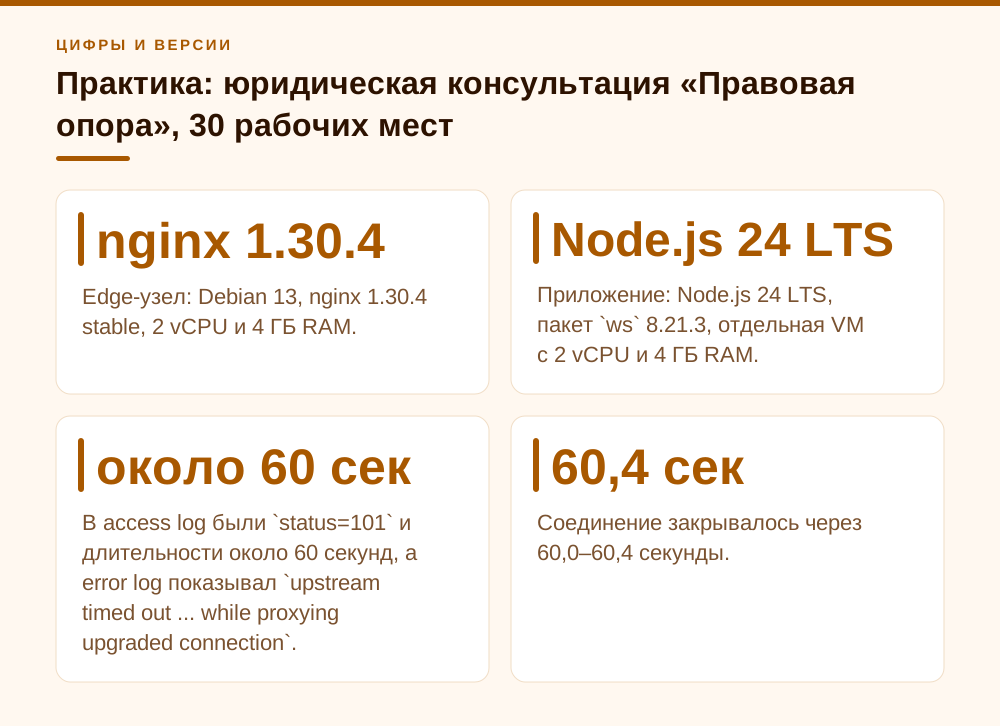
Покажу внедрение, в котором я разбирал проблему руками. «Правовая опора» — условное название юридической консультации на 30 рабочих мест, а не раскрытие клиента. Юристы и помощники работали во внутреннем веб-приложении учёта дел: через WebSocket приходили уведомления о новых документах, изменениях сроков и сообщения внутреннего чата. Обычно держалось 34–46 одновременных соединений — у части сотрудников было открыто по две вкладки. Edge-узел: Debian 13, nginx 1.30.4 stable, 2 vCPU и 4 ГБ RAM. Приложение: Node.js 24 LTS, пакет ws 8.21.3, отдельная VM с 2 vCPU и 4 ГБ RAM. Такой объём не требовал серьёзного железа: загрузка CPU nginx оставалась ниже 2 %.
События в карточках дел приходили нерегулярно — днём раз в несколько минут, во время судебных заседаний и обеда ещё реже. Фронтенд переподключался автоматически, поэтому сотрудники видели только мигание индикатора «нет связи» и иногда пропускали всплывающее уведомление о сроке. Зато сервер авторизации получал несколько тысяч повторных запросов за рабочий день. В access log были status=101 и длительности около 60 секунд, а error log показывал upstream timed out ... while proxying upgraded connection. Это сочетание сразу отделило успешное рукопожатие от последующего тайм-аута.
Исходная конфигурация выглядела правдоподобно, но в ней не было ни явного proxy_read_timeout, ни heartbeat на backend:
location /ws/ {
    proxy_pass http://127.0.0.1:8080;
    proxy_http_version 1.1;
    proxy_set_header Upgrade $http_upgrade;
    proxy_set_header Connection "upgrade";
}
На nginx 1.30 HTTP/1.1 уже является значением по умолчанию для проксирования: это изменение появилось в 1.29.7. Я всё равно оставляю proxy_http_version 1.1 явно. Конфиг тогда одинаково читается на старых и новых узлах, а его назначение не приходится угадывать.
Мы воспроизвели обрыв на тестовом пользователе, отключив бизнес-события. Соединение закрывалось через 60,0–60,4 секунды. После добавления серверного Ping раз в 25 секунд и установки proxy_read_timeout 75s провели 72-часовую проверку. Ошибок upstream timed out для WebSocket не осталось. Было 5 переподключений из-за сна ноутбуков и смены сети — это нормальные обрывы, которые клиент обязан уметь переживать. Пиковые 58 соединений не дали заметного роста CPU или памяти.
- Зафиксировали точный интервал жизни соединения.
- Проверили 101 и заголовки рукопожатия.
- Сопоставили время обрыва с error log nginx.
- Добавили heartbeat на сервере и запас между его периодом и тайм-аутом.
- Повторили тест дольше одного рабочего дня, включая периоды без бизнес-событий.
Конфигурация, которую я выбираю
Для этого класса систем я выбираю серверный Ping каждые 25 секунд и proxy_read_timeout 75s. Три интервала дают запас на паузу event loop, краткий сетевой джиттер и плановую нагрузку. Интервал в одну секунду создаёт ненужный шум, а раз в пять минут уже не проходит через многие прокси. Универсального числа в стандарте нет: 25/75 секунд — моё эксплуатационное решение, а не требование RFC.
Полный фрагмент nginx выглядит так:
# Контекст http
map $http_upgrade $connection_upgrade {
    default upgrade;
    ''      close;
}

upstream realtime_backend {
    server 127.0.0.1:8080;
}

server {
    listen 443 ssl;
    server_name app.example.ru;

    location /ws/ {
        proxy_pass http://realtime_backend;
        proxy_http_version 1.1;

        proxy_set_header Host $host;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection $connection_upgrade;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;

        proxy_read_timeout 75s;
        proxy_send_timeout 75s;
    }
}
Я не добавляю proxy_buffering off как магическое средство: специальный туннель включается после 101, и минутный idle timeout эта директива не исправляет. Также не размазываю многочасовой тайм-аут на весь server; правило относится только к WebSocket-location.
На Node.js серверный heartbeat можно реализовать по образцу библиотеки ws:
import WebSocket, { WebSocketServer } from 'ws';

const wss = new WebSocketServer({ port: 8080 });

function markAlive() {
  this.isAlive = true;
}

wss.on('connection', (socket) => {
  socket.isAlive = true;
  socket.on('pong', markAlive);
  socket.on('error', console.error);
});

const heartbeat = setInterval(() => {
  for (const socket of wss.clients) {
    if (socket.readyState !== WebSocket.OPEN) continue;
    if (socket.isAlive === false) {
      socket.terminate();
      continue;
    }
    socket.isAlive = false;
    socket.ping();
  }
}, 25_000);

wss.on('close', () => clearInterval(heartbeat));
Серверный Ping проходит от upstream к nginx и сбрасывает proxy_read_timeout. Клиент по RFC обязан ответить Pong, а ws и браузерный стек делают это автоматически. Полученный Pong позволяет приложению отметить клиента живым; если ответа нет, соединение завершается на следующей проверке.
Браузерный JavaScript не предоставляет метода для отправки протокольного Ping. Если архитектура требует heartbeat именно со стороны страницы, приходится посылать обычное сообщение, например {"type":"ping"}, и обязательно отвечать на него с сервера. Один клиентский ping без серверного pong не создаёт трафика upstream → nginx, а документация nginx связывает тайм-аут именно с данными от проксируемого сервера — такой heartbeat задачу proxy_read_timeout гарантированно не решает. Я предпочитаю серверный протокольный Ping: так же рекомендует и сама документация nginx, прикладного кода меньше, и сразу есть проверка живости клиента.
- Период heartbeat должен быть заметно меньше минимального idle timeout.
- Heartbeat обязан идти через всю ту же WebSocket-цепочку, которую он контролирует.
- Отсутствующий Pong должен приводить к очистке соединения, а не только к записи предупреждения.
- Клиент всё равно должен поддерживать reconnect с задержкой и случайным разбросом.
Как проверить результат и не поймать проблему снова
Сначала я проверяю итоговую, а не исходную конфигурацию. include и правила более точного location нередко переопределяют то, что разработчик смотрит в одном файле. Затем валидирую конфиг и выполняю штатную перезагрузку:
sudo nginx -T
sudo nginx -t && sudo nginx -s reload
В выводе nginx -T ищите фактически применившиеся proxy_read_timeout, proxy_http_version и заголовки внутри нужного location.
Рукопожатие можно увидеть так:
curl --http1.1 -i -N \
  -H 'Connection: Upgrade' \
  -H 'Upgrade: websocket' \
  -H 'Sec-WebSocket-Version: 13' \
  -H 'Sec-WebSocket-Key: dGhlIHNhbXBsZSBub25jZQ==' \
  https://app.example.ru/ws/
Для приложения с авторизацией добавьте его cookie или bearer-токен. Важны ответ 101, Upgrade: websocket и корректный Sec-WebSocket-Accept. После этого соединение надо оставить открытым минимум на несколько тайм-аутов и посмотреть WebSocket-фреймы в DevTools: при выбранной схеме Ping будет появляться примерно каждые 25 секунд.
В эксплуатации я записываю $status, $request_time, $upstream_status и $upstream_response_time. Access log для долгого WebSocket обычно появляется после завершения соединения, поэтому request_time хорошо показывает подозрительные кластеры около 60 или 75 секунд. Одновременно нужны метрики числа активных сокетов, reconnect, Ping/Pong и задержки event loop. Иначе после исправления nginx можно пропустить зависший backend.
На что можно забить в первой итерации: тонкую настройку TCP keepalive, экзотические параметры буферов и попытки купить больше CPU. Для сотни или даже нескольких тысяч лёгких соединений проблема обычно не в железе. Сначала добейтесь корректного Upgrade, выберите осмысленный heartbeat, настройте тайм-ауты на каждом промежуточном узле и проверьте длинную сессию. Уже потом оптимизируйте.
- 101 подтверждает только завершение handshake.
- Ping от сервера поддерживает направление upstream → nginx.
- Pong подтверждает, что клиентский endpoint отвечает.
- Нулевое число минутных обрывов проверяется логами и длительным тестом, а не ощущением в браузере.
- Reconnect необходим даже при идеальной настройке: сеть всё равно иногда исчезает.
Частые вопросы
Почему страницы работают, а WebSocket обрывается?
Страница завершает HTTP-запрос сразу после ответа. WebSocket остаётся открытым и при отсутствии данных от upstream впервые упирается в `proxy_read_timeout`, который по умолчанию равен 60 секундам.
Достаточно ли получить код 101?
Нет. 101 подтверждает успешное переключение с HTTP на WebSocket, но не отменяет тайм-ауты nginx и других узлов маршрута.
Сбрасывает ли клиентское сообщение proxy_read_timeout?
Полагаться на это нельзя. Документация nginx закрывает соединение, если данные не передавались с проксируемого сервера. Надёжно тайм-аут сбрасывают данные от upstream к nginx: серверный Ping, бизнес-событие или ответ на прикладной heartbeat клиента.
Можно ли просто установить proxy_read_timeout 24h?
Технически можно, но я так не делаю. Длинный тайм-аут скрывает полумёртвые соединения. Лучше умеренный запас плюс heartbeat и удаление клиентов, не отвечающих Pong.
Нужен ли proxy_http_version 1.1 в nginx 1.30?
Начиная с nginx 1.29.7 HTTP/1.1 используется для proxy по умолчанию. Я всё равно задаю директиву явно для читаемости и переносимости конфигурации на старые узлы.
Я увеличил proxy_read_timeout, а обрыв через 60 секунд остался. Почему?
Скорее всего, лимит стоит перед nginx: облачный балансировщик (у AWS ALB idle timeout по умолчанию 60 секунд), HAProxy без `timeout tunnel` или ingress-контроллер со своими аннотациями. Проверьте итоговый конфиг через `nginx -T` и каждый узел маршрута.
Источники
- nginx: Проксирование WebSocket — Официальная документация nginx: map $http_upgrade $connection_upgrade, заголовки Upgrade/Connection, закрытие через 60 секунд без данных с проксируемого сервера и ping-фреймы как решение: https://nginx.org/ru/docs/http/websocket.html
- nginx: модуль ngx_http_proxy_module — Директивы proxy_read_timeout, proxy_send_timeout, proxy_connect_timeout (дефолт 60s) и proxy_http_version (1.1 по умолчанию с 1.29.7): https://nginx.org/ru/docs/http/ngx_http_proxy_module.html
- nginx News 2026 — Официальная лента релизов; nginx 1.30.4 stable и 1.31.5 mainline на дату подготовки статьи: https://nginx.org/2026.html
- RFC 6455: The WebSocket Protocol — Разделы 1.2, 4 и 5.5: handshake, 101 Switching Protocols, Ping и Pong: https://www.rfc-editor.org/rfc/rfc6455.html
- RFC 9110: HTTP Semantics — Раздел 7.8 (поле Upgrade) и раздел 15.2.2 (статус 101 Switching Protocols): https://www.rfc-editor.org/rfc/rfc9110.html#name-101-switching-protocols
- ws: README — Официальный пример heartbeat (Ping раз в 30 секунд, флаг isAlive, terminate) из раздела «How to detect and close broken connections?» библиотеки ws: https://github.com/websockets/ws/blob/master/README.md#how-to-detect-and-close-broken-connections
- Node.js Releases — Официальный жизненный цикл релизов Node.js и статус ветки 24 LTS: https://nodejs.org/en/about/previous-releases
- WebSockets Standard — WHATWG Living Standard, браузерный WebSocket API и обработка Ping/Pong пользовательским агентом: https://websockets.spec.whatwg.org/