
Репликация Proxmox стоит «раз в минуту», а после отказа узла пропали данные за двое суток: как так вышло
Интервал «раз в минуту» в репликации Proxmox — это расписание, а не гарантия свежести. После первой же ошибки задание уходит в повтор раз в 30 минут, а если причина не исчезла, реплика стареет часами и сутками. Ниже — как считать реальную потерю данных, как заметить сбой до аварии и что я настраиваю в кластерах малых офисов.
Что на самом деле означает «репликация раз в минуту»
Начну с того, что меня до сих пор веселит в аудитах. Открываешь кластер, видишь в задании репликации расписание на одну минуту, и администратор уверенно говорит: «У нас потеря данных не больше минуты». Такая уверенность держится ровно до первого сбоя. Мы в АйТи-Фреш занимаемся внедрением open-source решений вроде Proxmox, и разговор про «минуту» я веду с каждым заказчиком, у которого кластер на локальном ZFS без общего хранилища.
Сначала о том, что известно твёрдо. Согласно документации Proxmox VE, минимальный интервал репликации — одна минута, максимальный — раз в неделю, а в интерфейсе по умолчанию стоит 15 минут. Формат расписания — подмножество календарных событий systemd. После первичной синхронизации, когда на второй узел уезжает весь диск, дальше передаются только изменения, накопленные с момента предыдущей репликации. Это и есть красота схемы: дешёвая копия без общего хранилища и без SAN.
Теперь о том, чего документация не обещает. Нигде не написано, что реплика на втором узле всегда отстаёт не более чем на интервал. Интервал — это как часто Proxmox пытается синхронизироваться. Получится ли у него, зависит от сети, свободного места на целевом пуле, загрузки дисков и от того, успела ли предыдущая синхронизация закончиться. Расписание описывает намерение, а не результат. В той же документации прямо сказано: репликацию можно сочетать с высокой доступностью, но между временем последней синхронизации и моментом отказа узла возможна потеря данных.
Поэтому правильный вопрос звучит не «какой у нас интервал», а «сколько времени прошло с последней успешной синхронизации прямо сейчас». Первое число вы выбрали в мастере. Второе живёт своей жизнью, и в большинстве кластеров малого бизнеса его никто не смотрит. Для планового переезда это не проблема: если гостя мигрируют на узел, где уже есть его реплика, отправляются только изменения, а направление репликации переключается само. Проблема начинается, когда узел умер без предупреждения.
- интервал задания — как часто Proxmox пробует синхронизироваться, а не гарантия результата
- минимум — 1 минута, максимум — раз в неделю, значение по умолчанию в интерфейсе — 15 минут
- реальная свежесть реплики — время с момента последней успешной синхронизации
- при аварийном отказе узла возможна потеря всего, что накопилось после последней удачной синхронизации
Что происходит с заданием после первой ошибки
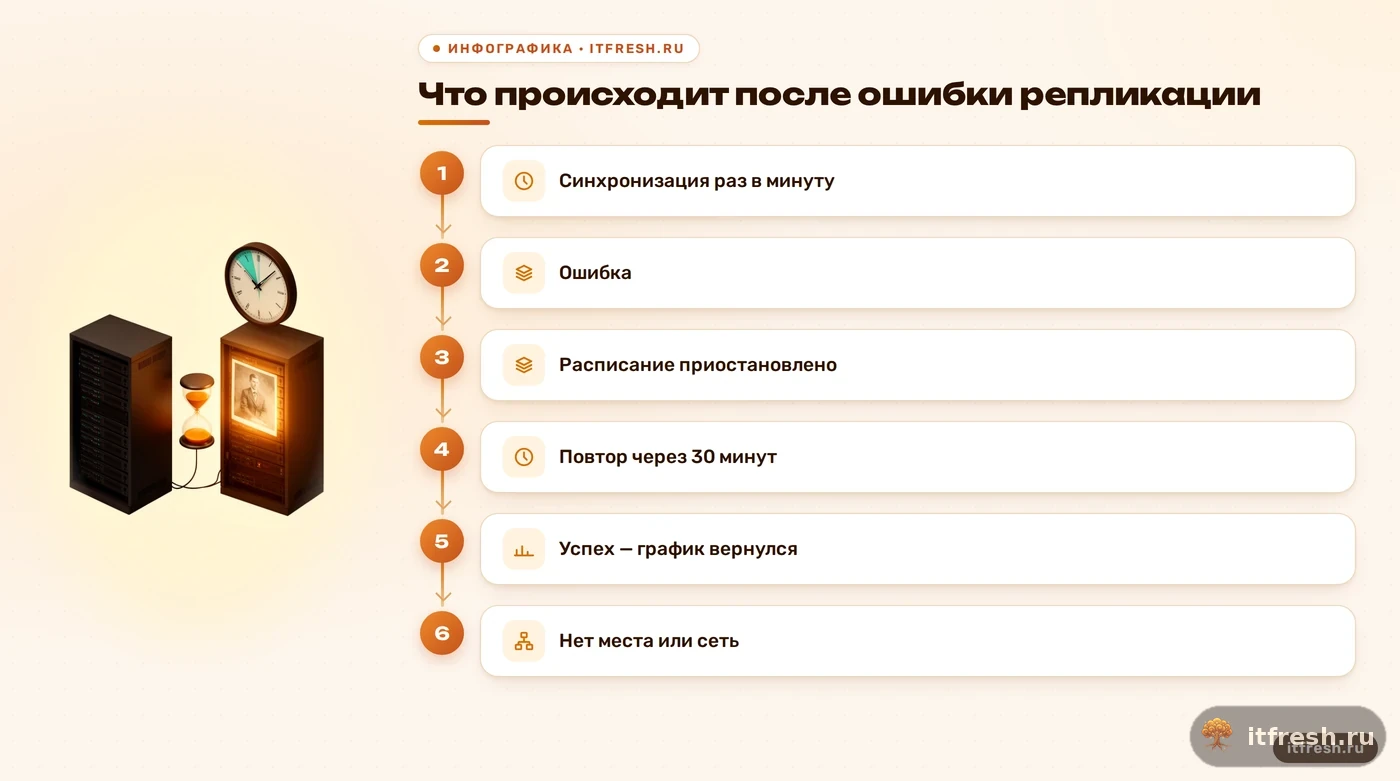
Вот тот самый абзац из документации, который почти никто не читает. Если репликация завершилась ошибкой, задание переходит в состояние ошибки, штатное расписание временно приостанавливается, а неудачная репликация повторяется раз в 30 минут. Когда попытка наконец удаётся, возвращается обычный график. Иными словами, ваша «минута» после первого сбоя превращается в «полчаса», причём без какого-либо шума: виртуальные машины работают, пользователи довольны, а в панели репликации тихо горит красный статус.
Среди типичных причин документация называет три: проблемы сети, отсутствие свободного места на целевом хранилище и отсутствие на целевом узле хранилища с тем же идентификатором. Третья причина особенно коварна. Её ловят после добавления нового узла или после «аккуратной» переделки хранилищ: на одном узле пул называется так, на другом иначе, и репликация молча перестаёт работать. Первая причина обычно возникает, когда сеть для репликации делит канал с пользовательским трафиком или с резервным копированием. Вторая — когда ZFS-пул забит снимками и данными до отказа.
Важная деталь, которую упускают: пока причина не устранена, повторы по 30 минут ничего не лечат. Они просто будут падать снова и снова. Если на целевом пуле нет места, то хоть каждые полчаса, хоть каждую минуту результат один. Поэтому слова «повтор через 30 минут» не надо понимать как «само починится». Само чинится только то, что сломалось временно, например короткий обрыв коммутатора.
Есть и ещё один эффект, который я видел вживую. Чем дольше реплика не обновлялась, тем больше накопилось изменений и тем тяжелее будет первая успешная синхронизация. Диск, который за минуту менялся на пару мегабайт, за двое суток меняется на гигабайты, и это передаётся по тому же самому каналу, который, возможно, и был причиной сбоя. Тут можно ограничить скорость задания, чтобы синхронизация не задушила рабочий трафик: в документации для этого есть параметр rate, в примере он равен 10 и означает мегабайты в секунду.
Разбор: как музыкальная школа потеряла двое суток записей при исправном кластере
Условный клиент — музыкальная школа «Скрипичный ключ», 29 рабочих мест. Два узла Proxmox VE на локальном ZFS и третий голос кворума на маленьком внешнем устройстве, всё по правилам. На кластере три виртуальные машины: сервер 1С с расписанием и учётом оплат, файловый сервер с методическими материалами и контроллер домена. Для первых двух стояли задания репликации с узла A на узел B с интервалом в одну минуту, высокая доступность была включена. Администратор, приходящий раз в неделю, считал, что школа защищена от отказа сервера практически без потерь. Схема на бумаге выглядела безупречно.
Что произошло на деле. В пятницу вечером на целевом пуле узла B закончилось место: туда же складывались копии из другого задания, о котором все забыли. Репликация обеих машин упала в ошибку, расписание в минуту приостановилось, задания пошли на повторы раз в 30 минут и каждый раз падали по той же причине. Письма об этом никуда не уходили, потому что оповещения никто не настраивал. Школа в выходные работает: в субботу занятия, преподаватели вносили в 1С записи об оплатах и переносах уроков. Узел A продолжал спокойно жить, и никому в голову не приходило смотреть в панель.
В понедельник около 8:40 узел A ушёл в аппаратный сбой, в логах осталась только перезагрузка контроллера питания. Кворум сохранился благодаря третьему голосу, высокая доступность отработала так, как и обещано: через пару минут обе машины стартовали на узле B. Документация описывает типичное время обнаружения отказа и переключения как около двух минут, и это совпало. Только стартовали они с реплики, которая застыла в пятницу. Сервер 1С поднялся, пользователи зашли и увидели базу, в которой нет всего, что внесли с пятничного вечера: примерно 58 часов работы, включая субботние занятия и оплаты.
Спасла школу не репликация, а выгрузка базы 1С по расписанию на отдельное сетевое хранилище, которую мы настроили как раз по схеме из статьи про резервное копирование 1С без потерь. Свежая выгрузка была от 2:00 понедельника, и между ней и сбоем в школе никто не работал. Базу подняли из выгрузки, на это ушло около трёх часов с проверкой, файловый сервер подняли из пятничной реплики и досинхронизировали документы с рабочих мест. Прямые потери — три часа простоя в понедельник утром. Могло быть иначе: если бы выгрузок не было, школа пересобирала бы платежи по бумажным квитанциям. Репликация — это не резервная копия, и этот случай очень хорошо показывает, почему.
Если хотите узнать свою цифру до того, как её назовёт авария, напишите нам: мы проверим задания репликации, место на пулах и сеть за один рабочий день и скажем, сколько данных вы потеряете сегодня.
Как посчитать реальную потерю данных (RPO), а не интервал из мастера
Я считаю потерю данных по простой модели. Максимальный возраст реплики в штатном режиме — интервал плюс время самой синхронизации. Если интервал одна минута, а синхронизация при нагрузке занимает 40 секунд, в худшем случае при отказе вы теряете чуть меньше двух минут. Это хорошая цифра, и она работает, пока всё здорово. Для 1С на 29 пользователей, где за минуту пишутся единицы документов, это почти ничто.
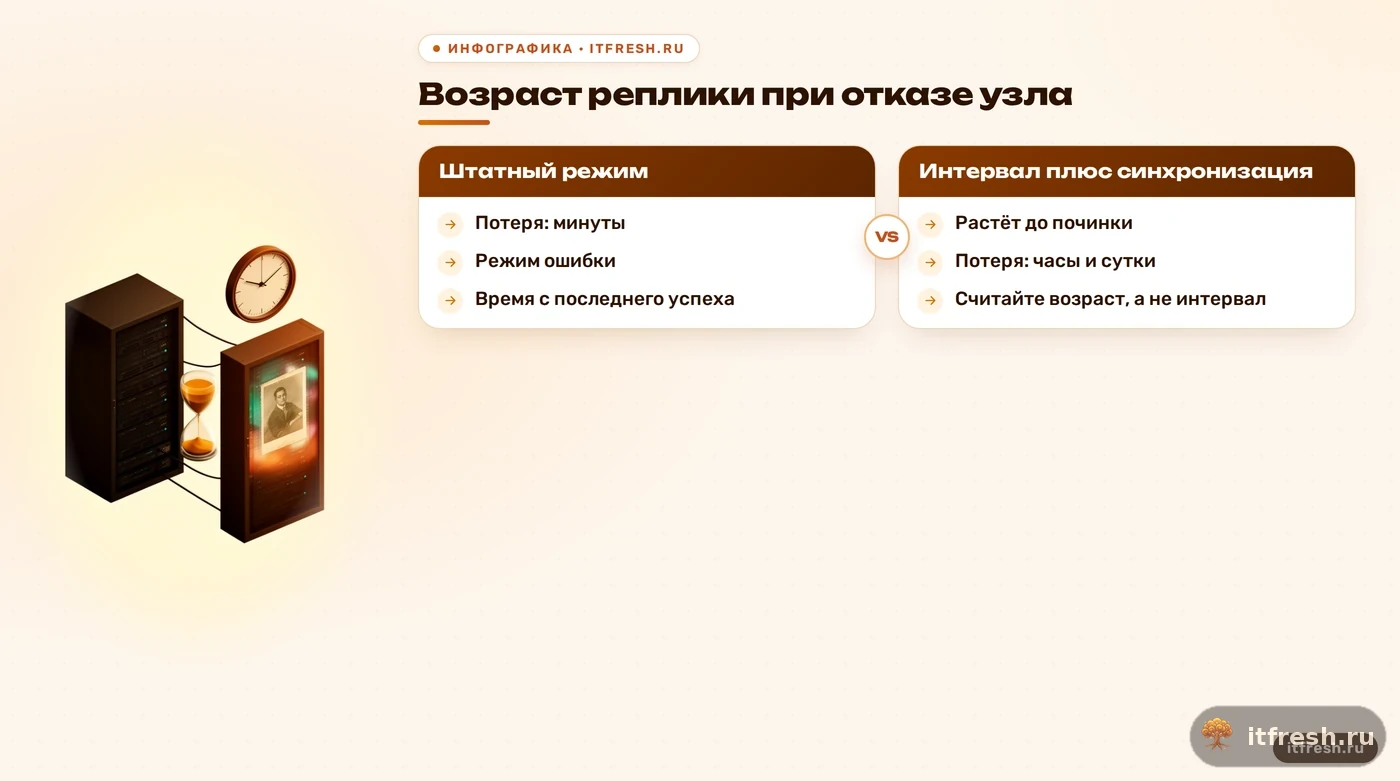
В режиме ошибки считать надо иначе. Возраст реплики равен времени с последней успешной синхронизации, а оно растёт, пока не устранена причина. После упавшей синхронизации ваш минутный график приостанавливается, и неудачная репликация повторяется раз в 30 минут. Значит, к времени устранения причины прибавляется ещё до получаса ожидания очередной попытки, плюс время самой синхронизации накопленных изменений. Я намеренно не пишу здесь универсальных чисел: они зависят от объёма изменений и канала. Важна структура: реальная потеря равна всему, что произошло с момента последней удачной синхронизации, а не интервалу.
Сравните три ситуации в таблице, чтобы увидеть разницу.
| Ситуация | Что с заданием | Возраст реплики при отказе узла |
|---|---|---|
| Всё исправно | Работает по расписанию в 1 минуту | Порядка интервала плюс время синхронизации |
| Короткий обрыв сети | Ошибка, затем повтор через 30 минут, после успеха расписание возвращается | До получаса и немного больше |
| Пул на целевом узле заполнен | Постоянная ошибка, повторы каждые 30 минут не помогают | Растёт, пока не освободите место: часы, сутки, выходные |
Из таблицы следует неприятный вывод про планирование. Если для бизнеса допустимая потеря — пять минут, то выбрать интервал в минуту недостаточно. Нужно ещё и следить за состоянием заданий так, чтобы сбой был замечен и устранён раньше, чем наступит авария. Если допустимая потеря — ноль, то репликация по расписанию вообще не ваш инструмент, и разговор надо вести про общее или распределённое хранилище, например про гиперконвергентный кластер Proxmox с Ceph. Но для школы, бухгалтерии на 15 человек и офиса с одним сервером 1С репликация с вдумчивым контролем обычно более чем достаточна.
- в штатном режиме: возраст реплики примерно равен интервалу плюс длительность синхронизации
- в режиме ошибки: возраст реплики равен времени с последней успешной синхронизации и растёт, пока не устранена причина
- после ошибки очередная попытка идёт каждые 30 минут, а не по вашему расписанию
- допустимую потерю данных определяет бизнес, а не мастер настройки
Как увидеть сбой репликации до аварии: проверки и оповещения
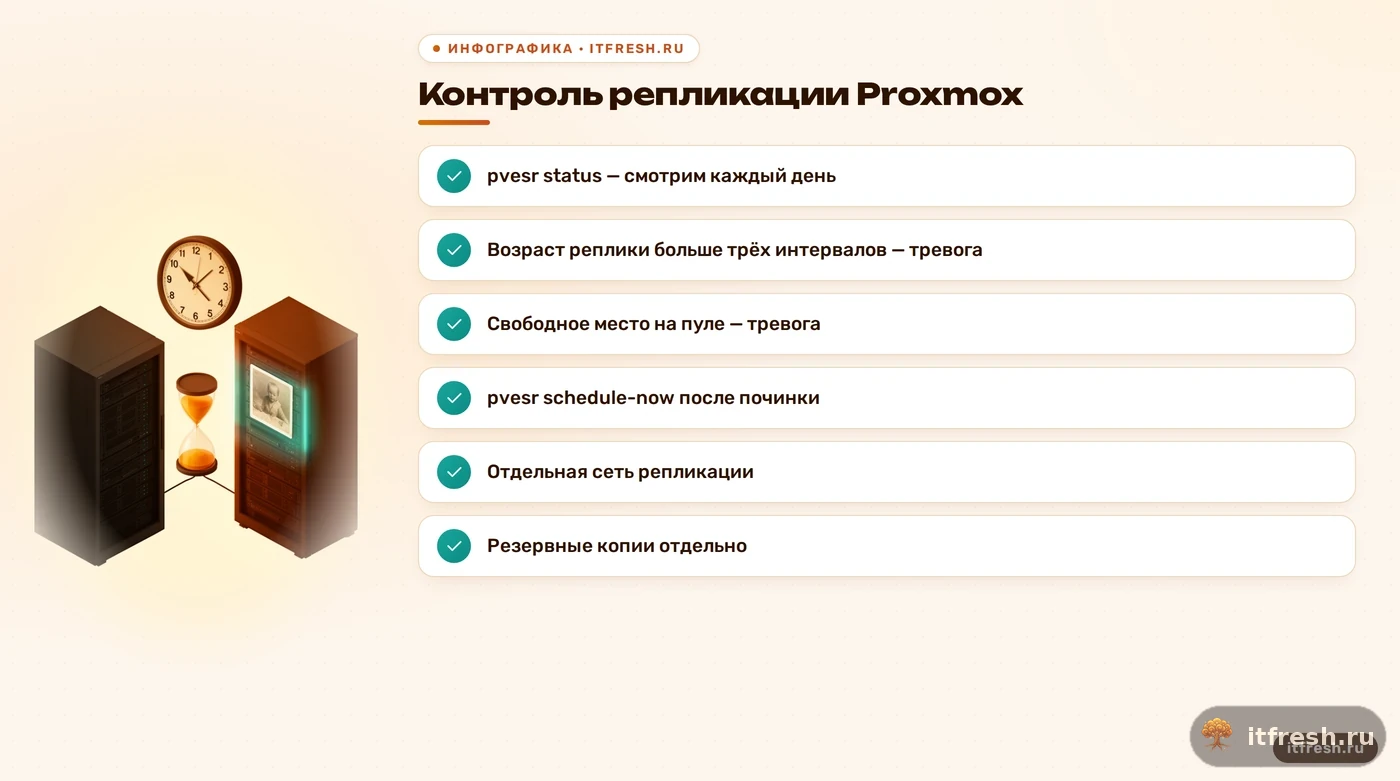
Теперь о практике. В интерфейсе Proxmox панель репликации доступна на уровне центра данных, узла и конкретного гостя, и на каждом уровне показан свой набор заданий. Обычно я смотрю на уровне центра данных: там видны все задания кластера сразу. Но интерфейс никто не открывает по утрам. Поэтому то же самое надо получать в консоли и отдавать системе мониторинга. Статус заданий выводится командой pvesr status, причём она показывает задания текущего узла, так что запускать её нужно на каждом узле-источнике (ключ --guest сужает вывод до одного гостя), а список настроенных заданий показывает pvesr list. Названия столбцов вывода сверьте в своей версии, но смотреть нужно на время последней синхронизации, время следующей попытки и счётчик неудач.
# все задания репликации и их состояние
pvesr status

# настроенные задания
pvesr list

# свободное место на пулах ZFS целевого узла
zpool list
Идентификатор задания состоит из номера гостя и номера задания, например 100-0, и нужен как раз в консоли. Если причина сбоя устранена, не ждите очередной попытки через полчаса: команда pvesr schedule-now с идентификатором задания запускает репликацию сразу. Это я использую после освобождения места на пуле или после починки сети, а потом смотрю статус ещё раз и убеждаюсь, что возврат к обычному графику состоялся.
pvesr schedule-now 100-0
pvesr status
Для мониторинга я делаю простую вещь: проверка возраста последней успешной синхронизации по каждому заданию с триггером, когда он превышает три интервала. Для минутного расписания это три минуты, для пятнадцатиминутного — 45. Отдельно заводится триггер на заполнение пула: до отказа репликации место заканчивается всегда постепенно, и его можно увидеть. Если у вас ещё нет системы, которая смотрит такие вещи, это как раз тот случай, ради которого мониторинг на Zabbix окупается первым же предотвращённым простоем. Конкретные ключи и скрипты зависят от версии и схемы, их я здесь не привожу.
Как настроить репликацию и высокую доступность, чтобы потерь было минимум
Первое: подберите интервал под реальную нагрузку, а не под красивую цифру. Если у вас 29 пользователей и один сервер 1С, пять минут часто разумнее одной: синхронизация реже наступает на пятки самой себе и меньше нагружает диски. Изменить расписание можно командой обновления задания, например pvesr update 100-0 --schedule '*/5'. Формат расписания — подмножество календарных событий systemd, и по умолчанию документация указывает */15. Минуту имеет смысл ставить, когда диски и канал это действительно тянут, а допустимая потеря измеряется минутами.
# создать задание для гостя 100 на узел pve2, каждые 5 минут, не более 10 МБ/с
pvesr create-local-job 100-0 pve2 --schedule '*/5' --rate 10

# сменить расписание существующего задания
pvesr update 100-0 --schedule '*/5'
Второе: отдельная сеть для репликации. По умолчанию трафик репликации идёт по сети миграции. Выделить отдельную подсеть можно в параметрах центра данных или записью в datacenter.cfg, в документации пример выглядит как replication: secure,network=10.1.2.0/24. Адрес подставьте свой. Отдельный канал убирает самую частую причину сбоев «сеть» и защищает пользовательский трафик от синхронизации накопленных за сутки изменений.
Третье: идентификаторы хранилищ на узлах должны совпадать, а на пулах должен быть запас. Репликация в документации поддерживается для локального ZFS, плагин zfspool, он умеет снимки. Я держу заполнение пула заметно ниже предела и не складываю на целевой узел ничего постороннего. Это скучно, но именно «ничего постороннего» губит больше кластеров, чем отказы дисков.
Четвёртое: высокая доступность. Для надёжного кворума нужно минимум три голоса, а для небольших кластеров из двух узлов третий голос даёт внешнее устройство QDevice. Подробнее о подводных камнях у меня есть разбор про флаги QDevice и кворум. И не забывайте, что HA не гарантирует запуска, если правила размещения отсекли все узлы-кандидаты: мы разбирали такую аварию в статье про правила размещения, блокирующие отказоустойчивость. Статус ресурсов смотрите командой ha-manager status.
Пятое, и главное: отдельные резервные копии с историей. Для виртуальных машин мы ставим Proxmox Backup Server на отдельное железо, а для баз 1С — выгрузки на независимое хранилище. Репликация отвечает на вопрос «как быстро поднять сервис после отказа узла», резервная копия — на вопрос «как вернуться к состоянию на вчерашний вечер». Это два разных вопроса, и у них разные ответы.
- интервал выбирайте по нагрузке и допустимой потере, а не по минимуму из мастера
- ограничивайте скорость задания параметром rate, чтобы синхронизация не душила рабочий трафик
- выделите отдельную сеть для репликации
- держите одинаковые идентификаторы хранилищ и запас места на целевом пуле
- для HA используйте не менее трёх голосов кворума
- резервные копии с историей храните отдельно от кластера
Частые вопросы
Какой минимальный интервал репликации в Proxmox?
Одна минута. Максимальный — раз в неделю, по умолчанию в интерфейсе стоит 15 минут. Но это интервал попыток, а не гарантия того, что реплика не старше одной минуты.
Что будет с репликацией Proxmox после ошибки?
Задание переходит в состояние ошибки, штатное расписание приостанавливается, а неудачная репликация повторяется каждые 30 минут. После первой успешной попытки возвращается обычный график.
Почему репликация Proxmox часто падает в ошибку?
Документация называет три типичные причины: проблемы сети, нехватка места на целевом хранилище и отсутствие на целевом узле хранилища с тем же идентификатором. Причину ищите в логе репликации.
Можно ли потерять данные при отказе узла с HA и репликацией?
Да. Документация прямо предупреждает: между временем последней синхронизации и моментом отказа узла возможна потеря данных. Чем старше последняя успешная синхронизация, тем больше потеря.
Как запустить репликацию немедленно после устранения причины?
Командой pvesr schedule-now с идентификатором задания, например pvesr schedule-now 100-0. Затем проверьте результат командой pvesr status.
Заменяет ли репликация резервное копирование?
Нет. Реплика хранит состояние на момент последней синхронизации и не даёт истории. Для отката к вчерашнему состоянию нужны отдельные резервные копии, лучше на независимом хранилище.
Источники
- Proxmox VE: Storage Replication — Проверены минимальный и максимальный интервал, значение по умолчанию, обработка ошибок и повтор раз в 30 минут, типичные причины, предупреждение о потере данных при HA, команды pvesr, параметр rate, сеть репликации: https://pve.proxmox.com/pve-docs/chapter-pvesr.html
- Proxmox VE: руководство pvesr(1) — Проверены подкоманды status, list, schedule-now, create-local-job, update и значение расписания по умолчанию: https://pve.proxmox.com/pve-docs/pvesr.1.html
- Proxmox VE: High Availability — Проверены типичное время обнаружения отказа и переключения около двух минут, команда ha-manager status, поведение watchdog при потере кворума: https://pve.proxmox.com/pve-docs/chapter-ha-manager.html
- Proxmox VE: Cluster Manager — Проверены требование минимум трёх узлов для надёжного кворума и роль QDevice как третьего голоса в малых кластерах: https://pve.proxmox.com/pve-docs/chapter-pvecm.html