
Два Pod пишут в один RWO-том: почему так и как перевести PVC на ReadWriteOncePod
ReadWriteOnce не означает «один писатель»: режим ограничивает том одним узлом, а Pod на этом узле могут открыть его хоть вдвоём. Единственного писателя гарантирует только ReadWriteOncePod. Ниже — разбор аварии с базой Prometheus, поиск таких томов за пять минут и миграция PVC без потери данных.
«Once» — это про узел, а не про Pod
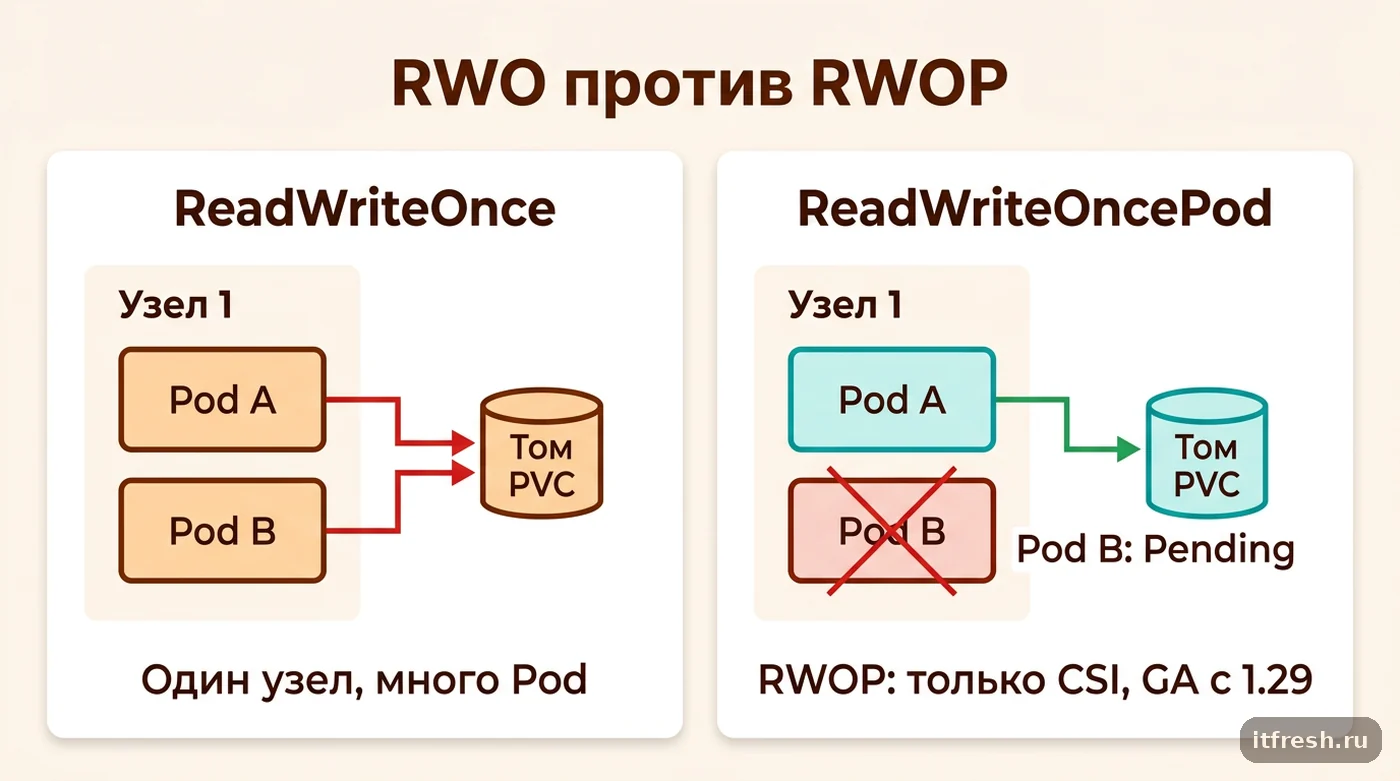
Начну с самого болезненного — с того, что я первым проверяю, когда мы в АйТи-Фреш берём кластер на сопровождение Kubernetes и open-source. Формулировка из официальной документации Kubernetes звучит так: «ReadWriteOnce: the volume can be mounted as read-write by a single node. ReadWriteOnce access mode still can allow multiple pods to access (read from or write to) that volume when the pods are running on the same node». То есть слово «Once» относится к узлу. Один узел — да. Один Pod — нет, никогда и не обещали.
Механика простая, и как только её проговоришь вслух, всё встаёт на места. CSI-драйвер делает attach блочного устройства к ноде и монтирует его в глобальную точку монтирования — ровно один раз. Дальше kubelet каждому Pod, который запросил этот PVC, делает bind-mount из этой глобальной точки в контейнер. Счётчик ссылок увеличивается, том остаётся один. Никакого «второй Pod получит ошибку» в этой схеме не заложено: с точки зрения хранилища всё корректно, диск примонтирован единожды и на одном хосте. Два процесса в двух контейнерах видят одну и ту же файловую систему — как два процесса на обычном сервере.
Режимов доступа в Kubernetes четыре, и путаница почти всегда между первым и четвёртым. Аббревиатуры, которые вы увидите в выводе kubectl: RWO, ROX, RWX, RWOP.
ReadWriteOncePod появился в Kubernetes 1.22 как alpha, а стабильным (GA) стал в 1.29 — в сентябре 2026-го актуальны ветки 1.35–1.37, так что это давно зрелый механизм, а не экспериментальный флаг. Единственное «но»: официально режим поддерживается только для CSI-томов. Для hostPath, in-tree-плагинов и провижнеров вроде rancher.io/local-path гарантия единственного Pod документацией не обещана — одни такой режим в PVC просто не примут, другие примут, но вести себя будут по-своему. Проверьте в своей версии, прежде чем на это рассчитывать.
- ReadWriteOnce (RWO) — том монтируется на чтение и запись одним узлом; несколько Pod на этом узле работают с ним одновременно.
- ReadOnlyMany (ROX) — только чтение, много узлов.
- ReadWriteMany (RWX) — чтение и запись, много узлов; нужна файловая система, которая это переживёт (CephFS, NFS), но не ext4 поверх RBD.
- ReadWriteOncePod (RWOP) — том монтируется на чтение и запись ровно одним Pod во всём кластере. Только CSI, стабилен с 1.29.
- Требования к сайдкарам драйвера: csi-provisioner v3.0.0+, csi-attacher v3.3.0+, csi-resizer v1.3.0+.
Разбор аварии: как брокер потерял 19 дней метрик
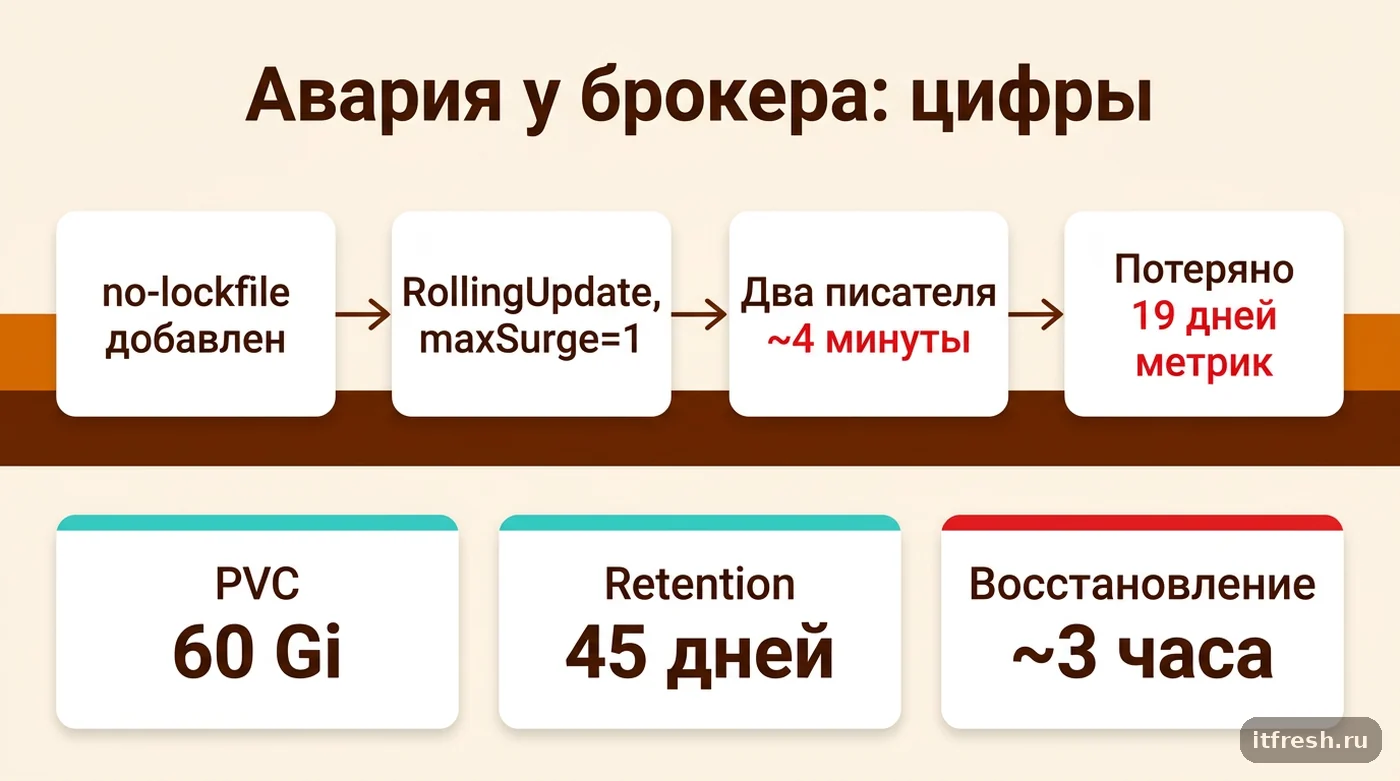
Клиент — страховой брокер «Страховой навигатор», 24 рабочих места. Своих разработчиков двое, они держат внутренний сервис расчёта полисов и портал для агентов на небольшом кластере из трёх узлов в стойке у провайдера: Kubernetes 1.35, хранилище Rook-Ceph с ceph-csi (RBD), сайдкары в связке provisioner 5.x / attacher 4.x — по версиям всё давно проходило под RWOP. Мониторинг — Prometheus, но не через оператор, а обычным Deployment из манифеста, который когда-то написал подрядчик. У Prometheus PVC на 60 Gi, retention 45 дней, режим доступа, как у всех, ReadWriteOnce, стратегия обновления — RollingUpdate по умолчанию.
За полгода до того, как брокер пришёл к нам, их разработчик столкнулся с классической болью: при kubectl rollout restart новый Pod Prometheus поднимался, упирался в lock-файл в каталоге данных и падал, а старый в это время ещё завершался — деплой залипал на несколько минут. В интернете на этот случай есть готовый совет, который повторяется в десятках issue: добавьте флаг --storage.tsdb.no-lockfile. Его и добавили. Залипание ушло. А вместе с ним ушла последняя защита от второго писателя — потому что RWO её никогда не давал, единственным барьером был как раз этот lock-файл.
Дальше — арифметика. Deployment с maxSurge=1, nodeSelector на узел с быстрым SSD-пулом. При очередном обновлении планировщик поставил новый Pod на тот же узел, где доживал старый: RWO это разрешает, том уже примонтирован, bind-mount выдаётся мгновенно. Два Prometheus одновременно писали в один WAL и один каталог chunks около четырёх минут — пока новый инстанс проигрывал WAL, а старый досчитывал последние scrape-интервалы и завершался. На следующем старте в логе появились ошибки чтения блоков вида invalid magic number, а в середине истории — битые блоки.
Итог: 19 дней метрик восстановить не удалось — снапшот тома был один и суточной давности, а битые блоки пришлось просто удалить из каталога данных, чтобы Prometheus вообще стартовал. На разбор и восстановление ушло около трёх часов моего времени плюс час согласования окна с руководителем брокера. Самое неприятное — по логам Prometheus мы нашли ещё два таких наложения за четыре месяца, просто перекрытие было секундным и TSDB его переварила. В событиях кластера этого не видно вообще: с точки зрения Kubernetes ничего не сломалось. Сама миграция всех восьми stateful-томов брокера на RWOP после этого заняла у нас один рабочий вечер.
Как за пять минут найти у себя такие же тома
Первое, что я делаю на новом кластере, — смотрю не «есть ли проблема», а «где она может выстрелить». Нужны две вещи: список PVC с режимом RWO и список случаев, когда на один PVC ссылается больше одного живого Pod. Второе — прямая улика, но встречается редко, потому что окно перекрытия короткое. Первое — карта рисков.
# 1. Все PVC и их режимы доступа
kubectl get pvc -A -o custom-columns=\
'NS:.metadata.namespace,PVC:.metadata.name,MODES:.spec.accessModes[*],SC:.spec.storageClassName,PV:.spec.volumeName'

# 2. Кто прямо сейчас держит один и тот же PVC больше чем одним Pod
kubectl get pods -A -o json | jq -r '
  .items[] | . as $p |
  ($p.spec.volumes // [])[] |
  select(.persistentVolumeClaim) |
  "\($p.metadata.namespace)/\(.persistentVolumeClaim.claimName)\t\($p.spec.nodeName)\t\($p.metadata.name)"' \
| sort | awk -F'\t' '{c[$1]++; n[$1]=n[$1]" "$3} END{for(k in c) if(c[k]>1) print c[k], k, n[k]}'
Дальше — проверка, что миграция вообще возможна. RWOP работает только на CSI, поэтому смотрим драйверы и провижнеры StorageClass. Если в provisioner стоит rancher.io/local-path, kubernetes.io/no-provisioner или что-то in-tree, на гарантии RWOP не рассчитывайте: документация обещает их только для CSI. Заодно сверяем версии сайдкаров: provisioner 3.0.0+, attacher 3.3.0+, resizer 1.3.0+. На современных драйверах 2026 года это выполняется с запасом, но у клиентов регулярно находится ceph-csi трёхлетней давности, приколоченный гвоздями к старому Helm-релизу.
kubectl get csidrivers
kubectl get sc -o custom-columns='NAME:.metadata.name,PROV:.provisioner,RECLAIM:.reclaimPolicy'

# Версии сайдкаров конкретного драйвера (пример для ceph-csi)
kubectl -n ceph-csi get pods -o jsonpath=\
'{range .items[*]}{.metadata.name}{"\n"}{range .spec.containers[*]}  {.name}={.image}{"\n"}{end}{end}'

# Красный флаг №1: Deployment c RWO-томом и стратегией RollingUpdate
kubectl get deploy -A -o json | jq -r '
  .items[] | select((.spec.template.spec.volumes // [])[]?.persistentVolumeClaim) |
  "\(.metadata.namespace)/\(.metadata.name)\t\(.spec.strategy.type)"'
Мой практический вывод после десятков таких прогонов: главный источник двойной записи — не экзотика, а связка «Deployment + PVC + RollingUpdate». StatefulSet ведёт себя приличнее (при обновлении контроллер сначала удаляет старый Pod и только потом создаёт новый с тем же именем), но и он не спасает от kubectl delete pod --force --grace-period=0 — форс-удаление убирает объект из API, а контейнер на ноде ещё живёт и пишет.
Миграция существующего PVC на ReadWriteOncePod
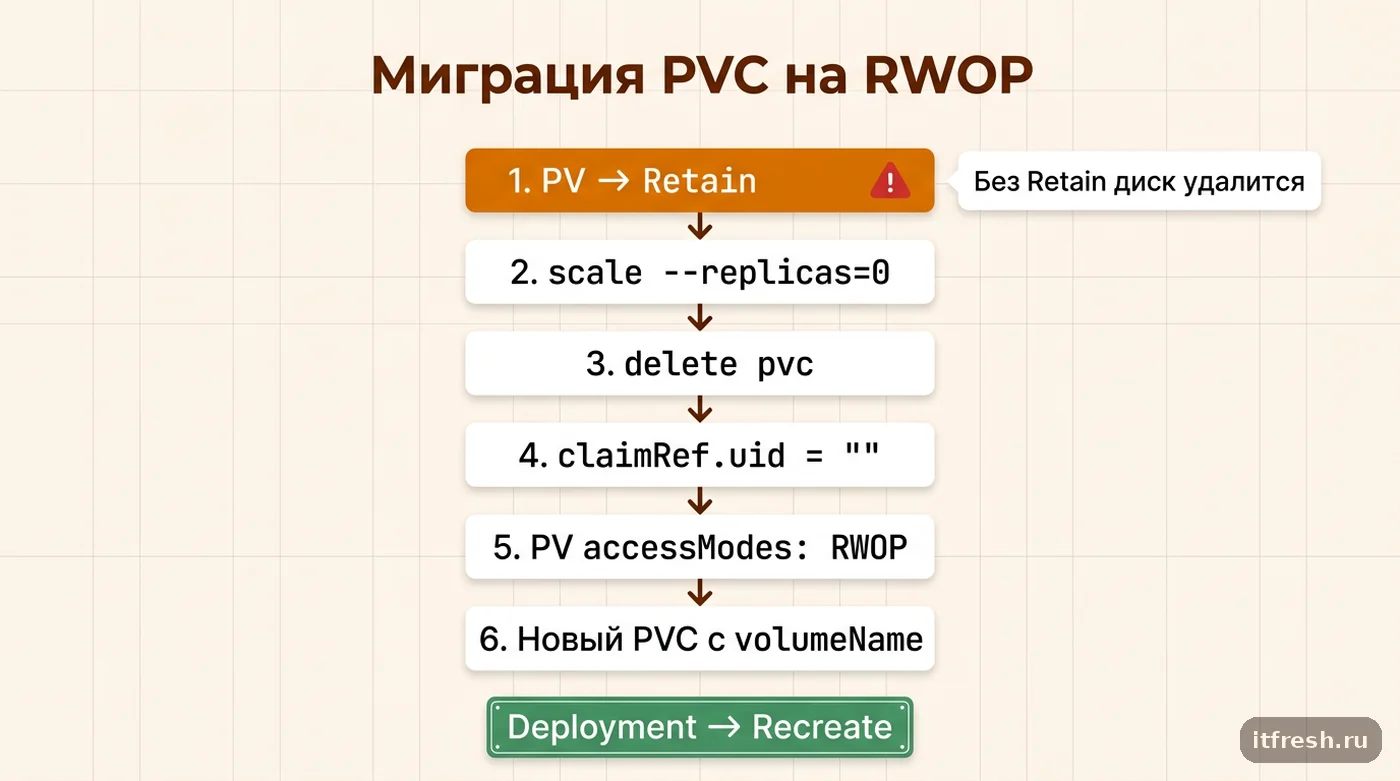
Плохая новость: поле accessModes у PVC иммутабельно, поменять его на месте нельзя. Хорошая: официальная процедура миграции есть, она описана в задачнике Kubernetes и сводится к тому, чтобы отвязать PV от PVC, не дав при этом удалить сами данные. Ключевой шаг — самый первый: перевести PV в reclaimPolicy: Retain. Если пропустить его и удалить PVC при политике Delete, CSI-драйвер честно снесёт RBD-образ или облачный диск. Возврата не будет.
Порядок действий такой (имена подставьте свои; имя PV для динамически созданного тома узнаётся через kubectl get pvc <name> -o jsonpath='{.spec.volumeName}'):
PV=pvc-8f1c0d2a-3b77-4a19-9d24-0f5b1a2c3d4e
NS=monitoring
PVC=prometheus-data

# 1. Обязательно ПЕРВЫМ шагом: защищаем данные
kubectl patch pv $PV -p '{"spec":{"persistentVolumeReclaimPolicy":"Retain"}}'
kubectl get pv $PV -o jsonpath='{.spec.persistentVolumeReclaimPolicy}{"\n"}'   # должно быть Retain

# 2. Гасим приложение и убеждаемся, что Pod РЕАЛЬНО исчез, а не Terminating
kubectl -n $NS scale deployment prometheus --replicas=0
kubectl -n $NS get pods -w

# 3. Удаляем PVC (PV останется в статусе Released)
kubectl -n $NS delete pvc $PVC

# 4. Освобождаем PV: обнуляем uid в claimRef
kubectl patch pv $PV -p '{"spec":{"claimRef":{"uid":""}}}'

# 5. Меняем режим доступа у PV
kubectl patch pv $PV -p '{"spec":{"accessModes":["ReadWriteOncePod"]}}'
Обратите внимание на шаг 4: мы обнуляем именно uid внутри claimRef, а не удаляем claimRef целиком. Разница принципиальная. Пустой claimRef означает «PV свободен для любого подходящего PVC», и его может перехватить чужой claim из другого namespace — я такое видел на кластере, где параллельно крутился оператор, штампующий PVC пачками. Оставленные name и namespace в claimRef держат PV зарезервированным именно за вашим будущим PVC.
Дальше пересоздаём PVC с новым режимом и жёсткой привязкой к тому через volumeName, применяем и поднимаем приложение. Ёмкость в resources.requests должна совпадать с ёмкостью PV, иначе привязка не состоится.
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: prometheus-data
  namespace: monitoring
spec:
  accessModes:
    - ReadWriteOncePod
  volumeName: pvc-8f1c0d2a-3b77-4a19-9d24-0f5b1a2c3d4e
  storageClassName: ceph-rbd
  resources:
    requests:
      storage: 60Gi
# 6. Создаём новый PVC и поднимаем приложение
kubectl apply -f prometheus-pvc.yaml
kubectl -n $NS get pvc $PVC # ждём Bound
kubectl -n $NS scale deployment prometheus --replicas=1
# 7. По желанию возвращаем исходную политику удаления
kubectl patch pv $PV -p '{"spec":{"persistentVolumeReclaimPolicy":"Delete"}}'Два ограничения, о которые спотыкаются. Первое: RWOP нельзя комбинировать с другими режимами — список accessModes должен содержать ровно один элемент. Манифест с ["ReadWriteOnce","ReadWriteOncePod"] API-сервер отклонит сразу с ошибкой may not use ReadWriteOncePod with other access modes, так что «для совместимости» указать оба не получится. Второе: документация поддерживает только миграцию ReadWriteOnce → ReadWriteOncePod, обратный путь и переезд с RWX не описаны. И совет из практики, который совпадает с официальным: не затевайте расширение тома в один заход с миграцией — дождитесь Bound и только потом трогайте размер.
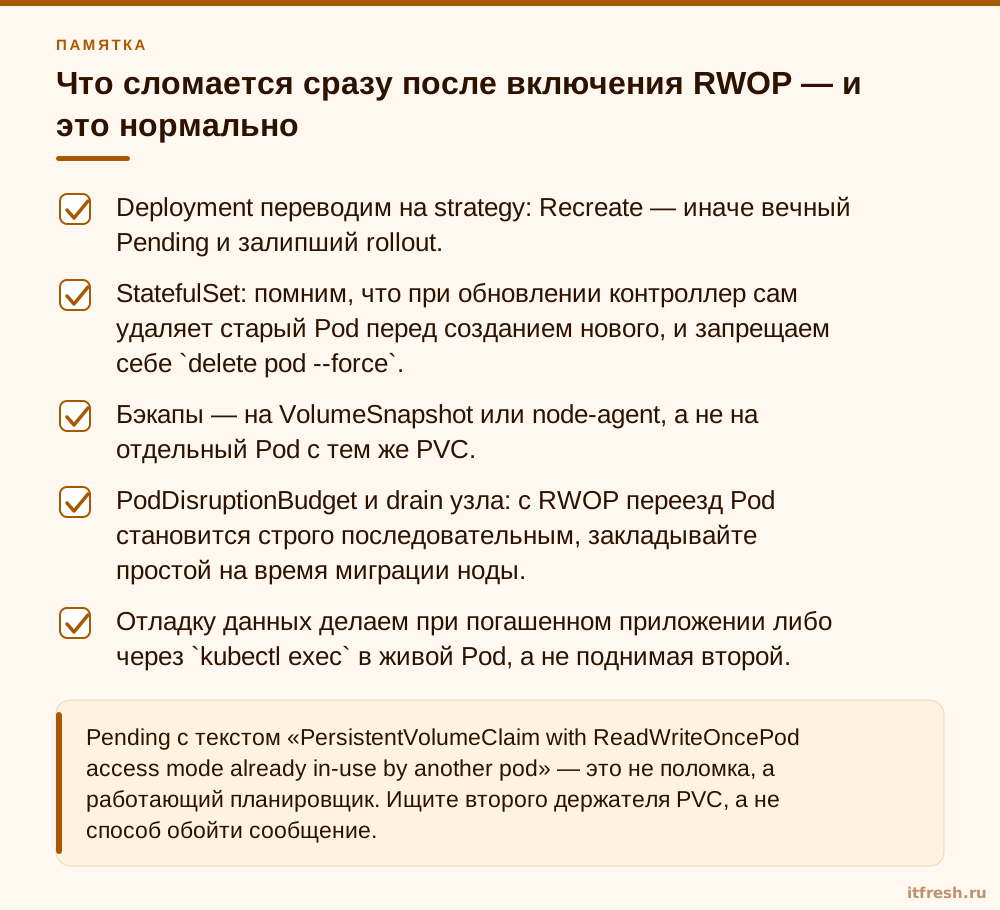
Что сломается сразу после включения RWOP — и это нормально
Первое, что вы увидите на следующем деплое: новый Pod навсегда зависает в Pending. Планировщик отработал ровно так, как задумано, — плагин volumerestrictions считает поды, ссылающиеся на RWOP-PVC, и при conflictingPVCRefCount больше нуля объявляет узел непригодным. В описании Pod вы найдёте текст node(s) unavailable due to PersistentVolumeClaim with ReadWriteOncePod access mode already in-use by another pod. Это не ошибка конфигурации, это и есть работающая защита. Но раз новый Pod больше не может подняться рядом со старым, стратегия обновления обязана стать Recreate.
apiVersion: apps/v1
kind: Deployment
spec:
  strategy:
    type: Recreate      # RollingUpdate с RWOP-томом просто не пройдёт
Второе — бэкапы и сервисные задачи. Всё, что монтировало тот же PVC отдельным Pod, встанет: Job, который тарит каталог на S3, отладочный Pod «посмотреть, что там в данных», CronJob ротации архивов, самописный скрипт синхронизации, который запускается отдельным Pod с тем же claim. Лечится это не откатом RWOP, а сменой подхода: снапшоты CSI через VolumeSnapshot, node-agent, который читает данные с узла, или бэкап силами самого приложения (для Prometheus — remote-write либо snapshot API). По моему опыту, именно эта часть вызывает у команд больше всего сопротивления, а на деле переделывается за один вечер и попутно чинит бэкап, который до этого держал том открытым по два часа.
Третье, о чём стоит знать честно: RWOP защищает от второго Pod внутри Kubernetes и не защищает ни от чего снаружи. Если кто-то смонтировал тот же LUN на гипервизоре, если два кластера смотрят на одно RBD-пространство имён, если админ зашёл на ноду и сделал mount руками — режим доступа тут ни при чём. И ещё: RWOP относится к тому, а не к логике приложения. Если у вас два экземпляра сервиса должны координироваться, для этого есть Lease и leader election, а не режим монтирования.
- Deployment переводим на strategy: Recreate — иначе вечный Pending и залипший rollout.
- StatefulSet: помним, что при обновлении контроллер сам удаляет старый Pod перед созданием нового, и запрещаем себе `delete pod --force`.
- Бэкапы — на VolumeSnapshot или node-agent, а не на отдельный Pod с тем же PVC.
- PodDisruptionBudget и drain узла: с RWOP переезд Pod становится строго последовательным, закладывайте простой на время миграции ноды.
- Отладку данных делаем при погашенном приложении либо через `kubectl exec` в живой Pod, а не поднимая второй.
Кому это нужно, а кому можно забить
Не надо переводить на RWOP всё подряд — я так делал на одном кластере и потом полдня разгребал вставшие CronJob'ы. Приоритет простой: RWOP нужен там, где второй писатель означает повреждение данных, а не просто гонку. Это встроенные в кластер TSDB и БД: Prometheus и VictoriaMetrics single-node, SQLite в контейнере, Redis с AOF/RDB на томе, самописные файловые индексы, очереди на файлах, любые ETL-воркеры, которые держат состояние в каталоге. На томах с логами, кэшем, статикой, артефактами сборки — забейте, там двойная запись максимум испортит один файл.
Отдельно про альтернативы, потому что они часто уместнее. Если приложение само умеет лидер-элекшн через Lease (операторы, контроллеры, современные очереди) — RWOP лишний слой, вы просто усложните себе обновления. Если писателей действительно должно быть несколько — вам не RWOP, а RWX на файловой системе, которая это умеет: CephFS, NFS-провижнер. Класть RWX-режим на блочный RBD с ext4 нельзя ни при каких обстоятельствах: ext4 не кластерная ФС, и два узла с примонтированным одним образом убивают её за минуты. А самое дешёвое решение, которое закрывает процентов девяносто риска одной строкой в манифесте, — это strategy: Recreate для Deployment с персистентным томом. Начните с него сегодня, а миграцию на RWOP планируйте на ближайшее окно.
Есть и спорный момент, где единого мнения нет. В управляемых кластерах поведение зависит от CSI-драйвера провайдера: сами сайдкары давно свежие, но у части драйверов встречаются нюансы в обработке RWOP при внезапной потере узла — Pod с RWOP-томом может дольше висеть в Terminating, пока не отработает force-detach, потому что заменяющий Pod по определению не может стартовать параллельно. На кластерах со своим Ceph я этого практически не вижу, на облачных дисках — иногда. Поэтому на боевом кластере я всегда сначала прогоняю сценарий «выключить узел с RWOP-томом рубильником» на тестовом namespace и замеряю время восстановления. Если время неприемлемо — это аргумент в пользу того, чтобы приложение вообще не держало состояние на одном томе.
И последнее по приоритетам. Если у вас в кластере на одном RWO-томе живёт боевая БД в контейнере — сначала подумайте, не вынести ли её на отдельный сервер или в managed-сервис. RWOP закроет вопрос двойной записи, но не закроет вопрос бэкапа, восстановления на точку времени и производительности. Я это говорю клиентам прямо, даже когда выгоднее продать настройку кластера.
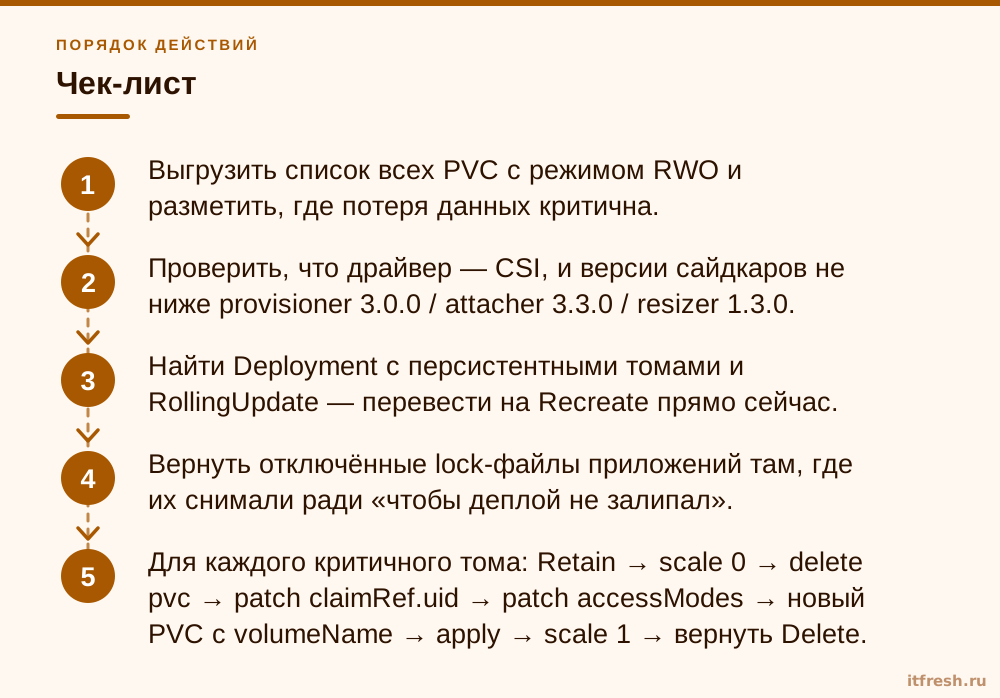
Чек-лист
Собираю всё в порядок, в котором делаю это руками у клиента. У «Страхового навигатора» на восемь stateful-томов ушёл один вечер; для кластера на 15–20 stateful-нагрузок закладывайте полдня, из которых половина времени — согласование окна простоя, потому что каждый переезд PVC требует остановки приложения.
После миграции обязательно проведите учения: остановите приложение, поднимите его заново, погасите узел, на котором висит том. Вы должны увидеть, что заменяющий Pod стартует и что в событиях нет вечного конфликта PVC. Если конфликт остался — значит, где-то живёт забытый Job или отладочный Pod, который держит claim; ищите его тем же jq-однострочником из третьего раздела.
- Выгрузить список всех PVC с режимом RWO и разметить, где потеря данных критична.
- Проверить, что драйвер — CSI, и версии сайдкаров не ниже provisioner 3.0.0 / attacher 3.3.0 / resizer 1.3.0.
- Найти Deployment с персистентными томами и RollingUpdate — перевести на Recreate прямо сейчас.
- Вернуть отключённые lock-файлы приложений там, где их снимали ради «чтобы деплой не залипал».
- Для каждого критичного тома: Retain → scale 0 → delete pvc → patch claimRef.uid → patch accessModes → новый PVC с volumeName → apply → scale 1 → вернуть Delete.
- Переделать бэкапы, которые монтировали тот же PVC, на VolumeSnapshot или node-agent.
- Убедиться, что в новых PVC режим RWOP указан один — комбинацию API-сервер всё равно не пропустит, но шаблоны Helm лучше поправить заранее.
- Провести учения: рестарт, drain узла, отключение узла — и замерить время восстановления.
Частые вопросы
ReadWriteOncePod работает на любом хранилище?
Официально — только CSI-тома: режим стабилен с Kubernetes 1.29 и требует сайдкаров csi-provisioner v3.0.0+, csi-attacher v3.3.0+, csi-resizer v1.3.0+. Для hostPath, in-tree-плагинов и rancher.io/local-path гарантия не обещана. Проверьте `kubectl get csidrivers` и provisioner у StorageClass до начала работ.
Можно ли поменять accessModes у существующего PVC на месте?
Нет, spec.accessModes у PVC после создания не меняется. Поэтому официальная процедура выглядит так: переводим PV в Retain, гасим приложение, удаляем PVC, обнуляем uid в claimRef у PV, патчим accessModes самого PV и создаём новый PVC с тем же именем и явным volumeName. Данные при этом остаются в PV нетронутыми.
Потеряю ли я данные при удалении PVC во время миграции?
Только если забудете первый шаг. При persistentVolumeReclaimPolicy: Delete удаление PVC заставит CSI-драйвер физически удалить том — RBD-образ или облачный диск. Поэтому Retain выставляется до всего остального и проверяется через `kubectl get pv <name> -o jsonpath='{.spec.persistentVolumeReclaimPolicy}'`. Вернуть Delete можно после успешной привязки нового PVC.
После миграции Pod висит в Pending — что не так?
Скорее всего, всё так. Планировщик пишет `node(s) unavailable due to PersistentVolumeClaim with ReadWriteOncePod access mode already in-use by another pod` — значит, тот же PVC держит другой Pod. Типичные виновники: Deployment со стратегией RollingUpdate (переведите на Recreate), забытый Job, отладочный Pod или самописная задача бэкапа, монтирующая тот же claim.
Можно ли указать RWOP вместе с ReadWriteOnce, чтобы «было совместимо»?
Нельзя. API-сервер отклонит такой PVC или PV с ошибкой «may not use ReadWriteOncePod with other access modes». Список accessModes должен содержать ровно один элемент — ReadWriteOncePod.
RWOP заменяет leader election в приложении?
Нет. RWOP — это про том: он гарантирует, что второй Pod не смонтирует те же данные. Логику «кто сейчас главный» он не решает и от второго экземпляра приложения, работающего без тома или с другим томом, не защищает. Для координации экземпляров используйте Lease и штатный leader election.
Источники
- Kubernetes Docs — Change the Access Mode of a PersistentVolume to ReadWriteOncePod — Процедура миграции: Retain → scale 0 → delete PVC → patch claimRef.uid → patch accessModes → новый PVC с volumeName → опционально вернуть Delete; только RWO→RWOP, не менять размер во время миграции. https://kubernetes.io/docs/tasks/administer-cluster/change-pv-access-mode-readwriteoncepod/
- Kubernetes Docs — Persistent Volumes, Access Modes — Определения RWO/ROX/RWX/RWOP, оговорка о нескольких Pod на одном узле для RWO, RWOP stable с v1.29, только CSI, сайдкары provisioner v3.0.0+/attacher v3.3.0+/resizer v1.3.0+. https://kubernetes.io/docs/concepts/storage/persistent-volumes/#access-modes
- Kubernetes Blog — Single Pod Access Mode for PersistentVolumes Graduates to Stable — Переход ReadWriteOncePod в GA в релизе 1.29. https://kubernetes.io/blog/2023/12/18/read-write-once-pod-access-mode-ga/
- kubernetes/kubernetes — scheduler plugin volumerestrictions — Текст ErrReasonReadWriteOncePodConflict и счётчик conflictingPVCRefCount. https://github.com/kubernetes/kubernetes/blob/master/pkg/scheduler/framework/plugins/volumerestrictions/volume_restrictions.go
- kubernetes/kubernetes — валидация API core — Ошибка «may not use ReadWriteOncePod with other access modes» при комбинации режимов. https://github.com/kubernetes/kubernetes/blob/master/pkg/apis/core/validation/validation.go
- Prometheus Docs — Storage — Устройство локальной TSDB (WAL, блоки, каталог данных); флаг --storage.tsdb.no-lockfile сверен по исходнику cmd/prometheus/main.go. https://prometheus.io/docs/prometheus/latest/storage/