
Добавил hostUsers: false в Kubernetes 1.36 — и поды с PVC перестали стартовать. Разбор idmap mounts
Вы добавили одну строку в шаблон пода — `hostUsers: false` — потому что в release notes Kubernetes 1.36 напротив user namespaces стоит слово stable. Stateless-сервисы взлетели. А Postgres, Redis и всё, что держит PVC, встало в ContainerCreating намертво. Ниже — почему «stable» в Kubernetes ничего не говорит о совместимости с вашим хранилищем, на каких трёх уровнях должна сойтись поддержка idmap mounts, как за десять минут проверить ноду и в каком порядке это раскатывать, чтобы не остановить прод.
Симптом: под висит в ContainerCreating, и виноват вовсе не CSI
Сценарий повторяется из компании в компанию. Приходит требование от безопасников или аудитора: контейнеры не должны работать с реальным root на хосте. Админ открывает документацию, видит, что user namespaces с версии 1.36 — стабильная функция, которую больше нельзя отключить фича-гейтом, и добавляет hostUsers: false в базовый шаблон деплоя. Nginx, фронты, воркеры без состояния поднимаются как ни в чём не бывало. А на следующем раскате ложится всё, что держит PersistentVolumeClaim: база, кэш с персистентностью, раннер с кэшем сборки, файловая шара приложения.
Выглядит это неприятно именно тем, что указывает не туда. Событие пода уводит вас в сторону CSI-драйвера, хотя драйвер отработал штатно: том создан, приаттачен к ноде и смонтирован в staging-каталог. Ломается следующий шаг — проброс этого каталога внутрь пода с перепаковкой владельцев. Примерный вид событий (точная формулировка зависит от рантайма и версии, но ключевые слова там всегда одни):
Events:
  Warning  FailedCreatePodSandBox  kubelet
    Failed to create pod sandbox: ... failed to setup user namespace:
    mount_setattr: invalid argument
  Warning  Failed  kubelet
    Error: failed to generate container spec: idmap mount of
    /var/lib/kubelet/pods/<uid>/volumes/... : invalid argument
EINVAL от mount_setattr(2) — это и есть та самая точка отказа. Ядро отвечает буквально: «The underlying filesystem does not support ID-mapped mounts».
Отличить это от обычных проблем с хранилищем просто: уберите hostUsers: false — под стартует немедленно, без каких-либо изменений в PVC, StorageClass или драйвере. Если так, дальше можно не искать: у вас не сломано хранилище, у вас не сошлись требования user namespaces на одном из трёх уровней. Каких — разбираем ниже.
И сразу главная мысль, ради которой стоит читать дальше. Статус stable в Kubernetes означает, что стабилизировался API и поведение kubelet: поле hostUsers больше не экспериментальное, фича-гейт UserNamespacesSupport заблокирован, и выключить фичу глобально больше нельзя: попытка передать UserNamespacesSupport=false закончится ошибкой запуска компонента, а =true лишь даст предупреждение о лишнем флаге. Стабильность API не даёт ни строчки гарантий про ваше ядро, ваш рантайм и вашу файловую систему. Это три независимых условия, и Kubernetes не проверит их заранее — он узнает о несовместимости ровно в момент запуска контейнера.
- Под с `hostUsers: false` и PVC — ContainerCreating, тот же под без этой строки — Running за секунды.
- В событиях и в журнале kubelet фигурирует `invalid argument` рядом со словами idmap / user namespace / mount_setattr.
- Другие поды на той же ноде с тем же StorageClass, но без user namespaces, работают нормально.
Почему опция про пользователей вообще трогает тома
User namespace отображает диапазон UID/GID внутри пода на другой, непересекающийся диапазон на хосте. Внутри контейнера процесс видит себя как uid 0, снаружи это, скажем, uid 264192. По умолчанию валидный диапазон внутри — 0–65535, и kubelet сам гарантирует, что двум подам не достанется один и тот же кусок хостового пространства. Именно это и даёт выигрыш в безопасности: побег из контейнера приземляет атакующего непривилегированным пользователем, а не root, и боковое перемещение между подами резко усложняется.
Дальше возникает вопрос: а как быть с файлами на томе? Они лежат на диске с реальными хостовыми владельцами. Наивный путь — рекурсивно перечоунить весь том под новый диапазон при каждом старте пода. Для терабайтного PVC это неприемлемо: старт занял бы часы, а том стал бы непригоден для любого другого пода. Поэтому используется механизм ядра idmap mounts: тот же каталог монтируется в под ещё раз, но с наложенной таблицей трансляции идентификаторов. Физически на диске ничего не меняется, трансляция живёт в самом маунте.
Делается это системным вызовом mount_setattr(2) с флагом MOUNT_ATTR_IDMAP и файловым дескриптором user namespace в поле userns_fd. Ключевое ограничение из мануала: маунт должен быть detached, ещё не idmapped, без открытых писателей, вызывающий обязан иметь CAP_SYS_ADMIN в начальном user namespace — и, самое главное, **нижележащая файловая система должна уметь idmapped mounts**. Умение это реализуется в каждом драйвере ФС отдельно, и если драйвер его не заявил, ядро возвращает EINVAL. Никакие настройки Kubernetes этого не обходят.
Отсюда вытекает то, что чаще всего упускают: условие проверяется не в одном месте, а минимум в двух. Во-первых, idmap должна поддерживать файловая система, на которой лежит /var/lib/kubelet/pods/ (или тот каталог, который вы указали в rootDirectory kubelet). Во-вторых, idmap должны поддерживать **все** файловые системы всех томов пода. Один том на неподдерживаемой ФС — и не стартует весь под целиком, а не только контейнер, который к нему обращается.
- Уровень 1 — ядро: сам механизм idmap mounts и его поддержка конкретным драйвером ФС.
- Уровень 2 — нода: файловая система под `/var/lib/kubelet/pods/` или под кастомным `rootDirectory`.
- Уровень 3 — под: каждая файловая система каждого тома, включая служебные — Secret, ConfigMap, projected-токен ServiceAccount.
Матрица требований: где обычно не сходится
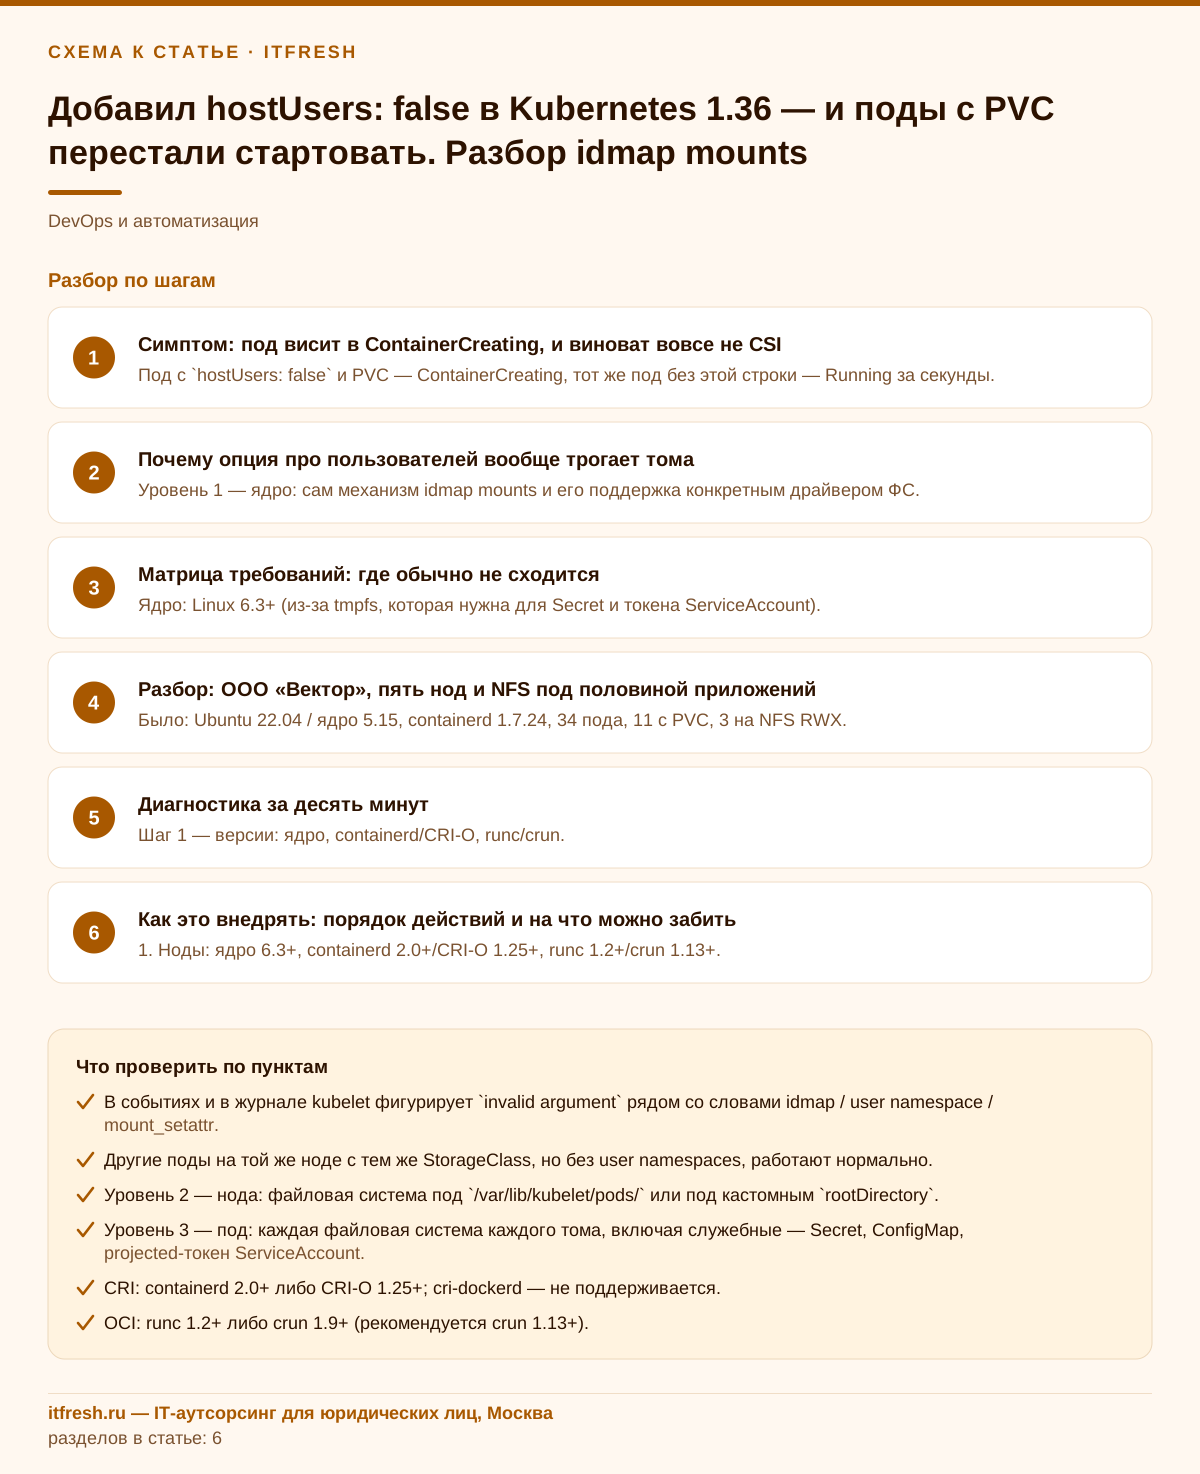
Официальные требования короткие, но каждое из них в реальном кластере способно оказаться нарушенным. Ядро — Linux 6.3 или новее; формулировка документации прямая: «In practice this means you need at least Linux 6.3, as tmpfs started supporting idmap mounts in that version». Рантайм — containerd версии 2.0 и новее либо CRI-O 1.25 и новее. OCI-рантайм — runc 1.2 и новее либо crun 1.9 и новее, причём для crun документация рекомендует 1.13+. cri-dockerd официально не поддерживается до сих пор.
По файловым системам документация Kubernetes перечисляет как поддерживающие idmap в ядре 6.3: btrfs, ext4, xfs, fat, tmpfs, overlayfs. NFS в этом списке нет: на сегодня Linux-клиент NFS не реализует idmapped mounts, и это вопрос ядра, а не Kubernetes — никакой апгрейд кластера его не решит. Это принципиальный момент: если ваш RWX-том приходит по NFS, совместимости с hostUsers: false у него нет, и «подождать следующего релиза Kubernetes» тут не стратегия.
Отдельно про номера версий ядра — здесь легко обмануться в обе стороны. Enterprise-дистрибутивы живут на бэкпортах: ядро с «старым» номером в RHEL-подобных дистрибутивах может нести бэкпорты отдельных возможностей, и по одному номеру версии нельзя уверенно сказать, умеет ли оно idmap для tmpfs. И наоборот — свежее ядро 6.x в кастомной сборке способно оказаться без модуля нужной ФС. Поэтому единственный честный способ — проверить фактически, тестовым подом на конкретной ноде, а не сверять uname -r со строчкой в документации.
Самый частый практический затык — не ядро, а containerd. Требуется 2.0+, а огромная часть кластеров, обновившихся до 1.3x, до сих пор работает на ветке 1.7.x, потому что апгрейд рантайма не входит в процедуру апгрейда кластера и делается отдельными руками. Проверять это надо до того, как вы поменяете шаблон деплоя, а не после.
- Ядро: Linux 6.3+ (из-за tmpfs, которая нужна для Secret и токена ServiceAccount).
- CRI: containerd 2.0+ либо CRI-O 1.25+; cri-dockerd — не поддерживается.
- OCI: runc 1.2+ либо crun 1.9+ (рекомендуется crun 1.13+).
- ФС по документации: btrfs, ext4, xfs, fat, tmpfs, overlayfs.
- Не подходит: NFS (клиент Linux не умеет idmapped mounts).
Разбор: кинотеатр «Большой экран» и билетный сервис подрядчика
Кейс честно оговорю сразу: у кинотеатра «Большой экран» — пятьдесят рабочих мест, кассы, бухгалтерия, офис — собственного Kubernetes нет и быть не должно. В кластере живёт сервис онлайн-продажи билетов, который кинотеатру сопровождает подрядчик: фронт с афишей и схемой зала, API бронирования, воркер оплат, PostgreSQL и Redis. Мы в этой истории — ИТ-аутсорсер кинотеатра, который по поручению заказчика проверяет, что подрядчик выполнил требования по безопасности. Кластер небольшой: четыре ноды (одна control plane и три worker), Ubuntu 22.04 с ядром 5.15, Kubernetes обновляли регулярно, а containerd остался на 1.7.24 с первичной установки. В проде восемнадцать подов, пять из них с PVC: local-path на xfs под PostgreSQL, Redis и очередь оплат, плюс RWX-тома через NFS-провижионер под загружаемые постеры фильмов и ночные выгрузки отчётов по продажам для бухгалтерии.
Поводом стала анкета по безопасности от банка-эквайера: пункт про изоляцию контейнеров от root на хосте. Подрядчик сделал ровно то, что просили: прописал hostUsers: false в общий шаблон Helm-чарта и раскатил во вторник днём. Дальше — около пятнадцати минут ContainerCreating по всем подам, потому что не поднялось вообще ничего: containerd 1.7 не удовлетворял требованию 2.0+. Продажа билетов на вечерние сеансы в это время не работала, кассы кинотеатра отбивались звонками. Откат вернул сервис за пять минут, после чего директор кинотеатра попросил нас разобраться вместе с подрядчиком и согласовать план, а не «пробовать ещё раз».
Порядок работ получился такой. Сначала обновили ядро на HWE-ветку (apt install linux-generic-hwe-22.04, получили 6.8) и перезагрузили worker-ноды по одной с cordon/drain — ночью, после последнего сеанса, по пятнадцать-двадцать минут на ноду с учётом миграции подов. Затем подняли containerd до ветки 2.0 и перезапустили; runc в комплекте уже был свежее 1.2. После этого каждый stateful-под проверили пробным запуском на копии тома. Три пода из пяти — PostgreSQL, Redis и очередь оплат на xfs — переехали на hostUsers: false без единого замечания. Два пода с NFS-томами (постеры и выгрузки отчётов) не заработали: их оставили с hostUsers: true и явным комментарием в манифесте, чтобы через полгода никто не «починил» это обратно.
Отдельно посмотрели kubelet: размер диапазона на под задаётся в его конфиге, по умолчанию это 65536 идентификаторов, и менять его без нужды я не советую — придётся дренить ноды и пересоздавать поды, чтобы новая настройка вступила в силу.
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
userNamespaces:
  idsPerPod: 65536
Итог: три из пяти stateful-подов и весь stateless переведены на user namespaces, два сервиса на NFS зафиксированы в ответе эквайеру как исключение с планом — при следующем продлении договора с подрядчиком перевести постеры в объектное хранилище, а выгрузки отчётов на блочный RWO-том с xfs. Работы заняли вечер на подготовку и две ночи на ноды, ни один сеанс продаж больше не пострадал.
Главный вывод из этого кейса даже не технический. Требование «включить изоляцию» нельзя выполнять массовой правкой одного шаблона, особенно когда кластер чужой, а простой бьёт по выручке заказчика в тот же вечер. Правильный результат — не «включено везде», а «включено там, где можно, явно задокументировано там, где нельзя, и раскатано в окно, согласованное с расписанием сеансов».
- Было: Ubuntu 22.04 / ядро 5.15, containerd 1.7.24, 18 подов, 5 с PVC, 2 на NFS RWX.
- Стало: ядро 6.8 (HWE), containerd 2.0.x, runc 1.2+, 3 из 5 stateful-подов с `hostUsers: false`.
- Не переведено: 2 сервиса на NFS (постеры, выгрузки отчётов) — `hostUsers: true` и комментарий в манифесте.
- Простой: 15 минут при первом неудачном раскате подрядчика, дальше — только ночные окна после последнего сеанса.
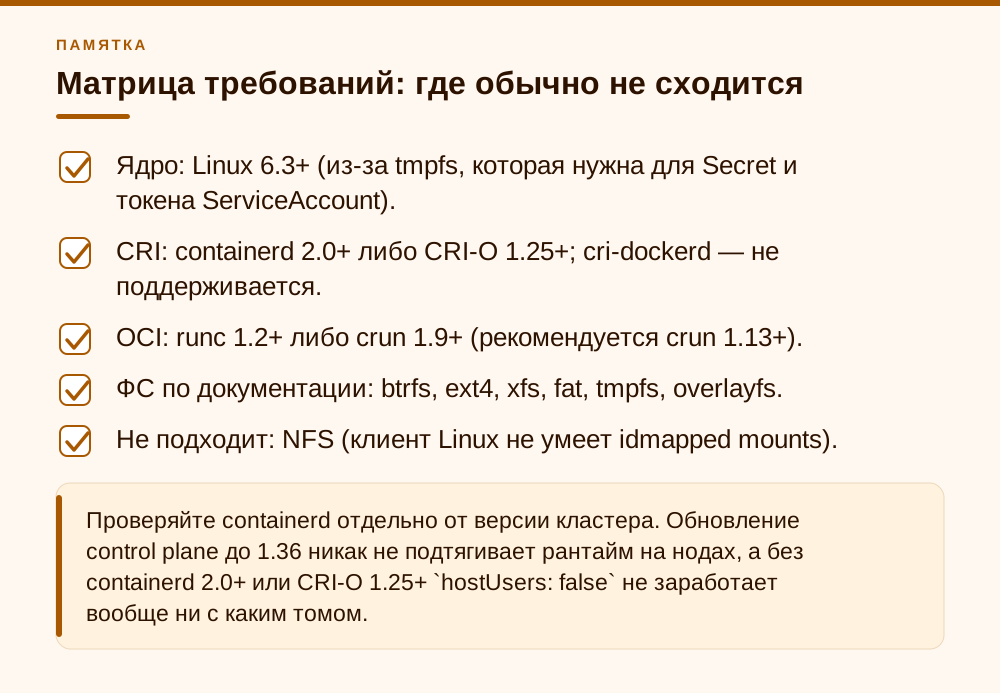
Диагностика за десять минут
Никакой магии тут нет, всё проверяется четырьмя командами на ноде и одним пробным подом. Начните с версий — это отсекает большинство случаев ещё до того, как вы полезете в тома:
uname -r                       # нужно 6.3 и новее
containerd --version           # нужно 2.0 и новее
runc --version                 # нужно 1.2 и новее (или crun 1.9+/1.13+)
findmnt -no FSTYPE /var/lib/kubelet/pods   # ФС под каталогом подов
Если findmnt вернул пустоту — значит, каталог лежит на корневой ФС, посмотрите её через findmnt -no FSTYPE /. Если там xfs, ext4 или btrfs — этот уровень у вас закрыт.
Дальше — какие ФС приезжают в под с томами. Смотреть надо не на StorageClass, а на реальный тип: у CSI-драйверов блочных дисков это обычно ext4 или xfs (то есть годится), а у сетевых RWX — nfs, cephfs или что-то ещё. Быстрый срез по кластеру:
kubectl get pv -o custom-columns=\
NAME:.metadata.name,\
SC:.spec.storageClassName,\
FS:.spec.csi.fsType,\
DRV:.spec.csi.driver,\
NFS:.spec.nfs.server
Всё, где в колонке NFS не пусто, а также любые тома через nfs-провижионеры — заведомо несовместимо.
И наконец, пробный под. Я всегда запускаю его на конкретной ноде и с конкретным PVC, потому что это единственный способ проверить фактически, а не по номерам версий:
apiVersion: v1
kind: Pod
metadata:
  name: userns-probe
  namespace: default
spec:
  hostUsers: false
  nodeName: worker-02
  restartPolicy: Never
  containers:
  - name: probe
    image: busybox:1.37
    command: ["sh","-c","id; cat /proc/self/uid_map; ls -ln /data; sleep 30"]
    volumeMounts:
    - name: data
      mountPath: /data
  volumes:
  - name: data
    persistentVolumeClaim:
      claimName: <ваш-pvc>
Если под поднялся и cat /proc/self/uid_map показал отображение с длиной диапазона 65536 в последней колонке (как в примере из документации Kubernetes), а ls -ln /data вывел ожидаемых владельцев, — этот том с user namespaces совместим. Если завис в ContainerCreating, смотрите события и журнал kubelet: kubectl describe pod userns-probe и journalctl -u kubelet -n 200 --no-pager | grep -iE 'idmap|userns|mount_setattr'.
Отдельно предупрежу про соблазн проверить «по документации и не трогать прод». Не работает. Бэкпорты в enterprise-ядрах, самосборные образы нод, экзотические CSI-драйверы, которые сами делают chown при монтировании, — всё это ломает вывод, сделанный по таблице версий. Пробный под стоит тридцать секунд и даёт ответ, которому можно доверять.
- Шаг 1 — версии: ядро, containerd/CRI-O, runc/crun.
- Шаг 2 — ФС под `/var/lib/kubelet/pods` (или под кастомным `rootDirectory`).
- Шаг 3 — типы ФС всех PV, которые монтируются в целевые поды.
- Шаг 4 — пробный под с `hostUsers: false`, привязанный к конкретной ноде и конкретному PVC.
- Шаг 5 — журнал kubelet по ключевым словам idmap / userns / mount_setattr.
Как это внедрять: порядок действий и на что можно забить
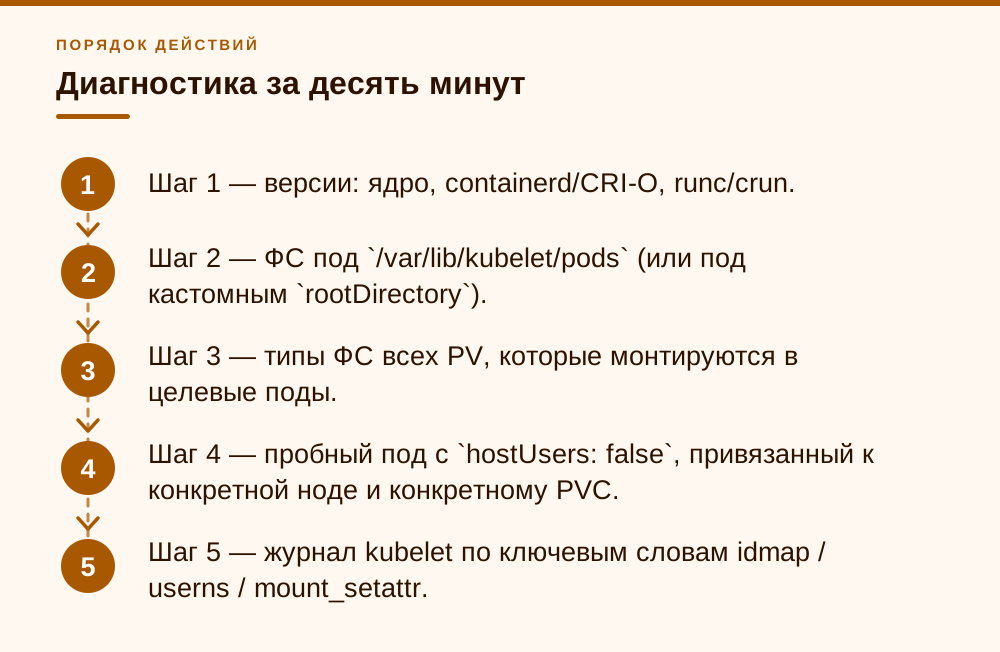
Моя последовательность неизменна уже на нескольких проектах. Сначала приводим ноды к требованиям — ядро и рантайм, окном, по одной ноде, с cordon/drain. Пока это не сделано, трогать манифесты вообще бессмысленно. Затем включаем hostUsers: false на stateless-нагрузках: фронты, API без томов, воркеры очередей. Это даёт основную часть выигрыша по безопасности почти бесплатно — именно эти поды чаще всего смотрят наружу и именно их пытаются пробить.
Третьим шагом — stateful на локальных и блочных томах: ext4 и xfs проходят нормально, тут проблем почти не бывает. И только четвёртым — разбор сетевых RWX-томов. Если это NFS, разбор короткий: оставляем hostUsers: true, пишем комментарий в манифесте, ставим задачу на смену типа хранилища при следующей закупке. Тратить время на попытки «обойти» тут не надо, обходов нет.
Что касается политик — Kyverno, ValidatingAdmissionPolicy или что у вас принято: не включайте enforce на весь кластер разом. Сначала audit-режим на неделю, посмотрите отчёт, вынесите известные исключения в список, и только потом переводите в блокирующий. Иначе получите ровно то, что было с билетным сервисом кинотеатра, только уже с запретом на откат.
Теперь честно про то, где риск преувеличен. Во-первых, user namespaces — pod-level opt-in, а не настройка ноды: пока вы не написали hostUsers: false в спеке, поведение подов не меняется, и «обновились на 1.36 и всё сломалось» само по себе невозможно. Во-вторых, это не замена seccomp, AppArmor/SELinux и своевременных обновлений — это дополнительный слой, который резко снижает цену побега из контейнера, но не отменяет остальное. И в-третьих: если у вас кластер из трёх нод под внутренние сервисы без внешнего доступа и на NFS, включение user namespaces — далеко не первый пункт вашего списка по безопасности. Обновить рантайм и закрыть API-сервер снаружи важнее.
- 1. Ноды: ядро 6.3+, containerd 2.0+/CRI-O 1.25+, runc 1.2+/crun 1.13+.
- 2. Stateless-нагрузки — включаем массово, риск минимальный.
- 3. Stateful на ext4/xfs/btrfs — включаем после пробного пода.
- 4. Сетевые RWX (особенно NFS) — фиксируем исключение и планируем смену хранилища.
- 5. Политика в admission — сначала audit, потом enforce со списком исключений.
Спорные места, о которых лучше знать заранее
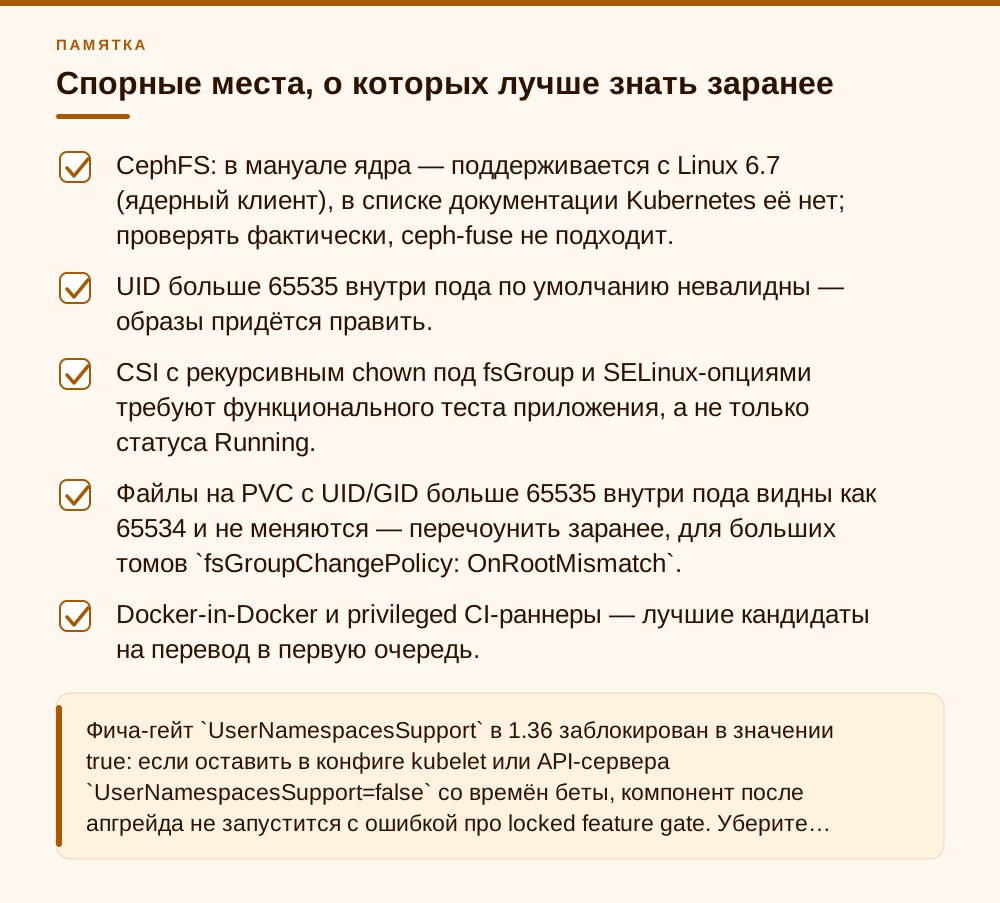
Первое и самое интересное — CephFS. В документации Kubernetes её нет в списке поддерживающих idmap ФС, а вот в мануале mount_setattr(2) cephfs среди поддерживаемых перечислена (с Linux 6.7) наряду с xfs, ext4, btrfs, overlayfs, tmpfs, squashfs, f2fs, erofs и другими. Это не противоречие, а разные срезы: список Kubernetes консервативнее и зависит ещё и от того, каким клиентом смонтирован том. Ядерный клиент CephFS на ядре 6.7+ шанс имеет, ceph-fuse — нет. Единого ответа тут нет, проверяйте пробным подом на своём стенде и не закладывайтесь на CephFS в плане миграции, пока не проверили.
Второе — диапазон UID внутри пода. По умолчанию при включённых user namespaces валидны идентификаторы 0–65535, и это относится и к файлам, и к процессам, то есть к runAsUser, runAsGroup и прочим полям securityContext. Если у вас образы, которые запускаются под UID больше 65535 — а такое встречается, например, при OpenShift-подобной практике произвольных высоких UID, — их придётся пересобрать или перенастроить. Об этом почти никогда не думают заранее, а выясняется в момент раската.
Третье — CSI-драйверы, которые самостоятельно занимаются владельцами файлов: делают рекурсивный chown под fsGroup, навешивают SELinux-контексты через опции монтирования. Такие драйверы способны конфликтовать с idmap-слоем самым неочевидным образом, вплоть до того, что под стартует, а приложение внутри получает Permission denied на своих же файлах. Здесь нужен именно функциональный тест приложения, а не только факт «под в Running».
Отдельно про права на уже заполненных PVC и fsGroup, потому что именно здесь чаще всего всплывает Permission denied после включения. Поля runAsUser, runAsGroup и fsGroup при hostUsers: false относятся к пользователям внутри контейнера, а idmap mount устроен так, что на диске файлы остаются с теми же числовыми владельцами, которые видит приложение. Поэтому том, заполненный подом с runAsUser: 999 и fsGroup: 999, после включения user namespaces читается тем же приложением без переделки. Проблемы начинаются, когда на томе лежат файлы с владельцами вне диапазона 0–65535: внутри пода они показываются как 65534 (nobody), изменить их нельзя, и рекурсивная смена группы под fsGroup на таких файлах не спасает. Перед переводом я делаю find /data -uid +65535 -o -gid +65535 | head через пробный под без user namespaces и, если что-то нашлось, один раз перечоуниваю том в окне обслуживания. На больших томах заодно ставлю fsGroupChangePolicy: OnRootMismatch, чтобы kubelet не обходил весь том при каждом старте.
spec:
  hostUsers: false
  securityContext:
    runAsUser: 999
    runAsGroup: 999
    fsGroup: 999
    fsGroupChangePolicy: OnRootMismatch
И четвёртое, приятное. Наибольший выигрыш от user namespaces получают не обычные веб-сервисы, а нагрузки, которым раньше приходилось выдавать привилегии: сборка образов, Docker-in-Docker в CI, тесты, требующие CAP_SYS_ADMIN. Внутри своего user namespace такие capabilities действительны, а снаружи — пусты. Если у вас в кластере живут privileged-раннеры, начинать имеет смысл именно с них: там соотношение «снижение риска к трудозатратам» лучшее в кластере, и, что удобно, у раннеров обычно нет NFS-томов.
- CephFS: в мануале ядра — поддерживается с Linux 6.7 (ядерный клиент), в списке документации Kubernetes её нет; проверять фактически, ceph-fuse не подходит.
- UID больше 65535 внутри пода по умолчанию невалидны — образы придётся править.
- CSI с рекурсивным chown под fsGroup и SELinux-опциями требуют функционального теста приложения, а не только статуса Running.
- Файлы на PVC с UID/GID больше 65535 внутри пода видны как 65534 и не меняются — перечоунить заранее, для больших томов `fsGroupChangePolicy: OnRootMismatch`.
- Docker-in-Docker и privileged CI-раннеры — лучшие кандидаты на перевод в первую очередь.
Частые вопросы
Достаточно ли обновиться до Kubernetes 1.36, чтобы hostUsers: false заработал?
Нет. Статус stable в 1.36 говорит только о стабильности API и поведения kubelet — фича-гейт UserNamespacesSupport заблокирован, поле hostUsers больше не экспериментальное. Работоспособность зависит от трёх вещей вне Kubernetes: ядра (6.3+), CRI-рантайма (containerd 2.0+ или CRI-O 1.25+ с runc 1.2+ / crun 1.9+) и поддержки idmap mounts всеми файловыми системами — и под /var/lib/kubelet/pods, и под каждым томом пода. Обновление control plane ничего из этого не подтягивает.
Почему требуется ядро 6.3, если xfs и ext4 умеют idmap значительно раньше?
Потому что дело не только в томах данных. Kubelet отдаёт в под секреты и projected-токен ServiceAccount через tmpfs, а tmpfs получила поддержку idmap mounts именно в 6.3. То есть даже под без единого PVC, но с обычным сервис-аккаунтом, на более старом ядре не поднимется. Отсюда и формулировка документации про «в практическом смысле нужен Linux 6.3».
Можно ли как-то использовать NFS вместе с hostUsers: false?
На текущих ядрах — нет. Linux-клиент NFS не реализует idmapped mounts, поэтому mount_setattr с MOUNT_ATTR_IDMAP на таком томе возвращает EINVAL, и обновление Kubernetes этого не меняет. Варианта два: оставить такие поды с hostUsers: true и явно задокументировать исключение, либо сменить тип хранилища для этих нагрузок — например, на блочные RWO-тома с ext4/xfs, а для RWX проверить CephFS (ядерный клиент, idmap с Linux 6.7) на своём стенде.
Как проверить совместимость, не роняя прод?
Запустить пробный под с hostUsers: false, привязанный через nodeName к конкретной ноде и подключающий копию нужного PVC (или сам PVC, если это допустимо). Внутри выполнить `cat /proc/self/uid_map` и `ls -ln` по каталогу тома. Если под поднялся и отображение непустое — совместимость есть. Если завис в ContainerCreating, смотрите `kubectl describe pod` и журнал kubelet по словам idmap, userns и mount_setattr. Проверка по таблице версий ненадёжна из-за бэкпортов в enterprise-ядрах.
Что произойдёт с уже лежащими в PVC файлами после включения user namespaces?
На диске владельцы не меняются — idmap mount транслирует идентификаторы на лету, физического chown не происходит. Внутри пода файлы будут видны с ожидаемыми UID/GID, а новые файлы получат идентификаторы, соответствующие пользователю контейнера. Отдельно проверьте приложения, где UID жёстко зашит в конфиг или в образ: по умолчанию валидный диапазон внутри пода — 0–65535, и всё, что запускается под большим UID, придётся переделывать.
Стоит ли вообще включать user namespaces в небольшом кластере?
Если у вас есть привилегированные нагрузки — сборка образов, Docker-in-Docker, CI-раннеры с CAP_SYS_ADMIN — да, начните именно с них, там выигрыш максимальный при минимуме работы. Если кластер маленький, целиком внутренний, а всё хранилище на NFS — это далеко не первый пункт списка: обновление рантайма, закрытие API-сервера снаружи и разбор RBAC дадут больше при тех же трудозатратах.
После включения hostUsers: false приложение получает Permission denied на своих файлах в PVC. Что проверить?
Сначала владельцев: если на томе есть файлы с UID/GID больше 65535, внутри пода они видны как 65534 и не меняются — такой том нужно один раз перечоунить в окне обслуживания. Затем securityContext: runAsUser, runAsGroup и fsGroup при user namespaces трактуются как идентификаторы внутри контейнера и должны совпадать с владельцами файлов на диске. Для больших томов задайте fsGroupChangePolicy: OnRootMismatch. Если CSI-драйвер сам меняет владельцев или навешивает SELinux-контексты при монтировании, проверяйте работу приложения, а не только статус Running.
Источники
- Kubernetes Documentation — User Namespaces — Раздел «Before you begin» / «Requirements» и «Filesystem support» концепции User Namespaces: статус Stable с v1.36 (впервые доступно в v1.28), фича-гейт UserNamespacesSupport заблокирован, требование Linux 6.3+ из-за tmpfs, containerd 2.0+ / CRI-O 1.25+, runc 1.2+ / crun 1.9+ (рекомендуется 1.13+), список ФС btrfs/ext4/xfs/fat/tmpfs/overlayfs, требования к ФС каталога /var/lib/kubelet/pods и ко всем томам пода. https://kubernetes.io/docs/concepts/workloads/pods/user-namespaces/
- KEP-127: Support User Namespaces in pods (kubernetes/enhancements) — История стадий фичи: alpha в 1.25, переход на idmap mounts в 1.27, stateful-поды в 1.28, beta в 1.30, включение по умолчанию в 1.33, GA в 1.36; требования к ядру 6.3+ и поддержке idmap mounts файловыми системами. https://github.com/kubernetes/enhancements/tree/master/keps/sig-node/127-user-namespaces
- Linux man-pages — mount_setattr(2) — Описание флага MOUNT_ATTR_IDMAP, поля userns_fd, условий создания idmapped-маунта (detached mount, отсутствие открытых писателей, CAP_SYS_ADMIN в initial user namespace) и ошибки EINVAL «The underlying filesystem does not support ID-mapped mounts»; перечень ФС с поддержкой idmap и версиями ядра: xfs/ext4/FAT с 5.12, btrfs с 5.15, tmpfs с 6.3, cephfs с 6.7. https://man7.org/linux/man-pages/man2/mount_setattr.2.html
- Kubernetes Blog — User Namespaces enabled by default (v1.33) — Пост о включении user namespaces по умолчанию в Kubernetes v1.33: pod-level opt-in через hostUsers, назначение непересекающихся диапазонов UID/GID подам, снижение риска бокового перемещения и последствий побега из контейнера. https://kubernetes.io/blog/2025/04/25/userns-enabled-by-default/
- Rodrigo Campos Catelin — User Namespaces in Kubernetes, Part I — Разбор автора реализации: механика idmap mounts вместо рекурсивного chown, диапазон 0–65535 на под и гарантия непересечения со стороны kubelet, необходимость дренить ноды при изменении настроек диапазонов, отсутствие поддержки idmap mounts у NFS и влияние на tmpfs-тома (токен ServiceAccount, /etc/resolv.conf). https://blog.sdfg.com.ar/posts/userns-in-kubernetes-part-i/
- Kubernetes Documentation — Kubelet Configuration (v1beta1) — Справочник конфигурации kubelet: структура UserNamespaces и поле idsPerPod (размер диапазона идентификаторов на под, по умолчанию 65536), а также rootDirectory — каталог, под которым живёт podsDir и чья ФС обязана поддерживать idmap mounts. https://kubernetes.io/docs/reference/config-api/kubelet-config.v1beta1/
- Kubernetes Documentation — Use a User Namespace With a Pod — Пошаговая инструкция: pod.spec.hostUsers: false и проверка через readlink /proc/self/ns/user и cat /proc/self/uid_map (длина диапазона 65536 внутри контейнера). https://kubernetes.io/docs/tasks/configure-pod-container/user-namespaces/