
Вернул рабочий образ в StatefulSet, а Pod всё ещё сломан: почему откат не продолжается сам
Вы вернули в StatefulSet прежний образ — тот самый тег, на котором вчера всё работало. kubectl apply прошёл, в спеке нужный шаблон, а Pod как висел в ImagePullBackOff, так и висит. И будет висеть до утра, до понедельника, вечно: контроллер StatefulSet не откатится сам, это его документированное поведение, а не поломка кластера. Ниже — что именно происходит внутри контроллера, как за минуту это подтвердить, какой одной командой чинится (подсказка: не той, которую первой предлагает интернет), когда --force действительно нужен и чем он опасен для базы данных, и как выстроить процесс, чтобы больше в эту яму не падать.
Что на самом деле делает контроллер, пока вы ждёте
Разберём механику, иначе дальнейшее выглядит магией. При .spec.updateStrategy.type: RollingUpdate и политике управления подами по умолчанию — OrderedReady — контроллер StatefulSet идёт строго от старшего порядкового номера к младшему: сначала sts-4, потом sts-3, и так вниз до sts-0. Он удаляет под, ждёт, пока новый станет Running и Ready, и только после этого берётся за следующий. Ждёт без таймаута. У StatefulSet нет progressDeadlineSeconds, как у Deployment, нет автоматического отката по неуспеху и нет никакого встроенного «сдаться через N минут». Это принципиальная разница между двумя контроллерами, и её надо держать в голове с самого начала.
Теперь ключевой момент. Когда вы правите шаблон обратно, создаётся новая ревизия — объект ControllerRevision, — и sts.status.updateRevision меняется на новый хеш. Но контроллер по-прежнему видит, что под со старшим ординалом не Ready, и считает, что предыдущее обновление ещё не завершилось. Он ждёт, пока сломанный под станет готов, чтобы «пойти дальше». А готовым тот не станет никогда, потому что образа с опечаткой в реестре не существует. Получается аккуратный дедлок: условие выхода зависит от пода, который сам зависит от условия выхода.
Это не моя интерпретация, а прямой текст официальной документации, раздел Forced rollback: «In this state, it is not enough to revert the Pod template to a good configuration... After reverting the template, you must also delete any Pods that StatefulSet had already attempted to run with the bad configuration». Проблема известна с 2018 года, и документация ссылается на тикет kubernetes/kubernetes#67250 как на «known issue». Учтите нюанс: сам тикет на GitHub закрыт, но раздел Forced rollback в документации Kubernetes 1.37 (релиз 1.37.0 вышел 26 августа 2026) никуда не делся и прямо требует удалять сломанные поды руками. Так что если загуглите и увидите «closed», не делайте вывода, что поведение исправили: ориентируйтесь на текст документации своей версии. И обратите внимание на оговорку в том же разделе: тупик описан для политики управления подами по умолчанию, OrderedReady.
Диагностика занимает минуту. Три поля показывают всё:
kubectl -n prod get sts rmq \
  -o jsonpath='cur={.status.currentRevision}{"\n"}upd={.status.updateRevision}{"\n"}ready={.status.readyReplicas}{"\n"}'
kubectl -n prod rollout status sts/rmq --timeout=30s
kubectl -n prod get pods -l app=rmq -o wide
Если currentRevision не равен updateRevision, а rollout status отваливается по таймауту на «Waiting for 1 pods to be ready...» (при partition — «Waiting for partitioned roll out to finish», при полном числе готовых — «waiting for statefulset rolling update to complete N pods at revision ...») и счётчик не двигается, вы ровно в этом состоянии. Первым kubectl проверяет число готовых реплик, поэтому в классическом залипании с одним неготовым подом вы увидите именно «Waiting for 1 pods to be ready».
- `status.currentRevision` — ревизия, по которой созданы «старые» поды
- `status.updateRevision` — ревизия, к которой контроллер пытается прийти
- метка `controller-revision-hash` на самом поде — по какой ревизии он реально создан
- `kubectl describe pod` → Events: ErrImagePull / ImagePullBackOff / Readiness probe failed
- `kubectl get controllerrevision -l app=rmq` — список сохранённых ревизий шаблона
Разбор из практики: три брокера и потерянная буква в теге
Случай, о котором рассказываю, — магазин одежды «ГардеробЛавка»: два торговых зала, склад и офис, всего 15 рабочих мест. Сами они Kubernetes не держат и держать не должны: интернет-магазин разработал и сопровождает подрядчик, крутится он в небольшом кластере у этого подрядчика — три ноды, Kubernetes 1.37.0, containerd, тома через CSI, приватный реестр registry.local. Мы у магазина на IT-аутсорсинге: офис, кассы, учёт, связь с подрядчиком. В кластере два StatefulSet, которые нельзя ронять: pg — PostgreSQL с каталогом и заказами на трёх репликах под Patroni, и rmq — RabbitMQ на три реплики с PVC по 20 ГБ, через него идут заказы с сайта в учётную систему и уведомления покупателям. Витрина и API — обычные Deployment за Ingress.
Вечернее окно, плановое обновление брокера 4.1.4 → 4.1.5. В values.yaml уехал тег rabbitmq:4.1.5-managemnet — «management» с потерянной буквой «e». В 19:40 применили, в 19:41 под rmq-2 встал в ErrImagePull, ещё через минуту — в ImagePullBackOff с экспоненциальным бэк-оффом. Инженер подрядчика сделал ровно то, что просится: git revert, helm upgrade, шаблон вернулся на 4.1.4-management. Прошло двадцать минут — rmq-2 в ImagePullBackOff, RESTARTS 0, AGE 23m. Ещё через пятнадцать директор магазина переслал мне сообщение подрядчика «откат не работает, кластер завис, заказы могут не проходить» — и мы созвонились втроём, я получил доступ к kubectl на время разбора.
Первое, что я всегда прошу проверить, — что реально сломано. Оказалось: rmq-0 и rmq-1 живы на старом образе, кворум RabbitMQ 2 из 3 держится, очереди обслуживаются, заказы с сайта продолжали доходить до склада, покупатели ничего не заметили. То есть деградация по отказоустойчивости есть, простоя нет. Это типичная картина в таких инцидентах: паника громче ущерба, и от этого люди начинают делать резкие движения — сносить StatefulSet целиком, руками удалять PVC, форсить удаление всех трёх подов сразу. Вот от этого ущерб уже настоящий.
Дальше — минута работы. Смотрим, что в шаблоне действительно уже правильный образ, и удаляем ровно один под — тот, который пытался стартовать со сломанной конфигурацией:
kubectl -n prod get sts rmq -o jsonpath='{.spec.template.spec.containers[0].image}{"\n"}'
# registry.local/rabbitmq:4.1.4-management   ← шаблон уже верный

kubectl -n prod delete pod rmq-2
# pod "rmq-2" deleted
Под пересоздался по возвращённому шаблону, поднялся за 34 секунды, PVC data-rmq-2 подцепился тот же самый — при пересоздании пода StatefulSet PVC не трогает, данные никуда не деваются. rollout status дошёл до конца, currentRevision сравнялся с updateRevision. Никакого --force, никакого --grace-period=0, никакого пересоздания StatefulSet. Инцидент занял 51 минуту, из которых 47 — ожидание чуда и переписка.
- Ущерб: одна реплика брокера из трёх, кворум цел, простоя витрины и потери заказов не было.
- Причина: опечатка в теге образа, которую не поймал пайплайн подрядчика — проверки существования тега в реестре не было.
- Почему «откат не сработал»: шаблон вернули верно, но при OrderedReady контроллер ждал Ready от пода, созданного по сломанной ревизии.
- Лечение: одно обычное `kubectl delete pod rmq-2` после проверки, что в спеке уже рабочий образ.
- Итог для магазина: подрядчик добавил в пайплайн проверку тега и `rollout status --timeout`, а мы — пункт в регламент взаимодействия: кто и в какой срок сообщает об аварии.
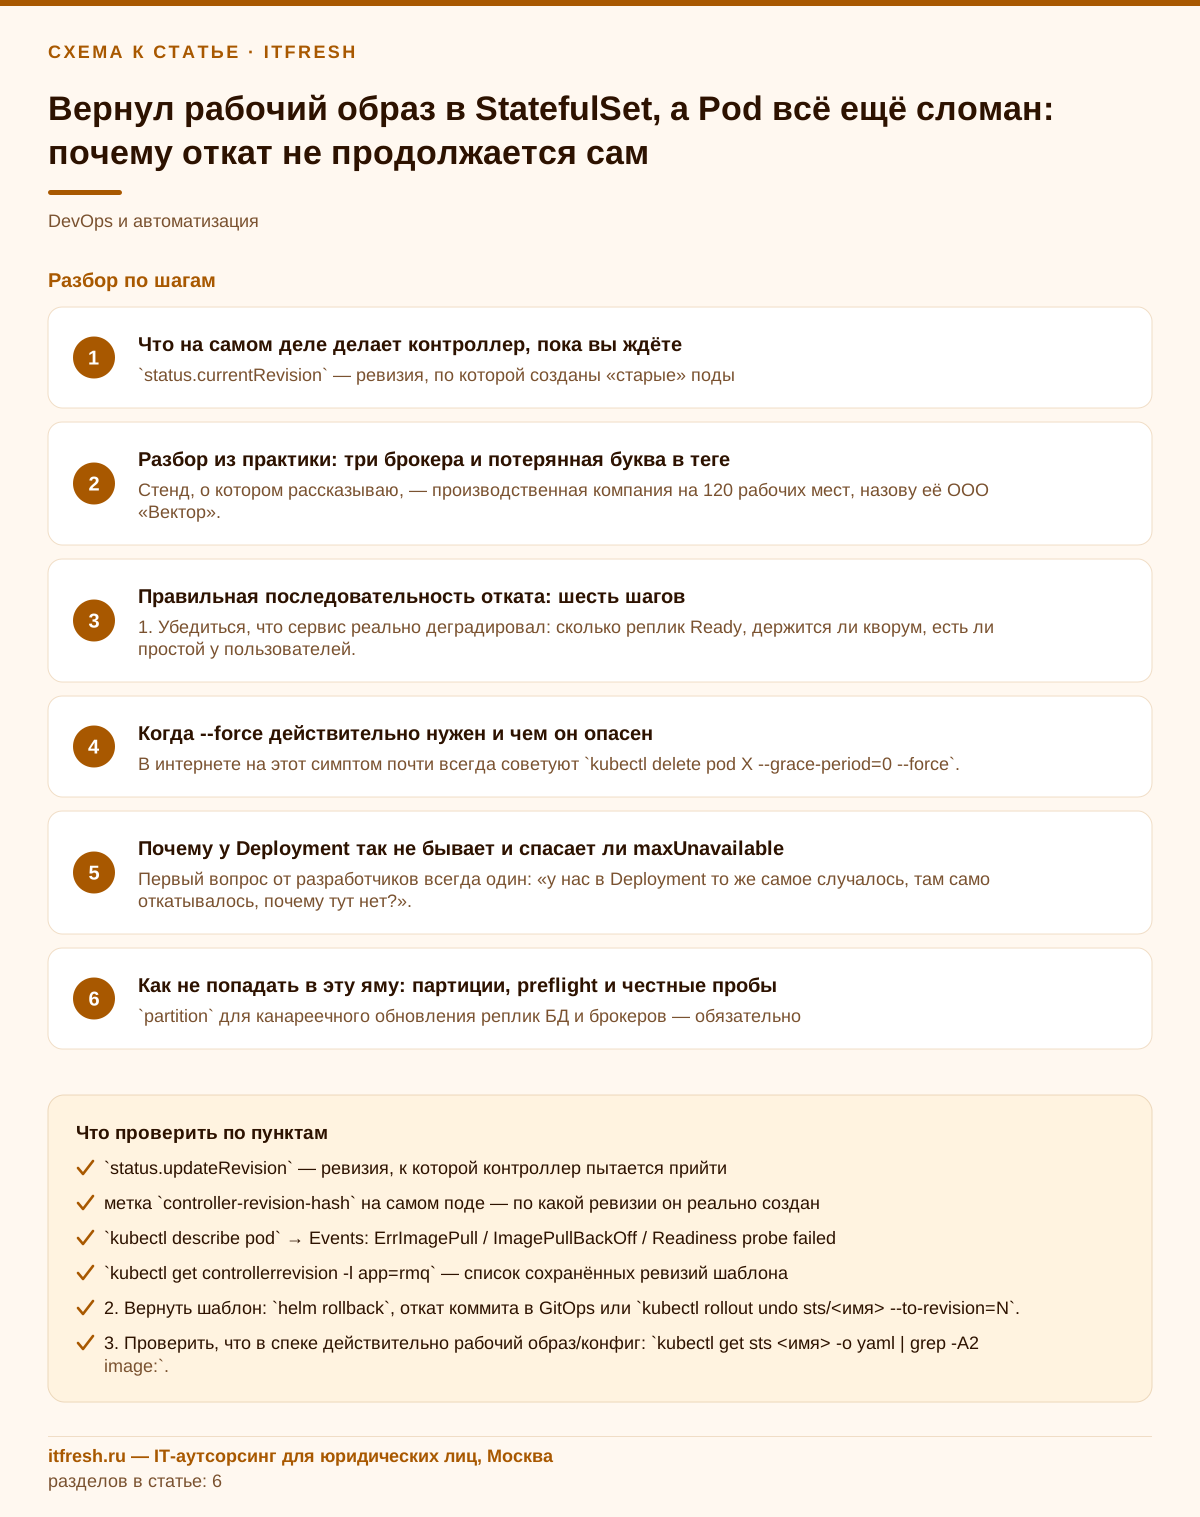
Правильная последовательность отката: шесть шагов
Я держу эту последовательность в раннбуке дежурного, потому что в три часа ночи люди путают порядок и начинают с удаления подов, ещё не вернув шаблон. Тогда контроллер честно пересоздаёт под по всё ещё сломанной ревизии, и человек делает вывод «удаление не помогает», после чего идёт за --force. Порядок принципиален: сначала правильный шаблон, потом удаление подов.
Вернуть шаблон можно двумя способами. Если у вас GitOps и Helm — просто откатите коммит или helm rollback, это честнее всего. Если правили руками или Git недоступен, работает встроенная история ревизий (по умолчанию хранится 10 штук, регулируется .spec.revisionHistoryLimit):
kubectl -n prod rollout history sts/rmq
kubectl -n prod rollout history sts/rmq --revision=7
kubectl -n prod rollout undo sts/rmq --to-revision=7
kubectl rollout undo со StatefulSet работает и просто пишет новый шаблон в спеку. Обратите внимание: сам по себе он вашу ситуацию не разрулит ровно по той же причине — контроллер продолжит ждать сломанный под. undo — это шаг 2 из шести, а не решение.
Дальше нужно понять, какие именно поды удалять. Удалять надо те, что уже пытались стартовать со сломанной конфигурацией, — то есть те, чья метка controller-revision-hash не совпадает с currentRevision, либо те, что просто не Ready. Одна команда показывает всю картину:
kubectl -n prod get pods -l app=rmq \
  -o custom-columns='POD:.metadata.name,REV:.metadata.labels.controller-revision-hash,PHASE:.status.phase,READY:.status.containerStatuses[0].ready'
Дальше удаляем по одному, начиная со старшего ординала (порядок обновления идёт сверху вниз), и после каждого дожидаемся Ready. Для СУБД и брокеров это не бюрократия: одновременное удаление двух реплик из трёх — это потеря кворума и, в худшем случае, восстановление из бэкапа.
- 1. Убедиться, что сервис реально деградировал: сколько реплик Ready, держится ли кворум, есть ли простой у пользователей.
- 2. Вернуть шаблон: `helm rollback`, откат коммита в GitOps или `kubectl rollout undo sts/<имя> --to-revision=N`.
- 3. Проверить, что в спеке действительно рабочий образ/конфиг: `kubectl get sts <имя> -o yaml | grep -A2 image:`.
- 4. Найти поды, застрявшие на плохой ревизии (`controller-revision-hash` != `currentRevision`, статус не Ready).
- 5. Удалить их обычным `kubectl delete pod`, по одному, от старшего ординала к младшему, дожидаясь Ready после каждого.
- 6. Дождаться `kubectl rollout status sts/<имя>` и сравнить `currentRevision` с `updateRevision` — они должны совпасть.
Когда --force действительно нужен и чем он опасен
В интернете на этот симптом почти всегда советуют kubectl delete pod X --grace-period=0 --force. В описанном сценарии он не нужен вообще. Форс решает совсем другую задачу: под завис в статусе Terminating, потому что kubelet на его ноде недоступен. API-сервер удаляет объект пода только после подтверждения от kubelet, что контейнеры действительно остановлены; нет kubelet — нет подтверждения — под висит в Terminating часами. Вот тогда форс уместен, и то не первым действием.
Опасность конкретная и не теоретическая. --force --grace-period=0 не ждёт подтверждения kubelet: объект просто выкидывается из API, и StatefulSet немедленно создаёт rmq-2 на другой ноде. Если старая нода на самом деле жива — а у неё, скажем, отвалился только доступ к control plane — вы получаете два процесса с одной и той же сетевой идентичностью, которые оба считают себя rmq-2. Документация формулирует прямо: StatefulSet гарантирует, что «at most one Pod with a given identity» работает в кластере, и force delete эту гарантию ломает. Для кворумных систем — Patroni, etcd, MongoDB replica set, Kafka, ClickHouse Keeper — это классический split-brain с расхождением данных.
Правильный порядок при подозрении на мёртвую ноду: сначала убедиться, что она действительно мертва — через IPMI/iLO, консоль гипервизора, питание, а не по одному лишь NotReady в kubectl. Затем удалить объект Node (kubectl delete node <имя>), после чего контроллер корректно почистит связанные с ней поды. Форсить руками стоит только тогда, когда вы можете гарантировать, что старый экземпляр уже никогда не свяжется с остальными членами кластера. Отдельно про финализаторы: команда kubectl patch pod <pod> -p '{"metadata":{"finalizers":null}}' в доке тоже есть, но она ещё жёстче — прежде чем её применять, выясните, чей это финализатор. Если CSI-драйвера, то вы рискуете оставить том примонтированным к мёртвой ноде и потом ловить multi-attach на новой.
И ещё одна вещь, которую вижу постоянно в чужих манифестах: terminationGracePeriodSeconds: 0 у подов StatefulSet. Это ровно то же самое, что форс, только включённый постоянно и для всех. Для базы данных это значит kill -9 при каждом рестарте, без сброса WAL и корректного закрытия соединений. Ставьте осмысленное значение — для PostgreSQL и RabbitMQ у меня обычно 60–120 секунд. Документация по принудительному удалению подов StatefulSet прямо называет нулевой terminationGracePeriodSeconds небезопасным и настоятельно не рекомендует его.
- Под в ImagePullBackOff, CrashLoopBackOff или Running 0/1 — только обычный `kubectl delete pod`, форс не нужен.
- Под висит в Terminating/Unknown, нода NotReady — сначала подтвердить, что нода действительно мертва (IPMI, гипервизор, питание).
- Нода подтверждённо мертва — удалить объект Node, а не форсить поды по одному.
- `--grace-period=0 --force` — только если старый экземпляр гарантированно не свяжется с остальными членами кластера.
- Снятие финализаторов — последним, предварительно выяснив, какой контроллер (например, CSI) их поставил и зачем.
Почему у Deployment так не бывает и спасает ли maxUnavailable
Первый вопрос от разработчиков всегда один: «у нас в Deployment то же самое случалось, там само откатывалось, почему тут нет?». Потому что Deployment управляет ReplicaSet'ами и не гарантирует ни порядка, ни идентичности: при откате он просто масштабирует старый ReplicaSet обратно, а новый — в ноль, и сломанные поды исчезают сами. У StatefulSet каждый под — именованная сущность с собственным PVC и стабильным DNS-именем; контроллер не может «просто выкинуть» реплику, потому что за ней стоит состояние. Отсюда и последовательность, и ожидание Ready, и отсутствие автоотката. Это не недоработка, это плата за гарантии.
Второй вопрос — про maxUnavailable. Поле .spec.updateStrategy.rollingUpdate.maxUnavailable действительно есть и позволяет обновлять больше одной реплики одновременно, но проверьте статус фичи в вашей версии, прежде чем на неё закладываться. По таблице фича-гейтов Kubernetes путь такой: MaxUnavailableStatefulSet был alpha с 1.24 по 1.34 (по умолчанию выключен), в 1.35.0–1.35.3 стал beta и включённым по умолчанию, в 1.35.4–1.36 дефолт вернули в false, и только в 1.37 гейт снова beta и включён по умолчанию. Такие качели — сами по себе повод не строить на этом поле процессы для боевых баз, особенно если у вас managed-кластер, где гейты вам никто не даст переключать. Значение поля — число или процент от реплик (процент округляется вверх), ноль недопустим, по умолчанию 1.
И главное: maxUnavailable вашу проблему не решает, а усугубляет. Он позволяет контроллеру держать недоступными не одну реплику за раз, а несколько — и вместо одного залипшего пода вы рискуете получить два или три, то есть потерю кворума и реальный простой вместо деградации. Документация отдельно предупреждает: неготовый под из диапазона 0…replicas-1 засчитывается в maxUnavailable. Для stateless-нагрузок вроде независимых шардов кеша поле полезное. Для Patroni и RabbitMQ я его не поднимаю выше единицы и другим не советую.
Третий соблазн — podManagementPolicy: Parallel, «пусть не ждёт». Тут надо быть точным. По документации 1.37 при Parallel и maxUnavailable больше 1 контроллер при обновлении удаляет и создаёт до maxUnavailable подов одновременно (так называемый bursting), и поды могут становиться Ready не по порядку. А раздел Forced rollback описывает тупик именно для политики OrderedReady. Но во время аварии это знание бесполезно: podManagementPolicy нельзя поменять у существующего StatefulSet, API такое обновление отклонит. Сменить политику можно только пересозданием объекта через kubectl delete sts <имя> --cascade=orphan с последующим apply — отдельная плановая операция с собственными рисками, и для кворумной базы параллельный режим сам по себе сомнителен. Скажу честно: в 1.37 для StatefulSet на OrderedReady штатного способа заставить контроллер самостоятельно перешагнуть через сломанную реплику нет. Единственный рабочий — удалить её руками.
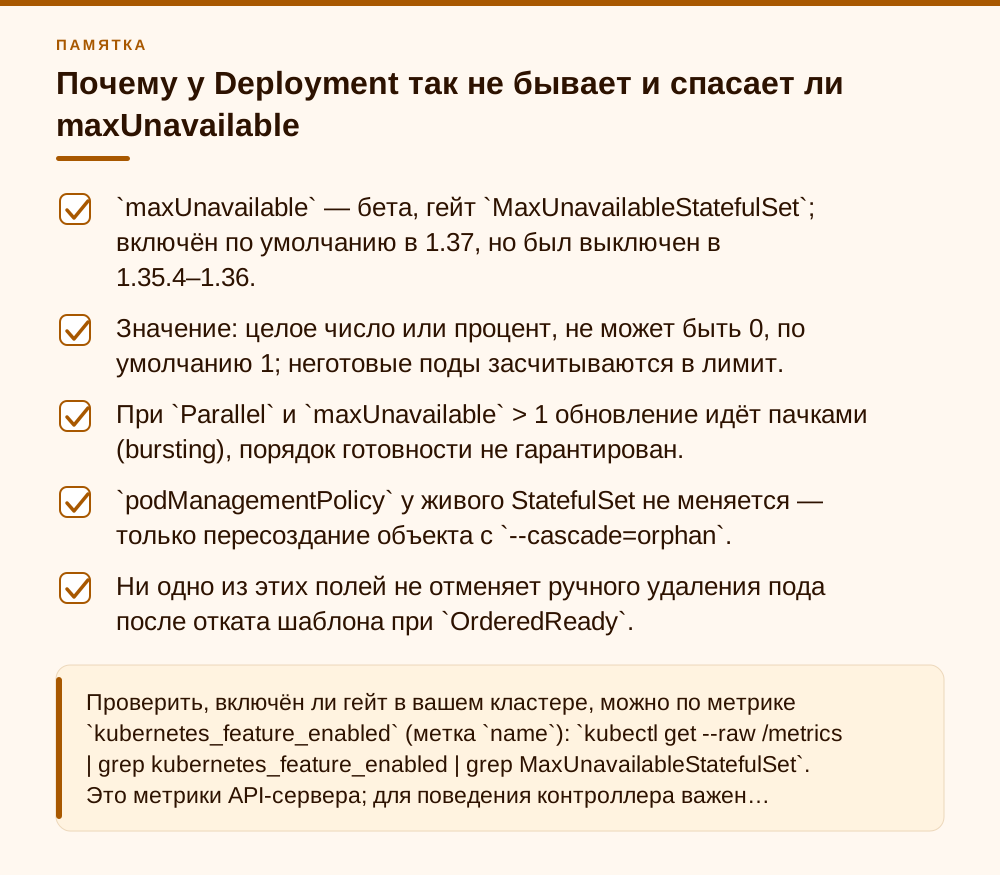
- `maxUnavailable` — бета, гейт `MaxUnavailableStatefulSet`; включён по умолчанию в 1.37, но был выключен в 1.35.4–1.36.
- Значение: целое число или процент, не может быть 0, по умолчанию 1; неготовые поды засчитываются в лимит.
- При `Parallel` и `maxUnavailable` > 1 обновление идёт пачками (bursting), порядок готовности не гарантирован.
- `podManagementPolicy` у живого StatefulSet не меняется — только пересоздание объекта с `--cascade=orphan`.
- Ни одно из этих полей не отменяет ручного удаления пода после отката шаблона при `OrderedReady`.
Как не попадать в эту яму: партиции, preflight и честные пробы
Самый дешёвый и самый недооценённый инструмент — партиционированная раскатка. Ставите partition, равный числу реплик минус один, и обновляется только самый старший под — канарейка. Убедились, что он поднялся и работает, — двигаете partition вниз. Для трёх-пяти реплик БД это три-пять команд и полный контроль над каждым шагом:
spec:
  updateStrategy:
    type: RollingUpdate
    rollingUpdate:
      partition: 2
При трёх репликах с partition: 2 обновится только rmq-2. Дальше kubectl patch sts rmq -p '{"spec":{"updateStrategy":{"rollingUpdate":{"partition":1}}}}' и так до нуля. Да, ручной труд. Зато сломанной оказывается ровно одна реплика, и вы это видите до того, как обновление доедет до кворума.
Второе — preflight-проверка образа в пайплайне. Опечатка в теге и образ, не запушенный в приватный реестр, — самые частые причины именно этого дедлока: из моих последних шести случаев четыре были ровно про это. Проверка занимает секунду и ставится перед helm upgrade:
crane manifest registry.local/rabbitmq:4.1.5-management >/dev/null \
  || { echo 'НЕТ ТАКОГО ТЕГА В РЕЕСТРЕ'; exit 1; }
# или: skopeo inspect docker://registry.local/rabbitmq:4.1.5-management
Для критичных StatefulSet я вообще перевожу image на digest: registry.local/rabbitmq@sha256:.... Тогда опечатку ловит не кластер в 19:41, а CI в 19:32.
Третье — readinessProbe. Вторая по частоте причина залипания: образ подтянулся, контейнер стартовал, а проба не проходит — из-за конфига, незавершённой миграции схемы или недоступной зависимости. Механика та же самая, дедлок тот же, но диагностика сложнее: под в Running 0/1, а не в ImagePullBackOff, и события молчат. Главное правило — не делайте readinessProbe, которая зависит от готовности всего кластера. Проба вида «отвечаю Ready, только когда кворум собран» превращает первую же обновляемую реплику в вечное ожидание на ровном месте, без всякого сломанного образа.
Четвёртое — не давайте пайплайну «зеленеть» на залипшем StatefulSet. Добавьте в шаг деплоя явный таймаут, чтобы падение было видно сразу, а не через сутки:
kubectl -n prod rollout status sts/rmq --timeout=300s || {
  kubectl -n prod get pods -l app=rmq
  kubectl -n prod describe sts rmq | tail -30
  exit 1
}
Плюс отдельный алерт в мониторинге на расхождение ревизий дольше 15 минут. Метрики kube_statefulset_status_current_revision и kube_statefulset_status_update_revision отдаёт kube-state-metrics, но хеш ревизии лежит в метке revision, а значение метрики всегда 1 — поэтому сравнивать надо метки, а не числа:
- alert: StatefulSetRolloutStuck
  expr: |
    kube_statefulset_status_update_revision
      unless on (namespace, statefulset, revision)
    kube_statefulset_status_current_revision
  for: 15m
  labels:
    severity: warning
Правило ловит вообще все залипшие раскатки StatefulSet, а не только историю с образом.
- `partition` для канареечного обновления реплик БД и брокеров — обязательно
- проверка существования тега/дайджеста в реестре до применения манифеста
- image по digest для критичных StatefulSet вместо плавающих тегов
- readinessProbe, не зависящая от кворума кластера
- `rollout status --timeout` в CI и алерт на расхождение currentRevision/updateRevision
Чек-лист дежурного и что можно спокойно отложить
Сведу всё в порядок действий, который можно отдать человеку на дежурстве. Первое: оценить реальный ущерб — сколько реплик Ready, держится ли кворум, страдают ли пользователи. Второе: посмотреть describe pod у неготовой реплики и понять класс проблемы — образ, проба, монтирование тома, планировщик. Третье: вернуть шаблон. Четвёртое: удалить залипшие поды обычным delete, по одному, сверху вниз. Пятое: дождаться rollout status и убедиться, что ревизии сошлись. Всё. В девяти случаях из десяти это укладывается в пять минут.
Чего делать не надо. Не надо удалять сам StatefulSet «чтобы пересоздался» — при удалении объекта в игру вступает persistentVolumeClaimRetentionPolicy, и если она настроена на удаление PVC, вы попрощаетесь с данными. Не надо трогать PVC руками. Не надо форсить удаление всех реплик разом. Не надо в три часа ночи включать фича-гейты, переезжать на оператор или переписывать Helm-чарт — это утренние задачи, и решать их на горячую голову дороже, чем сам инцидент.
На что можно спокойно забить в моменте: на расхождение revisionHistoryLimit, на «некрасивые» события в describe, на алерты по отдельной неготовой реплике, если кворум цел и трафик обслуживается. Деградация отказоустойчивости — это про «починить сегодня», а не «бежать сейчас». Разница между этими двумя состояниями и есть главное, что отличает спокойное дежурство от лихорадочного, после которого приходится восстанавливать базу из бэкапа.
И последнее наблюдение. Почти все случаи, что я разбирал, объединяет одно: люди искали ошибку в кластере — в CNI, в реестре, в CSI, в RBAC, — потому что не верили, что штатное поведение может выглядеть настолько похоже на поломку. Здесь ровно этот случай: кластер работает как задумано, просто задумано так, что без человека он из этого состояния не выйдет. Знание этого факта экономит те самые сорок семь минут.
- оценить ущерб: Ready-реплики, кворум, влияние на пользователей
- `kubectl describe pod` — определить класс проблемы (образ / проба / том)
- вернуть рабочий шаблон (helm rollback, git revert, rollout undo)
- удалить залипшие поды обычным delete, по одному, от старшего ординала
- дождаться сходимости currentRevision и updateRevision
- разбор причин и правки в пайплайн — утром, не в ночь
Частые вопросы
Почему kubectl rollout undo для StatefulSet не помогает сам по себе?
Он делает ровно то, что обещает: возвращает прежний шаблон подов и создаёт новую ревизию. Но контроллер при политике OrderedReady продолжает ждать, пока под, запущенный со сломанной конфигурацией, станет Running и Ready, и до этого момента не берётся за следующие. Поэтому после undo нужно вручную удалить залипшие поды — тогда они пересоздадутся уже по возвращённому шаблону.
Нужно ли удалять под с --force и --grace-period=0?
В сценарии «плохой образ / непроходящая проба» — нет, достаточно обычного kubectl delete pod. Форс нужен только когда под завис в Terminating из-за недоступного kubelet на упавшей ноде. При этом форс ломает гарантию StatefulSet «не более одного пода с данной идентичностью» и на кворумных СУБД может привести к split-brain и порче данных.
Потеряю ли я данные, если удалю под StatefulSet?
Нет. Удаление пода не затрагивает его PersistentVolumeClaim: контроллер создаст под с тем же именем и примонтирует тот же том. Опасно другое — удаление самого объекта StatefulSet при persistentVolumeClaimRetentionPolicy с whenDeleted: Delete, а также ручное удаление PVC. Проверяйте эту политику до любых операций с объектом.
Как отличить залипшую раскатку от идущей?
Сравните status.currentRevision и status.updateRevision у StatefulSet: если они расходятся дольше десяти-пятнадцати минут и число readyReplicas не растёт, раскатка стоит. Дополнительно посмотрите события у неготового пода: ImagePullBackOff, CrashLoopBackOff или Readiness probe failed. Алерт на расхождение ревизий по метрикам kube-state-metrics ловит это автоматически.
Поможет ли podManagementPolicy: Parallel или maxUnavailable обойти сломанную реплику?
Во время аварии — нет. podManagementPolicy у существующего StatefulSet изменить нельзя, только пересоздав объект, а раздел Forced rollback описывает тупик именно для OrderedReady. maxUnavailable позволяет обновлять несколько реплик сразу (при Parallel — пачками), то есть при плохом образе сломает не одну реплику, а несколько, и вместо деградации вы получите потерю кворума. К тому же гейт MaxUnavailableStatefulSet до 1.37 несколько раз менял значение по умолчанию.
Как вообще не доводить до forced rollback?
Три вещи закрывают почти все случаи: канареечное обновление через partition, проверка существования образа в реестре (crane/skopeo) до применения манифеста и readinessProbe, не зависящая от кворума всего кластера. Плюс rollout status с таймаутом в CI, чтобы пайплайн падал сразу, а не показывал зелёный статус на залипшем StatefulSet.
Источники
- Kubernetes — StatefulSets, раздел Forced rollback — Официальная документация Kubernetes, Concepts → Workloads → StatefulSets, разделы «Rolling Updates», «Partitioned rolling updates», «Maximum unavailable Pods», «Forced rollback» (актуально для v1.37): https://kubernetes.io/docs/concepts/workloads/controllers/statefulset/
- Kubernetes — Force Delete StatefulSet Pods — Официальная документация Kubernetes, Tasks → Run Applications → «Force Delete StatefulSet Pods»: гарантия «at most one Pod with a given identity», команды delete --grace-period=0 --force и patch финализаторов, порядок действий при недоступной ноде: https://kubernetes.io/docs/tasks/run-application/force-delete-stateful-set-pod/
- Kubernetes — Feature Gates (MaxUnavailableStatefulSet) — Официальная таблица фича-гейтов: MaxUnavailableStatefulSet — Alpha 1.24–1.34 (false), Beta 1.35.0–1.35.3 (true), Beta 1.35.4–1.36 (false), Beta с 1.37 (true): https://kubernetes.io/docs/reference/command-line-tools-reference/feature-gates/
- kubernetes/kubernetes issue #67250 — «StatefulSet - can't rollback from a broken state» — тикет, на который ссылается раздел Forced rollback в документации как на known issue; тикет закрыт, но требование удалять сломанные поды вручную в документации 1.37 сохраняется: https://github.com/kubernetes/kubernetes/issues/67250
- kube-state-metrics — StatefulSet Metrics — Документация kube-state-metrics: kube_statefulset_status_current_revision и kube_statefulset_status_update_revision (STABLE), ревизия передаётся в метке revision: https://github.com/kubernetes/kube-state-metrics/blob/main/docs/metrics/workload/statefulset-metrics.md
- kubectl — логика rollout status для StatefulSet — Исходный код kubectl, staging/src/k8s.io/kubectl/pkg/polymorphichelpers/rollout_status.go — тексты «Waiting for N pods to be ready», «Waiting for partitioned roll out to finish», «waiting for statefulset rolling update to complete»: https://github.com/kubernetes/kubernetes/blob/master/staging/src/k8s.io/kubectl/pkg/polymorphichelpers/rollout_status.go
- Kubernetes Releases — Страница поддерживаемых релизов: 1.37.0 выпущен 26.08.2026 (EOL 28.10.2027), поддерживаются также 1.36 и 1.35: https://kubernetes.io/releases/
- Флант — Как мы работаем со Stateful в Kubernetes: особенности и подводные камни — Практический разбор эксплуатации stateful-нагрузок в Kubernetes (порядок обновления, PVC, кворум): https://habr.com/en/companies/flant/articles/809377/