
Как настроить node_exporter на Proxmox VE и не оставить порт 9100 открытым всей сети
На хост Proxmox VE node_exporter ставится одной командой apt install prometheus-node-exporter, слушает порт 9100 и отдаёт метрики железа, дисков, ZFS и сети по пути /metrics. Главное, что нужно сделать после установки, — закрыть порт файрволом PVE и добавить хост в scrape_configs. Ниже — пакет против бинарника, ключи запуска, firewall, подключение к Prometheus и разбор на клубе из 50 рабочих мест.
Зачем нужен node_exporter на хосте Proxmox, если есть встроенная статистика
Я ставлю мониторинг в небольших компаниях больше пятнадцати лет, и с Proxmox всегда повторяется одна история. Администратор открывает веб-интерфейс на порту 8006, видит красивые графики загрузки и думает, что мониторинг у него есть. А потом ночью заполняется диск, и узнаёт он об этом утром от бухгалтера, у которой не открылась 1С. Графики в интерфейсе показывают, что происходит сейчас, но не будят вас и не хранят историю в удобном для запросов виде. Если вам нужен мониторинг серверов и виртуализации под ключ, начинается он именно со сбора метрик с самих хостов, и node_exporter для этого самый простой и самый надёжный вариант.
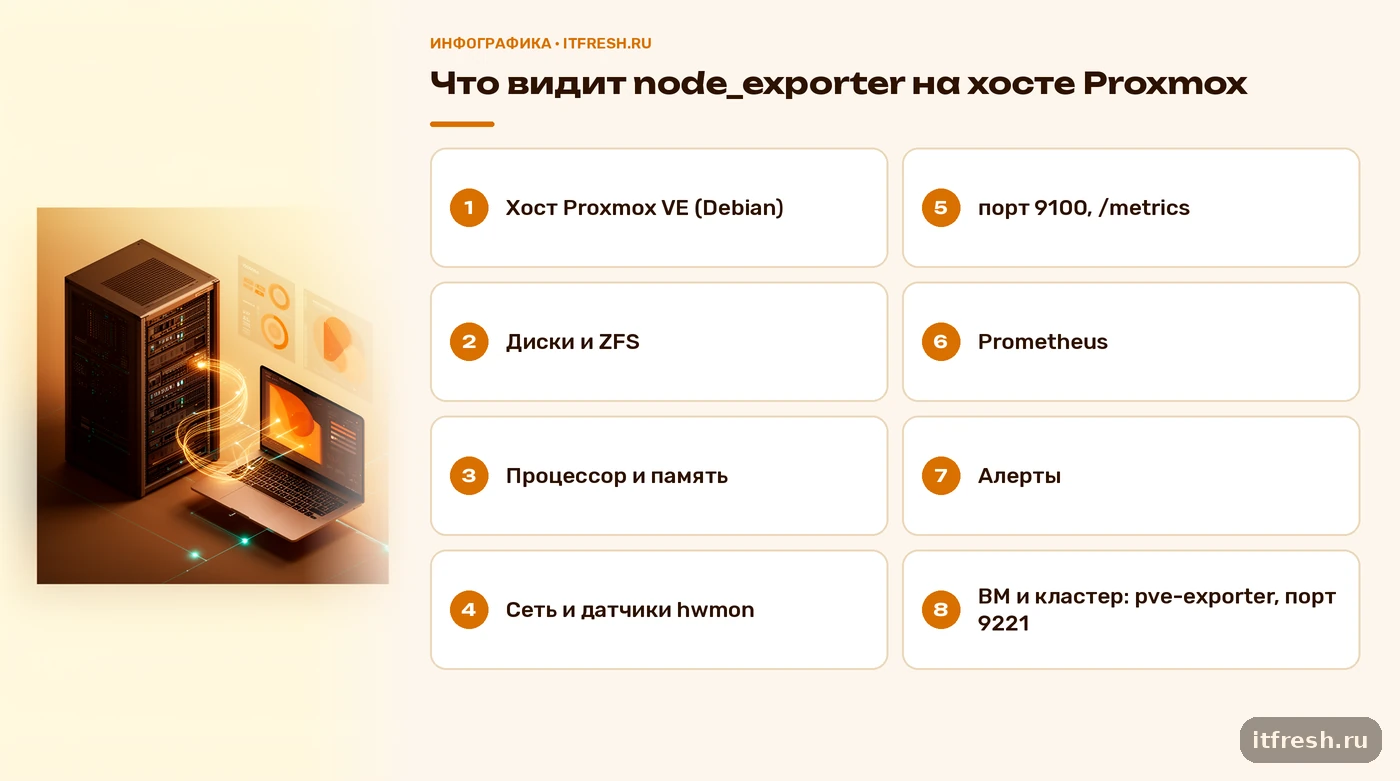
Что это такое. node_exporter — официальный экспортёр проекта Prometheus для машин с unix-системами. Документация Prometheus описывает его как один статический бинарник, который по умолчанию слушает HTTP-порт 9100 и отдаёт метрики по адресу /metrics. Proxmox VE работает поверх Debian (девятая версия — на Debian 13 «trixie», это видно по репозиториям в документации Proxmox), поэтому для экспортёра хост — обычный Linux, и всё, что работает на Debian, работает и тут. Он отдаёт загрузку процессора, память, нагрузку, сетевые интерфейсы, диски и файловые системы, датчики из /sys/class/hwmon и статистику ZFS: коллекторы filesystem, hwmon и zfs включены по умолчанию, отдельно их подключать не нужно.
Важная граница, которую понимают не все. node_exporter видит только то, что видит операционная система хоста. Он знает, что на узле занято 87 процентов раздела и что температура процессора выросла, но ничего не знает про виртуальные машины как про объекты: какая ВМ остановлена, сколько памяти выдано гостю, живёт ли контейнер. Для этого нужен отдельный экспортёр уровня Proxmox API, о нём я скажу в пятом разделе. Поэтому я воспринимаю node_exporter как фундамент: сначала железо и ОС хоста, потом всё остальное.
Нативные возможности Proxmox тут не помогают. Раздел документации про внешние серверы метрик перечисляет три варианта: Graphite, InfluxDB и OpenTelemetry. Prometheus в этом списке нет, и опрашивать сам хост Prometheus’у нечем без отдельного экспортёра. Если вы только выбираете систему, сравнение подходов я разбирал в статье Zabbix или Prometheus для офиса, а здесь исхожу из того, что выбор уже сделан в пользу Prometheus и нужно просто подключить хосты.
Как установить node_exporter на Proxmox: пакет из Debian или бинарник с GitHub
Есть два пути, и выбираю я между ними по одному критерию — кто будет обновлять. Первый путь — пакет prometheus-node-exporter из репозиториев Debian. В Debian 13 он есть, его версия в stable — 1.9.0, пакет рекомендует (Recommends) prometheus-node-exporter-collectors, то есть набор дополнительных скриптов для textfile-коллектора. Плюс очевидный: пакет приносит готовую службу systemd, пользователя и файл параметров, а обновляется вместе со всей системой через apt. Минус тоже очевиден: версия в Debian отстаёт от upstream. На момент написания статьи последний релиз node_exporter на GitHub — 1.12.1 от 14 июля 2026 года, и для обычного мониторинга хоста разница в версиях мне не мешает.
Ставится пакет так, на самом хосте под root:
apt update
apt install prometheus-node-exporter
systemctl status prometheus-node-exporter
curl -s http://localhost:9100/metrics | head -n 20
Имя службы — prometheus-node-exporter, оно совпадает с именем пакета, и это частая причина путаницы: люди ищут службу node_exporter и не находят. Из исходников пакета видно, что служба запускается от пользователя prometheus, читает параметры из файла /etc/default/prometheus-node-exporter и стартует /usr/bin/prometheus-node-exporter с переменной ARGS. Если curl вернул строки вида HELP и TYPE с метриками, экспортёр работает.
Второй путь — бинарник с GitHub. Беру его, когда нужна конкретная свежая версия или когда хосты в разных дистрибутивах и хочется одинаковую версию везде. Документация Prometheus показывает схему: скачать архив релиза, распаковать и запустить бинарник. Для постоянной работы я делаю то же самое, но руками настраиваю пользователя и службу:
VER=1.12.1
cd /tmp
wget https://github.com/prometheus/node_exporter/releases/download/v${VER}/node_exporter-${VER}.linux-amd64.tar.gz
tar xvfz node_exporter-${VER}.linux-amd64.tar.gz
install -m 0755 node_exporter-${VER}.linux-amd64/node_exporter /usr/local/bin/node_exporter
useradd --system --no-create-home --shell /usr/sbin/nologin node_exporter
Имя архива построено по тому же шаблону, что в примере документации (там версия 1.10.2); проверьте на странице релизов, что для вашей архитектуры файл называется именно так.
Службу для бинарника пишу сам, это стандартный unit без изысков:
cat > /etc/systemd/system/node_exporter.service <<'EOF'
[Unit]
Description=Prometheus node_exporter
After=network-online.target
Wants=network-online.target

[Service]
User=node_exporter
ExecStart=/usr/local/bin/node_exporter
Restart=on-failure

[Install]
WantedBy=multi-user.target
EOF
systemctl daemon-reload
systemctl enable --now node_exporter
Не ставьте оба варианта на один хост. Два экспортёра подерутся за порт 9100, и второй просто не запустится. Я для клиентов с одним-двумя узлами почти всегда беру пакет Debian: обновления прилетают вместе с остальными, и об экспортёре не нужно помнить отдельно. Бинарник оставляю для случаев, когда нужен новый коллектор из свежего релиза.
Как настроить параметры запуска: порт, коллекторы, ZFS и textfile
В пакете Debian все ключи запуска задаются через переменную ARGS в файле /etc/default/prometheus-node-exporter. Комментарии в этом файле напоминают про экранирование: обратные слэши в регулярных выражениях приходится удваивать, а под systemd — ещё раз. Я стараюсь регулярки вообще не писать, пока без них можно обойтись. Базовая правка выглядит так:
nano /etc/default/prometheus-node-exporter
# ARGS="--web.listen-address=192.0.2.11:9100"
systemctl restart prometheus-node-exporter
ss -tlnp | grep 9100
Ключ --web.listen-address привязывает экспортёр к одному адресу вместо всех интерфейсов. Список ключей всегда проверяйте командой prometheus-node-exporter --help (или node_exporter --help для бинарника) в своей версии: набор коллекторов растёт от релиза к релизу, а в 1.12.0, например, появились новые коллекторы nvmesubsystem и dmmultipath.
Что включено по умолчанию, я уже упоминал: на хосте Proxmox меня интересуют filesystem, hwmon, zfs, diskstats, netdev, meminfo, loadavg и cpu. Менять набор по умолчанию обычно незачем. README проекта даже советует включать дополнительные коллекторы по одному и сначала проверять на непромышленной системе. Если же нужно оставить только несколько штук, используется ключ --collector.disable-defaults вместе с --collector.<имя> для каждого нужного. На практике я делаю это только на очень слабых машинах, где нужно сэкономить каждый процент процессора, а на серверах виртуализации лишний коллектор стоит доли процента.
Отдельная история с коллектором systemd, и здесь пакет Debian ведёт себя не так, как upstream. В README проекта systemd числится среди выключенных по умолчанию, и для бинарника с GitHub его включают ключом --collector.systemd. А вот в пакете Debian патч меняет умолчание: коллектор systemd там уже включён (он ходит в systemd через D-Bus, поэтому пакет и рекомендует dbus). Он показывает состояние служб, и на хосте Proxmox это полезно: можно получать сигнал, когда падает pve-cluster, corosync или pvedaemon. Чтобы не получать метрики сотен ненужных юнитов, я ограничиваю его ключом --collector.systemd.unit-include с регулярным выражением. Мой набор для узла кластера — pve-cluster, corosync, pvedaemon, pveproxy и pve-firewall, остальное шум.
Отдельно скажу про ZFS, потому что на Proxmox он встречается очень часто. Коллектор zfs включён по умолчанию и отдаёт статистику производительности ZFS, в том числе по ARC, с префиксом node_zfs_. Это полезно: когда узел начинает тормозить, первая гипотеза — не хватает памяти под ARC, и по метрикам видно, что происходит. А вот состояние пулов и ошибок записи через node_exporter красиво не получается, для этого я пишу небольшой скрипт и отдаю результат через textfile-коллектор.
Textfile-коллектор включён по умолчанию, но у upstream-бинарника каталог пустой, и без ключа --collector.textfile.directory читать ему нечего. В пакете Debian умолчание изменено патчем: каталог /var/lib/prometheus/node-exporter прописан сразу, ключ указывать не нужно. Коллектор читает все файлы *.prom в каталоге, метки времени внутри не поддерживаются, а файлы должны читаться пользователем prometheus (так написано в README.textfile пакета). Что стоит запомнить: файл нужно записывать во временное имя и затем переименовывать, иначе экспортёр может прочитать недописанный файл. Пример для кластера, где я хочу знать, когда последний раз отработал бэкап:
TMP=$(mktemp /var/lib/prometheus/node-exporter/.backup.XXXXXX)
echo "backup_last_success_timestamp_seconds $(date +%s)" > $TMP
chmod 644 $TMP
mv $TMP /var/lib/prometheus/node-exporter/backup.prom
Имя метрики backup_last_success_timestamp_seconds — моё собственное, не стандартное. Скрипт вызываю в хуке после успешного задания, а в Prometheus по нему строю алерт: «с момента последнего успеха прошло больше 26 часов». Про сам бэкап и сервер для него я писал в статье Proxmox Backup Server: установка и настройка, и там метрики PBS разобраны отдельно, а здесь только то, что видит хост.
Как закрыть порт 9100: файрвол Proxmox, привязка к адресу и пароль
Это самый важный раздел статьи, и именно его чаще всего пропускают. node_exporter по умолчанию не требует никакой аутентификации и слушает порт 9100 на всех интерфейсах. Любой, кто доберётся до этого порта, получит подробный список железа, версию ядра, точки монтирования, имена сетевых интерфейсов и загрузку хоста. Это не уязвимость экспортёра, это его задумка: он рассчитан на доверенную сеть. Но в сети, где у вас стоят Wi-Fi для посетителей, камеры и принтеры, доверенной сеть назвать нельзя, и я закрываю порт всегда.
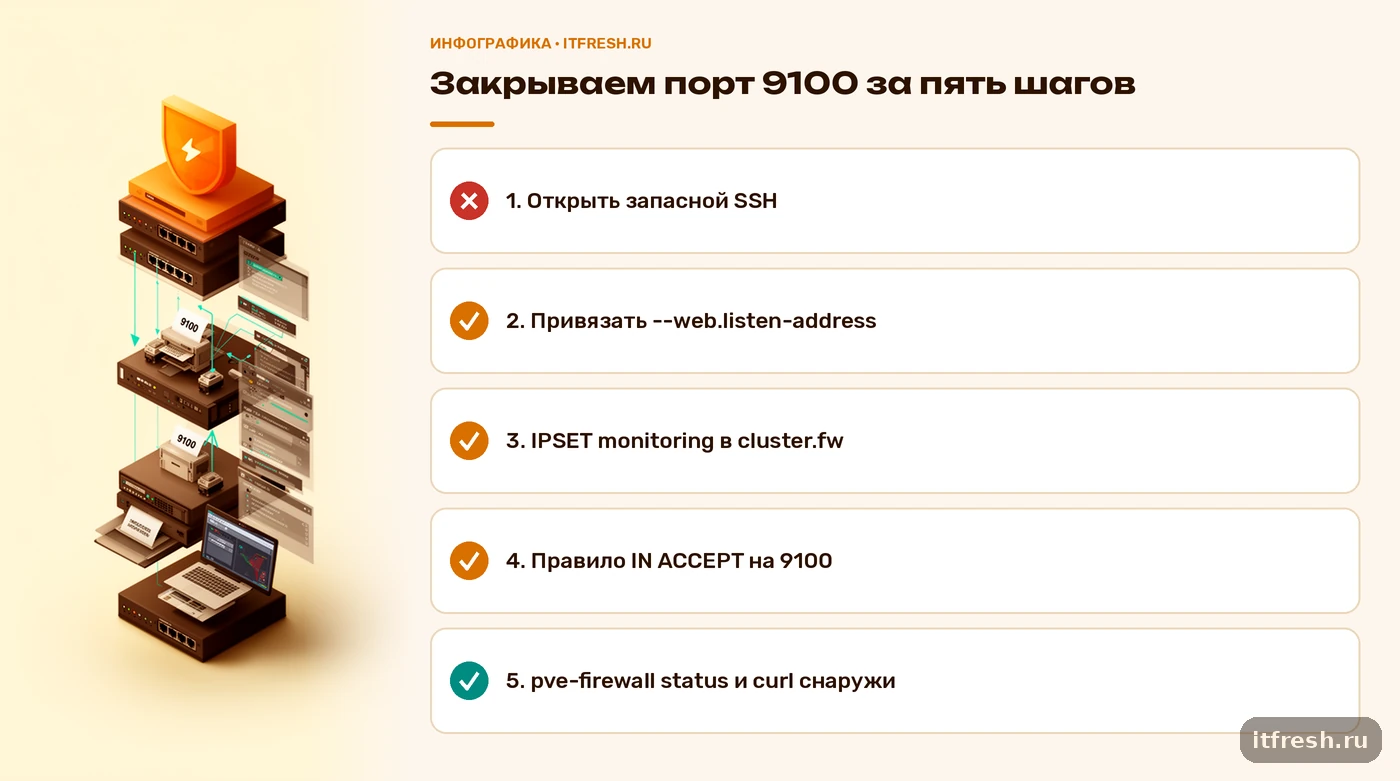
Самый простой слой защиты — привязка к адресу управления через --web.listen-address, как в предыдущем разделе: тогда экспортёр не откликнется на интерфейсах гостевых сетей и мостов виртуальных машин. Второй слой — файрвол Proxmox. Его конфигурация лежит в /etc/pve/firewall/cluster.fw для кластера и в /etc/pve/nodes/<имя узла>/host.fw для конкретного хоста. Файрвол по умолчанию выключен, включается строкой enable: 1 в разделе [OPTIONS] файла cluster.fw. Документация отдельно просит открыть SSH-сессию на хост до включения. Прислушайтесь к этому совету: если ошибётесь в правилах, веб-интерфейс на 8006 можно потерять, а без SSH вы вернуться не сможете, хотя по умолчанию доступ с управляющих адресов к 8006, 22 и ряду портов разрешён.
Рецепт у меня такой. В cluster.fw заводится набор адресов с сервером мониторинга, а в правилах разрешается входящий TCP на 9100 только с него:
# /etc/pve/firewall/cluster.fw
[IPSET monitoring]
10.10.5.20

[RULES]
IN ACCEPT -p tcp -dport 9100 -source +monitoring
Синтаксис раздела IPSET, ссылку на набор через знак плюс (+имя) и форму правила с -p tcp и -dport документация Proxmox показывает в примерах для SSH и HTTP. После правки сразу выполните pve-firewall status: команда читает и компилирует правила и ругается предупреждениями, если где-то опечатка. Если у вас узлы кластера опрашивают друг друга, добавьте их адреса в тот же набор или заведите отдельный.
Третий слой — аутентификация и шифрование. Экспортёр поддерживает файл веб-конфигурации, который передаётся ключом --web.config.file; раздел про TLS в README помечен как экспериментальный. В файле можно задать пароль для basic-аутентификации (пароли хранятся как хеши bcrypt, хеш можно получить командой htpasswd -nBC 10) и пару cert_file и key_file для TLS. Со стороны Prometheus в scrape-конфигурации используются поля scheme, basic_auth и tls_config с ca_file. Нужно ли это в маленьком офисе? Если мониторинг и хосты в одной изолированной сети управления с файрволом, я останавливаюсь на двух первых слоях: привязка и правила файрвола дают 95 процентов защиты за пять минут. Если же метрики идут через границу сетей, например в облако или в другой филиал, добавляйте TLS и пароль обязательно. Открытый всем экспортёр — то, что я проверяю в первую очередь, когда смотрю чужую инфраструктуру.
Как подключить node_exporter с Proxmox к Prometheus и что мониторить
Теперь Prometheus. Подключение хостов — это раздел scrape_configs в prometheus.yml. Документация Prometheus показывает минимальный пример с job_name и static_configs, и для нескольких узлов он расширяется просто списком адресов:
global:
  scrape_interval: 30s

scrape_configs:
  - job_name: pve-nodes
    static_configs:
      - targets: ['10.10.5.11:9100', '10.10.5.12:9100']
        labels:
          role: hypervisor
      - targets: ['10.10.5.13:9100']
        labels:
          role: backup
Интервал по умолчанию наследуется из глобальной секции, а там по умолчанию стоит одна минута. Для хостов виртуализации я ставлю 30 секунд: достаточно, чтобы видеть всплески, и не раздувает базу. Если нужен более частый сбор, помните, что таймаут сбора не может превышать интервал. Метки role я добавляю сразу, потому что потом по ним удобно писать правила.
Как выглядит минимум правил, который я ставлю каждому клиенту. Первое и главное — метрика up. Prometheus сам создаёт её для каждой цели: единица, если сбор удался, ноль, если нет. Правило up == 0 в течение пяти минут сообщает, что экспортёр или сам хост недоступен. Второе — место на файловых системах. Метрики node_filesystem_avail_bytes и node_filesystem_size_bytes позволяют посчитать долю свободного места, и порог 15 процентов я ставлю на всё, кроме служебных файловых систем вроде tmpfs. Третье — память и нагрузка: node_memory_MemAvailable_bytes и node_load1. Четвёртое — температура с датчиков hwmon (метрика node_hwmon_temp_celsius), которая на хостах в тесных стойках нужнее всего.
Как я готовлю графики. Для просмотра всё это удобно показывать в Grafana, и как собрать готовую панель, я разбирал в статье Prometheus и Grafana с нуля на сервере. Не пишите дашборды с нуля: возьмите готовый дашборд для node_exporter из каталога Grafana и уберите лишнее. Метки instance и job, которые Prometheus добавляет к каждой метрике, позволяют фильтровать панели по конкретному узлу.
Теперь про то, чего node_exporter не даёт. По виртуальным машинам и контейнерам, по состоянию кластера и хранилищ Proxmox нужен отдельный экспортёр уровня API — prometheus-pve-exporter. Он собирает данные с узлов Proxmox VE для Prometheus, по умолчанию слушает порт 9221, читает настройки из /etc/prometheus/pve.yml, а пользователю для него нужна роль PVEAuditor (только чтение) на корневом пути. В scrape-конфигурации для него используется metrics_path: /pve. Я подключаю его вторым слоем, когда клиенту реально нужны метрики по отдельным ВМ. Если же вас интересует только «железо живо и место есть», хватает одного node_exporter. Для консолидации серверов и рабочих нагрузок на Proxmox есть материал консолидация серверов офиса на Proxmox.
Как это выглядело на практике: два узла и сервер бэкапов в «Атлетике Плюс»
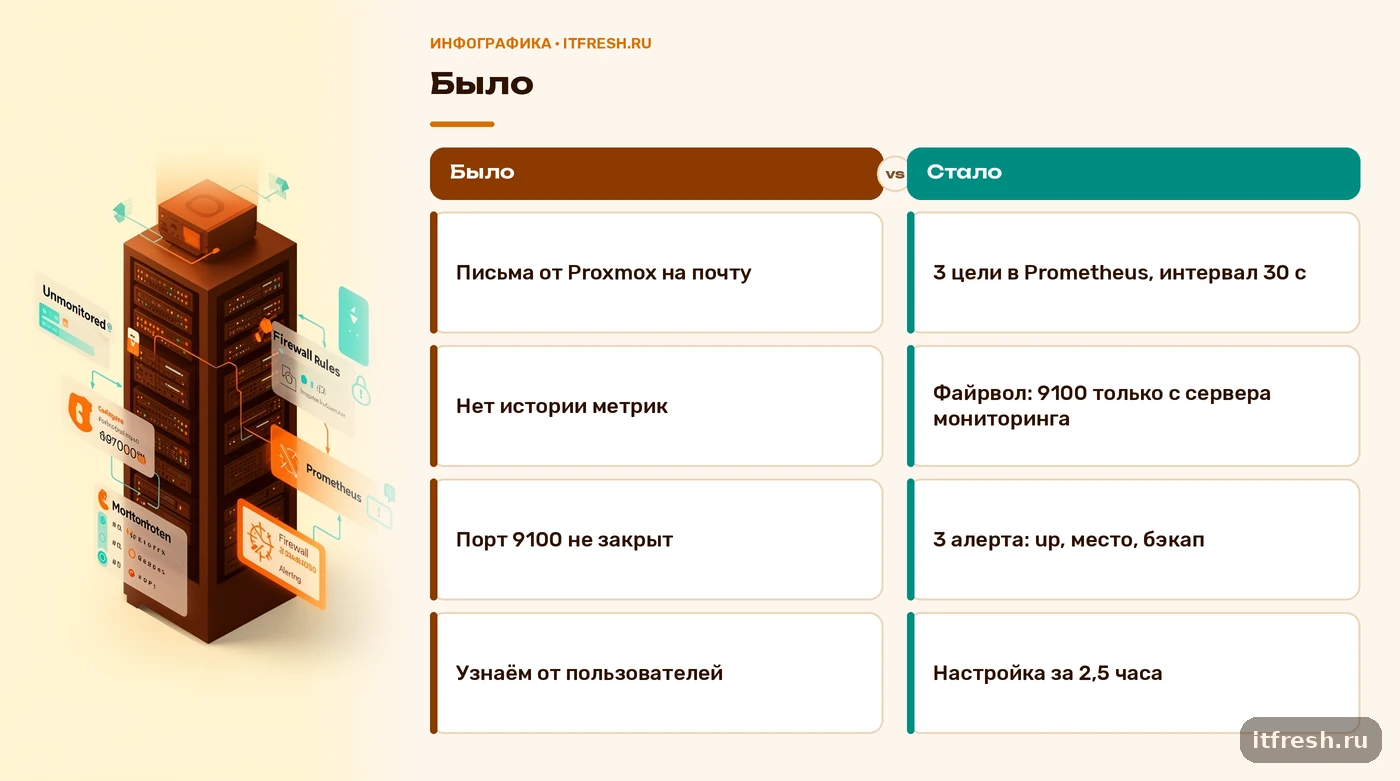
Условный пример из моих проектов — спортивный клуб «Атлетика Плюс», 50 рабочих мест: ресепшн, тренерская, бухгалтерия, администраторы нескольких залов. Инфраструктура: два узла Proxmox VE 9 в кластере с QDevice, отдельный сервер Proxmox Backup Server и около полутора десятков виртуальных машин — 1С, CRM клуба, контроллер СКУД, видеонаблюдение, файловый сервер. До нашей работы мониторингом служили письма от самого Proxmox на почту администратора и ощущения сотрудников. Задача стояла простая: узнавать о проблеме с хостом раньше, чем о ней узнает администратор клуба.
Что мы сделали за один рабочий вечер, примерно два с половиной часа. Поставили пакет prometheus-node-exporter на оба узла и на сервер бэкапов: все три хоста на Debian, поэтому процедура одинакова. Привязали экспортёр к адресу управляющей сети через ARGS в /etc/default/prometheus-node-exporter. В cluster.fw завели набор monitoring с единственным адресом сервера мониторинга и одно правило на входящий TCP 9100, после чего проверили pve-firewall status и сделали проверку curl снаружи. Подключили три цели в prometheus.yml с меткой role и интервалом 30 секунд. Коллектор systemd в пакете Debian уже включён, поэтому мы только ограничили его пятью службами Proxmox через --collector.systemd.unit-include.
Итог по цифрам такой: три цели, три правила алертов — up == 0 пять минут, свободное место меньше 15 процентов и устаревший файл backup.prom (старше 26 часов), — сообщения уходят администратору на почту. Стоимость поддержки практически нулевая: экспортёр потребляет мало ресурсов, обновляется вместе с системой, и на этом этапе мы к нему не возвращались. Через месяц клуб попросил добавить метрики по отдельным виртуалкам, и мы поставили prometheus-pve-exporter вторым слоем, не трогая то, что уже работало. Для сравнения, если бы мы строили всё на Zabbix, пришлось бы поднимать сервер Zabbix с базой, ставить агентов и подбирать шаблоны, а для двух узлов это избыточно, хотя при росте числа площадок я бы вернулся к вопросу, и о нём есть материал про Zabbix для малого офиса.
Типичные ошибки, которые я вижу чаще всего. Первая — открытый порт 9100 на все интерфейсы: проверка занимает минуту, а последствия неприятные. Вторая — ищут службу под именем node_exporter, а в Debian она называется prometheus-node-exporter. Третья — два экспортёра на одном хосте, пакет и бинарник, и один из них не стартует. Четвёртая — включили файрвол Proxmox, не открыв запасной SSH, и потеряли доступ. Пятая — мониторят хост и забывают мониторить сам мониторинг: если упадёт сервер Prometheus, алерты замолчат, и об этом тоже надо знать, например по внешней проверке доступности.
Частые вопросы
Какой порт использует node_exporter и как его поменять?
По умолчанию 9100, метрики отдаются по пути /metrics. Адрес и порт меняются ключом --web.listen-address; в пакете Debian ключи задаются переменной ARGS в файле /etc/default/prometheus-node-exporter, после правки нужен systemctl restart prometheus-node-exporter.
Как называется служба node_exporter в Proxmox и Debian?
Если ставили пакет из Debian, служба называется prometheus-node-exporter и запускается от пользователя prometheus. Если ставили бинарник с GitHub, имя службы зависит от того unit-файла, который вы создали сами, например node_exporter.
Можно ли ставить node_exporter прямо на хост Proxmox, или только в виртуальные машины?
Нужно ставить на хост: Proxmox VE построен на Debian, и экспортёр показывает железо, диски, ZFS и сеть узла. Внутри ВМ его ставят отдельно, чтобы видеть нагрузку гостя. Для Windows-гостей есть windows_exporter.
Как защитить порт 9100 от посторонних?
Привяжите экспортёр к адресу управляющей сети через --web.listen-address, разрешите входящий TCP 9100 только серверу мониторинга в файрволе Proxmox и проверьте curl с постороннего хоста. Для передачи через границу сетей добавьте TLS и пароль через --web.config.file.
Чем отличается node_exporter от prometheus-pve-exporter?
node_exporter собирает метрики операционной системы хоста: процессор, память, диски, ZFS, сеть. prometheus-pve-exporter берёт данные из API Proxmox VE: состояние узлов, ВМ, контейнеров и хранилищ. Порт по умолчанию — 9221, нужна роль PVEAuditor.
Источники
- Prometheus: мониторинг Linux с node_exporter — Порт 9100, путь /metrics, установка из tarball, пример scrape_configs, упоминание windows_exporter: https://prometheus.io/docs/guides/node-exporter/
- node_exporter README (GitHub) — Список коллекторов по умолчанию, systemd выключен по умолчанию в upstream (в пакете Debian включён патчем 0001-Debian-defaults.patch), textfile и --collector.textfile.directory, --collector.disable-defaults, --web.config.file: https://github.com/prometheus/node_exporter/blob/master/README.md
- node_exporter releases (GitHub) — Последний релиз 1.12.1 от 14.07.2026, изменения 1.12.0 и 1.11.1: https://github.com/prometheus/node_exporter/releases
- Debian: пакет prometheus-node-exporter — Версия 1.9.0 в trixie, Recommends prometheus-node-exporter-collectors; исходники пакета (служба, /etc/default, textfile-каталог): https://packages.debian.org/trixie/prometheus-node-exporter и https://sources.debian.org/src/prometheus-node-exporter/1.9.0-1/debian/
- Proxmox VE Wiki: Firewall — Файлы cluster.fw и host.fw, синтаксис IPSET и правил, порт 8006 и 22, команда pve-firewall status: https://pve.proxmox.com/wiki/Firewall
- prometheus-pve-exporter и Proxmox External Metric Server — Порт 9221, /etc/prometheus/pve.yml, роль PVEAuditor: https://github.com/prometheus-pve/prometheus-pve-exporter ; поддерживаемые внешние серверы метрик Proxmox: https://pve.proxmox.com/wiki/External_Metric_Server