
Как принять восстановленный бэкап Zimbra по фактам
Чтобы проверить бэкап Zimbra, я восстанавливаю его на изолированном стенде, сверяю состав данных и проверяю рабочие операции. Одного запуска служб недостаточно: он не доказывает, что вернулись нужные письма и вложения. Ниже — критерии приёмки, диагностика без автоматического ремонта и пример проверки допустимых потерь и времени восстановления.
Что на самом деле доказывает успешный бэкап
Я начинаю проверку с простого вопроса: какую именно аварию должна пережить почта? Удаление письма, потерю всей машины и повреждение хранилища проверяют разными сценариями. При обслуживании корпоративной почты я заранее согласую, какие ящики и функции должны вернуться. Иначе можно успешно восстановить архив одного сотрудника и ошибочно объявить готовым весь почтовый сервис. Объект проверки надо назвать до запуска задачи.
Зелёный отчёт имеет смысл в пределах того, что проверяла программа. Архиватор подтверждает упаковку файлов, средство копирования — выполнение своей операции. Специализированный модуль может проверять больше, поэтому я читаю его документацию и подробный отчёт. Универсального правила «все программы скрывают повреждения» нет. Есть ошибка приёмки: из сообщения об успешной задаче делают вывод о готовности почты к работе. Галочка замечательная. Только переписку она не читала.
Я разделяю три результата: копия доступна для чтения, из неё удалось развернуть систему, восстановленные данные прошли проверку. Контрольная сумма помогает заметить изменение файла после её расчёта. Но если исходный файл уже содержал ошибку, совпавшая сумма не исправит его смысл. Размер архива и дата создания тоже полезны для контроля задачи, однако не заменяют проверку содержимого. Для каждого результата нужны свои доказательства, а не одна общая отметка об успехе.
Порядок развёртывания я отделяю от критериев приёмки: восстановление Zimbra из бэкапа — соседняя задача. Здесь разбираю следующий вопрос: по каким признакам признать конкретную копию пригодной для согласованного сценария. Такой протокол должен позволять другому администратору повторить проверку и получить сопоставимый результат. Личное убеждение инженера в комплект резервного копирования не входит.
Условный разбор: почта запустилась, проверка провалена
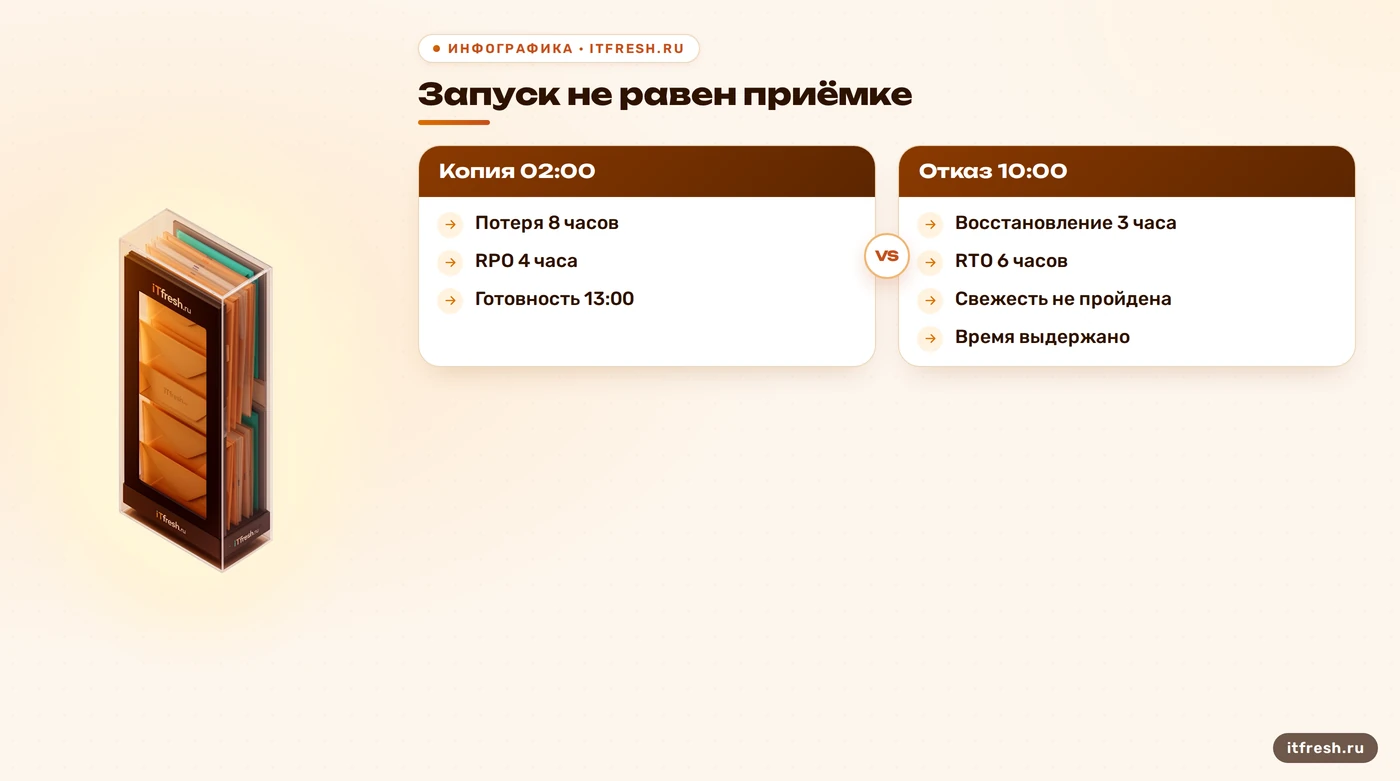
Разберу учебный сценарий для сети «Еврострой Групп». Это условный клиент; все числа ниже — параметры примера, а не сведения о реальной аварии. Возьмём 24 ящика и одну почтовую машину. Для упражнения согласуем RPO в 4 часа и RTO в 6 часов. RPO задаёт требуемую точку возврата данных относительно сбоя, то есть допустимое окно потерь. RTO задаёт допустимое время восстановления сервиса после сбоя.
Пусть условный отказ произошёл в 10:00, доступная согласованная копия отражает состояние на 02:00 того же дня, а почта полностью прошла функциональную приёмку к 13:00. Восстановление заняло 3 часа и уложилось в RTO. Но окно потери данных составило 8 часов при допустимых 4. Значит, требование по свежести данных не выполнено. Быстрый запуск не делает старую копию свежей. Тут арифметика портит красивый отчёт, зато сохраняет смысл проверки.
Теперь добавлю второй дефект упражнения: у контрольного письма видны отправитель и тема, но не открывается вложение. Сам по себе вход в веб-почту этого не обнаружит. Я записываю идентификатор проверяемого объекта, ожидаемый результат и фактическую ошибку. Затем разбираю, есть ли содержимое в копии, включён ли нужный том и сохранились ли права доступа. Объявлять причиной повреждение базы только по одному симптому было бы гаданием.
Итог такого теста я формулирую точно: целевое время выдержано, требование по точке возврата нарушено, чтение контрольного вложения не пройдено. После исправления причины нужны новая копия и повторная приёмка. Одного увеличения частоты заданий мало: для нашего примера придётся подтвердить достижимую точку восстановления и чтение проблемного объекта. Результат упражнения — перечень доказанных возможностей и конкретных отказов. Обещать полную сохранность на его основании нельзя.
Что должно попасть в копию Zimbra
Я включаю LDAP в проверку потому, что одних почтовых файлов недостаточно для возвращения учётных записей и настроек Zimbra. Метаданные сообщений хранятся в базе данных, а содержимое сообщений — в отдельных файлах, BLOB. Поэтому исправные таблицы и доступные файлы проверяют по отдельности, а затем проверяют их соответствие. Это разные части одного почтового объекта.
За поиск и индексацию в описанной архитектуре Zimbra отвечает Lucene. Индекс помогает находить письмо, но не заменяет его содержимое. Поиск, чтение письма и открытие вложения я принимаю разными проверками. Если поиск не находит известное письмо, сначала отделяю проблему индекса от отсутствия данных. Перестроение индекса не вернёт утраченный файл сообщения. Напротив, видимая строка в списке писем ещё не доказывает, что содержимое доступно.
Я обязательно уточняю редакцию и модуль резервирования Zimbra: от них зависит доступный механизм копирования. Команды штатного резервирования Network Edition нельзя автоматически приписывать любой установке Open Source Edition. Перед испытанием я записываю фактическую версию и сборку, редакцию, ОС, название и версию модуля копирования, состав томов. Команды восстановления выбираю для этого набора. Документация по Zimbra 9 в источниках подтверждает устройство соответствующей ветки, а не совместимость любой будущей или сторонней сборки.
В процедуре обычного файлового копирования нужно получить согласованное состояние взаимосвязанных данных. Копирование изменяющихся файлов работающей системы само по себе этого не обещает; в процедуре холодной копии нужна остановка служб и подтверждение её завершения. При этом специализированные механизмы умеют копировать работающую Zimbra своим способом. Я проверяю именно используемую процедуру. В опись также включаю конфигурацию, сертификаты и ключи, дополнительные тома и внешние зависимости. Если хранилище вынесено за пределы стандартных каталогов, один архив /opt/zimbra может оказаться неполным.
Какие журналы и команду я использую для диагностики
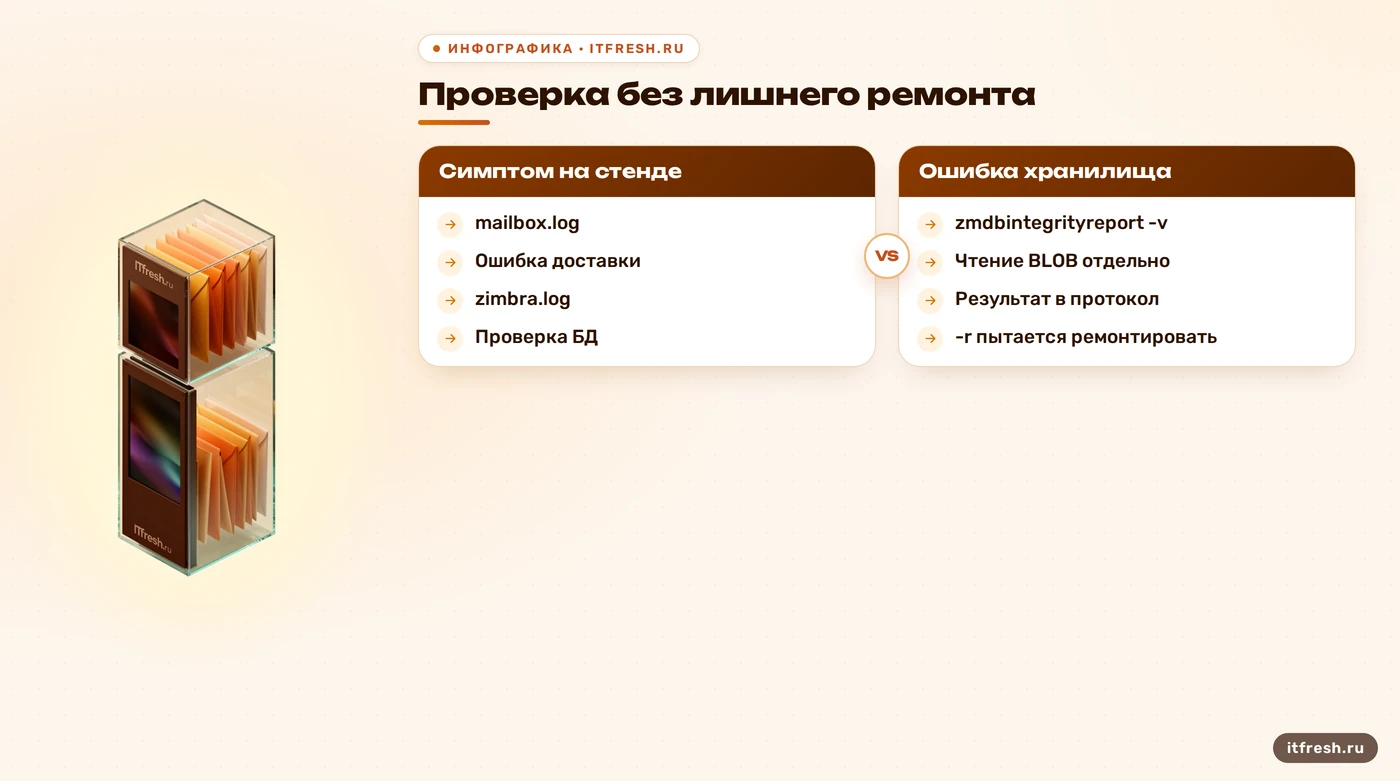
Для проблем почтового хранилища я начинаю с /opt/zimbra/log/mailbox.log. В нём ищу события нужной операции и связанный контекст, а не только слово ERROR. /var/log/zimbra.log относится прежде всего к MTA и системным событиям; это другой источник, полезный при проверке доставки. Путь /var/log/maillog зависит от настройки системного журналирования и не обязан дублировать нужные сведения. Мой выбор журнала определяет компонент, который проверяю, а не привычка смотреть один файл на все случаи.
Я сопоставляю время начала и завершения копирования с журналом самого задания и событиями системы: перезапуском, нехваткой места, ошибкой чтения или недоступностью тома. Время и часовой пояс должны быть понятны. Отдельный zimbra_backup.log из стороннего скрипта нельзя выдавать за обязательный журнал любой установки. Если журнал не сохранился, в протоколе будет пробел в доказательствах. Молчание потерянного лога — так себе справка о здоровье.
Для проверки БД в установках, где эта утилита предусмотрена, документация описывает zmdbintegrityreport. Ниже — диагностический запуск из оболочки пользователя zimbra на стенде. Ключ -v включает подробный вывод. До запуска сверяю доступность утилиты с установленной версией; на рабочей системе учитываю нагрузку на диски и выбираю окно обслуживания.
/opt/zimbra/libexec/zmdbintegrityreport -vКлюч -r я не добавляю к диагностическому запуску: согласно справке Zimbra, он включает попытку автоматического ремонта таблиц. Для обычной диагностики такой побочный эффект не нужен. Результат проверки БД тоже нельзя трактовать как проверку всего бэкапа. Утилита не доказывает наличие каждого BLOB и доступность вложений. Ошибка в отчёте требует разбора причины; она не делает автоматически бесполезными все предыдущие копии. Сначала сохраняю результаты, затем выбираю способ исправления.
Проблемы доставки после восстановления разбираю отдельно от ошибок хранилища: мониторинг служб и очередей помогает уточнить границы отказа. В протокол прикладываю относящийся к проверке фрагмент журнала, время и проверяемую учётную запись в обезличенном виде. Сообщение об отсутствии копии само по себе не доказывает повреждение базы: я выясняю, какую копию и где искала программа. Сначала событие, потом объяснение, а не наоборот.
Как устроить стенд без скрытой помощи рабочей системы
Мой стенд должен работать с восстановленными данными и заранее описанными зависимостями. До первого запуска клона я отделяю его сеть от рабочей, ограничиваю исходящую доставку и готовлю тестовое разрешение имён. Иначе копия может подключиться к живому каталогу или рабочему хранилищу и незаметно занять у них недостающую часть системы. Получится репетиция с суфлёром, который при настоящей аварии тоже исчезнет. Успех такого опыта будет трудно повторить.
Отдельно описываю, какие зависимости считаю сохранившимися в выбранной аварии. Если проверяю потерю только почтовой машины, доступный внешний каталог может быть допустимым условием. Если моделирую потерю площадки, подмена восстановленного каталога рабочим обесценивает сценарий. Я проверяю маршруты, подключённые диски и фактические источники данных. Само название сети «тестовая» ещё ничего не доказывает: нужно подтвердить, куда действительно обращаются службы.
Исходную копию сохраняю отдельно от экземпляра, на котором идут испытания. Восстановленная служба меняет своё состояние уже при запуске, поэтому после ремонта повторный тест должен начинаться с понятной исходной точки. Доступ к стенду ограничиваю так же внимательно, как к рабочей почте: в нём находится переписка. По окончании упражнения тестовые экземпляры и временные доступы убираю по согласованному порядку. Это часть процедуры, которую тоже стоит включить в план работ.
На стенде проверяю владельцев файлов, права на томах и возможность прочитать данные служебной учётной записью. Массово менять права наугад я не предлагаю. Сертификат проверяю по имени подключения, сроку действия и цепочке доверия; его проблема может объяснить отказ клиента при целых сообщениях. Обновление сертификата и необходимые действия для применения выполняю по процедуре своей версии, когда это действительно требуется. Перезапуск рабочей почты после каждого просмотра сертификата к проверке копий отношения не имеет.
Как проверить письма, вложения, права и свежесть
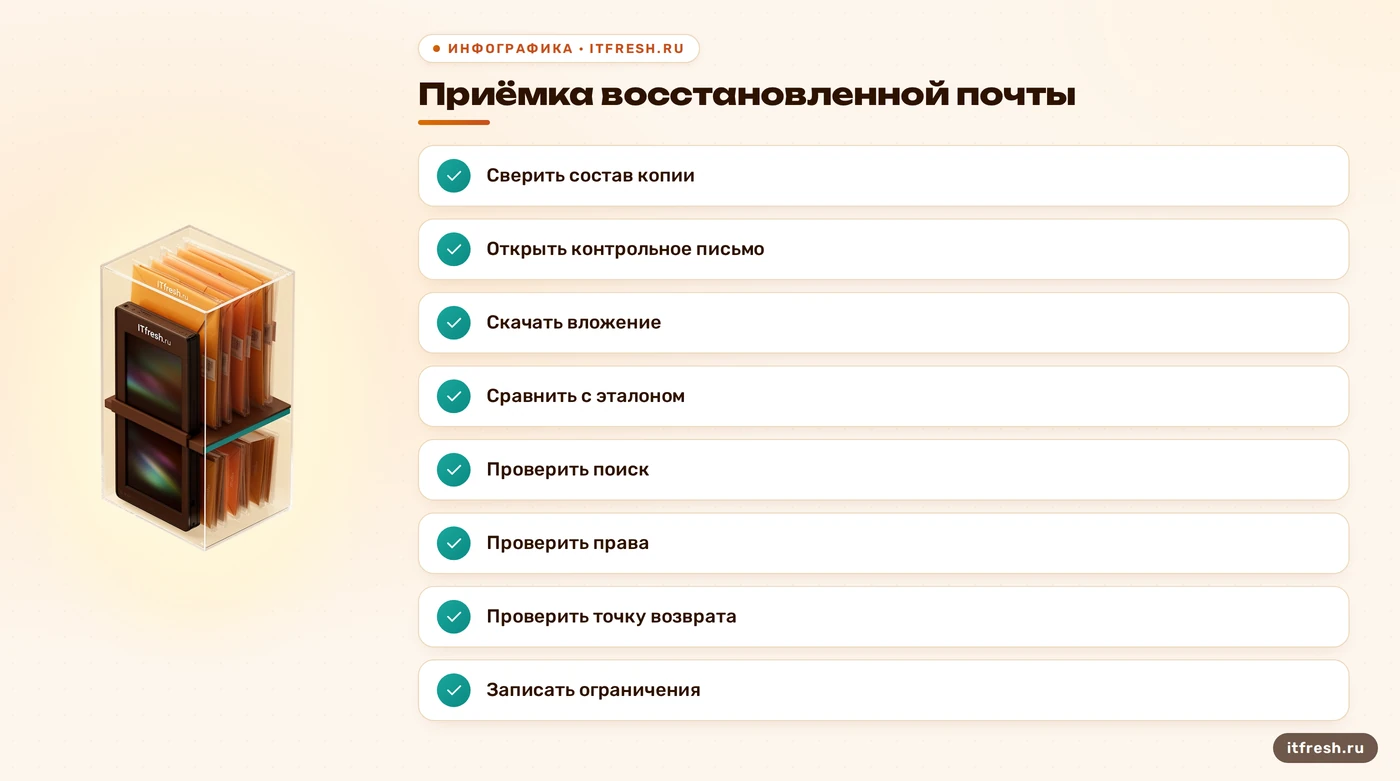
До испытания я составляю перечень контрольных объектов: письма из разных периодов, сообщения с вложениями, пользовательские папки, контакты и встречи, если они используются. Для каждого объекта записываю признак поиска и ожидаемое содержимое без публикации переписки. Одного случайного ящика мало: выборка должна затрагивать разные тома, размеры и используемые функции. Если исходного эталона нет, честно отмечаю, что доказать полное совпадение содержимого не удалось.
В восстановленном ящике я открываю контрольное письмо, читаю тело, скачиваю вложение и сравниваю его с заранее сохранённым эталоном. При наличии контрольной суммы сравниваю и её. Затем проверяю поиск по известному объекту. В документации Zimbra описан случай, когда метаданные есть, а соответствующего BLOB нет: объект виден в интерфейсе, но открыть его нельзя. Именно поэтому количество строк в папке и успешный вход не заменяют чтение данных.
Для общей папки я проверяю разрешённый доступ и отказ пользователю без прав. Для почтовых правил, псевдонимов и списков рассылки проверяю только те функции, которые включены в согласованный объём восстановления. Пробную доставку выполняю между контролируемыми тестовыми адресатами; внешнюю доставку на изолированном стенде отмечаю как непроверенную. Если для её приёмки требуется отдельное окно, планирую его заранее. Нельзя молча считать проверенными операции, которые в упражнении вообще не выполнялись.
При инкрементальной схеме я проверяю достижение выбранной точки штатным для установленного модуля способом. Для классического механизма из руководства Zimbra важны полная копия и необходимые журналы изменений. Наличие последнего файла не доказывает сохранность всей требуемой последовательности. Точку возврата сопоставляю с контрольными объектами нужного периода, учитывая время копирования. Время последнего письма в тихом ящике само по себе тоже не доказывает, что более поздняя почта потеряна.
Проверку недавних и старых данных я дополняю контролем охвата: все ли нужные ящики и тома вообще включены в задание. Пропущенный ящик способен исчезнуть из копии без повреждения остальных. Если после восстановления не работает поиск, использую отдельный разбор проверки индекса почтового ящика. Ошибки поиска, отсутствие BLOB и исключение ящика из задания требуют разных исправлений. Универсальная кнопка «всё починить» пока существует преимущественно в обещаниях.
Когда я принимаю результат и назначаю повторный тест
Я принимаю копию для конкретного сценария, когда выполнены заранее согласованные проверки и нет необъяснённых расхождений. В протокол заношу идентификатор копии, исходную сборку и модуль, состав восстановленных данных, условия стенда, достигнутую точку и продолжительность работ. Отдельно указываю, какие проверки выполнены полностью, какие — выборочно, а какие не выполнялись. Выборка даёт полезное свидетельство, но не превращается в доказательство исправности каждого сообщения. Это ограничение результата, а не повод отказаться от испытаний.
Для RTO я считаю весь согласованный путь от сбоя до готовности сервиса: доступ к резервному хранилищу, подготовку машины, развёртывание данных и функциональную приёмку. Если ресурсы были подготовлены заранее, это условие записываю. Измеренное время распаковки нельзя выдавать за срок возвращения почты в любой аварии. Для RPO указываю достигнутую точку данных и сравнение с допустимым окном потерь. В учебном примере выше время пройдено, свежесть — нет: один общий зелёный статус скрыл бы этот результат.
Периодичность я выбираю по допустимому риску и изменениям системы. Универсальную норму «раз в месяц или квартал» без привязки к компании не выдаю за требование вендора. Повторное испытание назначаю после смены механизма резервирования, состава хранилищ, существенного обновления или обнаруженной ошибки. Для регулярных упражнений заранее согласую календарь и ответственного. Автоматизация должна сообщать не только об ошибке задачи, но и об отсутствии свежей копии и просроченной проверке восстановления.
Если тест провален, сохраняю исходную копию и результаты, ищу причину и проверяю доступные предыдущие точки. Не предлагаю сначала удалить старые архивы, чтобы отчёт стал красивее. Исправление подтверждаю повторным упражнением, а рабочую инструкцию обновляю по его итогам. На выходе у руководителя должны быть допустимые потери, достижимый срок и список нерешённых ограничений. На выходе у администратора — воспроизводимые действия и доказательства. Вот такую проверку бэкапа я готов подписать.
Частые вопросы
Тестовое восстановление Zimbra бесполезно?
Нет, оно необходимо. Но один запуск служб подтверждает только часть результата. Я дополнительно проверяю состав данных, чтение писем и вложений, рабочие операции и согласованные RPO/RTO.
Можно ли запускать zmdbintegrityreport с ключом -r?
Ключ -r означает попытку автоматического ремонта таблиц. Для диагностической проверки его не добавляю; доступность и синтаксис утилиты сверяю с установленной версией.
Какие журналы смотреть при проверке копии?
Для событий почтового хранилища — /opt/zimbra/log/mailbox.log; для MTA и системных событий — /var/log/zimbra.log. Также нужен журнал фактически используемого средства резервирования.
Нужно ли останавливать Zimbra для любого бэкапа?
Это зависит от механизма. Для обычной холодной файловой копии нужна согласованная остановка, а специализированные модули могут копировать работающую систему. Проверяю процедуру своего модуля.
Как часто проверять восстановление?
По согласованному календарю с учётом риска. Дополнительную проверку назначаю после существенных изменений и исправления ошибок резервирования. Общую норму для всех установок не выдумываю.
Что делать, если не открывается вложение?
Сохранить исходную копию и ошибку, проверить наличие содержимого, охват томов и права доступа. Причину устанавливаю до ремонта; после исправления повторяю тест с понятной исходной точки.
Источники
- Zimbra Wiki — Zmdbintegrityreport — Проверены назначение утилиты, запуск пользователем zimbra, подробный вывод -v, автоматический ремонт с -r и нагрузка на диски. URL: https://wiki.zimbra.com/wiki/Zmdbintegrityreport
- Zimbra Wiki — Log Files — Проверено назначение /opt/zimbra/log/mailbox.log и /var/log/zimbra.log; расположение почтовых журналов зависит от настройки syslog. URL: https://wiki.zimbra.com/wiki/Log_Files
- Zimbra Collaboration 9 Administrator Guide — Подтверждены факты базы знаний: роль LDAP, раздельное хранение данных и метаданных, роль Lucene и штатное резервирование Network Edition. Также проверена роль полной копии и redo-журналов в классическом механизме. Руководство относится к ветке 9, не доказывает совместимость других сборок. URL: https://zimbra.github.io/zimbra-9/adminguide.html
- Zimbra Wiki — Steps To Rebuild ZCS Server — Проверены остановка служб перед файловым переносом БД и хранилища, отдельный экспорт LDAP и учёт дополнительных HSM-томов. Команды переноса из руководства в статью не переносились. URL: https://wiki.zimbra.com/wiki/Steps_To_Rebuild_ZCS_Server
- Zimbra Wiki — Checking the message BLOBs health — Подтверждено разделение метаданных и содержимого: при Missing BLOB объект может быть виден в интерфейсе, но недоступен для чтения. Синтаксис команд старого модуля HSM Plus не использован как универсальный. URL: https://wiki.zimbra.com/wiki/Zimbra_Suite_Plus/Zimbra_HSM_Plus/Checking_the_message_BLOBs_health
- NIST SP 800-34 Rev. 1 — Contingency Planning Guide — Проверены смысл RPO и RTO, необходимость испытаний и документирования результатов восстановления. Использовано как методическое руководство, без утверждения об обязательных требованиях для российской компании. URL: https://csrc.nist.gov/pubs/sp/800/34/r1/upd1/final