
pg_upgrade --swap: когда старый кластер PostgreSQL 18 уже нельзя запускать
Старый кластер перестаёт быть безопасным не при первом старте PostgreSQL 18, а раньше: как только pg_upgrade сообщил, что старый кластер запускать нельзя. Дальше откат только из резервной копии. Ниже: чем --swap отличается от копирования, что говорит документация, как проверить режим через --check и какой откат я готовлю.
Где проходит граница: ответ без воды
Сначала то, ради чего вы открыли статью. В режиме --swap точка невозврата наступает в момент, когда pg_upgrade сообщает, что старый кластер больше нельзя безопасно запускать. Это происходит во время переноса файлов, то есть до запуска нового сервера. Если вы ждёте, что откат заключается в «поднять старый PostgreSQL обратно», в этом режиме он не сработает после такого сообщения. Документация на этот счёт не оставляет места фантазиям: если pg_upgrade сообщил, что старый кластер небезопасно запускать, он разрушен, и восстанавливать его нужно из резервной копии. Если вы переводите на новую версию базу 1С, а 1С и PostgreSQL на Linux у вас живут на одном сервере, цена такой ошибки измеряется остановленным учётом, а не одним неудачным вечером.
Теперь нюанс, который почти все пропускают. Граница проходит не по запуску нового сервера, как в режиме --link, а раньше. В --link старый кластер можно вернуть, пока вы не стартовали новый: pg_upgrade только дописывает суффикс .old к файлу global/pg_control, и достаточно этот суффикс убрать. В --swap такого утешительного приза нет: каталоги данных перемещаются, а системные каталоги заменяются подготовленными для новой версии. Я видел, как люди читают «самый быстрый режим» и пропускают вторую половину предложения. Скорость в этом режиме платится именно возможностью быстро откатиться.
Ещё одна оговорка, и она честная. Пока pg_upgrade не сообщил, что старый кластер небезопасен, он не тронут и его можно запустить. То есть если утилита упала на проверках или остановилась до начала переноса, у вас есть прежняя база. Но проверять это надо не по ощущениям и не по тому, что «вроде бы файлов поменялось не так много», а по выводу утилиты. Поэтому вывод pg_upgrade я всегда сохраняю в файл и не закрываю терминал, пока окно не завершено.
Дальше по порядку: чем режим отличается от соседних, что дословно сказано про откат, как это выглядело на одном небольшом проекте, какие команды я запускаю до и после. Про смежную ловушку обновления на 18 версию, когда утилита отказывается работать из-за разных настроек контрольных сумм, у меня есть отдельный разбор: pg_upgrade и checksums. Здесь я его не повторяю, а говорю только про сам режим переноса и про границу, после которой назад дороги нет.
Чем --swap отличается от --copy, --link и --clone
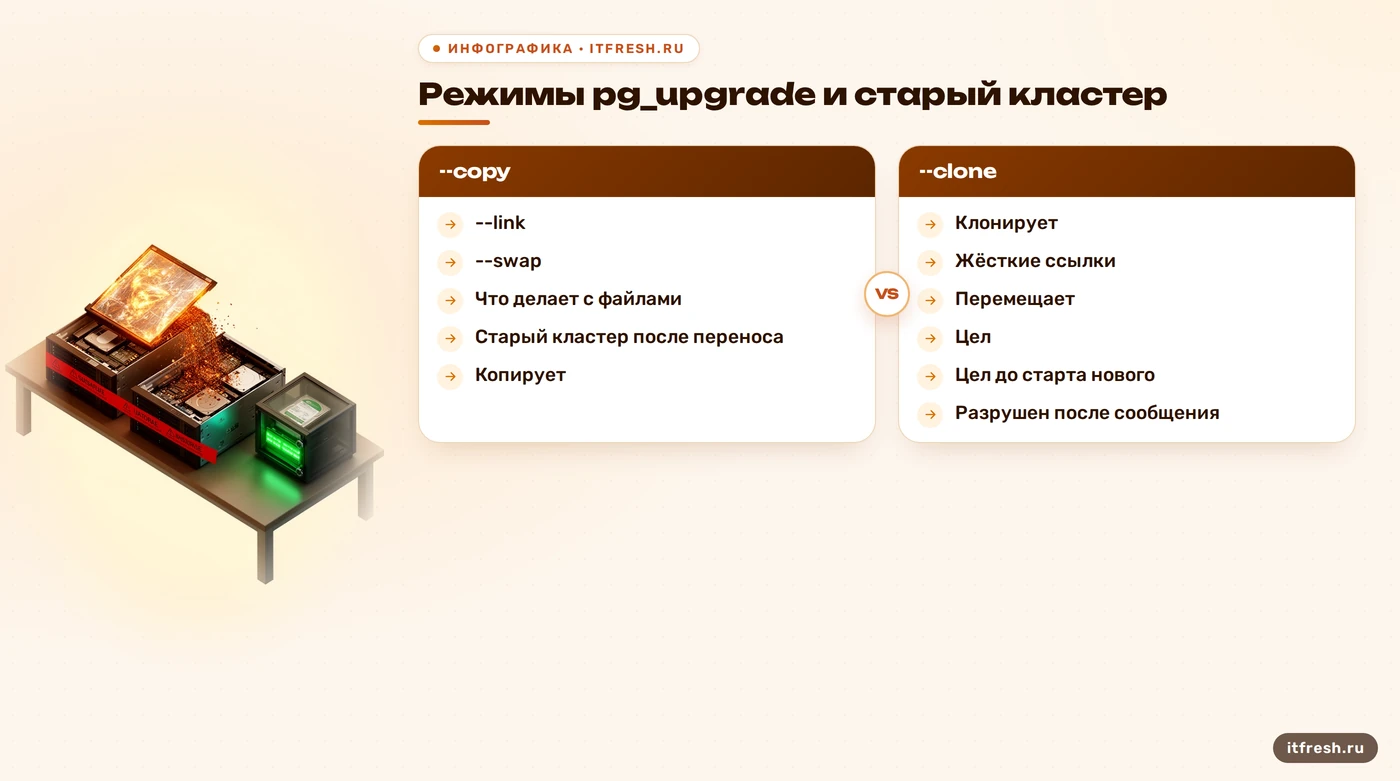
Описание режима в документации PostgreSQL 18 такое: утилита перемещает каталоги данных из старого кластера в новый, затем заменяет файлы каталога системными файлами, созданными для нового кластера. Режим может обогнать --link, --clone, --copy и --copy-file-range, особенно на кластерах с большим числом отношений, то есть таблиц, индексов и прочих объектов. Для базы 1С это важно: там очень много таблиц, и накладные расходы на каждый файл складываются. Но слово «перемещает» тут не метафора. Это не копирование, где исходник остаётся лежать, и не жёсткие ссылки, где данные общие, но пока новый сервер не запущен, хотя бы можно вернуть pg_control.
Различия в моей практике удобно держать в голове в виде таблицы. Строки про состояние старого кластера взяты из раздела документации про откат, остальное из описания ключей.
| Режим | Что делает с файлами | Старый кластер после переноса | |---|---|---| | --copy (по умолчанию) | копирует файлы в новый кластер | не изменён, можно запускать | | --clone | клонирует файлы (reflink), старый остаётся | не изменён, можно запускать после старта нового | | --link | жёсткие ссылки на те же файлы | до старта нового можно вернуть, убрав .old у pg_control; после старта нового кластера небезопасен | | --swap | перемещает каталоги, заменяет системные каталоги | после сообщения утилиты разрушен, нужна копия | Требование к дискам у режимов, кроме копирования, общее: старый и новый каталоги данных должны лежать в одной файловой системе. Документация уточняет для link-режима, что табличные пространства и pg_wal могут быть на других файловых системах. Для --clone добавляется поддержка на уровне файловой системы: на Linux (ядро 4.5 и новее) это Btrfs и XFS, созданная с поддержкой reflink, на macOS это APFS; иначе pg_upgrade завершится ошибкой. Для --swap «одна файловая система» прямо указана в шаге документации про выбор режима переноса.
Есть и неприятная вещь про побочный эффект. Документация предупреждает: в режиме --swap в старом кластере остаётся много мусорных файлов, и если вместе с ним использовать --sync-method=syncfs, шаг синхронизации файлов затянется. Поэтому для --swap рекомендовано --sync-method=fsync (он и так по умолчанию). Ключ -N / --no-sync ради «ещё чуть быстрее» не берите: утилита вернётся, не дожидаясь записи на диск, а авария ОС после этого может оставить каталог данных повреждённым. Документация считает его годным для тестов, но не для боевой установки. Скорость вы выигрываете не там.
Что документация говорит про откат (и как это читать)
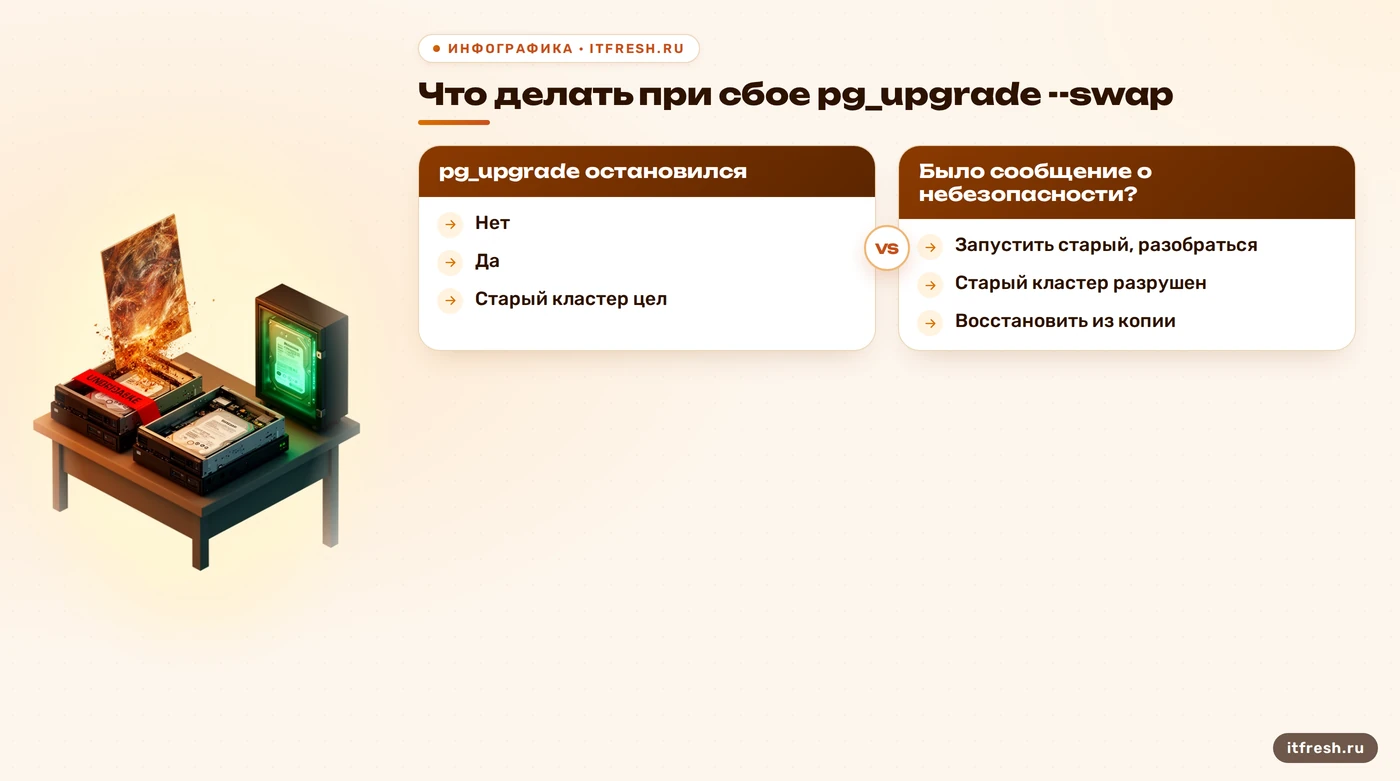
Раздел про откат к старому кластеру я бы распечатал и повесил над столом того, кто собирается запускать pg_upgrade ночью. Для --swap там два пункта. Первый: если pg_upgrade прервался до того, как сообщил, что старый кластер больше нельзя безопасно запускать, старый кластер не тронут, его можно запустить. Второй: если сообщил, старый кластер разрушен, восстанавливайте его из резервной копии. Между этими пунктами нет промежуточного «ну, может, получится руками собрать». Для --link есть хотя бы тонкая тропинка с переименованием pg_control. Для --swap её нет.
Из этого следует практическое правило, и я его считаю главным: откат в режиме --swap это не операция, а заранее подготовленная копия. Не «вернём каталог на место», не «запустим старый сервер на другом порту», а проверенная резервная копия, из которой реально поднимается рабочий кластер, причём на этом же оборудовании и в приемлемое время. Смешно, но чаще всего заказчик на вопрос «есть откат?» отвечает «ну, мы же можем просто запустить старый». С режимом --swap эта фраза работает ровно до одного сообщения в консоли.
Второе следствие касается мониторинга окна. Пока pg_upgrade работает, я не меряю «сколько осталось» по прогрессу, потому что у утилиты нет красивой шкалы. Я просто читаю вывод и жду либо успеха, либо ошибки. Если ошибка случилась и сообщения о небезопасности старого кластера в выводе нет, запускаем старый сервер и разбираемся спокойно. Если сообщение есть, стоп: ничего не запускаем, ничего не «чиним руками» и начинаем восстановление из копии. Самое опасное время в такой работе наступает, когда человек в три часа ночи пытается героически собрать каталоги обратно.
В таком разделе надо оговориться: про схему «потерял при сбое» документация говорит осторожно, а я не буду её додумывать. Что именно остаётся в старом каталоге после аварийной остановки на середине переноса, зависит от момента сбоя, и расписывать это по файлам я не берусь. Для практики хватает правила: после сообщения о небезопасности старый кластер считаем потерянным.
Если ваша база сейчас живёт на одной машине без второго экземпляра, без свежей проверенной копии и с версией, которой скоро конец поддержки, вы можете написать мне. Я посмотрю, где у вас лежит каталог данных, как устроен бэкап и каким режимом обновлять, и скажу честно, нужен ли вам вообще --swap.
Разбор: школа «Камертон», 10 рабочих мест, 1С на PostgreSQL 14
Ниже разбор на условном клиенте: музыкальная школа «Камертон», 10 рабочих мест. Один сервер на Linux, на нём PostgreSQL 14 и информационные базы 1С: бухгалтерия и небольшая база учёта учеников. Обновляли в связи с тем, что у ветки 14 заканчивается поддержка: на странице политики версий проекта PostgreSQL она значится с финальным выпуском 12 ноября 2026 года. Для десяти рабочих мест это не страшилка, а календарь: после этой даты исправления безопасности для 14 выходить перестанут.
Исходные цифры: размер каталога данных около 38 ГБ, на диске для данных свободно около 90 ГБ, в одной файловой системе лежат и старый, и будущий каталог. Окно, которое согласовали с директором, это воскресенье с утра до вечера, потому что в понедельник начинается приём. Я предложил --swap, а потом сам себя остановил. Объяснение простое: выигрыш режима тем заметнее, чем больше объектов и больше данных, а 38 ГБ копируются на этом сервере за разумное время. Отнимать у школы возможность вернуться к старому кластеру ради экономии часа я не стал.
Что мы сделали. Во-первых, на стенде из копии виртуальной машины прогнали полный цикл: инициализацию нового кластера, проверку, обновление, запуск баз 1С с тестовой платформой. На стенде прогон с --swap занял заметно меньше времени, чем с копированием, и это был честный аргумент в его пользу. Во-вторых, на боевом сервере я оставил режим копирования: окно хватало с запасом, а старый кластер остаётся нетронутым до тех пор, пока мы сами его не удалим. Итог в воскресенье: обновление и проверка заняли около полутора часов, из них на сам pg_upgrade ушло порядка двадцати минут. Остальное съели бэкап, проверки и анализ статистики.
Урок из этого кейса такой: --swap нужен, когда окно действительно упирается в количество файлов и объём, и когда есть проверенная копия. Для школы на десять рабочих мест он не нужен, и мне не стыдно было выбрать медленнее. Самое быстрое обновление, после которого утром не открывается бухгалтерия, остаётся самым дорогим. Если вы пойдёте тем же путём, не забудьте сверить версию платформы 1С и версию PostgreSQL по документации вашей сборки: поддержку именно вашей связки проверяйте до окна, а не после. Про настройку самого сервера после обновления есть отдельный текст про оптимизацию PostgreSQL для 1С.
Как готовиться: резервная копия, проверка --check --swap и порядок команд
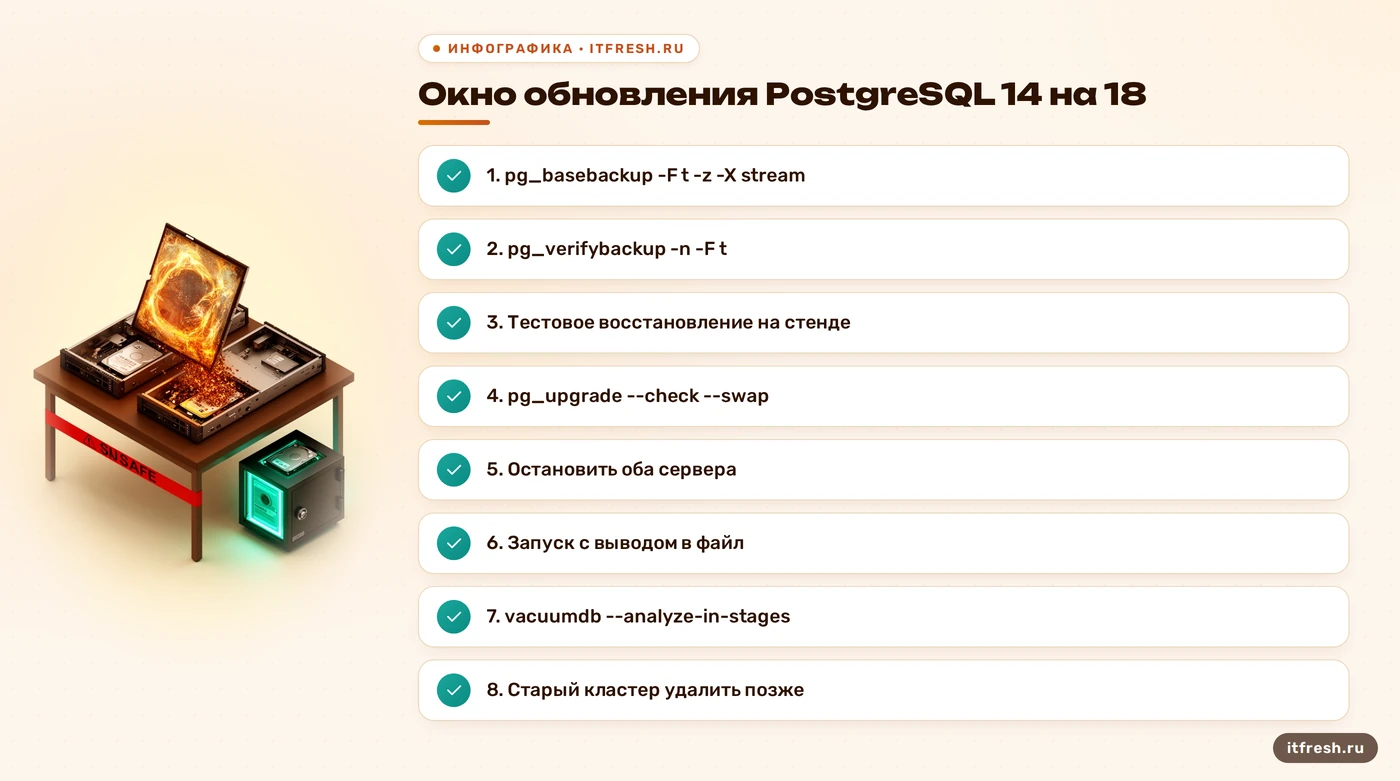
Мой порядок такой. Сначала резервная копия, которую я сам умею восстановить. Для работающего кластера беру pg_basebackup: ключ -D задаёт каталог (он должен быть пустым или несуществующим), -F t включает tar-формат, -z сжимает, -X stream передаёт WAL параллельно, -P показывает приблизительный прогресс, --checkpoint=fast убирает ожидание контрольной точки. Пользователю нужны права репликации, и это надо предусмотреть в pg_hba.conf заранее. После копирования проверяю её через pg_verifybackup: для tar-копий нужен ключ -n (не разбирать WAL), потому что проверка WAL работает только для plain-формата.
pg_basebackup -h 127.0.0.1 -U replicator -D /backup/pg14-base -F t -z -X stream -P --checkpoint=fast
pg_verifybackup -n -F t /backup/pg14-base
Важно, чего pg_verifybackup не умеет. Он сверяет файлы с манифестом, но документация прямо говорит, что тестовое восстановление он не заменяет: нужно поднять копию и убедиться, что базы открываются и данные на месте. Поэтому на стенде я разворачиваю копию, открываю базу 1С и смотрю свежий документ. Бэкап делают все, а проверяет почти никто, и ровно поэтому я пишу об этом в каждом таком тексте. О том, как строить такую цепочку для 1С целиком, у меня есть отдельный материал про резервное копирование 1С без потерь.
Дальше проверка самого обновления. Ключ --check выполняет только проверки совместимости и ничего не меняет, он может работать даже при запущенном старом сервере, но тогда порты старого и нового серверов должны быть разными. Главное: чтобы включились проверки, специфичные для режима, нужно указать режим вместе с --check, то есть --check --swap. Ещё два замечания: утилите нужны права записи в текущий каталог, а запускать надо бинарник pg_upgrade нового сервера. Параметр --jobs позволяет обрабатывать несколько баз и табличных пространств параллельно, хорошая стартовая точка по документации это большее из двух чисел: количество ядер процессора или табличных пространств.
/opt/PostgreSQL/18/bin/pg_upgrade \
  --old-datadir /data/pg14 --new-datadir /data/pg18 \
  --old-bindir /opt/PostgreSQL/14/bin --new-bindir /opt/PostgreSQL/18/bin \
  --check --swap --jobs 4
Пути выше условные, подставьте свои. Перед этим новый кластер должен быть создан командой initdb новой версии и не запущен, оба сервера остановлены (для боевого обновления). Если на старом кластере выключены контрольные суммы, а initdb версии 18 по умолчанию их включает, вспомните про ключ --no-data-checksums в initdb: он упомянут в примечаниях к релизу именно для обновления кластеров без контрольных сумм. Всё остальное (расширения, пути, права) подробно описано в документации, шаги 1-9, и я не пересказываю их, а лишь проверяю по списку.
Боевой запуск: что делать до и после сообщения о небезопасности
Сам запуск отличается от проверки только отсутствием --check. Перед ним оба сервера остановлены, копия сделана и проверена, вывод идёт в файл. Я запускаю команду под терминальным мультиплексором или через nohup, потому что обрыв SSH-сессии в середине переноса файлов это тот случай, когда лучше не знать подробностей. После запуска смотрим на вывод: либо ошибка до сообщения о небезопасности (старый кластер цел, можно запускать, разбираемся), либо сообщение о небезопасности (старый кластер считаем потерянным, откат только из копии), либо успех.
/opt/PostgreSQL/18/bin/pg_upgrade \
  --old-datadir /data/pg14 --new-datadir /data/pg18 \
  --old-bindir /opt/PostgreSQL/14/bin --new-bindir /opt/PostgreSQL/18/bin \
  --swap --jobs 4 --sync-method=fsync 2>&1 | tee /root/pg_upgrade_run.log
После успеха начинается послеобработка. Новый сервер запускаем уже штатно. Если утилита при завершении выдала предупреждения о послеобработке, выполняем сформированные ею скрипты: каждый через psql --username=postgres --file=script.sql postgres, порядок не важен, после выполнения их можно удалить. Дальше статистика. PostgreSQL 18 переносит большую часть статистики оптимизатора, но не всю, поэтому утилита предложит выполнить vacuumdb. По документации сначала vacuumdb --all --analyze-in-stages --missing-stats-only, затем vacuumdb --all --analyze-only; --jobs ускоряет оба вызова. Подробности и подводные камни этого этапа я разобрал в тексте про статистику и ANALYZE после pg_upgrade, повторять не буду.
vacuumdb --all --analyze-in-stages --missing-stats-only --jobs 4
vacuumdb --all --analyze-only --jobs 4
Последнее, что хочется сказать, это удаление старого кластера. Утилита по завершении называет скрипт для этого, и документация советует выполнять его после того, как вы убедились, что новый кластер работает (автоматическое удаление невозможно, если пользовательские табличные пространства лежат внутри старого каталога данных). Я не удаляю ничего в день обновления. Пара суток в понедельник-вторник с живой нагрузкой, потом удаление. Резервную копию перед обновлением тоже оставляю: она дешевле, чем объяснения. Выбор режима, как и всё остальное, это вопрос того, что вы готовы потерять в худшем случае, а не того, что красиво выглядит на графике времени.
Когда --swap брать, а когда не нужно
Мой выбор очень простой. Беру --swap, если одновременно выполнены три условия: у базы много объектов или огромный объём, а окно жёсткое; есть проверенная копия, из которой я уже поднимал кластер; новый и старый каталоги данных лежат в одной файловой системе. Если хотя бы одно не выполнено, беру --copy. Для небольших компаний до пятидесяти рабочих мест это почти всегда копирование, потому что база помещается в диск с запасом, окно в выходные не горит, а нетронутый старый кластер дороже сэкономленного часа.
Если нужен компромисс между скоростью и безопасностью, смотрю на --clone: документация говорит, что он даёт скорость, близкую к --link, и оставляет старый кластер нетронутым. Но только на Linux с Btrfs или XFS с поддержкой reflink (либо на macOS с APFS) и, опять же, в одной файловой системе. Если у вас ext4, режим не заработает, и это надо знать до окна. Проверить, подходит ли режим, можно тем же --check с нужным ключом.
Отдельно про реплики. Если у вас есть standby, у документации есть самостоятельный порядок с rsync для режима link, и я не стал бы переносить его на --swap по аналогии. Прочтите шаги про standby в документации вашей версии и проверьте, что там сказано именно про ваш режим, прежде чем что-то запускать. А если репликация критична, пусть этим занимается тот, кто делал это руками.
И последнее. Если вы всё ещё сидите на ветке 14, у которой финальный выпуск запланирован на 12 ноября 2026, то времени на аккуратное обновление остаётся мало, а на спешку не остаётся совсем. Лучше потратить неделю на стенд и репетицию, чем ночь на восстановление.
Если хотите, чтобы это сделал человек, который уже ломал и чинил такие обновления, ниже описано, как это устроено у нас.
Частые вопросы
В какой момент после pg_upgrade --swap нельзя запускать старый кластер?
После того как pg_upgrade сообщил, что старый кластер больше нельзя безопасно запускать. Это происходит во время переноса файлов, до старта нового сервера. До этого сообщения старый кластер не тронут. После него документированный путь один: восстановление из резервной копии.
Чем --swap отличается от --link?
В --link данные общие для обоих кластеров, и пока новый сервер не запущен, старый можно вернуть, убрав суффикс .old у global/pg_control. В --swap каталоги перемещаются, а системные каталоги заменяются. После сообщения утилиты старый кластер разрушен.
Нужно ли хранить старый и новый каталоги в одной файловой системе?
Да, для --swap старый и новый каталоги данных должны находиться в одной файловой системе. То же требование у --link и --clone. Проверить подготовку можно командой с ключами --check --swap.
Как проверить режим до боевого запуска?
Запустить pg_upgrade с ключом --check вместе с выбранным режимом, то есть --check --swap. Тогда включаются проверки, специфичные для режима, а данные не меняются. Бинарник pg_upgrade берите от нового сервера.
Какой метод синхронизации выбрать вместе с --swap?
Документация рекомендует --sync-method=fsync, потому что в старом кластере остаётся много мусорных файлов и syncfs затянет шаг синхронизации. Ключ --no-sync на боевой установке не используйте: после сбоя ОС каталог данных может оказаться повреждённым.
Подходит ли --swap для небольшой базы 1С?
Обычно нет. Выигрыш заметнее на кластерах с большим числом объектов, а для базы в несколько десятков гигабайт копирование укладывается в окно и оставляет старый кластер нетронутым. Я выбираю --swap только при жёстком окне и проверенной копии.
Источники
- PostgreSQL 18: pg_upgrade — Режимы --swap, --link, --clone, --copy, ключи --check, --jobs, --sync-method, --no-statistics, порядок обновления, раздел про возврат к старому кластеру. https://www.postgresql.org/docs/18/pgupgrade.html
- PostgreSQL 18: Release notes — Новый ключ --swap, параллельные проверки через --jobs, перенос статистики оптимизатора, initdb --no-data-checksums, дата выхода 25 сентября 2025. https://www.postgresql.org/docs/18/release-18.html
- PostgreSQL: Versioning policy — Сроки поддержки версий, финальный выпуск ветки 14 12 ноября 2026 года. https://www.postgresql.org/support/versioning/
- PostgreSQL 18: pg_basebackup — Ключи -D, -F, -X stream, -P, -z, --checkpoint=fast, манифест копии. https://www.postgresql.org/docs/18/app-pgbasebackup.html
- PostgreSQL 18: pg_verifybackup — Проверка копии по манифесту, ключ -n для tar-формата, ограничения проверки. https://www.postgresql.org/docs/18/app-pgverifybackup.html