Оптимизация PostgreSQL для 1С:Предприятие 8.3
ТОЛЬКО ДЛЯ ПОДПИСЧИКОВ🔒 Закрытый канал · @ITfresh_DarkТёмная сторона IT: то, о чём подрядчики молчат› Разборы реальных аварий — как было на самом деле› Приватные предложения только для подписчиков› Серверы, сети, VPN и ИИ-агенты без водыОткрыть доступ →бесплатно · 1 клик · отписаться можно в любой момент
Оптимизацию PostgreSQL для 1С я начинаю с замеров: что задерживает проведение документов и отчёты — диск, память, блокировки или сам запрос. Затем проверяю совместимость сборки, настраиваю память, WAL и autovacuum. Здесь покажу порядок работы, диагностические запросы и проверку восстановления, без которой любой тюнинг превращается в азартную игру с бухгалтерией.
С чего начать, если 1С на PostgreSQL тормозит
В компании до 50 рабочих мест я сначала уточняю, какая операция тормозит, у кого и когда: проведение, открытие формы, обмен или тяжёлый отчёт. Для проектов с 1С на Linux фиксирую время выполнения, число одновременно работающих сеансов, фоновые задания и состояние сервера в тот же момент. Сравнение утренней пустой базы с закрытием месяца ничего не доказывает. Нужен повторяемый сценарий с одинаковыми параметрами и сопоставимой нагрузкой. Иначе после правки конфигурации ускорится только рассказ администратора о проделанной работе.
Следующий шаг — паспорт системы: полный релиз платформы 1С, конфигурация приложения, поставщик и сборка СУБД, ОС, память и хранилище. Фирма «1С» выпускает PostgreSQL со своими патчами; отдельно существуют продукты Postgres Pro, включая Postgres Pro 1C. Эти названия нельзя использовать как синонимы. Я сверяю конкретное сочетание с системными требованиями 1С и описанием своего релиза платформы. Наличие ветки PostgreSQL в общей таблице ещё не означает совместимость с любым выпуском 8.3. Принцип «поставим самое новое, там наверняка быстрее» к проверке совместимости отношения не имеет.
Примеры SQL и названия представлений ниже сверены с документацией PostgreSQL 17. Это обозначение версии примеров, а не команда обновить рабочую базу. Для другой ветки и сборки я проверяю наличие параметров и столбцов в её руководстве. В документации 1С рекомендации прямо названы приблизительными стартовыми значениями: это полезная отправная точка, но не готовый файл для любого сервера. Настройки интерпретации строк и требования сборки проверяю отдельно от ускорения запросов. В частности, указанные в методике 1С standard_conforming_strings = off и escape_string_warning = off переношу только после проверки применимости к своему окружению.
Перед изменениями я сохраняю конфигурацию и смотрю действующие значения через pg_settings, а не только открытый в редакторе postgresql.conf. Поля source и sourcefile помогают найти источник настройки, context — понять способ применения, pending_restart — увидеть ожидающий перезапуска параметр. Доступ к sourcefile зависит от прав. Проверку выполняю и в контексте роли приложения: настройки сеанса могут отличаться от административного подключения. Изменение файла само по себе ещё ничего не ускорило. После применения повторно проверяю значения и журналы, а перезапуск планирую отдельно от перечитывания конфигурации.
SELECT name, setting, unit, source, sourcefile, context, pending_restart
FROM pg_settings
WHERE name IN ('shared_buffers', 'work_mem', 'temp_buffers',
'effective_cache_size', 'max_locks_per_transaction');- Зафиксировать сценарий, длительность операции и одновременную нагрузку.
- Проверить совместимость релиза 1С, сборки СУБД и ОС.
- Сохранить конфигурацию и исходные показатели для сравнения.
- Проверить восстановление копии до рискованных изменений.
Как распределить shared_buffers, work_mem и кеш
Для выделенного сервера СУБД документация PostgreSQL предлагает shared_buffers около 25 % ОЗУ как разумную стартовую оценку. Для общего сервера с процессами 1С я сначала вычитаю их потребность и резерв ОС, затем проверяю бюджет памяти под нагрузкой. Универсального потолка «не больше 8 ГБ» у параметра нет. Если выделенной машине условно доступны 32 ГиБ, четверть составляет 8 ГиБ: это арифметический пример, а не обязательная настройка. Кеш ОС тоже нужен, а увеличение общего буфера не исправляет очередь к медленному диску или запрос, который читает лишние данные.
work_mem задаёт базовый бюджет отдельной операции сортировки или хеширования. Таких операций в запросе бывает несколько, одновременно работают другие сеансы, а параллельные исполнители добавляют расход. Для хеширования учитывается hash_mem_multiplier. Поэтому я разбираю расход памяти на запрос, прежде чем поднимать глобальное значение ради одного отчёта. Рост временных файлов — повод изучить план и конкуренцию за память, а не сразу раздать каждому процессу большой лимит. Свободная память в спокойный час не описывает потребность сервера в рабочий пик.
Простой расчёт показывает масштаб ошибки. В учебной модели 20 одновременно выполняющихся запросов имеют по две активные сортировки с work_mem = 64MB: их суммарные бюджеты дают 2560 МиБ. При 16MB получатся 640 МиБ. Здесь нет хеширования, параллельных исполнителей, временных таблиц и остальных расходов процессов; это иллюстрация умножения, а не точный прогноз потребления. Для расчёта хеш-операций добавляю фактический hash_mem_multiplier. Значение work_mem выбираю после проверки всего пика, а для отдельного задания рассматриваю локальную настройку в управляемом сеансе, если способ его запуска это позволяет.
effective_cache_size вообще не выделяет память. Это оценка доступного кеша для планировщика, включающая общий буфер PostgreSQL и полезную для базы часть кеша ОС с учётом конкуренции и возможного дублирования страниц. Красивые «75 % RAM» без измерений здесь бесполезны. Отдельно считаю память обслуживания: maintenance_work_mem относится к обслуживающим операциям, а autovacuum_work_mem — к каждому работнику autovacuum; при наследовании значения расходы тоже суммируются. Я оставляю запас для пика и проверяю давление на память. Размер файла базы сам по себе не даёт формулы необходимой ОЗУ.
Зачем 1С temp_buffers и max_locks_per_transaction
temp_buffers обслуживает временные таблицы конкретного сеанса. Это другой механизм, чем временные файлы сортировок при нехватке work_mem. Буферы выделяются по потребности до заданного предела, поэтому большое значение не означает немедленного резервирования всего объёма каждым подключением. Но при одновременной работе с временными таблицами расход вполне реален. Я сопоставляю число активных сеансов и характер запросов, затем проверяю, даёт ли изменение пользу. Поднять temp_buffers только потому, что в конфигурации много отчётов, — слишком короткое расследование для сервера с ограниченной памятью.
Есть важная деталь применения: temp_buffers можно изменить для сеанса только до первого использования временных таблиц в нём. Проверять такую настройку через давно открытое подключение приложения бессмысленно. Для честного сравнения я обеспечиваю новые тестовые подключения и одинаковый сценарий, затем снова измеряю расход памяти и время операции. Одновременно проверяю нагрузку хранилища: перенести временные данные в другой каталог на том же перегруженном устройстве — ещё не значит получить отдельный ресурс. Название папки быстрее диска не работает, хотя в отчётах об оптимизации выглядит убедительно.
max_locks_per_transaction определяет ёмкость общей таблицы блокировок объектов с учётом серверных процессов и подготовленных транзакций. Это не ограничение числа заблокированных строк и не лекарство от конфликтующих документов. Отдельная транзакция может использовать больше среднего значения, пока хватает общей таблицы. Если журнал сообщает о её исчерпании, проверяю характер операции и связанные лимиты, затем планирую изменение и перезапуск. В методике 1С встречается диапазон 512–2000 для её сценариев; переносить его на любую небольшую базу без проверки я не предлагаю. Увеличение таблицы блокировок занимает память.
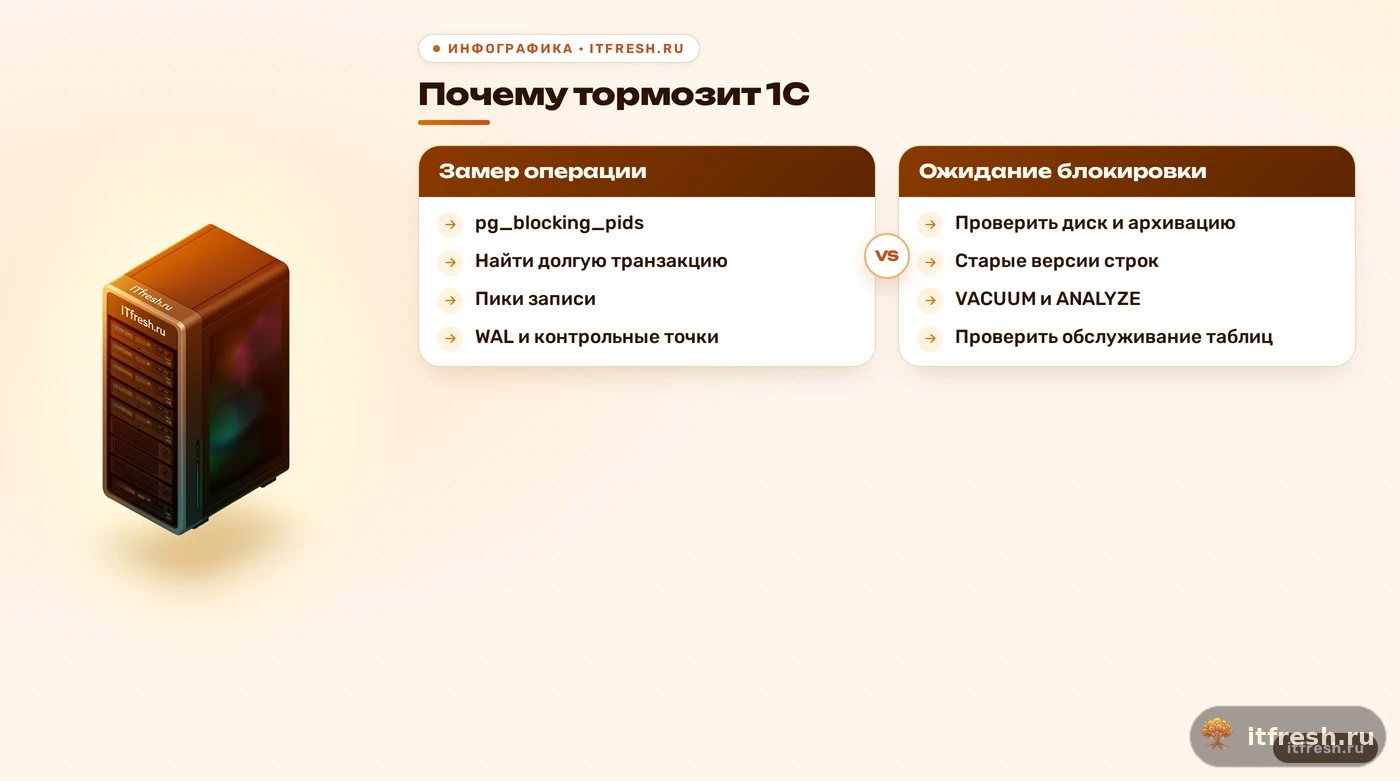
Ожидание блокировки расследую отдельно: pg_stat_activity показывает состояние сеанса и ожидание, а pg_blocking_pids(pid) помогает найти блокирующие процессы. Возраст открытой транзакции сопоставляю с операцией 1С, пользователем и фоновым заданием. Для журнала ожиданий применяется log_lock_waits; порог записи связан с deadlock_timeout, который также управляет задержкой проверки взаимоблокировки. Я не уменьшаю его автоматически ради скорости. Длинную транзакцию сначала объясняю, а уже потом решаю, как её завершать. Массовое отключение сеансов — быстрый способ заменить медленную работу сообщениями об ошибке.
SELECT pid, state, wait_event_type, wait_event,
       now() - xact_start AS xact_age,
       pg_blocking_pids(pid) AS blocked_by
FROM pg_stat_activity
WHERE datname = current_database()
  AND wait_event_type = 'Lock';
Как настроить WAL и checkpoint без потери надёжности
При записи PostgreSQL использует WAL, а контрольная точка организует сохранение изменённых страниц и границу для восстановления после сбоя. Если задержки совпадают с интенсивной записью, я проверяю журнал контрольных точек и накопительную статистику. В PostgreSQL 17 данные о работе checkpointer находятся в pg_stat_checkpointer: смотрю изменения num_timed, num_requested, write_time и sync_time за выбранный интервал. Запрошенная точка бывает вызвана не только объёмом WAL, поэтому счётчик сам по себе не доказывает слишком маленький max_wal_size. В старых ветках состав представлений отличается — запросы к статистике тоже требуют проверки версии.
SELECT num_timed, num_requested, write_time, sync_time
FROM pg_stat_checkpointer;
max_wal_size задаёт мягкий ориентир объёма WAL для автоматического checkpoint, а не жёсткий размер каталога pg_wal. WAL может занять больше из-за нагрузки, проблем архивации или удержания журналов для репликации. Я подбираю его вместе с checkpoint_timeout, свободным местом и допустимым временем восстановления после сбоя. Увеличить интервал иногда полезно для записи, но восстанавливать после аварийной остановки может потребоваться больше WAL. Удалять файлы из pg_wal вручную нельзя превращать в способ освобождения диска: сначала выясняю, что удерживает журнал и почему штатная очистка не справляется.
checkpoint_completion_target распределяет запись контрольной точки по части её интервала. В PostgreSQL 17 значение по умолчанию — 0.9; часто разумно начать с него и изучить задержки хранилища. Это не обещание убрать все пики. wal_segment_size сообщает размер сегмента: прописать ему новое значение в postgresql.conf как обычной изменяемой настройке нельзя. Это характеристика кластера, которую я проверяю отдельно от настройки контрольных точек. Размер сегмента не надо путать с max_wal_size. Аналогично wal_buffers не назначаю большим «потому что 1С»: сначала проверяю действующее значение и признаки того, что именно этот механизм ограничивает запись.
Для рабочей базы я сохраняю fsync = on, full_page_writes = on и synchronous_commit = on, если отдельно не спроектирован иной режим подтверждения записи. Отключение fsync или full_page_writes может привести к повреждению данных после сбоя. synchronous_commit = off имеет другой риск: возможна потеря недавно подтверждённых транзакций без такого же нарушения согласованности базы. Эти последствия нельзя смешивать. Сжатие WAL тоже требует измерений: оно сокращает полные образы страниц ценой процессорной работы. Сэкономленные секунды бесполезны, если потом приходится объяснять исчезновение проведённого документа.
Как autovacuum и ANALYZE помогают регистрам 1С
После UPDATE и DELETE остаются старые версии строк. VACUUM освобождает место для повторного использования и выполняет другие задачи обслуживания, ANALYZE обновляет статистику для планировщика. Я оставляю autovacuum включённым и проверяю, успевает ли он обслуживать активно меняющиеся таблицы. Объявлять его лишней нагрузкой удобно ровно до момента, когда база разрастается, а планы начинают промахиваться. Для временных таблиц autovacuum недоступен: их обслуживание и статистика требуют внимания к сценарию, который создаёт эти таблицы. Добавление фоновых работников само по себе эту особенность не меняет.
Начинаю с pg_stat_user_tables: смотрю n_dead_tup, n_live_tup, n_mod_since_analyze, last_autovacuum и last_autoanalyze. Это оценки и накопленные сведения, а не точное измерение свободного места внутри файлов. Я сравниваю снимки за рабочий интервал, учитываю ручные обслуживания и длительные транзакции, способные мешать очистке. Пустая дата последнего autovacuum ещё не доказывает поломку механизма. Нужно понять, требовался ли запуск и что происходило со статистикой. Равно как большой процент старых строк не превращается автоматически в такой же процент возвращаемого операционной системе дискового пространства.
SELECT relid::regclass AS relation, n_live_tup, n_dead_tup,
       n_mod_since_analyze, last_autovacuum, last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 10;
В PostgreSQL 17 порог обычной очистки после изменений связан с autovacuum_vacuum_threshold плюс autovacuum_vacuum_scale_factor, умноженным на оценку числа строк. У ANALYZE свои порог и доля изменений; для вставок существуют отдельные условия запуска VACUUM. На большой горячей таблице я рассматриваю индивидуальные параметры хранения, чтобы очистка и анализ начинались своевременно, и проверяю затраты на диск. Назначать одинаковую маленькую долю всем таблицам подряд необязательно: редкий справочник и постоянно обновляемый регистр живут по-разному. Настройки выбираю для конкретной таблицы после сопоставления с объектом метаданных 1С.
Если обслуживание отстаёт, выясняю, что мешает: долгие транзакции, нехватка работников, ограничения их затрат или возможности диска. Память каждого работника включаю в общий бюджет. Обычный VACUUM обычно сохраняет файл таблицы, освобождая место внутри него; VACUUM FULL переписывает таблицу и требует сильной блокировки, поэтому это отдельная операция с окном и запасом места. REINDEX тоже назначаю по установленной причине, а не каждую неделю для бодрости. Для приложения важно, чтобы обслуживание не пересекалось с тяжёлыми регламентными заданиями. Я проверяю их расписание прежде, чем объявлять сервер недостаточно мощным.
Как найти тяжёлый SQL и проверить план выполнения
pg_stat_statements помогает выбрать запросы по суммарной стоимости для системы. Модуль добавляют к имеющемуся списку shared_preload_libraries, затем нужен перезапуск; для работы требуется вычисление идентификаторов запросов, например compute_query_id = auto. В исследуемой базе выполняют CREATE EXTENSION pg_stat_statements, если расширение ещё не создано и необходимые файлы установлены. Права на чужие тексты запросов выдаю осознанно. Расширение нужно подготовить до замера, а не обнаружить его отсутствие после жалобы. Накопленная статистика без известного интервала наблюдения плохо отвечает на вопрос, что испортилось сегодня.
Начальный запрос ниже ранжирует по суммарному времени выполнения, а не по максимальной задержке отдельного вызова. Сравниваю прирост calls и total_exec_time за интервал и связываю SQL с пользовательской операцией через технологический журнал 1С. Частый короткий запрос иногда съедает больше времени, чем редкий долгий отчёт.
SELECT queryid, calls, total_exec_time, mean_exec_time,
       temp_blks_written, left(query, 160) AS query_preview
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;
Затем рассматриваю план конкретного SQL с реальными параметрами и контекстом, включая временные таблицы и настройки сеанса. Обычный EXPLAIN показывает оценки. EXPLAIN (ANALYZE, BUFFERS) действительно выполняет запрос и добавляет фактические данные: на рабочем сервере это дополнительная нагрузка, а изменяющий запрос ещё и изменяет данные. Начинаю на изолированной копии. Смотрю расхождение оценённых и фактических строк, повторения узлов, чтения и запись временных данных. Если воспроизведение отличается от сеанса 1С, выводы о плане могут оказаться красивыми, но бесполезными. Сначала добиваюсь воспроизводимости, затем выбираю исправление.
В планировщике сначала проверяю статистику, условия отбора и объём промежуточных результатов. random_page_cost задаёт относительную стоимость случайного чтения: его снижение может склонить план к индексному доступу, но наклейка SSD на сервере не подтверждает конкретное число. Я сравниваю несколько характерных операций, учитываю кеш и фактическую задержку устройства. effective_cache_size тоже влияет на выбор плана и требует правдоподобной оценки. JIT и параллелизм проверяю отдельными опытами на своём сочетании платформы и СУБД. Глобальное включение или выключение механизма ради одного отчёта способно ухудшить остальные операции.
Изменение схемы согласую с разработчиком 1С и связываю с объектами метаданных. SQL-индекс, вручную добавленный к случайно выбранной физической таблице, не заменяет понимания запроса и может потребовать отдельного сопровождения после реструктуризации. Я начинаю с отбора данных, структуры запроса, актуальности статистики и штатного описания индексов в приложении. Для каждого исправления записываю исходную причину, новое поведение и проверку соседних сценариев. Универсальная команда «проиндексировать всё» ускоряет главным образом рост расходов на запись и обслуживание. Результат должен быть виден в операции пользователя.
Как проверить бэкап и внедрить настройки с откатом
До внедрения я определяю допустимую потерю данных и время восстановления. Логический pg_dump даёт согласованную копию одной базы, но не сохраняет все объекты уровня кластера и не заменяет физическую копию для восстановления по WAL. Для параллельной выгрузки нужен directory-формат: -Fd вместе с -j. При двух работниках выгрузка открывает три подключения — ведущего и работников. Параллельное восстановление поддерживает directory и custom. Копию храню отдельно от рабочего сервера с проверкой доступа и ошибок. Файл, лежащий рядом с базой на том же диске, слишком разделяет её судьбу, чтобы считаться достаточной защитой.
Ниже — пример для заранее настроенной аутентификации, существующей базы base1c и подготовленного каталога /backup. Каталог base1c_directory должен отсутствовать; base1c_restore — новая пустая база на изолированном тестовом сервере с нужными ролями, расширениями и совместимой локалью. Параметры подключения выбирают источник для первой команды и тестовый сервер для второй.
pg_dump -Fd -j 2 -f /backup/base1c_directory base1c
pg_restore --exit-on-error -j 2 -d base1c_restore /backup/base1c_directory
Сначала проверяю успешное завершение выгрузки, затем запускаю восстановление. Два работника здесь иллюстрируют синтаксис, а не рекомендуемую мощность любого сервера.
Если восстанавливать надо к выбранному моменту, нужна физическая базовая копия и непрерывная доступная цепочка WAL до целевой точки. Один pg_dump такой возможности не даёт. Я проверяю архивацию, доставку журналов, запас места и зависимости хранения; конфигурационные файлы сохраняю отдельно. Порядок выбора точки и проверки результата разобран в материале про восстановление PostgreSQL по времени. Контроль заканчивается запуском отдельного сервера и проверкой базы через 1С. Для согласованности внешних файлов и обменов нужен свой порядок восстановления: сама СУБД не сохранит то, что хранится за её пределами.
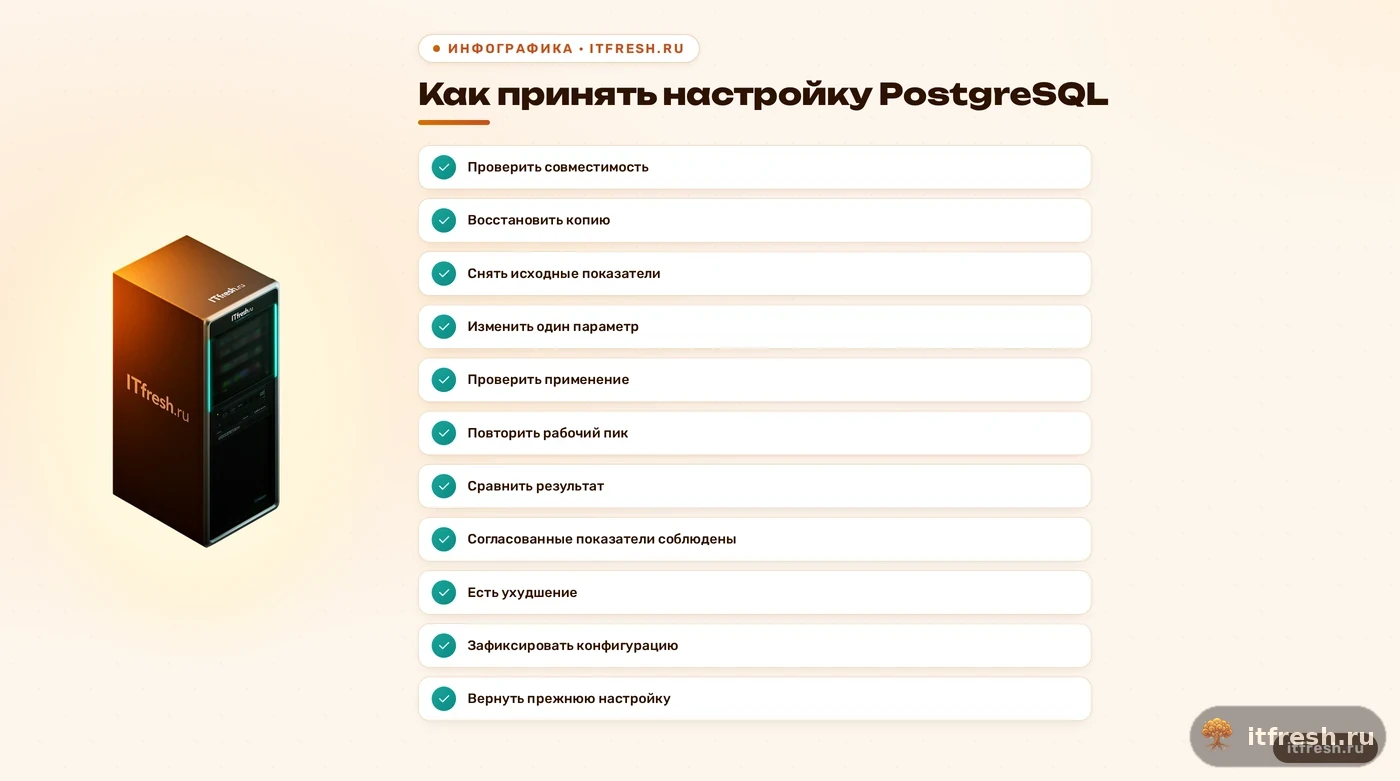
Покажу учебный разбор настройки на изолированной копии. Условие: отдельная тестовая машина с 32 ГиБ ОЗУ, NVMe и PostgreSQL 17 в сборке, совместимой с выбранным релизом 1С 8.3. Точный релиз платформы перед испытанием фиксируется в паспорте. План опыта: исходный work_mem = 64MB, пробный = 16MB; shared_buffers = 8GB оставляем одинаковым. Для 20 запросов с двумя сортировками получаем бюджеты 2560 и 640 МиБ, как считали выше. В первый день плана снимаем исходные показатели, в согласованное окно меняем один параметр, затем повторяем рабочий пик. Эти числа — условия опыта, не результаты внедрения.
Итог такого разбора заранее не назначается: меньший work_mem снижает бюджет операций, но может увеличить запись временных файлов и замедлить отчёт. Я принимаю настройку только после измерения времени проведения, отчётов, ожиданий, памяти и диска при сопоставимой нагрузке. Если выросли ошибки или ухудшился согласованный сценарий, возвращаю прежнее значение и повторно проверяю применение. После приёмки оставляю журнал изменений, проверенный порядок восстановления и наблюдение за пиками. Именно такой результат получает директор: понятные причины и управляемые изменения. Набор красивых строк в postgresql.conf не заменяет работающую бухгалтерию.
Частые вопросы
Сколько памяти выделить PostgreSQL для 1С?
По нагрузке и совместному размещению служб. Около 25 % ОЗУ для shared_buffers — стартовая оценка для выделенного сервера. work_mem, временные таблицы и обслуживание считаются отдельно. Формулы «размер базы × 2» для любой системы нет.
effective_cache_size резервирует оперативную память?
Нет. Он сообщает планировщику оценку доступного кеша и влияет на выбор плана. Ни общий буфер PostgreSQL, ни кеш ОС от изменения этого параметра не увеличиваются.
Какую сборку PostgreSQL выбрать для 1С 8.3?
Проверьте точный релиз платформы, ОС и сборку в требованиях 1С и описании релиза. PostgreSQL с патчами от 1С и продукты Postgres Pro — разные варианты поставки. Общая поддержка ветки не подтверждает совместимость со всеми выпусками 8.3.
Нужно ли отключать autovacuum или регулярно делать REINDEX?
Autovacuum оставляю включённым и проверяю, успевает ли он очищать таблицы и обновлять статистику. REINDEX назначаю по конкретной диагностированной причине, с учётом блокировок и ресурсов. Еженедельного правила для всех баз нет.
Можно ли проверить медленный запрос через EXPLAIN ANALYZE?
Да, но ANALYZE действительно запускает запрос. Воспроизведите параметры, временные таблицы и контекст сеанса на изолированной копии; изменяющий запрос изменит данные. Для просмотра оценочного плана без выполнения используйте обычный EXPLAIN.
Достаточно ли pg_dump для восстановления на нужную минуту?
Нет. Для восстановления по WAL нужны физическая базовая копия и непрерывная цепочка журналов до выбранной точки. Логический дамп решает другую задачу. Любую схему проверяйте реальным восстановлением и запуском 1С в изоляции.
ITfresh Dark в Telegram
@ITfresh_DarkТёмная сторона IT: разборы аварий, безопасность, бэкапы, 1С — без воды.
Источники
- 1С: сборки PostgreSQL и системные требования — Проверены назначение патчей 1С, отдельное перечисление PostgreSQL с патчем от 1С и продуктов Postgres Pro, необходимость проверки ОС и конкретного релиза платформы. https://v8.1c.ru/platforma/postgresql/ ; https://v8.1c.ru/tekhnologii/systemnye-trebovaniya-1s-predpriyatiya-8/subd/subd-postgresql/
- 1С:ИТС — настройки PostgreSQL, часть 2 — Проверены оговорка о приблизительных стартовых рекомендациях, учёт других приложений, параметры строк standard_conforming_strings и escape_string_warning, диапазон max_locks_per_transaction 512–2000 в контексте методики. Описание памяти дополнительно сверено с PostgreSQL: work_mem относится к операции, а не ко всему запросу. https://its.1c.ru/db/content/metod8dev/src/developers/scalability/administration/postgresql/i8105866.htm
- PostgreSQL 17: память и планировщик — Проверены ориентир 25 % для shared_buffers на выделенном сервере, отсутствие потолка 8 ГБ, work_mem, hash_mem_multiplier, temp_buffers, память обслуживания и параллельных исполнителей; effective_cache_size не выделяет память, random_page_cost влияет на выбор индексного доступа. https://www.postgresql.org/docs/17/runtime-config-resource.html ; https://www.postgresql.org/docs/17/runtime-config-query.html
- PostgreSQL 17: WAL и применение конфигурации — Проверены мягкий характер max_wal_size, checkpoint_timeout, checkpoint_completion_target = 0.9, различие рисков fsync/full_page_writes и synchronous_commit, сжатие полных образов страниц, wal_segment_size как предустановленная характеристика, поля pg_settings. https://www.postgresql.org/docs/17/runtime-config-wal.html ; https://www.postgresql.org/docs/17/wal-configuration.html ; https://www.postgresql.org/docs/17/runtime-config-preset.html ; https://www.postgresql.org/docs/17/view-pg-settings.html
- PostgreSQL 17: обслуживание, блокировки и диагностика — Проверены VACUUM/ANALYZE, формула порога очистки, недоступность autovacuum для временных таблиц, ограничения VACUUM FULL; смысл max_locks_per_transaction и deadlock_timeout; pg_blocking_pids; столбцы pg_stat_user_tables и pg_stat_checkpointer; установка pg_stat_statements, его поля и выполнение запроса через EXPLAIN ANALYZE. https://www.postgresql.org/docs/17/routine-vacuuming.html ; https://www.postgresql.org/docs/17/runtime-config-autovacuum.html ; https://www.postgresql.org/docs/17/runtime-config-locks.html ; https://www.postgresql.org/docs/17/view-pg-locks.html ; https://www.postgresql.org/docs/17/functions-info.html ; https://www.postgresql.org/docs/17/monitoring-stats.html ; https://www.postgresql.org/docs/17/pgstatstatements.html ; https://www.postgresql.org/docs/17/using-explain.html
- PostgreSQL 17: pg_dump, pg_restore и PITR — Проверены -Fd, -j, -f, -d, --exit-on-error, требование отсутствующего каталога для directory-дампа, число подключений jobs + 1, поддержка параллельного восстановления custom/directory и границы логического дампа. Для PITR проверены физическая базовая копия, непрерывная цепочка WAL и отдельное сохранение конфигурации. https://www.postgresql.org/docs/17/app-pgdump.html ; https://www.postgresql.org/docs/17/app-pgrestore.html ; https://www.postgresql.org/docs/17/continuous-archiving.html