
Почему SHAP не работает с LLM — и что делать
SHAP не работает с LLM, потому что LLM — не интерпретируемые модели. Это не ошибка, а закономерность. Если вы сталкиваетесь с этой проблемой, вы не один. Надо понимать, почему и как это исправить.
Почему SHAP не работает с LLM
SHAP (SHapley Additive exPlanations) — это метод для объяснения результатов машинного обучения, основанный на теории игр. Он работает, когда модель — белый ящик, то есть её внутреннее устройство известно. LLM — это чёрный ящик, даже если мы знаем архитектуру. Внутренние веса и связи в LLM настолько сложны, что невозможно вычислить точные вклады каждого признака. Это не техническая ошибка — это фундаментальное ограничение метода.
Когда вы пытаетесь применить SHAP к LLM, вы сталкиваетесь с ошибкой 'Model is not interpretable', потому что SHAP не может построить шаплиевы значения. Это не ошибка в коде, а сигнал от системы: «я не могу объяснить это». Это нормально. Даже в научных публикациях по LLM часто отказываются от интерпретируемых объяснений, потому что они не дают полезной информации. Вместо этого используются другие подходы — например, визуализация внимания или локальные приближения.
SHAP работает с моделями, где можно вычислить вклад каждого признака. Это возможно в линейных моделях, деревьях решений, и даже в нейросетях, если они достаточно простые. LLM — это не просто нейросеть, а сложная система с тысячами параметров, где каждый токен влияет на весь вывод. В таких системах вклад каждого признака не определяется однозначно. Это не проблема SHAP, это проблема LLM.
SHAP предназначен не для объяснения LLM, а для интерпретации традиционных моделей. Если вы используете SHAP для LLM, вы пытаетесь применить линейный метод к нелинейной системе. Это как пытаться измерить площадь круга линейкой. Это не работает, и не потому что линейка плохая, а потому что метод не подходит.
Если вы всё же хотите использовать SHAP, то можно попробовать применить его к промежуточным выводам LLM, например, к токенам или скрытым состояниям. Но это уже не SHAP для LLM, а SHAP для промежуточных моделей. Это может дать понятные результаты, но не объяснит, почему LLM выдал конкретный ответ.
Что делать, если нужно объяснение LLM
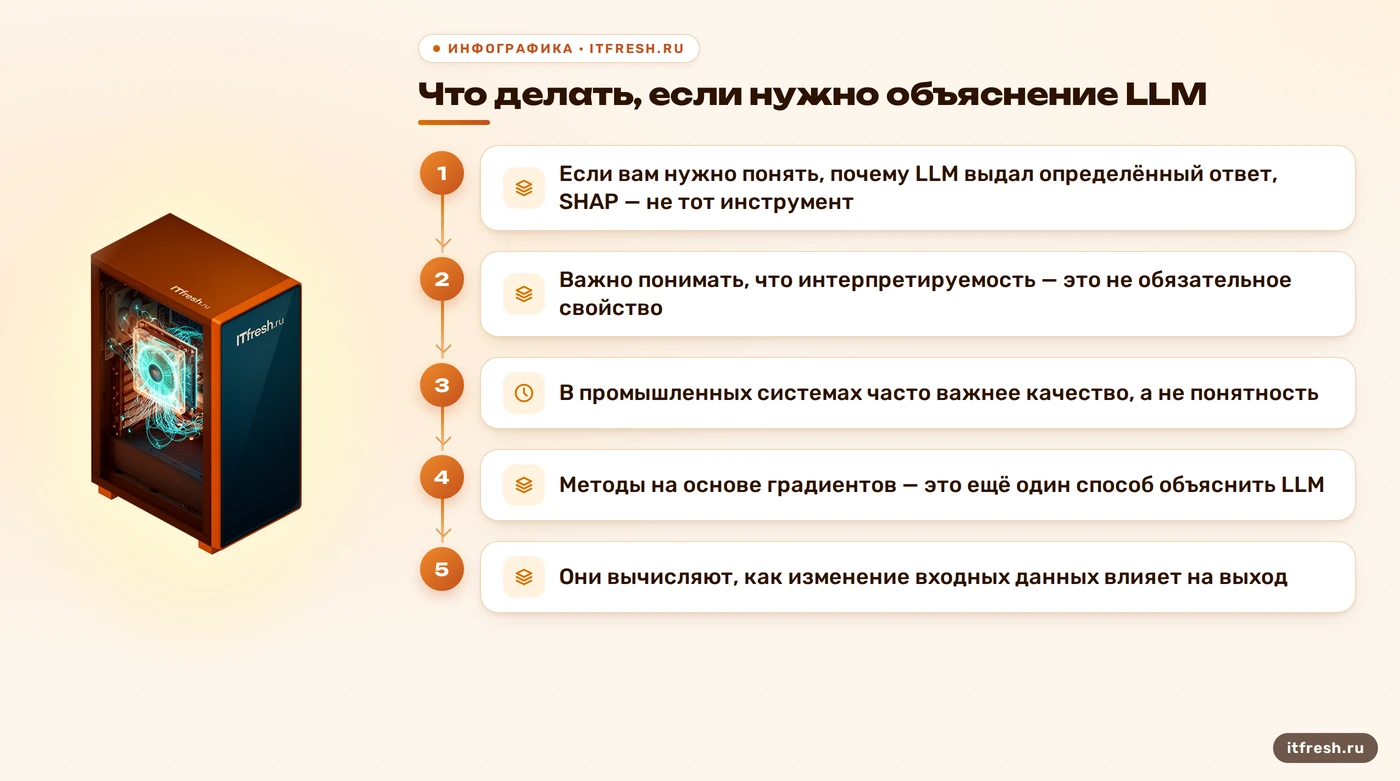
Если вам нужно понять, почему LLM выдал определённый ответ, SHAP — не тот инструмент. Вместо него используются методы, которые работают с интерпретацией LLM: визуализация внимания, локальные объяснения (LIME, LER), или методы на основе градиентов. Например, в библиотеке Hugging Face есть инструменты для визуализации внимания, которые показывают, какие слова или токены повлияли на вывод. Это не интерпретация в смысле SHAP, но она дает понятный результат.
Визуализация внимания — это метод, который показывает, какие части входного текста повлияли на выход. Это не математически строго, но даёт понятный визуальный результат. Например, если вы спрашиваете LLM: «Какой город в России?», и он отвечает «Москва», то визуализация внимания покажет, что токен «Россия» получил высокий вес. Это не доказывает, что LLM «понял» Россию, но показывает, что он «обратил внимание» на этот токен.
Другой путь — использовать LLM как часть более сложной системы, где есть интерпретируемая модель. Например, вы можете обучить модель-регрессор, которая принимает выходы LLM и объясняет их на основе входных данных. Это не идеально, но работает. Интерпретируемость — необязательное свойство. В промышленных системах часто важнее качество, а не понятность. Если LLM даёт точные ответы, и вы можете проверить их, то интерпретация — дополнительная функция, а не основная.
Методы на основе градиентов — это ещё один способ объяснить LLM. Они вычисляют, как изменение входных данных влияет на выход. Например, если вы измените слово «Россия» на «Франция», то можно посмотреть, как изменился выход. Это не даст точного вклада каждого признака, но покажет, какие части текста важны. Это полезно, но требует глубокого понимания архитектуры LLM.
Если вы не хотите использовать сложные методы, можно просто попросить LLM объяснить свой ответ. Некоторые модели, например, GPT-4, могут генерировать пояснения. Это не научно, но работает. Например, вы можете спросить: «Почему ты выбрал «Москва»?» и получить ответ: «Потому что «Россия» — это страна, а «Москва» — её столица». Это не интерпретация, но даёт понятный результат.
Какие инструменты работают с LLM
Вместо SHAP для LLM используются методы, которые не требуют полной интерпретируемости. Например, методы на основе внимания показывают, какие части входного текста повлияли на выход. Это не математически строго, но даёт понятный визуальный результат. Также применяются локальные объяснения, где модель-объяснитель аппроксимирует поведение LLM в окрестности конкретного примера. Это позволяет понять, почему LLM выдал определённый ответ, не требуя полной интерпретации.
Визуализация внимания — это стандартный инструмент для объяснения LLM. Он показывает, какие токены или слова повлияли на вывод. Например, если вы вводите «Какой город в России?», и LLM отвечает «Москва», то визуализация внимания покажет, что токен «Россия» получил высокий вес. Это не доказывает, что LLM «понял» Россию, но показывает, что он «обратил внимание» на этот токен. Это полезно, но не точное объяснение.
Локальные объяснения — это методы, которые аппроксимируют поведение LLM в окрестности конкретного примера. Например, вы можете использовать LIME, который строит линейную модель, аппроксимирующую поведение LLM в окрестности определённого запроса. Это не даст точного вклада каждого признака, но покажет, какие признаки важны. Это полезно, но требует настройки и может быть неточным.
Модели-объяснители — это ещё один подход. Вы обучаете интерпретируемую модель (например, линейную или дерево решений), которая принимает выходы LLM и объясняет их на основе входных данных. Это не идеально, но работает. Например, вы можете обучить линейную модель, которая принимает токены и объясняет, почему LLM выдал определённый ответ. Это не точное объяснение, но даёт понятный результат.
- Визуализация внимания
- Локальные объяснения (LIME, LER)
- Методы на основе градиентов
- Модели-объяснители (например, интерпретируемая модель, обучающаяся на выводах LLM)
Когда интерпретируемость важна
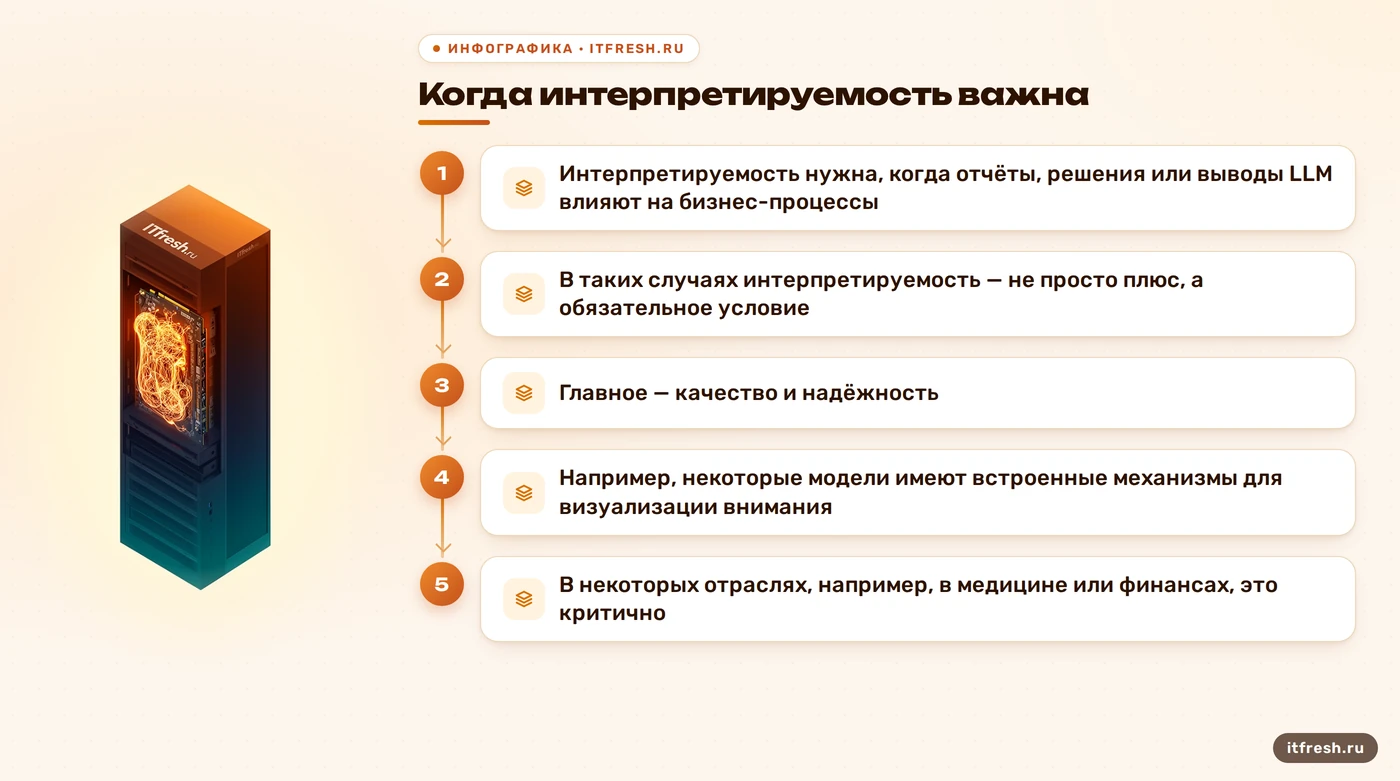
Интерпретируемость нужна, когда отчёты, решения или выводы LLM влияют на бизнес-процессы. Например, если LLM используется для оценки рисков в финансовой сфере, то нужно понимать, почему он выдал определённый риск. В таких случаях интерпретируемость — не просто плюс, а обязательное условие. Однако в большинстве случаев, особенно в IT-проектах, интерпретируемость не критична. Главное — качество и надёжность.
Если вы работаете в среде, где интерпретируемость обязательна, то нужно выбирать LLM, которые поддерживают объяснения. Например, некоторые модели имеют встроенные механизмы для визуализации внимания. Также можно использовать LLM с ограничениями — например, модели, которые генерируют не только ответ, но и пояснение. Это не решает проблему интерпретируемости, но снижает её значимость.
Интерпретируемость — это одновременно техническая проблема и бизнес‑задача. Если вы не можете объяснить, почему LLM выдал определённый ответ, то это может повлиять на доверие к системе. В некоторых отраслях, например, в медицине или финансах, это критично. В IT-проектах, где LLM используется для генерации текста или ответов, интерпретируемость — дополнительная функция.
Если вы не можете объяснить вывод LLM, то это не обязательно проблема. LLM — это не система, «думающая» сама, а инструмент, который имитирует мышление. Её выводы основаны на статистике, а не на логике. Поэтому объяснение — это не доказательство, а приближение. В большинстве случаев, если LLM даёт правильный ответ, то это достаточно.
Интерпретируемость — это не всегда необходимость. В некоторых случаях, особенно в IT-проектах, качество и надёжность важнее. Если LLM работает, и вы можете проверить его выводы, то интерпретируемость — дополнительная функция, а не основная. LLM — это лишь инструмент, а не эксперт.
Типовые ошибки сисадминов
Сисадмины часто пытаются применить SHAP к LLM, потому что это стандартный инструмент для объяснения моделей. Но LLM — это не тот случай. SHAP работает с линейными моделями, деревьями решений и нейросетями, где можно вычислить вклад каждого признака. LLM — это не линейная модель. Даже если вы используете SHAP для LLM, он будет выдавать бессмысленные результаты. Это не ошибка, а ожидаемое поведение.
Ещё одна ошибка — попытка интерпретировать LLM через внешние инструменты. Например, использовать SHAP для объяснения выводов LLM, которые используются как часть системы. Это не работает. Вместо этого нужно использовать инструменты, которые работают с LLM напрямую. Например, если вы используете Hugging Face, то можно использовать их встроенные инструменты для визуализации внимания. Это не SHAP, но это работает.
Сисадмины часто не понимают, что LLM — это не просто нейросеть, а сложная система с тысячами параметров. Даже если вы измените архитектуру, LLM остаётся сложной системой, где невозможно вычислить точные вклады каждого признака. SHAP не подходит для LLM, независимо от архитектуры.
Если вы применяете LLM в промышленной системе, интерпретируемость не является обязательным свойством. Главное — качество и надёжность. Если LLM даёт правильные ответы, и вы можете проверить их, то интерпретируемость — дополнительная функция. LLM — это не эксперт, а инструмент.
Сисадмины часто ожидают, что LLM будет объяснять себя. Но LLM не может объяснить, почему он выдал определённый ответ, если это не встроено в модель. Вы можете попросить LLM объяснить свой ответ, но это не гарантирует точность. LLM — это не система, «думающая» самостоятельно, а инструмент, который имитирует процесс мышления.
Как проверить результат
После того как вы внедрили методы объяснения LLM, важно проверить, что они работают. Например, вы можете проверить, что визуализация внимания показывает, что токены, которые должны быть важны, действительно получают высокий вес. Также можно проверить, что локальные объяснения аппроксимируют поведение LLM в окрестности конкретного примера.
Один из способов проверки — сравнение с человеческими объяснениями. Например, вы можете спросить человека, почему он выбрал «Москва» в ответ на «Какой город в России?», и сравнить это с выводами LLM. Если они совпадают, то это хороший знак. Если нет, то нужно пересмотреть методы объяснения.
Другой способ — проверка на контрольных примерах. Например, вы можете изменить входные данные и посмотреть, как изменился вывод. Если LLM изменил ответ, то методы объяснения должны показать, какие части текста повлияли на это. Это не даст точного вклада каждого признака, но покажет, что методы работают.
Проверка — это не формальное математическое доказательство, а визуальный и логический контроль. Например, если вы видите, что токен «Россия» получил высокий вес, и LLM ответил «Москва», то это хороший знак. Если токен «Франция» получил высокий вес, и LLM ответил «Париж», то это тоже хороший знак. Если нет, то нужно пересмотреть методы объяснения.
Проверка — это не только техническая задача, но и бизнес-задача. Если вы не можете объяснить, почему LLM выдал определённый ответ, то это может повлиять на доверие к системе. LLM — не эксперт, а инструмент, и его выводы должны быть проверяемы.
Что делать, если уже сломалось
Если вы уже использовали SHAP для LLM и получили ошибку, то это не проблема. Это ожидаемое поведение. SHAP не работает с LLM, потому что LLM — это не интерпретируемая модель. Это не ошибка, а сигнал системы: «я не могу объяснить это».
Если вы хотите исправить ситуацию, то нужно перейти к другим методам объяснения. Например, использовать визуализацию внимания, локальные объяснения, или методы на основе градиентов. Это не решит проблему интерпретируемости, но даст понятные результаты.
LLM — это не система, «думающая» сама, а система, «имитирующая» мышление. Поэтому объяснение — это не доказательство, а приближение. LLM — лишь инструмент, а не эксперт. Его выводы основаны на статистике, а не на логике.
Если вы не можете объяснить вывод LLM, то это не обязательно проблема. LLM — это не эксперт, а лишь инструмент. Его выводы должны быть проверяемы, но не обязательно интерпретируемы. LLM — это не система, которая действительно «понимает», а лишь имитирует понимание.
Если вы уже использовали SHAP для LLM, то это не ошибка. Это ожидаемое поведение. SHAP предназначен не для объяснения LLM, а для интерпретации традиционных моделей. LLM — это совсем иной случай.
Частые вопросы
Почему SHAP не работает с LLM?
SHAP требует, чтобы модель была интерпретируемой. LLM — это чёрный ящик, и невозможно вычислить точные вклады каждого признака. Поэтому SHAP выдаёт ошибку 'Model is not interpretable'.
Как объяснить вывод LLM, если SHAP не работает?
Используйте методы, которые работают с LLM: визуализация внимания, локальные объяснения (LIME, LER), или методы на основе градиентов. Также можно использовать модели-объяснители, которые аппроксимируют поведение LLM.
Нужна ли интерпретируемость в LLM-проектах?
Интерпретируемость важна, если выводы LLM влияют на бизнес-решения. В большинстве случаев, особенно в IT-проектах, качество и надёжность важнее интерпретируемости.
Можно ли использовать SHAP для LLM, если изменить архитектуру?
Нет. Даже если вы измените архитектуру, LLM остаётся сложной системой, где невозможно вычислить точные вклады каждого признака. SHAP не подходит для LLM, независимо от архитектуры.
Как проверить, что методы объяснения работают?
Проверьте, что визуализация внимания показывает, что важные токены получают высокий вес. Также можно сравнить выводы LLM с человеческими объяснениями или проверить на контрольных примерах.
Что делать, если уже использовали SHAP для LLM?
Это не ошибка. Это ожидаемое поведение. SHAP не работает с LLM, поэтому следует использовать альтернативные методы объяснения.
Источники
- SHAP Documentation — https://shap.readthedocs.io/en/latest/index.html
- Hugging Face Documentation — https://huggingface.co/docs/transformers/main/en/attention
- LIME Documentation — https://github.com/marcotcr/lime