
Обновил ConfigMap, а в поде старый файл: почему subPath ломает hot reload и что с этим делать
Вы поправили ConfigMap, применили, GitOps отрапортовал Synced и Healthy. Прошло десять минут, полчаса, два часа — реплики продолжают ходить на старый адрес базы и работать со старыми лимитами. Файл в поде физически не изменился. Это не баг кластера и не подвисший kubelet: так работает subPath, и в Kubernetes 1.37 поведение ровно то же, что было пять лет назад. Ниже — почему так устроено, как за пять минут отличить эту проблему от «приложение не умеет перечитывать конфиг», и четыре схемы доставки настроек, которые я реально ставлю клиентам вместо магии с hot reload.
Симптом: конфиг новый везде, кроме того места, где он нужен
Сценарий узнаваемый до боли. Меняется адрес реплики PostgreSQL, правится один ключ в ConfigMap, коммит уезжает в Git, Argo CD подхватывает, ресурс в кластере обновлён — проверяется в одну команду и действительно обновлён. А приложение как ходило на старый хост, так и ходит. Разработчик идёт к вам с формулировкой «кластер не применил конфиг».
Первое, что делают почти все, — перезапускают под. Конфиг подхватывается. Делается вывод «ну, у нас просто нет hot reload, будем перезапускать». И вот тут закапывается мина: проблема не в отсутствии hot reload, а в том, что файл в контейнере физически не менялся, и не поменяется никогда — хоть через минуту, хоть через неделю. Приложение могло уметь перечитывать конфиг по inotify идеально, ему просто нечего перечитывать.
Проверяется гипотеза за пятнадцать секунд. Сравниваем то, что лежит в API, с тем, что видит контейнер:
kubectl get cm app-config -n prod -o jsonpath='{.data.config\.yaml}' | md5sum
kubectl exec -n prod deploy/api -c api -- md5sum /etc/app/config.yaml
Если хеши разошлись — дело почти наверняка в способе монтирования, а не в приложении.
И сразу второй индикатор, самый надёжный. Смотрим содержимое каталога, куда смонтирован ConfigMap:
kubectl exec -n prod deploy/api -c api -- ls -la /etc/app/При нормальном монтировании ConfigMap как тома вы увидите служебный зоопарк: каталог вида ..2026_09_07_09_14_22.1274839561, симлинк ..data, указывающий на него, и симлинк config.yaml -> ..data/config.yaml. Если вместо этого лежит обычный одинокий файл — у вас subPath, и обновлений не будет.
- ConfigMap в API обновлён, `kubectl get cm` показывает новые данные
- GitOps-контроллер зелёный: Synced, Healthy, дрейфа нет
- В контейнере файл со старым содержимым и старым mtime
- Перезапуск пода лечит — до следующего изменения
- В каталоге монтирования нет `..data` и нет каталога с меткой времени
Механика: почему subPath не получает обновлений и не получит
Kubernetes проецирует ConfigMap в контейнер не построчной перезаписью файлов, а подменой симлинка. Внутри тома kubelet создаёт скрытый каталог с меткой времени, кладёт туда все ключи, затем атомарно переставляет симлинк ..data на новый каталог, а старый удаляет. Это описано прямо в комментарии к AtomicWriter в исходниках: видимые файлы тома — симлинки на файлы в каталоге данных, а сам каталог данных — симлинк, переключение которого и делает обновление атомарным. Ни один читатель никогда не увидит полуобновлённый набор файлов — либо весь старый, либо весь новый.
Теперь ключевой момент. subPath монтирует в контейнер не том, а конкретный путь внутри тома — по сути один-единственный файл, привязанный к inode на момент старта контейнера. Когда kubelet переставляет ..data, старый inode уходит вместе со старым каталогом, а bind-mount в контейнере продолжает указывать в никуда — точнее, на то, что было в момент запуска. Обновить его, не пересоздав контейнер, физически нечем.
Поэтому документация Kubernetes формулирует это без всяких «может быть»: контейнер, использующий ConfigMap как том, смонтированный через subPath, не получит обновлений при изменении этого ConfigMap (в оригинале: «A container using a ConfigMap as a subPath volume mount will not receive ConfigMap updates»). Аналогичные оговорки в документации есть для Secret и downward API. Ограничение сознательное и архитектурное, а не «пока не починили».
В Kubernetes 1.37 (релиз 26 августа 2026 года) поведение ровно то же. В changelog 1.37 действительно есть правки вокруг subPath — kubelet научился восстанавливаться из повреждённых точек монтирования subPath при рестарте контейнера вместо зависания в CreateContainerConfigError, и починен цикл ошибок при обрывах FUSE/GlusterFS, — но это про устойчивость монтирования, а не про доставку обновлений. Ждать, что «в следующей минорке починят», не надо: ключевой ишью kubernetes/kubernetes#22368 про раскатку ConfigMap («Facilitate ConfigMap rollouts / management») открыт со 2 марта 2016 года и на сентябрь 2026-го всё ещё не закрыт.
- `subPath` фиксирует inode при старте контейнера — обновление тома его не затрагивает
- Обычный `configMap`/`projected` том обновляется через переключение симлинка `..data`
- Тот же эффект у `subPathExpr` — это не обходной путь, а тот же механизм
- Secret и downward API через `subPath` ведут себя идентично
- В 1.37 правки по subPath есть, но они про восстановление монтирования, а не про обновления
Даже без subPath hot reload часто не срабатывает: ловушка inotify
Убрали subPath, смонтировали ConfigMap нормальным томом — и обнаружили, что hot reload всё равно молчит. Файл в контейнере обновляется (md5 сходится), а приложение продолжает работать со старыми значениями. Это уже вторая, независимая проблема, и путать её с первой очень легко.
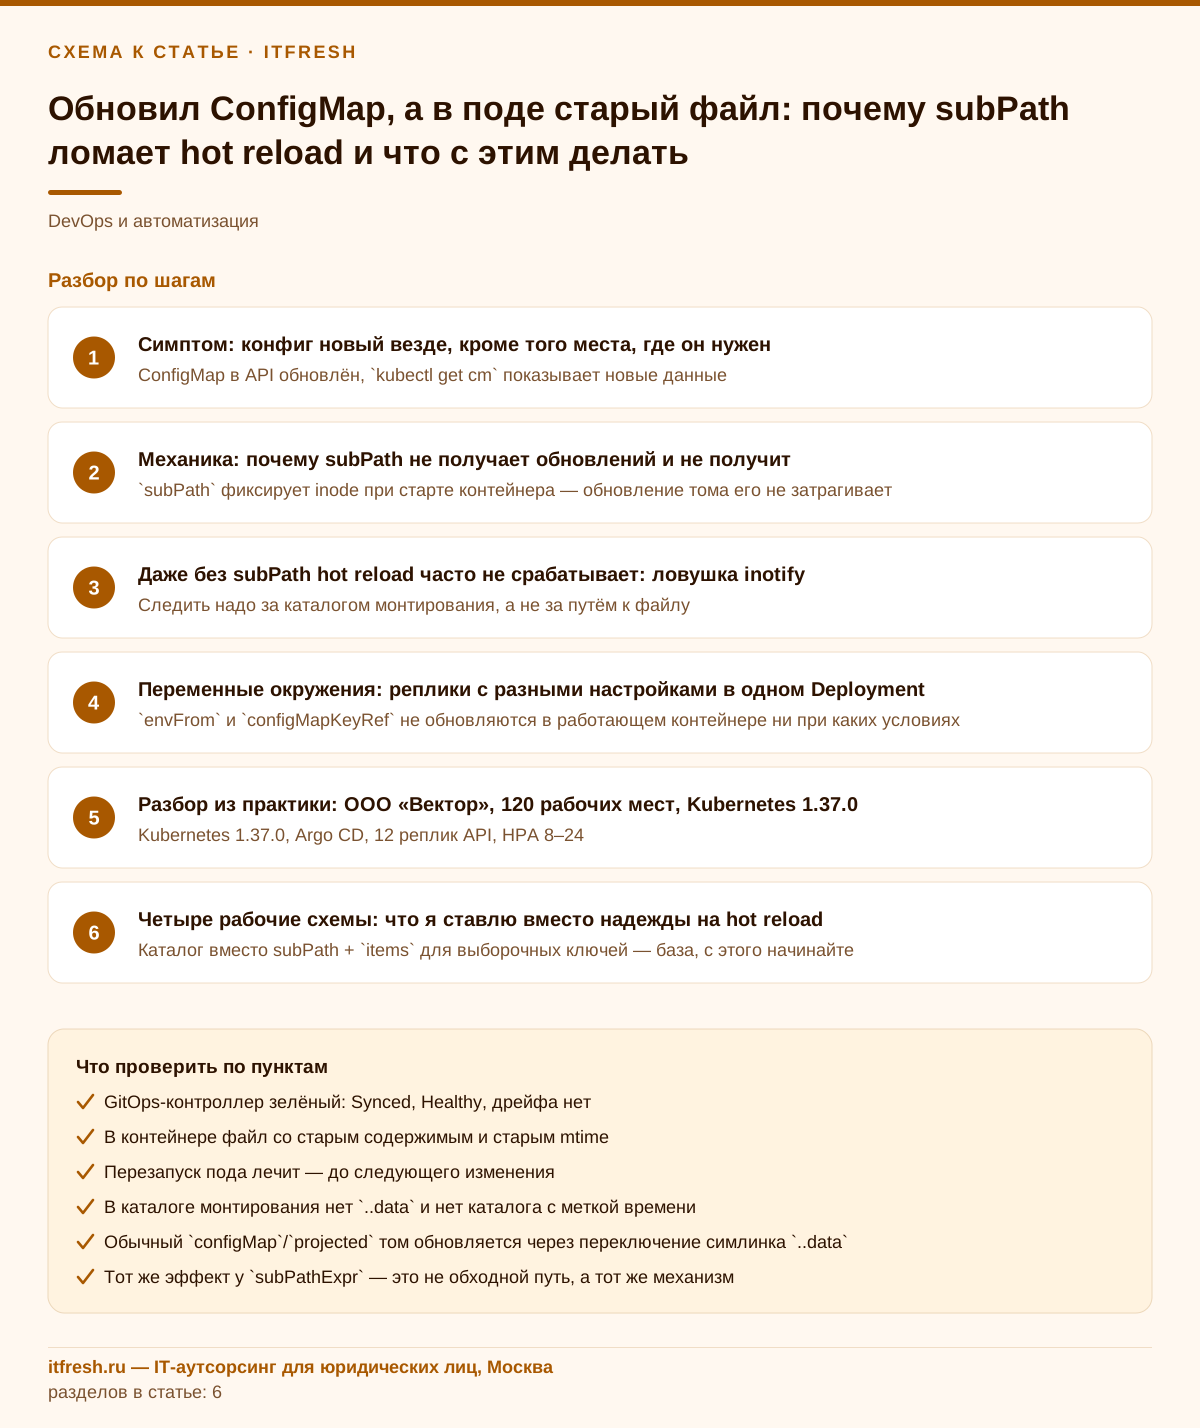
Причина в том же симлинке. Библиотеки вроде fsnotify и всё, что на них построено, по умолчанию вешают watch на путь к файлу, а inotify следит за inode, а не за именем. При переключении ..data inode файла не модифицируется — он просто перестаёт быть доступен по прежнему имени. Событие IN_MODIFY не приходит никогда. Приходит IN_CREATE и IN_MOVED_TO на сам каталог монтирования — и вот их-то и надо слушать. В том же комментарии к AtomicWriter это сказано прямым текстом: потребителям каталога предлагается наблюдать за симлинком ..data через inotify или fanotify.
Практический вывод: чтобы hot reload по файлу работал, приложение должно следить за каталогом, а не за файлом, и перечитывать конфиг по событию на ..data. Если исходники не ваши и вы не можете это поменять — не героствуйте. Дешевле и надёжнее пойти путём перезапуска, о котором ниже.
И про задержку. Документация Kubernetes формулирует её точно: суммарная задержка от обновления ConfigMap до появления новых ключей в поде может достигать периода синхронизации kubelet плюс задержки распространения в его кеше. Дефолт syncFrequency — 1m. Тип кеша задаётся параметром configMapAndSecretChangeDetectionStrategy: Watch (по умолчанию, задержка равна задержке watch), Cache (TTL-кеш, к задержке добавляется TTL) и Get (kubelet каждый раз ходит в API-сервер, добавочной задержки нет, зато есть нагрузка). То есть в норме это секунды, но в регламентах закладывайтесь на минуту с лишним, а на стратегии Cache — ещё и на TTL.
- Следить надо за каталогом монтирования, а не за путём к файлу
- Значимые события — `IN_CREATE` / `IN_MOVED_TO` на `..data`, а не `IN_MODIFY` на конфиге
- Дефолт `syncFrequency` — 1 минута; закладывайтесь на неё в регламентах, а не на «мгновенно»
- `configMapAndSecretChangeDetectionStrategy` по умолчанию `Watch`; `Get` бьёт по API-серверу, `Cache` добавляет задержку на TTL кеша
- Проверка того, что дошло: `kubectl exec -- ls -la` каталога и сравнение md5
Переменные окружения: реплики с разными настройками в одном Deployment
Отдельная и, на мой взгляд, куда более опасная история — ключи ConfigMap, проброшенные через envFrom или valueFrom.configMapKeyRef. Они читаются ровно один раз, в момент создания контейнера, и не обновляются никогда. Тут даже нет механики симлинков — переменные окружения процесса в Linux после старта извне не переписываются. Документация про это говорит прямо: для применения изменений требуется замена подов.
Опасность в том, что это тихо. Файл в контейнере хотя бы можно сравнить с ConfigMap одной командой, а расхождение по env всплывает через недели. И самый неприятный сценарий такой: ConfigMap поменяли, поды не трогали, а потом HPA доскейлил Deployment вверх. Новые реплики стартуют уже с новыми переменными, старые продолжают жить со старыми. В одном Deployment, под одним Service, за одним ingress у вас одновременно два разных набора настроек. Запросы балансируются между ними случайно.
Дальше начинается диагностический ад: «ошибка воспроизводится примерно в трети случаев», «на стенде всё нормально», «повторный запрос проходит». Ищут гонки в коде, сетевые таймауты, кривой keep-alive. А это просто два поколения конфига в одной реплика-сете.
Проверяется в одну команду — по всем подам сразу:
for p in $(kubectl get po -n prod -l app=api -o name); do
  echo -n "$p "
  kubectl exec -n prod $p -c api -- printenv DB_HOST 2>/dev/null
done
kubectl get cm app-config -n prod -o jsonpath='{.data.DB_HOST}{"\n"}'
Если в выводе больше одного значения — поздравляю, вы нашли причину плавающих ошибок.
- `envFrom` и `configMapKeyRef` не обновляются в работающем контейнере ни при каких условиях
- Расхождение всплывает при скейлинге, эвикшене, перепланировании — то есть в самый неудобный момент
- Симптом на проде: ошибка воспроизводится «через раз» и не ловится на стенде
- Лечится только заменой подов: `kubectl rollout restart deploy/api -n prod`
- Профилактика — привязка рестарта к изменению ConfigMap, а не ручная дисциплина
Разбор из практики: магазин сумок «СумочныйРяд», 43 рабочих места
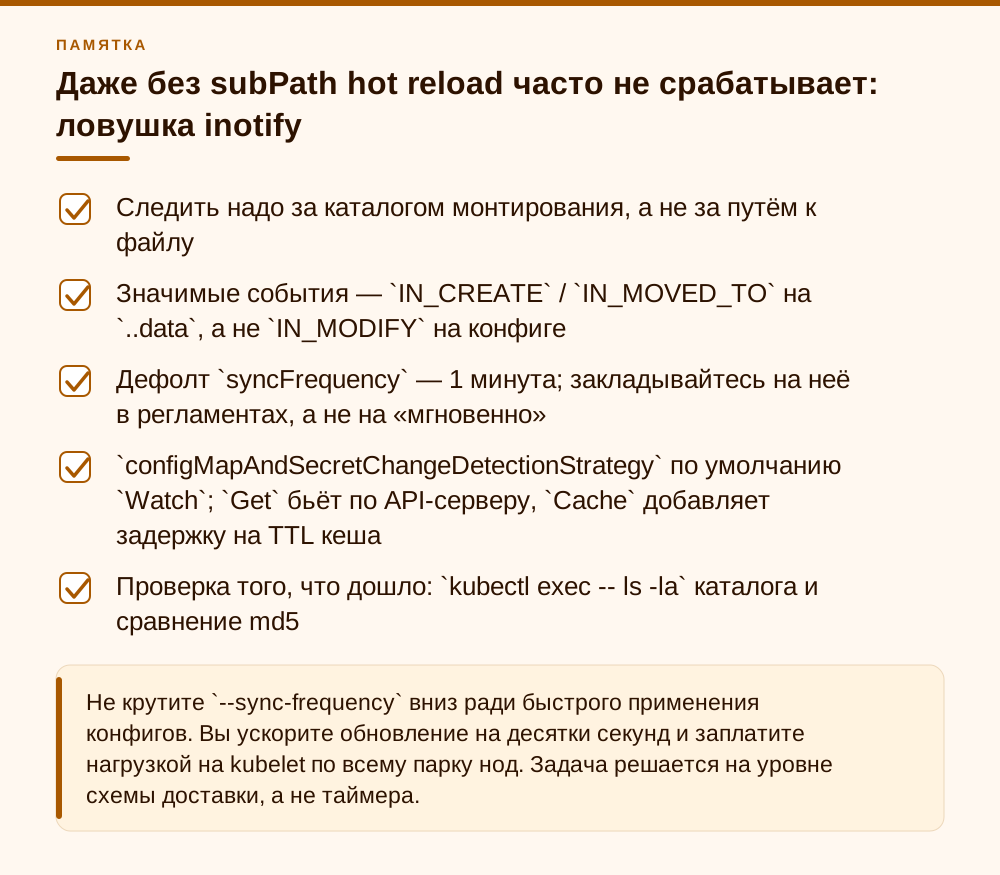
Клиент — магазин сумок «СумочныйРяд»: розничная точка, склад и интернет-магазин, 43 рабочих места. Мы сопровождаем у них офис, 1С и рабочие места, а сам интернет-магазин много лет назад заказали у веб-подрядчика, и он крутится у того в управляемом Kubernetes 1.37.0: три рабочие ноды, Argo CD, полтора десятка Deployment. Своего DevOps у магазина нет и не будет — при таком штате это нормально. Основной сервис — бэкенд каталога и корзины на Go, 6 реплик, HPA от 4 до 12. Конфиг — YAML-файл, приложение умеет перечитывать его по fsnotify, подрядчик этим гордится и прописал в README.
Директор пришёл к нам с формулировкой «после переезда базы часть заказов не оформляется, покупатели звонят, подрядчик говорит, что у них всё зелёное». За два дня до этого подрядчик переключил магазин на новую реплику PostgreSQL: поправили DB_HOST в ConfigMap app-config, Argo синхронизировался, дашборд зелёный. Ошибки начались не сразу, а часа через четыре — ровно когда вечерний пик заказов докинул реплик через HPA. С согласия директора подрядчик выдал нам доступ на чтение к namespace магазина, дальше работали вместе с их разработчиком.
Разбор занял двадцать минут. Первое: md5sum файла в поде и ключа в ConfigMap не совпали. Второе: ls -la /etc/app/ показал одинокий config.yaml без ..data — классический subPath. В манифесте было ровно то, чего я и ждал:
        volumeMounts:
        - name: cfg
          mountPath: /etc/app/config.yaml
          subPath: config.yaml
Причина, по которой так сделали, тоже типовая: в /etc/app/ уже лежал logging.yaml из образа, и монтирование тома целиком его затирало. subPath был выбран как «аккуратное» решение.
Третье и самое интересное: часть настроек дублировалась через envFrom. Прогон printenv DB_HOST по всем подам дал два разных значения — 6 старых реплик со старым хостом и 3 новые, поднятые HPA, с новым. Отсюда и «случайность»: старую реплику БД уже перевели в read-only, и падали ровно те запросы на оформление заказа, что попадали на старые поды и пытались писать. Каталог при этом открывался нормально — чтение-то работало. Доля неудачных оформлений гуляла вместе с работой автоскейлера — то около 40 %, то около 15 %.
Что сделал разработчик подрядчика по нашим рекомендациям. Убрали subPath: перенесли конфиг в отдельный каталог /etc/app/conf.d/, приложению передали путь флагом, logging.yaml из образа остался нетронутым. Перевели генерацию ConfigMap на configMapGenerator в Kustomize — он добавляет к имени хеш содержимого, поэтому любое изменение конфига меняет имя ресурса, а значит и спеку пода, и Argo сам делает честный rolling update. Из envFrom выкинули всё, что меняется в эксплуатации, оставив там только по-настоящему статичные вещи. Плюс поправили watcher в приложении, чтобы он слушал каталог, а не файл — иначе после ухода от subPath hot reload всё равно бы не завёлся.
Итог: изменение конфига стало доезжать до всех реплик за один rolling update — около 45 секунд на 6 реплик при maxUnavailable: 1, без 5xx благодаря нормальным readiness-пробам. Потерянные заказы ушли в тот же день. Неприятная деталь: почти двое суток магазин жил с расщеплённым конфигом, и узнали об этом по звонкам покупателей, потому что мониторинг подрядчика смотрел на агрегированный error rate, а не на разбивку по подам. Для небольшой компании вывод простой: если сайт у подрядчика в Kubernetes, в договоре должен быть доступ хотя бы на чтение и понятный регламент изменения конфигурации.
- Управляемый Kubernetes 1.37.0 у веб-подрядчика, Argo CD, 6 реплик бэкенда, HPA 4–12
- Первопричина №1: `subPath: config.yaml` — файл в поде не обновлялся вообще
- Первопричина №2: `envFrom` + HPA — два поколения настроек в одном Deployment
- Диагностика: `md5sum` + `ls -la` каталога + прогон `printenv` по всем подам
- Решение: отдельный каталог вместо subPath, `configMapGenerator` с хешем в имени, чистка `envFrom`
- Результат: раскатка за ~45 секунд, заказы оформляются в день разбора
Четыре рабочие схемы: что я ставлю вместо надежды на hot reload
Скажу сразу свою позицию, она не всем нравится. Я не считаю hot reload конфигов целью. Цель — чтобы изменение доезжало до ВСЕХ реплик детерминированно и наблюдаемо. Честный rolling restart это обеспечивает, а hot reload — только если приложение написано под него аккуратно и вы это проверяли. Поэтому по умолчанию я иду через перезапуск и включаю hot reload только там, где рестарт реально дорог: например, у приложения долгий прогрев кеша или тяжёлые долгоживущие соединения.
Схема первая, базовая: монтировать ConfigMap каталогом, без subPath. Если мешают файлы из образа — не воюйте с ними, а разведите пути. Если из ConfigMap нужны не все ключи, используйте items — это даёт выборочность без потери обновлений:
      volumes:
      - name: cfg
        configMap:
          name: app-config
          items:
          - key: config.yaml
            path: config.yaml
      containers:
      - name: api
        args: ["--config=/etc/app/conf.d/config.yaml"]
        volumeMounts:
        - name: cfg
          mountPath: /etc/app/conf.d
          readOnly: true
Схема вторая, для Kustomize и Argo CD — configMapGenerator. Он по умолчанию дописывает к имени ConfigMap хеш содержимого, ссылки в манифестах подменяются автоматически, и любое изменение данных превращается в изменение спеки пода. Дальше Kubernetes сам делает то, что умеет лучше всего, — rolling update. Это мой любимый вариант: никаких внешних контроллеров, никаких аннотаций руками.
# kustomization.yaml
configMapGenerator:
- name: app-config
  files:
  - config.yaml
generatorOptions:
  disableNameSuffixHash: false
Схема третья, для Helm — аннотация с контрольной суммой на шаблоне пода. Официальный приём из документации Helm, раздел Automatically Roll Deployments:
kind: Deployment
spec:
  template:
    metadata:
      annotations:
        checksum/config: {{ include (print $.Template.BasePath "/configmap.yaml") . | sha256sum }}
Меняется конфиг — меняется аннотация — меняется спека пода — идёт rollout. Работает и для Secret, и для случая с envFrom, что особенно ценно.
Схема четвёртая, когда манифесты трогать нельзя: контроллер Reloader от Stakater. Вешаете на Deployment аннотацию reloader.stakater.com/auto: "true", контроллер следит за связанными ConfigMap и Secret и сам дёргает rollout restart. Проект живой: на момент написания последние релизы — v1.4.22 и chart-v2.2.17 от 9 сентября 2026 года. Минус честный: это ещё один контроллер с правами на изменение ваших рабочих нагрузок в кластере, и его надо мониторить наравне с остальным. Если у вас нормальный GitOps — обходитесь схемами два и три.
И пятое, не схема, а гигиена: immutable: true на ConfigMap. Поле появилось в 1.19, стабильным стало в 1.21. У неизменяемого ConfigMap нельзя ни поменять data/binaryData, ни снять флаг обратно — только удалить и создать заново; документация отдельно рекомендует после этого пересоздать поды, потому что они держат точку монтирования удалённого объекта. На практике это означает дисциплину «новый конфиг — новое имя», что автоматически превращает изменение конфига в изменение спеки пода. Бонус — меньше нагрузки на kube-apiserver: watch'и для неизменяемых объектов закрываются. Отлично сочетается с генераторами имён по хешу.
- Каталог вместо subPath + `items` для выборочных ключей — база, с этого начинайте
- Kustomize `configMapGenerator` — хеш в имени, rollout из коробки, без внешних зависимостей
- Helm `checksum/config` — тот же эффект в helm-мире, лечит в том числе `envFrom`
- Stakater Reloader (аннотация `reloader.stakater.com/auto`) — когда манифесты править нельзя; помните про лишние права в кластере
- `immutable: true` — дисциплина «новый конфиг = новое имя» и меньше нагрузки на API-сервер
- Hot reload по inotify — только для приложений с дорогим стартом и только после проверки на стенде
Чек-лист: пять минут на диагностику и аудит всего кластера
Порядок действий, когда прилетело «конфиг не применился». Сначала подтверждаем, что ConfigMap в API действительно новый, — бывает, что Argo зелёный, а изменение вообще не в той ветке. Дальше сравниваем содержимое в контейнере, потом смотрим на ..data, потом на env. Четыре шага, никаких гаданий.
Полезно сразу прогнать аудит по всему кластеру и найти все места, где ConfigMap или Secret смонтированы через subPath. Один раз потратите десять минут, зато получите список мин, разложенных до вас:
kubectl get pods -A -o json | jq -r '
  .items[] as $p
  | (($p.spec.volumes // []) | map(select(.configMap or .secret) | .name)) as $cfg
  | $p.spec.containers[]
  | .volumeMounts[]?
  | select(.subPath or .subPathExpr)
  | select(.name as $n | $cfg | index($n))
  | "\($p.metadata.namespace)\t\($p.metadata.name)\t\(.mountPath)"
' | sort -u
Второй аудит — по переменным окружения. Ищем нагрузки, которые тянут ключи через envFrom или configMapKeyRef, и помечаем их как требующие обязательного rollout при изменении конфига:
kubectl get deploy -A -o json | jq -r '
  .items[]
  | select([.spec.template.spec.containers[]
      | (.envFrom // [])[] , ((.env // [])[] | .valueFrom // {})
      | select(.configMapRef or .configMapKeyRef)] | length > 0)
  | "\(.metadata.namespace)/\(.metadata.name)"'
Про приоритеты. В первую очередь чините связку envFrom + HPA — это то, что даёт разное поведение реплик и плавающие ошибки на проде. Во вторую — subPath на конфигах, которые реально меняются в эксплуатации. А вот subPath на файлах, которые не менялись с момента внедрения и меняться не будут (какой-нибудь timezone или статичный robots.txt), можно спокойно оставить в покое до ближайшего планового рефакторинга. Не всё, что технически неидеально, стоит трогать сегодня.
- Шаг 1: `kubectl get cm ... -o yaml` — убедиться, что в API действительно новые данные
- Шаг 2: сравнить `md5sum` ключа и файла в контейнере
- Шаг 3: `ls -la` каталога монтирования — есть ли `..data`
- Шаг 4: `printenv` по всем подам Deployment — нет ли расхождений между репликами
- Шаг 5: аудит subPath и `envFrom` по всему кластеру, приоритет — то, что меняется в эксплуатации
Частые вопросы
Можно ли как-то заставить subPath получать обновления ConfigMap?
Нет. Это архитектурное ограничение: subPath привязывает bind-mount к inode на момент старта контейнера, а kubelet обновляет том переключением симлинка ..data. Никакие флаги kubelet, аннотации или настройки тома это не меняют. Единственный способ обновить файл под subPath — пересоздать контейнер. Если файл меняется в эксплуатации, от subPath надо уходить.
Через сколько времени обновляется ConfigMap, смонтированный обычным томом?
Документация Kubernetes: суммарная задержка может достигать периода синхронизации kubelet плюс задержки распространения в его кеше. Дефолт syncFrequency — 1 минута, стратегия кеша по умолчанию — Watch, поэтому на практике это чаще секунды; на стратегии Cache добавляется TTL. В регламентах закладывайтесь на минуту с запасом, а факт применения проверяйте сравнением md5, а не по часам.
Почему приложение с fsnotify не видит изменения, хотя файл в поде обновился?
Потому что inotify следит за inode, а не за именем файла. Kubernetes не переписывает файл, он переставляет симлинк ..data на новый каталог с данными. События IN_MODIFY на пути к конфигу не будет никогда. Watcher должен слушать каталог монтирования и реагировать на IN_CREATE и IN_MOVED_TO. Это прямо рекомендовано в комментарии к AtomicWriter в исходниках Kubernetes.
Что делать с ключами, проброшенными через envFrom?
Считать их частью образа. Переменные окружения читаются один раз при создании контейнера и не обновляются никогда. После любого изменения ConfigMap нужен rollout: либо через хеш в имени (configMapGenerator в Kustomize), либо через аннотацию checksum/config в Helm, либо через Reloader. Особенно опасно сочетание envFrom и HPA — новые реплики поедут с новыми значениями, старые останутся со старыми.
Как быстро понять, что реплики работают с разными настройками?
Прогнать printenv по всем подам Deployment одной строкой в цикле и сравнить вывод с текущим значением в ConfigMap. Если значений больше одного — конфиг расщеплён. Симптом на проде обычно выглядит как ошибка, воспроизводящаяся «через раз» и не ловящаяся на стенде. На агрегированном графике error rate это почти не видно, нужна разбивка по подам.
Стоит ли ставить Reloader или лучше обойтись без него?
Если у вас Kustomize или Helm и вы контролируете манифесты — обойдитесь без него: хеш в имени ConfigMap или аннотация checksum/config решают задачу без лишнего контроллера. Reloader оправдан там, где манифесты править нельзя или их слишком много и разных. Помните, что это контроллер с правами на изменение рабочих нагрузок в кластере — его надо мониторить и обновлять как любой другой компонент периметра.
Интернет-магазин у подрядчика в Kubernetes — что нам, небольшой компании, стоит проверить?
Три вещи. Первое: есть ли у вас доступ хотя бы на чтение к namespace и к репозиторию манифестов, иначе любой разбор превращается в пересказ со слов подрядчика. Второе: как у них доставляются изменения конфигурации — хеш в имени ConfigMap, checksum-аннотация или Reloader, а не «поправили ConfigMap руками». Третье: смотрит ли мониторинг ошибки в разбивке по подам. Если на все три вопроса ответ «нет», проблема расщеплённого конфига — вопрос времени.
Источники
- Kubernetes Documentation — ConfigMaps — Concepts / Configuration / ConfigMaps: «A container using a ConfigMap as a subPath volume mount will not receive ConfigMap updates»; задержка = kubelet sync period + cache propagation delay (watch / TTL / ноль); Immutable ConfigMaps (v1.21 stable). https://kubernetes.io/docs/concepts/configuration/configmap/
- Kubernetes Documentation — Updating Configuration via a ConfigMap — Tutorials / Configuration: «The total delay from the moment when the ConfigMap is updated to the moment when new keys are projected to the Pod can be as long as kubelet sync period»; переменные окружения требуют замены подов. https://kubernetes.io/docs/tutorials/configuration/updating-configuration-via-a-configmap/
- Kubernetes Documentation — Volumes, using subPath — Concepts / Storage / Volumes: «A container using a ConfigMap as a subPath volume mount will not receive updates when the ConfigMap changes». https://kubernetes.io/docs/concepts/storage/volumes/
- Kubelet Configuration (v1beta1), исходники ветки release-1.37 — staging/src/k8s.io/kubelet/config/v1beta1/types.go: syncFrequency — Default: "1m«; configMapAndSecretChangeDetectionStrategy — значения Get / Cache / Watch, Default: »Watch". https://github.com/kubernetes/kubernetes/blob/master/staging/src/k8s.io/kubelet/config/v1beta1/types.go
- Kubernetes Documentation — Kubelet Configuration (v1beta1) — Reference / Config API: поля syncFrequency и configMapAndSecretChangeDetectionStrategy. https://kubernetes.io/docs/reference/config-api/kubelet-config.v1beta1/
- Kubernetes source — pkg/volume/util/atomic_writer.go — Комментарий к типу AtomicWriter: видимые файлы тома — симлинки, каталог данных переключается симлинком ..data, потребителям предлагается наблюдать за ..data через inotify/fanotify. https://github.com/kubernetes/kubernetes/blob/master/pkg/volume/util/atomic_writer.go
- Kubernetes CHANGELOG-1.37 (релиз 1.37.0 от 26.08.2026) — Правки kubelet по subPath: восстановление из повреждённых точек монтирования (#138856), устранение цикла ошибок после сбоев FUSE/GlusterFS (#139275). https://github.com/kubernetes/kubernetes/blob/master/CHANGELOG/CHANGELOG-1.37.md
- Helm Documentation — Chart Development Tips and Tricks — Раздел Automatically Roll Deployments: аннотация checksum/config со значением sha256sum шаблона ConfigMap. https://helm.sh/docs/howto/charts_tips_and_tricks/
- Stakater Reloader — Контроллер автоматического рестарта нагрузок при изменении ConfigMap/Secret, релизы v1.4.22 и chart-v2.2.17 от 09.09.2026. https://github.com/stakater/Reloader/releases