
Поставили тайм-аут 10 секунд на NFS automount, а приложение всё равно виснет при отказе NAS: разбор
Приложение зависает потому, что x-systemd.mount-timeout ограничивает только выполнение команды mount, а не операции чтения и записи на уже подключённой NFS. По умолчанию режим hard повторяет запросы бесконечно. Ниже: что именно ограничивает каждая опция, почему soft не лекарство и как я строю схему, где отказ NAS не кладёт приложение.
Что на самом деле ограничивает x-systemd.mount-timeout=10s
Ко мне эта история приходит регулярно: сисадмин читает про зависания при падении NAS, находит в fstab волшебную опцию с «timeout» в названии, ставит десять секунд, перезагружает сервер и считает вопрос закрытым. Через месяц NAS снова уходит в перезагрузку, а приложение снова стоит колом. Опцию не обманули, она работает ровно так, как написано в документации, просто решает другую задачу. Если у вас такая картина и разбираться некогда, IT-аутсорсинг для офиса и малого бизнеса как раз для этого и существует, но принцип понять полезно в любом случае.
Смотрим в документацию systemd.mount. Опция x-systemd.mount-timeout задаёт, сколько systemd ждёт завершения команды mount, прежде чем сдаться. Там же сказано, что за подробностями надо смотреть параметр TimeoutSec= для mount-юнитов: если команда не уложилась во время, монтирование считается неудавшимся и юнит останавливается. Значение по умолчанию берётся из DefaultTimeoutStartSec= в systemd-system.conf, а там по документации 90 секунд. Итого опция отвечает на вопрос «сколько ждать, пока шара подключится». Она ничего не говорит о том, что делать с процессом, который уже работает с файлами на подключённой шаре.
Вторая половина механизма это x-systemd.automount. Опция создаёт automount-юнит для файловой системы, и реальное монтирование происходит при первом обращении к точке монтирования. Это удобно: сервер загружается быстро, даже если NAS ещё не поднялся, а шара подключается тогда, когда она кому-то понадобилась. Но у automount есть свой нюанс. Он решает проблему момента подключения и бездействия, а не проблему «шара пропала в середине работы».
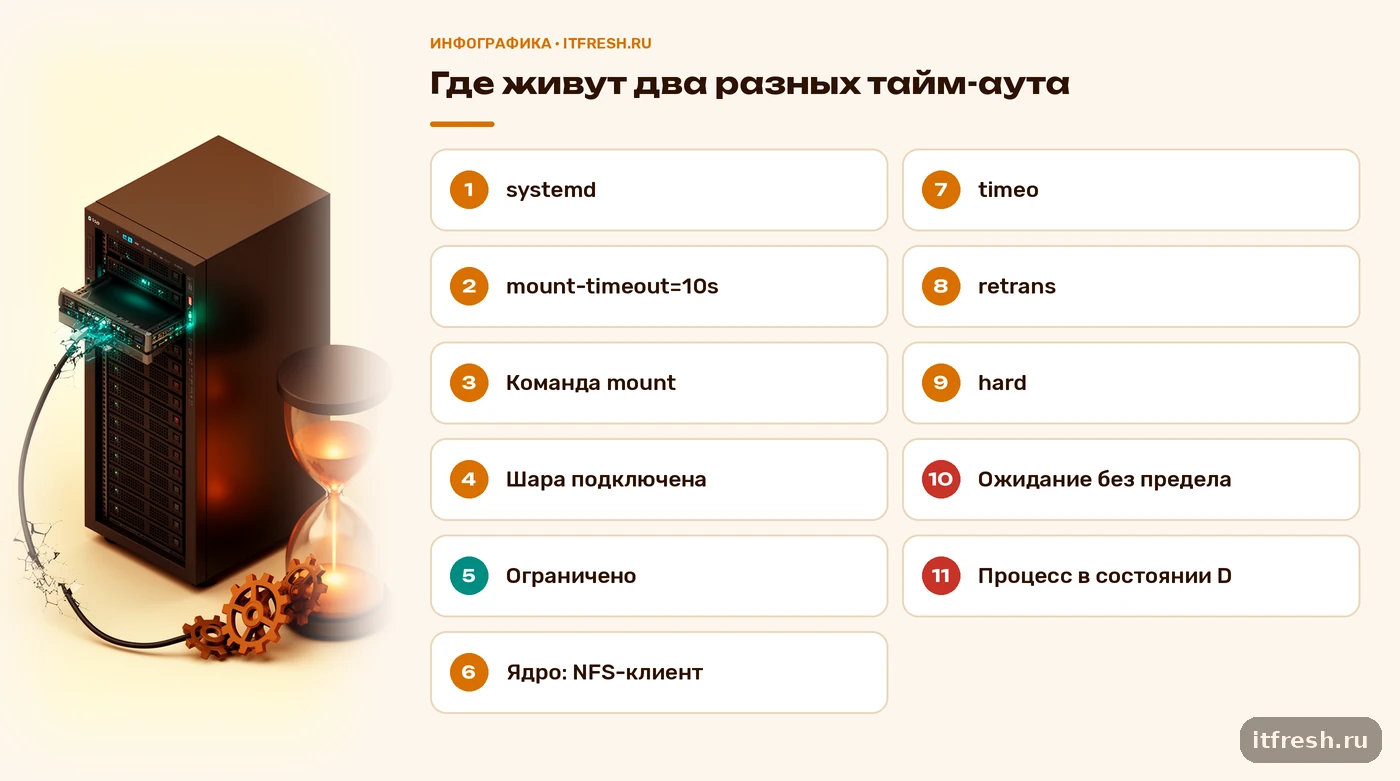
Сформулирую как правило, которое я повторяю на каждом аудите. Тайм-аут монтирования и тайм-аут файловых операций это два разных мира. Первый живёт в systemd и контролируется fstab-опциями. Второй живёт в NFS-клиенте ядра и контролируется опциями hard, soft, timeo и retrans. Путать их и означает «ставить 10 секунд и удивляться».
Почему приложение висит после отказа NAS: режим hard и бесконечные повторы
Откроем nfs(5). Если не указано ничего или указан hard, NFS-запросы повторяются бесконечно. Это сделано сознательно: сетевая файловая система по умолчанию ведёт себя как локальный диск, который «просто медленный». Операция записи не должна вернуть успех, если данные не дошли, и не должна вернуть ошибку, если сервер просто перезагружается и через минуту вернётся. Для базы данных, бухгалтерии или виртуальных машин это правильное поведение.
Цена этого выбора в том, что процесс, который сделал вызов к недоступной шаре, застревает в ядре. Обычно в списке процессов он виден в состоянии D, то есть непрерываемого ожидания. Приложение при этом не «упало» и ничего не залогировало, оно просто ждёт. Ждёт и его поток, и все остальные потоки, которые пошли в ту же шару. Если это веб-приложение с пулом воркеров, пул вычерпывается за минуты: каждый новый запрос, который тронул файл на NFS, занимает ещё один воркер навсегда. Через какое-то время не отвечает уже страница, не имеющая отношения к файлам, потому что свободных воркеров не осталось.
Когда NFS-клиент долго не получает ответа, он по документации пишет сообщение «server not responding» и продолжает повторять запрос, если действует hard. Подробнее про механику: timeo это время в десятых долях секунды, которое клиент ждёт ответа перед повтором. Для TCP по умолчанию 600, то есть 60 секунд, и после каждой повторной отправки тайм-аут увеличивается на значение timeo, максимум до 600 секунд. Опция retrans определяет, сколько повторов клиент делает до сообщения «server not responding»: по умолчанию два для TCP и три для UDP. Заметьте главное: при hard после этого ничего не заканчивается, запросы идут дальше.
Есть ещё один момент, который путает людей. У команды mount для NFS есть собственная опция retry, и она относится именно к попытке монтирования. По документации по умолчанию это 2 минуты для монтирования на переднем плане и 10000 минут для фонового. То есть в цепочке сразу два ограничителя монтирования, systemd и сама mount.nfs, а вот ограничителя для работы уже подключённой шары нет вообще, пока вы не выберете его сами.
- mount-timeout: сколько systemd ждёт завершения команды mount, действует только на момент подключения;
- retry (опция mount.nfs): как долго команда mount пытается подключить шару, по умолчанию 2 минуты на переднем плане;
- timeo и retrans: через сколько клиент повторяет запрос и сколько повторов делает до сообщения «server not responding»;
- hard или soft: что происходит после исчерпания повторов, бесконечные повторы или ошибка приложению.
Можно ли просто переключиться на soft или softerr
Это первое, что приходит в голову после прочтения документации, и именно здесь я чаще всего вижу самолечение. По nfs(5) опции soft и softerr прекращают попытки после retrans повторов. Разница в том, какую ошибку получит приложение: при soft это EIO, при softerr это ETIMEDOUT. Какая из ошибок удобнее, зависит от приложения, но ради этого переключение обычно и делают: «пусть оно уже вернёт ошибку, а не висит».
Документация при этом прямо предупреждает, что так называемый soft-тайм-аут в ряде случаев может привести к скрытому повреждению данных, и советует применять soft или softerr, только если отзывчивость клиента важнее целостности данных. Как это происходит на практике. Приложение записало файл, клиент отправил запрос, сервер был занят или недоступен, запрос получил ошибку, а приложение либо не проверило код возврата, либо проверило и всё равно продолжило работу. В итоге в каталоге лежит обрезанный документ, а в базе данных запись о том, что он сохранён. Заметить это можно через неделю, а восстановить уже нечем. Документация упоминает, что риск можно снизить использованием TCP и увеличением retrans, но не устранить.
Моё правило простое. Для данных, которые нельзя терять, hard остаётся. Для шар, где лежит заведомо перестраиваемое содержимое, например кэш, дистрибутивы, медиатека только на чтение, мониторить доступность можно через soft или softerr. Но и там сначала надо понять, как приложение реагирует на ошибку ввода-вывода: если оно на неё падает целиком, вы просто заменили вечное зависание на аварийное завершение. Чуть лучше, но не решение. Про то, как выбирать между сетевым хранилищем и сервером под файловую роль, я писал отдельно: NAS или файловый сервер, и там как раз видно, чем отличаются сценарии, где шара критична, и где нет.
Как правильно настроить fstab для NFS с automount
Начну с того, что fstab остаётся нужным, просто от него не надо ждать лишнего. Хорошая конфигурация для шары, без которой сервер должен загружаться и работать, выглядит так. Поля в строке стандартные: источник, точка монтирования, тип файловой системы, опции, затем dump и порядок fsck, последние два для NFS нули.
# /etc/fstab
192.0.2.20:/volume1/archive  /mnt/archive  nfs4  _netdev,nofail,x-systemd.automount,x-systemd.mount-timeout=10s,x-systemd.idle-timeout=10min,hard  0  0
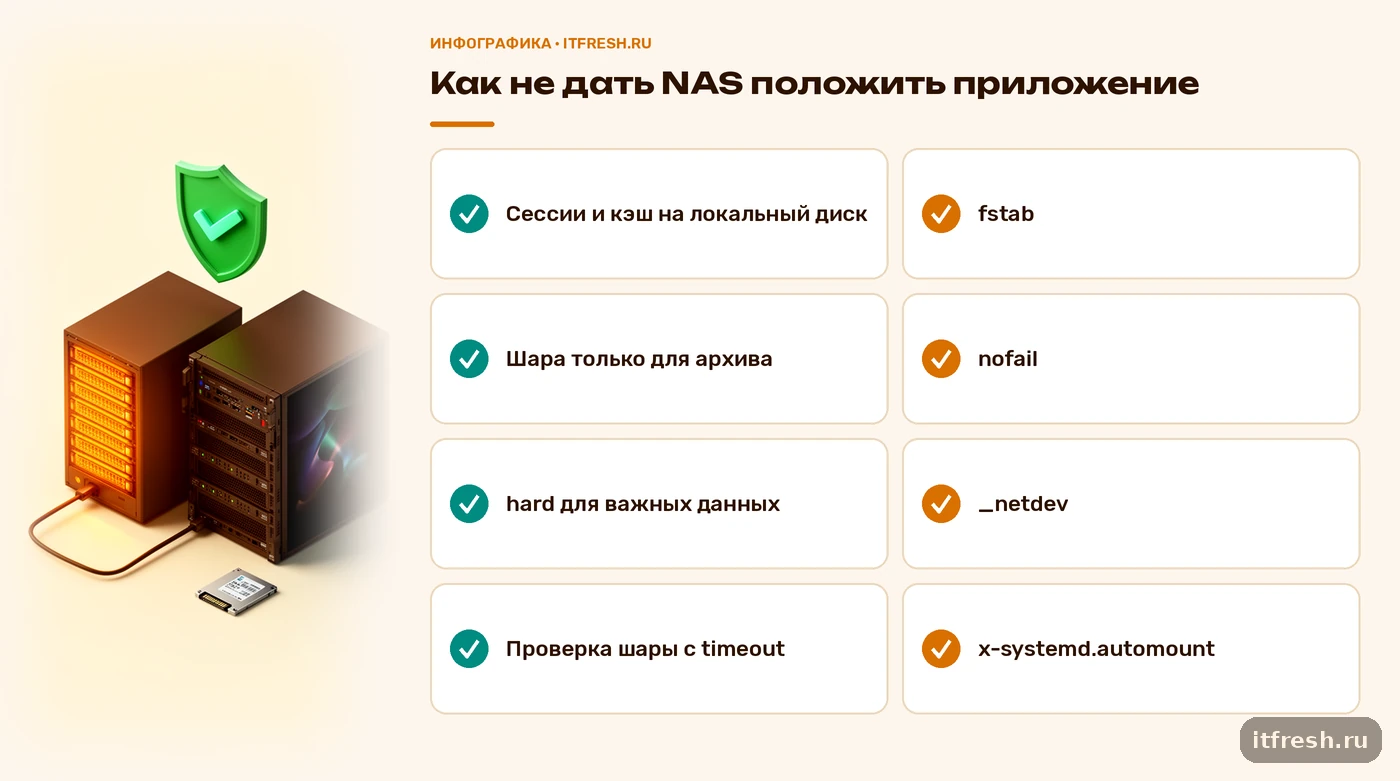
Что тут к чему. Опция _netdev по документации systemd.mount помечает монтирование как сетевое и переопределяет автоматическое определение. Опция nofail означает, что монтирование желательно, но не обязательно для remote-fs.target, и загрузка не будет его ждать. Связка x-systemd.automount с x-systemd.idle-timeout даёт подключение по требованию и отключение после простоя: в automount-юните за это отвечает TimeoutIdleSec, по умолчанию простой не отслеживается, поэтому без idle-timeout шара, однажды подключённая, остаётся подключённой. Опцию hard я пишу явно, хотя это значение по умолчанию: через год кто-то откроет файл и сразу поймёт, что выбор сделан осознанно.
После правки fstab systemd нужно сообщить об этом, иначе юниты останутся прежними. Имя юнита получается из пути точки монтирования, слэши заменяются на дефисы, для /mnt/archive это mnt-archive.mount и mnt-archive.automount. Если путь сложный, имя можно получить командой systemd-escape.
systemctl daemon-reload
systemctl restart mnt-archive.automount
systemctl status mnt-archive.automount mnt-archive.mount
systemd-escape -p --suffix=mount /mnt/archive
findmnt -t nfs4
nfsstat -m
Команда nfsstat -m показывает реальные параметры монтирования, с которыми работает клиент, включая значения timeo и retrans. Я всегда сверяю их с тем, что написал в fstab: иногда сервер согласовывает не то, что вы ожидали, а правда лежит именно там. Если шара должна быть с ограничением на ожидание, а не бесконечной, это отдельное решение, которое мы обсудим ниже. Если нужны более быстрые сообщения о недоступности, можно уменьшить timeo и подобрать retrans, но помните: при hard это изменит только момент, когда клиент начнёт писать «server not responding», процесс всё равно будет ждать.
Что делать, чтобы отказ NAS не клал приложение
Главный вывод из практики: проблему надо решать на уровне архитектуры приложения, а не через подбор опций. Если критичный путь запроса проходит через NFS, любой отказ NAS остановит приложение, как бы вы ни настроили клиента. Поэтому первым делом я выношу с шары всё, что приложению нужно мгновенно: сессии, кэш, временные файлы, очереди, логи, сокеты. Всё это живёт на локальном диске. На NFS остаётся то, что можно подождать или показать пользователю как «недоступно».
Второе: у приложения должен быть свой тайм-аут на обращение к хранилищу. Для веб-приложений это означает, что файловые операции с шарой выносятся в отдельный пул или фоновую задачу, а пользовательский запрос не ждёт их без ограничения. Обработчик ограничивается по времени на уровне веб-сервера и менеджера процессов, поэтому застрявший воркер в итоге получает сигнал. Но предупреждаю: процесс, застрявший в ожидании NFS, не реагирует на обычный SIGTERM, который шлют менеджеры процессов при мягкой остановке. Опция intr, которая когда-то делала такие ожидания прерываемыми, по nfs(5) игнорируется начиная с ядра 2.6.25; в современных ядрах ожидание NFS снимается только SIGKILL. Поэтому в юните службы и в менеджере воркеров должна быть настроена жёсткая остановка по тайм-ауту, иначе перезапуск сам повиснет, как это и случилось в разборе ниже.
Третье: мониторинг. Если шара пропала, вы должны узнать об этом раньше пользователей. Проверка доступности должна сама иметь ограничение по времени, иначе сам агент мониторинга встанет в очередь зависших процессов. Минимальный вариант: запускать проверку через timeout с запасом на принудительное завершение.
timeout -k 2 10 stat -t /mnt/archive >/dev/null 2>&1 && echo ok || echo fail
ps -eo pid,stat,wchan:32,cmd | awk '$2 ~ /^D/'
Если мониторинг построен на Zabbix, зависимость триггеров друг от друга стоит продумать заранее, чтобы при отказе NAS не прилетела лавина сообщений: я разбирал это в статье про зависимости триггеров в Zabbix 7.4. Сам триггер я делаю простым: элемент данных со скриптом выше, срабатывание после двух подряд значений fail, а зависимые проверки приложения подчинены ему.
Отдельно про сам NAS. Мониторинг подскажет, что шара пропала, но не вернёт данные, если хранилище умрёт насовсем. Для случая, когда разовый отказ хранилища нельзя допустить вообще, подумайте о резервной копии вне площадки: сравнение подходов есть в материале про облачный бэкап и NAS в офисе.
Разбор: спортивный клуб, 34 рабочих места, шара с фото и договорами
Условный клиент, спортивный клуб «Спортивный причал», 34 рабочих места. Приложение ресепшена на Linux-сервере: карточки клиентов, абонементы, фото для пропусков и сканы договоров. Файлы лежали на NAS с экспортом по NFS, в fstab стояла строка с x-systemd.automount и x-systemd.mount-timeout=10s. Администратор клуба поставил эту опцию после прошлого инцидента, когда сервер не загружался без NAS.
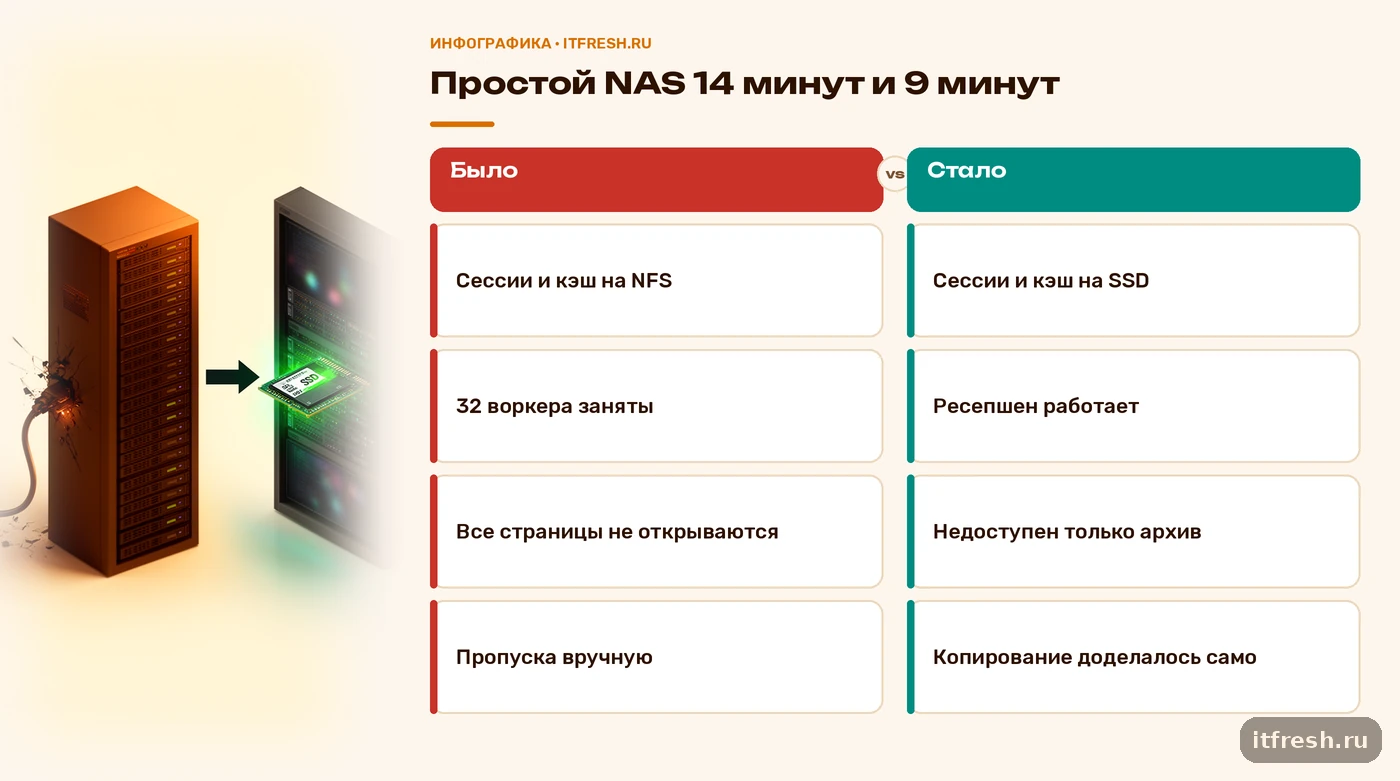
Во время планового обновления прошивки NAS не отвечал около четырнадцати минут. Сервер приложения не упал, но через три-четыре минуты перестали открываться все страницы, не только карточки с фото. Лимит воркеров был 32, и каждый запрос, который тронул каталог с фотографиями, занимал воркера навсегда. Сессии и кэш тоже лежали на той же шаре: это был главный источник проблемы. Администратор перезапускал службу веб-сервера, но она сама зависала на корректном завершении. Пропуска на входе пришлось оформлять вручную.
Что мы сделали за два дня. Сессии, кэш и временные файлы перенесли на локальный SSD сервера. Шару оставили для архива фото и сканов, режим hard сохранили, потому что договоры терять нельзя. В fstab добавили nofail, _netdev и x-systemd.idle-timeout=10min. Фоновые операции с шарой вынесли из пользовательского запроса: фото сначала пишется локально и копируется на NAS отдельной задачей. Проверку доступности шары добавили в мониторинг с собственным ограничением по времени.
Результат при следующем обслуживании NAS, которое длилось девять минут: ресепшен работал, карточки клиентов и абонементы открывались, не открывались только архивные фото и сканы, и пользователь видел понятное сообщение вместо белой страницы. Задачи копирования накопились в очереди и после возвращения NAS отработали сами. Общая стоимость работ для клуба вышла в два дня моего времени, без покупки оборудования.
Диагностика: как понять, что вы упёрлись именно в NFS
Когда звонят с жалобой «всё висит», я не гадаю, а иду по короткому чек-листу. Сначала смотрю, есть ли вообще зависшие процессы: список с состоянием D, у которых в wchan видна функция NFS-клиента. Затем проверяю статус юнитов mount и automount и журнал. Если сообщения «server not responding» уже есть, это почти диагноз. Затем иду на сторону NAS и смотрю, жива ли служба NFS и доступен ли сервер по сети.
systemctl status mnt-archive.mount mnt-archive.automount
journalctl -u mnt-archive.mount -u mnt-archive.automount --since '1 hour ago'
dmesg | grep -i nfs
nfsstat -m
Если шара уже зависла и процессы не освобождаются, у umount есть два рычага. Опция -f по документации предназначена для принудительного отключения в случае недоступного NFS-сервера, но та же страница предупреждает, что это не гарантирует отсутствия зависания самого umount. Опция -l отключает файловую систему от иерархии немедленно, а очистку ссылок откладывает до момента, когда она перестанет быть занятой. Для сетевых файловых систем документация советует после -l быть готовым к скорой перезагрузке. Я использую -l как аварийную меру, чтобы освободить точку монтирования и вернуть сервису жизнь, а потом планирую нормальный перезапуск.
И последнее, о чём редко вспоминают: после возврата NAS клиент продолжит работать сам, потому что hard означает повторы, а не отказ. Не надо в панике перезагружать сервер, пока NAS перезагружается: запросы дождутся, а процессы продолжат работу. Это та сторона hard, ради которой его и выбирают по умолчанию, и её стоит учитывать при планировании окон обслуживания хранилища.
Частые вопросы
Ограничивает ли x-systemd.mount-timeout зависание уже подключённой NFS?
Нет. Опция задаёт, сколько systemd ждёт завершения команды mount. На файловые операции после подключения она не влияет, там действуют hard или soft, timeo и retrans.
Что делает hard по умолчанию, если NFS-сервер недоступен?
По nfs(5) при hard NFS-запросы повторяются бесконечно. Клиент сообщает «server not responding» после retrans повторов, но продолжает ждать ответа.
Чем soft отличается от softerr?
После исчерпания повторов soft возвращает приложению ошибку EIO, а softerr возвращает ETIMEDOUT. Документация предупреждает о риске скрытого повреждения данных при обоих вариантах.
Стоит ли ставить soft, чтобы приложение не висело?
Для данных, которые нельзя потерять, нет: документация советует soft и softerr, только если отзывчивость важнее целостности. Надёжнее вынести критичное с шары и поставить тайм-ауты в приложении.
Как проверить, с какими параметрами реально подключена шара?
Командой nfsstat -m или findmnt -t nfs4. Сверьте вывод с тем, что написано в fstab, особенно timeo и retrans.
Источники
- systemd.mount(5) — Проверено: x-systemd.automount, x-systemd.mount-timeout, x-systemd.idle-timeout, nofail, _netdev, TimeoutSec= для mount-юнитов. https://man7.org/linux/man-pages/man5/systemd.mount.5.html
- systemd.automount(5) — Проверено: TimeoutIdleSec= (по умолчанию отключён), правило именования automount-юнитов по пути. https://man7.org/linux/man-pages/man5/systemd.automount.5.html
- nfs(5) — Проверено: hard, soft, softerr, timeo, retrans, retry, предупреждение о скрытом повреждении данных при soft. https://man7.org/linux/man-pages/man5/nfs.5.html
- systemd-system.conf(5) — Проверено: DefaultTimeoutStartSec= по умолчанию 90 секунд. https://man7.org/linux/man-pages/man5/systemd-system.conf.5.html
- umount(8) — Проверено: опции -f и -l для недоступных сетевых файловых систем и их ограничения. https://man7.org/linux/man-pages/man8/umount.8.html