
Добавили памяти виртуалке — она перестала включаться: сколько места на datastore съедает .vswp
Если виртуалка перестала включаться сразу после добавления памяти, почти наверняка ей не хватило места под файл подкачки .vswp: ESX создаёт его при включении размером «память минус резервирование». Ниже — как это посчитать заранее, где держать свопы и почему резервирование памяти лечит одно, но ломает другое.
Почему ВМ не включается после добавления памяти
Сценарий повторяется у меня из года в год почти дословно, и в рамках ИТ-аутсорсинга для небольших компаний я разбираю его чаще, чем хотелось бы. Плановое окно, сервер 1С тормозит, бизнес просит «дайте памяти». Админ выключает ВМ, в Edit Settings меняет 24 ГБ на 64 ГБ, жмёт OK — и машина обратно не поднимается. vCenter отдаёт что-то из семейства «Insufficient disk space on datastore», в vmware.log виртуалки лежит честное «No space left on device». Дальше начинается тупик: человек смотрит на VMDK — 300 ГБ, как и был; снапшотов нет; внутри гостя ничего не распухло. Связь между «добавил RAM» и «кончилось место на диске» в голове не выстраивается, потому что интуитивно память и дисковое пространство — разные ресурсы.
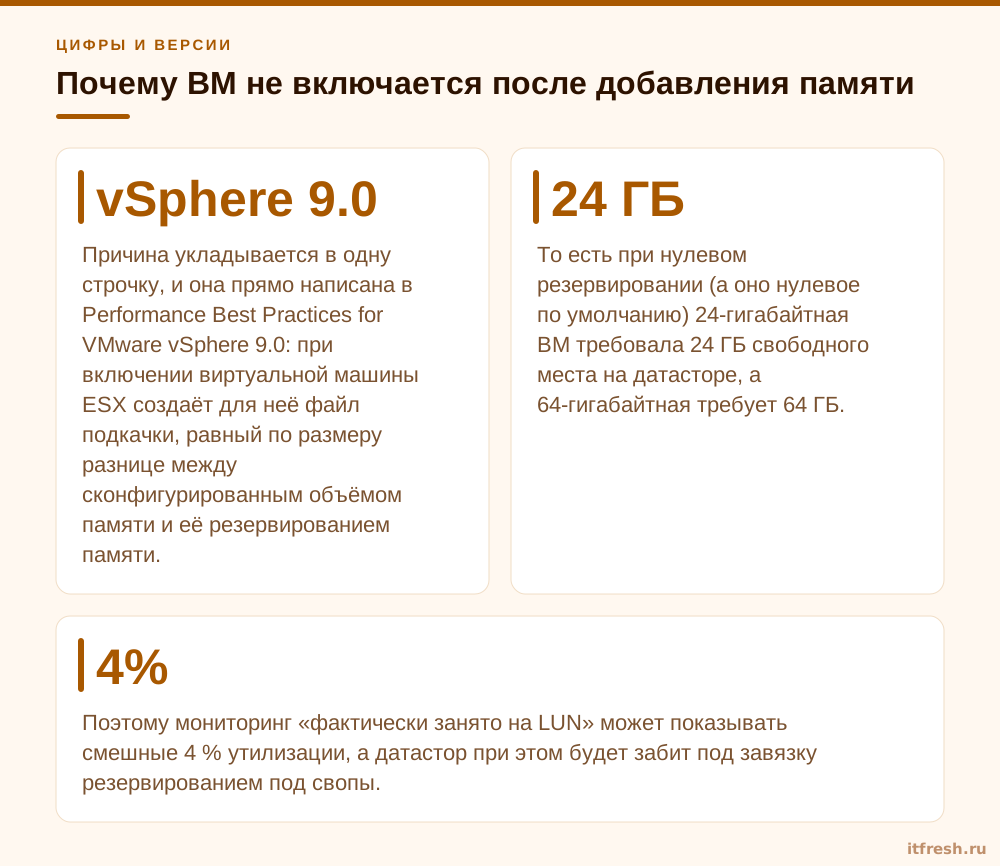
Причина укладывается в одну строчку, и она прямо написана в Performance Best Practices for VMware vSphere 9.0: при включении виртуальной машины ESX создаёт для неё файл подкачки, равный по размеру разнице между сконфигурированным объёмом памяти и её резервированием памяти. Доступного места на диске должно быть как минимум столько же — плюс место под VMX swap. То есть при нулевом резервировании (а оно нулевое по умолчанию) 24-гигабайтная ВМ требовала 24 ГБ свободного места на датасторе, а 64-гигабайтная требует 64 ГБ. Вы не трогали диск — вы подняли требование к свободному месту на 40 ГБ. А если файл создать не удалось, документация vSphere формулирует итог коротко: виртуальная машина не включится.
Отдельно объясню, почему днём всё работало, а вечером сломалось. Пока ВМ включена, её .vswp существует и место держит. Как только вы выключили машину на обслуживание, файл удалился и 24 ГБ вернулись в общий котёл — где их немедленно разобрали соседние ВМ, растущие тонкие диски и бэкапные снапшоты. Обратно вы просите уже не 24, а 64 ГБ, и их там нет. Отсюда фирменный вывод «до перезагрузки же работало», который уводит расследование совсем не туда.
Ещё одна ловушка — ESX создаёт своп-файл целиком, а не по мере использования. Внутри он почти всегда пустой: реальная запись в него идёт только при host-level swapping, то есть когда хосту уже плохо с памятью. Поэтому мониторинг «фактически занято на LUN» может показывать смешные 4 % утилизации, а датастор при этом будет забит под завязку резервированием под свопы. Не путайте эти две метрики, иначе будете долго спорить с СХД. Похожая путаница бывает и в Linux, когда на ext4 свободны гигабайты, а файл не создаётся: метрика «сколько записано» и метрика «сколько можно выделить» живут отдельно.
- ВМ не включается сразу после изменения объёма памяти, при этом VMDK не менялся
- Ошибка в духе «Insufficient disk space on datastore» или «No space left on device» в vmware.log
- Свободное место на datastore меньше, чем новый объём RAM машины
- Датастор «занят», но реально записанных данных на нём заметно меньше
- Соседние выключенные ВМ на том же датасторе тоже перестают включаться — эффект домино
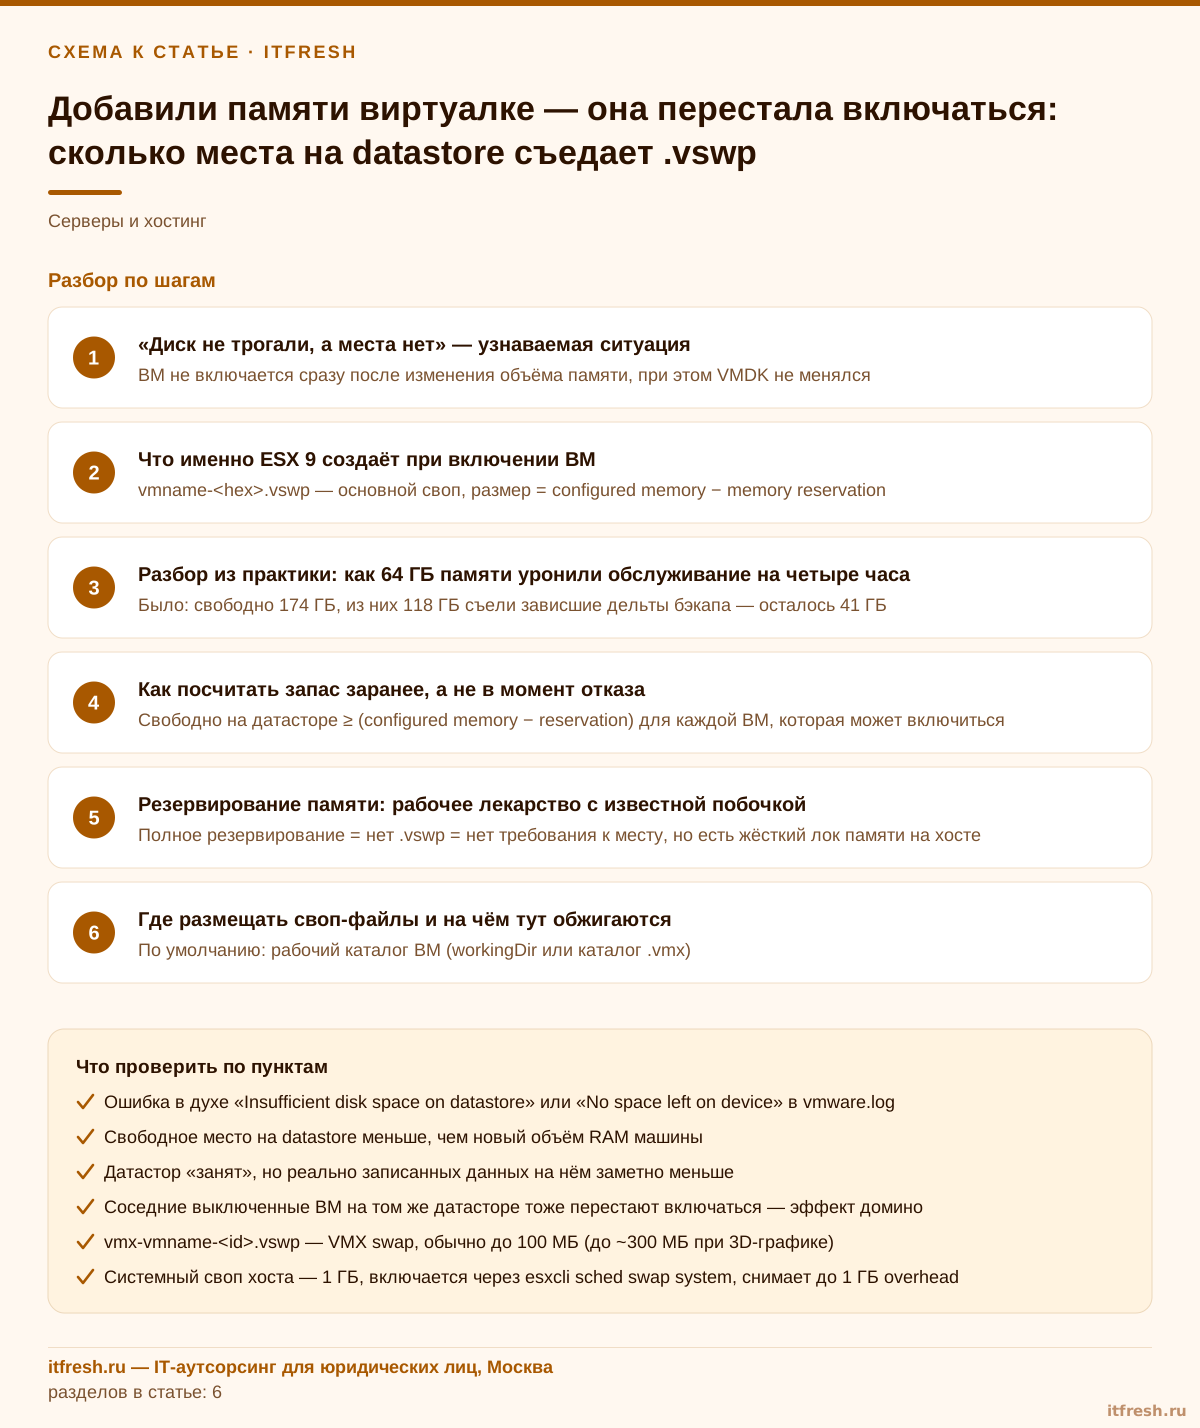
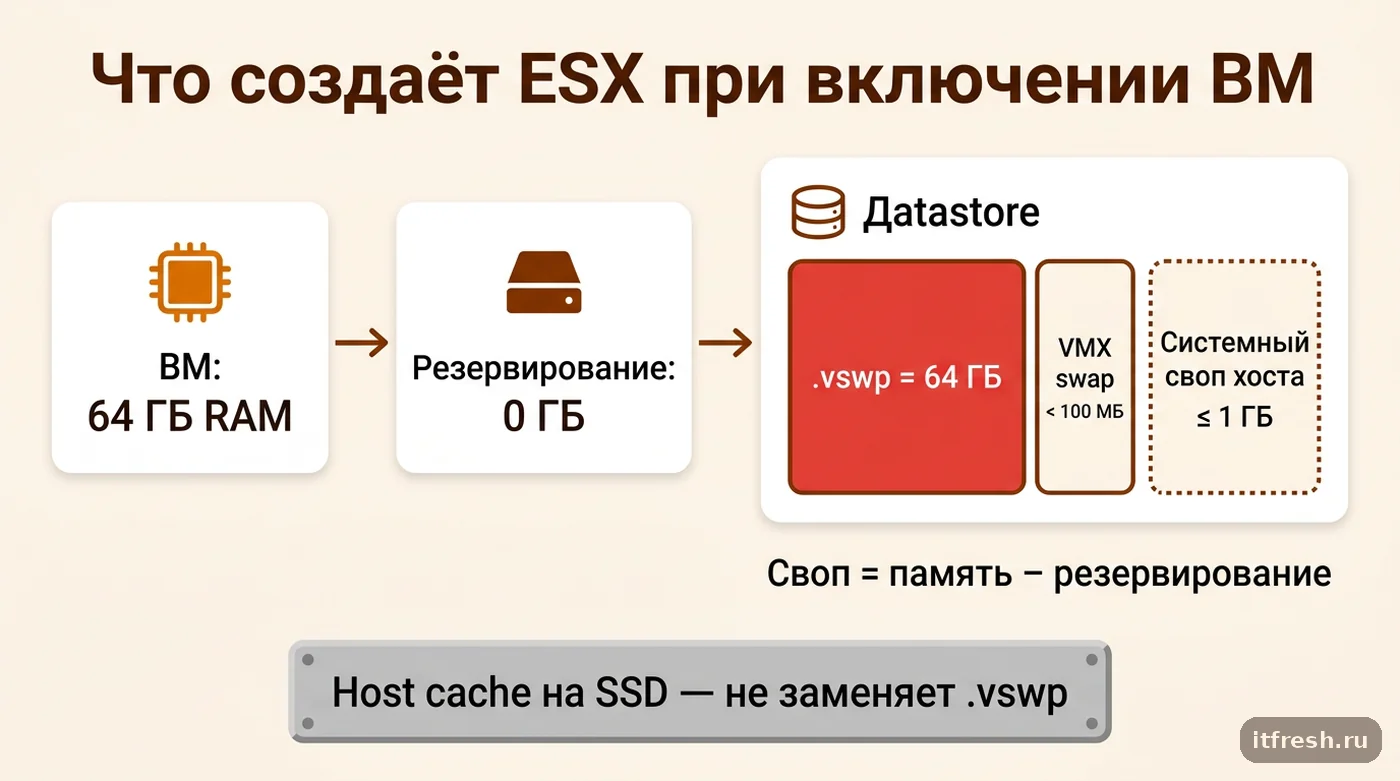
Какие своп-файлы ESX 9 создаёт при включении ВМ
Файлов подкачки на самом деле несколько, и путать их не надо. Первый — основной .vswp, он же «тот самый». Имя вида vmname-abcd1234.vswp, размер строго равен configured memory минус memory reservation. Резервирование 0 — файл размером во всю память ВМ. Резервирование равно всей памяти — файл не создаётся вовсе. Всё, что между, даёт файл пропорционального размера: у 64-гигабайтной машины с резервированием 32 ГБ своп будет 32 ГБ.
Второй файл — VMX swap, он выглядит как vmx-vmname-<id>.vswp и обслуживает служебную память процесса VMX (стеки потоков, код, куча — то, что нужно, чтобы поднять и обслуживать гостя). Документация по производительности vSphere говорит, что объём требуемого места варьируется, но даже для крупной ВМ обычно составляет менее 100 МБ, и менее 300 МБ, если у ВМ включена 3D-графика. Создаётся он автоматически при включении, по умолчанию — в каталоге ВМ; перенести можно параметром sched.swap.vmxSwapDir, а полностью отключить — sched.swap.vmxSwapEnabled = FALSE. Отключать я не советую: документация прямо предупреждает, что цена — существенный рост резервирования overhead-памяти хоста. Экономия в сотню мегабайт того не стоит.
Третий файл к конкретной ВМ отношения не имеет — это системный своп самого хоста, который позволяет вытеснить до 1 ГБ системной памяти гипервизора под давлением. Он настраивается отдельно через esxcli sched swap system (или в vSphere Client: хост → Configure → System Swap), и для него можно указать датастор или host cache. Ключи ниже полные — короткие варианты тоже есть, но в скриптах я пишу длинные, так читаемее:
# системный своп хоста на выбранном датасторе
esxcli sched swap system set --datastore-enabled true --datastore-name DS_INFRA_01
esxcli sched swap system get

# что реально лежит в каталоге ВМ
ls -lh /vmfs/volumes/DS_1C_01/SRV-1C/*.vswp
# SRV-1C-1f3a9c02.vswp            64.0G
# vmx-SRV-1C-2839471263-1.vswp    89.0M
И отдельно проговорю пункт, на котором спотыкаются чаще всего: SSD host cache (swap to host cache) не отменяет создание обычных своп-файлов. Формулировка в Performance Best Practices недвусмысленная — даже если перегруженный по памяти хост использует swap to host cache, ему всё равно нужно создавать обычные своп-файлы. Host cache лишь делает менее важной скорость хранилища, на котором эти файлы лежат. Это ускорение, а не замена. Я несколько раз видел, как админ включал host cache на локальном NVMe и искренне ждал, что .vswp на общем LUN исчезнут.
- vmname-<hex>.vswp — основной своп, размер = configured memory − memory reservation
- vmx-vmname-<id>.vswp — VMX swap, обычно менее 100 МБ (менее 300 МБ при 3D-графике)
- Системный своп хоста — до 1 ГБ, настраивается через esxcli sched swap system
- Swap to host cache на SSD — ускорение host-level swapping, но не отмена .vswp
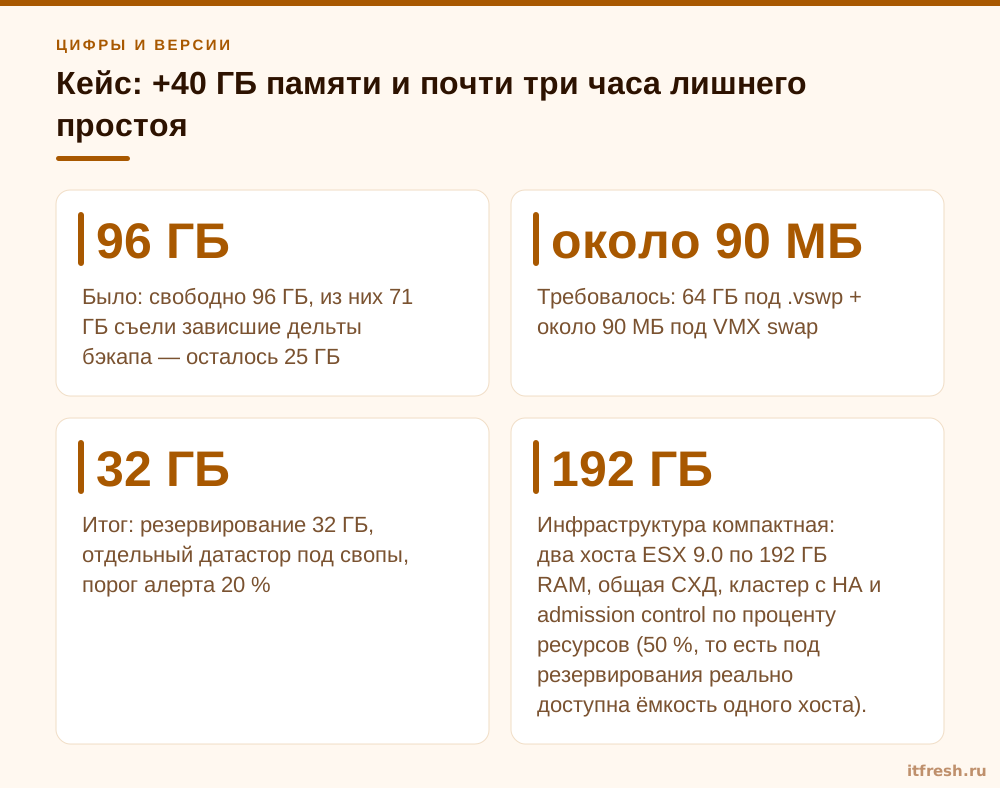
Кейс: +40 ГБ памяти и почти три часа лишнего простоя
Условный клиент — сумочное производство «СумкаПром», 48 рабочих мест: офис, раскройный цех и склад. Инфраструктура компактная: два хоста ESX 9.0 по 192 ГБ RAM, общая СХД, кластер с HA и admission control по проценту ресурсов (50 %, то есть под резервирования реально доступна ёмкость одного хоста). Под продуктивный контур — VMFS-датастор DS_1C_01 на 2 ТБ: сервер 1С (24 ГБ RAM, диск 300 ГБ), SQL Server (64 ГБ, полное резервирование, диски 900 ГБ), терминальный сервер на 30 пользователей (64 ГБ, тоже с полным резервированием) и три служебные ВМ. Свободного места перед работами — 96 ГБ, по внутреннему регламенту «примерно ок».
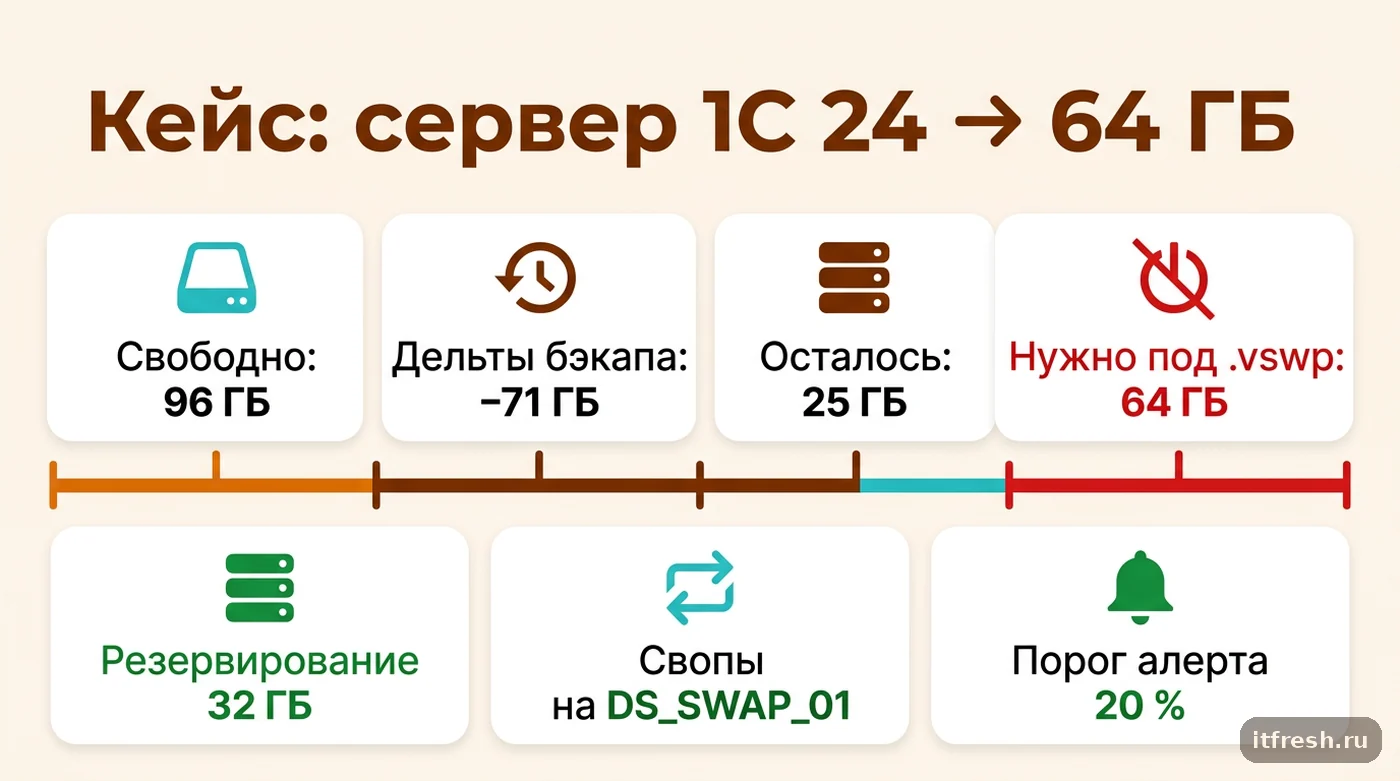
В субботнее окно делали две вещи сразу: обновляли конфигурацию 1С и увеличивали память серверу 1С с 24 до 64 ГБ. Обновление прошло, ВМ выключили, поменяли память, нажали Power On — отказ. Сорок минут ушло на проверку «а не сломался ли VMDK»: смотрели vmkfstools, целостность каталога, консистентность дисков. Диски были в порядке. Считать надо было не диски, а арифметику: своп теперь требовал 64 ГБ вместо 24, а свободных к моменту включения оставалось 25 ГБ. За неделю до этого агент резервного копирования оставил на датасторе два зависших дельта-файла снапшотов на 71 ГБ, и никто их не заметил: алерт стоял на пороге 10 %.
Первое лечение было быстрым и, как это часто бывает, породило вторую проблему. Админ выставил серверу 1С резервирование на все 64 ГБ (Reserve all guest memory). Своп-файл не создаётся, ВМ включилась. А через час, когда после обновления перезагружали терминальный сервер, он включаться отказался: HA admission control посчитал, что резервирования SQL, 1С и терминала (64 + 64 + 64 ГБ) плюс overhead уже не помещаются в отведённую под них половину кластера. Сотрудники смены остались без терминала ещё на полтора часа — уже по совершенно другой причине, чем начиналось. Всего окно растянулось почти на три часа сверх плана.
Как закончили. Удалили зависшие дельты через консолидацию снапшотов — вернулся 71 ГБ. Резервирование серверу 1С снизили до 32 ГБ: это с запасом покрывает его активный рабочий набор, своп стал 32 ГБ вместо 64, а admission control снова пустил терминал. Своп-файлы продуктивных ВМ вынесли на отдельный общий датастор DS_SWAP_01 на 500 ГБ — так рост RAM больше не конкурирует за место с дисками баз. Порог алерта по свободному месту подняли с 10 до 20 % и добавили отдельную проверку «свободно на датасторе не меньше суммы незарезервированной памяти выключенных ВМ». За следующие полгода сюрпризов с включением не было.
- Было: свободно 96 ГБ, из них 71 ГБ съели зависшие дельты бэкапа — осталось 25 ГБ
- Требовалось: 64 ГБ под .vswp + около 90 МБ под VMX swap
- Резервирование на все 64 ГБ включило 1С, но admission control не пустил терминальный сервер
- Итог: резервирование 32 ГБ, отдельный датастор под свопы, порог алерта 20 %
Как посчитать запас места на datastore заранее
Формула, которую я держу в голове перед любым изменением памяти: свободного места на датасторе должно остаться не меньше, чем (новая configured memory − резервирование) + 0,3 ГБ на VMX swap + нормальный запас на рост тонких дисков и снапшоты. Если у вас на датасторе живут выключенные ВМ, которые кто-то может включить, — их суммарная неарезервированная память тоже должна быть в запасе, иначе вы просто передвинете отказ на другую машину.
Смотреть свободное место я предпочитаю прямо на хосте, а не в GUI: цифра в vSphere Client обновляется с задержкой и в момент разбора инцидента врёт.
# свободное место по датасторам глазами хоста
esxcli storage filesystem list
df -h /vmfs/volumes/DS_1C_01

# кто и сколько держит свопом прямо сейчас
find /vmfs/volumes/DS_1C_01 -name '*.vswp' -exec ls -lh {} \;

# список ВМ и их состояние
vim-cmd vmsvc/getallvms
vim-cmd vmsvc/power.getstate <vmid>
Для планирования по всему кластеру удобнее PowerCLI. Этот отчёт показывает, сколько места под своп потребует каждая включённая ВМ, и сразу вскрывает машины с нулевым резервированием и жирной памятью:
Get-VM | Where-Object { $_.PowerState -eq 'PoweredOn' } |
  Select-Object Name,
    @{N='MemGB'; E={ $_.MemoryGB }},
    @{N='ResGB'; E={ (Get-VMResourceConfiguration $_).MemReservationGB }},
    @{N='VswpGB'; E={ $_.MemoryGB - (Get-VMResourceConfiguration $_).MemReservationGB }},
    @{N='Datastore'; E={ ($_ | Get-Datastore).Name -join ',' }} |
  Sort-Object VswpGB -Descending | Format-Table -AutoSize
Одна оговорка честности ради: имя свойства резервирования в PowerCLI зависит от версии модуля — в актуальных сборках есть MemReservationGB, в более старых приходится брать MemReservationMB и делить на 1024. Проверьте на своём окружении через Get-VMResourceConfiguration | Get-Member, прежде чем гнать отчёт по всему кластеру.
- Свободно на датасторе ≥ (configured memory − reservation) для каждой ВМ, которая может включиться
- Плюс ~0,1–0,3 ГБ на VMX swap на каждую ВМ
- Плюс запас на рост тонких дисков и на снапшоты бэкапа (у меня это минимум 20 % тома)
- Отдельно проверяйте выключенные ВМ — их свопы сейчас не занимают места, но займут при старте
Резервирование памяти: когда ставить и чем оно опасно
Резервирование действительно решает исходную проблему. Поставили резервирование, равное всей памяти ВМ, — своп-файл не создаётся, требование к месту на датасторе под него падает до нуля. Плюс это гарантированно убирает host-level swapping для этой машины, а он для 1С и SQL смертельно вреден: зарезервированную память хост не отбирает ни балуном, ни своим свопом, даже если гость её сейчас не использует.
Побочка серьёзная. Хост не включит ВМ, если не может гарантировать её резервирование из незарезервированной памяти. В кластере с HA добавляется admission control: при политике по проценту ресурсов он суммирует резервирования и overhead всех включённых ВМ и сравнивает с ёмкостью, оставшейся после отложенной под отказ доли. При политике слотов ещё хуже — размер слота по умолчанию определяется самым большим резервированием, и одна ВМ с полным локом памяти резко снижает число допустимых машин. Раздали резервирования щедро — получили кластер, где ВМ перестают стартовать при формально свободной памяти.
Мой рабочий компромисс для типичного офисного контура до 50 рабочих мест: полное резервирование ставлю только там, где хост-своп недопустим по природе задачи — сервер СУБД, сервер 1С, иногда телефония. Для остальных резервирую не более половины памяти или не резервирую вовсе, а место под свопы просто закладываю в ёмкость датастора. Ставить «Reserve all guest memory» веером на все ВМ «чтобы не думать про место» — плохая идея: вы меняете понятную проблему нехватки дискового места на непонятную проблему отказов включения по памяти.
И ещё нюанс, который экономит нервы при отладке: если вы поменяли резервирование у работающей машины, эффект проявляется постепенно, а полностью — только после power-cycle. Своп-файл создаётся в момент включения, и его размер на лету не пересчитывается. Поменяли резервирование — перезагрузка ВМ обязательна, иначе на датасторе так и будет лежать старый файл прежнего размера.
- Полное резервирование = нет .vswp = нет требования к месту, но есть жёсткий лок памяти на хосте
- Частичное резервирование уменьшает своп пропорционально — это часто лучший баланс
- Резервирование влияет на HA admission control и на плотность ВМ в кластере
- Изменение резервирования на лету не пересоздаёт своп-файл — нужен перезапуск ВМ
Где размещать своп-файлы: отдельный датастор, SSD, thin
По умолчанию своп ложится в тот же каталог, где лежит конфигурационный файл ВМ (.vmx). Это удобно, но именно из-за этого рост памяти начинает конкурировать за место с файлами баз данных на том же LUN. Поменять место можно на уровне кластера (своп в каталоге ВМ или на датасторе, заданном хостом), на уровне хоста (указать ему swap-датастор) и у конкретной ВМ в её параметрах. Для площадок, где память крутят регулярно, я выношу свопы на отдельный общий датастор — так изменение RAM перестаёт быть операцией с продуктивным хранилищем.
Локальный SSD под свопы выглядит соблазнительно и по производительности действительно хорош, но у него есть прямо задокументированная плата: размещение своп-файлов на локальном хранилище хоста может немного снизить производительность vMotion, потому что вытесненные в локальный своп страницы приходится передавать по сети на хост назначения. Для кластера с активным DRS я на это не иду. Если очень хочется выжать SSD — правильный путь другой: swap to host cache на локальном SSD, при том что обычные своп-файлы остаются на общем хранилище. Так рекомендует и сама документация: под весь объём свопа SSD обычно всё равно не хватает.
Отдельно — про тонкое размещение. Документация по управлению ресурсами vSphere говорит прямо: не храните своп-файлы на thin-provisioned LUN — рост свопа может упереться в исчерпание места на переподписанной СХД, и работающая ВМ будет остановлена. Логика понятная: своп — как раз тот файл, который обязан быть гарантированно доступен целиком. Ещё один источник «пропавшего» места — осиротевшие .vswp после аварии хоста: если хост упал с работающими ВМ, их своп-файлы остаются и занимают гигабайты, пока их не удалят.
Спорный момент, где я честно скажу «проверяйте на своей версии»: поведение свопа на vSAN. Там своп — не файл в каталоге, а отдельный объект со своей политикой хранения, и вопрос тонкий/толстый и учёт FTT менялись от версии к версии. Считать ёмкость на vSAN по формуле «память минус резервирование» напрямую нельзя — надо смотреть, какая политика применяется к swap-объектам в вашей конкретной сборке. На классическом VMFS всё предсказуемо, там формула работает буквально.
- По умолчанию: каталог ВМ рядом с .vmx
- Отдельный общий датастор под свопы — мой выбор для кластеров, где память меняют часто
- Локальный своп хоста — быстрее, но немного бьёт по vMotion; SSD лучше отдать под swap to host cache
- Thin-provisioned LUN под своп — нельзя, документация против
- vSAN/vVols — своп это отдельный объект со своей политикой, формулу применяйте с оглядкой
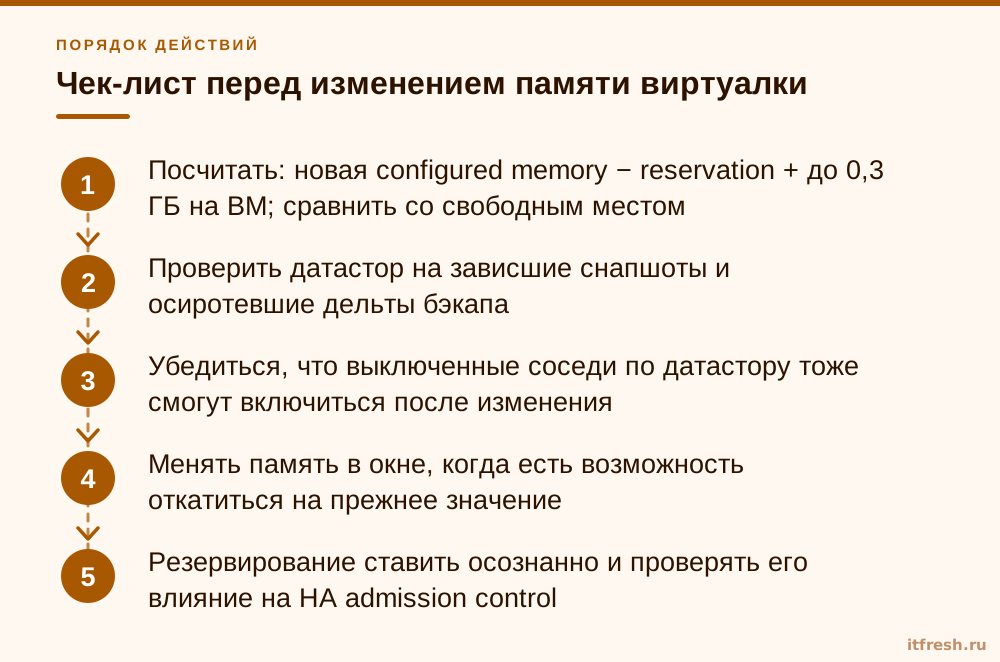
Чек-лист перед изменением памяти виртуалки
Порядок действий у меня простой и занимает минут пять — против почти трёх лишних часов в разборе выше. Сначала считаем требуемое место, потом чистим мусор, потом меняем память, и только потом думаем про резервирование. Обратный порядок («сначала поставим резервирование, потом разберёмся») как раз и приводит к каскаду отказов включения.
Что делать в первую очередь, а на что можно забить. В первую очередь — свободное место на датасторе и зависшие снапшоты бэкапа: это две причины из трёх. Во вторую — размещение свопов, если вы вообще регулярно меняете память. А вот на VMX swap с его сотней мегабайт можно спокойно забить: он влияет на расчёт только у сотен ВМ на одном датасторе, и трогать sched.swap.vmxSwapEnabled я не рекомендую вообще никому. Системный своп хоста на 1 ГБ — тоже приятная мелочь, а не решение проблемы ёмкости.
И последнее, про мониторинг. Порог свободного места на продуктивном датасторе в 10 % — это порог, который сработает уже после того, как у вас перестанут включаться машины. Я ставлю 20 % и отдельно — синтетическую проверку «свободного места хватит, чтобы включить все выключенные ВМ этого датастора». Вторая проверка нестандартная, её приходится дописывать руками в Zabbix или скриптом на PowerCLI, но именно она ловит проблему до инцидента, а не после. Если вы как раз планируете уходить с VMware, логика расчёта свопа пригодится и на новой платформе — об этом я рассказывал в кейсе замены VMware на zVirt: у других гипервизоров механика другая, но вопрос «где и сколько места под подкачку» никуда не девается.
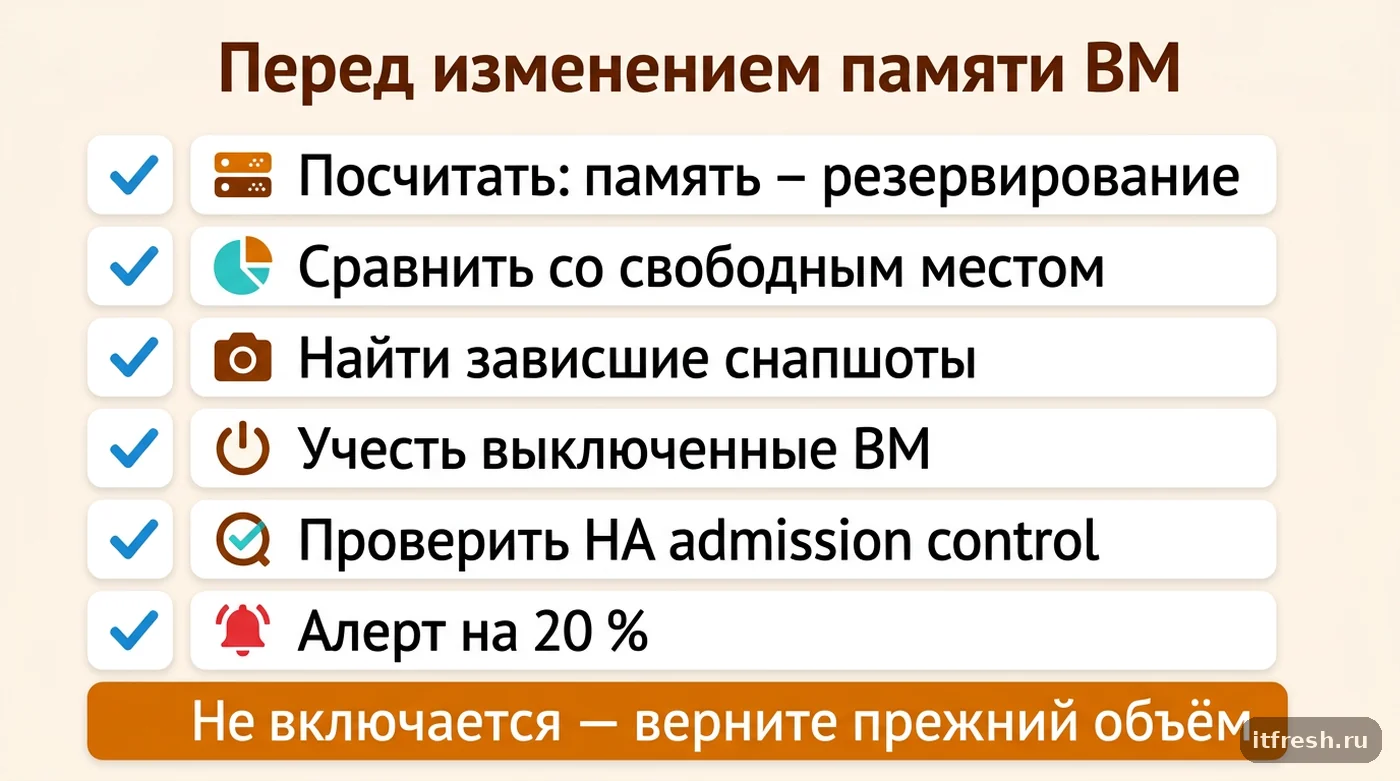
- Посчитать: новая configured memory − reservation + до 0,3 ГБ на ВМ; сравнить со свободным местом
- Проверить датастор на зависшие снапшоты и осиротевшие дельты бэкапа
- Убедиться, что выключенные соседи по датастору тоже смогут включиться после изменения
- Менять память в окне, когда есть возможность откатиться на прежнее значение
- Резервирование ставить осознанно и проверять его влияние на HA admission control
- Поднять порог алерта по свободному месту до 20 % и добавить проверку на суммарный своп
Частые вопросы
Сколько именно места на datastore нужно под .vswp?
Ровно столько, сколько составляет разница между сконфигурированной памятью ВМ и её резервированием памяти. При нулевом резервировании — весь объём RAM машины: 96 ГБ памяти означают 96 ГБ на датасторе. Плюс небольшой VMX swap, обычно менее 100 МБ (до ~300 МБ при включённой 3D-графике).
Почему проблема вылезла именно после выключения ВМ, а до этого всё работало?
Своп-файл существует только пока ВМ включена. На выключении он удаляется, место возвращается на датастор и его успевают занять соседи — тонкие диски, снапшоты бэкапа, другие ВМ. При включении машина просит уже новый, больший объём, и его не находит.
Поможет ли SSD host cache избавиться от .vswp?
Нет. Документация vSphere 9.0 прямо говорит, что даже хост со swap to host cache всё равно создаёт обычные своп-файлы. Host cache снижает влияние медленного хранилища на host-level swapping, но требование к месту на датасторе не убирает.
Можно ли просто выставить всем ВМ полное резервирование памяти и забыть про свопы?
Технически да, своп-файлы тогда не создаются. Но хост не включит ВМ, если не может гарантировать её резервирование, а HA admission control учитывает все резервирования. Веерное резервирование меняет нехватку места на отказы включения по памяти.
Я поменял резервирование у работающей ВМ, а размер .vswp не изменился. Это баг?
Нет. Своп-файл создаётся в момент включения ВМ, и его размер на лету не пересчитывается. Чтобы файл пересоздался с новым размером, машину нужно выключить и включить.
Куда лучше вынести своп-файлы?
Для кластеров, где память меняют регулярно, — на отдельный общий датастор. Локальный своп хоста быстрее, но немного замедляет vMotion. На thin-provisioned LUN своп класть нельзя.
Источники
- Broadcom TechDocs: vSphere Resource Management 9.0 — Using Swap Files — Своп по умолчанию рядом с .vmx; место под незарезервированную память; без свопа ВМ не включится; рост времени включения при свопе >100 ГБ; запрет thin-provisioned LUN; host-local swap и vMotion; осиротевшие своп-файлы. https://techdocs.broadcom.com/us/en/vmware-cis/vsphere/vsphere/9-0/vsphere-resource-management/using-swap-files.html
- Performance Best Practices for VMware vSphere 9.0 — Размер .vswp = configured memory − reservation; VMX swap обычно менее 100 МБ (менее 300 МБ с 3D), sched.swap.vmxSwapEnabled; swap to host cache не отменяет обычные своп-файлы. https://www.vmware.com/docs/vsphere-esxi-vcenter-server-90-performance-best-practices
- Broadcom KB 423891 — Почему занятое ВМ место больше размера дисков: .vswp размером с незарезервированную память. https://knowledge.broadcom.com/external/article/423891/virtual-machine-storage-usage-showing-hi.html
- Broadcom TechDocs: vSphere HA Admission Control — Политики Cluster Resources Percentage и Slot Policy, учёт резервирований при допуске ВМ. https://techdocs.broadcom.com/us/en/vmware-cis/vsphere/vsphere/8-0/vsphere-availability/creating-and-using-vsphere-ha-clusters/vsphere-ha-admission-control.html
- Broadcom KB 342554 — При отключении своп-файла ВМ резервируется вся память гостя. https://knowledge.broadcom.com/external/article/342554/all-guest-os-memory-reserved-when-disabl.html