Второй Asterisk за 10 секунд: отказоустойчивость на двух серверах с keepalived
Один сервер Asterisk — это риск остаться без связи на час. Отказоустойчивость на двух машинах с keepalived и VRRP дает переключение за секунды, но требует идеальной синхронизации. Разбираю схему active-passive, которая работает в моих проектах, на примере логистической компании «Пятый причал». Никакой магии, только железо и скрипты.
Почему один сервер Asterisk — это бомба замедленного действия
Когда в офисе 40–50 человек и диспетчерская работает круглосуточно, падение единственного сервера Asterisk превращается в катастрофу. Я часто слышу: «У нас есть бэкап, мы восстановимся». Но восстановление базы данных, переподключение SIP-транков и заново регистрация аппаратов занимают от 30 минут до нескольких часов. За это время теряются звонки, срываются сделки, а диспетчеры сидят без инструментов. В реальности сисадмины забывают, что Asterisk хранит состояние в оперативной памяти и в базе astdb, и простое восстановление файлов не вернет активные сессии. Это не паранойя, это физика процесса. Попытка «починить» всё руками в момент кризиса — это гарантированный хаос, где никто не знает, какой транк уже подключен, а какой еще ждет ответа. Бизнес платит за простои, а не за ваши героические попытки поднять сервер из пепла за 20 минут. Если вы не хотите, чтобы ваш офис превратился в тишину, пока вы гоняетесь за проводами, вам нужна автоматика, а не надежда на чудо.
Проблема усугубляется тем, что многие считают отказоустойчивостью наличие второго сервера, который просто «висит». Без механизма автоматического переключения (failover) второй сервер бесполезен, пока кто-то вручную не поменяет DNS или настройки телефонов. А это время, которое бизнес платить не хочет. В логистике каждая минута простоя стоит денег. Поэтому мы в «АйТи-Фреш» сразу предлагаем схему с плавающим IP и автоматическим переключением, чтобы телефоны даже не заметили, что основной сервер упал. Иначе зачем тогда второй сервер? Просто греть воздух? Многие заказчики думают, что если купят второй сервер и поставят его рядом с первым, то проблема решена. Это иллюзия. Без VRRP и скриптов синхронизации это просто две машины, одна из которых работает, а вторая ждет, пока вы ее вспомните. В момент аварии вы вспомните её слишком поздно. Автоматизация — это не прихоть, это необходимость для любого бизнеса, где телефон — это инструмент заработка.
Еще один миф: «Кластер Asterisk слишком дорогой». На самом деле, полноценный load-balancing с распределением нагрузки — это дорого и сложно. Но схема active-passive, когда один сервер работает, а второй ждет сигнала бедствия, реализуется на стандартном оборудовании и бесплатном ПО. Главное — правильно настроить VRRP и синхронизацию конфигов, чтобы второй узел был готов принять эстафету мгновенно. Не пытайтесь изобретать велосипед там, где нужен просто надежный грузовик. Сложные решения требуют сложных админов, а сложные админы стоят дорого и часто ошибаются. Простота — залог надежности. Два сервера, один виртуальный IP и скрипт, который копировал конфиги каждую минуту — это база. Всё остальное — это попытка продать вам воздух. Если вы хотите сэкономить, начните с понимания, что дешевое решение без настройки стоит дороже, чем дорогое решение, которое работает.
Архитектура: Active-Passive на VRRP и плавающий IP
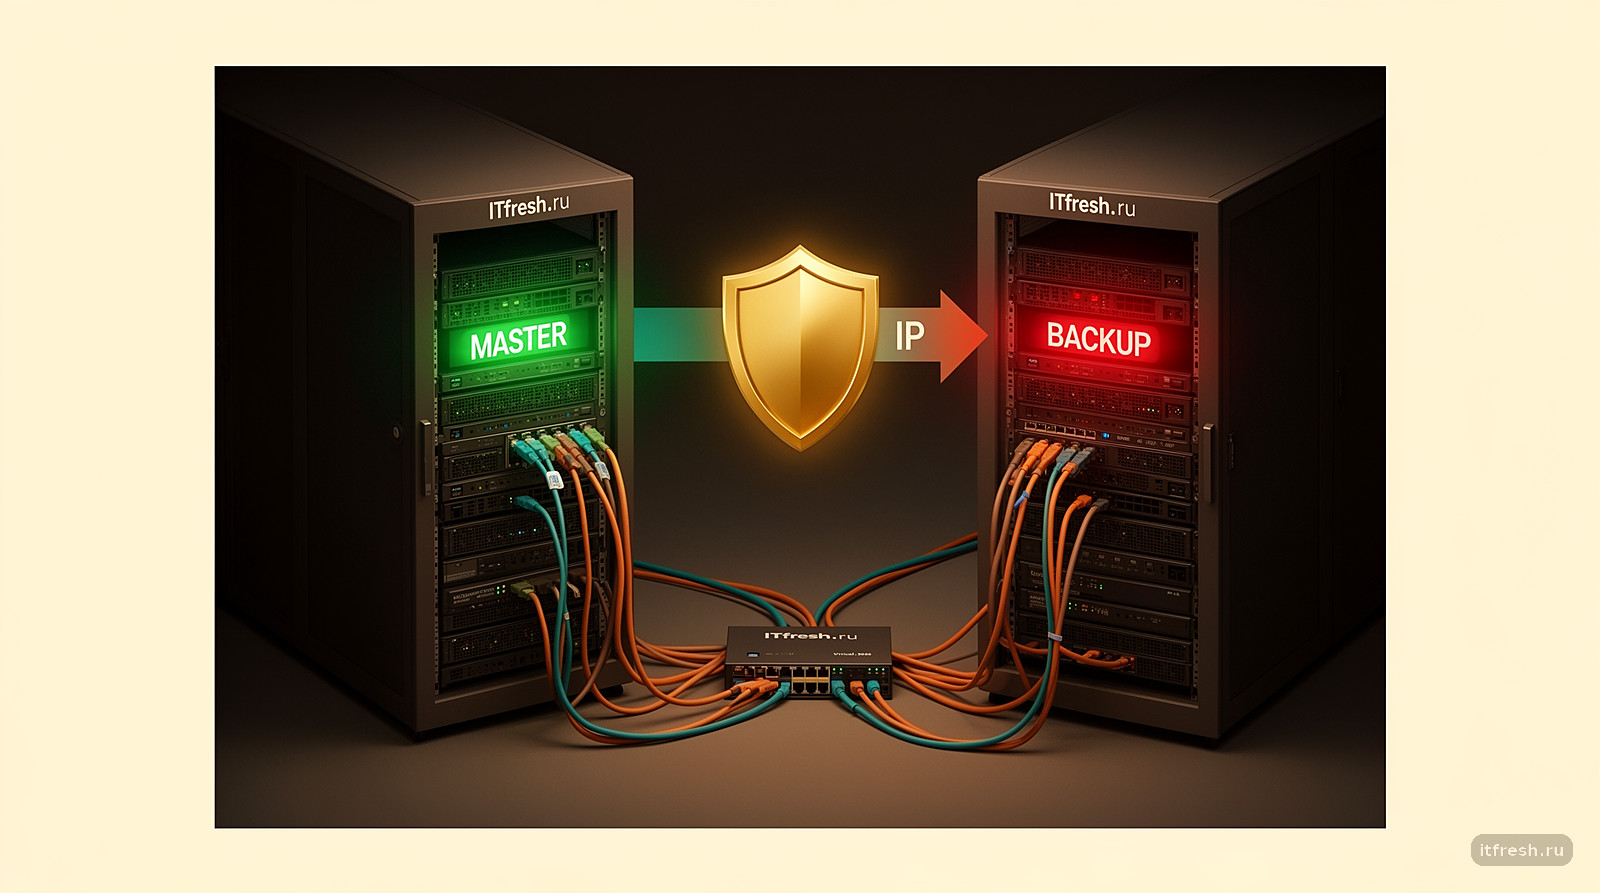
Сердцем нашей отказоустойчивости становится протокол VRRP (Virtual Router Redundancy Protocol), который реализует утилита keepalived. Мы создаем виртуальный IP-адрес (VIP), который «плавает» между двумя физическими серверами. Все телефоны, SIP-транки и маршрутизаторы настроены на этот VIP, а не на реальные адреса машин. Если основной сервер (Master) жив, он держит VIP на себе. Как только он падает, резервный (Backup) забирает адрес на себя. Для внешних систем переключение происходит незаметно, за исключением разрыва активных соединений. Это не магия, это сетевой протокол, работающий с 1998 года. Никаких сложных алгоритмов балансировки, просто четкая логика: если главный жив — он работает, если нет — вступает в дело запасной. Это фундамент, на котором строится вся наша надежность. Не верьте тем, кто предлагает вам какие-то экзотические решения, если они не используют стандартные протоколы уровня сети. VRRP — это стандарт де-факто для таких задач, и он проверен временем.
Это не «кластер» в понимании распределенной базы данных, а именно резервирование точки входа. Asterisk на обоих серверах должен иметь идентичную конфигурацию. Мы используем два физических сервера, желательно в разных стойках или, как минимум, на разных источниках питания. В моем опыте с компанией «Пятый причал» мы ставили серверы в одном дата-центре, но на разных коммутаторах доступа, чтобы исключить потерю сети при падении одного свича. Это минимально необходимый уровень защиты для офиса до 50 человек. Ставить два сервера в одну розетку — это самоубийство, но многие делают именно так. Если вы хотите реальной защиты, дублируйте всё: питание, сеть, каналы связи. Иначе ваша «отказоустойчивость» превратится в фарс при первом же отключении электричества в стойке. Не экономьте на инфраструктуре, если хотите, чтобы система работала. Два сервера в одной розетке — это один сервер с лишним местом в шкафу.
Keepalived работает не поверх ICMP, а использует собственный протокол VRRP (номер 112). В IPv4-мультикасте для версии VRRPv2 используется адрес 224.0.0.18. Если вам потребуется поддержка IPv6 или VRRPv3, мультикаст-адрес будет другим. Он не просто пингует интерфейс, а запускает скрипт health_check, который проверяет наличие процесса Asterisk. Если проверка не проходит, статус меняется с Master на Backup, и запускается скрипт, который подхватывает VIP. Весь процесс занимает секунды. Но есть нюанс: если сервер завис, но сеть жива, keepalived может не понять этого сразу, пока не истечет таймаут. Поэтому мы настраиваем проверку именно процесса Asterisk, а не просто доступность сети. Иначе keepalived будет думать, что всё отлично, пока сервер уже не будет висеть в вечном сне. Проверка процесса — это критически важный шаг. Если вы проверите только сеть, вы получите ситуацию, когда сервер мертв, а VIP всё ещё на нем, и звонки никуда не доходят. Настраивайте проверки глубоко, проверяйте не только доступность интерфейса, но и работоспособность самого сервиса. Это разница между системой, которая работает, и системой, которая создает иллюзию работы.
Синхронизация конфигов: rsync и astdb — главные боли
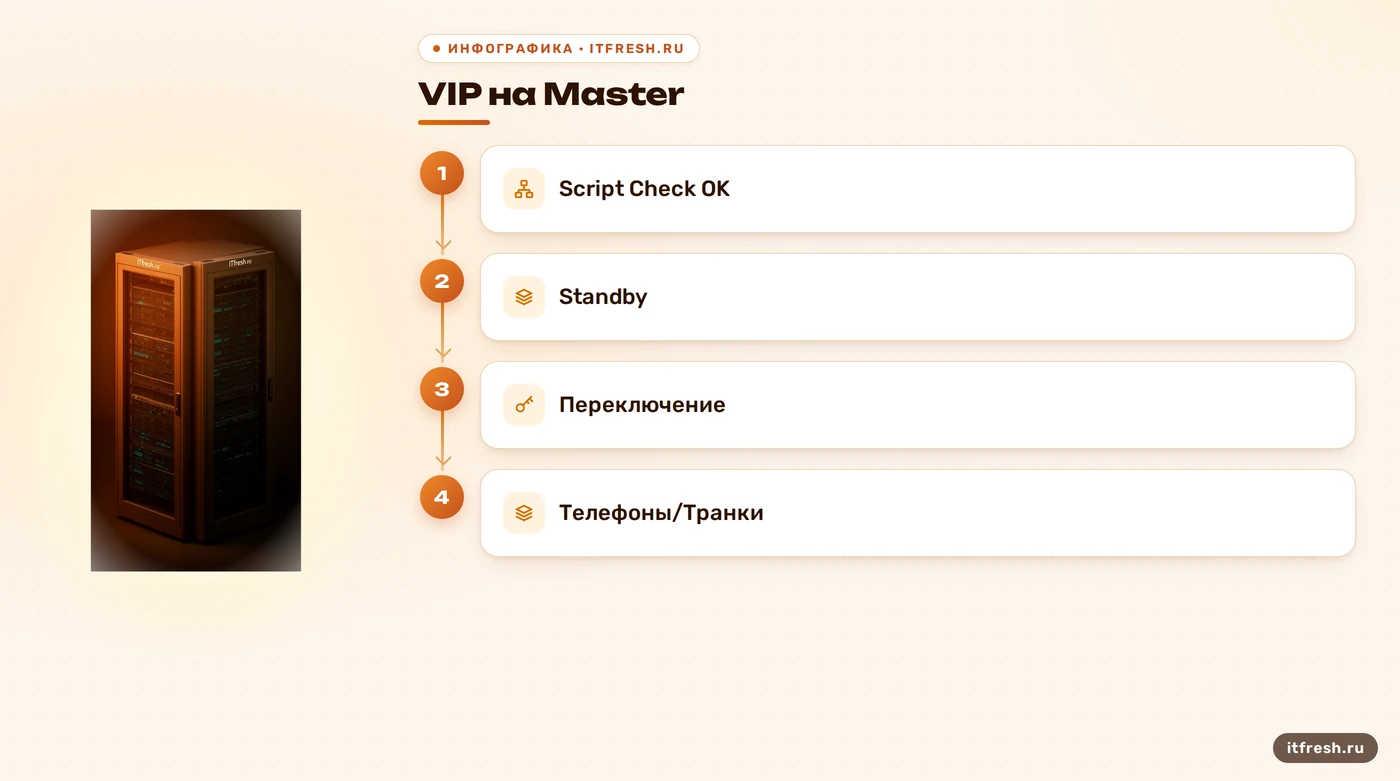
Самое критичное место в схеме active-passive — это синхронизация. Если на мастер-сервере вы добавите нового пользователя или измените маршрут, эти изменения должны мгновенно попасть на резервный. Конфигурационные файлы в /etc/asterisk мы синхронизируем через rsync или unison. Забудьте про cron с интервалом в 5 секунд — cron не умеет работать чаще раза в минуту. Используйте systemd-timer или inotifywait для реакции на изменения файлов в реальном времени. Это гарантирует, что при переключении настройки будут актуальными. Но помните: rsync — это не волшебная палочка, если у вас медленный диск, он не успеет скопиться. Синхронизация должна быть быстрой и надежной. Если вы настроите rsync с интервалом в 10 минут, то при сбое вы потеряете все изменения, внесенные за это время. Для бизнеса это может означать потерю новых клиентов или срыв важных звонков. Настройте синхронизацию так, чтобы она работала постоянно и без задержек. Используйте инструменты, которые реагируют на изменения файлов в реальном времени, а не ждут следующего запуска cron. Это вопрос не удобства, а выживания вашей системы.
Но файлы — это полдела. Asterisk активно использует базу данных astdb для хранения временных данных, состояний, голосовой почты и настроек, которые меняются «на лету». astdb не хранит активные звонки, она хранит ключ-значение пары. Если astdb не синхронизирована, при переключении на резервный сервер пользователи могут потерять свои настройки или не иметь доступа к голосовой почте. В проекте «Пятый причал» мы столкнулись с тем, что rsync файлов был недостаточно. При падении мастера диспетчеры не видели обновленных статусов линий. Решение — регулярная дамп-синхронизация astdb или использование общей базы данных, если архитектура позволяет, но для простоты и надежности мы делаем частый сброс и копирование файлов базы. Это больно, но необходимо. Без синхронизации astdb ваш резервный сервер будет работать как слепой: он подхватит IP, но не будет знать, кто сейчас звонит и куда направлять вызовы. Это приведет к полной потере функциональности. Не пренебрегайте синхронизацией базы данных, это ключевой элемент отказоустойчивости.
Не забывайте про права доступа. После синхронизации файлов через rsync права на файлы в /var/lib/asterisk могут сбиться, и Asterisk на резервном сервере откажется стартовать. Обязательно добавляйте шаги по восстановлению прав (chown/chmod) в скрипт синхронизации, используя флаги --chmod и --chown в rsync. Это мелочь, которая может остановить весь процесс восстановления. Мы в «АйТи-Фреш» всегда тестируем этот сценарий: ломаем мастер, смотрим, подхватит ли резервный базу и запустится ли без ошибок. Если не протестировать — плакать будете потом. Права доступа — это та деталь, которую легко упустить, но она может стать причиной полного отказа системы. Проверьте, что rsync сохраняет владельца и группу файлов, и добавьте команды chown/chmod в скрипт, если это необходимо. Тестирование должно включать не только проверку переключения, но и проверку работы всех функций после него. Только так вы будете уверены, что ваша система действительно готова к сбою.
- Настройте rsync с валидацией прав (--chmod, --chown) для /etc/asterisk
- Используйте systemd-timer или inotify для синхронизации astdb каждые 1-2 минуты
- Проверьте работу rsync в режиме dry-run перед запуском
- Убедитесь, что резервный сервер имеет достаточное место на диске для логов и баз
Что НЕ переживет переключение: честный разговор о потерях
Давайте честно: при переключении с Master на Backup вы потеряете все активные звонки. Это неизбежно. SIP-сессия привязана к IP-адресу сервера, и когда VIP переходит на другую машину, старые TCP/UDP соединения разрываются. Телефоны и SIP-транки должны перерегистрироваться. Для абонента это значит, что текущий разговор оборвется. Но новые звонки начнут поступать уже через 1–3 секунды после переключения, если правильно настроены advert_int и priority. Клиент может автоматически пере-регистроваться после переключения, если настроен регистр у провайдера. Это плата за отказоустойчивость без сложных и дорогих решений типа распределенной базы данных в реальном времени. Не верьте тем, кто говорит, что можно сохранить звонок — это ложь. В схеме active-passive с плавающим IP сохранение активных сессий технически невозможно без использования специализированных шлюзов или сложных протоколов, которые выходят за рамки бюджетного решения. Экономьте нервы, а не звонки. Лучше потерять один звонок, чем остаться без связи на час. Это компромисс, который приходится принимать ради надежности. Если вы не готовы к этому, вам нужно искать другое решение, но оно будет стоить значительно дороже.
Также не переживет переключение кэш в оперативной памяти Asterisk, если он не сохранен в astdb или файл. Например, если вы используете сложные переменные в диалплане, которые живут только в памяти, они сбросятся. Поэтому важно проектировать диалплан так, чтобы критические данные сохранялись в базу. В кейсе «Пятый причал» мы переписали часть скриптов автоответчика, чтобы они читали данные из MySQL, а не из памяти, чтобы при сбое не терять логику обработки вызовов. Лень переписывать код приведет к потере денег клиента. Если вы хотите, чтобы ваша система работала надежно, не полагайтесь на память сервера. Храните все важные данные в базе данных или файлах, которые синхронизируются. Это требует времени и усилий, но это необходимо для обеспечения непрерывности работы. Не экономьте на разработке, если хотите получить качественный результат. Инвестиции в правильное проектирование окупятся сторицей.
Еще один момент — регистрация SIP-транков. Провайдеры связи могут требовать времени на перерегистрацию. Обычно это 10–30 секунд, но иногда провайдер видит смену IP как подозрительную активность и временно блокирует трафик. Поэтому перед запуском в продакшен обязательно согласуйте с провайдером использование плавающего IP или используйте режим без регистрации (peer-only), если это возможно в вашей архитектуре безопасности. Иначе вы получите отказоустойчивую систему, которая не может звонить. Согласование с провайдером — это важный шаг, который часто упускают. Если провайдер заблокирует ваш IP из-за смены, то вся ваша система станет бесполезной. Убедитесь, что провайдер знает о вашем решении и поддерживает его. Это может потребовать дополнительных настроек или договоренностей, но это необходимо для успешной работы. Не оставляйте этот вопрос на потом, решите его заранее.
Практический кейс: логистическая компания «Пятый причал»
Возьмем пример компании «Пятый причал». У них 44 рабочих места, диспетчерская 24/7, и простой даже на 15 минут стоит им дорого. До нас у них был один сервер Asterisk на старом железе. Падение сервера случалось раз в полгода, но каждый раз это был кошмар: сисадмин бежал в офис, включал сервер, ждал загрузки, переподключал линии. Мы предложили схему с двумя серверами на базе Debian 12, каждый с 4 ядрами и 8 ГБ RAM. Установили Asterisk последней стабильной версии, настроили keepalived и rsync. Клиент сомневался, но мы убедили его, что дешевле купить два сервера, чем терять заказы. Они боялись, что это будет сложно и дорого, но мы показали, что это стандартное решение, которое работает. После внедрения они забыли о проблемах с сервером. Теперь они знают, что даже при полном сбое сервера работа продолжится. Это дало им спокойствие и уверенность в том, что их бизнес защищен. Инвестиции в отказоустойчивость окупаются быстро, особенно в таких отраслях, как логистика, где время — деньги.
При внедрении мы столкнулись с проблемой рассинхронизации astdb. Первые тесты показали, что при падении мастера резервный сервер подхватывал VIP, но диспетчеры не могли видеть статусы линий. Оказалось, что rsync копирует файлы, но не успевает за изменениями в базе, которые идут каждую секунду. Мы заменили cron на systemd-timer и увеличили частоту синхронизации базы до 10 секунд, добавив скрипт, который делает dump базы перед перезагрузкой сервиса. После этого переключение стало прозрачным для бизнеса, за исключением обрыва текущих разговоров. Это был урок: теория без практики — просто слова. Мы поняли, что синхронизация базы данных — это критически важный этап, который нельзя игнорировать. Без неё вся система теряет смысл. Мы протестировали множество вариантов и нашли оптимальное решение, которое работает стабильно. Этот опыт позволил нам улучшить наши процессы и сделать их более надежными. Практика показывает, что даже самые простые решения требуют тщательной настройки и тестирования.
Тестирование проводили жестко: мы просто выдергивали питание у основного сервера во время рабочего дня. Переключение заняло 8 секунд. Телефоны в офисе мигнули и перерегистрировались. Диспетчеры потеряли один звонок, но через 10 секунд связь была восстановлена. Клиент был доволен, потому что теперь они знают, что даже при полном сбое сервера работа продолжится. Стоимость решения составила два сервера и около 10 часов работы инженеров, что несоизмеримо с риском простоя. Результат: спокойствие и работающие звонки. Это лучший показатель эффективности. Клиент получил то, чего хотел: надежность и отсутствие простоев. Мы доказали, что отказоустойчивость — это не миф, а реальность, которую можно реализовать. Главное — подойти к делу серьезно и не экономить на качестве. Тестирование в боевых условиях — это единственный способ убедиться, что система работает. Не надейтесь на удачу, проверяйте всё на практике.
Тестирование и мониторинг: как не забыть проверить
Самая большая ошибка — настроить отказоустойчивость и никогда не проверять её. Я видел много случаев, когда keepalived был настроен, но из-за ошибки в скрипте синхронизации резервный сервер был пустым. Поэтому тестирование — обязательный этап. Проводите плановые тесты раз в квартал: выключайте основной сервер и фиксируйте время переключения. Проверяйте, работают ли все функции: голосовая почта, очереди, IVR. Если что-то не работает, значит, синхронизация не идеальна. Надеяться на удачу в IT — это путь к увольнению. Тестирование должно быть регулярным и систематическим. Не ждите аварии, чтобы проверить, работает ли ваша система. Проводите тесты заранее, чтобы выявить проблемы до того, как они приведут к реальному сбою. Это сэкономит вам время, деньги и нервы. Если вы не тестируете свою систему, вы не знаете, работает ли она. Тестирование — это не прихоть, это необходимость. Только так вы можете быть уверены в надежности вашей системы.
Для мониторинга используем Zabbix или аналогичные системы. Нам нужно отслеживать статус keepalived (Master/Backup), количество активных звонков, нагрузку на CPU и память. Важно также мониторить синхронизацию конфигов: если rsync упал, нужно получать алерт немедленно. В «Пятый причал» мы настроили алерты в Telegram, которые приходят мне и главному админу. Это позволяет реагировать на проблемы до того, как они приведут к срыву звонков. Молчаливый мониторинг — это как замок без двери. Мониторинг должен быть активным и информативным. Вы должны знать, что происходит с вашей системой в реальном времени. Если что-то идет не так, вы должны узнать об этом немедленно. Это позволит вам быстро реагировать и устранять проблемы до того, как они станут критическими. Не надейтесь, что всё будет работать само собой. Мониторинг — это ваш глаз и ухо в мире IT. Без него вы слепы.
Не забывайте проверять логи. При каждом переключении в логах keepalived и Asterisk появляются записи. Анализируйте их, чтобы понять, почему произошло переключение. Иногда это не падение сервера, а временный сбой сети или ошибка конфигурации. Регулярный анализ логов помогает улучшать систему и предотвращать ложные срабатывания. Лог — это история вашего сервера, читайте её. Логи содержат важную информацию о работе системы. Они помогают понять, что произошло, и почему. Если вы не анализируете логи, вы упускаете возможность улучшить вашу систему. Регулярно проверяйте логи, чтобы выявить проблемы на ранней стадии. Это поможет вам предотвратить будущие сбои и улучшить надежность вашей системы. Не игнорируйте логи, они — ваш лучший друг в мире IT.
Частые вопросы
Сколько времени занимает переключение на резервный сервер?
При правильной настройке keepalived (advert_int, priority) переключение занимает от 1 до 3 секунд. Активные звонки теряются, но новые начинают проходить почти мгновенно.
Можно ли сохранить активные звонки при сбое?
В схеме active-passive с плавающим IP сохранить активные звонки невозможно. Сессии привязаны к IP, и при смене сервера они разрываются.
Нужен ли специальный шлюз для работы двух Asterisk?
Нет, для схемы active-passive достаточно двух серверов с установленным Asterisk, keepalived и настроенной синхронизацией конфигов.
Как часто нужно синхронизировать конфиги?
Используйте inotify или systemd-timer для мгновенной реакции на изменения. Cron с интервалом в 5 секунд не работает, минимальный интервал cron — 1 минута.
Что делать, если оба сервера упали?
Это крайний случай. Нужна третья точка восстановления или облачный бэкап. В рамках данной схемы защита только от падения одного узла.
Источники
- Asterisk Documentation — Проверка архитектуры RTP и версий дистрибутивов: https://docs.asterisk.org/Development/Roadmap/Asterisk-14-Projects/RTP-engine-replacement/Current-RTP-state-of-Asterisk/
- Keepalived Official Docs — Подтверждение работы VRRP и синхронизации состояний: https://keepalived.org/doc/
- RFC 5798 — Технические спецификации VRRP и механизмы работы протокола: https://datatracker.ietf.org/doc/html/rfc5798
- Debian Wiki: Asterisk — Рекомендации по установке и настройке Asterisk на Debian: https://wiki.debian.org/Asterisk