
Задание бэкапа Always On зелёное, а файлов нет: как работают Backup Preferences в SQL Server 2025
Задание зелёное, а файлов нет, потому что Backup Preferences ничего не запускают и ничего не запрещают: это настройка, которую обязан прочитать ваш скрипт через sys.fn_hadr_backup_is_preferred_replica. После failover он может молча выйти «успешно» на каждой реплике. Ниже: как это устроено в SQL Server 2025, разбор случая на 47 рабочих местах и скрипт, который так не врёт.
Почему задание бэкапа после failover зелёное, а файлов нет?
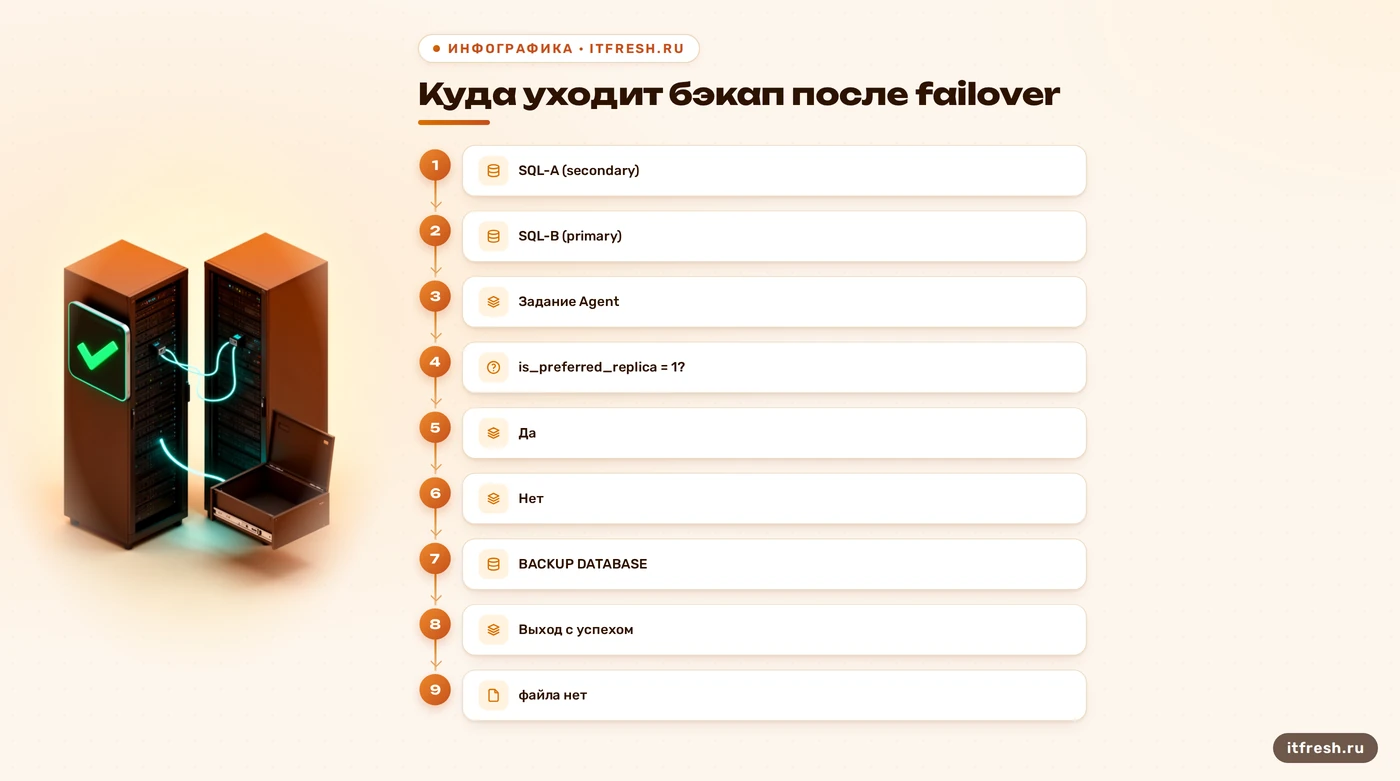
Скажу сразу: в большинстве таких историй SQL Server не сломался. Он сделал ровно то, что ему написали. Если вам нужно обслуживание SQL Server и баз 1С, первое, что я проверяю в группе доступности, это не кластер и не сеть, а текст задания бэкапа на каждой реплике. Именно там живёт «успех без файла».
Теперь по документации Microsoft, без фантазий. Настройка автоматического предпочтения бэкапа (AutomatedBackupPreference) не создаёт заданий и ничего не принуждает: в документации прямо сказано, что принудительного исполнения нет, а смысл предпочтения определяется логикой, которую вы сами заложили в задания бэкапа. На разовые (ad hoc) бэкапы настройка вообще не влияет. И ещё одна деталь, которую пропускают: задания нужно создать для каждой базы на каждом экземпляре, где стоит реплика-кандидат. Агент SQL Server сам себя между репликами не копирует. Бэкап есть, просто его никто не запускал.
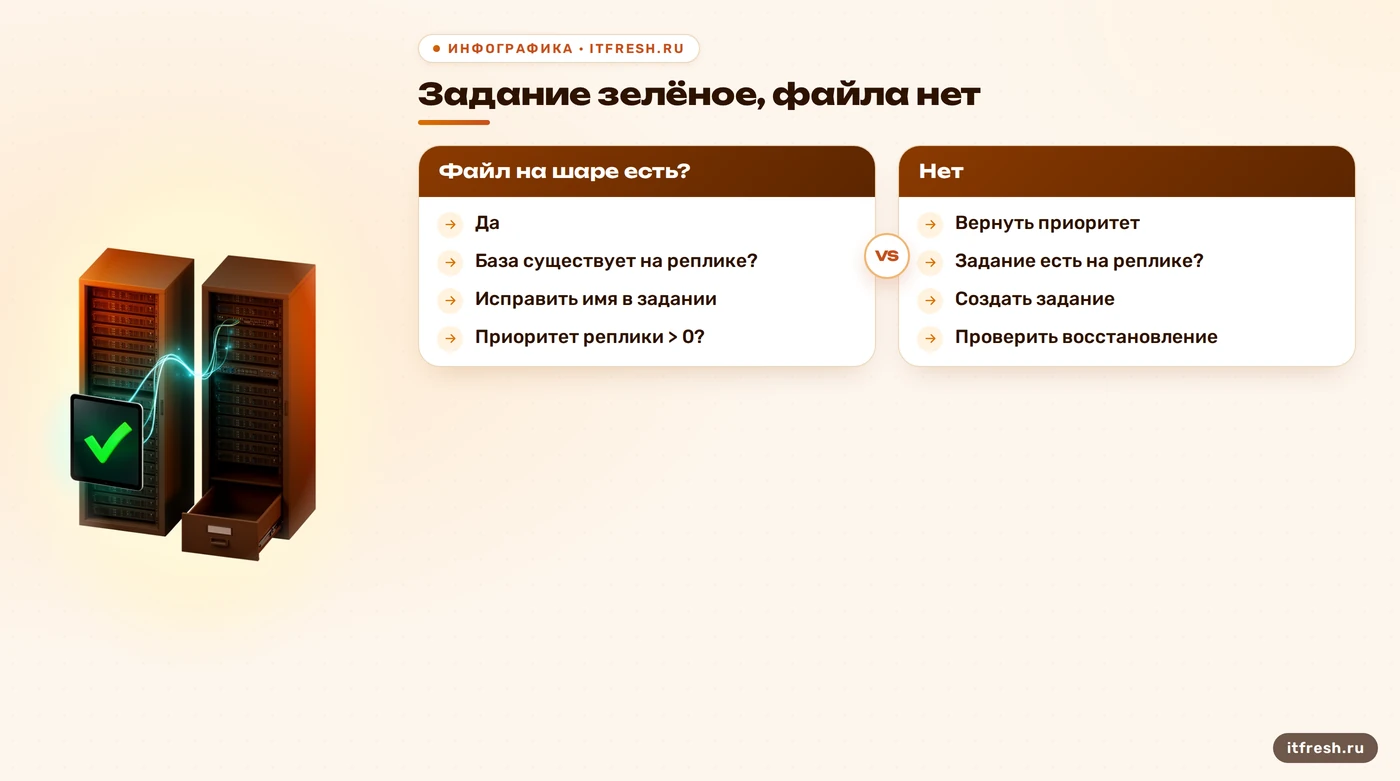
Из этого получается три способа получить зелёное задание без файла. Первый: функция sys.fn_hadr_backup_is_preferred_replica вернула 0 на текущей реплике, скрипт честно вышел «успешно», а на соседней реплике по какой-то причине тоже 0 (приоритет 0, выбран режим «только secondary», а secondary недоступна, нет связи). Второй: имя базы в задании не совпадает с реальным. Для несуществующей базы функция возвращает 0, начиная с SQL Server 2019 CU20 и SQL Server 2022 CU2, а в более ранних сборках возвращала 1 (то есть в старых версиях ошибка в имени вела к попытке бэкапа и к красному заданию, а в новых ведёт к тихому пропуску). Третий: задания на новой реплике просто нет или оно отключено. Про все три я ниже расскажу, как их ловить.
Что на самом деле значат Backup Preferences и приоритеты реплик?
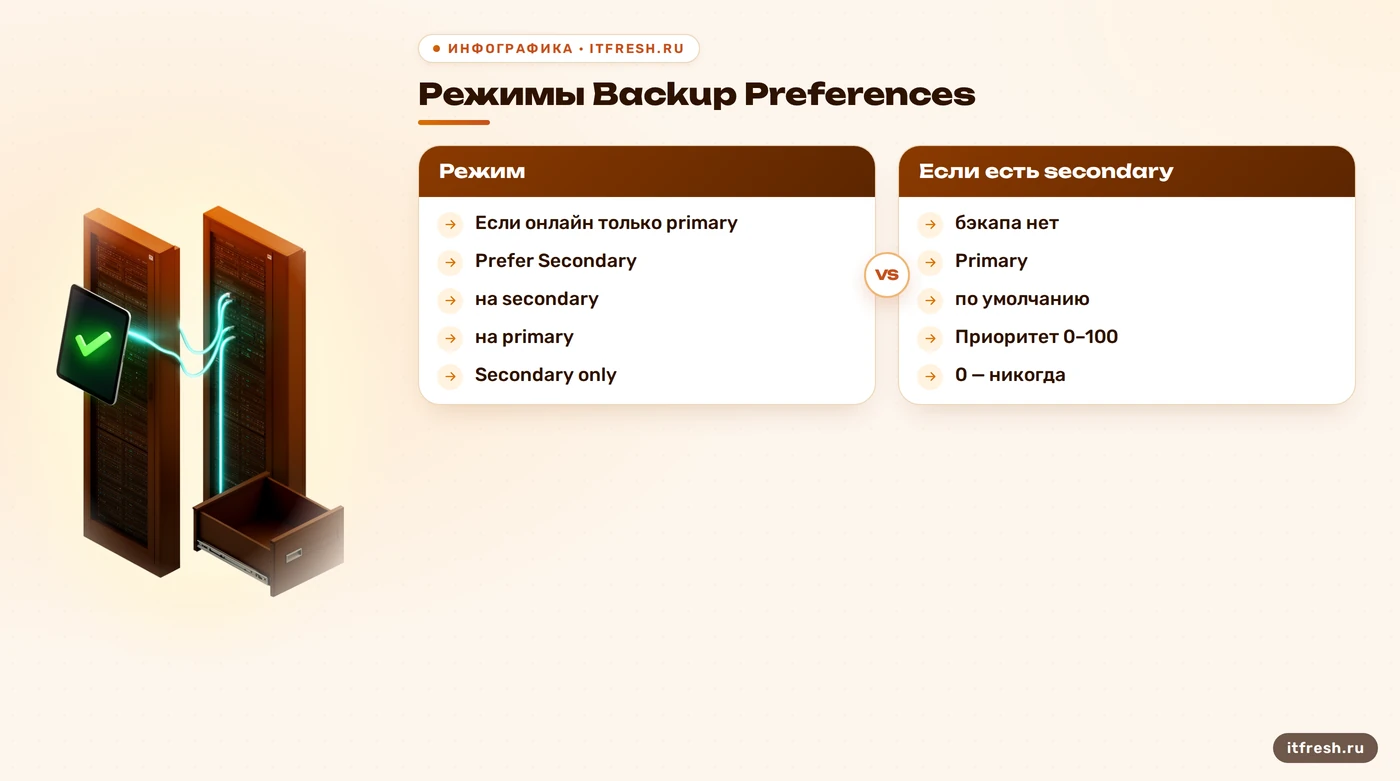
Четыре режима. В SSMS на странице Backup Preferences они называются иначе, чем в T-SQL и PowerShell, поэтому в чужих инструкциях регулярно путаются. Сведу в одну таблицу по документации на странице настройки бэкапов на secondary-репликах и в описании представления sys.availability_groups. | SSMS | T-SQL (AUTOMATED_BACKUP_PREFERENCE) | PowerShell | Смысл | |---|---|---|---| | Prefer Secondary | SECONDARY | Secondary | Бэкап на secondary, а если онлайн только primary, то на primary. Режим по умолчанию | | Secondary only | SECONDARY_ONLY | SecondaryOnly | Никогда на primary. Если онлайн только primary, бэкап не выполняется | | Primary | PRIMARY | Primary | Всегда на primary | | Any Replica | NONE | None | Роль реплики не важна, учитываются приоритет и состояние | Обратите внимание на «Secondary only». Это не «желательно на secondary», а «на primary не делать вообще». Если все secondary недоступны, правильное поведение скрипта по документации: не выполнять бэкап. А значит, зелёное задание без файла здесь штатный исход, и без внешней проверки вы о нём не узнаете.
Теперь приоритеты. У каждой реплики есть BACKUP_PRIORITY, целое число от 0 до 100. Единица означает самый низкий приоритет: такая реплика выбирается, только если нет доступных реплик с более высоким. Сто означает самый высокий. Ноль означает, что реплика никогда не выбирается для бэкапа (в SSMS это галочка Exclude Replica). Значение по умолчанию в документации для PowerShell указано как 50. Ноль удобен для удалённой реплики в другом офисе, куда бэкапы переезжать не должны, но он же классическая бомба: поставили «временно», забыли, и после failover выбирать стало некого.
Что именно учитывает функция? Документация формулирует осторожно: задания бэкапа могут учитывать приоритет реплики вместе с её операционным состоянием и состоянием соединения. Вывод для практики простой: предпочитаемая реплика не равна «secondary». Это результат вычисления на текущий момент, и после failover он меняется. Текущее состояние смотрите в sys.availability_groups (поле automated_backup_preference_desc), sys.availability_replicas (backup_priority) и sys.dm_hadr_availability_replica_states (role_desc, connected_state_desc, operational_state_desc). Заодно запомните неочевидный нюанс: если вы готовите secondary-базы через log shipping, документация просит держать режим Primary, пока все они не присоединены к группе.
Что изменилось в SQL Server 2025: full и differential на secondary
Раньше на secondary можно было делать только COPY_ONLY full и обычные бэкапы журнала. Начиная с SQL Server 2025 (17.x), по документации Microsoft, на любой secondary-реплике допустимы также полные и дифференциальные бэкапы. Для тех, кто годами писал «differential только на primary» в регламентах, это серьёзное изменение: схему «воскресный full плюс ежедневный differential» теперь можно целиком снять с боевого узла.
Теперь честность. В той же статье документации в списке ограничений всё ещё стоит строка «Differential backups aren't supported on secondary replicas», а на странице настройки в описании режима Primary по-прежнему сказано про дифференциальные бэкапы, которые не поддерживаются на secondary. Документация, как это бывает, обновлена кусками. Я не строю расписание на одной фразе: если планируете differential на secondary, сначала проверьте его на своей сборке 2025 и своём наборе обновлений, и только потом включайте в регламент. Заодно помните про COPY_ONLY: по документации копийный full не служит базой для differential и не влияет на неё, поэтому differential от такого full не получится.
Ограничения, которые остались и которые я встречаю в реальных схемах. Secondary должна связываться с primary и быть в состоянии SYNCHRONIZED или SYNCHRONIZING. Одновременные бэкапы, например журнал на primary во время full на secondary, пока не поддерживаются. BACKUP LOG на secondary выполняется только в обычном режиме, без COPY_ONLY, а цепочка журнала при этом остаётся согласованной, откуда бы вы ни брали бэкапы. Копийный full на secondary на время работы удерживает усечение журнала на этой реплике, и при неудачном стечении обстоятельств вы получите ошибку 9019, остановку синхронизации и, при синхронном режиме, блокировку записи на primary. Документация советует в этом случае сделать full на primary. Читабельная secondary для бэкапов не нужна: параметр Readable Secondary может стоять в No, бэкап всё равно пройдёт (исключение по документации одно: managed backup в Azure). Про другие неприятные особенности версии 2025 я писал отдельно, например про зависание при переводе множества баз, там тема другая, к бэкапам отношения не имеет.
Как это выглядело у риэлторской компании на 47 рабочих местах
Условный пример из моей практики: риэлторская компания «КвадратМетр», 47 рабочих мест, CRM и учёт объектов на SQL Server 2025 (17.x) в группе доступности из двух реплик, SQL-A и SQL-B, синхронная фиксация. Основная база около 210 ГБ, полный бэкап со сжатием около 62 ГБ. Режим предпочтения настроили как Prefer Secondary: бэкапы уехали на SQL-B, ночной full занимал порядка 38 минут, журнал бэкапился каждые 15 минут. На SQL-A и SQL-B стояли одинаковые задания, каждое начиналось с проверки предпочтительной реплики. Схема выглядела образцово. Образцово выглядят они все, пока их не проверяют.
В субботу 12 сентября после установки обновлений провели плановый failover: primary стал SQL-B, а SQL-A превратился в secondary и, значит, в предпочтительную реплику. Задание на SQL-A отработало ночью, статус «успешно», длительность меньше секунды. Всю неделю никто не смотрел: зелёное есть зелёное. Спохватились во вторник 22 сентября, когда сработал Zabbix на заполнение диска с журналом: файл журнала вырос с 18 до 96 ГБ, диск стал занят на 81 процент. Журнал не усекался, потому что журнальных бэкапов не было десять суток. Последний полный бэкап был от 12 сентября, ночной.
Причина оказалась скучной. SQL-A восстанавливали после сбоя летом, задание подняли из старого скрипта, где база называлась по-старому: во время миграции её переименовали. Функция sys.fn_hadr_backup_is_preferred_replica для несуществующего имени вернула 0, скрипт вывел «не предпочтительная реплика» и вышел с успехом. Ни ошибки, ни файла, ни письма. Данные в группе доступности были целы, репликация работала, потеряли мы только возможность восстановиться на любой момент за десять суток. Устранили за два часа: поправили имя, запустили внеочередной full на SQL-A, дождались цепочки журналов. Остальная неделя ушла на то, чтобы такое больше не повторилось, об этом дальше. Подробнее о том, почему журнал не усекается без бэкапа, есть в статье про причину LOG_BACKUP в log_reuse_wait.
Если хотите не повторять этот сценарий, мы можем разобрать ваши задания бэкапа на всех репликах за один рабочий день и показать, где у вас «успех без файла». Напишите, это быстрее, чем ждать следующего failover.
Как написать задание, которое не врёт при failover?
Начинаем с настройки группы. Выполняется на primary. Имена AG_CRM и SQL-B ниже условные, подставьте свои: приоритет 70 у реплики, где вы хотите держать бэкапы, и режим «предпочитать secondary».
ALTER AVAILABILITY GROUP [AG_CRM] SET (AUTOMATED_BACKUP_PREFERENCE = SECONDARY);
ALTER AVAILABILITY GROUP [AG_CRM] MODIFY REPLICA ON N'SQL-B' WITH (BACKUP_PRIORITY = 70);
ALTER AVAILABILITY GROUP [AG_CRM] MODIFY REPLICA ON N'SQL-A' WITH (BACKUP_PRIORITY = 50);
Сразу проверьте результат запросом по трём системным объектам, о которых шла речь выше. Запускайте его на primary: на secondary представление sys.dm_hadr_availability_replica_states возвращает только локальную реплику, и вы увидите одну строку вместо всех. И не пугайтесь NULL в operational_state_desc у secondary-реплик: на primary для удалённых реплик это штатное значение, смотрите на connected_state_desc. Если в колонке backup_priority у кого-то стоит 0 без вашего ведома, это повод для разговора.
SELECT ag.name AS ag_name, ag.automated_backup_preference_desc,
       ar.replica_server_name, ar.backup_priority,
       rs.role_desc, rs.connected_state_desc, rs.operational_state_desc
FROM sys.availability_groups AS ag
JOIN sys.availability_replicas AS ar ON ar.group_id = ag.group_id
JOIN sys.dm_hadr_availability_replica_states AS rs ON rs.replica_id = ar.replica_id;
Теперь само задание. Один и тот же скрипт ставится на обе реплики с одинаковым расписанием, в точности как рекомендует документация: каждый экземпляр сам решает, его ли сейчас очередь. Отличие от примера из документации одно, но принципиальное: сначала мы убеждаемся, что база вообще существует на этом экземпляре, и если нет, задание падает с ошибкой, а не выходит «успешно». Выход с успехом допустим только там, где реплика действительно не предпочтительная.
DECLARE @db sysname = N'CRM';
DECLARE @file nvarchar(260);

IF DB_ID(@db) IS NULL
    THROW 50001, N'База не найдена на этой реплике. Проверьте имя в задании.', 1;

IF sys.fn_hadr_backup_is_preferred_replica(@db) <> 1
BEGIN
    PRINT N'Не предпочтительная реплика, выходим.';
    RETURN;
END;

SET @file = N'\\fs01.example.com\sqlbackup\' + @db + N'_'
          + FORMAT(SYSDATETIME(), 'yyyyMMdd_HHmm') + N'.bak';

BACKUP DATABASE @db TO DISK = @file
    WITH COPY_ONLY, COMPRESSION, CHECKSUM, STATS = 10;
Несколько пояснений. Путь указывает на сетевую папку (здесь условный fs01.example.com), доступную обеим репликам: тогда файл появляется в одном месте независимо от того, кто сейчас предпочтительный, и проверить его наличие можно с одной точки. Учётной записи службы SQL Server Agent нужны права на запись в эту папку. COPY_ONLY я оставил для переносимости: он работает на любой версии, но, как вы помните, не создаёт базу для differential. Если на 2025 вы подтвердили на своей сборке обычный full и differential на secondary, уберите COPY_ONLY и сделайте отдельное задание differential. Если вы создаёте бэкап мастером планов обслуживания (Maintenance Plan Wizard), по документации он сам добавляет проверку функции, но сообщения «не предпочтительная реплика» не выводит, и задания всё равно надо создать на каждой реплике. О том, как строить автоматизацию бэкапов и контроль вокруг неё, у меня есть отдельный разбор системы мониторинга бэкапов.
Как убедиться, что бэкап существует, а не просто отработал?
Статус задания SQL Agent говорит только об одном: скрипт завершился без ошибки. О файлах он молчит. Поэтому проверять надо результат, а не процесс: свежий файл на общем ресурсе, запись в msdb и, главное, возраст последнего бэкапа с оповещением. Простейшая проверка для планировщика или Zabbix, которая смотрит именно на файл, а не на задание:
$limit = (Get-Date).AddHours(-26)
$last = Get-ChildItem '\\fs01.example.com\sqlbackup' -Filter 'CRM_*.bak' |
        Sort-Object LastWriteTime -Descending | Select-Object -First 1
if (-not $last -or $last.LastWriteTime -lt $limit) { Write-Output 'NO FRESH BACKUP'; exit 2 }
Write-Output ('OK: ' + $last.Name)
Окно в 26 часов оставляет запас на суточный цикл. Подставьте своё расписание. Дополнительно можно смотреть msdb.dbo.backupset (колонки database_name, type, backup_finish_date, is_copy_only), но помните: запись о бэкапе остаётся в msdb того экземпляра, где он выполнялся, поэтому после failover историю придётся собирать с обеих реплик.
Второе, что я делаю на каждом проекте, это регулярный плановый failover как тест. Не авария, а учения: переключили группу командой ALTER AVAILABILITY GROUP ... FAILOVER на целевой реплике, дождались следующего окна задания и проверили, что файл появился уже с нового узла. Проверка занимает час, а обнаруживает ровно те ошибки, которые иначе вскрылись бы в 3 часа ночи. После этого полезно сделать то, о чём все говорят и мало кто делает: восстановить свежий бэкап на тестовом сервере. Как это организовать без героизма, описано в статье про тест восстановления бэкапа. Бэкап делают все, проверяет его почти никто.
Приоритеты на случай, если времени мало. Первое: убедиться, что задание есть, включено и расписано на каждой реплике-кандидате. Второе: вставить в скрипт защиту от несуществующей базы, как выше. Третье: поставить оповещение по возрасту последнего файла, а не по статусу задания. Четвёртое: проверить, нет ли реплик с приоритетом 0 и режима «только secondary» там, где secondary нет. Не стоит тратить время на сложные самописные балансировщики бэкапов и на споры, какая реплика «лучше»: в группе из двух узлов хватает приоритетов и одного общего скрипта.
- задание бэкапа создано, включено и расписано на каждой реплике, где backup_priority больше 0
- в скрипте перед проверкой реплики есть защита от несуществующей базы (DB_ID) и ошибка вместо тихого выхода
- оповещение смотрит на возраст последнего файла бэкапа, а не на статус задания Agent
- раз в квартал плановый failover и проверка, что файл появился с нового узла
- бэкап хотя бы раз в месяц реально восстанавливают на тестовом сервере
Частые вопросы
Почему задание SQL Agent успешно, а файла бэкапа нет?
Скрипт мог выйти «успешно» по ветке «не предпочтительная реплика»: функция sys.fn_hadr_backup_is_preferred_replica вернула 0. Так бывает при неверном имени базы, приоритете 0, режиме «только secondary» без доступной secondary. Статус задания файлов не гарантирует, проверяйте возраст последнего файла.
Автоматически ли предпочтительная реплика выполняет бэкапы после failover?
Нет. По документации Microsoft принудительного исполнения AutomatedBackupPreference нет: настройка работает только через логику ваших заданий и на разовые бэкапы не влияет. Задания нужно создать на каждой реплике-кандидате, в них проверять sys.fn_hadr_backup_is_preferred_replica.
Чем Prefer Secondary отличается от Secondary only?
Prefer Secondary делает бэкап на secondary, а если онлайн только primary, то на primary. Secondary only никогда не выполняет бэкап на primary, и если secondary недоступна, бэкап не делается. Prefer Secondary используется по умолчанию.
Можно ли в SQL Server 2025 делать full и differential на secondary?
Да, по документации Microsoft, начиная с SQL Server 2025 (17.x) допустимы full и differential на любой secondary-реплике. В тексте той же документации остались и старые формулировки о differential, поэтому перед регламентом проверьте на своей сборке. Копийный full базой для differential не служит.
Что означает backup priority 0?
Реплика никогда не выбирается для бэкапа. Значения от 1 до 100: чем больше, тем выше приоритет, 1 выбирается, только если нет доступных реплик с более высоким. После failover приоритет 0 «на время» часто оставляет группу без реплики для бэкапа.
Источники
- Microsoft Learn: настройка бэкапов на secondary-репликах — Режимы Backup Preferences, приоритеты 0..100, отсутствие принудительного исполнения, фрагмент скрипта с sys.fn_hadr_backup_is_preferred_replica, примеры PowerShell: https://learn.microsoft.com/en-us/sql/database-engine/availability-groups/windows/configure-backup-on-availability-replicas-sql-server?view=sql-server-ver17
- Microsoft Learn: бэкапы на secondary-репликах — Поддерживаемые типы бэкапов, раздел про full и differential для SQL Server 2025 (17.x), ограничения, ошибка 9019: https://learn.microsoft.com/en-us/sql/database-engine/availability-groups/windows/active-secondaries-backup-on-secondary-replicas-always-on-availability-groups?view=sql-server-ver17
- Microsoft Learn: sys.fn_hadr_backup_is_preferred_replica — Синтаксис, возвращаемое значение, поведение для несуществующей базы (CU20 для 2019, CU2 для 2022): https://learn.microsoft.com/en-us/sql/relational-databases/system-functions/sys-fn-hadr-backup-is-preferred-replica-transact-sql?view=sql-server-ver17
- Microsoft Learn: ALTER AVAILABILITY GROUP — Синтаксис AUTOMATED_BACKUP_PREFERENCE и BACKUP_PRIORITY: https://learn.microsoft.com/en-us/sql/t-sql/statements/alter-availability-group-transact-sql?view=sql-server-ver17
- Microsoft Learn: sys.availability_groups и sys.availability_replicas — Колонки automated_backup_preference_desc и backup_priority: https://learn.microsoft.com/en-us/sql/relational-databases/system-catalog-views/sys-availability-groups-transact-sql?view=sql-server-ver17
- Microsoft Learn: Copy-Only Backups — Копийный full не служит базой для differential, колонка is_copy_only в backupset: https://learn.microsoft.com/en-us/sql/relational-databases/backup-restore/copy-only-backups-sql-server?view=sql-server-ver17